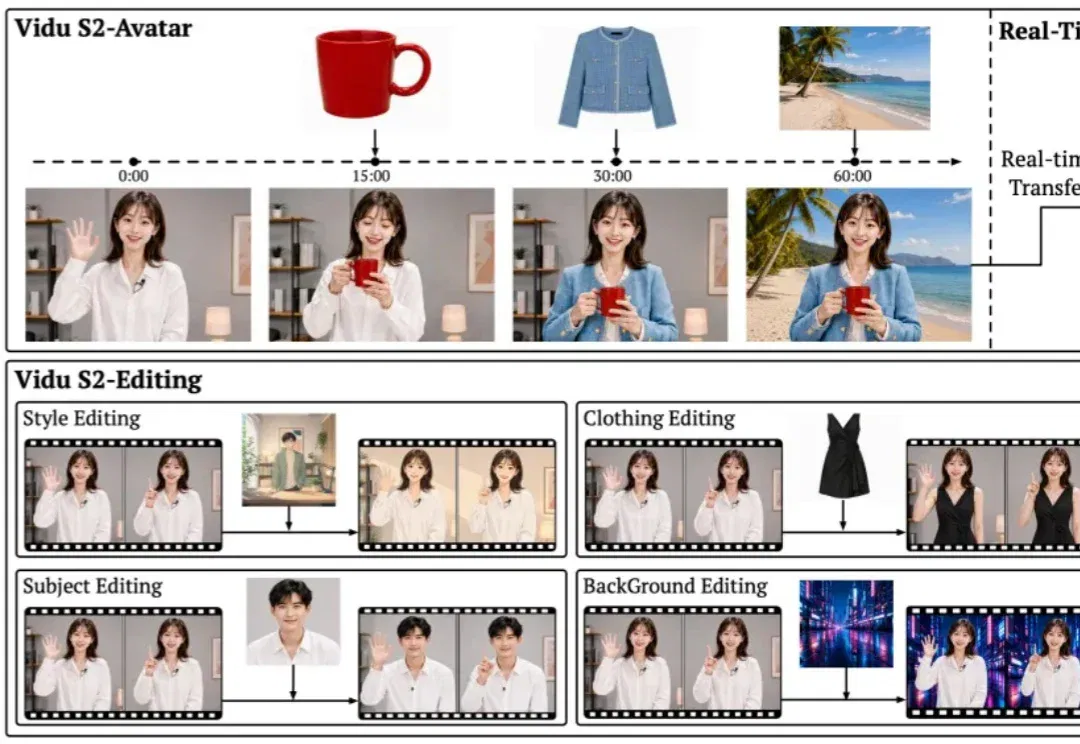
实时编辑、实时互动视频双旗舰,Vidu S2发布即体验 (opens in a new tab)
AI 视频,正在变成一个可以边播、边演、边改的实时系统。
Categories
Practical guides to AI tools, models and related technologies.
AI 视频,正在变成一个可以边播、边演、边改的实时系统。
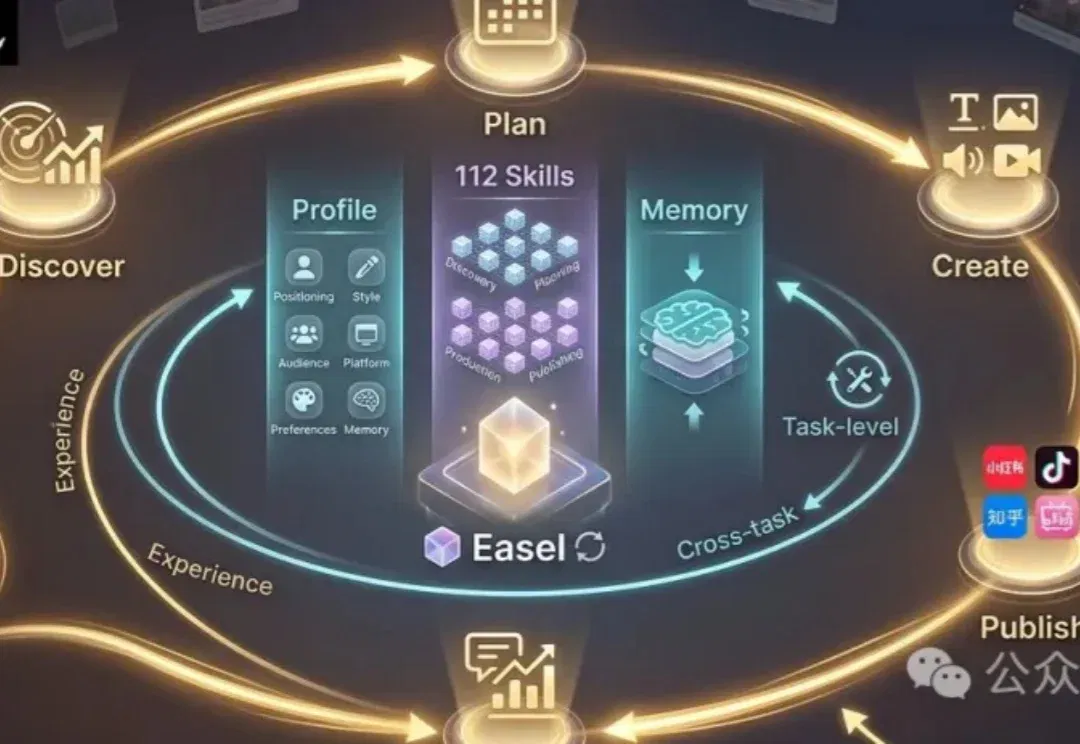
当大模型已经能够快速生成文案、图片和视频,一个更进一步的问题是:Agent 能否从执行过的任务中积累经验,并在持续交互中改进后续行为?
论文标题:Rethinking the Evaluation of Harness Evolution for Agents论文链接:https://arxiv.org/abs/2607.12227代码:https://github.com/rethinking-harness-evolution 博客:https://yikee.github.io/harnessevolution/ 一个 Agent 第一次没把任务做对。 接下来,你有五份额外的推理预算,可以有很多种花法。 你可以让它把同一道题重新做几遍,从多个结果里挑最好的;可以把上一次失败的过程交给它,让它接着修;也可以做一件听起来更
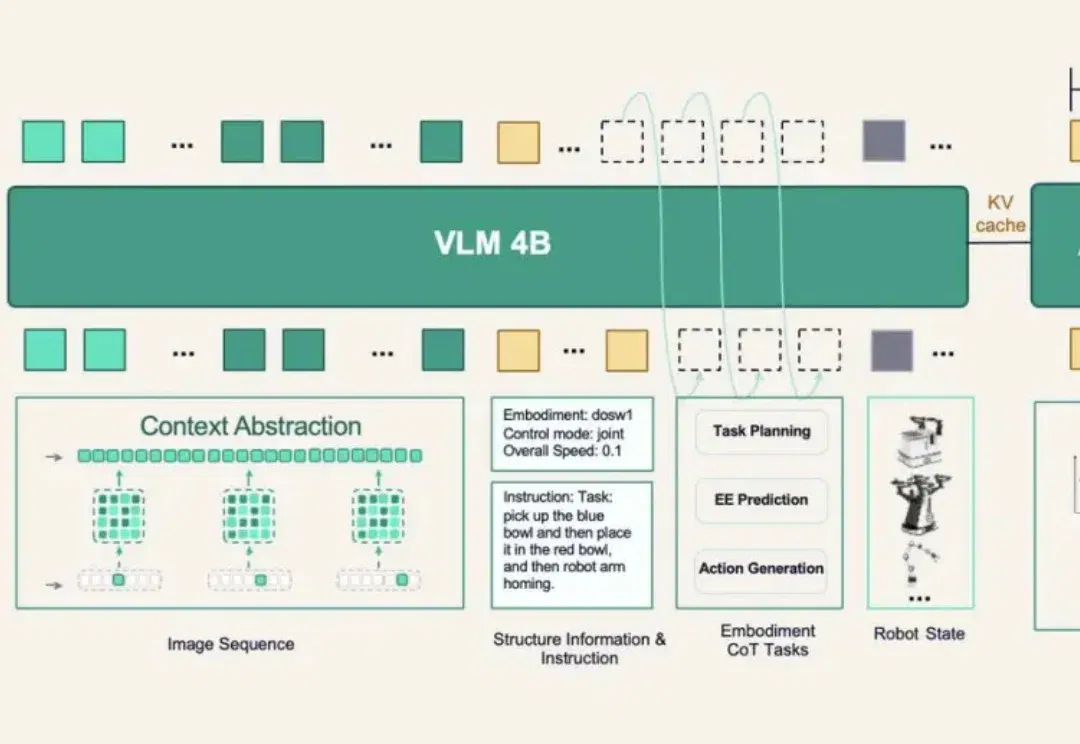
具身智能最近又多了一张榜单,而排在第一的,还是一个熟悉的名字:原力灵机 DM0.5。
Seedance 2.5 让我这个半吊子的AI视频创作者都能上瘾玩上一个多月,就不用再多余说表现有多强了吧。
10B参数以内,空间具身能力同档第一的通用多模态大模型来了!
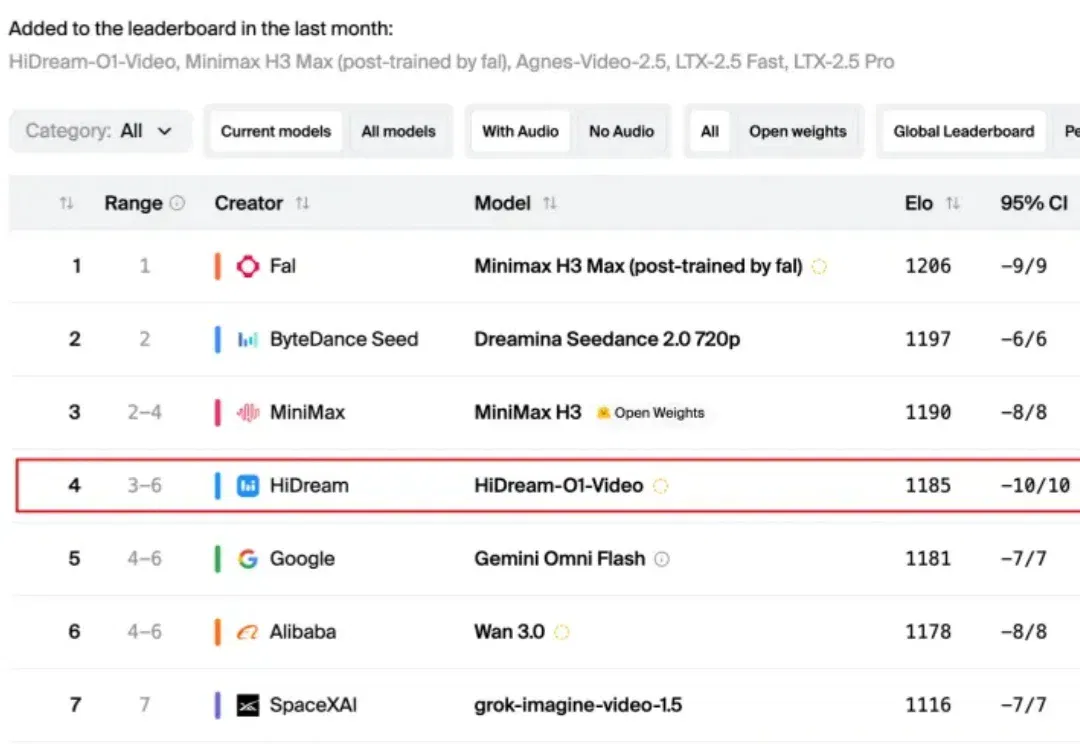
最近几个月,AI 视频赛道开始热起来了: Seedance2.0 发布后,AI 视频进入可用阶段,MiniMax H3 发布后,以 1/4 的价格,把 Seedance 2.0 的成本打了下去,AI 视频成本进入平价时代。
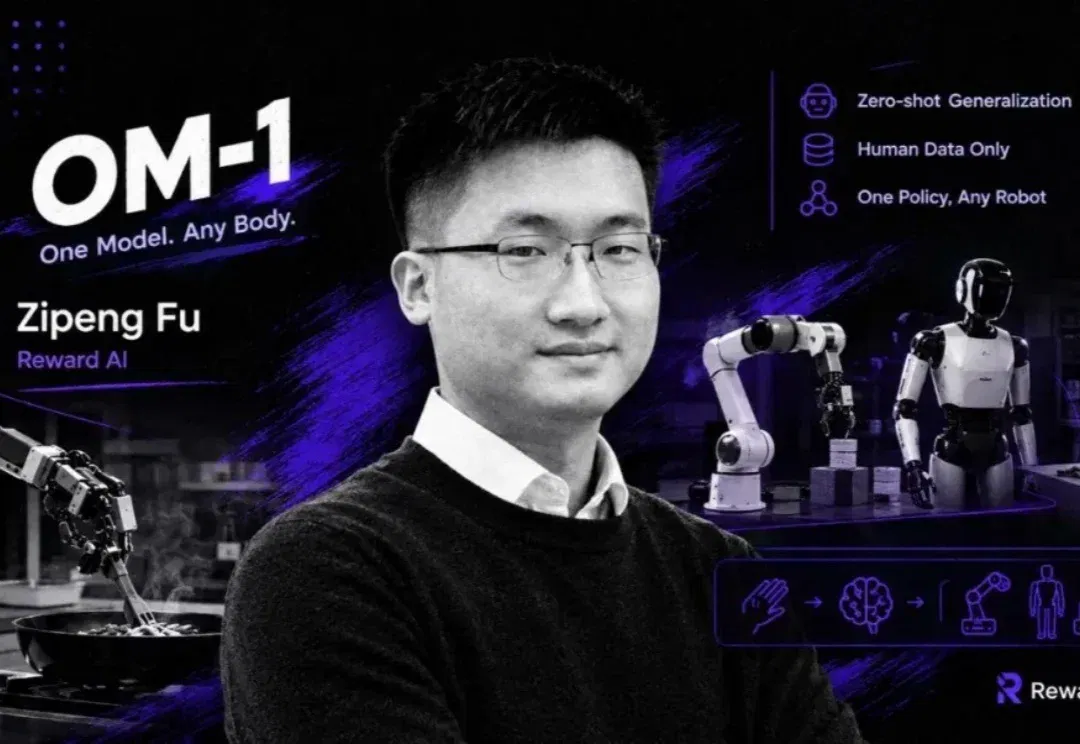
近期,由斯坦福大学计算机科学博士符梓鹏(Zipeng Fu)联合创立的新团队Reward AI,正式发布通用机器人策略OM-1(Omnibody Model 1),并公布了完整的Omnibody技术栈。
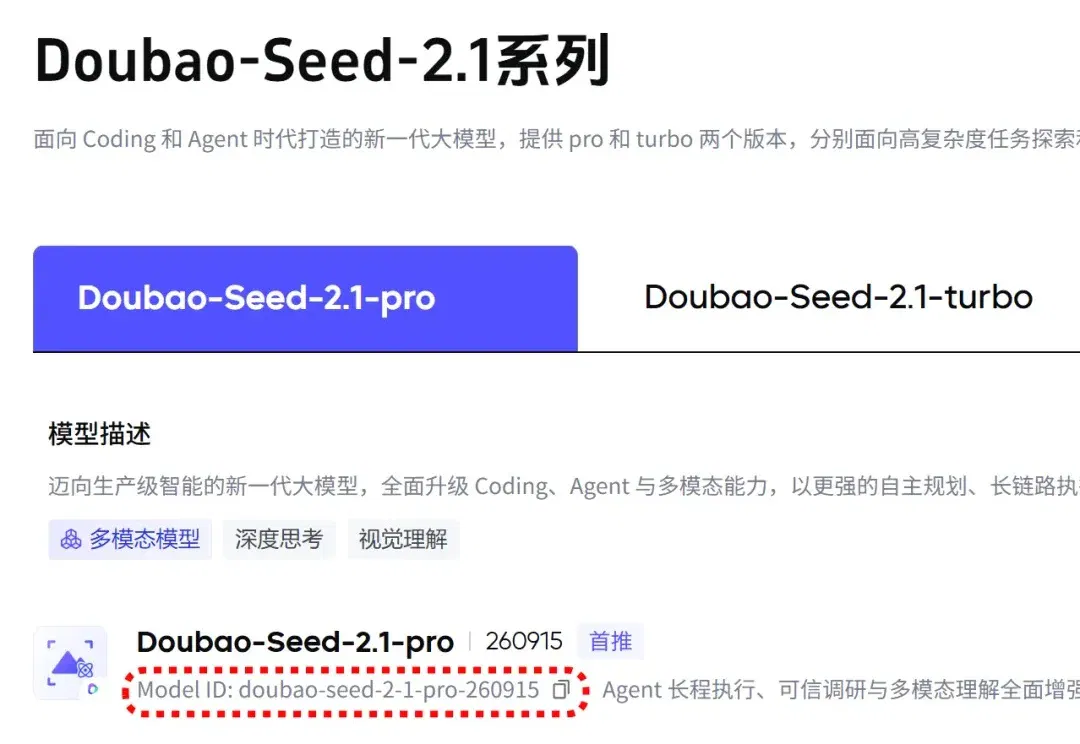
盼了三个月,今天 Seed-2.1-pro 终于迭代了 图片
在过去的几年里,LLM RL 系统的工作负载发生了巨大的变化。早期的 RLHF 围绕同步训练展开:模型按固定顺序进行生成、打分和训练,每个阶段之间有着明确的同步边界。如今,系统还需要处理异步生成、持续训练、多轮 Agent 以及与外部环境的交互 —— 那些在同步执行中原本隐含的状态、版本和故障边界,现在都必须显式地进行管理。
43页财报一句话变带图表网页。 一款模型“好不好”,究竟该如何定义? 显然,Agent正在改变人们评价大模型的方式。过去,判断模型强不强,往往看参数规模、Benchmark成绩和上下文长度。 而在Agent时代,一款能够又快又好地解决问题、完成任务,且token花得起的模型,才是很多用户眼中的好模型。 顶级模型固然能力更强,但往往思考和执行时间长、成本高昂,而快速模型生成token很快,却容易走错路、反复尝试,甚至需要人工接手,任务完成速度根本没快多少。 用更少的计算和无效尝试,更快更好地完成任务,是如今用户对Flash级别模型的期待,也让Flash级别模型逐渐从旗舰模型的轻量版本,走向一条独
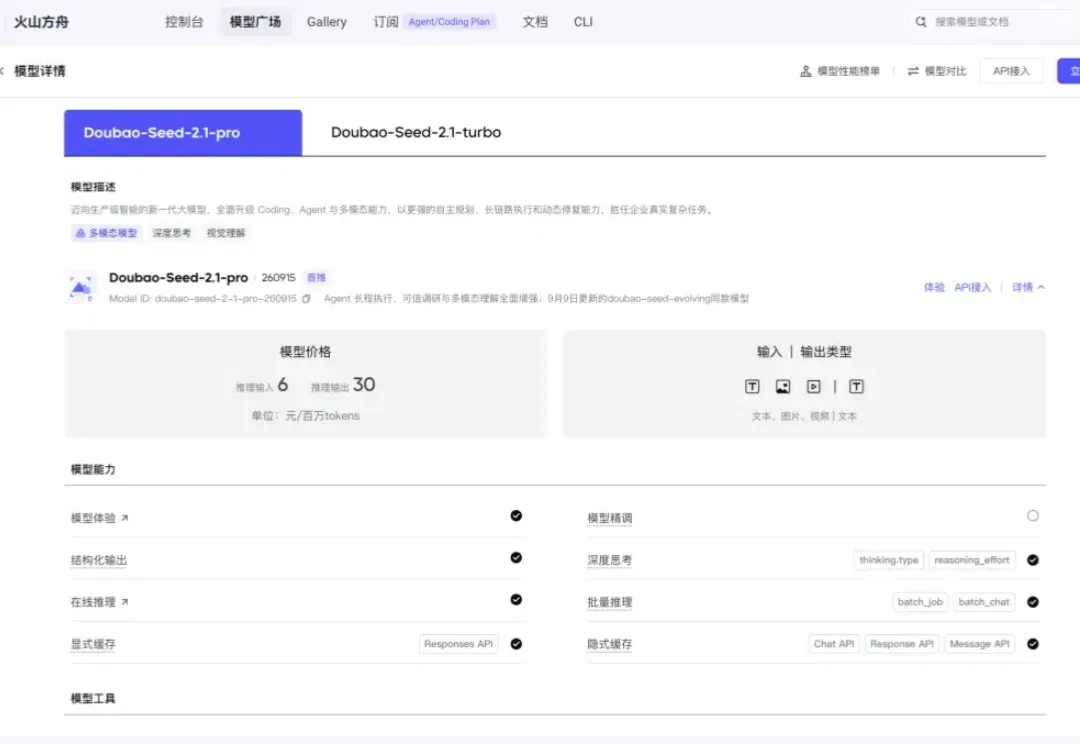
最近Seed-2.1-pro又更新了。 上一次记得还是6月下旬,Coding能力有了一大波刷新,带来了很多有意思的场景落地。 最新升级到了0915,Doubao-Seed-Evolving同步更新到同一版本。 静态视觉和动态交互,都有了新的水准。给大家看看我做的网页质感: 提示词: Design a premium futuristic AI startup landing page based on the reference image. Style: cinematic, minimalist, high-end, black background, white typography,
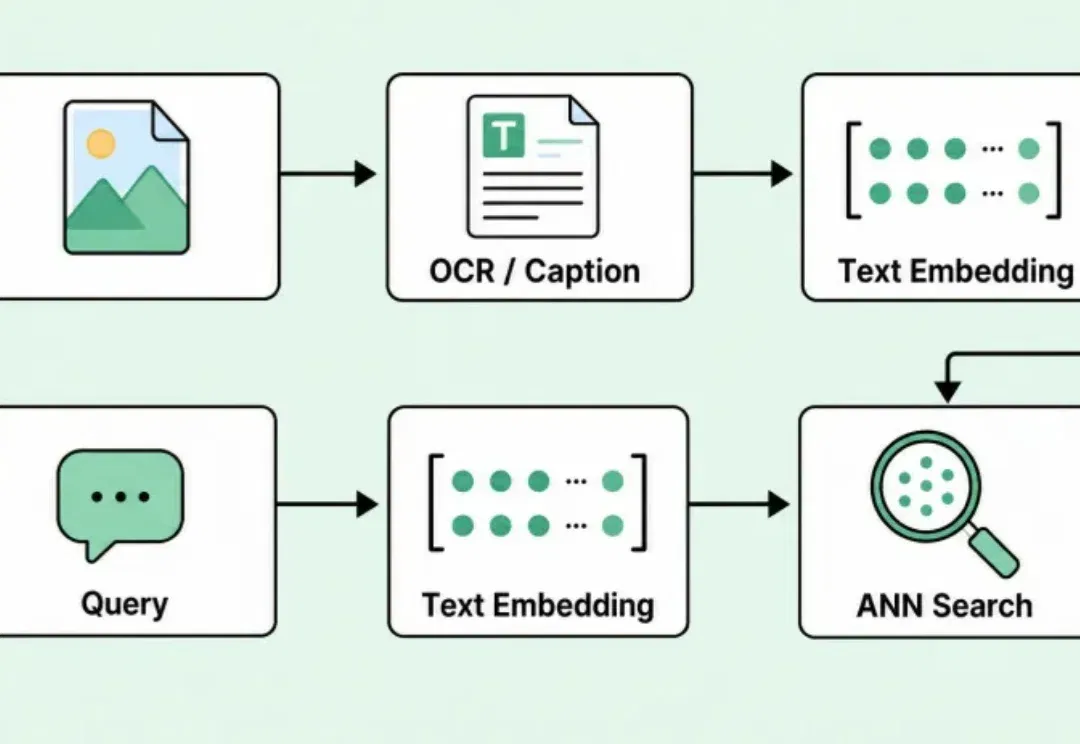
前不久,微信视觉团队开源了WeMM-Embedding。
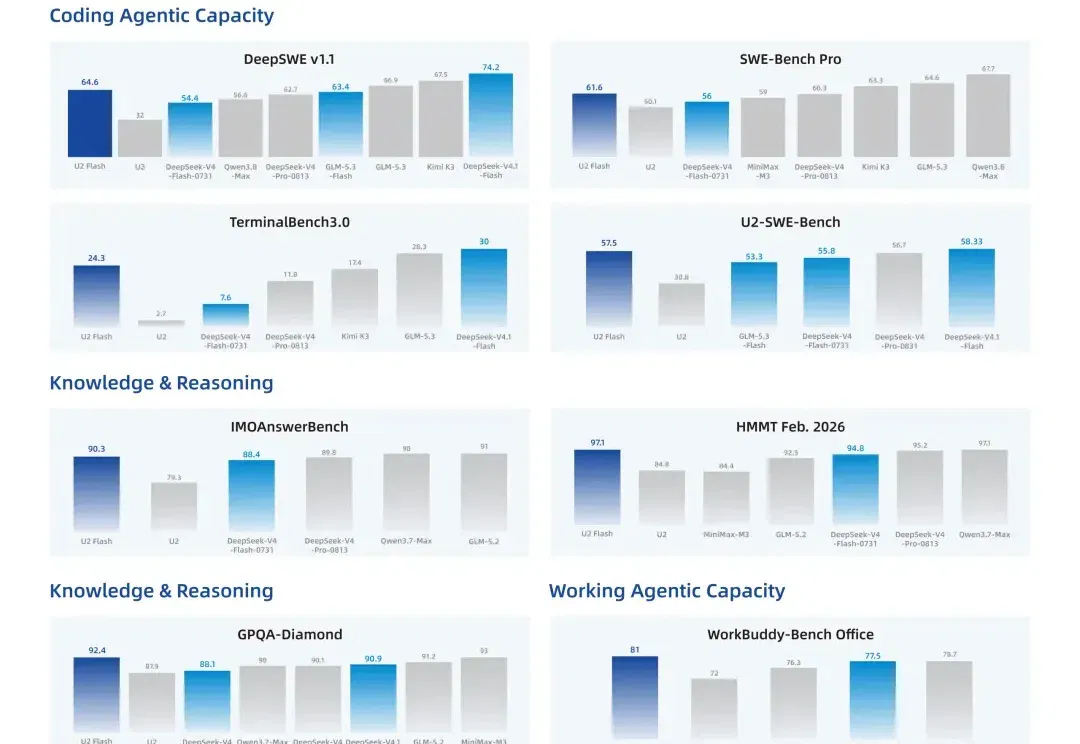
RSI,彻底火了。 从硅谷一路烧到国内,「让模型参与训练下一版自己」几乎一夜之间成了AI圈最热的叙事。 不过热闹归热闹,目前真正拿模型交卷的还屈指可数。 而就在这一当口,「港股AGI第一股」云知声正式发布U2-Flash,率先交出一份国产RSI早期答卷。 △图源:云知声 在U2-Flash的后训练闭环里,模型已经开始深度参与自身演进: 从生成训练数据、分析执行轨迹,到巡检和修复训练系统。 然后,反常识的部分来了。 按行业惯例,Flash一般默认是「旗舰平替」,通常更快、更便宜,但能力相对打折。 结果U2-Flash呢? 速度和省钱能力的提升确实没含糊。相比U2,其生成速度提升2.1倍,Agen
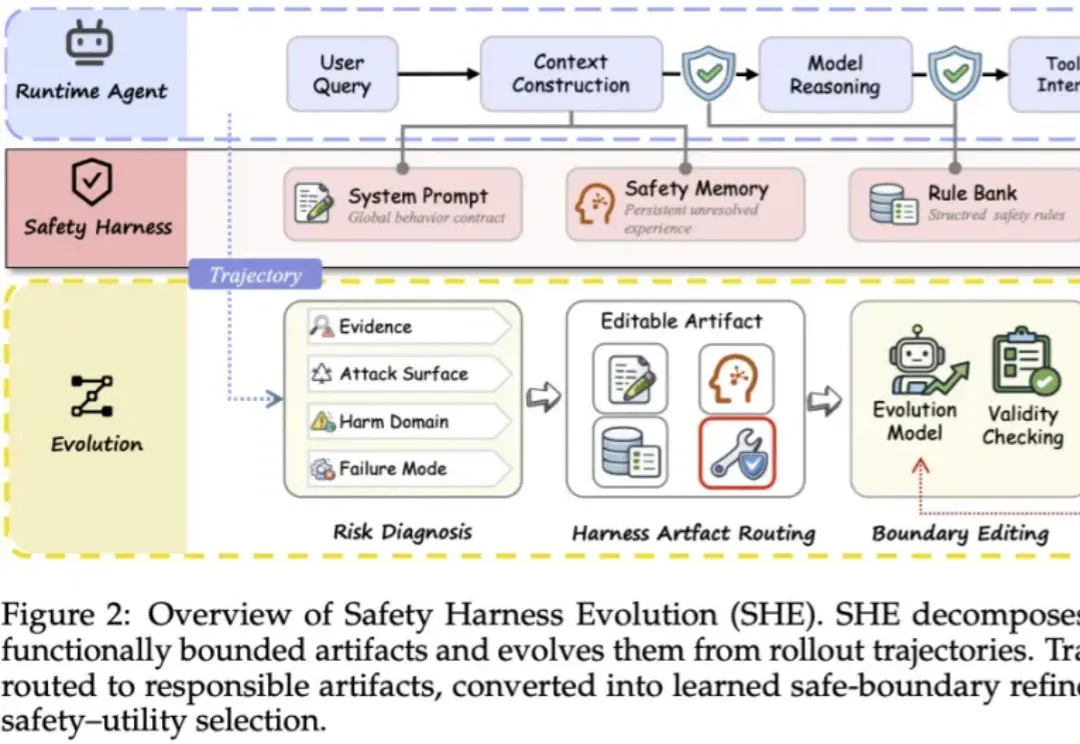
大模型 Agent 进入浏览器、邮件、数据库和业务系统后,安全评估如果仍只检查最终回复是否包含有害内容,覆盖面会明显不足。Agent 需要规划步骤、读取外部信息并调用工具,风险可能出现在执行过程中的任一环节。
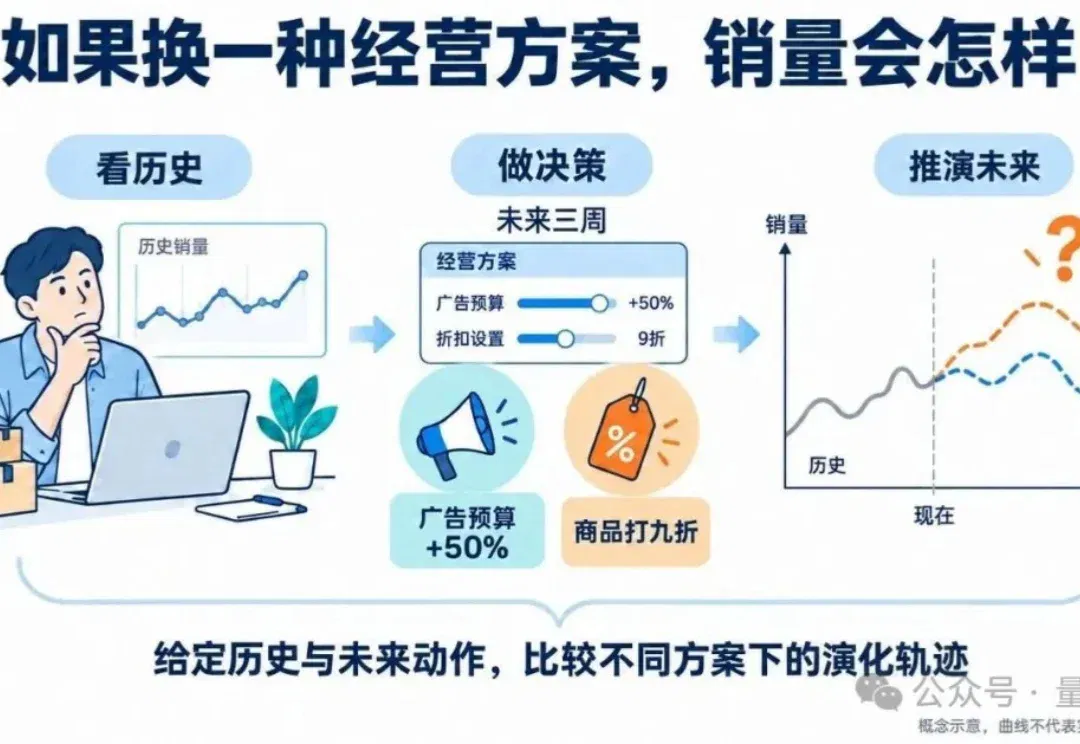
真实世界的时间序列,不仅被外部事件冲击,也被人为决策持续重塑。
9 月 3 日,OpenAI 正式发布 GPT-6 Astra。在 ARC-AGI-3(一个考验 AI 能否在陌生环境中自主探索、理解规则并规划行动的 Benchmark),Astra 拿下 99.9%,并在 96% 的关卡中达到或超过人类的行动效率基准。
谷歌,可能已经破解了RSI! 就在刚刚,谷歌联合 Google DeepMind、马里兰大学及弗吉尼亚大学,发表了一篇重磅论文。 这一次,他们展示了一条完全不同的RSI路线:AI自我进化,居然可以靠做梦? 这一次,谷歌是让智能体把自己走过的每一步存成一棵树,然后在树里「做梦」。 在梦里练出更优的探索策略,再回到现实继续干。 论文地址:https://arxiv.org/abs/2609.14858 Dream-RSI的效果可以说是相当震撼: 算法优化任务,主流进化搜索系统需要跑51200代,Dream-RSI调用317次就达到了同等水平。 圆填充问题,追平谷歌自家AlphaEvolveV2的最
一笔融资、一份技术报告,让一个过去五年鲜少公开发声的团队,逐渐显露出更完整的面貌。
灵巧手从 demo 走向真实应用,关键不只是 “会不会动”,而是能否在 noisy depth、稀疏触觉、外力扰动和未见物体下稳定泛化。现有 in-hand manipulation 往往依赖固定物体、定初始位姿或理想传感器。而一旦遇到真实深度噪声、形状变化和接触状态不可见,这些策略就容易退化成近乎开环的 “手指套路”。
Join the conversation
Read how to join the community. No sign-in is required to read articles.