Minimax H3 之后,又来了一位狠角色:智象 HD-V1 发布,视频模型开始理解现实世界!
最近几个月,AI 视频赛道开始热起来了: Seedance2.0 发布后,AI 视频进入可用阶段,MiniMax H3 发布后,以 1/4 的价格,把 Seedance 2.0 的成本打了下去,AI 视频成本进入平价时代。
最近几个月,AI 视频赛道开始热起来了:
Seedance2.0 发布后,AI 视频进入可用阶段,MiniMax H3 发布后,以 1/4 的价格,把 Seedance 2.0 的成本打了下去,AI 视频成本进入平价时代。
很多创作者开始意识到:AI 视频真的能进入内容生产流程。
不过,当创作者真正用起来,问题很快就会出现:
这些视频乍看都挺漂亮,但你点开视频,发现每一秒都可能藏着穿帮:你想让人物推开一扇沉重木门,模型生成的手在往左用力,门却向右打开;你想让人物 5s 后从一个地点跑到另外一个地点,结果人物念完对白,时间不够了,马上瞬移到另外一个地点。
于是重新生成,结果一条十几秒的视频,最后花掉的时间和积分远超预算。
与此同时,随着模型生成速度快于模型播放速度,B 站上开始出现 24h 直播的互动视频服务,但是如果你仔细观察:
这些互动视频,由于不同用户的提示词不连贯,人物经常做出出戏的动作,导致互动播放效果极差。
AI 视频赛道,还需要一个真正理解世界的视频模型。
最近,视频模型里又来了一位新选手:智象未来刚发布了 HiDream-O1-Video-1.0(简称 HD-V1)。
我们第一时间便上手体验了下,HD-V1 给这个行业完善了一个重要的拼图:
相比于 Seedance 系列和 H3 系列,它能更好的理解这个“世界”。
国际双榜验证,HD-V1 站上全球前列
HD-V1 是智象(HiDream.ai)发布的首个原生全模态视频生成模型。
它支持文本、图片、视频等多种输入方式,可直接生成 5 至 20 秒的 1080P 高清视频。
值得注意的是,HD-V1 在两项国际权威独立模型评测榜单上的首次表现:
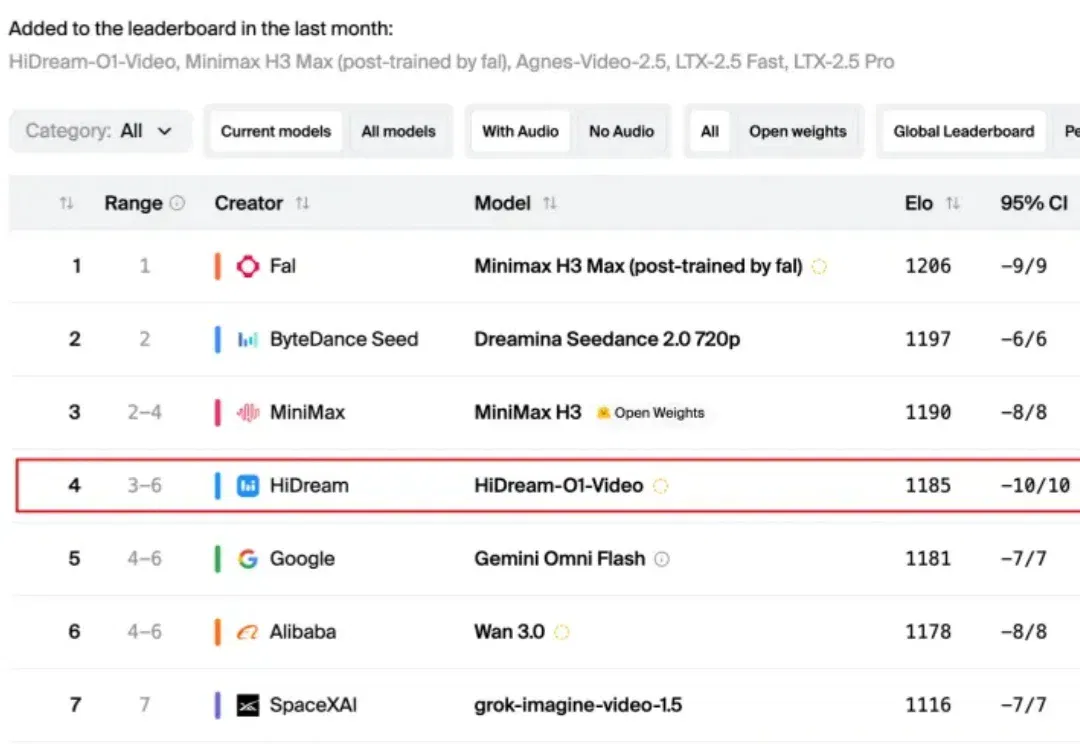
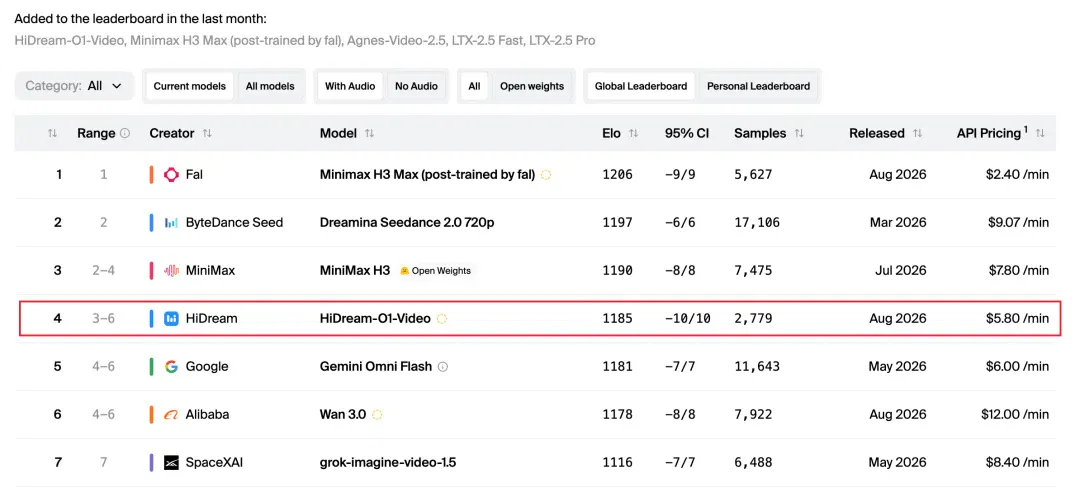
在 Artificial Analysis 的 Image to Video Leaderboard(With Audio)中,HD-V1 位列全球第 4。Artificial Analysis 采用标准化、可复现的评测方式,是目前观察全球视频模型综合能力的重要平台。
在另一个偏用户盲测的 Arena.ai 的图生视频盲测榜中,它排到了第 8。这个榜单则是让用户在不知道模型名称的情况下,进行两两比较让用户打分,更接近真实用户对最终结果的选择。
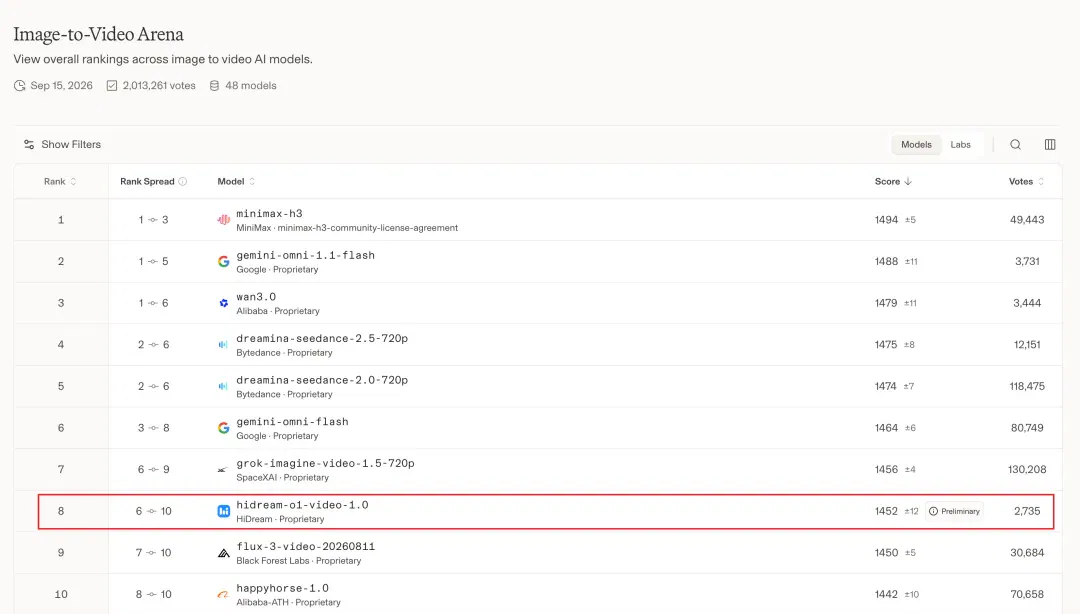
这意味着,在全球图生视频这个竞争最激烈的方向里,它已经站进了全球第一梯队。
HD-V1 最核心的能力,是「先理解,再生成」。 它前置了多模态意图理解模块,能够将用户的口语化、模糊化的需求自动转写为包含场景、角色、动作、运镜、音效、转场等要素的结构化规划,理解完成后才启动视频生成。
此外,HD-V1 还支持音画同出:区别于传统模型“先生成画面、再匹配音轨”的两段式流程,HD-V1 在同一生成过程中对画面与声音进行联合建模,一键直出带配音的完整视频,帮助创作者省去后期配音环节,进一步降低制作成本。
在物理逻辑遵循方面,HD-V1 表现尤为突出:无论是物体的的张力变化、还是随画面同步变化的声音节奏,它都能生成符合真实物理规律的连续画面与音频。
这意味着创作门槛大幅降低了:创作者只需要专注于剧本设计,而不再需要精心打磨提示词和配音。
HD-V1 效果,一手实测
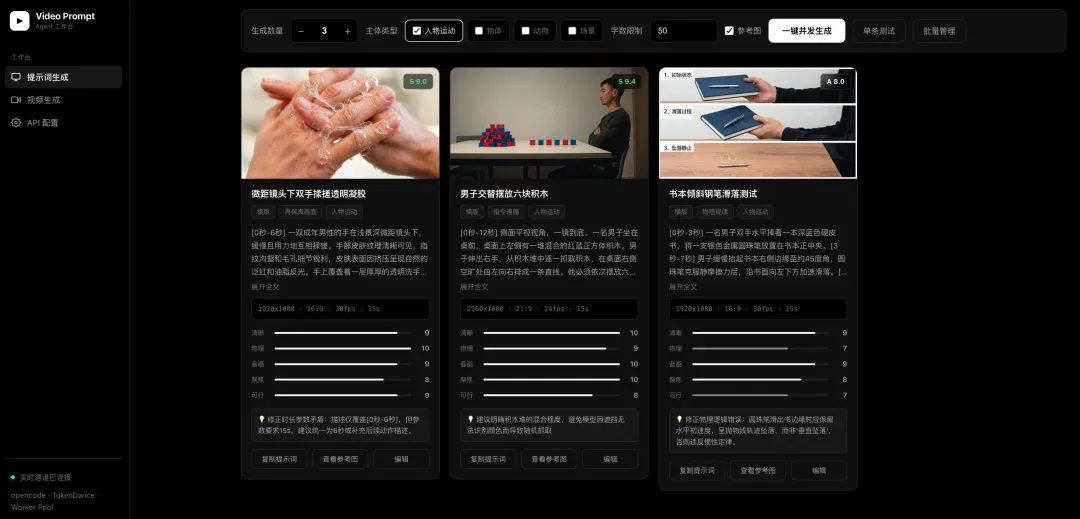
本次测评,我使用了自己专门用于模型评测的提示词系统:
先接入 HD-V1 的 API,再以两款视频模型:Minimax H3 和 Seedance 2.5 作为对照组,进行效果对比。
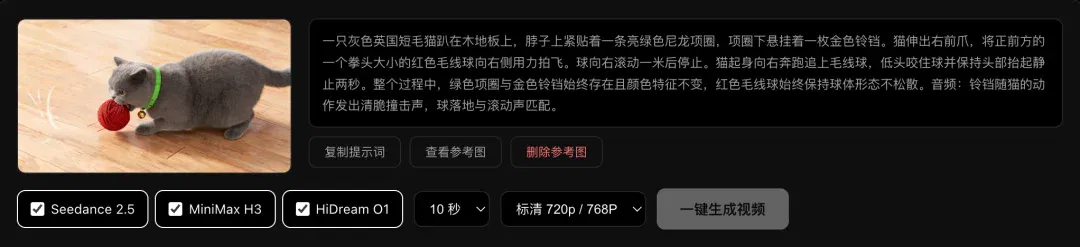
我先用一段猫咪场景做测试:
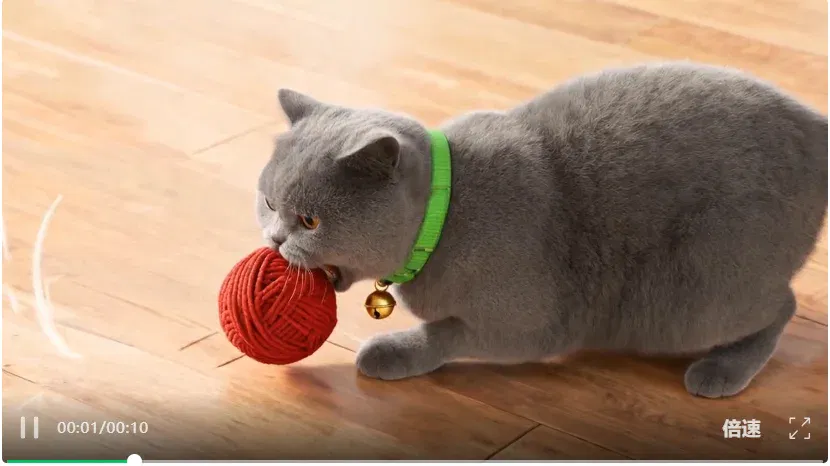
一只灰色英国短毛猫趴在木地板上,脖子上紧贴着一条亮绿色尼龙项圈,项圈下悬挂着一枚金色铃铛。猫伸出右前爪,将正前方的一个拳头大小的红色毛线球向右侧用力拍飞。球向右滚动一米后停止。猫起身向右奔跑追上毛线球,低头咬住球并保持头部抬起静止两秒。整个过程中,绿色项圈与金色铃铛始终存在且颜色特征不变,红色毛线球始终保持球体形态不松散。音频:铃铛随猫的动作发出清脆撞击声,球落地与滚动声匹配。
HD-V1 生成的画面非常流畅:猫咪的拍球、追球动作连贯,铃铛和毛线球的视觉特征全程可以保持一致。
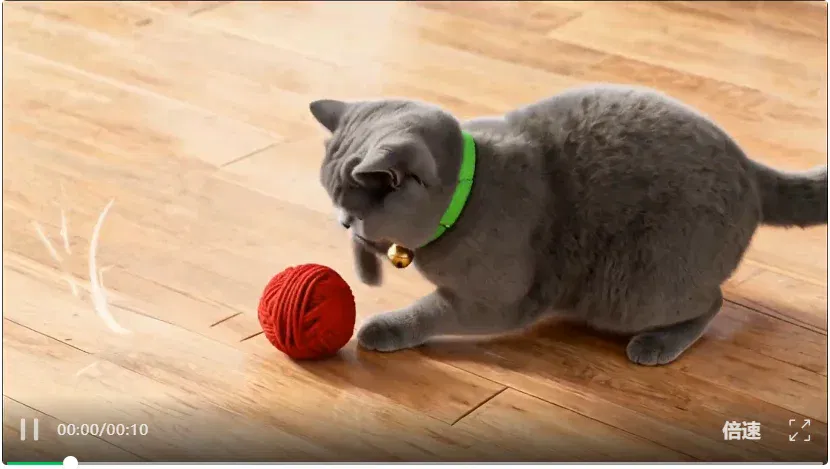
MiniMax H3 的动作,略微有些僵硬:
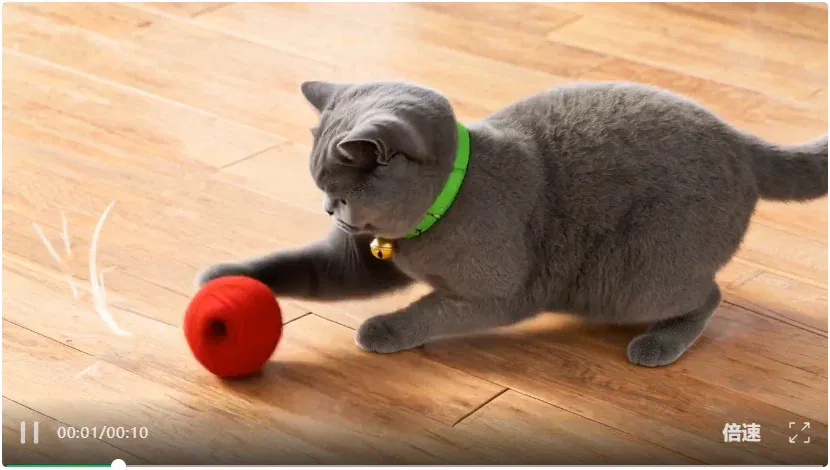
Seedance 2.5 的开头有明显的起始卡顿,后半段不错:
接着,我用一组扑克牌测试模型对指令顺序和物理逻辑的遵循能力。
顶拍视角,一镜到底,固定镜头。深绿色桌面上,一只手从左至右依次放置四张扑克牌。顺序必须严格遵循:第一张黑桃A,第二张红心K,第三张梅花5,第四张方块2。牌与牌之间保持等距,且下边缘呈一条直线对齐。音频:伴随四次清脆的落牌声,声音与牌面接触桌面的画面动作逐帧同步。
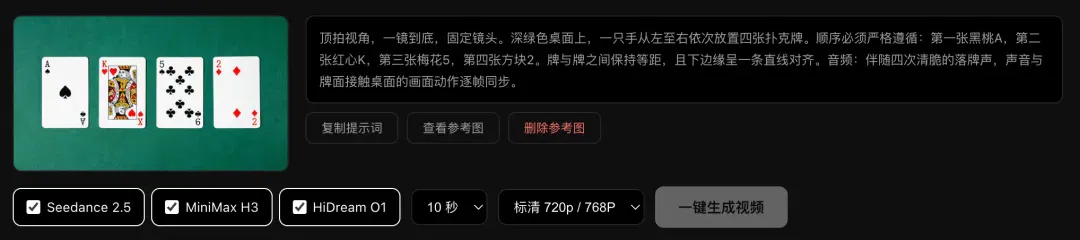
由于参考图已经给出了正面朝上的牌面,HD-V1 正确理解了这一视觉语义,仅对牌的位置进行了调整,物理逻辑完全正确:
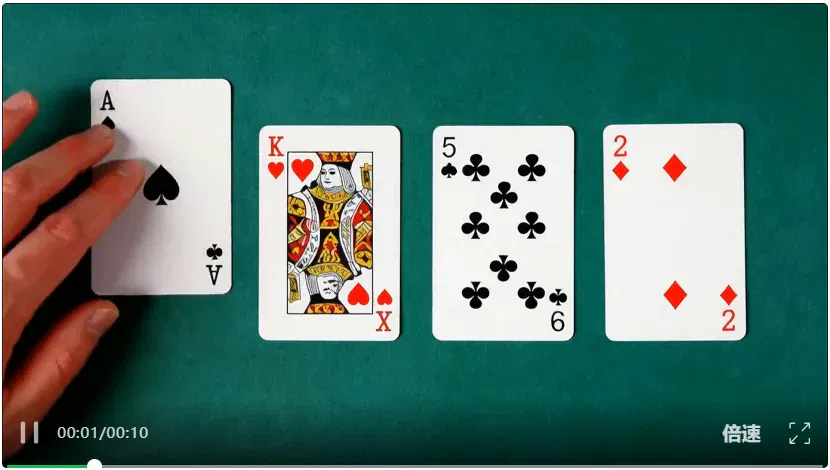
H3 没处理好这个语义,将 4 张独立的牌错误理解为一副扑克:
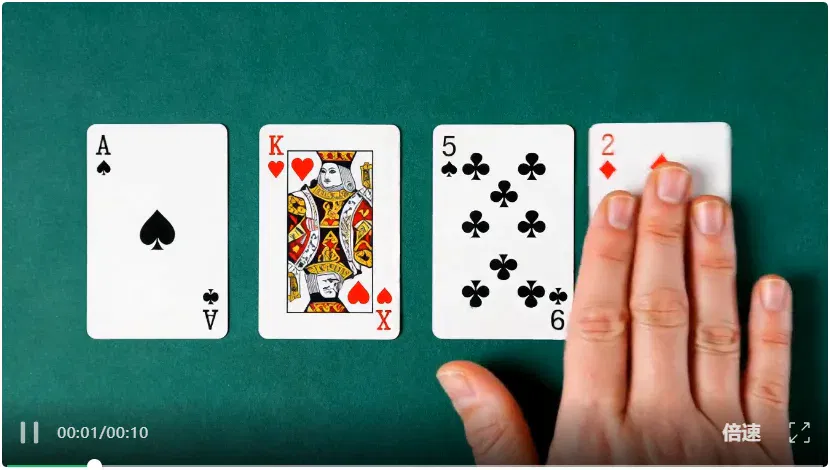
Seedance 2.5 的问题则最离谱:出现了牌面正反翻折的问题。
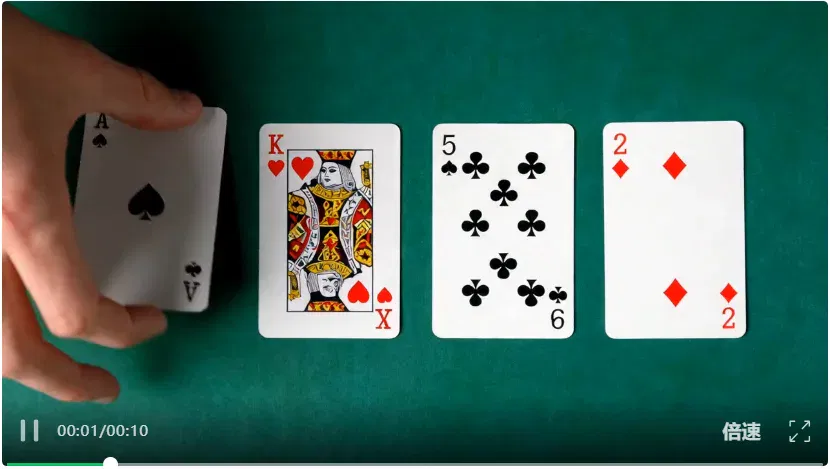
这个 Case 实测下来,三个模型里面,只有 HD-V1 严格遵循了物理逻辑。
最后,我用一个更高难度的物理场景来考验三个模型:
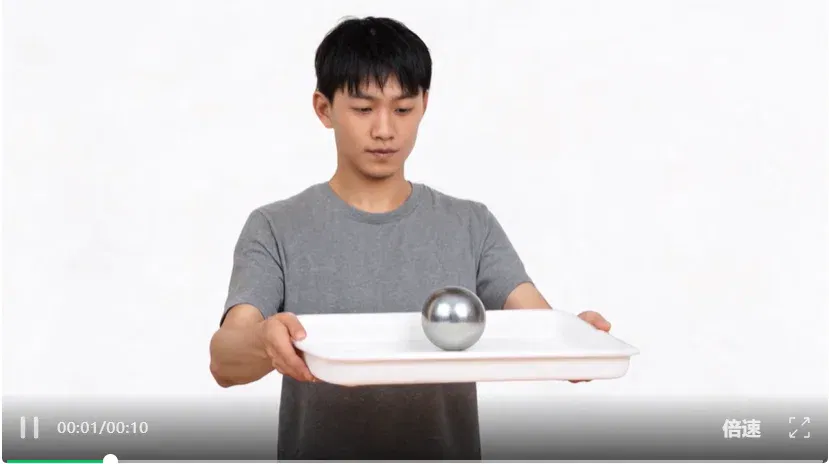
金属球从倾斜托盘滚落、抛物线坠地、连续反弹三次且高度递减,这要求模型同时理解重力加速、能量衰减和音画同步。
[0秒-3秒] 一名穿着灰色T恤的男性双手水平持握一个白色光滑塑料托盘,将一颗银色金属实心球放置在托盘正中央。[3秒-6秒] 男性将托盘右侧迅速向下倾斜45度,金属球在重力作用下向右加速滚动,脱离托盘边缘后呈抛物线坠落。[6秒-10秒] 金属球撞击坚硬的木地板,连续反弹三次,反弹高度依次严格递减,最后完全静止。音频:球体滚动声随倾斜角度增大而增强,落地撞击声清脆短促,三次反弹声的音量和音调呈现符合物理规律的逐次衰减。
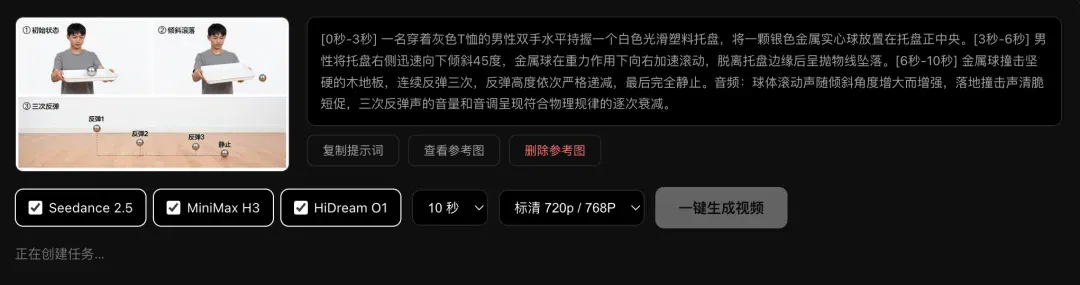
HD-V1 的整体效果最为自然,反弹节奏和球落地的声音衰减都符合物理直觉:
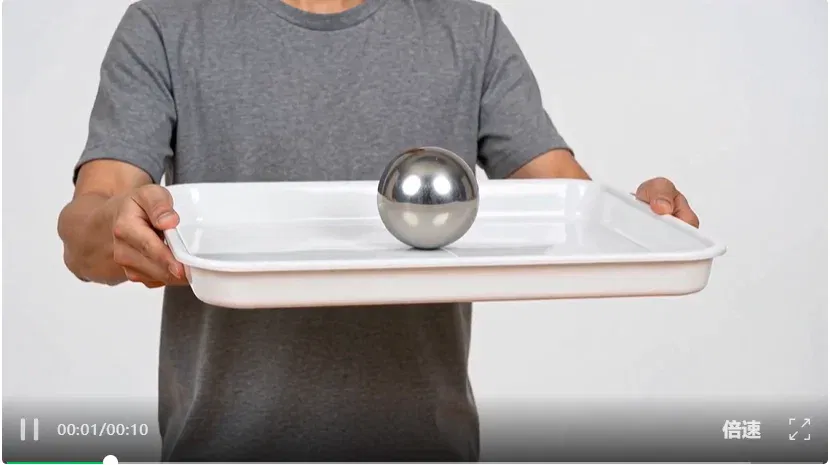
H3 的画面还不错,但球落地的声音变化没那么自然(从金属碰撞声变成另外一种木质感觉的声音):
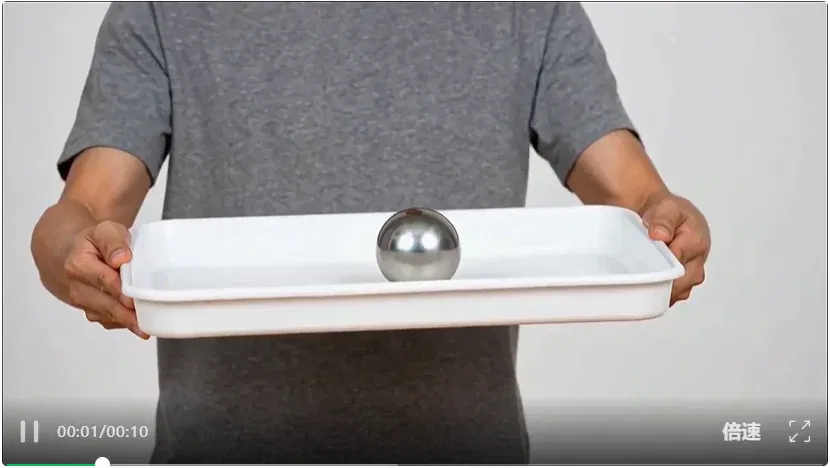
Seedance 2.5 的效果依然最糟糕:人物动作则明显僵硬,整体观感最弱。
三组测试整体看下来:HD-V1 在物理逻辑合理上,显著超越了 Seedance 2.5 和 Minimax H3。
它确实做到了“先理解后生成”:理解画面里真正在发生什么,然后生成的画面较为符合现实逻辑,并且也比较稳定。
视频模型的胜负手:理解世界
过去大家看视频模型,最直观的指标是分辨率、时长和画面。
随着最近视频模型的发展,主流模型的画面和画质都在快速提高,并且 1080P 和十几秒生成也逐渐成为基础能力。
真正拉开差距的,开始变成视频模型对于世界的理解:
用户说“球逐渐停止弹跳”,模型要理解能量不断衰减,弹跳高度、碰撞间隔和声音都应该随之变化。用户说“接住苹果”,苹果在运动前后还得是同一个苹果,不能突然丢掉叶片或者改变外观。
但传统视频生成模型通常基于数据驱动的方法,通过在海量视频数据上学习统计规律来生成新视频,这种方法很难以保证生成内容在物理上的合理性。
智象的 HD-V1 将物理规律融入生成逻辑的技术路径,有效的解决了这个问题:
它先通过多模态理解模块进行全局规划,再联合生成画面与声音,后训练阶段引入 Diffusion Reinforcement Learning 和多模态 Reward 模型,对画质、连贯性、身份一致、物理合理性与音画同步进行统一评估。
在视频生成领域,这是目前最具前瞻性的探索之一。
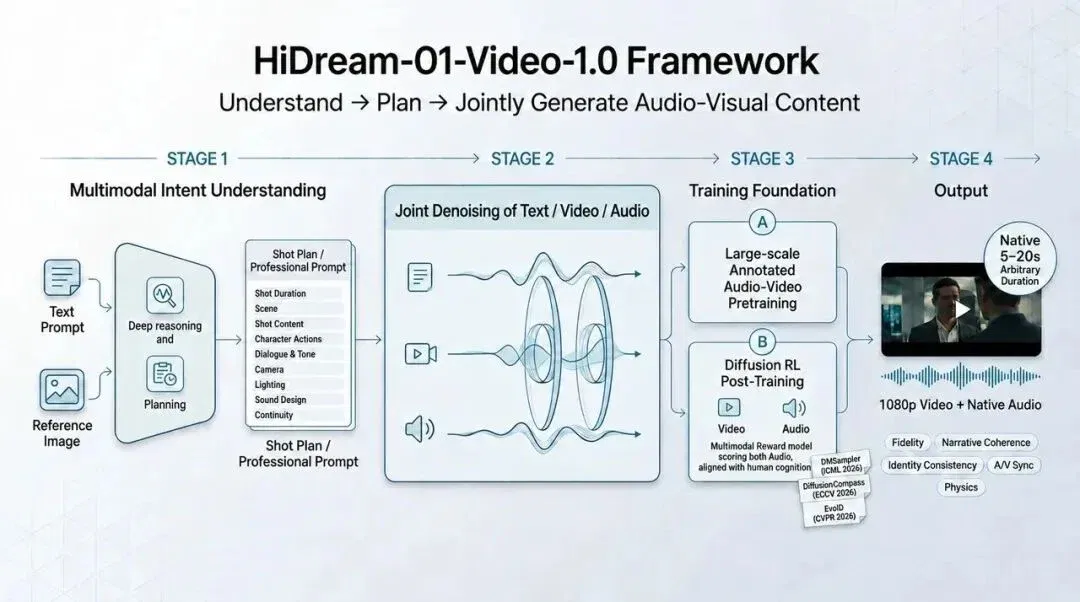
这条路径指向的,是视频生成领域下一阶段真正的分水岭:
当模型的画面、质量、成本不再是效果区分度的来源,模型对世界的理解深度,才是决定用户选择的核心。
谁能更准确地理解意图,谁能处理声音、动作与叙事之间的因果关系,谁才更有机会从视频生成工具,走向真正的世界模型。
而 HD-V1 的技术路径,正是当前对这一方向最具前瞻性的探索之一。
四大模型同源演进,原生全模态世界模型从蓝图走向现实
对于智象未来,HD-V1 不止是一款新的视频生成工具,它补上的,是智象原生全模态世界模型矩阵里最关键的一块拼图。
在此之前,智象的其他模块的模型已经取得领先身位:
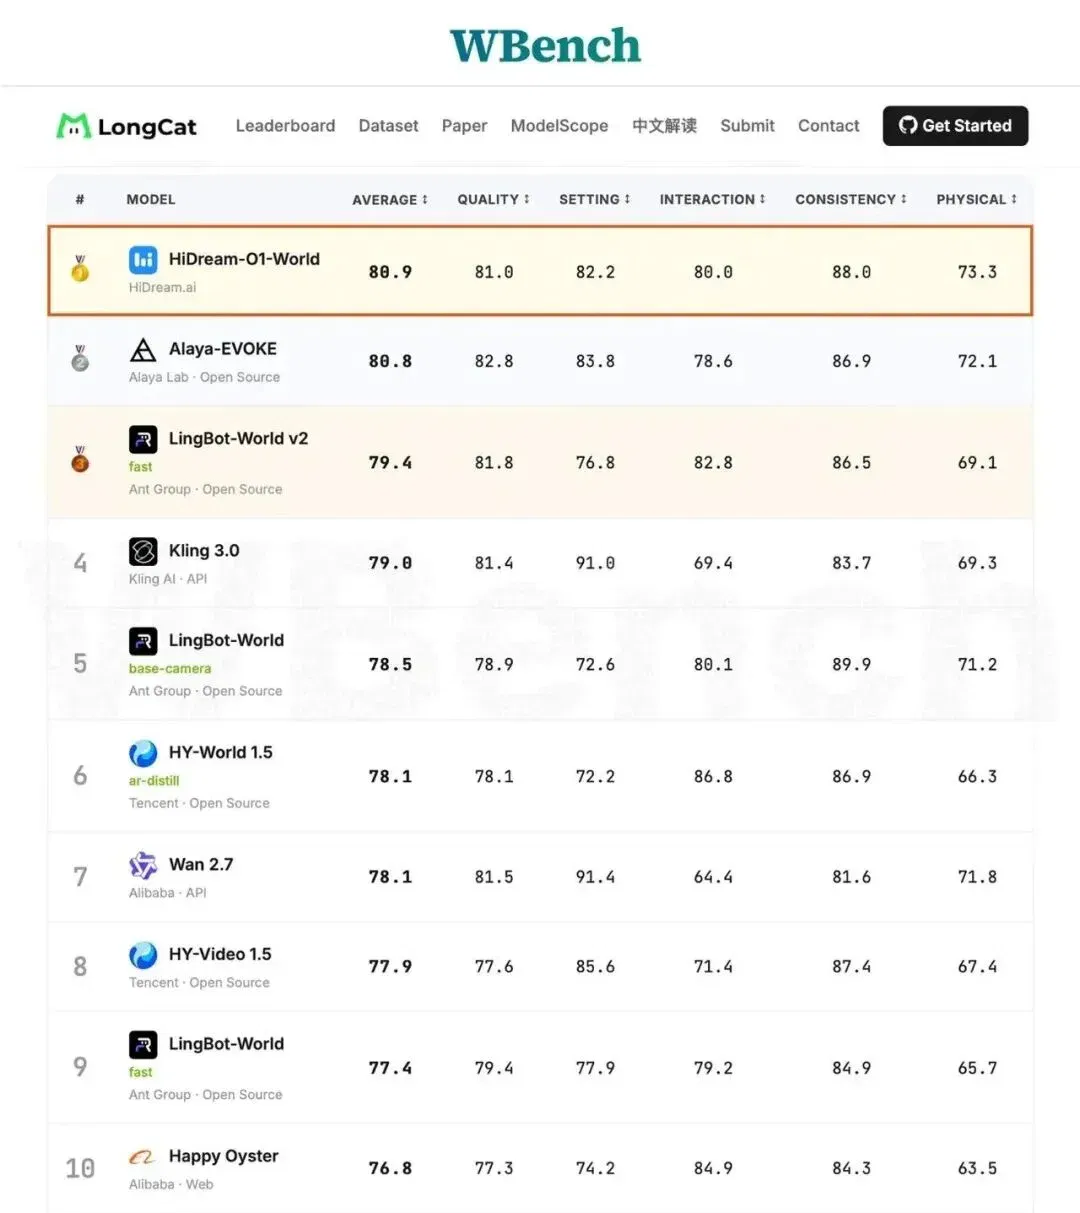
- 智象的图像模型 HiDream-O1-Image-1.5 在 Artificial Analysis 文生图榜单中取得中国第一、全球第三;
- 智象交互式世界模型 HiDream-O1-World 位列 WBench 综合榜第一;
-智象具身世界模型 HiDream-O1-Embodied 在 RoboColiseum 的扰动适应和空间推理子榜登顶。
加上 HD-V1 补上的视频能力,业内首个覆盖图像、视频、3D 交互与具身动作的原生全模态世界模型闭环,正式成型。
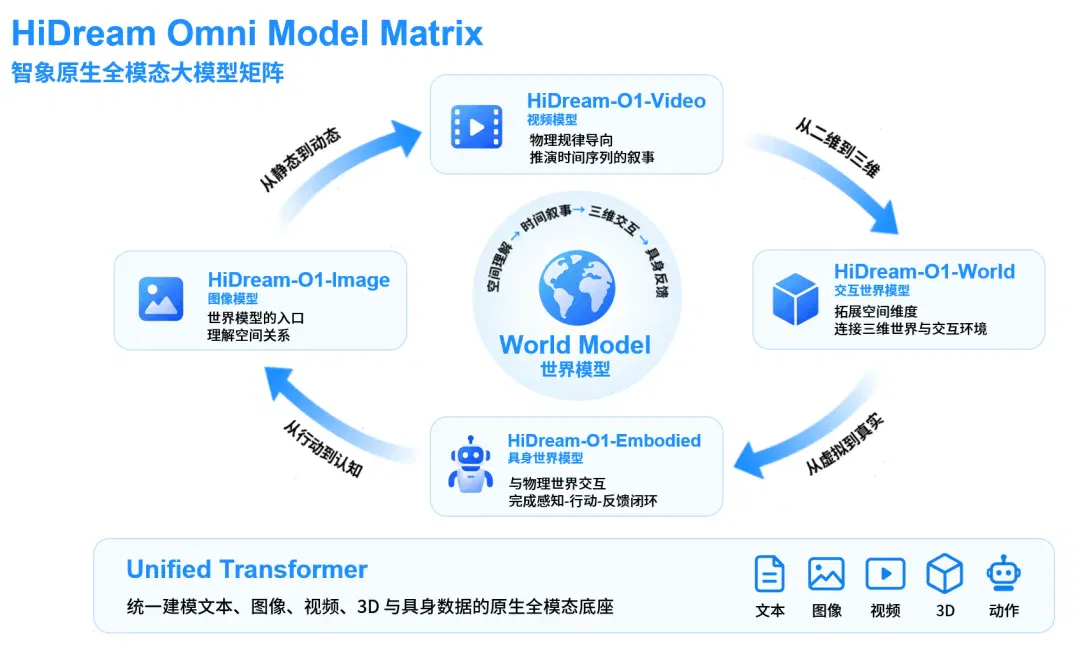
如何释放模型能力的上限呢?智象的另一条业务线,是把这些模型能力,做成人人都可以用的创作 Agent。
就在模型发布的一周前,智象旗下内容创作智能体 vivago R1 全球上线,国内版本 「够搭」全新升级发布(下文统称 R1)。
不同于需要自己搭工作流的画布式、节点式工具,R1 走的是 Chat-first(对话优先)创作路线:
一句话描述创意,Agent 自动完成故事、脚本、分镜、角色、镜头到成片的全流程。R1的对话式创作,不是把复杂消灭,而是把复杂藏在简单背后。
让创作者从灵感闪现到进入执行的过程更加丝滑。是业内首个主打稳定生成 3–5 分钟视频的对话式创作 Agent。
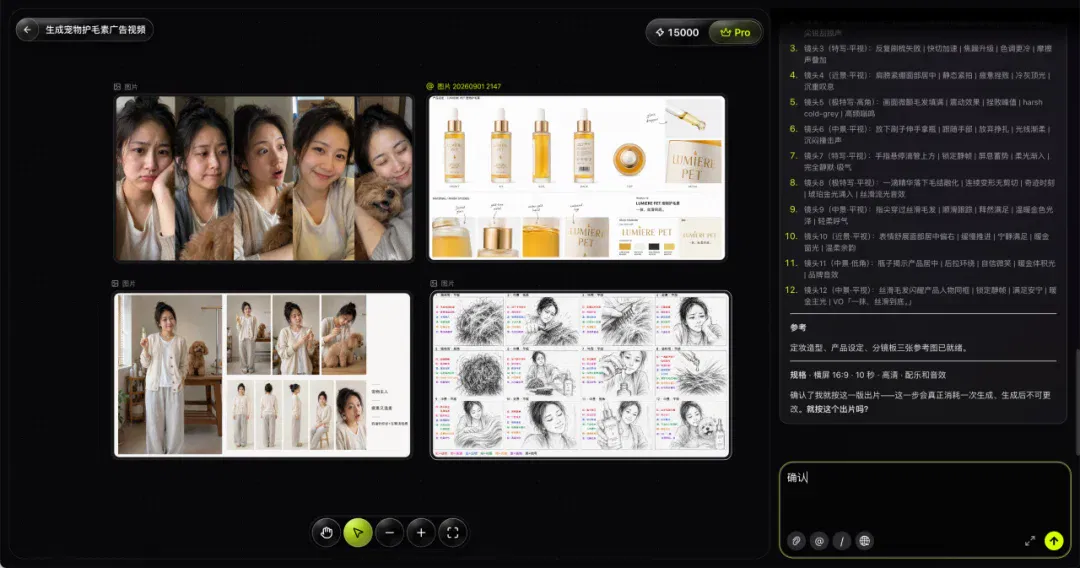
一边是 HiDream-O1 系列在探模型能力的上限,一边是 R1 把模型能力转化成人人可用的创作体验,这就是智象的「模型 + 智能体」双轮驱动战略:模型底座决定视频生成上限,Agent 保证用户能创作作品的下限。
放到行业格局里看,字节、MiniMax 与智象三家公司的视频模型Seedance、MiniMax H3 与 HD-V1,已一同进入国际榜单和真实产品体验的核心区:
它们在中国 AI 视频领域形成三足鼎立的格局,也在国际视频领域竞争格局里,各自具备稳定的全球竞争力。
与此同时,随着各家视频模型能力的逐渐趋同,下一阶段的胜负手,不再是单纯的模型比拼,而在于两件事:
谁能真正理解世界,谁又能把这份理解稳定地变成作品,交到每一个创作者手上。
目前 HiDream-O1-Video-1.0 处于内测阶段,vivago R1 正式全球上线。
文章来自于"特工宇宙",作者 "特工小花 特工小天"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
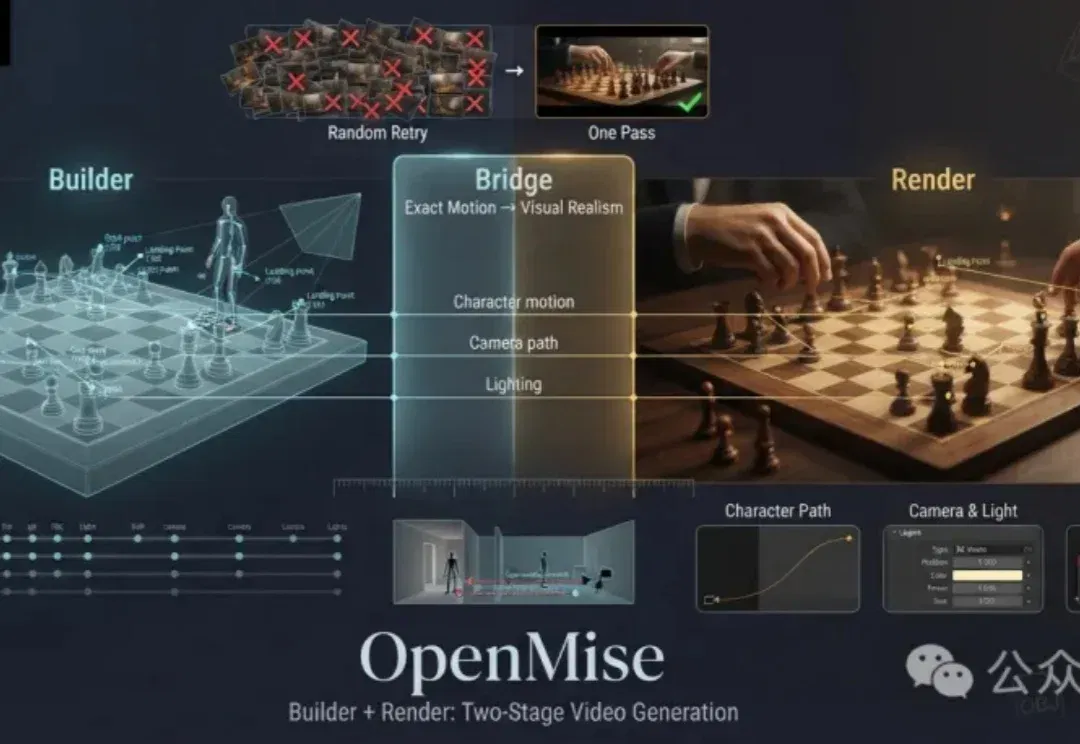
OpenMise 先用 Blender 编排三维草稿,再交给视频模型渲染 (opens in a new tab)
项目把场景、角色路径、摄影机和灯光放进同一时间轴,用可编辑的白模检查动作,再将草稿交给视频模型生成写实画面。
Genspark Media Studio 体验:从分镜、配乐到 AI 短剧返修 (opens in a new tab)
量子位通过拟人化音乐视频、知识讲解和剧情短片体验 Genspark Media Studio,观察多模型调度、角色设定、局部重拍与工程导出。流程整合降低了工具切换成本,但审核操作、音画同步、画面穿帮和积分消耗仍影响成片体验,用户仍需要判断与返修。
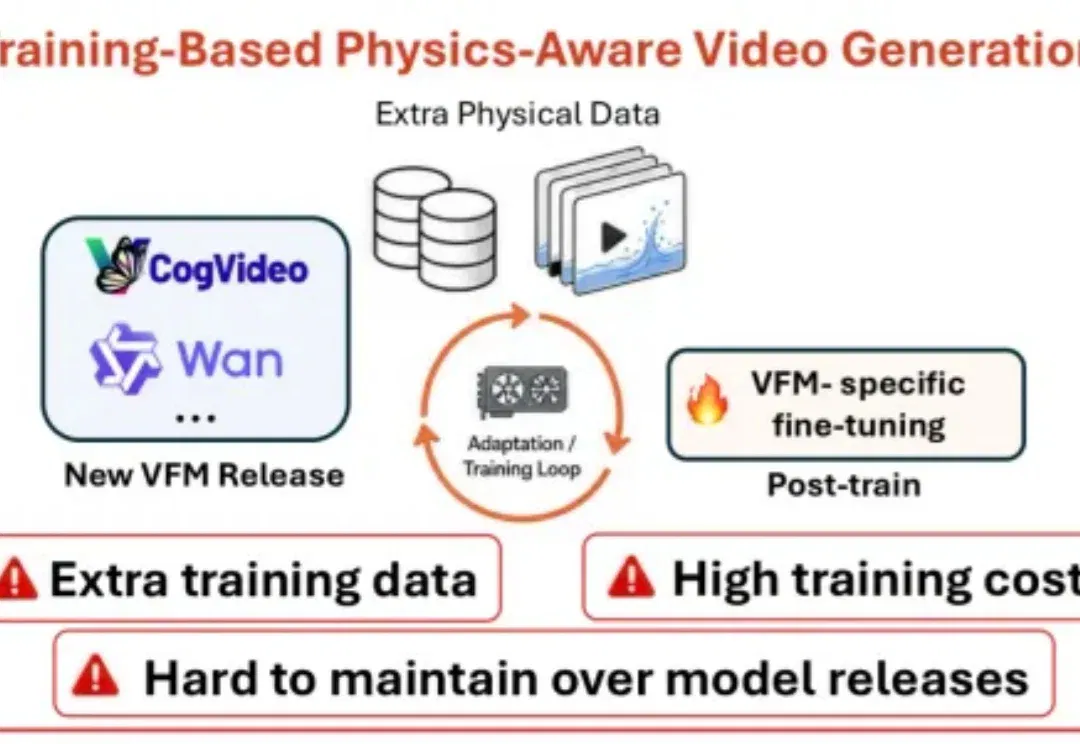
Fluid-Gen-Zero:不改模型权重,用物理仿真引导流体视频生成 (opens in a new tab)
Fluid-Gen-Zero 把运动轨迹交给物理模拟器,把外观生成交给预训练视频模型,并通过事件规划与区域引导连接两者。研究在流体交互场景中测试了这条无需更新模型权重的路线,但效果仍依赖场景重建、仿真质量和具体生成设置。
视频生成也能代码驱动了,Code Video Model来了 (opens in a new tab)
视频生成模型的视觉质量不断提升,但当前主流视频扩散模型仍面临两项根本局限。第一是物理规律约束不足:模型从像素中学习世界的视觉表象,却缺少物理方程的显式约束,画面看似合理,实际却不符合物理规律。
少步视频生成不再牺牲画质!双重分布匹配方案实现又快又好 (opens in a new tab)
在视频生成领域,少步视频模型已经实现只需少量采样步骤,就能生成连续画面。