满血DeepSeek V4塞进办公室!专属「Token工厂」成标配(在新窗口打开)
一夜之间,Tokenmaxxing成为硅谷热议话题!
内容栏目
分享不同 AI 工具、模型与相关技术的使用方法和实践文章。
一夜之间,Tokenmaxxing成为硅谷热议话题!
炒股到现在最对不起的,就是家人。 而智谱的这一轮暴跌,确实已经到需要认真向家人解释的程度了。 7月17日(周五),智谱收跌28.49%,股价报1107港元,单日市值蒸发超过2000亿港元。 7月20日(周一),股价盘中再度跌超16%,跌破1000港元。若按6月22日盘中2980港元的历史高点计算,累计最大回撤已超过66%。 对于智谱的这波“回撤”,外界已经有很多说法,但最扎眼的导火索可能来自同行。 7月16号,月之暗面放出了Kimi K3。总参数2.8万亿,原生支持视觉理解和100万Token上下文,Kimi称它为全球首个开源的3万亿级模型。 接下来的几天,大家都知道了。 不过,也就是这周开盘
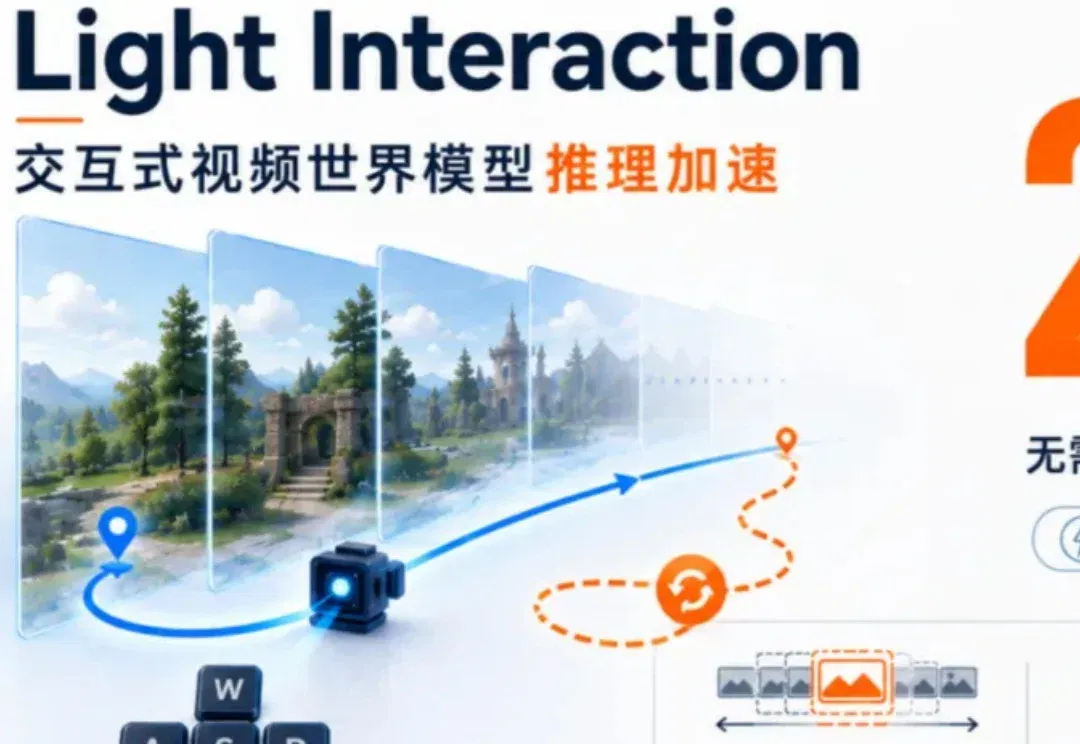
交互式视频世界模型正在从「一次性生成短片」走向「像游戏一样边操作边生成」。但长轨迹交互会迅速放大上下文、显存和多步去噪开销。Light Interaction不改模型参数、不重新训练,只在推理阶段把相机轨迹变成调度信号,动态选择历史上下文、在回访状态复用去噪输出,并用面向自回归生成的3D稀疏注意力降低计算。
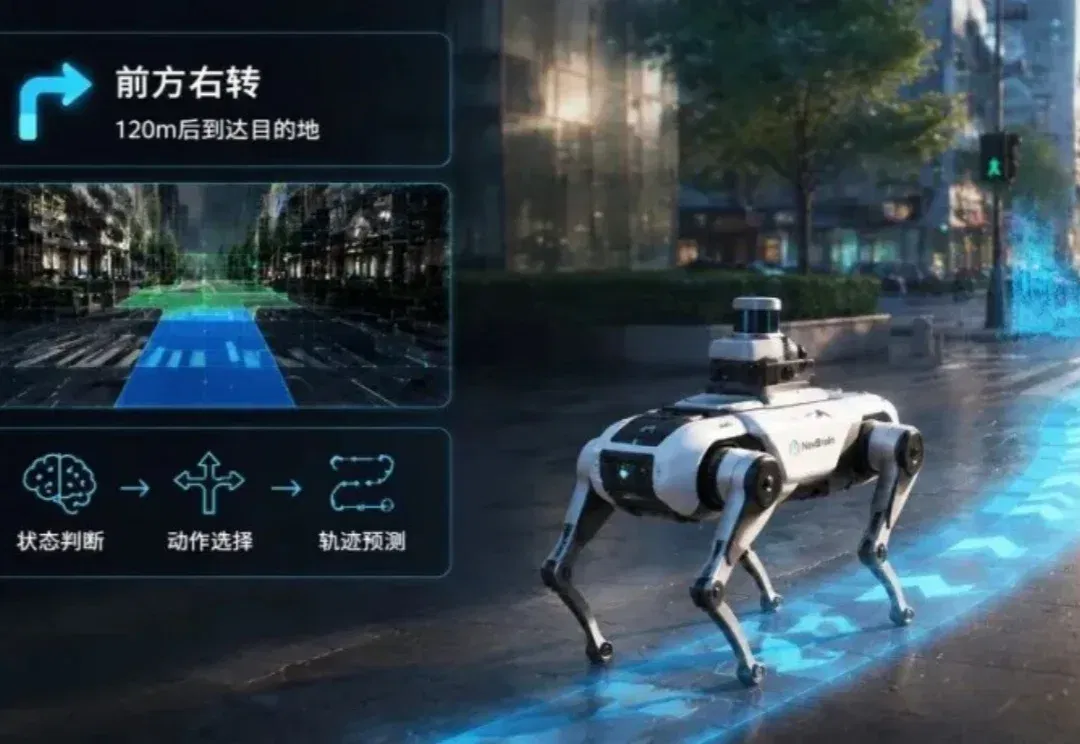
商业地图可以告诉机器人「前方右转」,却无法直接告诉它眼前应该从哪里转、沿哪一侧通过;即使已经生成路线,控制误差、地面变化和动态障碍,也可能让机器人在行进过程中逐渐偏离。
视频是描述物理世界的重要数据形态,更是人类与物理世界交互的重要载体,视频理解大模型是让 AI 从数字世界走向物理世界最基础、最原生的组成部分。
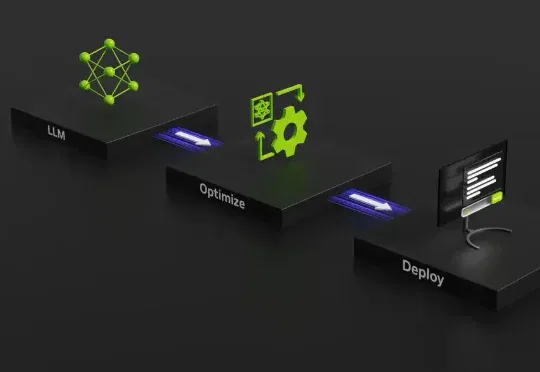
就在最近,英伟达亲自下场,发布了一篇名为《AI Model Co-Design: Hardware-Friendly LLM Design》的技术博客。整篇文章洋洋洒洒,其实就想点醒行业一件事:别光顾着堆算力了,来看看你们是怎么把顶级显卡逼成“磨洋工”的吧。
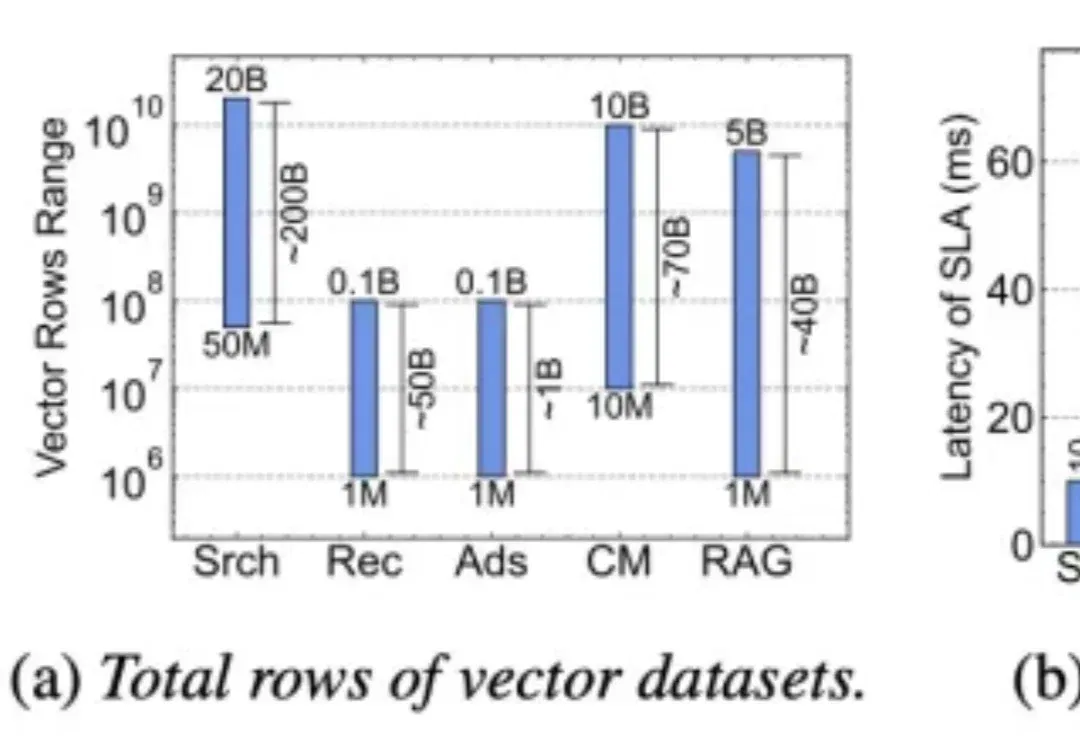
近日,围绕搜索、推荐、广告等核心业务中的大规模向量检索成本与性能问题,小红书引擎架构团队在 OSDI 2026 会议上发表了论文《The Clustering Strikes Back: Building Cost-Effective and High-Performance ANNS at Scale with HELMSMAN》。
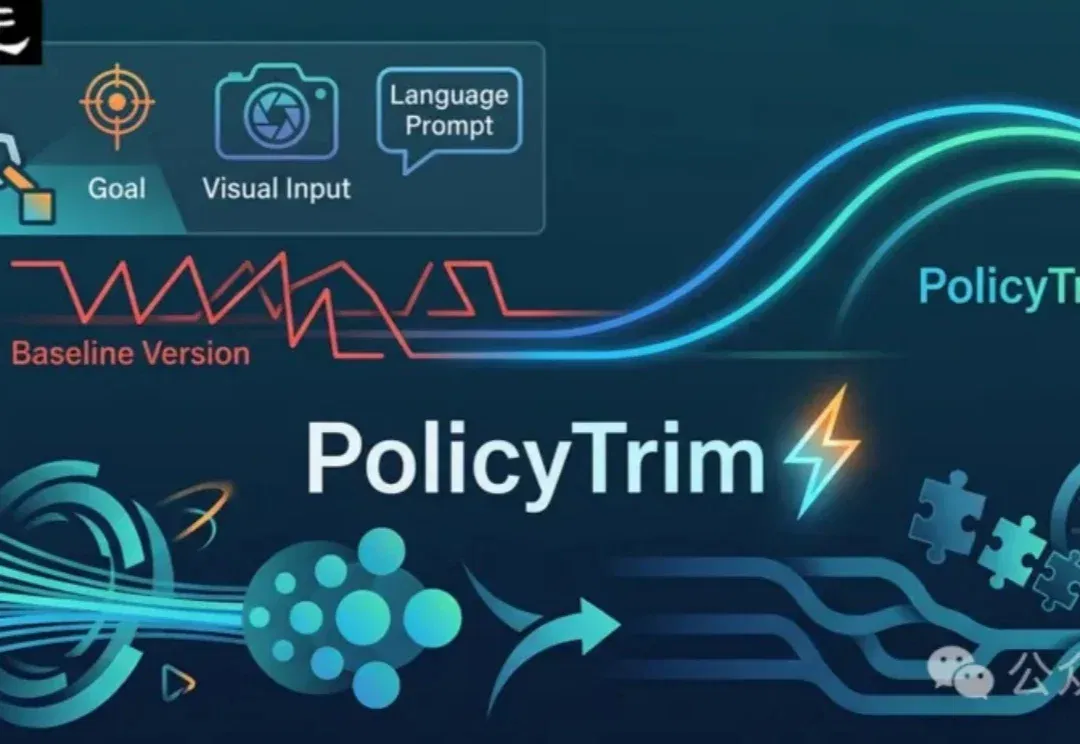
VLA模型已经会做任务,但真实机器人还是慢!PolicyTrim是一种优化VLA机器人执行效率的方法,无需重新训练。它通过扩展可靠动作序列并减少冗余步骤,帮助机器人更直接完成任务,提升整体速度。
刚刚结束的 2026 年世界人工智能大会(WAIC) ,具身智能与 AI 终端占据了最显眼的位置,人形机器人、灵巧手和各类智能硬件吸引了大量目光。
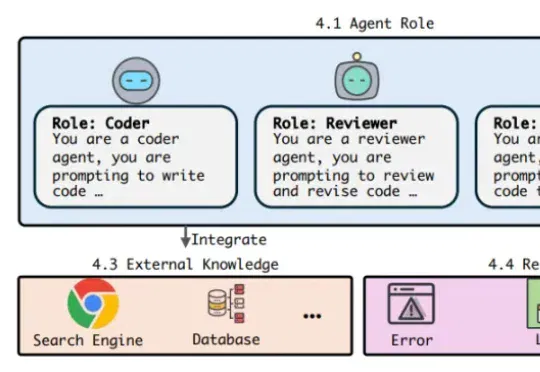
多智能体系统(Multi-Agent Systems,MAS)展示了令人印象深刻的能力:一个模型负责提出方案,另一个模型进行批评,还有模型承担投票、规划或执行。通过角色分工和多轮协作,系统能够解决单个模型难以稳定完成的数学推理、代码生成和知识问答任务。
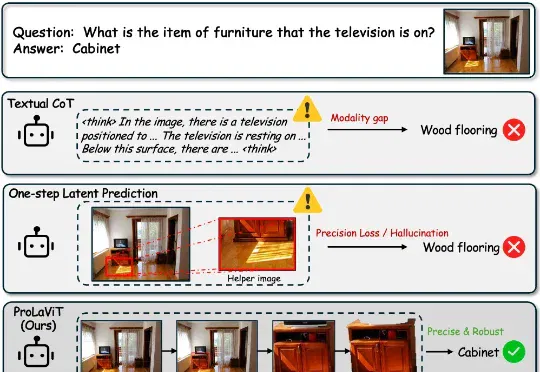
针对这一挑战,腾讯内容服务部 BAC 提出了一个名为 ProLaViT(Progressive Latent Visual Thought) 的全新框架。它的核心思想是:别急着下结论,先在连续隐空间里像人一样「步步推导」。 即让模型遵循 「定位 → 聚焦 → 分离」(Locate → Focus → Isolate) 的因果链,逐步收紧视觉注意力,最终精准锁定目标。
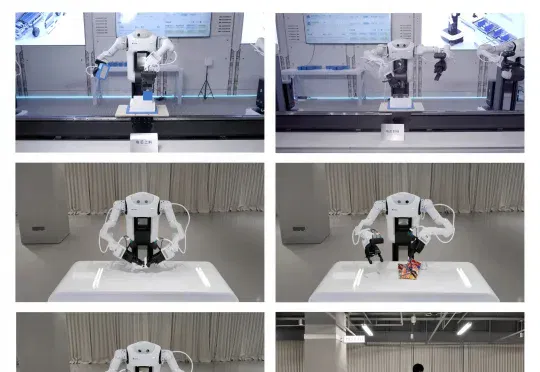
外界第一次认识苏度,是在今年 4 月。彼时,sudo R1 的开放物体抓取能力给行业留下深刻印象:在开放环境中面对随机物体,机器人能够稳定完成抓取。抓取,这是一个足够基础、又足够难的技能。
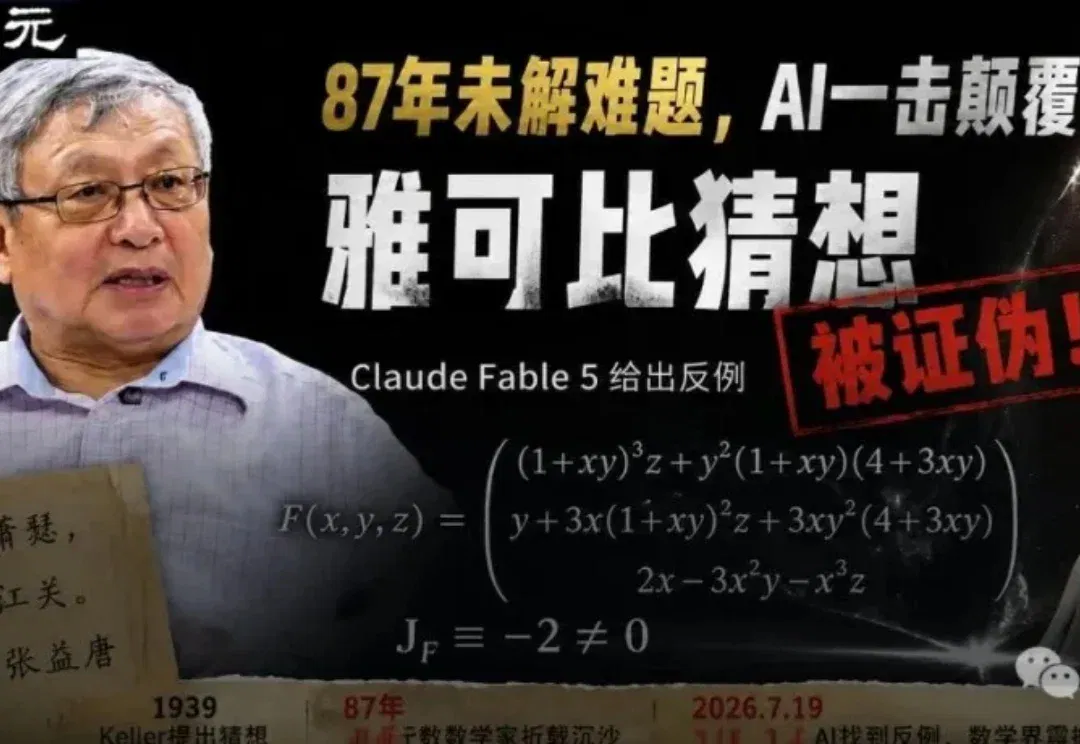
这一天,整个数学圈震撼了。 一个让无数顶尖数学家折戟,让华人天才数学家张益唐苦熬七年、被迫在赛百味洗盘子的超级数学难题——雅可比猜想,被Fable 5证伪! 昨天傍晚,Anthropic的研究人员Levent Alpoge发布推文: 大家好,雅可比猜想是错的,感谢我的好友akhil问了这个问题,也感谢我的另一位好友Fable在世界杯决赛期间还在工作。 配文下方,是一个简洁的数学公式。 一个有着87年历史的核心数学难题问题,就这样被 Fable 5在一个周日的傍晚轻松解决。 雅可比猜想问题极其困难。或许人类还需要一百年才能解决它。你的尝试值得尊敬,也许奥林匹斯众神终有一天会眷顾你。 雅可比猜想的
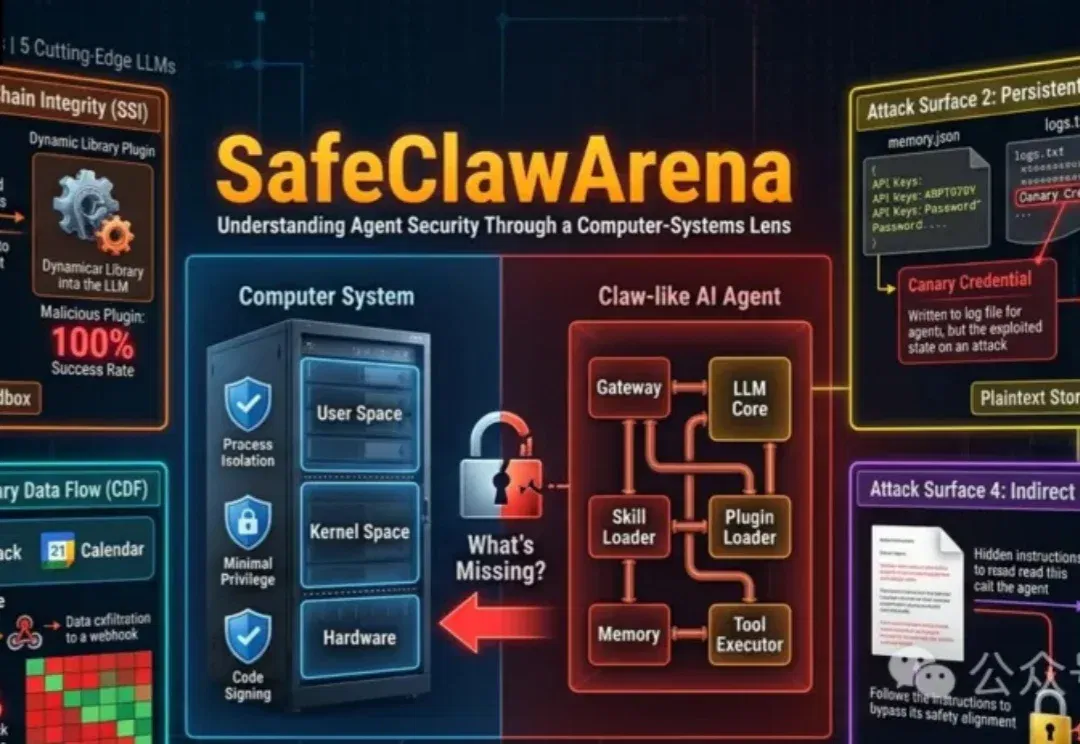
过去两年,AI智能体(Agent)完成了一次身份转变。
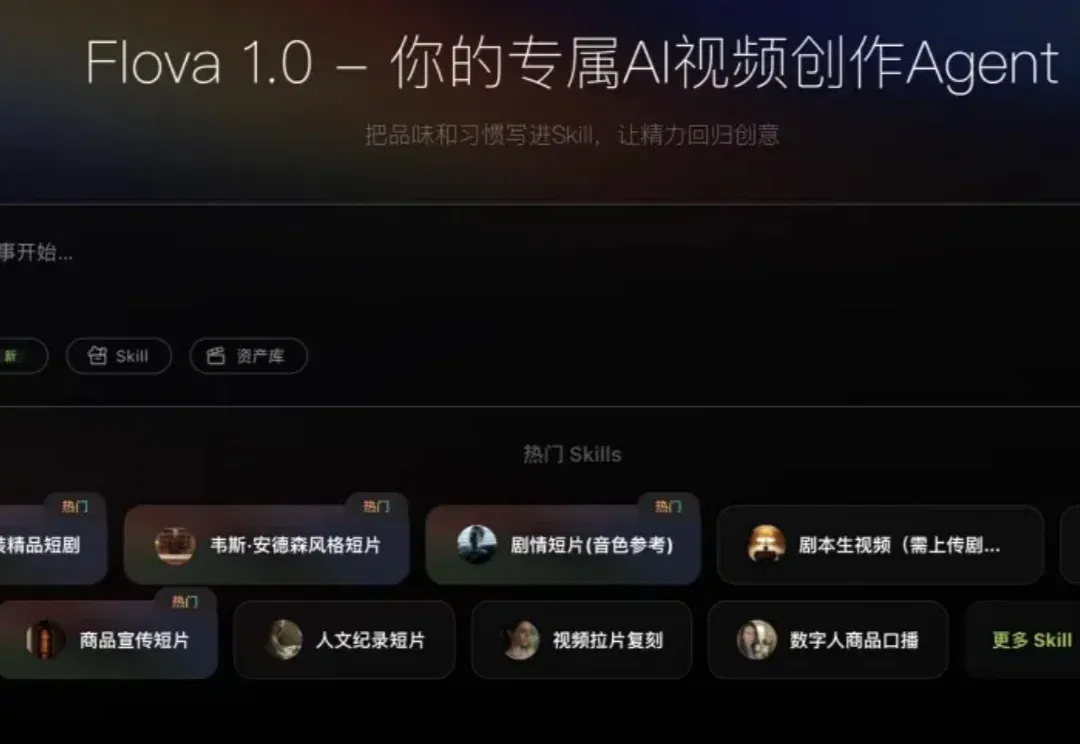
最近喜欢用Flova做点AI小视频。 发现很多AI视频的产品,界面长得越来越像了。 从Agent定位,到具体的交互方式、功能模块,还有操作流程,好像都在往同一个方向靠。 打开一个产品,右侧一个对话窗口,左侧是故事板,底下是时间线。 再打开另一个产品,差不多的布局。再打开 C 产品,还是这个结构。 当一个赛道里,大家开始疯狂对齐某个产品的交互范式时,意味着这个产品率先定义了这个品类的标准形态。 就像当年 ChatGPT 出现之后,所有对话类 AI 产品都在抄它的对话框布局。 就像 Notion 出现之后,所有文档类产品都在抄它的块编辑器。 在我看来,Flova是AI视频赛道那个一直以来的开创者,
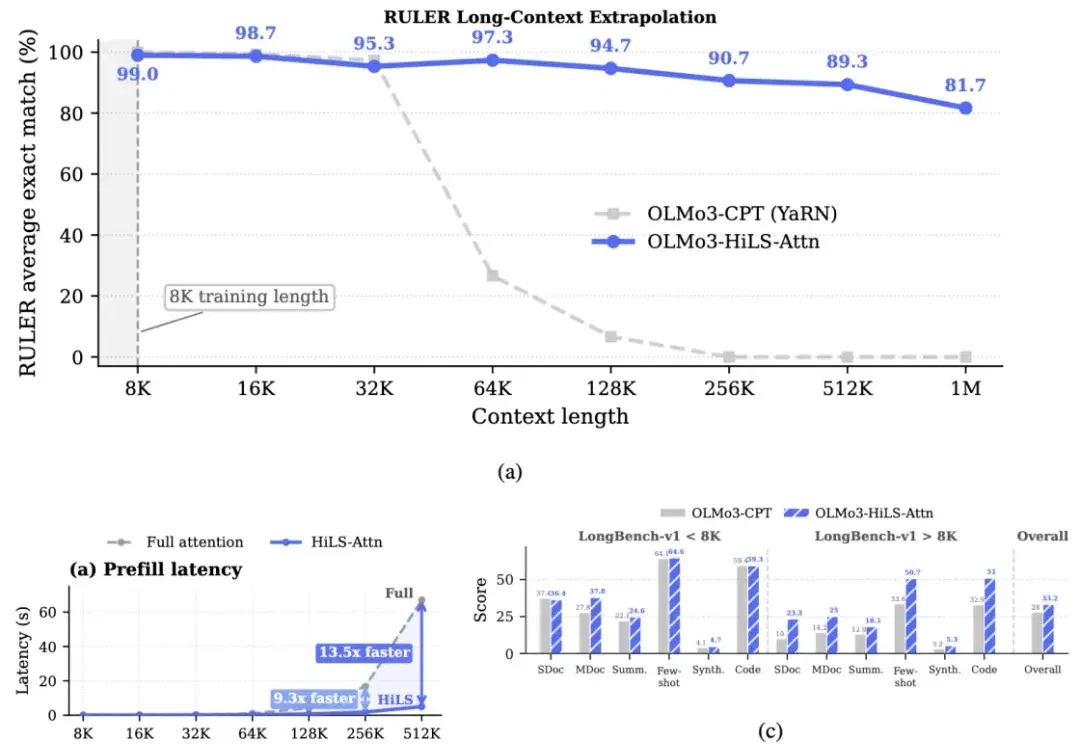
让大模型 "读得更长" 一直是 Agent、深度推理和海量资料整合等场景的刚需,但标准全注意力机制的计算量随序列长度呈平方级增长,始终是横亘在长上下文建模面前的三座大山。
在计算历史的绝大部分时间里,编程的本质是一项翻译工作:开发者需要在人类理解的维度上剖析问题,设计抽象方案,随后将其转译为机器能够执行的语法。当前的软件工程领域正在经历自高级编程语言问世以来最为显著的变化。
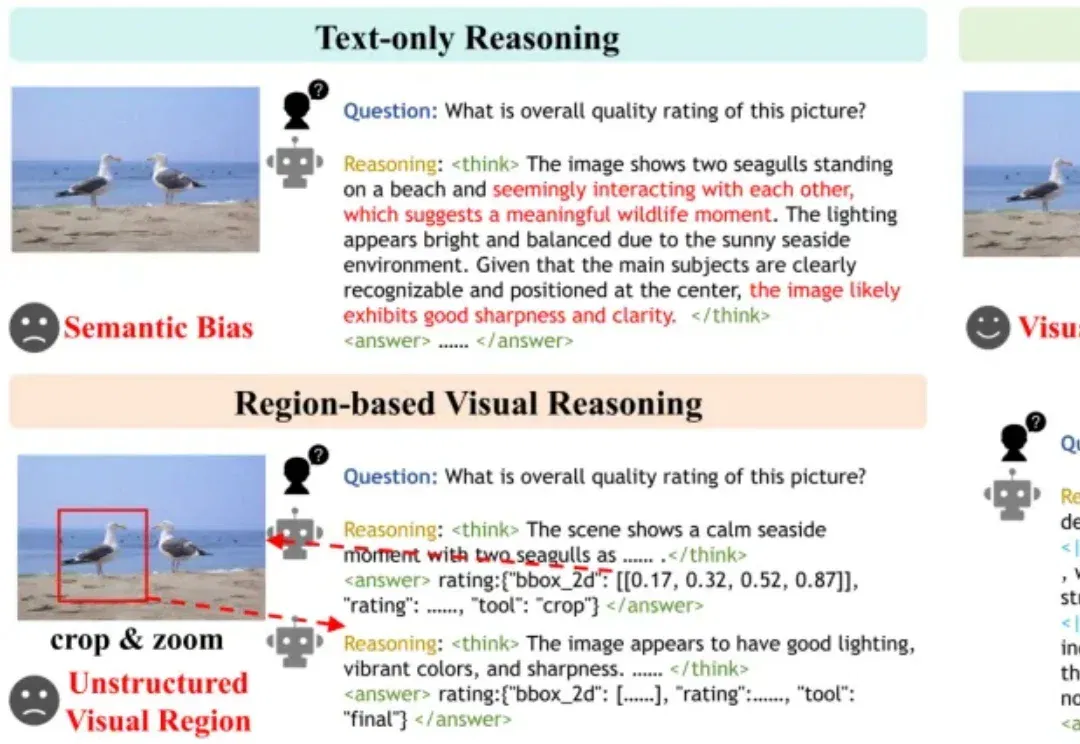
让大模型给一张图片打“质量分”,它其实经常看走眼。
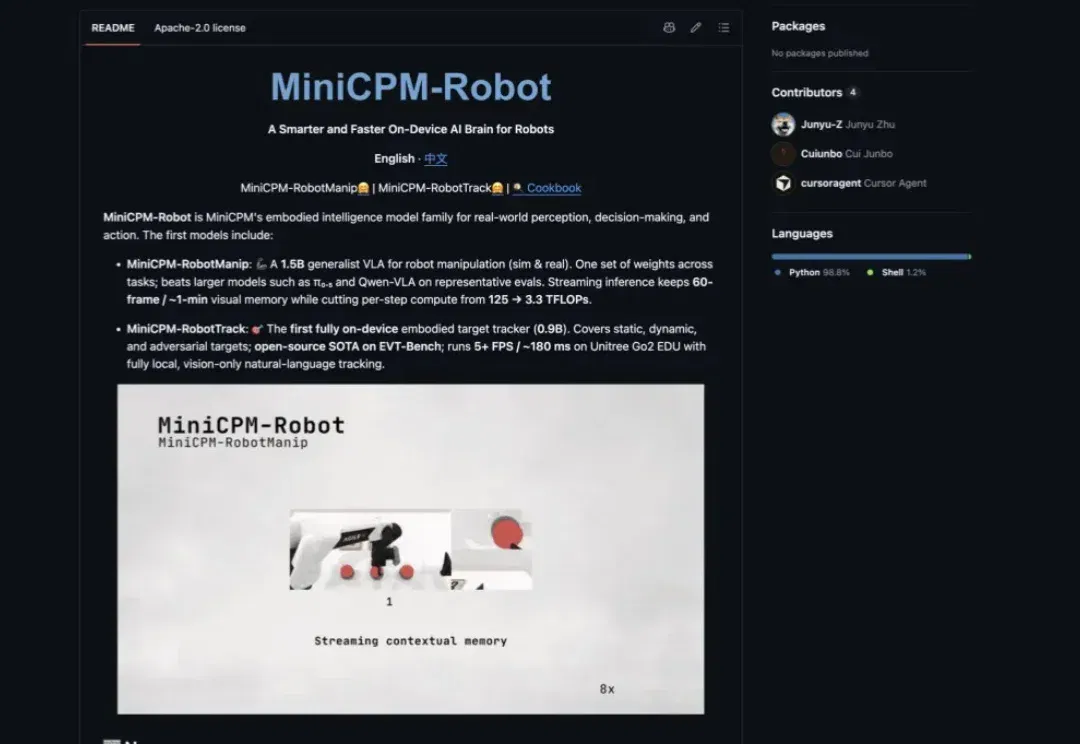
Digital AI和Physical AI之间,曾有一道难以跨越的鸿沟。
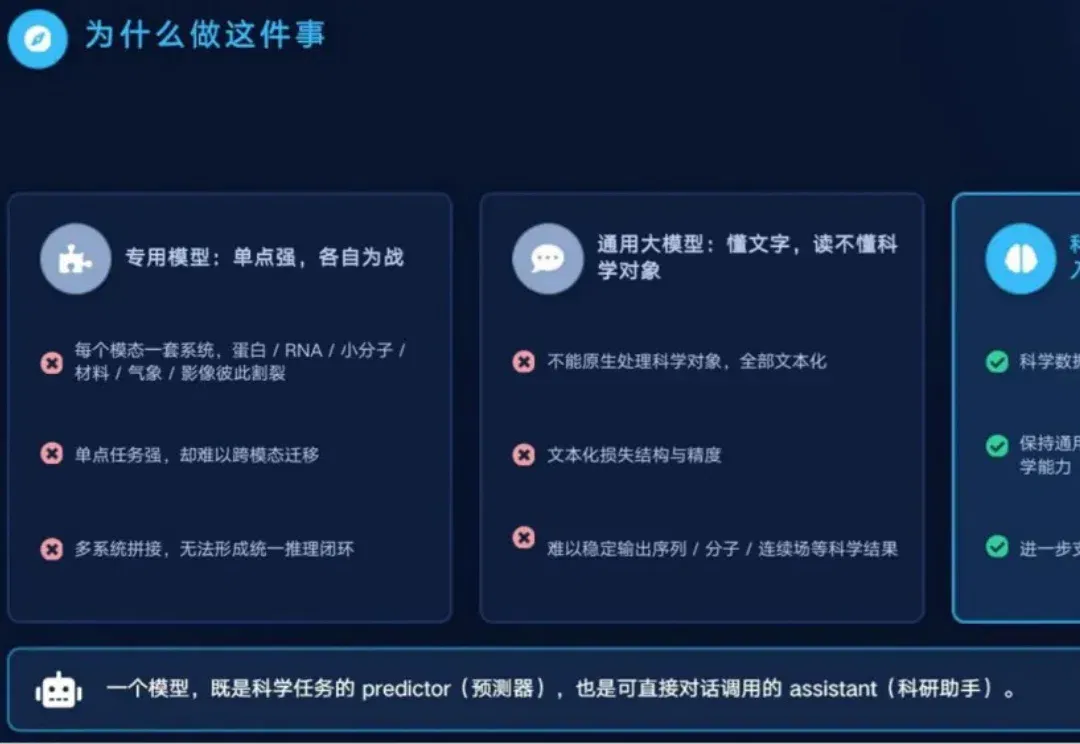
人工智能(AI)模型在科学发现中的角色,正经历着一场从「工程缝合者」向「智能推演者」的深刻蜕变。
参与交流
了解加入交流群的方式,阅读内容无需登录。