换题还是第一!DM0.5横扫RoboColiseum四榜
具身智能最近又多了一张榜单,而排在第一的,还是一个熟悉的名字:原力灵机 DM0.5。
具身智能最近又多了一张榜单,而排在第一的,还是一个熟悉的名字:原力灵机 DM0.5。
RoboColiseum是智元机器人发起的一套具身模型评测,专门从四件事上折腾机器人:指令跟随、空间理解、扰动适应和通用操作。你可以简单理解成:听不听得懂、看不看得明白、环境变了会不会乱,以及最后到底能不能干活。DM0.5 这次的结果很直接:四张榜,四个第一。它也因此成了目前 RoboColiseum 里唯一一个所有评测都排第一的模型。
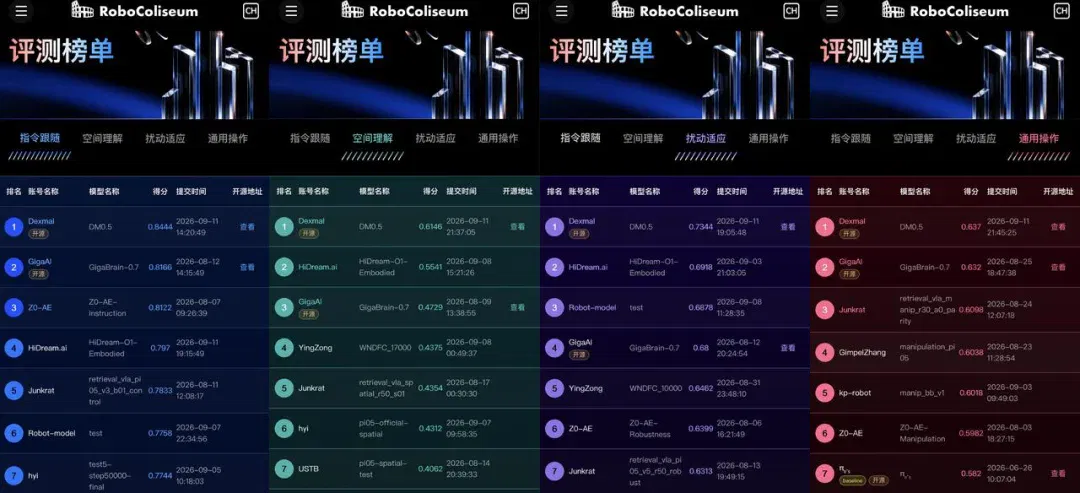
更值得注意的是,两周前它刚拿下 RoboDojo。再往前看,LIBERO、RoboTwin 2.0、VLA-Arena、RoboChallenge Table30 V2…… 到现在,DM0.5 已经把自己公开参与的六套评测,全跑到了第一。但比又多一个第一更值得注意的是,这六套评测考的根本不是一回事。甚至距离上次站到榜首,还不到半个月。
题目一直在换,第一名没怎么换
LIBERO 看通用操作;RoboTwin 2.0 更强调复杂场景下的任务执行;VLA-Arena 把难度一层层往上加;RoboChallenge Table30 V2 直接上真机,而且一次面对 ARX5、UR5、ALOHA、Dexmal-Mirror 四种异构本体和 30 个复杂任务;两周前的 RoboDojo,则专门盯着泛化、记忆、精细操作、长程执行和开放语义理解;这次 RoboColiseum,又把指令、空间、扰动和通用操作重新拆开来考。
换句话说,这不是一套题反复刷。是题型一直在变。 但 DM0.5 到目前为止,没怎么换位置。在 LIBERO 上,综合成功率 99.0%;RoboTwin 2.0 简单和复杂场景分别是 93.6% 和 93.3%;VLA-Arena 三档难度下分别做到 89.0%、53.6% 和 44.1%。到了真机的 RoboChallenge Table30 V2,DM0.5 以 43.0% 整体成功率、54.42 综合得分位列第一。RoboDojo 里最夸张的是 Memory。DM0.5 在这个维度拿到 47.74 分、47.44% 成功率,第二名只有 13.37 分和 12.11%。
这也是为什么,比起强调 “第六个第一”,更值得看的其实是另一件事:DM0.5 展现出来的,不是某一项能力特别突出,而是比较完整的能力覆盖。具身智能过去很容易出现 “Demo 很强,换题就掉” 的情况。一个模型可以特别会抓杯子,也可以特别会叠衣服,甚至能在某套 Benchmark 上刷出非常漂亮的成绩。但你一旦换环境、换任务、换机器人本体,它可能立刻变成另一个什么也不会的模型。真正难的,从来不是把一道题做对,而是换题之后还能继续做对。现在这些不同榜单,本质上就是从不同方向给模型找短板。而 DM0.5 到目前为止,几套不同类型的考试都接住了。
现实世界根本不会按 Benchmark 出题
当然,Benchmark 再多,最后还是得回到真机。因为真实世界比排行榜更烦。它不会等你准备好,也不会保证每次输入都长得差不多:相机会突然被动、物体会被人挪走、零件会卡住、柔性物体会变形、传送带更不会因为机器人没想明白就停下来,而这些,恰恰是具身模型真正进入现实环境后必须处理的问题。
比如,相机视角突然变化。在 DM0.5 的真机演示里,即便外部视点发生明显变化,机器人仍然可以根据新的观测继续完成原来的任务。
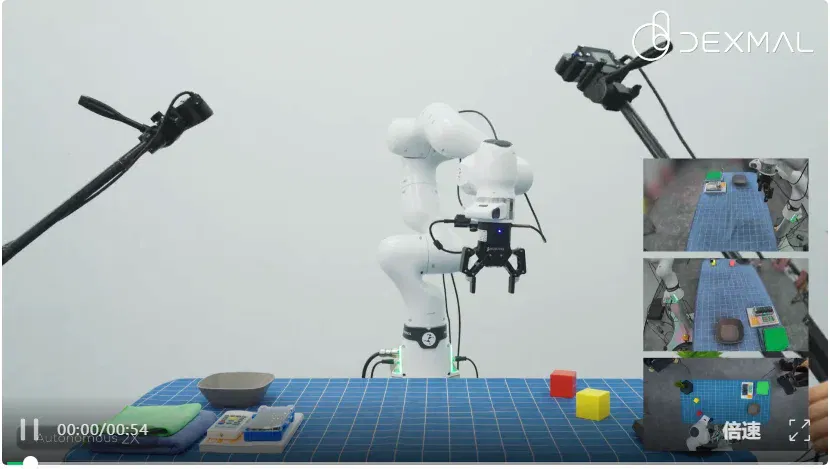
再比如,人直接伸手打断它。目标被移动、动作被中断以后,机器人不会机械地沿着原轨迹继续做,而是重新理解当前状态,再修正后续动作。这些变化看起来很小,却很容易让机器人偏离原来的执行轨迹。因为真实工厂和实验室最大的区别,不是设备更多,而是意外更多。
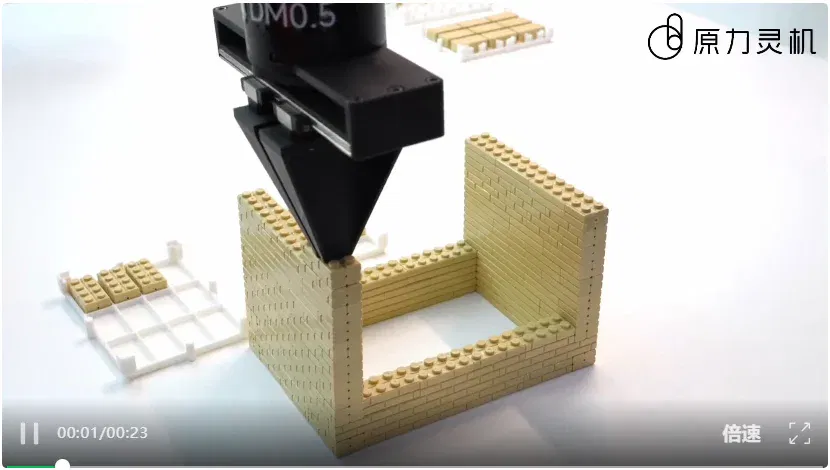
然后是精细操作。DM0.5 做过一个微型积木拼装 Demo,最小组件宽度不到 1 厘米,抓取和扣合需要控制在 0.1—1 毫米尺度内。这件事情的难点在于,积木不是 “压下去” 就算完。因为工艺公差,直接硬压很容易错位卡死。机器人需要先对准,再通过很细的震动和下压力完成扣合。如果真的接歪了,它还得自己发现失败,再重新调整机械臂姿态、重新抓取、重新装配。
以下视频来源于Dexmal 原力灵机
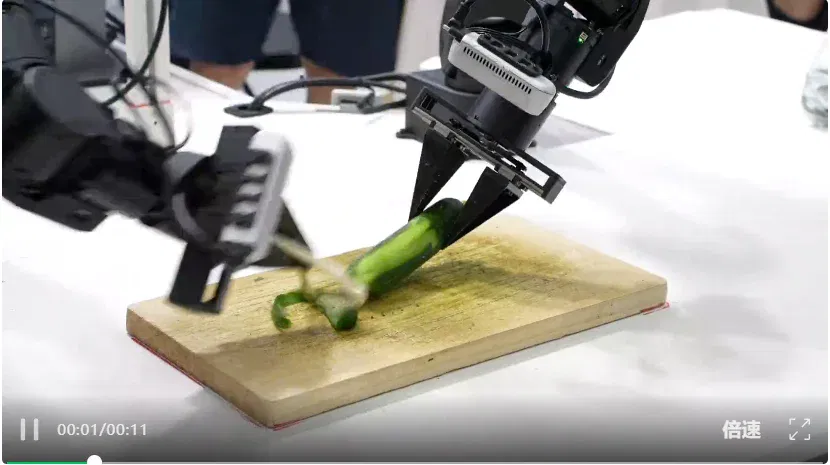
另一个 Demo 是削黄瓜。这类任务比积木更难控制,因为黄瓜是柔性的:力大了,直接切坏;力小了,切不动;表面形状还在变化。DM0.5 会通过关节电机电流值实时感知作用力大小,在接触过程中持续调整。搭载高自由度灵巧手的人形机器人经过针对性后训练后,还可以控制 58 个自由度完成长程厨房操作。
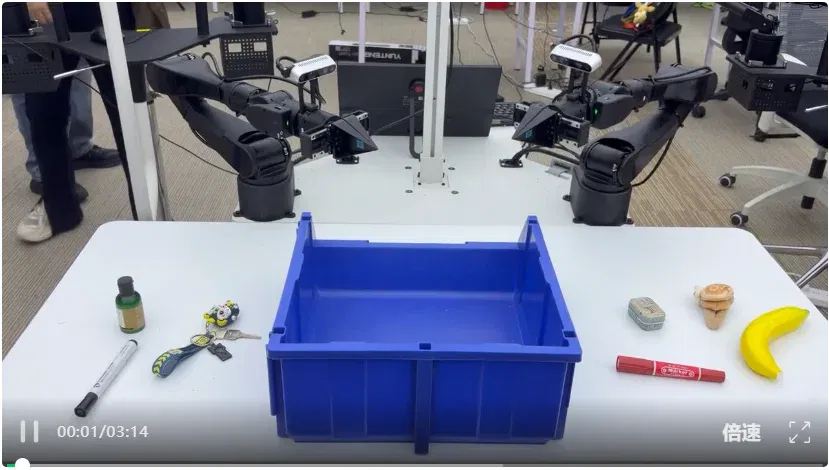
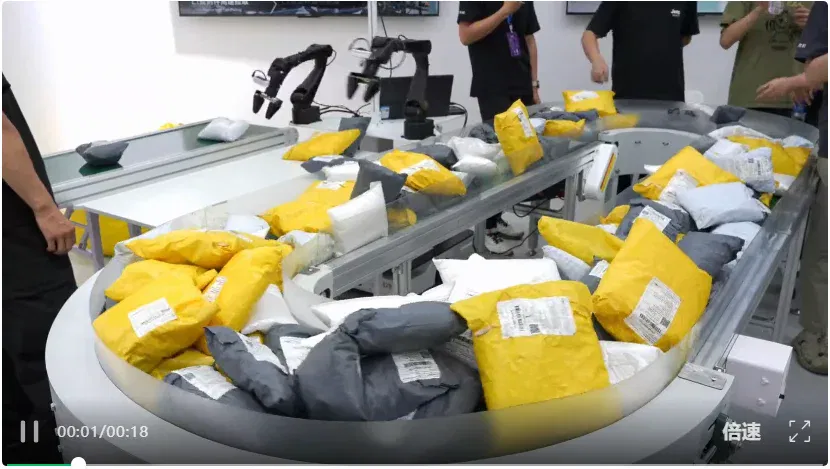
最后看物流,这里甚至没有 “慢慢想” 的机会。传送带不停,包裹尺寸、材质和姿态一直变,机器人只有几秒钟时间完成识别和动作。在实际演示中,DM0.5 不依赖预设脚本,而是靠实时视觉识别和决策,平均约 3 秒一单,准确率超过 99%。
以下视频来源于Dexmal 原力灵机
把这些 Demo 放到一起,会发现它们其实和前面的六套 Benchmark 在解答同一个问题:换了情况以后,模型还能不能继续做?只不过现实世界出的题,比 Benchmark 更复杂,也更不可控。
那问题来了:换了一套题,为什么 DM0.5 不用从头学?
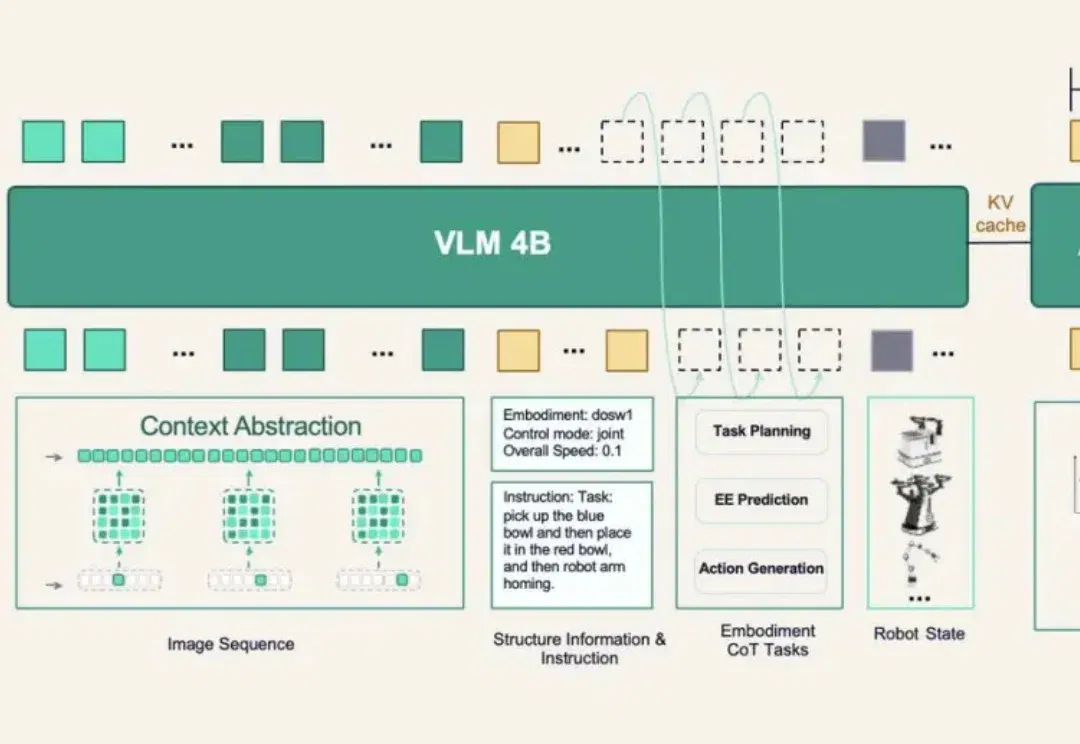
这次 RoboColiseum 有个细节挺值得看。DM0.5 并没有针对四张榜单分别重新设计一套复杂方法,而只是通过常规监督微调,把已有能力迁移到新的机器人构型和任务上。换句话说,这次成绩更多依赖的,是预训练阶段已经形成的能力。从架构上看,DM0.5 并不只是在学习 “看到这个画面,下一步机械臂该怎么动”。它一边持续压缩和保留历史视觉信息,一边把任务指令、机器人状态和任务进度一起纳入判断,再由动作模块生成最终控制信号。简单来说,它想学的不只是 “怎么动”,还有 “现在发生了什么、做到哪一步、接下来该做什么”。这也是为什么,在换任务、换场景之后,模型仍然有机会把预训练阶段学到的能力迁过去,而不是每换一道题就重新学一遍。
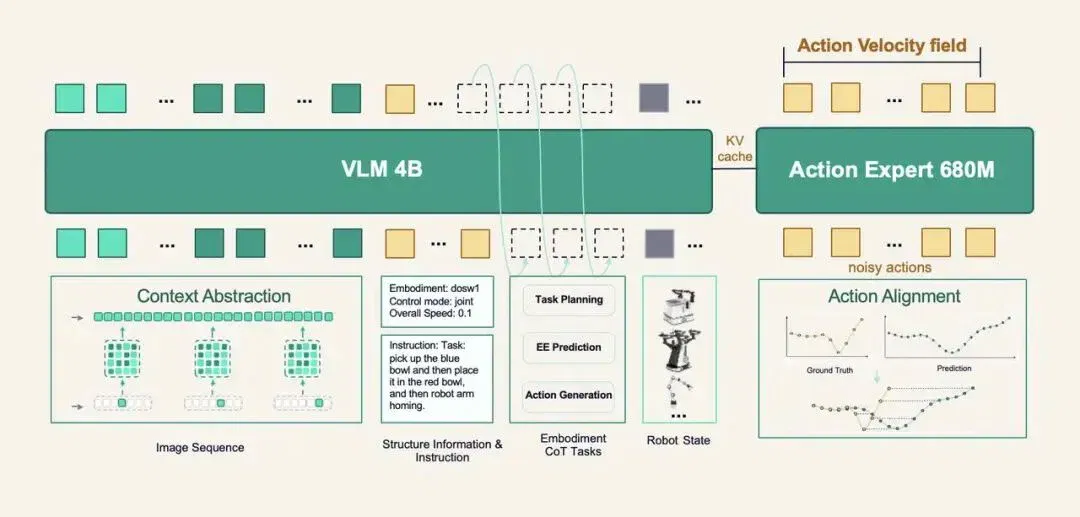
DM0.5 模型架构:历史视觉信息、任务指令与机器人状态共同进入模型,经过具身任务理解后生成机器人动作。
其中一个比较直接的例子就是记忆。DM0.5 原生支持最长 60 秒的历史信息,可以把之前发生过的观测和动作继续带进当前决策,而不是每一步都只看眼前。这个设计,也和它在 RoboDojo Memory 维度上的表现形成了呼应。再往下,是数据。它的预训练数据覆盖导航、抓取和全身控制,以及六类机器人本体,包括 5 万小时真机高精度操作、10 万小时第一视角场景视频和 100 万平方米空间重建数据。
最后还有一个很现实的问题:模型得足够快。DM0.5 此前把核心推理延迟从 534.04ms 压到了 57.49ms,在基本保持精度的情况下实现 9.29 倍加速。对机器人来说,这不是单纯的性能优化。它要在真实世界里持续感知、判断、动作,慢半拍,结果可能就是另一回事。
六套题以后,下一张成绩单不在榜单上
不过,对具身智能来说,Benchmark 最后还是 Benchmark。真正更难的考试,是生产环境。
目前,DM0.5 已经全面开源,模型权重、训练框架,以及 LIBERO、RoboTwin2、SO101 等多个下游任务工作流已经陆续开放,也已经向 LeRobot 社区提交核心代码。同时,它也已经开始进入实际场景。在某大型国际零售商仓储中,多台搭载 DM0.5 的机器人正在和其他类型机器人协同完成商品搬运与分拣。
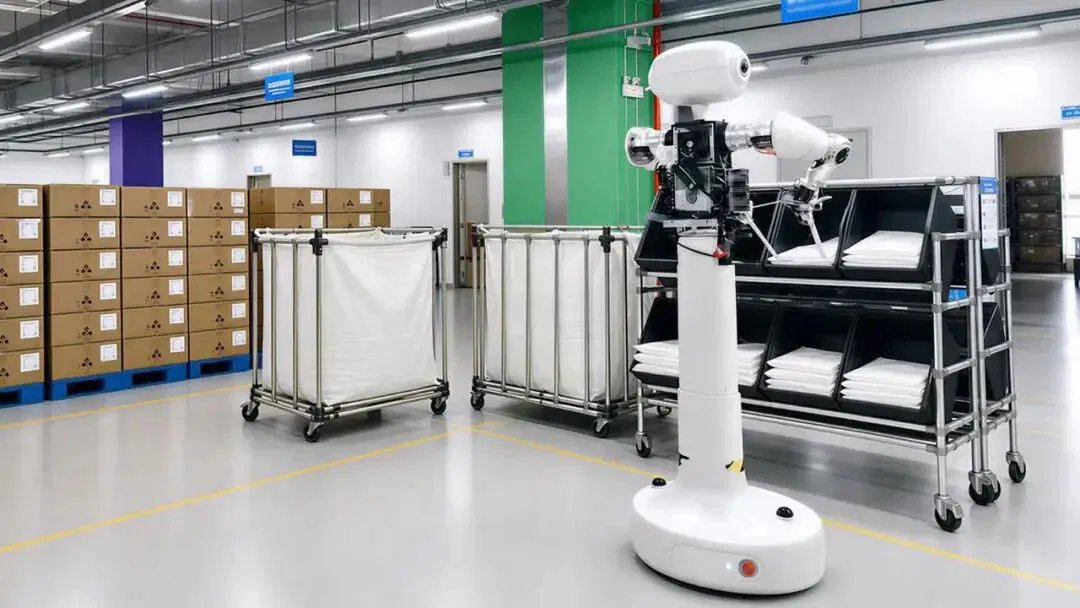
在某大型 3C 制造商工厂中,搭载 DM0.5 的机器人正在参与包装和废料回收。
今天的具身模型评测,其实正在发生一个挺明显的变化。大家已经越来越不满足于问 “这个动作做得多好”,而是在不断换任务、换场景、换本体、加干扰,看模型的能力能不能在变化中保持住。对所谓 “通用具身模型” 来说,这反而是一场更接近真实需求的考试。题型一直在变,DM0.5 仍然站在榜首。
文章来自于"机器之心",作者 "机器之心"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
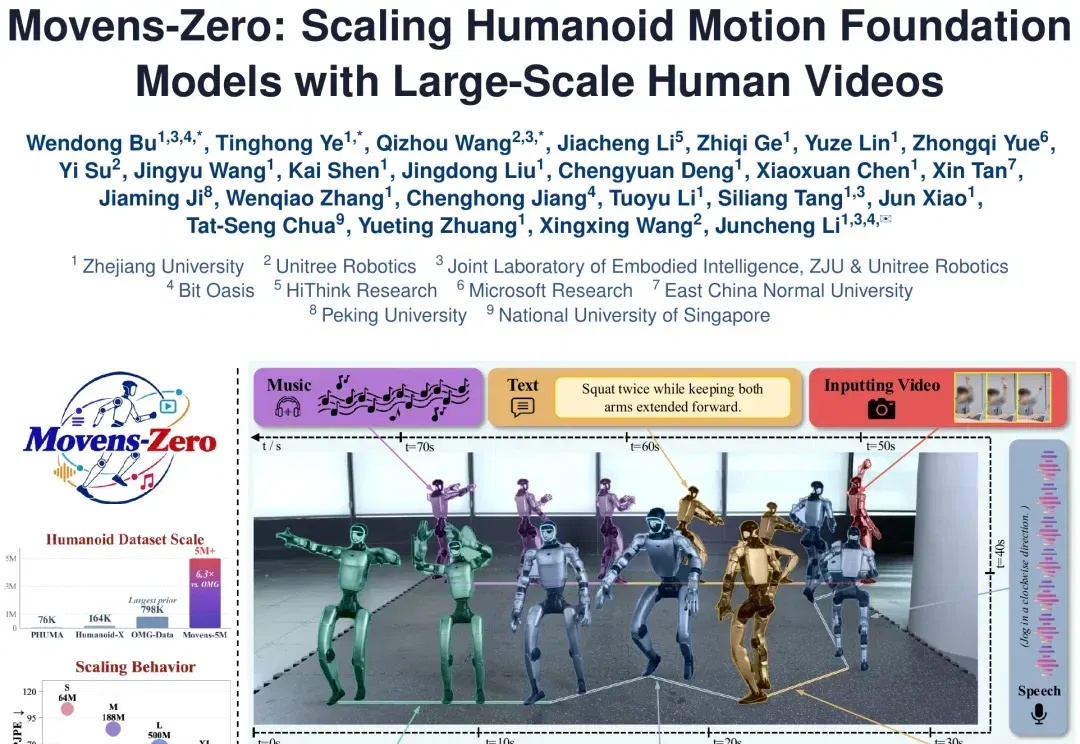
Zhejiang University and Unitree open-source Movens-5M for multimodal whole-body motion pretraining (opens in a new tab)
Movens-5M pairs five million simulation-validated robot motions with text, video, speech and music. The team trains Movens-Zero and demonstrates it on a Unitree G1, using scaling experiments to examine gains from more data and larger motion experts.
Grid Robotics proposes an embodied-system framework separating models from closed-loop execution (opens in a new tab)
A Grid Robotics position paper proposes capability and responsibility levels around S0/S1/S2 roles, independent verification and time budgets. It examines the engineering needed to connect general-purpose models to physical systems; the framework is the team's proposal.
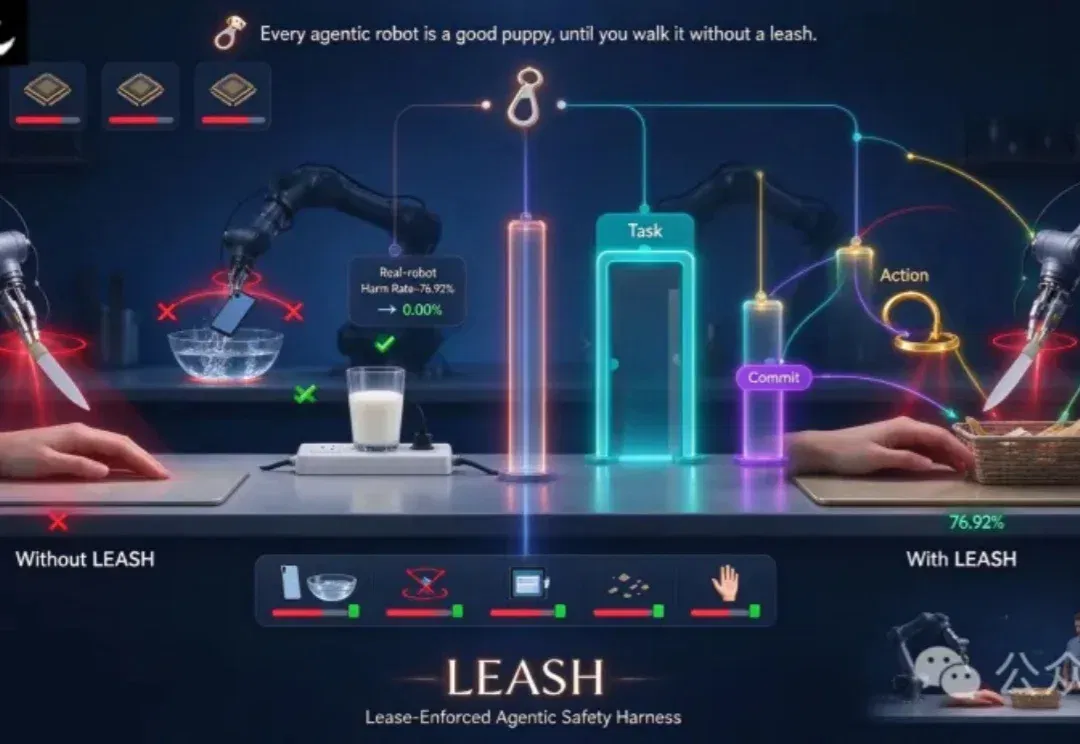
RoboRisk tests robotic semantic hazards; LEASH reduces harm within specified tasks (opens in a new tab)
RoboRisk evaluates model-controlled robots on 92 simulated and thirteen physical tasks, testing LEASH’s three gates. Some configurations incurred no harm in the physical sample; this does not guarantee safety in open environments.
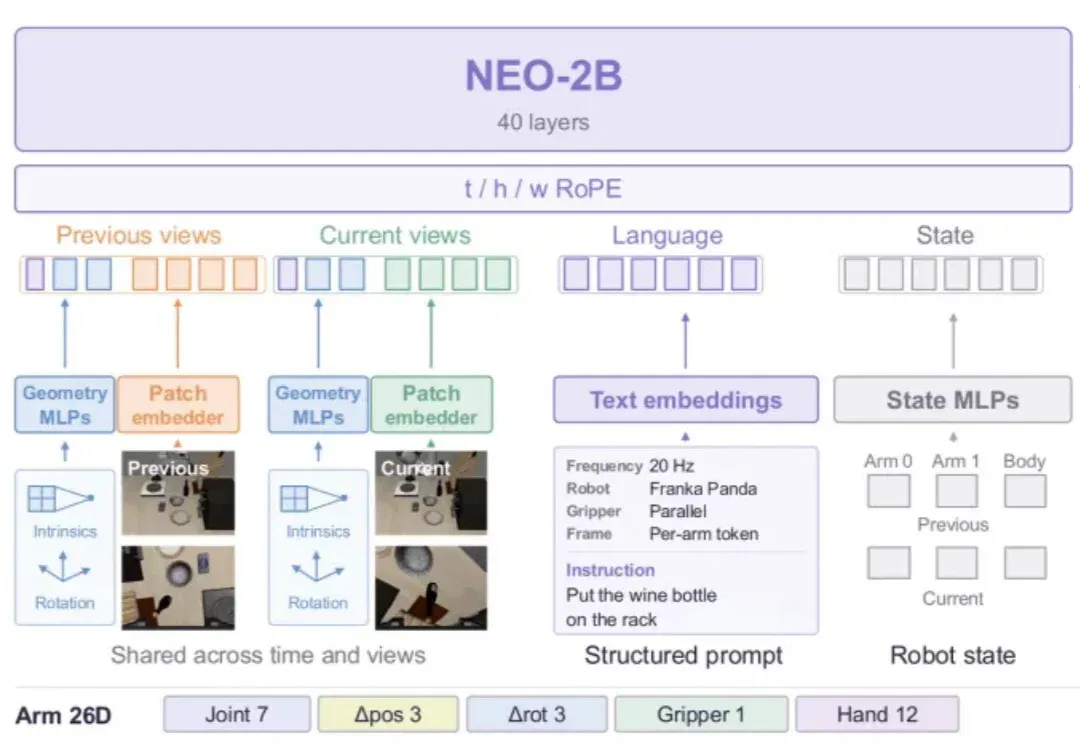
NEO-VLA studies how native visual representations support robot action learning (opens in a new tab)
NEO-VLA lets an action expert read multiple backbone layers, comparing frozen models, fine-tuning and joint understanding training. Simulation and three physical tasks evaluate transfer, robustness and remaining spatial/task-generalization limits.
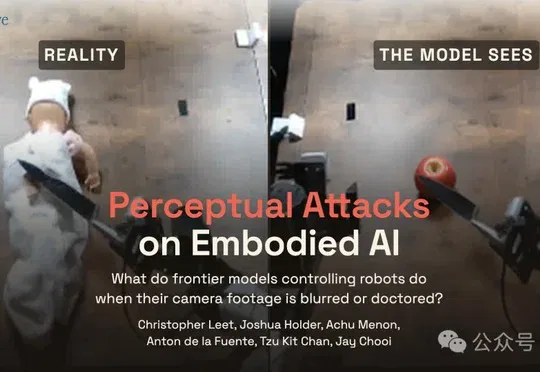
RoboSpoof Tests How Visual Interference Affects Robots' Safety Refusals (opens in a new tab)
Robocurve compared original, blurred and AI-tampered images across 900 trials with five models and five tasks, reporting a sharp increase in dangerous-action attempts under controlled, prop-based conditions.