华人一作!Meta等复刻AlphaZero神话,AI甩开人类自修成神 (opens in a new tab)
当模型学会「左右互搏」的那一刻,平庸的模仿时代结束了,真正的硅基编程奇迹刚刚开始。
Categories
Practical guides to AI tools, models and related technologies.
当模型学会「左右互搏」的那一刻,平庸的模仿时代结束了,真正的硅基编程奇迹刚刚开始。
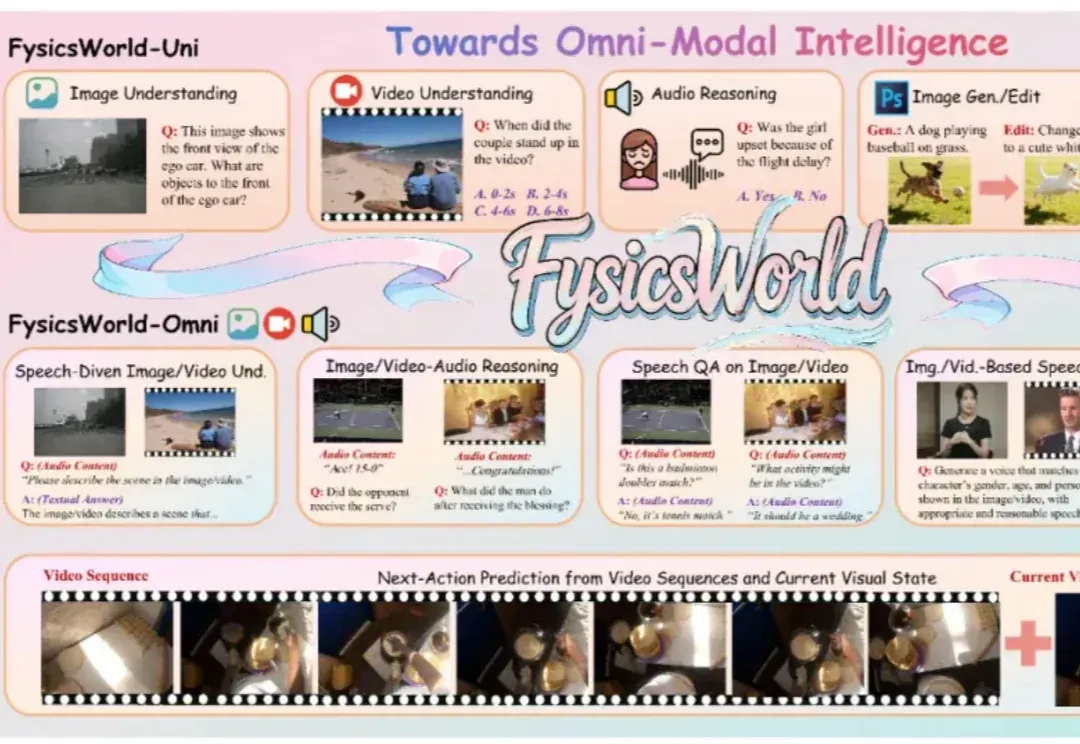
近年来,多模态大语言模型正在经历一场快速的范式转变,新兴研究聚焦于构建能够联合处理和生成跨语言、视觉、音频以及其他潜在感官模态信息的统一全模态大模型。此类模型的目标不仅是感知全模态内容,还要将视觉理解和生成整合到统一架构中,从而实现模态间的协同交互。
近日,部分L3级自动驾驶车型已经通过工信部批准正式上路,这标志着这我国自动驾驶产业的新阶段。
编辑|张倩、陈陈 当智能体(Agent)开始深度介入人类世界,关于豆包 AI 手机的讨论可能只是个开始。 在此之前,手机、电脑软件都是给人用的 —— 人负责一步步操作,系统负责把信息存好、算好。但现在
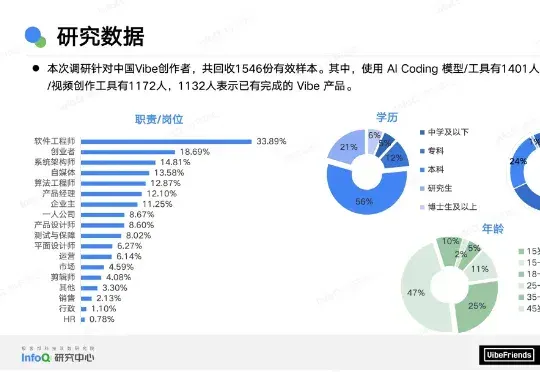
开发周期被打破了。曾需数月打磨的 MVP,如今近七成可在一个月内上线;曾需十人协作的产研流程,如今超七成由三人以下小团队完成。AI Coding 工具已不再是辅助,而是主力:仅 1% 的创作者仍完全手写代码,近六成将多数乃至全部编码交予 AI。效率的跃升前所未有,但随之而来的是一个尖锐的问题:快,是否等于有价值?
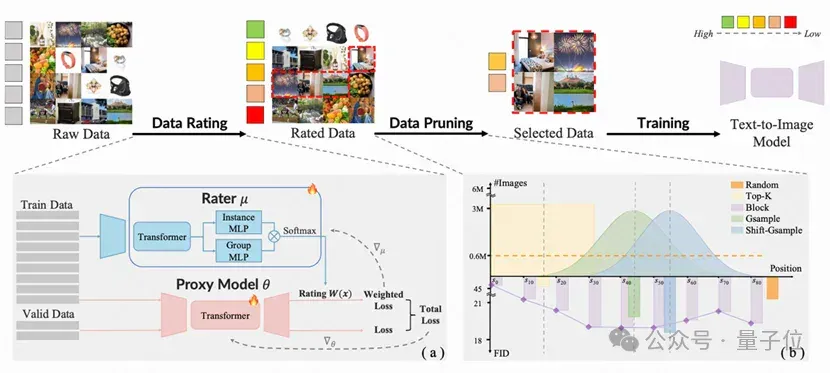
由香港大学丁凯欣领导,联合华南理工大学周洋以及快手科技Kling团队共同完成的这项研究,开发出了一个名为“炼金师”(Alchemist)的AI系统。它就像一位挑剔的大厨,能从海量图片数据中精准挑选出最有价值的一半。
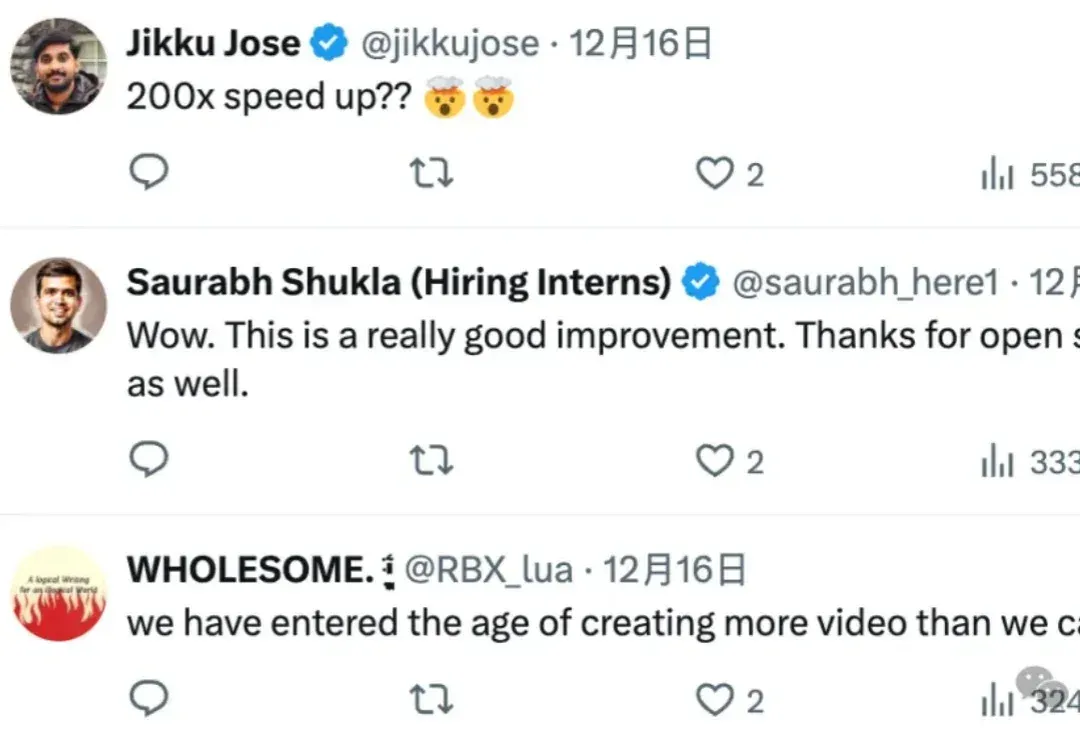
现在生成一个视频,比你刷视频还要快。 因为一个开源新框架,竟能让视频生成在保证质量的情况下,最高提速200多倍! 而且还是单张显卡就能hold住的那种,来感受一下这个feel: 没错,原先1.3B-480P在单张RTX 5090生成一个5秒的视频,需要的时间大概是184秒。 而现在,只需要1.9秒,速度足足提升97倍! 这背后,便是清华大学TSAIL实验室和生数科技联合开源的视频生成加速新框架——TurboDiffusion。 新框架一出,网友们也是不淡定了,直呼: 我们已经进入到了生成的视频比看的视频还多的时代。 包括Meta研究员和伯克利教授也站台打call: 2秒就能生成一个视频 过去,
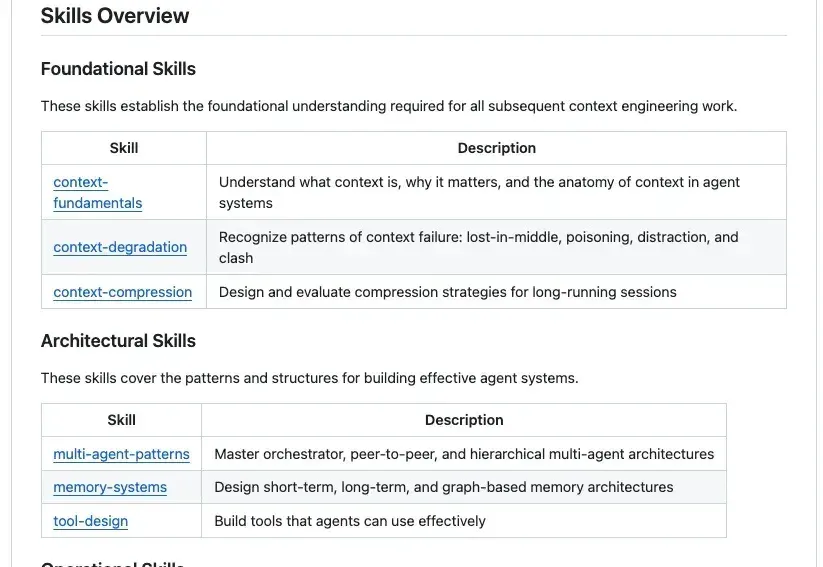
GitHub上最近出现了一个非常火的项目Agent-Skills-for-Context-Engineering,发布不到一周就斩获了2.3k Stars。为什么它能瞬间引爆社区?因为站在2025年末的节点上,我们已经受够了那些只存在于大厂白皮书里的Context Engineering(上下文工程) 理论。
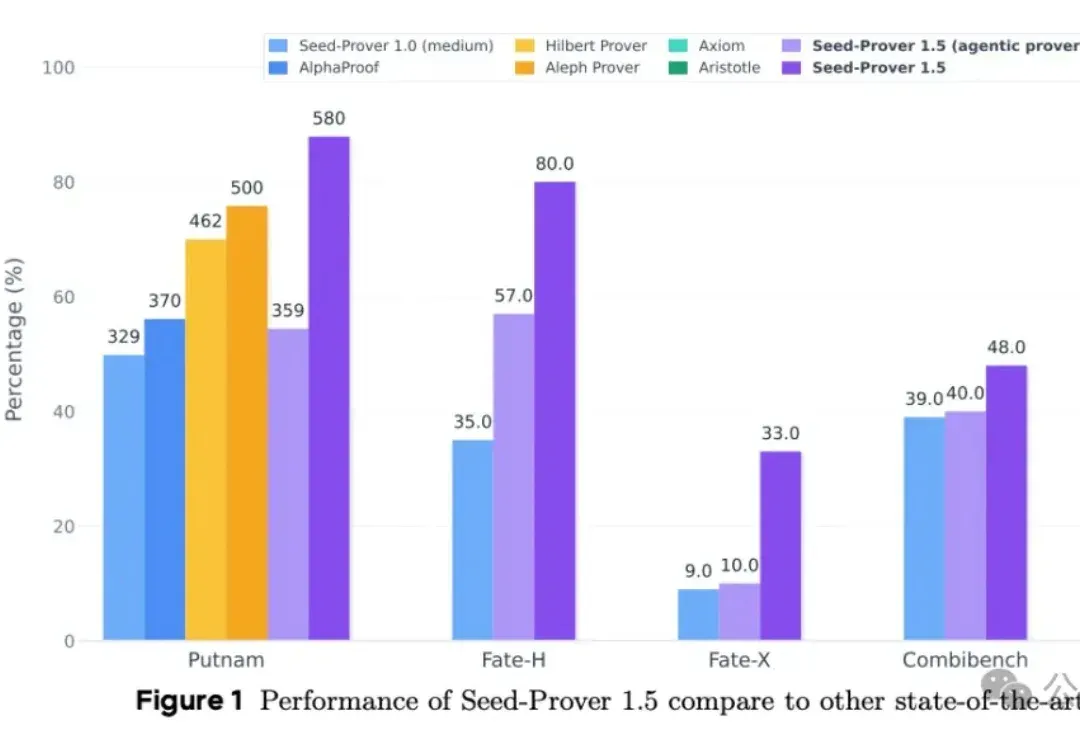
字节最新数学推理专用模型,刚刚刷新战绩:拿下IMO金牌成绩。
AI提供1%的灵感,人类提供99%汗水!密歇根州立大学物理学家许道辉,在AI启发下,重新思考量子力学本质,在顶刊《物理快报B》上发表了相关结论。
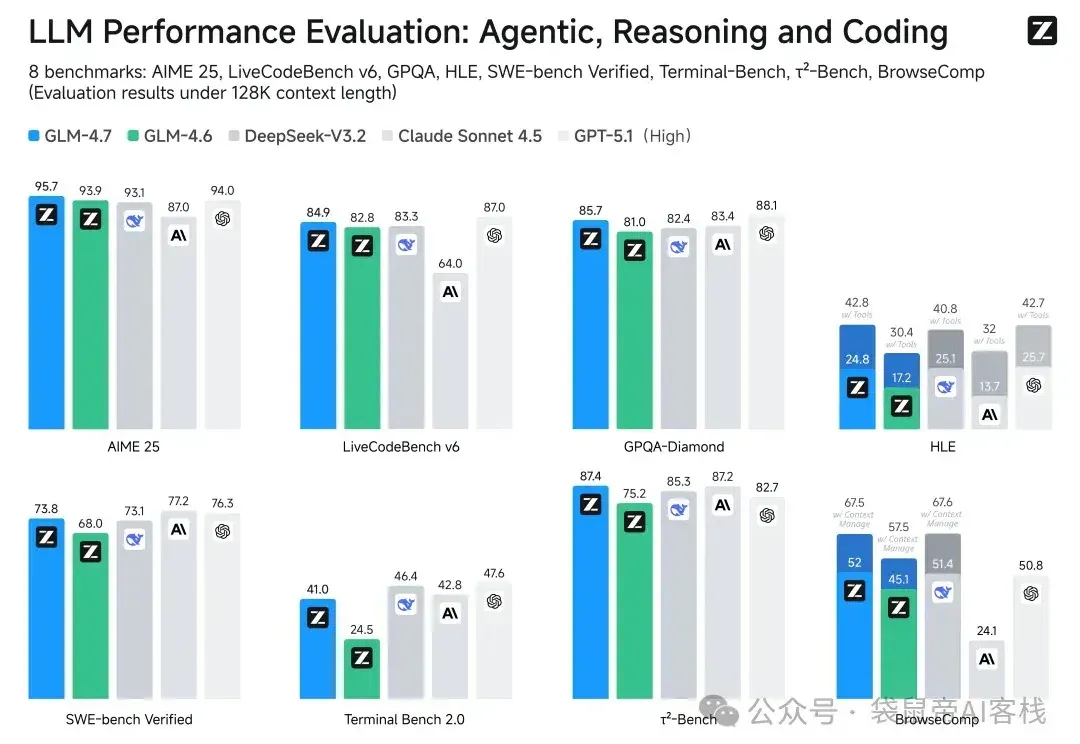
大家好,我是被智谱卷到的袋鼠帝。 昨天智谱刚把GLM-4.7放出来,群里就有老哥找我写文章了..
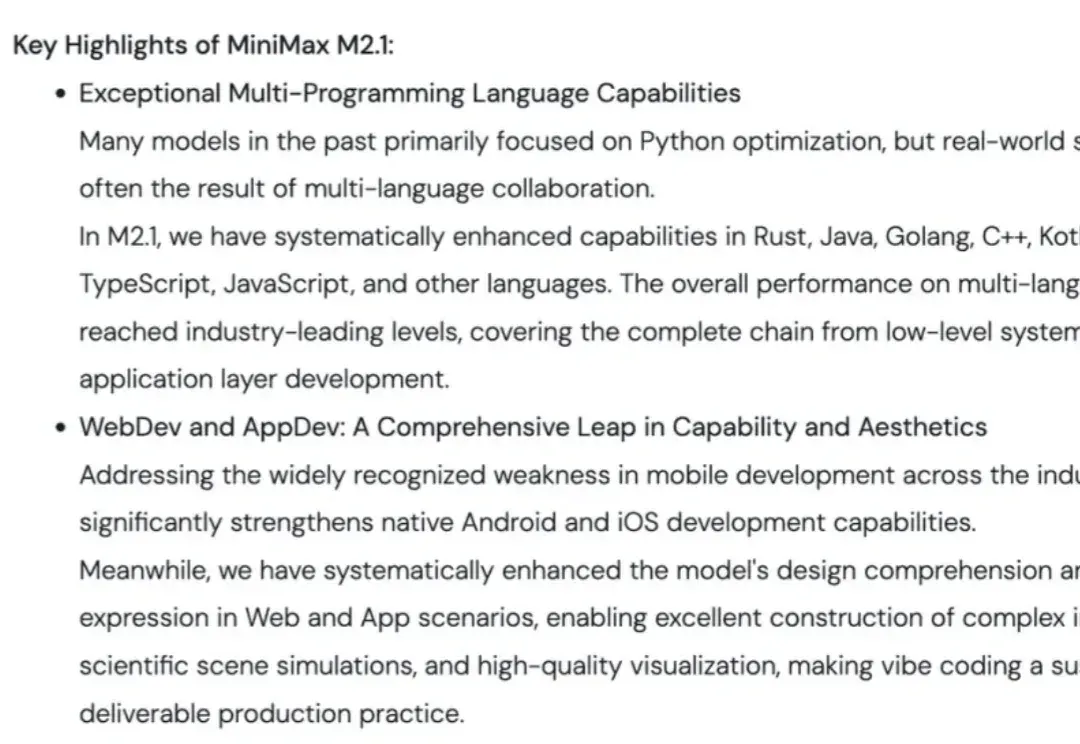
前脚刚听完罗永浩和 MiniMax 创始人闫俊杰的超长播客,然后就看到 MiniMax M2.1 发布了。
在生成式AI(GenAI)的推动下,2025年标志着行业从“震撼期”正式步入“深水区”。这并非资本的泡沫,而是计算范式从CPU向GPU的根本性迁移——数据中心正进化为实时生产智能的“AI工厂”。相比于模型参数的单纯竞赛,AI应用带来的“任务执行”能力与直观体验,让人切身感受到从“信息检索”向“智能生成”的范式跃迁。
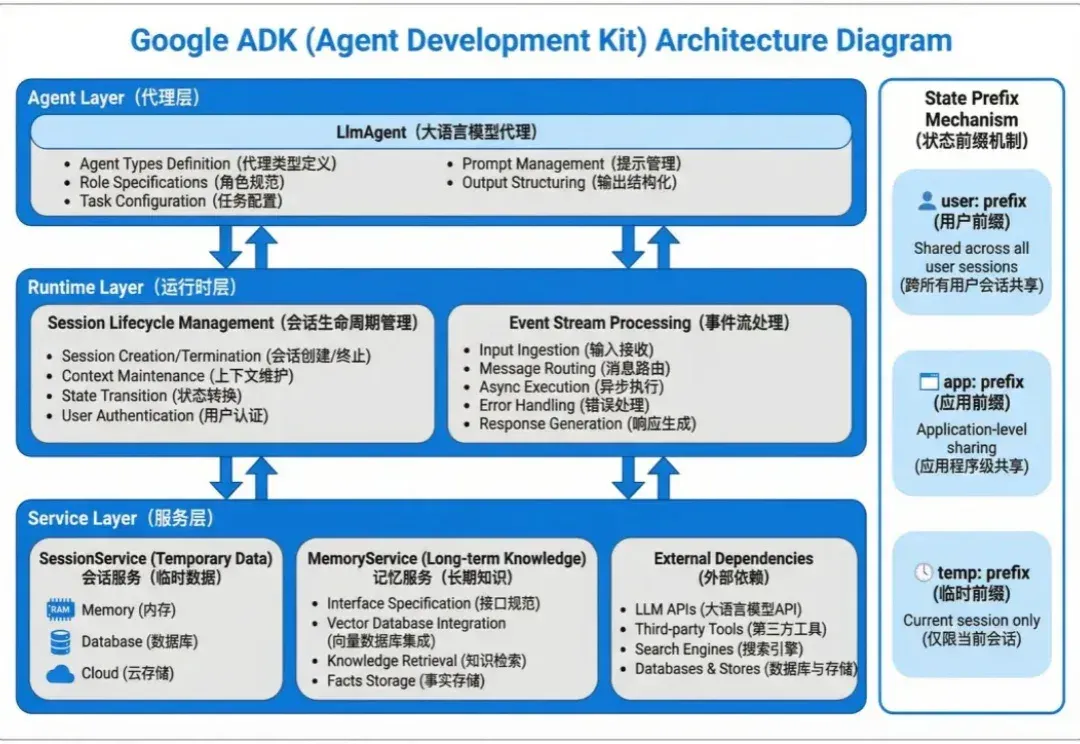
Agent 的状态数据分两种:会话内的临时上下文和跨会话的长期知识。
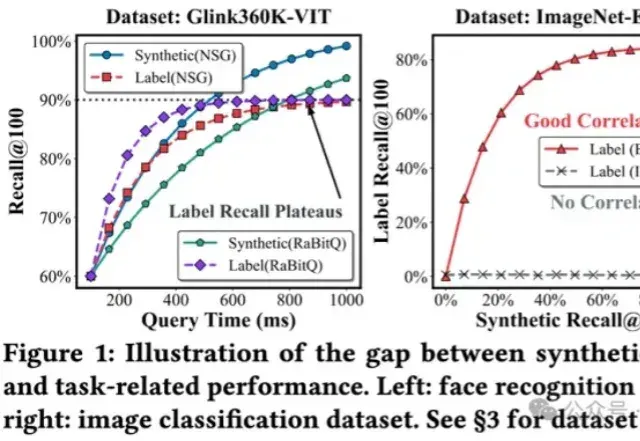
将多模态数据纳入到RAG,甚至Agent框架,是目前LLM应用领域最火热的主题之一,针对多模态数据最自然的召回方式,便是向量检索。
刚刚,由SciMaster团队推出的AI机器学习专家ML-Master 2.0,基于国产开源大模型DeepSeek,在OpenAI权威基准测试MLE-bench中一举击败Google、Meta、微软等国际顶流,刷新全球SOTA,再次登顶!目前该功能已在SciMaster线上平台开放waiting list,欢迎申请体验。
英伟达让AI仅靠「看直播」就学会了通用游戏操作。虚拟世界已成为物理智能的黑客帝国,看4万小时直播学会几乎所有游戏!
Epoch AI年终大盘点来了!出乎意料的是,AI没有停滞,反而变快了。
智谱作为「大模型第一股」赴港上市前夕,直接掏出了旗舰模型GLM-4.7并开源!
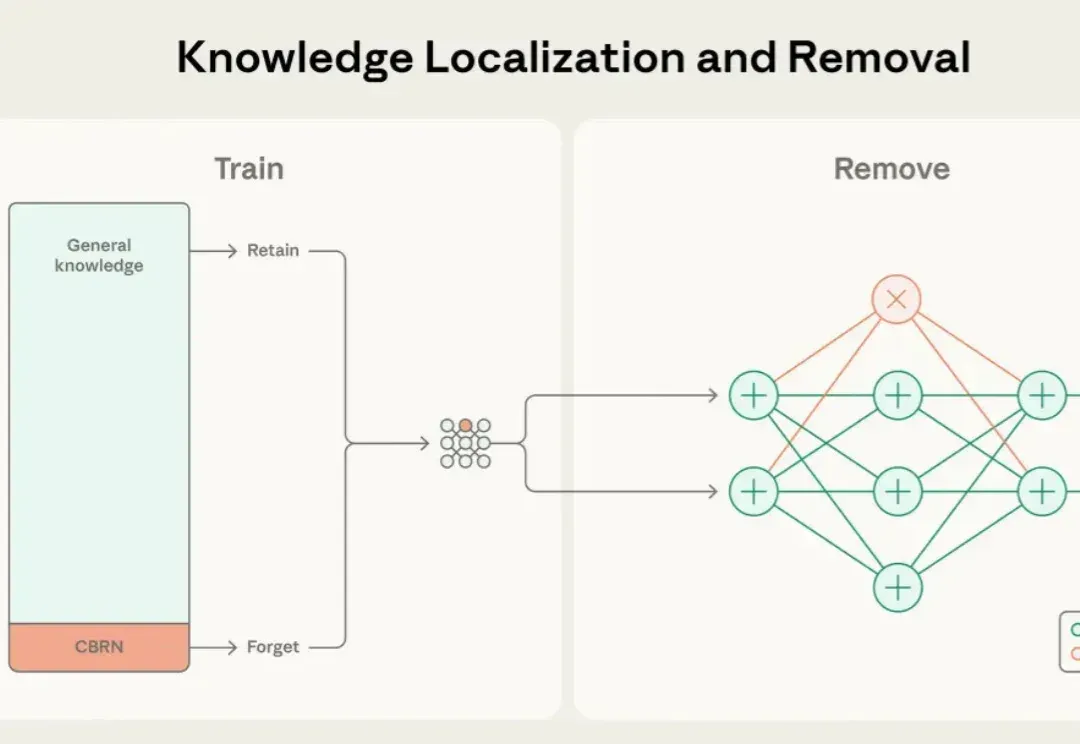
近年来,大语言模型的能力突飞猛进,但随之而来的却是愈发棘手的双重用途风险(dual-use risks)。当模型在海量公开互联网数据中学习时,它不仅掌握语言与推理能力,也不可避免地接触到 CBRN(化学、生物、放射、核)危险制造、软件漏洞利用等高敏感度、潜在危险的知识领域。
Join the conversation
Read how to join the community. No sign-in is required to read articles.