我招了 6 个 AI 员工一起干活 (opens in a new tab)
大家好,我是艾逗笔。 今天我花了一天时间,招聘了 6 个 AI 员工,帮助他们走完了入职流程,给他们分配了工作权限,了解了他们各自的特点和能力,然后安排了一个工作间,让他们在一起开始干活了。
Categories
Practical guides to AI tools, models and related technologies.
大家好,我是艾逗笔。 今天我花了一天时间,招聘了 6 个 AI 员工,帮助他们走完了入职流程,给他们分配了工作权限,了解了他们各自的特点和能力,然后安排了一个工作间,让他们在一起开始干活了。
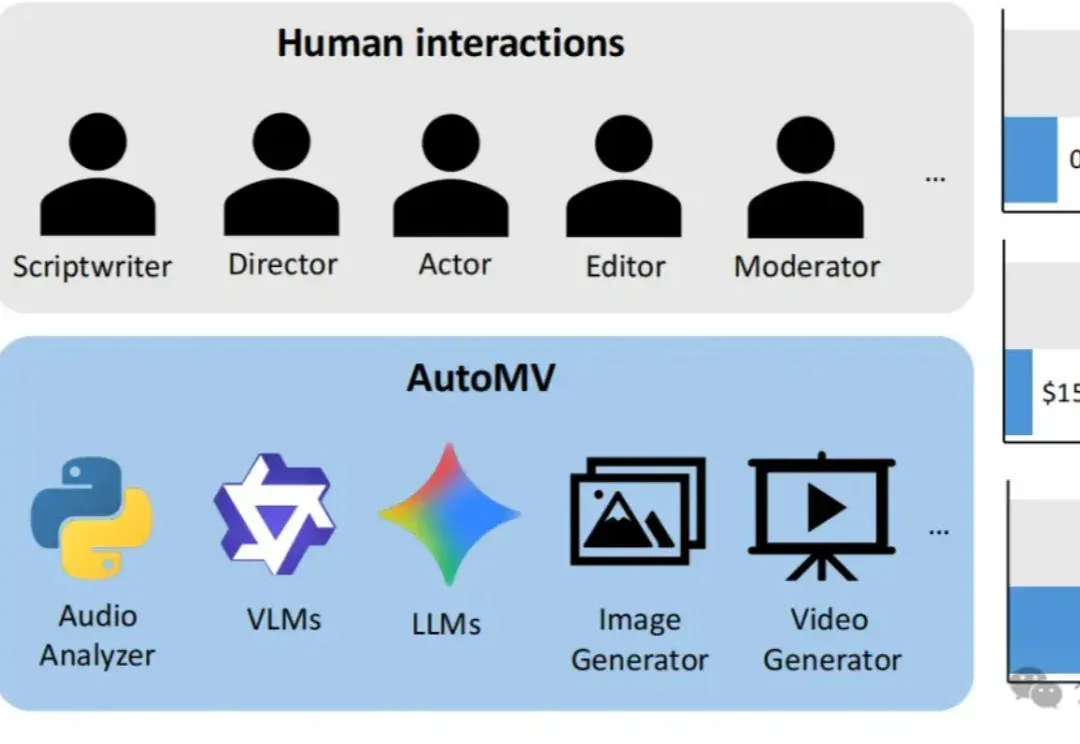
现有的AI视频生成模型虽然在短片上效果惊人,但面对一首完整的歌曲时往往束手无策——画面不连贯、人物换脸、甚至完全不理会歌词含义。
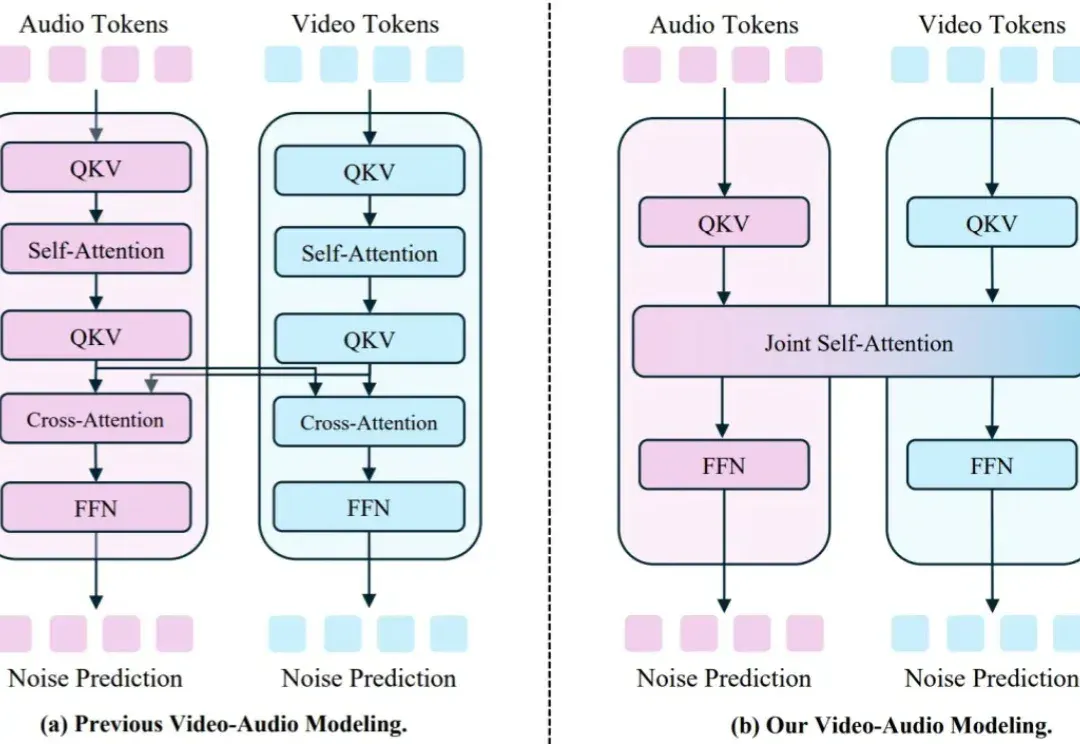
视频 - 音频联合生成的研究近期在开源与闭源社区都备受关注,其中,如何生成音视频对齐的内容是研究的重点。
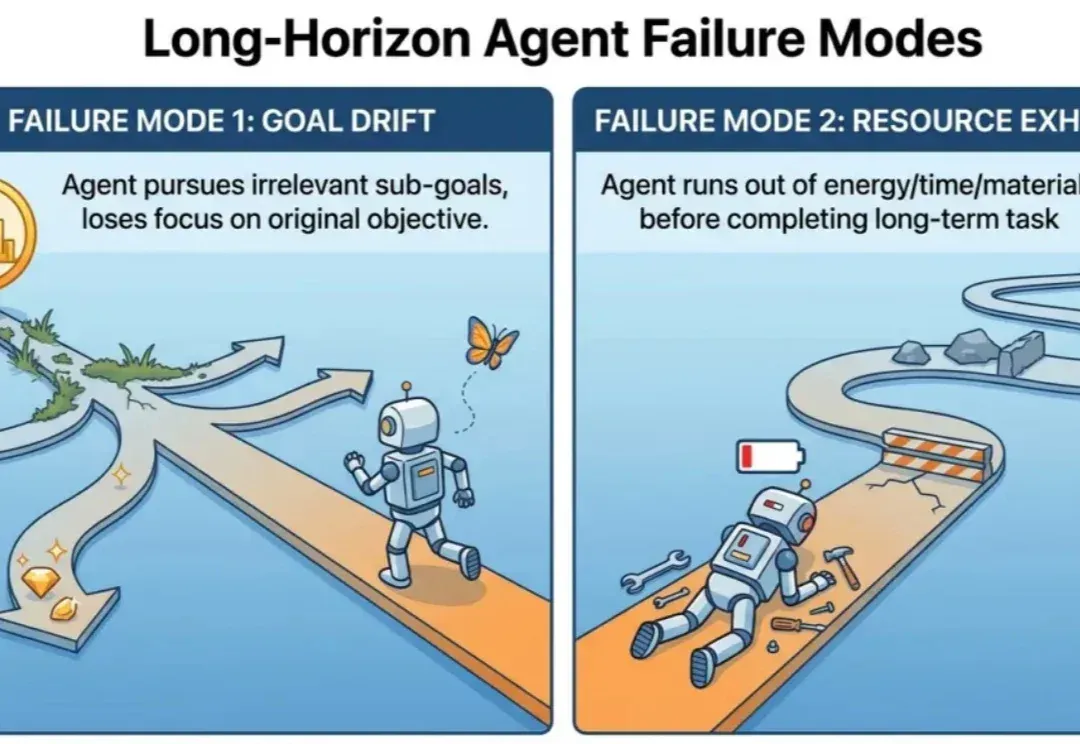
做agent简单,但是做能落地的agent难,做能落地的长周期agent更是难上加难!
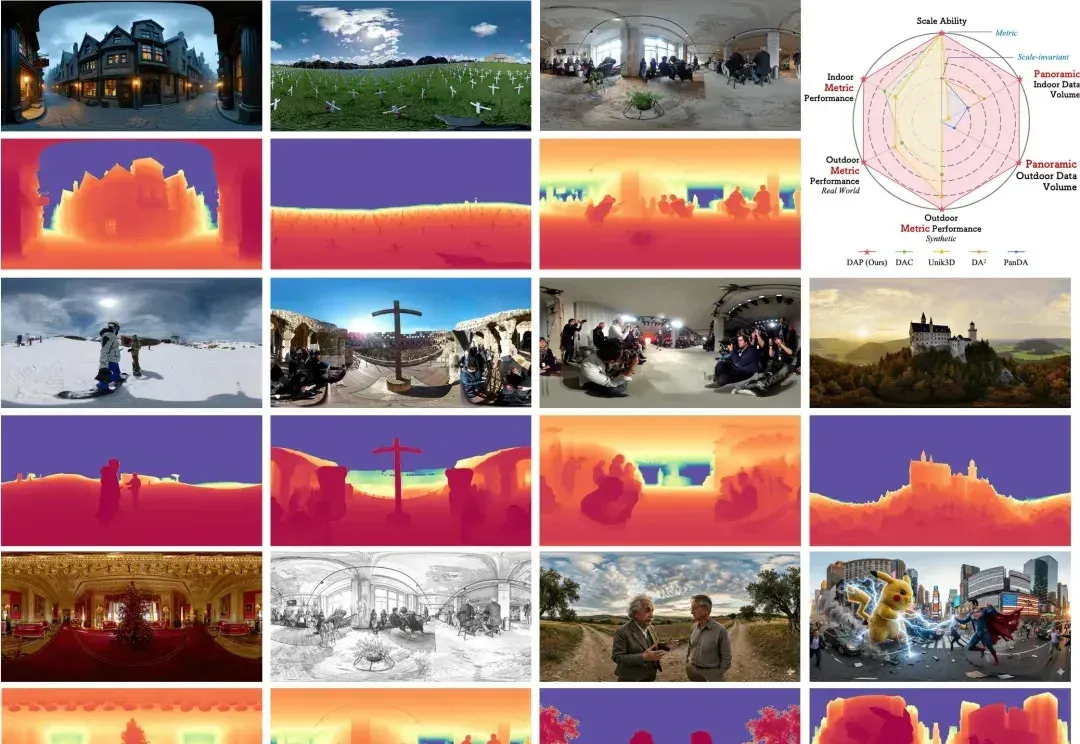
在空间智能(Spatial Intelligence)飞速发展的今天,全景视角因其 360° 的环绕覆盖能力,成为了机器人导航、自动驾驶及虚拟现实的核心基石。然而,全景深度估计长期面临 “数据荒” 与 “模型泛化差” 的瓶颈。
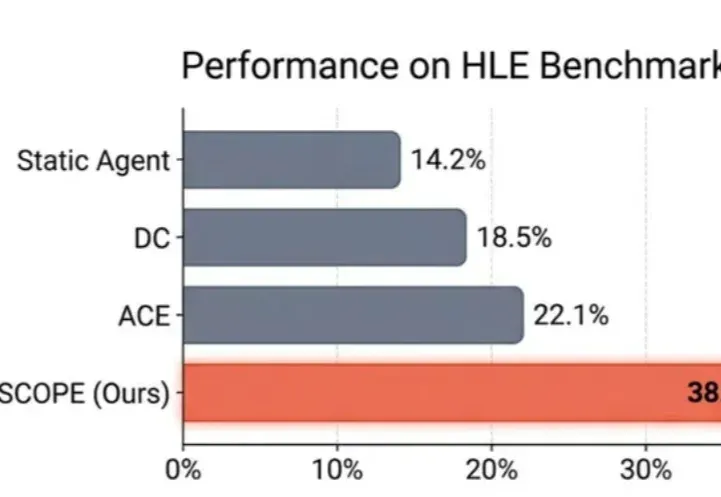
在 LLM Agent 领域,有一个常见的问题:Agent 明明 "看到了" 错误信息,却总是重蹈覆辙。
在电影与虚拟制作中,「看清一个人」从来不是看清某一帧。导演通过镜头运动与光线变化,让观众在不同视角、不同光照条件下逐步建立对一个角色的完整认知。然而,在当前大量 customizing video generation model 的研究中,这个最基本的事实,却往往被忽视。
近日,刚刚 IPO 的国产 GPU 公司沐曦股份,完成了自上市后的首个重大技术发布。
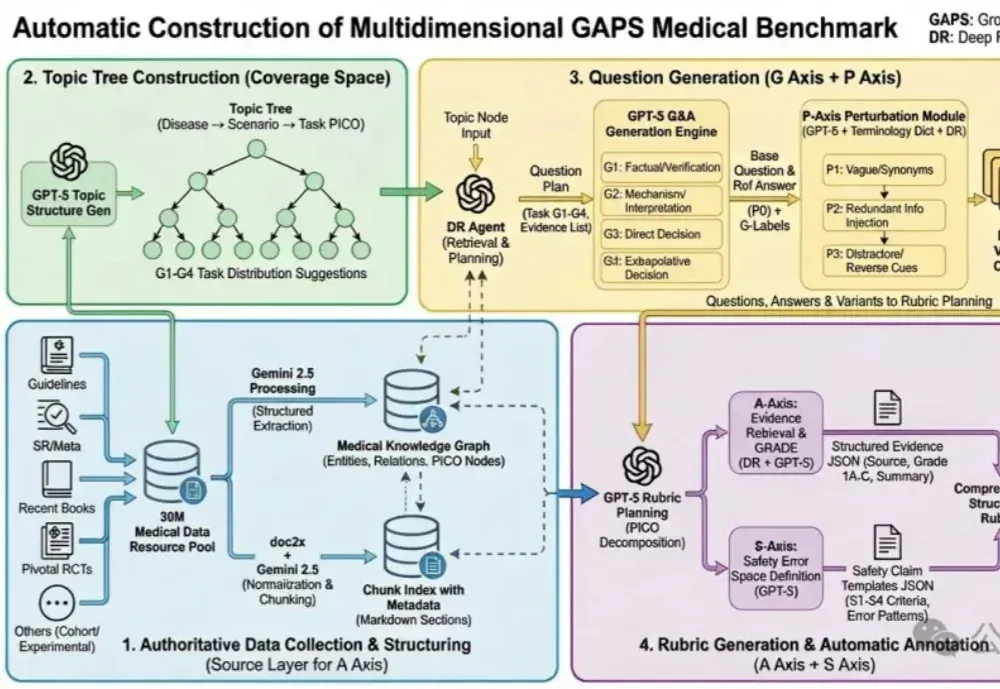
蚂蚁健康与北京大学人民医院王俊院士团队历时6个多月,联合十余位胸外科医生共同打磨,发布了全球首个大模型专病循证能力的评测框架—— GAPS(Grounding, Adequacy, Perturbation, Safety),及其配套评测集 GAPS-NSCLC-preview。
清华大学等多所高校联合发布SR-LLM,这是一种融合大语言模型与深度强化学习的符号回归框架。它通过检索增强和语义推理,从数据中生成简洁、可解释的数学模型,显著优于现有方法。在跟车行为建模等任务中,SR-LLM不仅复现经典模型,还发现更优新模型,为机器自主科学发现开辟新路径。
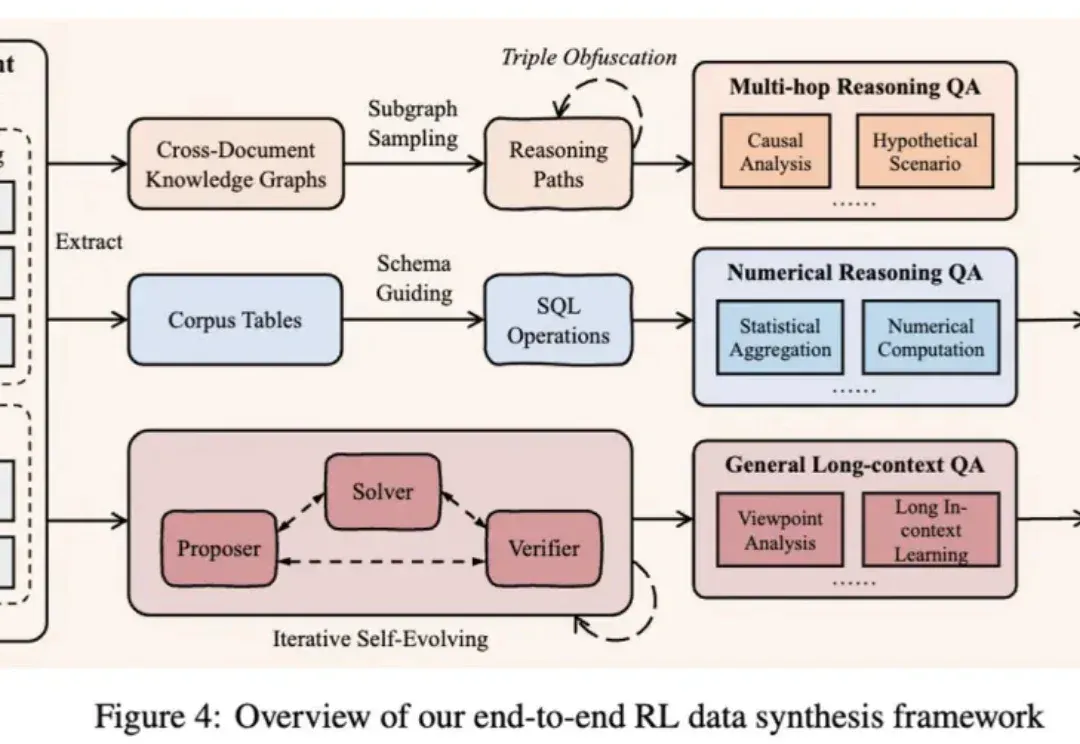
作为大模型从业者或研究员的你,是否也曾为一个模型的 “长文本能力” 而兴奋,却在实际应用中发现它并没有想象中那么智能?
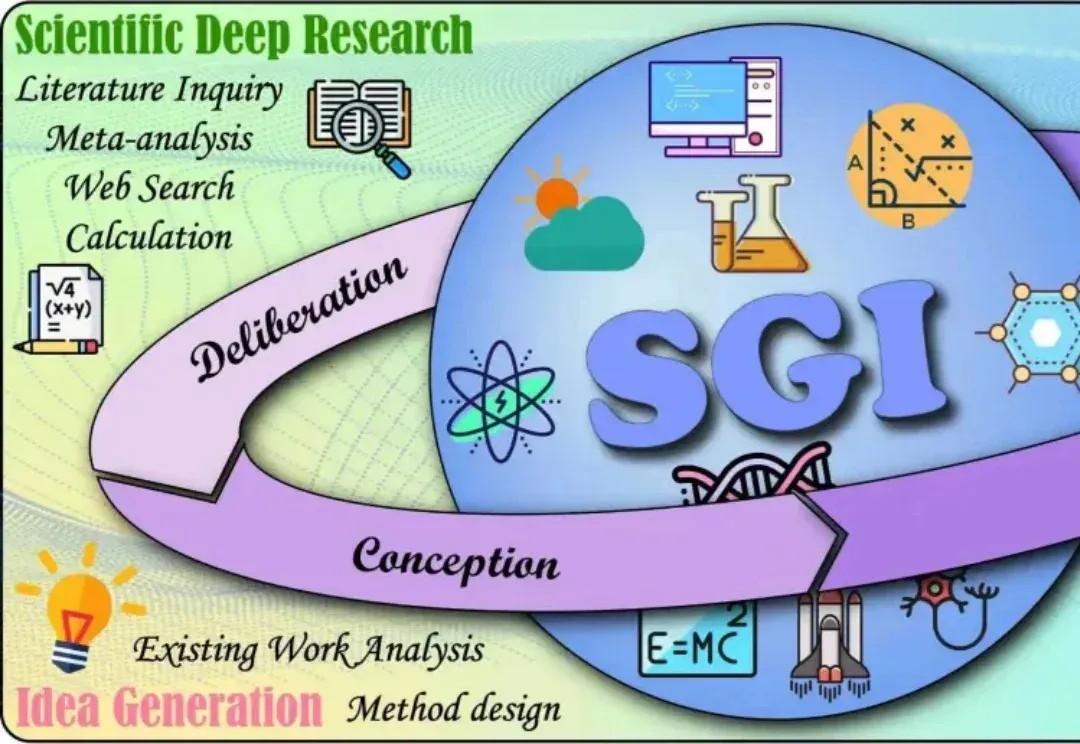
如今,大模型在理解、推理、编程等方面表现突出,但AI的“科学通用能力”(SGI)尚无统一标准。
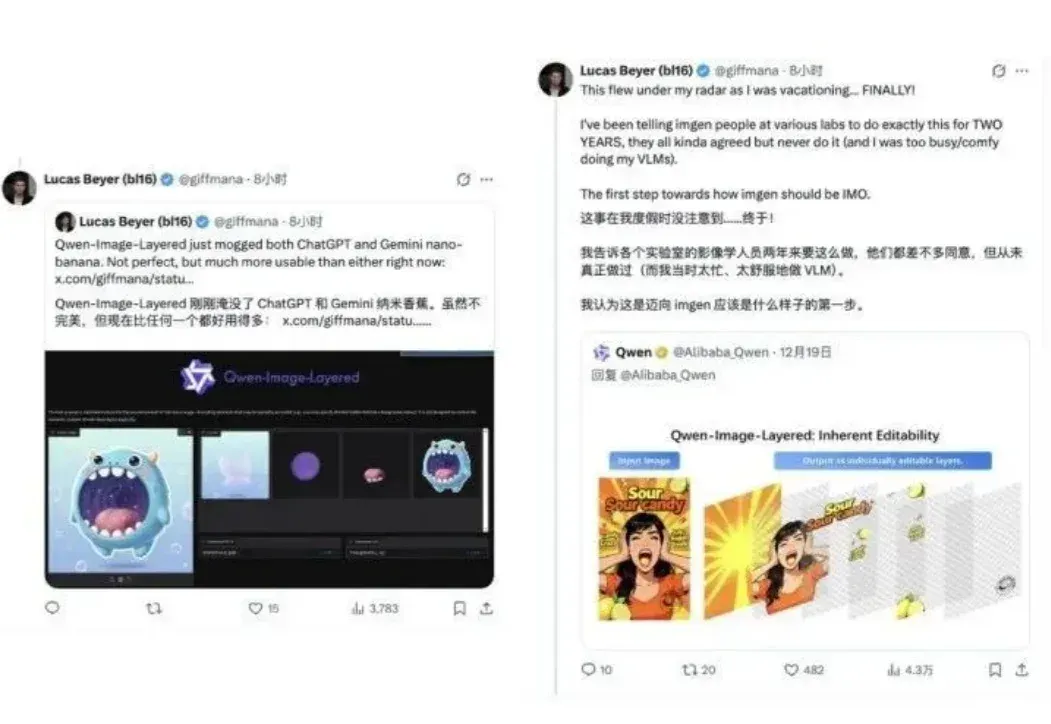
太香了太香了,妥妥完爆ChatGPT和Nano Banana!
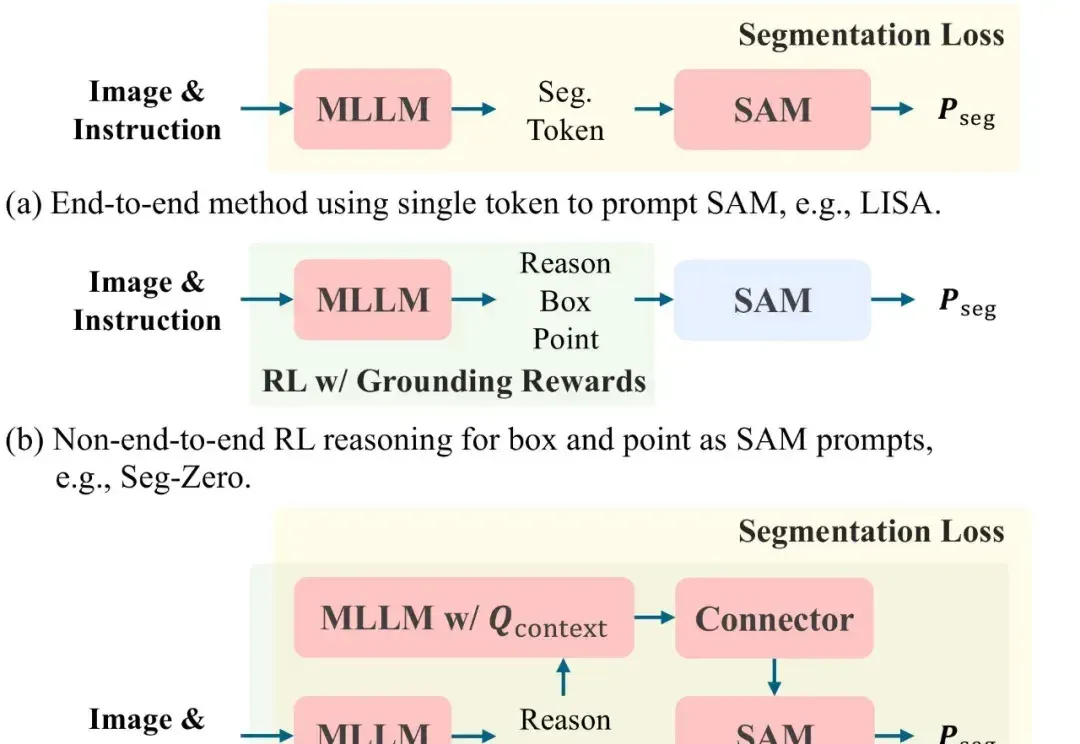
文本提示图像分割(Text-prompted image segmentation)是实现精细化视觉理解的关键技术,在人机交互、具身智能及机器人等前沿领域具有重大的战略意义。这项技术使机器能够根据自然语言指令,在复杂的视觉场景中定位并分割出任意目标。
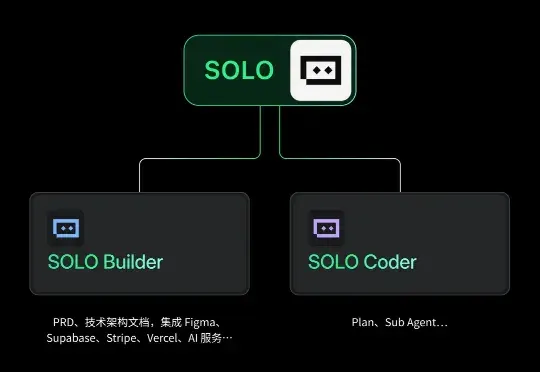
TRAE在一年里写了1000亿行代码!如果按照一个程序员每天写100行有效代码计算,这相当于300万个程序员不吃不喝、没日没夜干了一整年。而这也仅仅是《TRAE 2025年度产品报告》中的冰山一角,更多惊人的数据还包括:
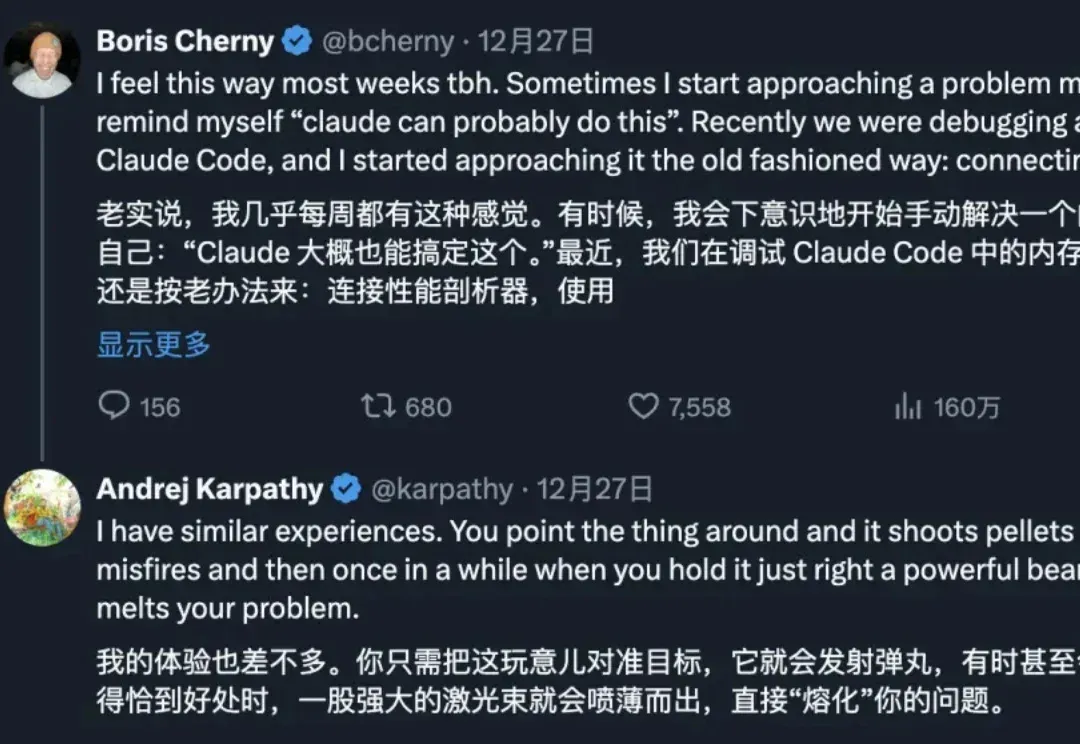
两个月以来,我一直想写一篇给小白的 CC 入门指南,今天终于可以写了。
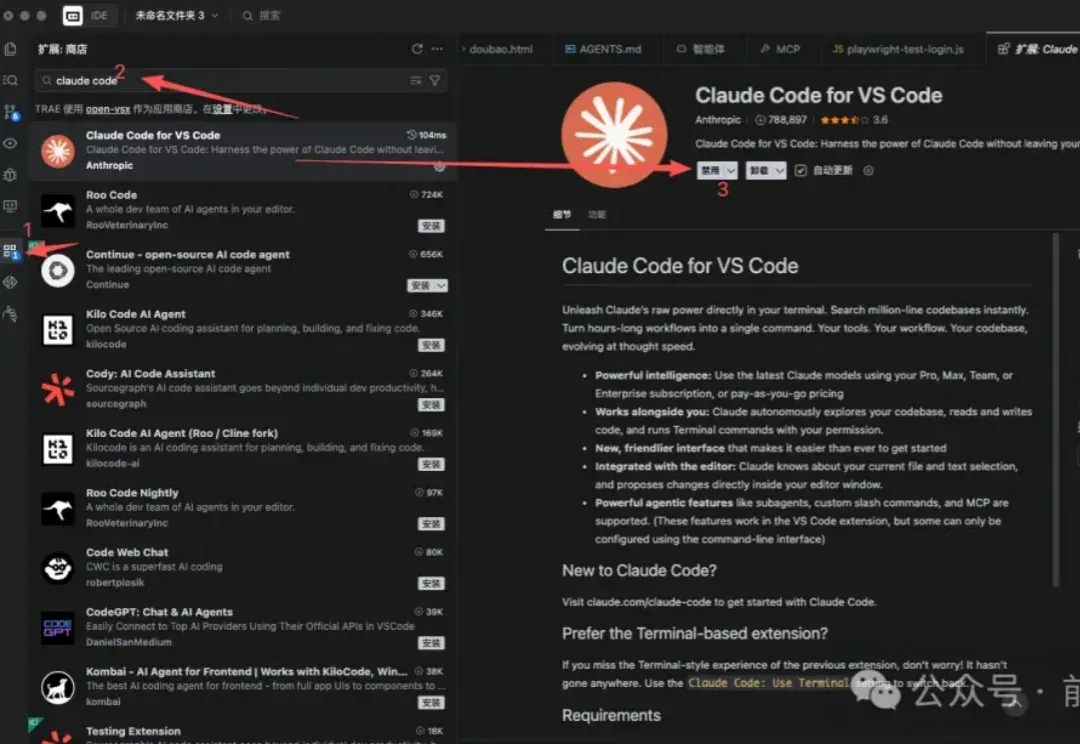
面对苍白的CLI终端界面,有些深度依赖IDE的使用者,用Claude Code还是会不习惯的。于是我找了蛮多的资料,看看有没有适合新手的GUI工具。
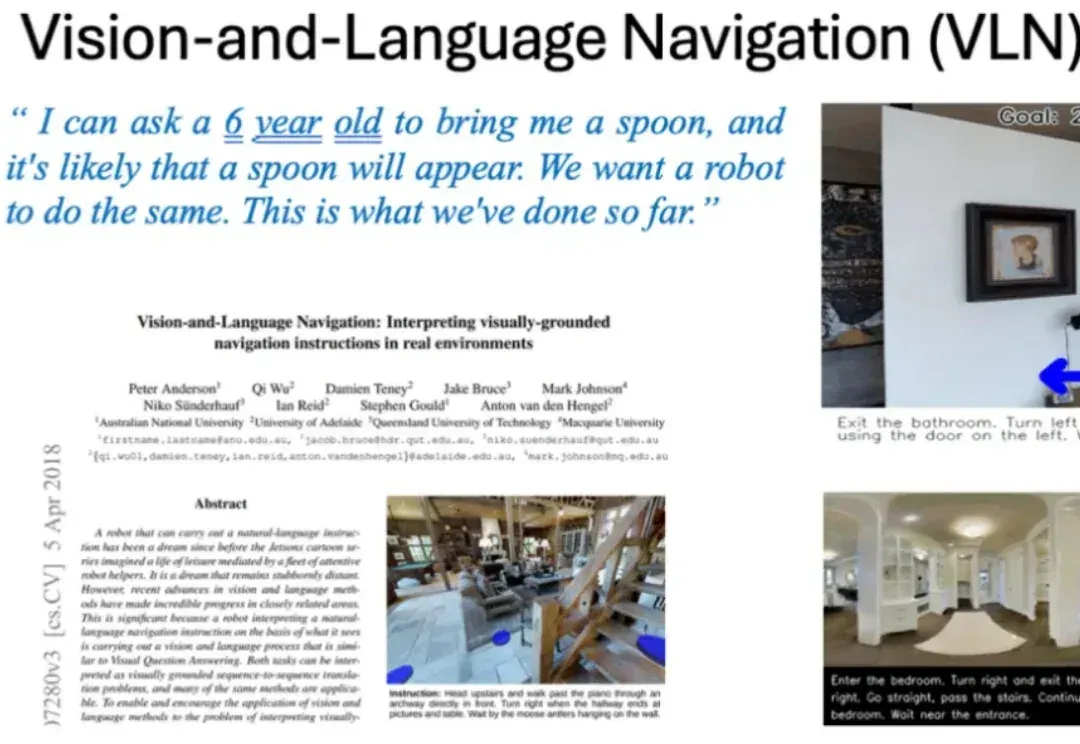
告别碎片化!以全栈之姿,开启具身导航的 2026 新篇章。
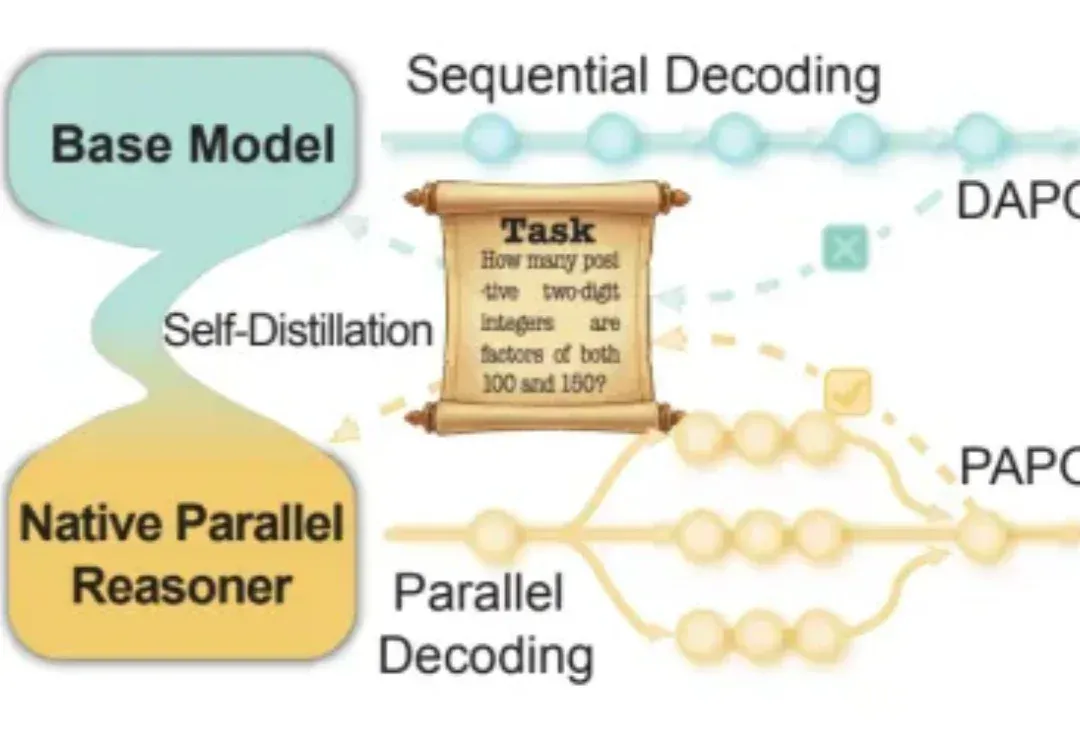
近年来,大语言模型在「写得长、写得顺」这件事上进步飞快。但当任务升级到真正复杂的推理场景 —— 需要兵分多路探索、需要自我反思与相互印证、需要在多条线索之间做汇总与取舍时,传统的链式思维(Chain-of-Thought)往往就开始「吃力」:容易被早期判断带偏、发散不足、自我纠错弱,而且顺序生成的效率天然受限。
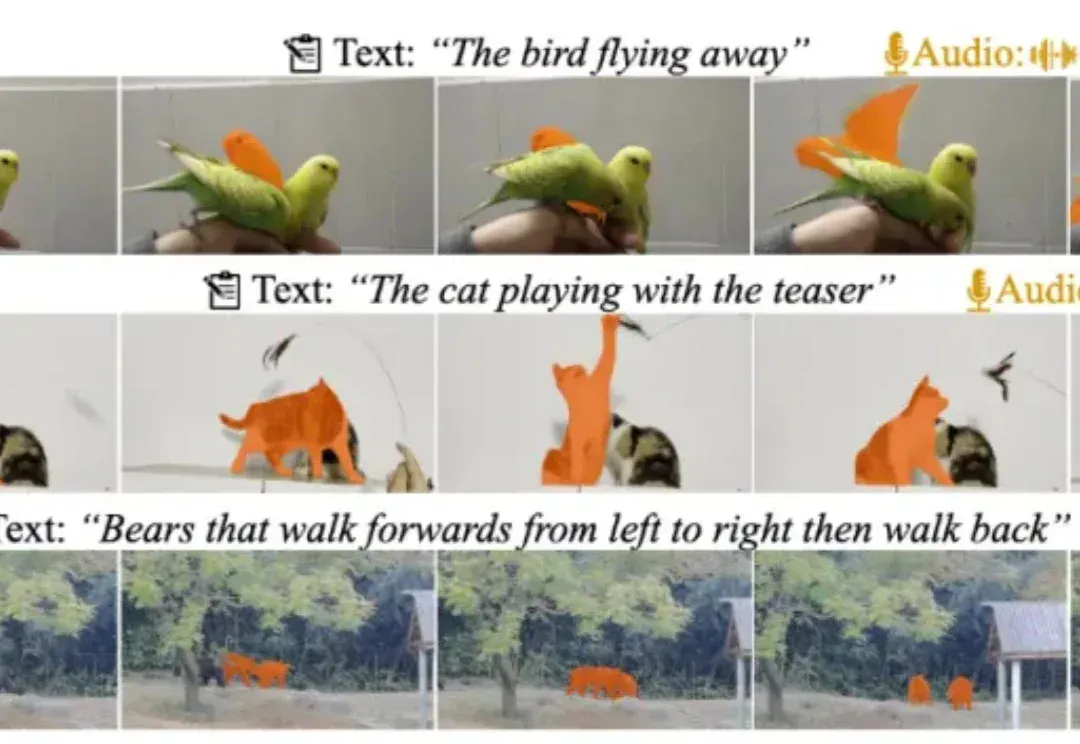
近日,多模态视频理解领域迎来重磅更新!由复旦大学、上海财经大学、南洋理工大学联合打造的 MeViSv2 数据集正式发布,并已被顶刊 IEEE TPAMI 录用。
Join the conversation
Read how to join the community. No sign-in is required to read articles.