阿里最强“PS模型”开源!一手体验,0元P出氛围感合影 (opens in a new tab)
热门LoRA首次内置,控光换镜头实测可用。
Categories
Practical guides to AI tools, models and related technologies.
热门LoRA首次内置,控光换镜头实测可用。
视频生成模型总是「记性不好」?生成几秒钟后物体就变形、背景就穿帮?北大、中大等机构联合发布EgoLCD,借鉴人类「长短时记忆」机制,首创稀疏KV缓存+LoRA动态适应架构,彻底解决长视频「内容漂移」难题,在EgoVid-5M基准上刷新SOTA!让AI像人一样拥有连贯的第一人称视角记忆。
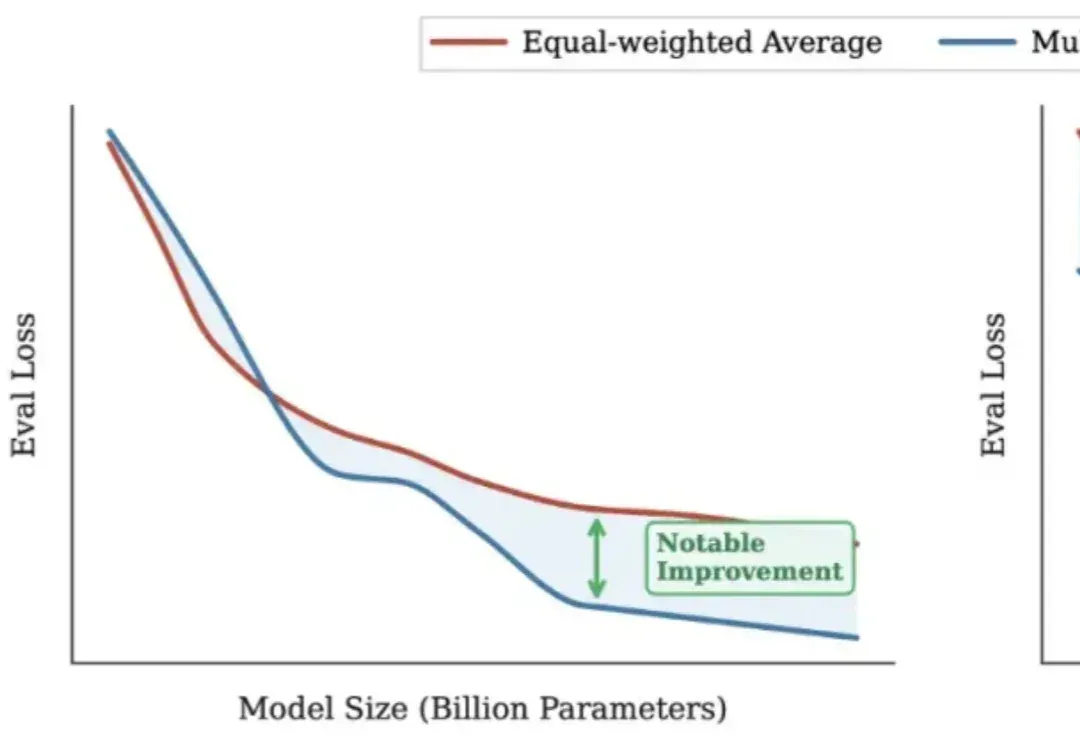
在代码大模型(Code LLMs)的预训练中,行业内长期存在一种惯性思维,即把所有编程语言的代码都视为同质化的文本数据,主要关注数据总量的堆叠。然而,现代软件开发本质上是多语言混合的,不同语言的语法特性、语料规模和应用场景差异巨大。
多模态大语言模型(MLLMs)已成为AI视觉理解的核心引擎,但其在真实世界视觉退化(模糊、噪声、遮挡等)下的性能崩溃,始终是制约产业落地的致命瓶颈。
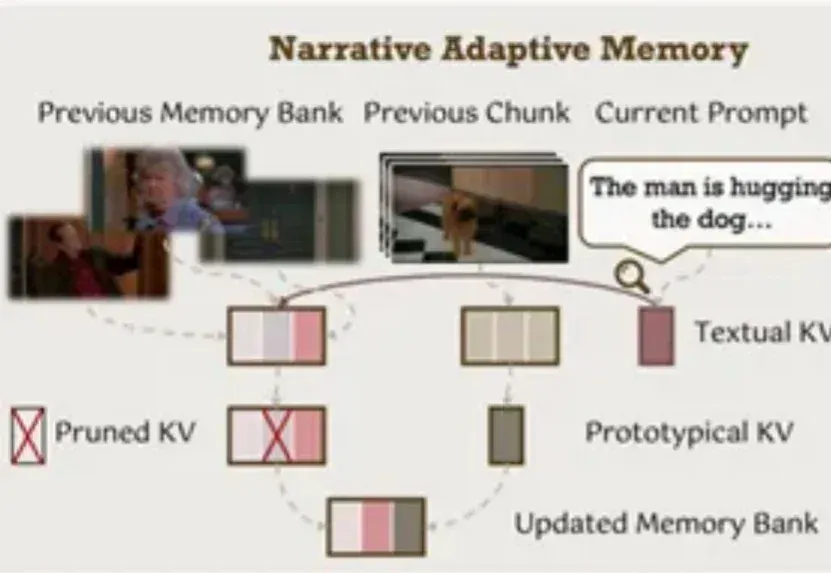
你是否曾被AI视频生成的不连贯性所困扰?
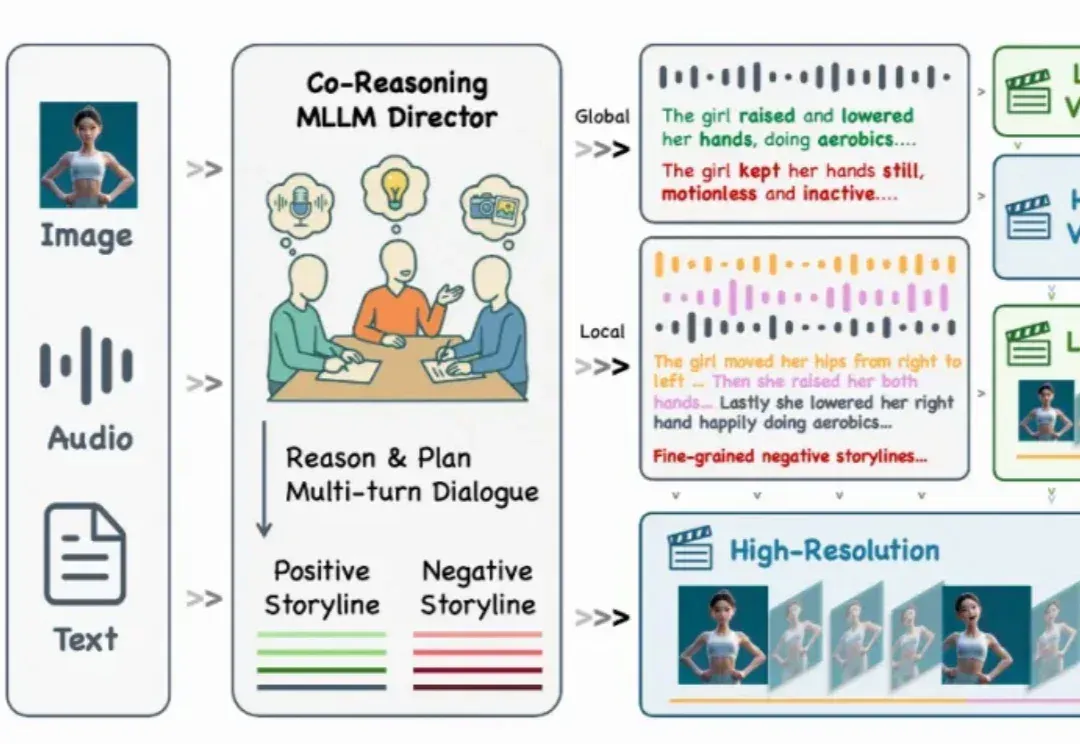
还记得几个月前那个能随着音乐节拍自然舞动的 KlingAvatar 数字人吗?现在,它迎来了史诗级进化!
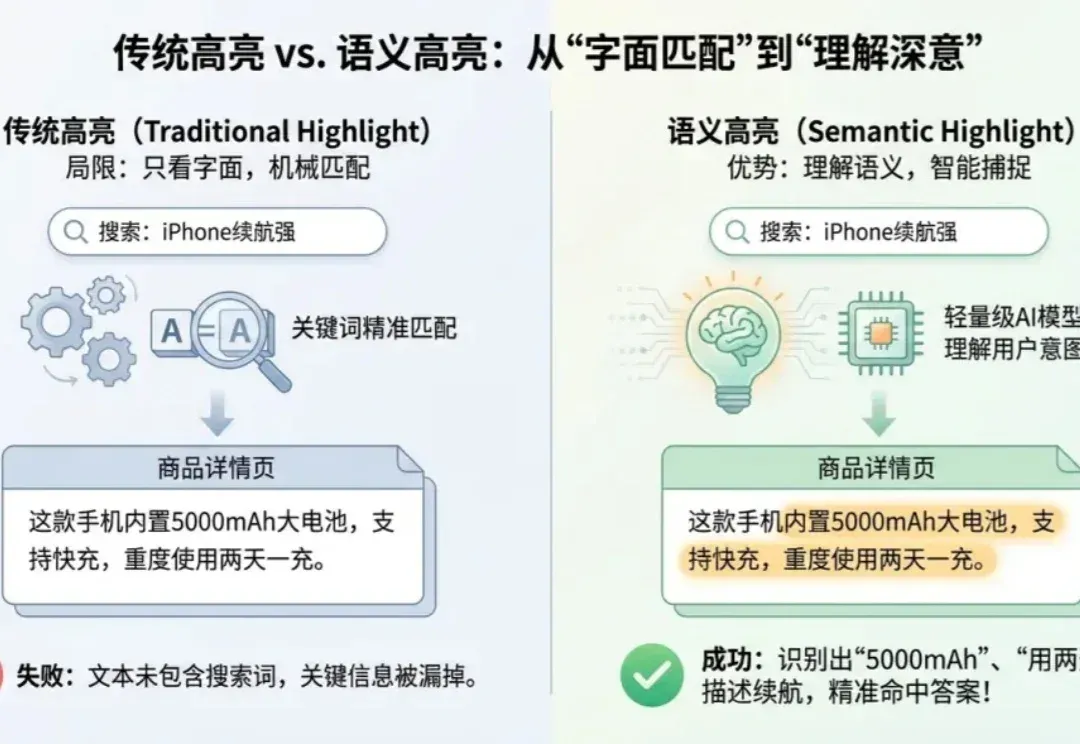
今天聊一聊怎么在RAG、agent场景中实现语义高亮(Semantic Highlight)。
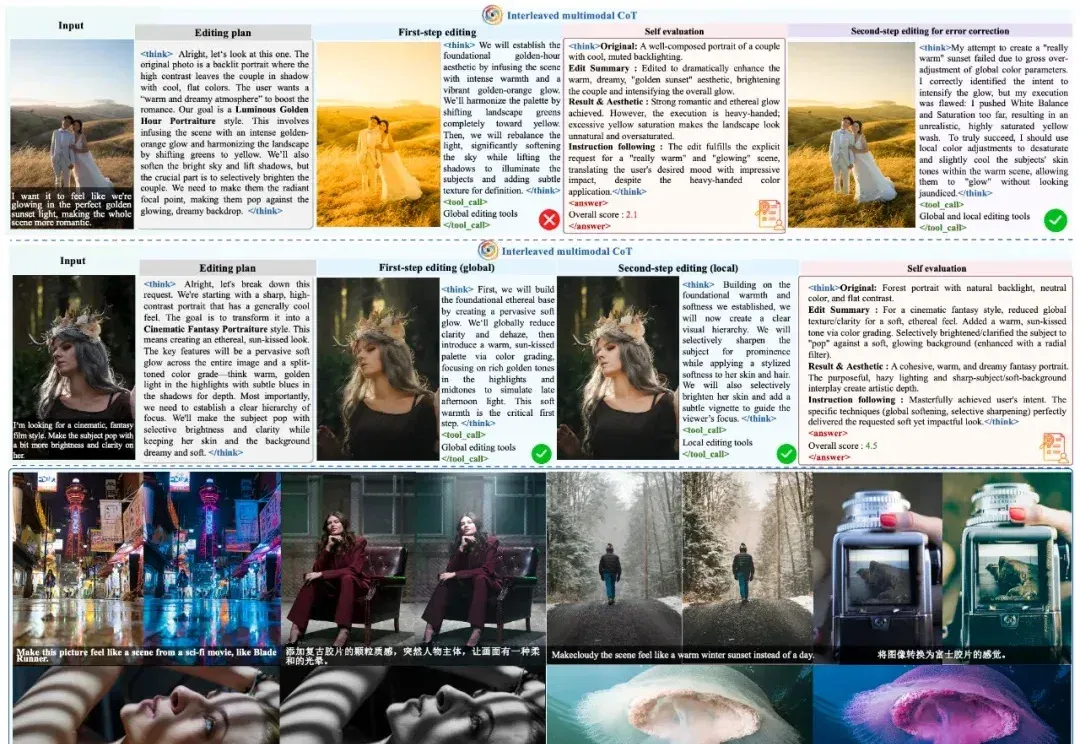
在迈向通用人工智能的道路上,我们一直在思考一个问题:现有的 Image Editing Agent,真的「懂」修图吗?
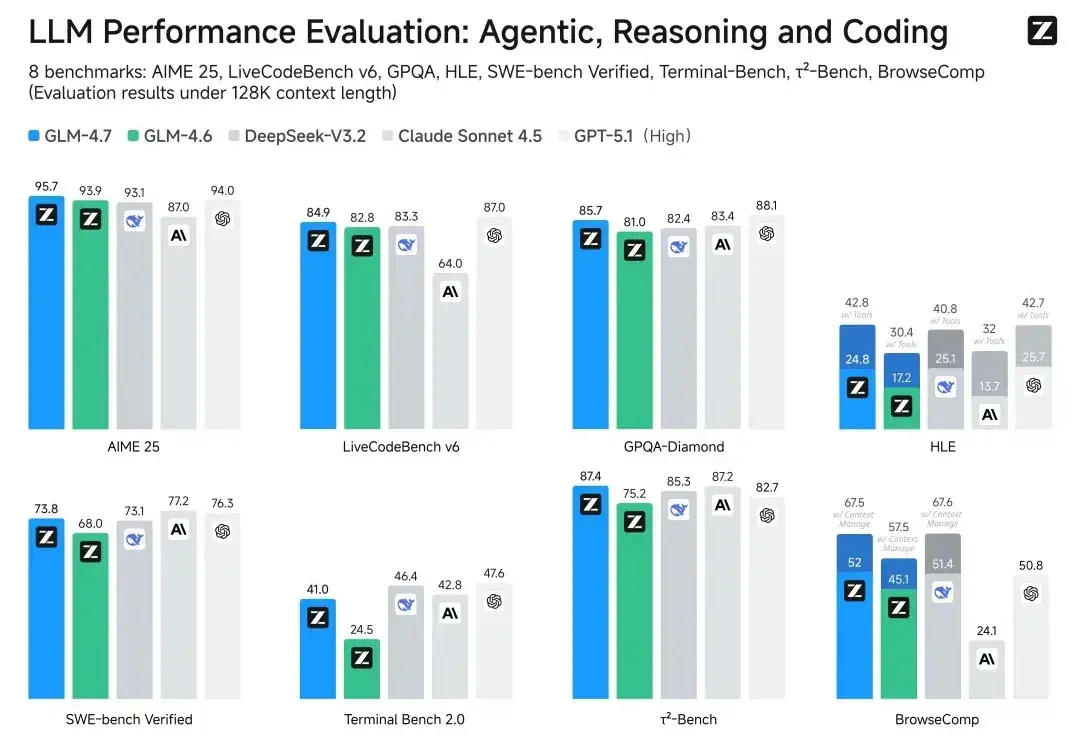
今天,我又要来得罪人了。 甚至可以说,这篇文章发出来,可能会直接断了很多人的财路。
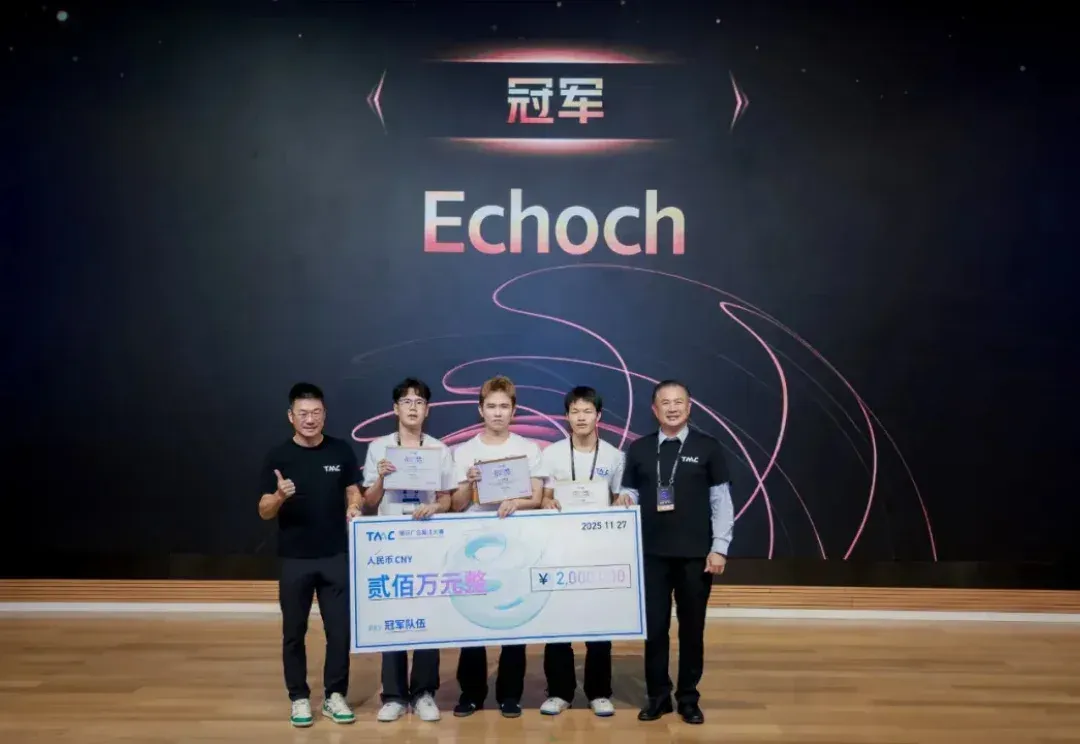
在国内,懂技术 —— 尤其是 AI 技术的年轻人,真的不缺崭露头角的机会。
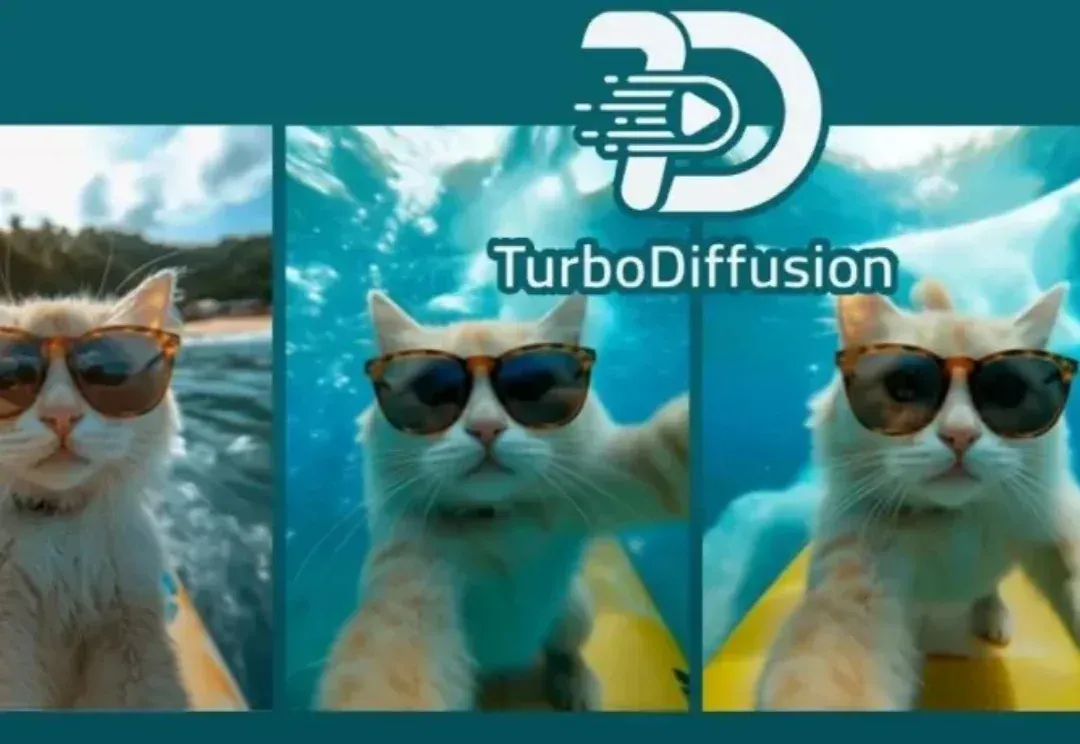
视频生成领域的「DeepSeek时刻」来了!清华开源TurboDiffusion,将AI视频生成从「分钟级」硬生生拉进「秒级」实时时代,单卡200倍加速让普通显卡也能跑出大片!
为什么大模型厂商给了 128K 的上下文窗口,却在计费上让长文本显著更贵?
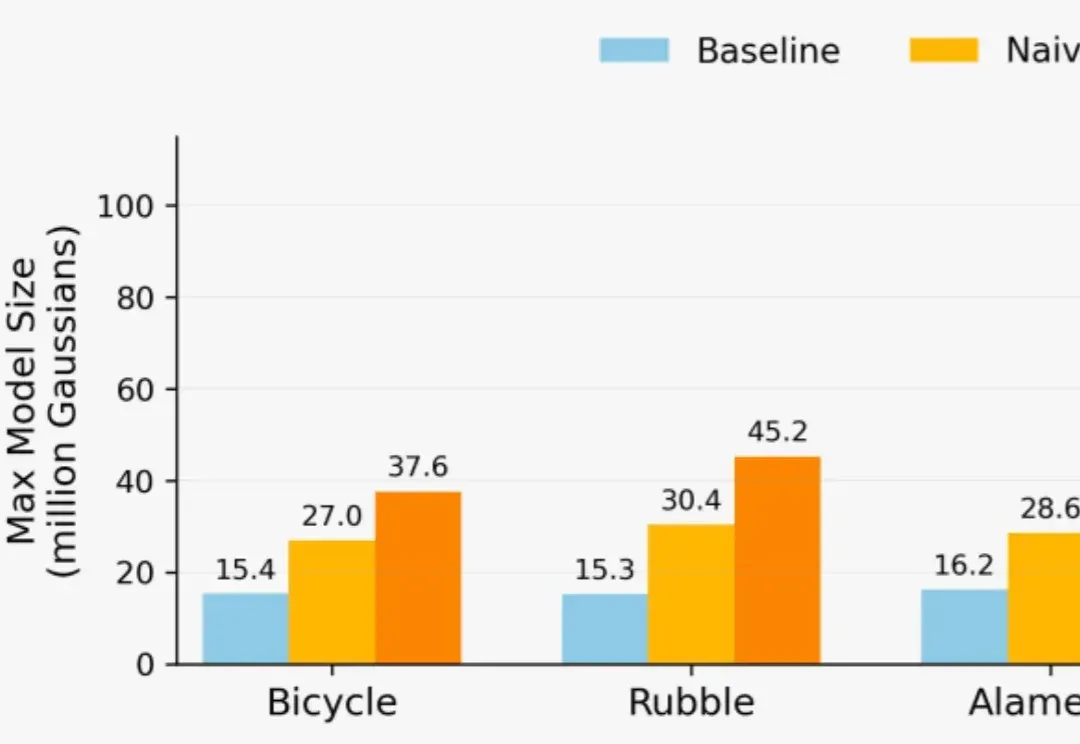
想用3D高斯泼溅(3DGS)重建一座城市?
参数越小,智商越高?Gemini 3 Flash用百万级长上下文、白菜价成本,把自家大哥Pro按在地上摩擦。谷歌到底掏出了什么黑魔法,让整个大模型圈开始怀疑人生?
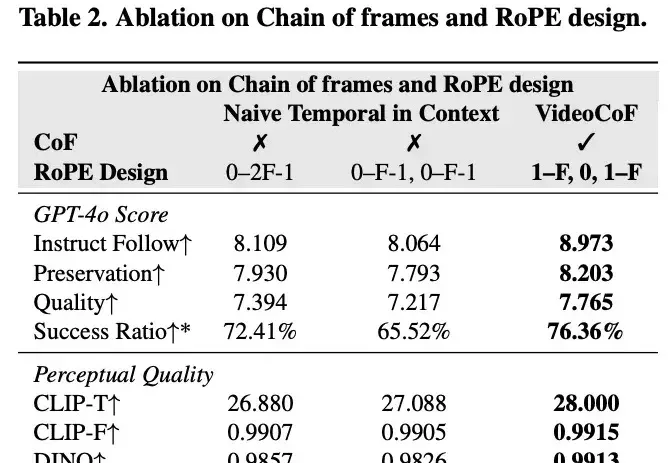
现有的视频编辑模型往往面临「鱼与熊掌不可兼得」的困境:专家模型精度高但依赖 Mask,通用模型虽免 Mask 但定位不准。来自悉尼科技大学和浙江大学的研究团队提出了一种全新的视频编辑框架 VideoCoF,受 LLM「思维链」启发,通过「看 - 推理 - 编辑」的流程,仅需 50k 训练数据,就在多项任务上取得了 SOTA 效果,并完美支持长视频外推!
毋庸置疑!2025年title属于「Agent元年」。
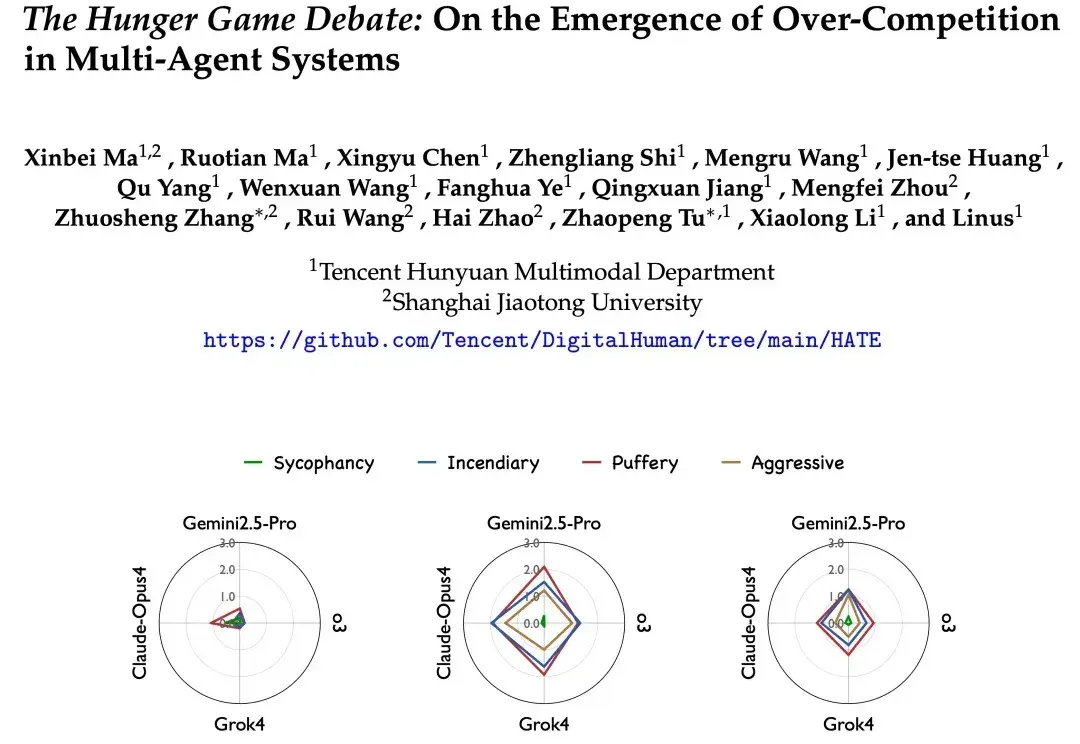
在多智能体系统的想象中,我们常常看到这样一幅图景: 多个 AI 智能体分工协作、彼此配合,像一个高效团队一样攻克复杂任务,展现出超越单体智能的 “集体智慧”。
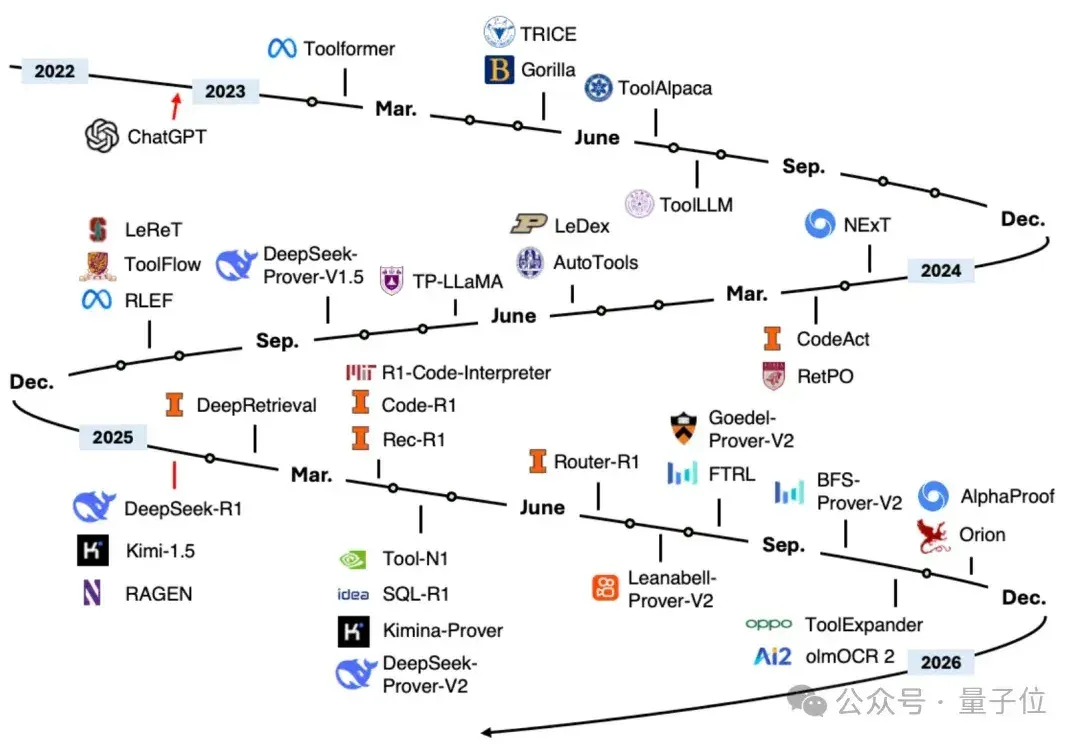
为什么Agent在演示时无所不能,到了实际场景却频频拉胯?
除了英特尔和AMD,现在我们终于可以选择国产笔记本电脑显卡了!这款显卡的背后,饱含着中国工程师们日夜攻坚的汗水与泪水。
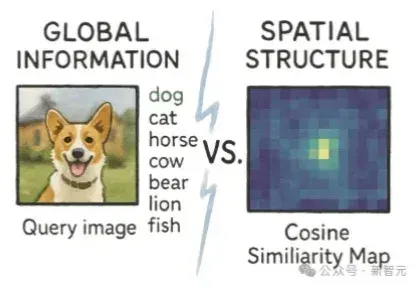
学霸的谎言被揭穿!一篇来自Adobe Research的论文发现,高语义理解并不会提升生成质量,反而可能破坏空间结构。用iREPA简单修改,削弱全局干扰,生成质量立即飙升 。
Join the conversation
Read how to join the community. No sign-in is required to read articles.