GLM-5真够顶的:超24小时自己跑代码,700次工具调用、800次切上下文!(在新窗口打开)
当看到GLM-5正式发布后的能力,才惊觉前几天神秘模型Pony Alpha的热度还是有点保守了。
内容栏目
分享不同 AI 工具、模型与相关技术的使用方法和实践文章。
当看到GLM-5正式发布后的能力,才惊觉前几天神秘模型Pony Alpha的热度还是有点保守了。
就是说,这几天还有哪档晚会节目是没有机器人现身的吗?
过去几年,大模型把自然语言处理彻底重塑了。GPT 出来之前,NLP 领域的状态是:每个任务一套模型,每个场景一批数据,每个公司一条流水线,互不通用,边界清晰。GPT 之后,这套逻辑被一个预训练底座 + 任务微调的范式整个替换掉了。
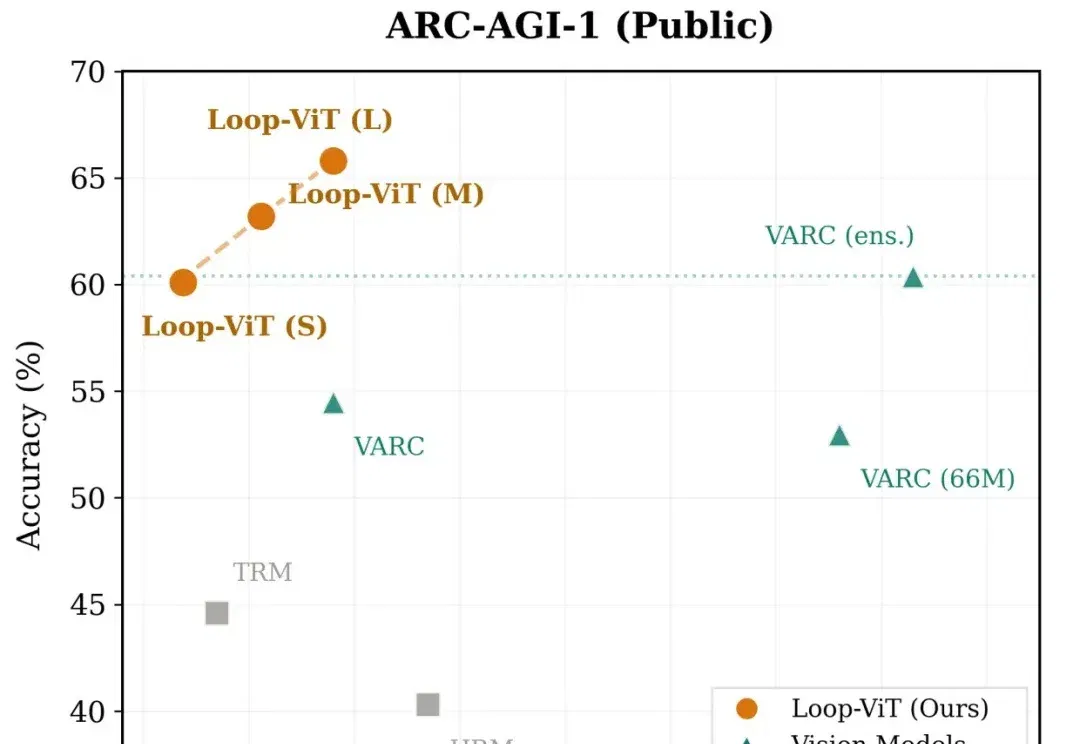
当我们解一道复杂的数学题或观察一幅抽象图案时,大脑往往需要反复思考、逐步推演。然而,当前主流的深度学习模型却走的是「一次通过」的路线——输入数据,经过固定层数的网络,直接输出答案。
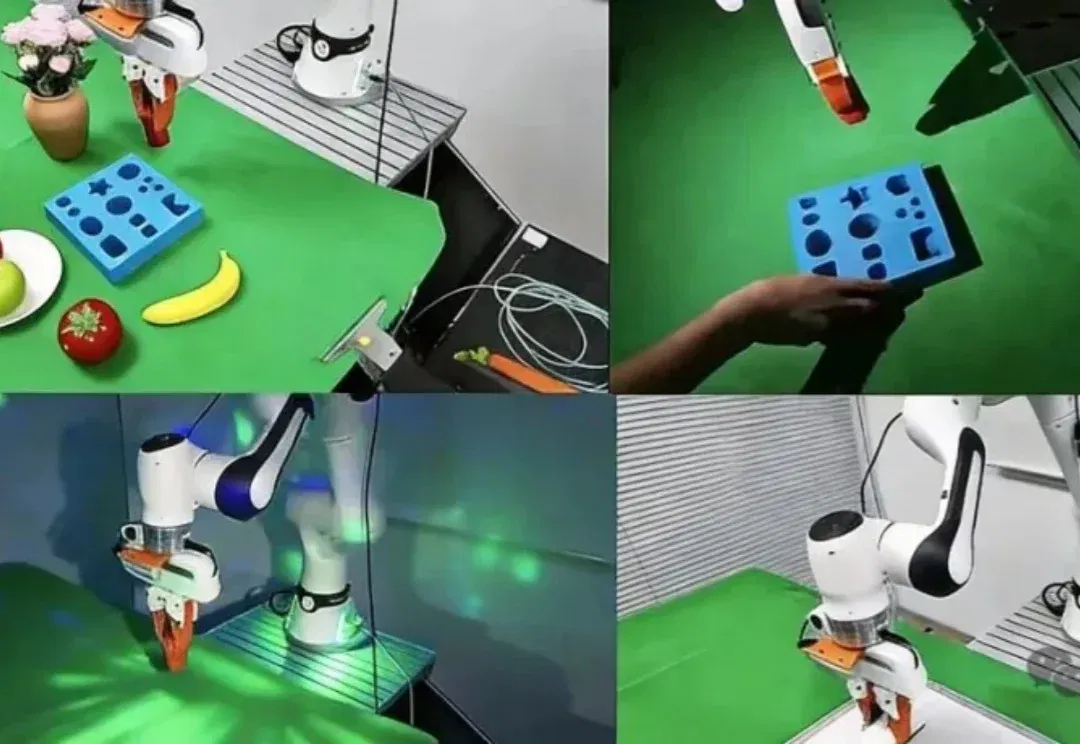
TwinRL用手机扫一遍场景构建数字孪生,让机器人先在数字孪生里大胆探索、精准试错,再回到真机20分钟跑满全桌面100%成功率——比现有方法快30%,人类干预减少一半以上。
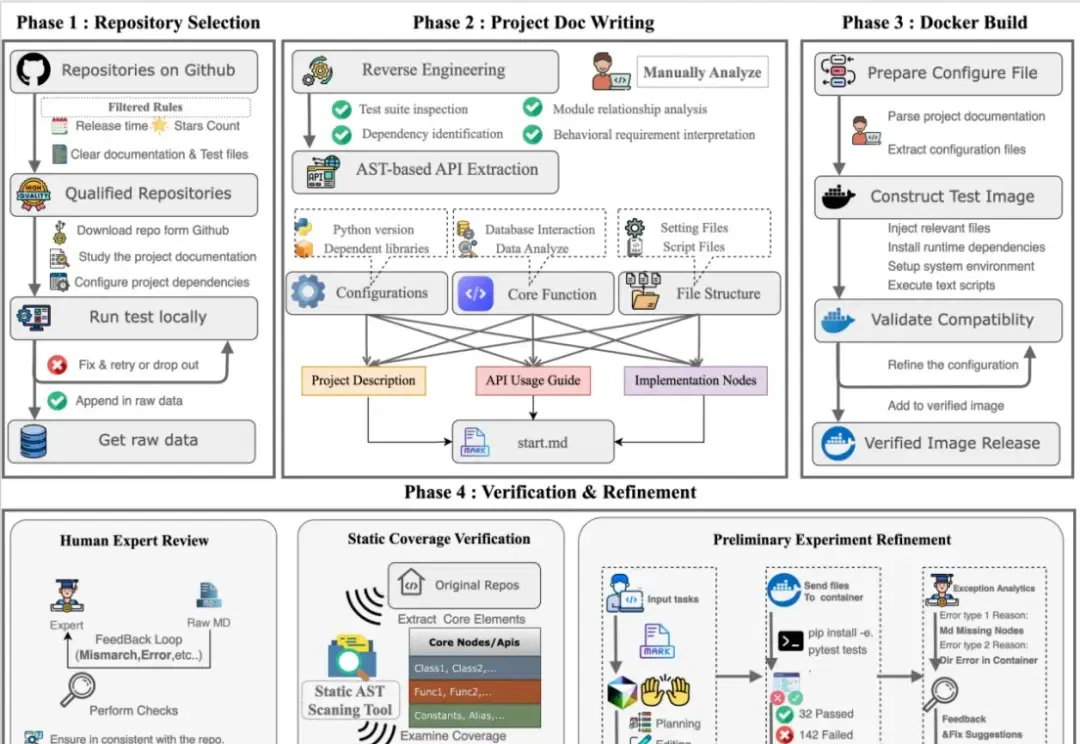
在 AI 编程领域,大家似乎正处于一个认知错觉的顶点:随着 Coding Agents 独立完成任务的难度和范围逐渐增加,Coding 领域的 AGI 似乎就可以实现?
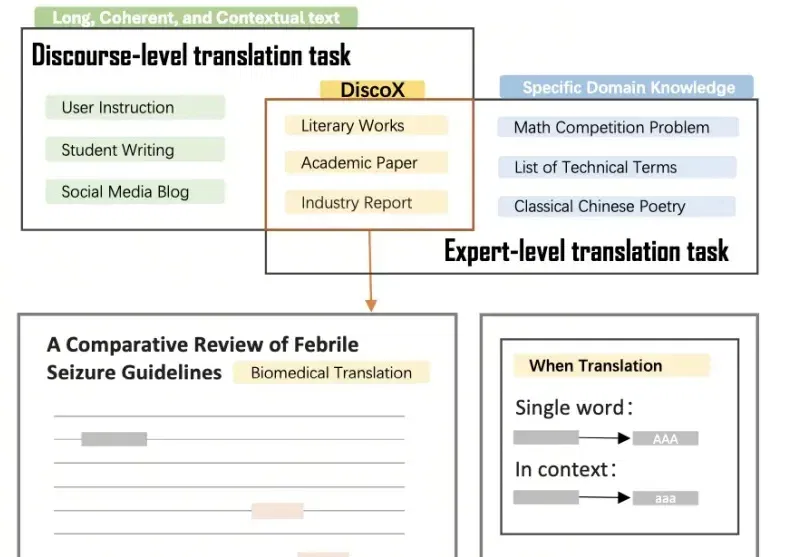
DiscoX构建了一套200题的长文翻译数据集,以平均长度1,712 tokens的长篇章做评测单元,要求整个长文文本作为一个整体来翻译,除翻译准确度外,重点考察跨段落的逻辑与风格一致性、上下文中的术语精确性、以及专业写作规范,贴合用户真实的使用场景。
这个国产开源模型,把多模态玩出了“魔法”感。
春节还没到,「过年的气氛」已经渗入科技圈每个人的毛孔。单说 AI 大模型这一块,刚刚发布的有 kimi 2.5 和 Step 3.5 Flash,即将发布的据说还有 DeepSeek V4,GPT-5.3、Claude Sonnet 5、Qwen 3.5,GLM-5,说不定一觉醒来,现有的技术就要被颠覆。
2026 马年注定迎来一个「AI 味」最浓的春节。
2026 开年至今,人工智能圈子最火的是一只小龙虾 Clawdbot 。
过去一年,大模型写代码的能力几乎以肉眼可见的速度提升。从简单脚本到完整功能模块,GPT、Claude、DeepSeek 等模型已经能够在几秒钟内生成看起来相当 “专业” 的代码。
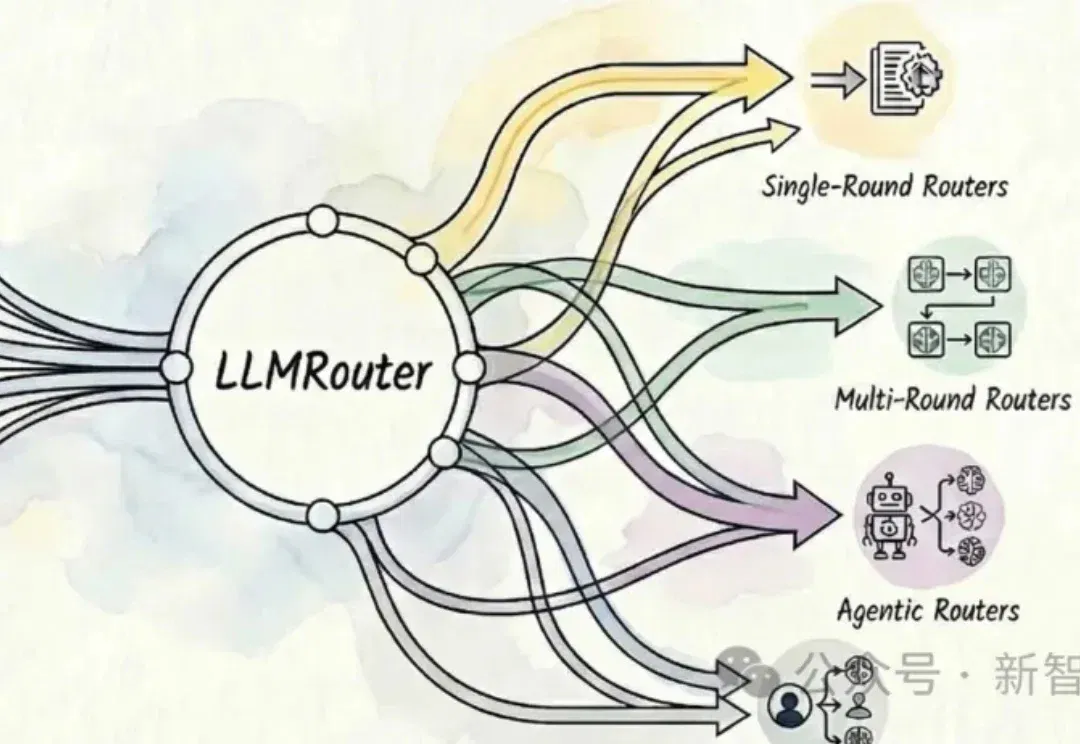
UIUC开源的智能模型路由框架LLMRouter可以自动为大模型应用选择最优模型,提供16+路由策略,覆盖单轮选择、多轮协作、个性化偏好和Agent式流程,在性能、成本与延迟间灵活权衡。
最强的大模型,已经把scaling卷到了一个新维度:百万级上下文。
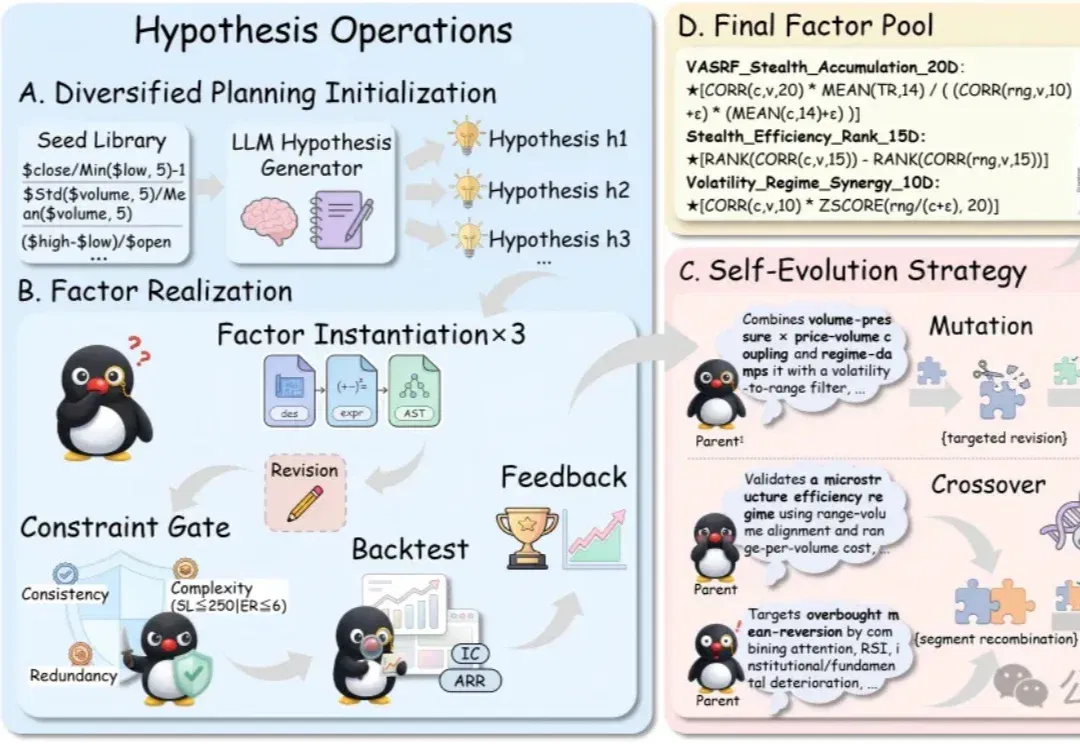
在量化金融的底层,Alpha因子本质上是一段可执行的代码逻辑,它们试图将嘈杂的市场数据映射为精准的交易信号。
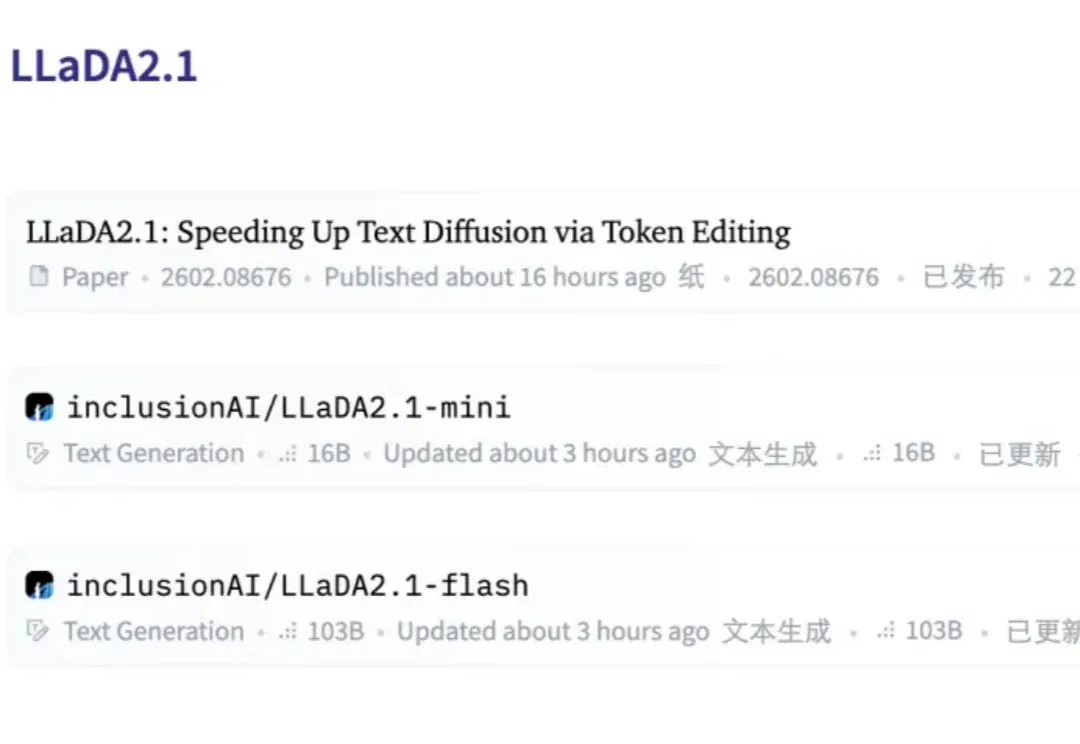
扩散语言模型(dLLM),这个曾被认为是「小众赛道」的研究方向,如今终于迎来了质变。
在经济学和博弈论的世界里,找到「纳什均衡」往往意味着找到了复杂局势下的最优解。多所顶尖高校的研究人员开发出了一位名为PrimeNash的「AI数学家」,不仅能像人类专家一样推导公式,还能解决许多连传统算法都束手无策的复杂博弈难题,成果已发表在Cell Press旗下的交叉学科期刊Nexus上。
Anthropic刚刚扔出一份18页重磅炸弹:《2026年智能体编码趋势报告》。结论直接炸裂:程序员不再写代码了,他们变成了「指挥官」。
思考token在精不在多。Yuan 3.0 Flash用RAPO+RIRM双杀过度思考,推理token砍75%,网友们惊呼:这就是下一代AI模型的发展方向!
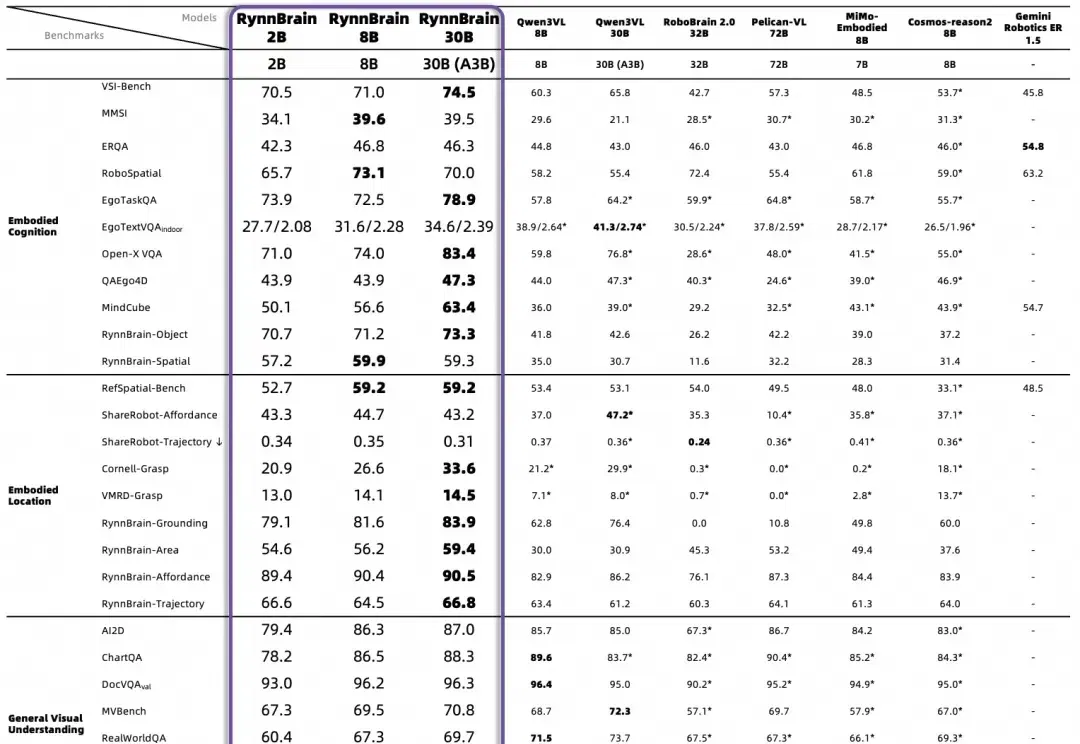
你斥巨资买回家的全能家务机器人,正在执行“把药片拿给奶奶”的任务。
参与交流
了解加入交流群的方式,阅读内容无需登录。