ICLR 2026 Oral | 大道至简!斯坦福、英伟达、新国立联合推出InfoTok,用信息论重新定义高效视频分词 (opens in a new tab)
在生成式 AI 领域,视觉分词器(Visual Tokenizer)通常采用固定压缩率 —— 无论是单调的监控画面,还是复杂的动作大片,都被切分为等量的 Token。这种 "一刀切" 的做法不仅会造成巨大的计算冗余,也产生了 “信息量” 不同的 Token,不利于下游理解生成任务处理。
Categories
Practical guides to AI tools, models and related technologies.
在生成式 AI 领域,视觉分词器(Visual Tokenizer)通常采用固定压缩率 —— 无论是单调的监控画面,还是复杂的动作大片,都被切分为等量的 Token。这种 "一刀切" 的做法不仅会造成巨大的计算冗余,也产生了 “信息量” 不同的 Token,不利于下游理解生成任务处理。
您在使用LLM时,如果遇到它胡说八道或者彻底偏题,第一反应是什么?大概率是直接关掉窗口,新开一个对话,懒得跟机器废话。但您可能不知道,这个看似再正常不过的习惯,正在给下一代大语言模型的训练库疯狂“投毒”。
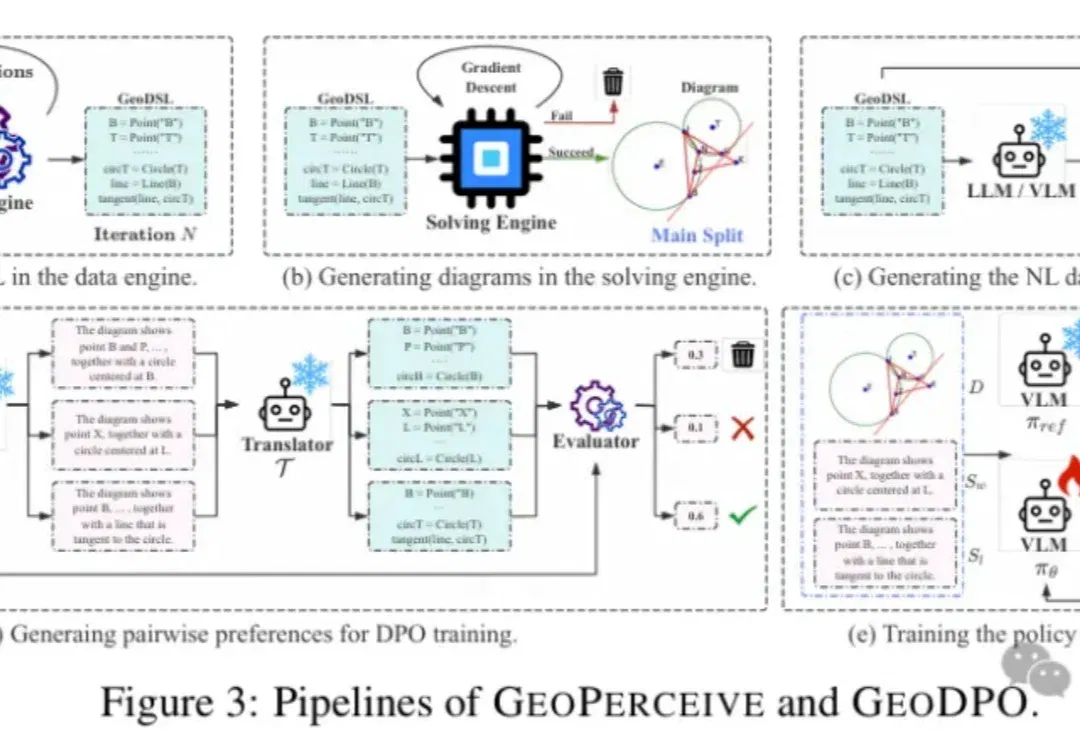
几何问题,真的只是“推理难”吗? 近年来,视觉语言模型(VLMs)在图文问答、表格理解、数学应用题等多模态任务上取得了显著进展。 但当问题变成几何图形时,它们的表现却往往明显下降。 为什么? 近日,来自光明实验室与清华大学的研究团队深入剖析了多个主流模型的错误案例,观察到一个值得关注的现象: 当前VLM在几何问题上的失败,很大程度上暴露出其几何感知错误(perceptual errors)的短板,而这一核心因素在现有研究中往往未被单独系统分析。 换句话说,在不少情况下,模型并不是不会推理,而是在更早阶段——对图形结构的识别已经出现偏差。 常见问题包括: 错误识别几何基本元素(点、线、圆)漏检关
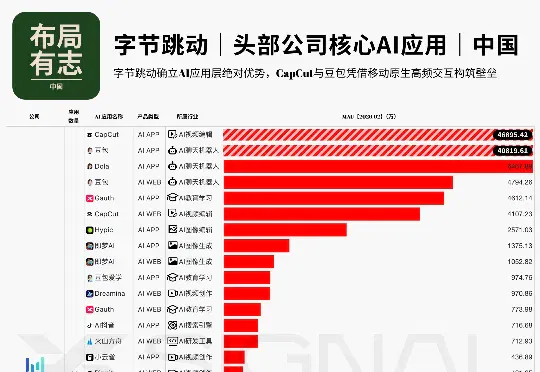
大模型的狂热已然退潮。当我们将目光从参数榜单转向真实的活跃数据,四家头部大厂的底层商业图谱已极度收敛。AI的竞争,早已变成一场基于算力成本与高频场景的残酷算账。
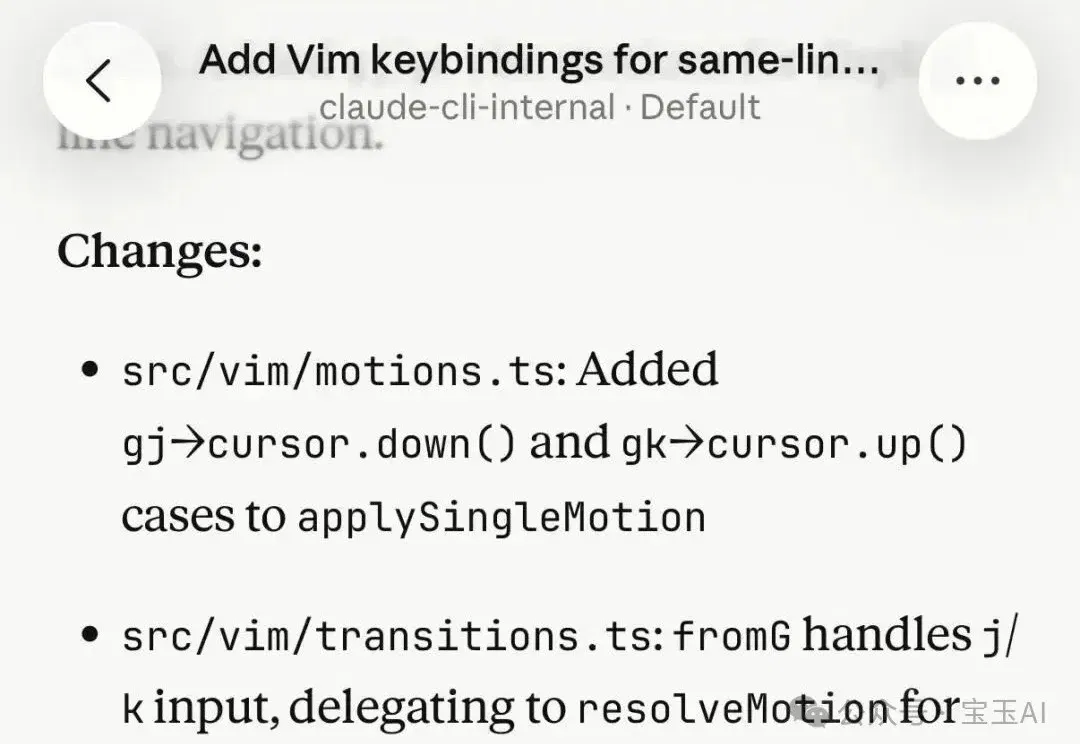
你日常用 Claude Code,用了多少功能?手机上写代码?语音编程?让 Claude 每 5 分钟自动帮你处理代码审查?
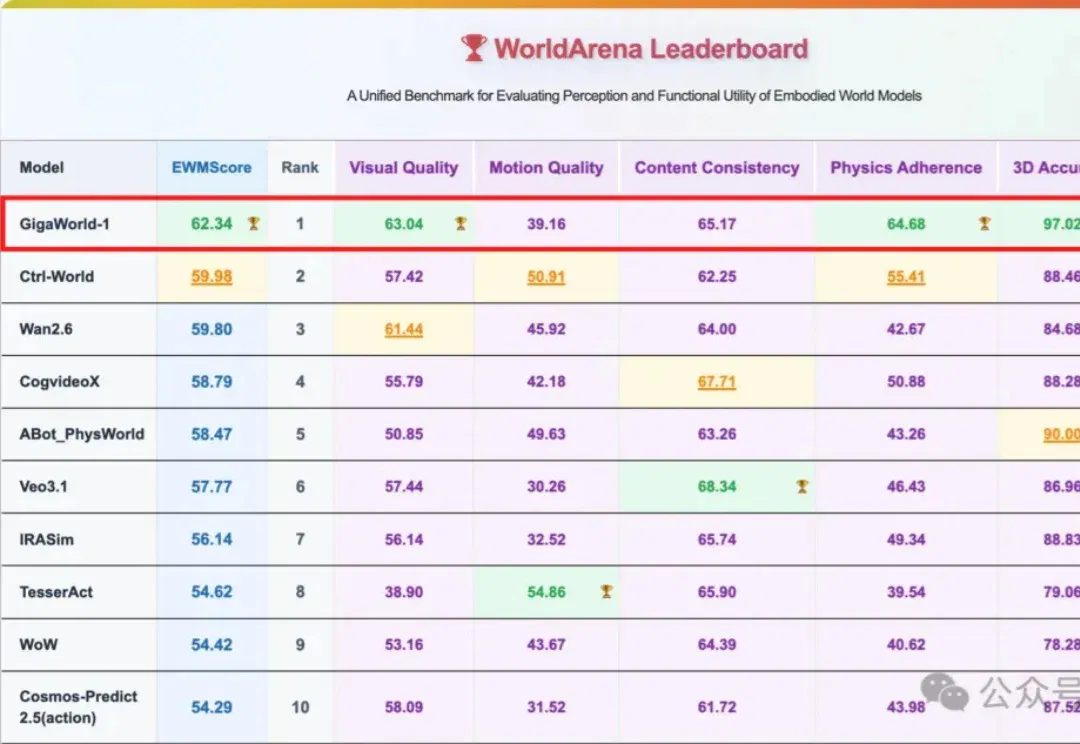
还得是咱国产世界模型牛! 极佳视界最新力作GigaWorld-1,直接击穿谷歌英伟达,WorldArena登顶全球第一。 而且还是唯一一个综合得分突破60分大关的具身世界模型。 什么概念呢?就以三大核心维度为例,几乎是断层式领先: Physics Adherence(物理遵循):相比第二名提升了整整16%。3D Accuracy(3D准确度):近乎逼近满分。Visual Quality(视觉质量):同样遥遥领先。 也就是说,GigaWorld-1是真正的全能型具身世界模型,不仅视觉真实,而且几何精准、物理准确。 这意味着,极佳视界这家由清华系领衔,汇聚了阿里、百度、地平线等一众顶尖大厂核心骨干
我们对 AI 的爱与怕,是同一个东西。 关于 AI 的讨论,好像永远只有两种声音: 「它会毁灭世界」和「它会拯救一切」。 很少有人停下来问一句:那些真正在用 AI 的普通人,他们怎么想? Anthropic 刚刚发布了一份万字报告,试图回答这个问题。 他们做了件很有意思的事,让 Claude 充当访谈员,和全球用户一对一深聊:人和 AI 互动式追问,话题是每个人对 AI 最深层的期待和最真实的不安。最终收到了来自 159 个国家、70 种语言的 80508 份深度对话。 我花了一晚上读完了这篇报告,里面的案例非常真实和生动: 里面有乌克兰战区里的士兵,讲 AI 怎么在炮火中给他们精神力量,帮他
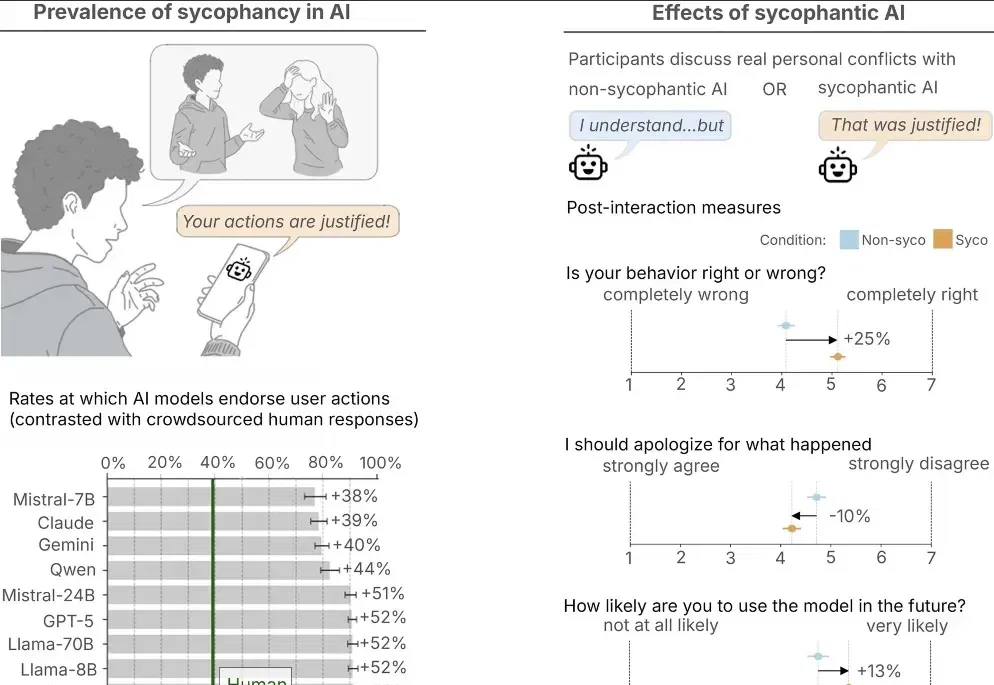
自从大语言模型诞生起至今,AI 已经润物无声地融入了我们的工作生活,也成为了现代社会的重要组成部分。
本文综合北京大学王选计算机研究所发布的 ProactiveVideoQA 和 MMDuet2 两篇论文,介绍视频多模态大模型如何实现 “主动交互”—— 在视频播放过程中自主决定何时发起回复,而非等待用户提问。ProactiveVideoQA 提出评估指标和 benchmark,MMDuet2 则通过强化学习训练方法实现了 SOTA 性能,无需精确的回复时间标注即可训练出及时、准确的主动交互模型。
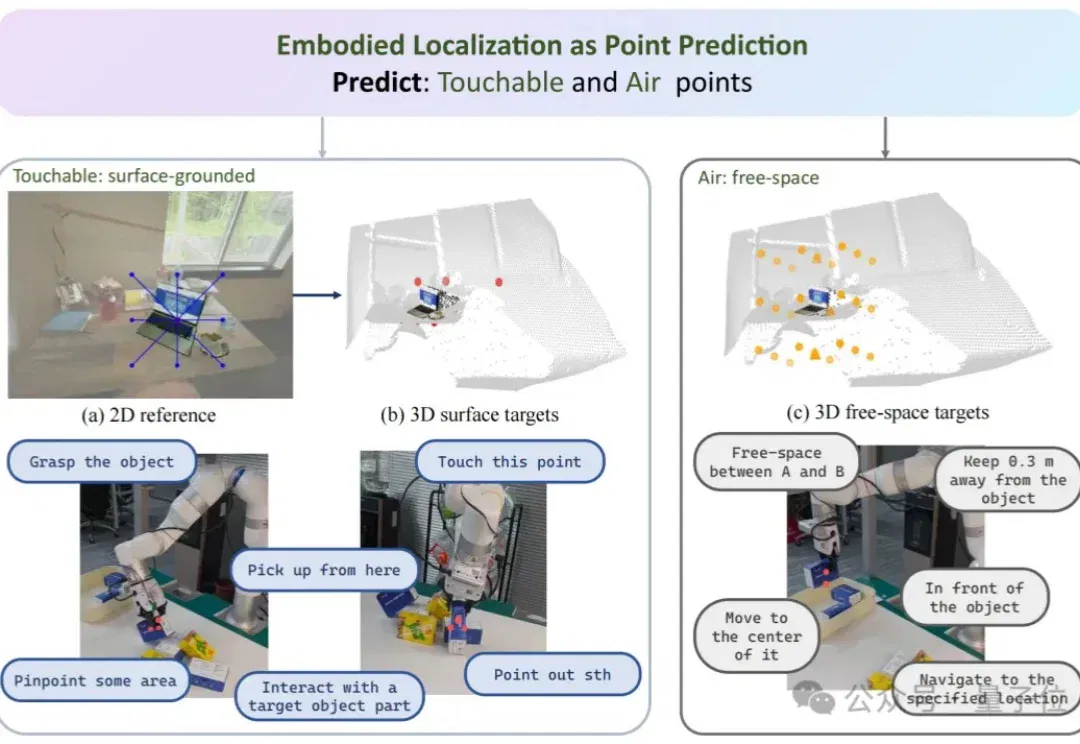
机器人能认出杯子,却看不懂杯口朝哪、离自己多远、该抓哪里。
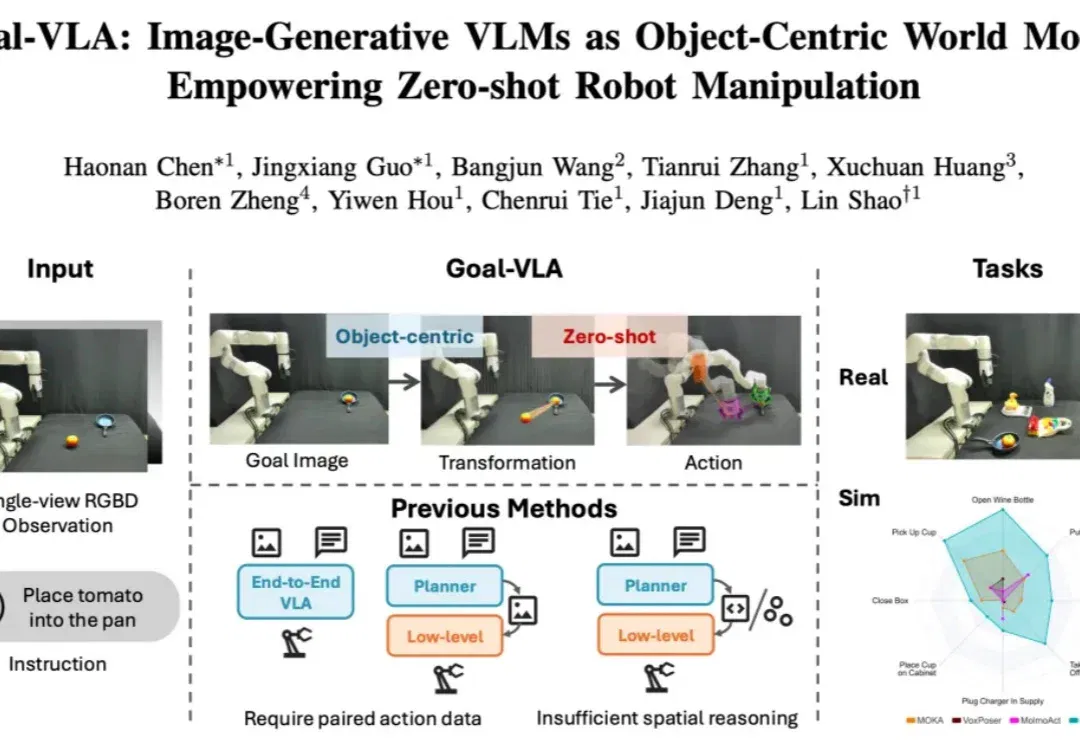
在具身智能领域,机器人操作的泛化能力一直是一个核心挑战。当前,视觉 - 语言 - 动作(VLA)模型主要分为两大范式:端到端模型与分层模型。端到端 VLA 模型(如 RT-2 [1], OpenVLA [2])严重依赖海量的 “指令 - 视觉 - 动作” 成对数据,获取成本极高,导致其在面对新任务或新场景时零样本泛化能力受限。
最近,AI 圈子里又冒出一个新词:Harness Engineering。
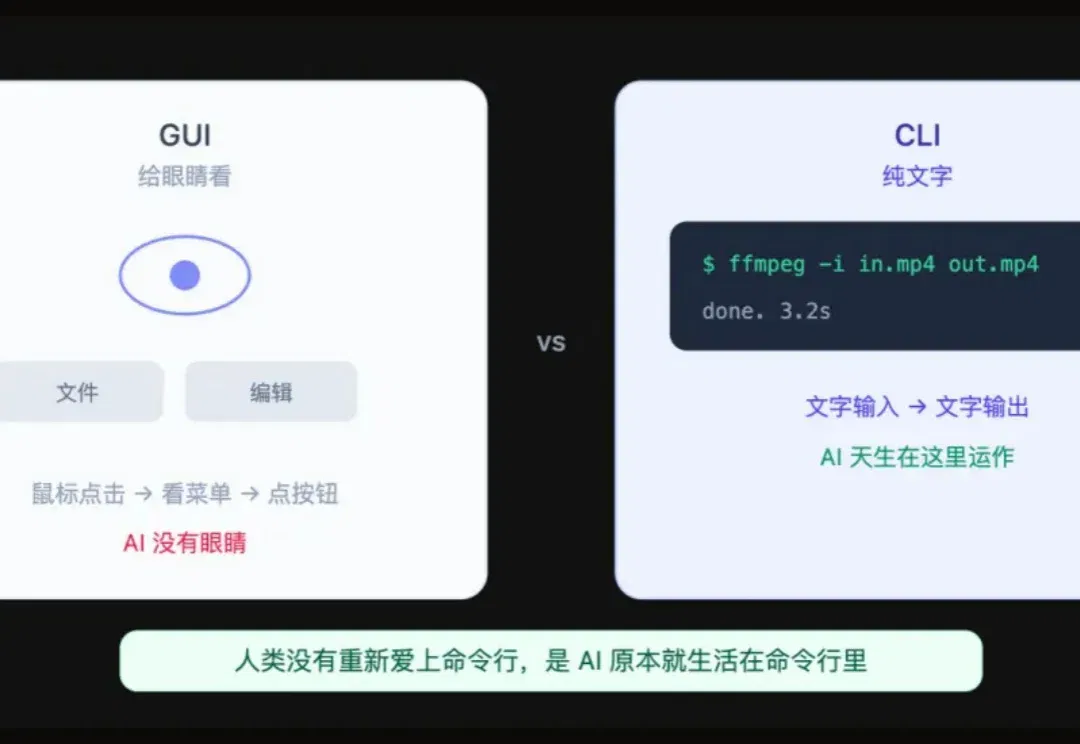
飞书、Google、Stripe、ElevenLabs、网易云音乐。 最近几个月,一群看起来毫不相关的公司不约而同做了同一件事:发布 CLI 工具。
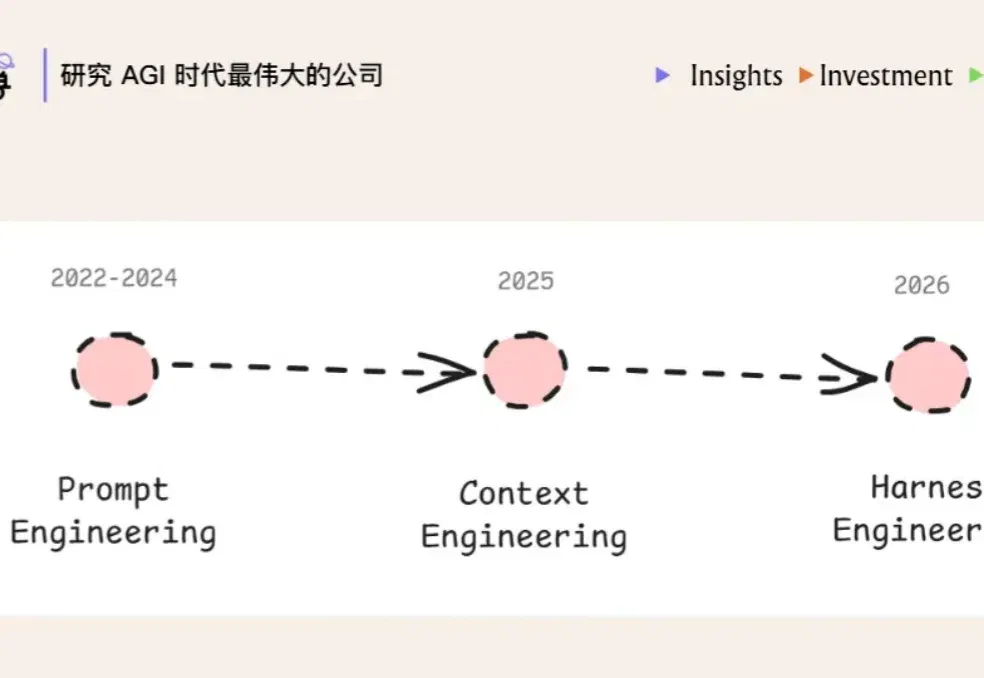
最近,harness engineering 又成了继 prompt engineering、context engineering 之后新一代的 buzzword。
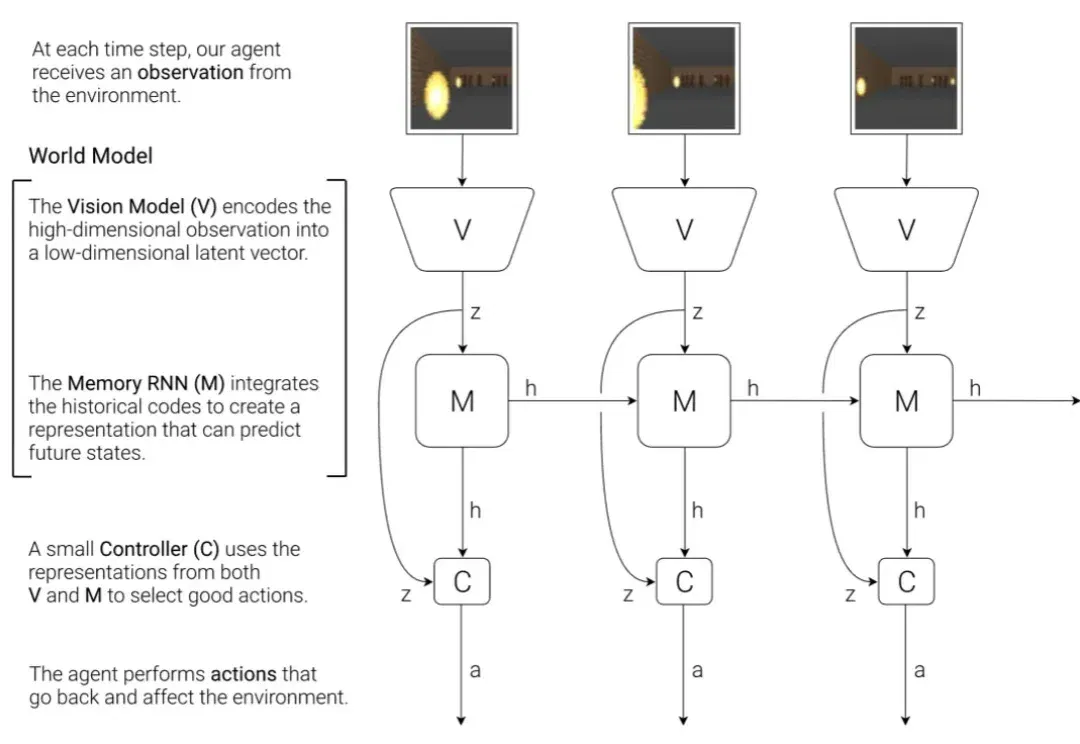
当世界模型越来越大,真正制约它走向「内部模拟器」的,未必是表征能力,而可能是动力学建模。
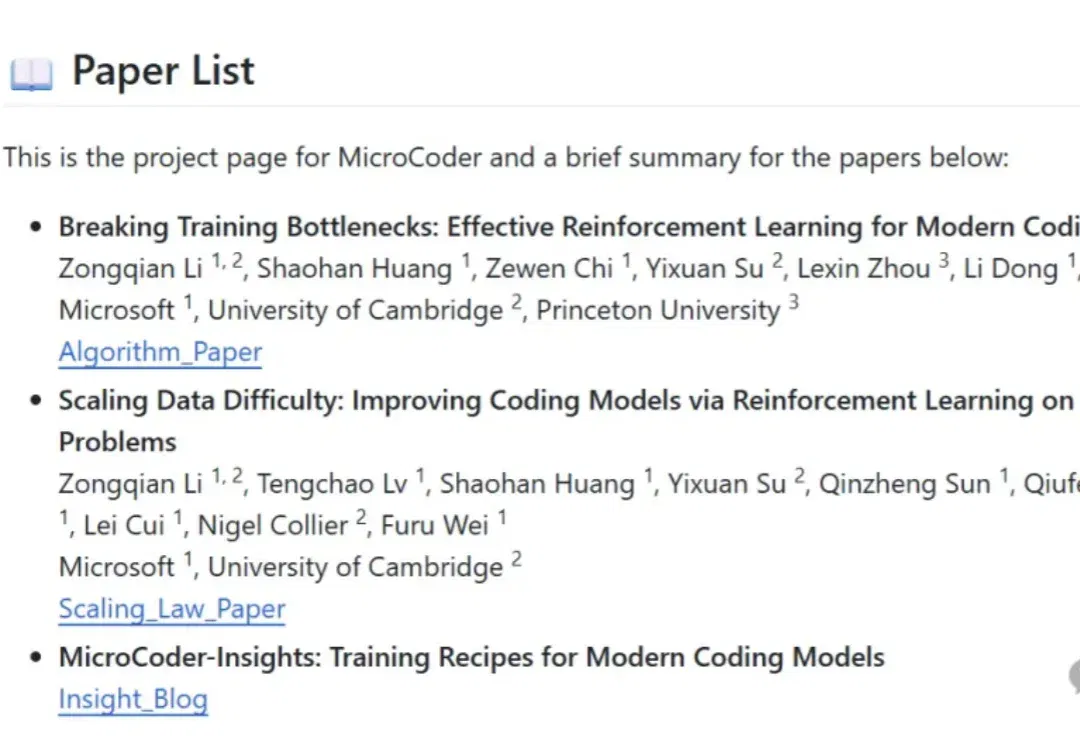
新一代代码模型的训练动态已与旧模型截然不同,主流强化学习方法和数据集在其上几乎“失效”。
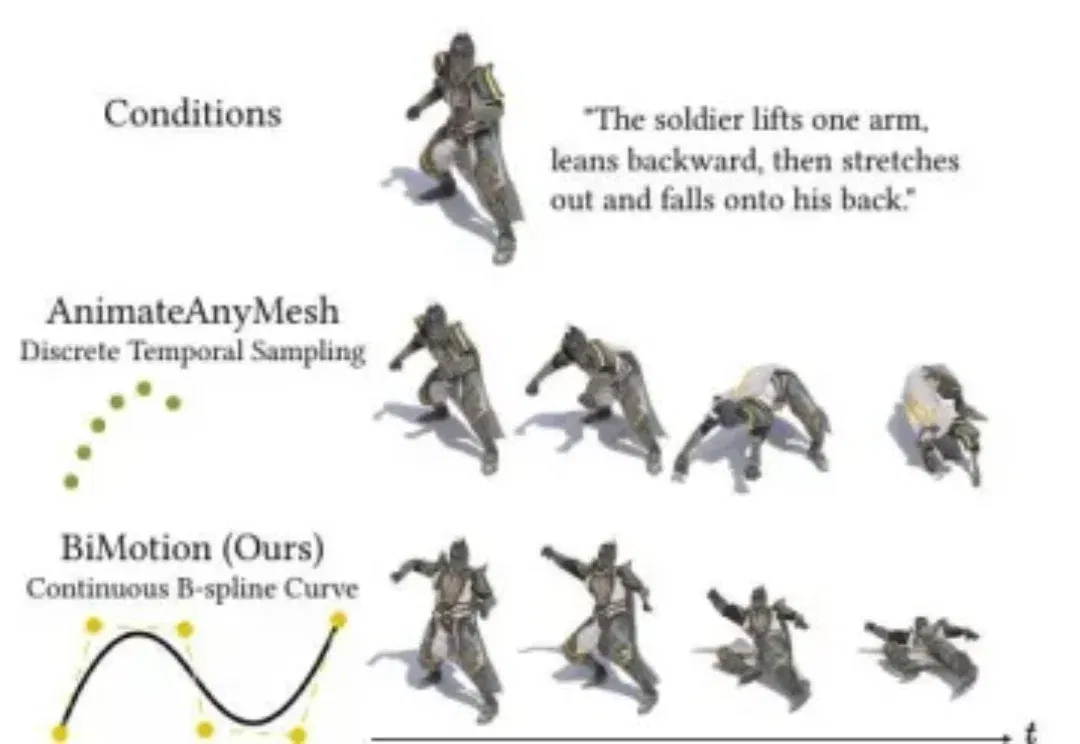
当你希望 AI 将 "士兵举起手臂,向后倾身,然后身体向前扑倒" 这段文字转化为一段 3D 角色动画,现有大多数方法给出的答案是:一段摇摇晃晃、语义残缺的短片段。这并非模型能力不足,问题的根源在于将运动表达为逐帧离散序列这一根本性的设计决策。
大家好,我是吴师兄。 之前有个学员面阿里的 NLP 岗,简历上写着"搭建了基于 RAG 的企业知识问答系统"。面试官翻着简历问: "你们知识库有多少文档?什么格式?" 他说:"大概 5000 份,PD
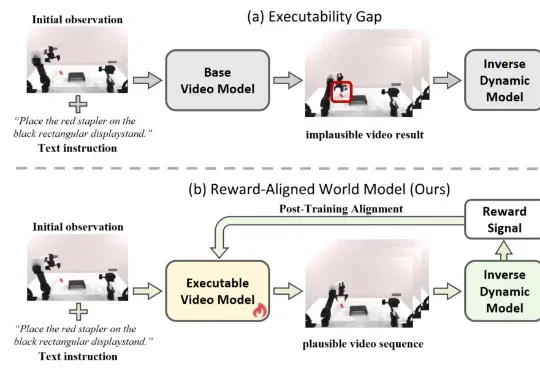
近期,利用视频生成模型为机器人构建 “世界模型”,已成为具身智能领域的热门技术路线。给定当前观测和自然语言指令,这类模型能够先 “想象” 出未来的视觉轨迹,再由逆动力学模型(IDM)将生成画面解码为机器人动作,从而形成 “先预测、后执行” 的解耦式规划范式。由于兼具较强的可解释性与开放场景泛化潜力,这一路线正在受到学术界和工业界的广泛关注。
硅心科技(aiXcoder)发布了一款专为「代码变更应用」场景设计的高性能、轻量级模型 aiX-apply-4B。基准测试结果显示,在 20 多种主流编程语言及 Markdown 等多类型文件格式的测试中,aiX-apply-4B 的平均准确率达到 93.8%,超越 Qwen3-4B 基座模型 62.6% 的准确度
Join the conversation
Read how to join the community. No sign-in is required to read articles.