GLM-5 技术报告全解读|a16z:“最好的开源模型”(在新窗口打开)
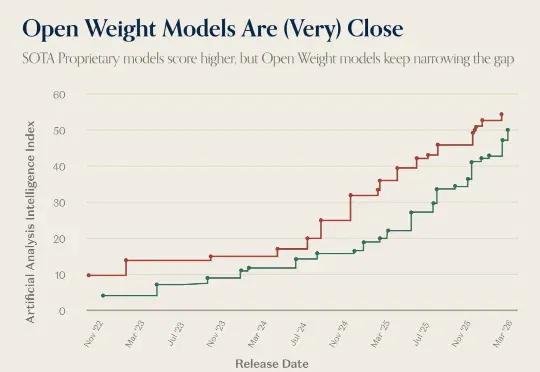
a16z 昨天发了一张图,把 GLM-5 和 Claude Opus 4.6 并排标注在 Artificial Analysis Intelligence Index 的时间线上。原文的说法是: A proprietary model (Claude Opus 4.6) is still the 'most intelligent,' but the gap between
内容栏目
分享不同 AI 工具、模型与相关技术的使用方法和实践文章。
a16z 昨天发了一张图,把 GLM-5 和 Claude Opus 4.6 并排标注在 Artificial Analysis Intelligence Index 的时间线上。原文的说法是: A proprietary model (Claude Opus 4.6) is still the 'most intelligent,' but the gap between
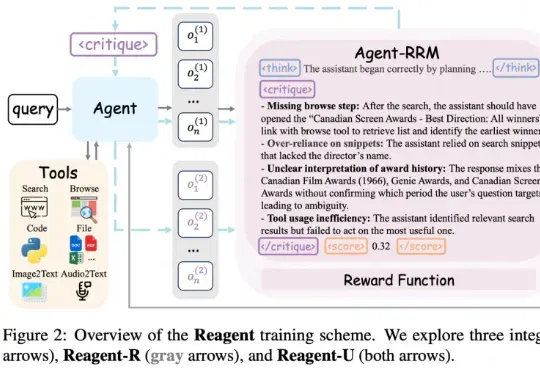
在很多大模型和 Agent 的训练里,最常见的一种做法就是只看结果:最后答案对了就给奖励,错了就当 0 分。 在单轮问答里,这样「只看结果」还勉强能用;可一旦换成 Agent 这种要多轮对话、搜索、刷
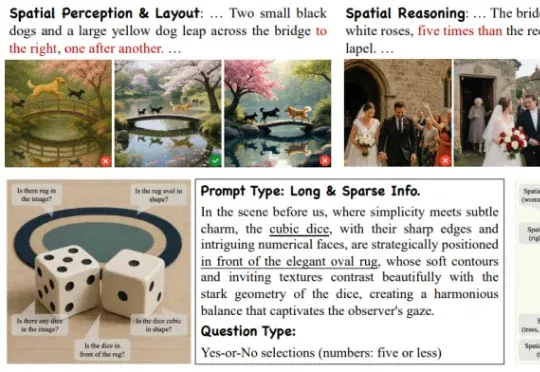
来自阿里高德的一篇最新 ICLR 2026 中稿论文《Everything in Its Place: Benchmarking Spatial Intelligence of Text-to-Image Models》提出了面向文生图空间智能的系统性评估基准 SpatialGenEval,旨在通过长文本、高信息密度的 T2I prompt 设计,以及围绕空间感知
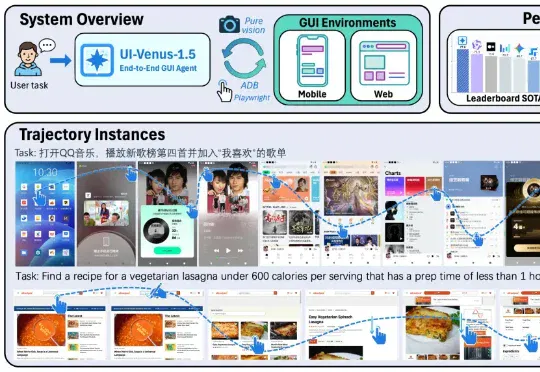
GUI 智能体最近卷到什么程度了?Claude、OpenAI Agent 及各类开源模型你方唱罢我登场,但若真想让 AI 成为 「能在手机和网页上稳定干活的助手」,仍绕不开三大现实难题:
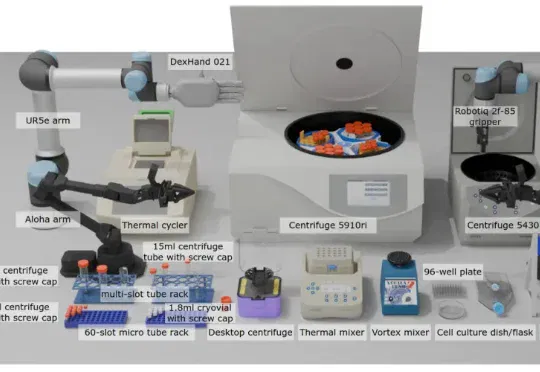
现有 VLA 模型的研究和基准测试多局限于家庭场景(如整理餐桌、折叠衣物),缺乏对专业科学场景(尤其是生物实验室)的适配。生物实验室具有实验流程结构化、操作精度要求高、多模态交互复杂(透明容器、数字界面)等特点,是评估 VLA 模型精准操作、视觉推理和指令遵循能力的理想场景之一。
机器之心编译 如果把人生看作一个开放式的大型多人在线游戏(MMO),那么游戏服务器在刚刚完成一次重大更新的时刻,规则改变了。 自 2022 年 ChatGPT 惊艳亮相以来,世界已经发生了深刻变化。在
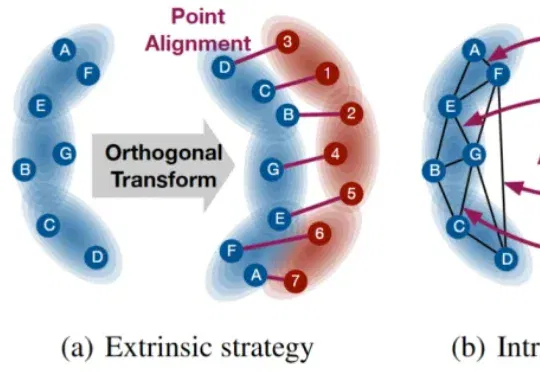
本文提出一种具有 SE(p) 不变传输性质的度量 SEINT:通过构造无需训练的 SE(p) 不变表示,将高维结构信息压缩为可用于 Optimal Transport (OT) 对齐的一维表征,从而在保持不变性与严格度量性质的同时显著提升效率。
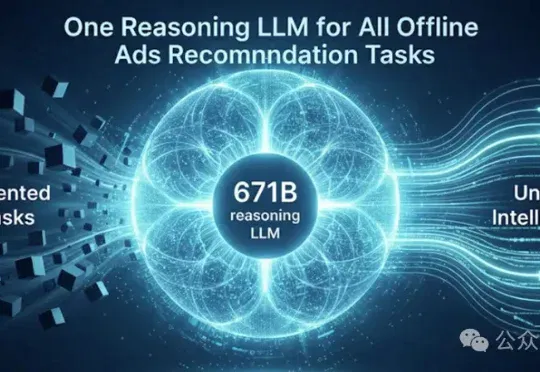
近日,微软Bing Ads与DKI团队发表论文《AdNanny: One Reasoning LLM for All Offline Ads Recommendation Tasks》,宣布基于DeepSeek-R1 671B打造了统一的离线推理中枢AdNanny,用单一模型承载所有离线任务。这标志着从维护一系列任务特定模型,转向部署一个统一的、推理中心化的基础模型,从
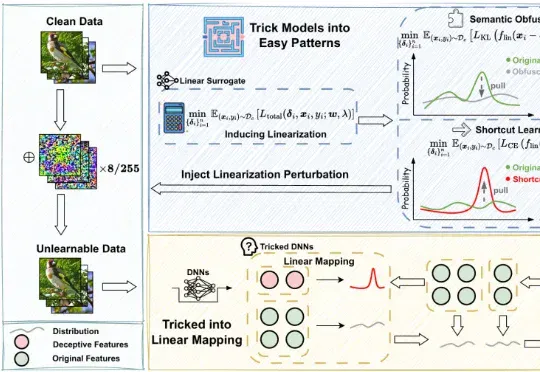
不可学习样本(Unlearnable Examples)是一类用于数据保护的技术,其核心思想是在原始数据中注入人类难以察觉的微小扰动,使得未经授权的第三方在使用这些数据训练模型时,模型的泛化性能显著下降,甚至接近随机猜测,从而达到阻止数据被滥用的目的。
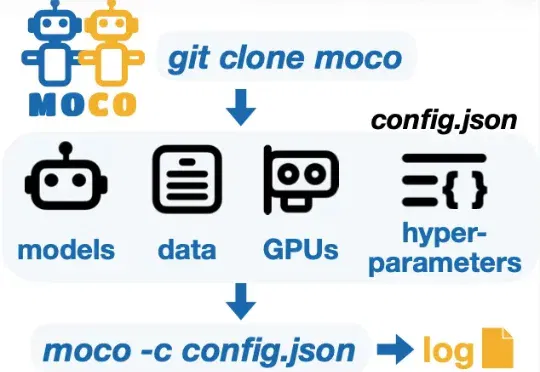
为了支持多模型协同研究并加速这一未来愿景的实现,华盛顿大学 (University of Washington) 冯尚彬团队联合斯坦福大学、哈佛大学等研究人员提出 MoCo—— 一个针对多模型协同研究的 Python 框架。MoCo 支持 26 种在不同层级实现多模型交互的算法,研究者可以灵活自定义数据集、模型以及硬件配置,比较不同算法,优化自身算法,以此构建组合式人工智能系统。MoCo 为设计、
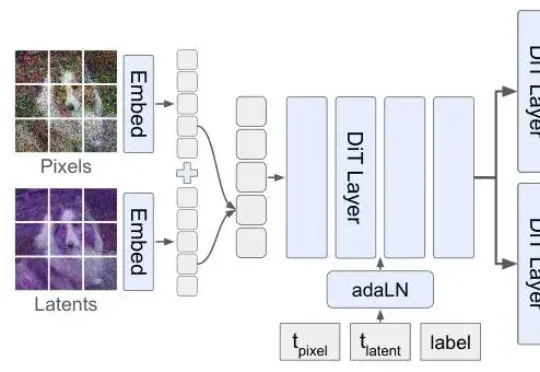
但扩散模型生图,顺序真的对吗?李飞飞团队最新论文提出的Latent Forcing方法直接打破了这一共识,他们发现生成的质量瓶颈不在架构,而在顺序。
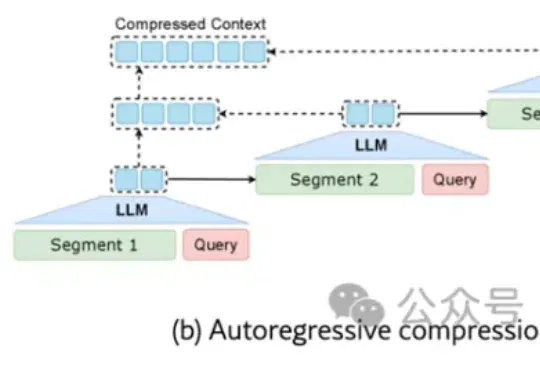
来自清华大学、鹏城实验室与阿里巴巴未来生活实验室的联合研究团队发现:现有任务相关的压缩方法不仅陷入效率瓶颈——要么一次性加载全文(效率低),要么自回归逐步压缩(速度慢),更难以兼顾“保留关键信息”与“保持自然语言可解释性”。
随着 MiniMax M2.5 的发布并在社区引发热烈反响,很高兴能借此机会,分享在模型训练背后关于 Agent RL 系统的一些思考。 在大规模、复杂的真实世界场景中跑 RL 时,始终面临一个核心难
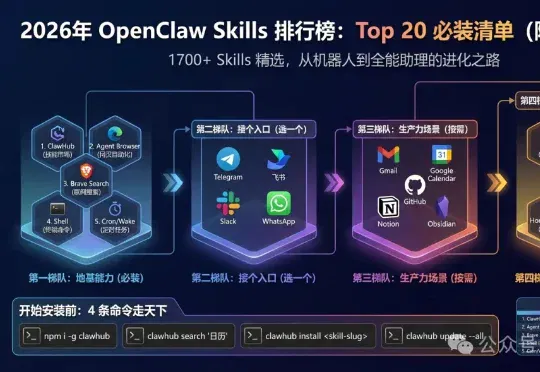
装 Clawdbot(现在叫 OpenClaw)不难。难的是装完之后打开一看——1700 多个 Skill,不知道先装哪个。我帮你筛了一遍。下面 20 个 Skill 按「先打地基 → 再接入口 → 最后扩场景」的顺序排好了,跟着装就行。每个都写清楚:干嘛用的、适合谁、一句话安装。
当大多数人还在测试它的单点逻辑推理能力时,敏锐的开发者已经发现了一个更具破坏力的玩法:将GLM-5的高密度思维模型注入到Anthropic最新推出的Claude Code Agent Teams架构中。
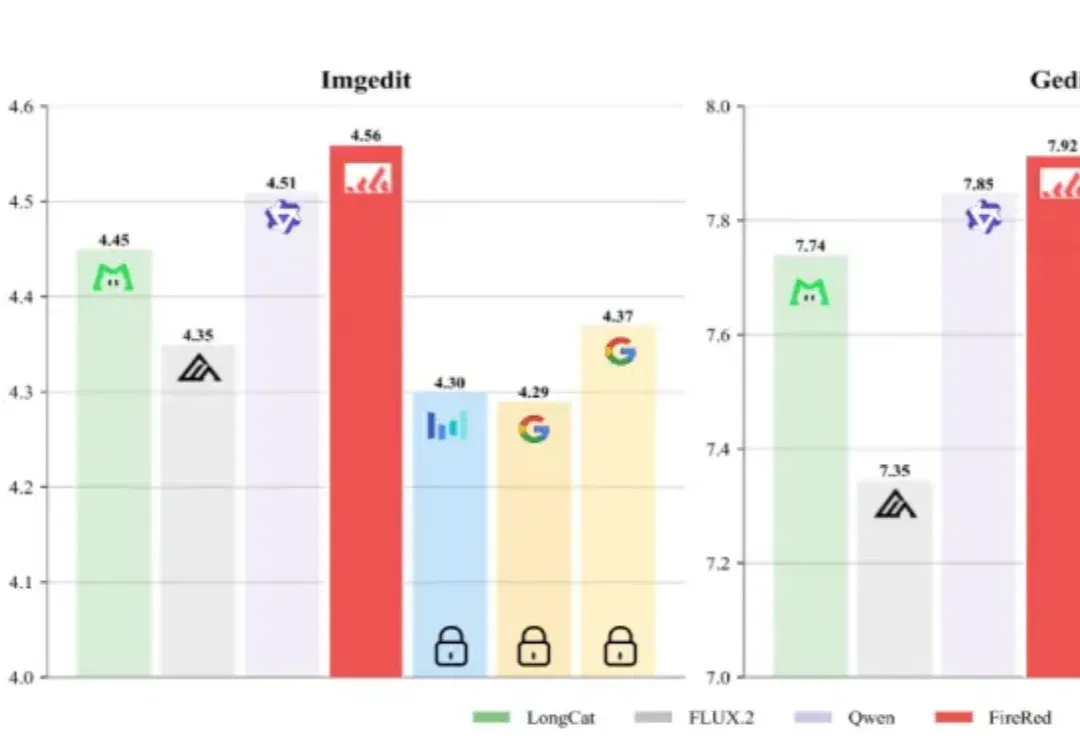
AI生图领域,又出了个“狠角色”。 今日,小红书基础模型FireRed-Image-Edit正式亮相。 看似“低调”,实则战绩惊人——其在处理复杂编辑指令、风格化转换,及高精度文字编辑等多个核心指标上,展现出超强实力。 对比结果显示,FireRed-Image-Edit凭借更精准的理解力、更强的ID保持度及高效的架构,在多项权威测试中脱颖而出,在ImgEdit、GEdit等多个榜单中取得了SOTA,达到业界领先水平。 △主流榜单和自建评测集上的指标对比 这种高效架构背后的技术底座,来自小红书Super Intelligence Team在图像生成与编辑领域的一次重要探索。 划重点!目前该项目代
清华大学团队推出的Dolphin模型突破了「高性能必高能耗」的瓶颈:仅用6M参数(较主流模型减半),通过离散化视觉编码和物理启发的热扩散注意力机制,实现单次推理即可精准分离语音,速度提升6倍以上,在多项基准测试中刷新纪录,为智能助听器、手机等端侧设备部署高清语音分离开辟新路。
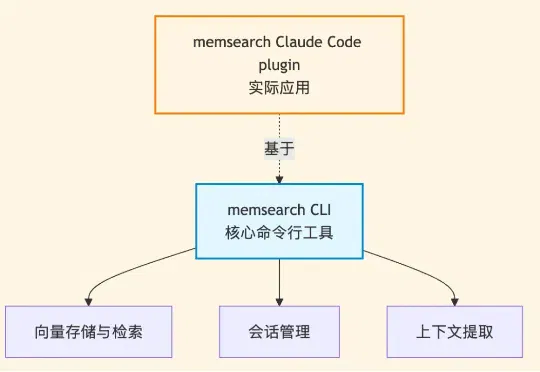
但考虑到在代码领域,如何做好记忆与检索,相比其他场景又有所不同,因此,基于 memsearch CLI ,我们同时也为Claude Code 做了个永久记忆的 plugin——memsearch ccplugin(可适用所有AI coding软件)。
灵初智能选择了一条更为激进的技术路线:「人类中心(Human-Centric)」。他们自主研发了全球首个灵巧手真实世界数采引擎Psi-SynEngine。
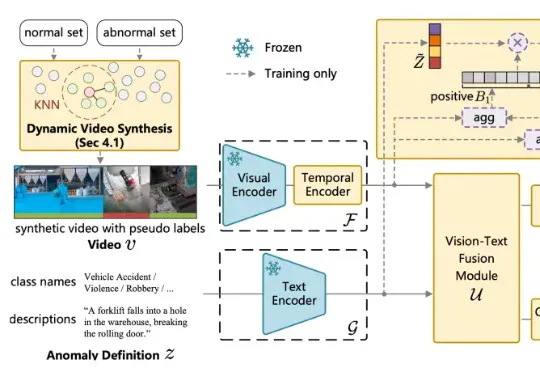
针对这一问题,中国传媒大学媒体融合与传播国家重点实验室的吴晓雨教授团队于 ICLR 2026 发表论文《Language-guided Open-world Video Anomaly Detection under Weak Supervision》,直面 VAD 领域的核心问题 —— 什么是异常?
参与交流
了解加入交流群的方式,阅读内容无需登录。