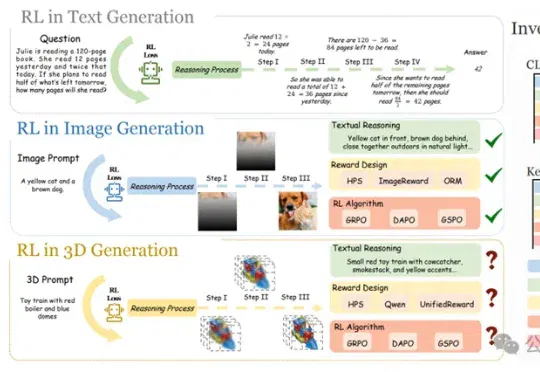
首次证实RL能让3D模型学会推理,复杂文本描述下生成质量跃升!(在新窗口打开)
当GRPO让大模型在数学、代码推理上实现质变,研究团队率先给出答案——首个将强化学习系统性引入文本到3D自回归生成的研究正式诞生,并被CVPR 2026接收。该研究不只是简单移植2D经验,而是针对3D生成的独特挑战,从奖励设计、算法选择、评测基准到训练范式,做了一套完整的系统性探索。
内容栏目
分享不同 AI 工具、模型与相关技术的使用方法和实践文章。
当GRPO让大模型在数学、代码推理上实现质变,研究团队率先给出答案——首个将强化学习系统性引入文本到3D自回归生成的研究正式诞生,并被CVPR 2026接收。该研究不只是简单移植2D经验,而是针对3D生成的独特挑战,从奖励设计、算法选择、评测基准到训练范式,做了一套完整的系统性探索。
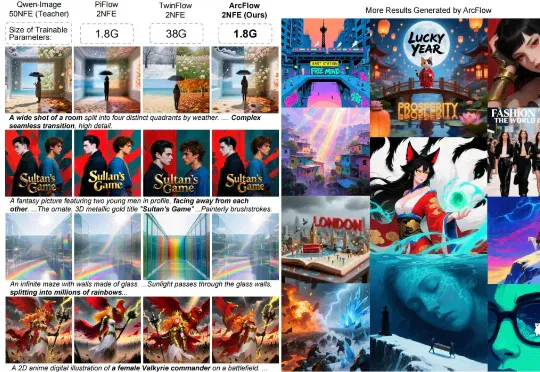
复旦大学与微软亚洲研究院带来的 ArcFlow 给出了答案:如果路是弯的,那就学会 “漂移”,而不是把路修直。在扩散模型中,教师模型(Pre-trained Teacher)的生成过程本质上是在高维空间中求解微分方程并进行多步积分。由于图像流形的复杂性,教师模型原本的采样轨迹通常是一条蜿蜒的曲线,其切线方向(即速度场)随时间步不断变化。
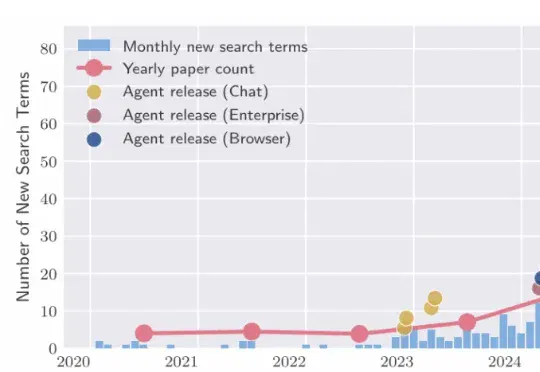
这两周,Claude Code 上了个 COBOL 现代化功能,IBM 当天暴跌 13%;又上了个安全扫描功能,一口气翻出 500 多个此前藏了几十年的高危漏洞,网安股集体跳水。彭博社甚至专门做了一期播客讨论“哪些 SaaS 公司能活下来”。
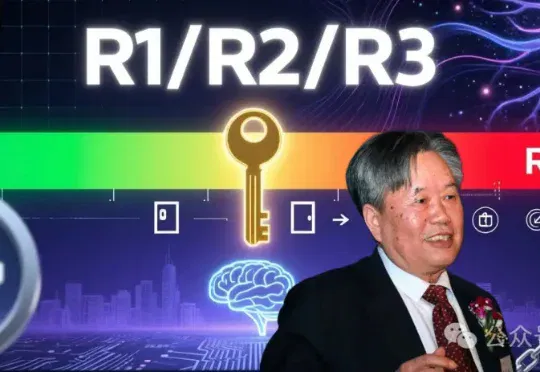
李国杰院士指出,AI安全风险应按逻辑复杂性分为三类:R1可验证、R2可发现但不可证明安全、R3不可治理。当前AI多属R2,关键不在「证明安全」,而在构建人类主导的制度性刹车机制,拒绝让渡终极控制权。
近期发表于 TMLR 的论文《Large Language Model Reasoning Failures》对这一问题进行了系统性梳理。该研究并未围绕 “模型是否真正理解” 展开哲学层面的争论,而是采取更加务实的路径 —— 通过整理现有文献中的失败现象,构建统一框架,系统分析大语言模型的推理短板。
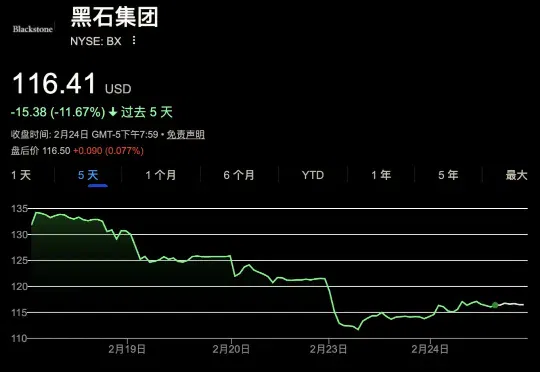
随着AI即将抵达自我进化的AGI奇点和Agent泛滥的「AI繁荣」,一场更彻底的经济危机已经在迅速酝酿中:AI能力提升 → 裁员增加、工资降级 → 消费疲弱 → 企业利润被挤压 → 企业购买更多AI能力 → AI能力继续提升。所有平台层将被Agent彻底击穿,而房贷和私募基金将成为危机的加速器。
SSI-Bench是首个在约束流形中评估模型空间推理能力的基准,强调真实结构与约束条件,通过排序任务考察模型是否能准确理解三维结构的几何与拓扑关系,揭示当前大模型在空间智能上严重依赖2D信息,实际表现远低于人类。研究指出,模型需提升三维构型识别和约束推理能力,才能真正理解空间问题。
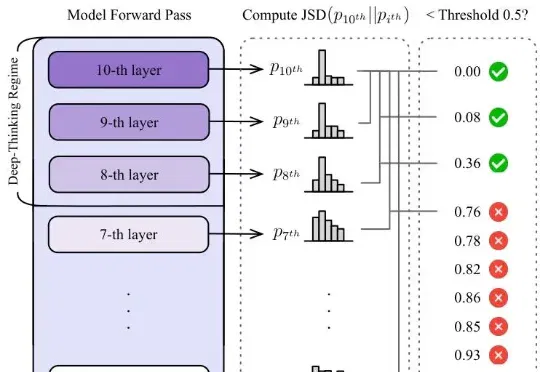
大模型的思维链越长,推理能力就越强?谷歌Say No——token数量和推理质量,真没啥正相关,因为token和token还不一样,有些纯凑数,深度思考token才真有用。新研究抛弃字数论,甩出衡量模型推理质量的全新标准DTR,专门揪模型是在真思考还是水字数。
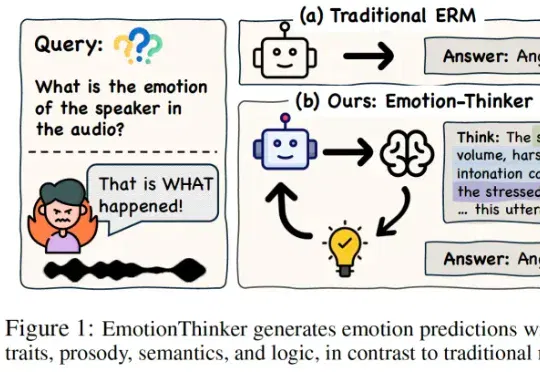
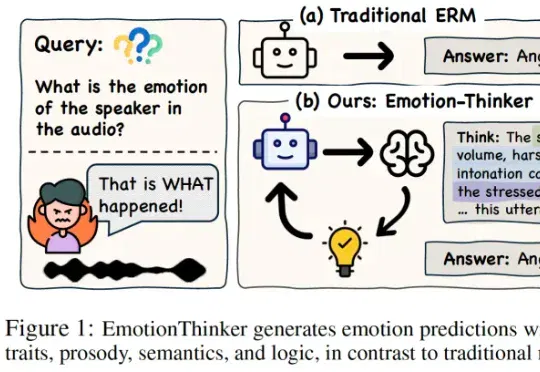
SpeechLLM 是否具备像人类一样解释 “为什么” 做出情绪判断的能力?为此,研究团队提出了EmotionThinker—— 首个面向可解释情感推理(Explainable Emotion Reasoning)的强化学习框架,尝试将 SER 从 “分类任务” 提升为 “多模态证据驱动的推理任务”。
在2026当下的智能体(Agent)开发体系中,“为LLM加Skills”已经成为事实上的行业标准。您的Agent表现不好,是因为底层的LLM参数量不够,还是因为您喂给它的“Skills”写得一塌糊涂?无论是日常使用的各类CLI工具,还是最近的Openclaw,其底层能力的跃升很大程度上都依赖于这些特定领域的Agent Skills。
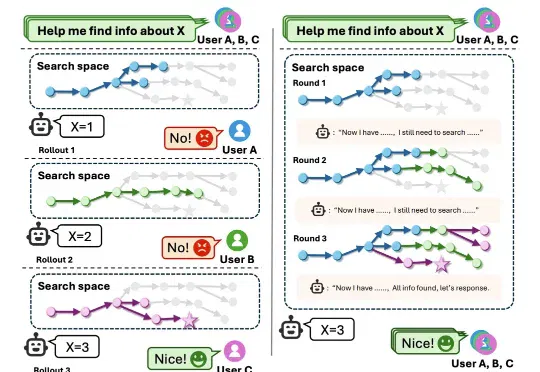
来自东南大学、微软亚洲研究院等机构的研究团队提出了一种全新的解决方案——Re-TRAC(REcursive TRAjectory Compression),这个框架让 AI 智能体能够「记住」每次探索的经验,在多个探索轨迹之间传递经验,实现渐进式的智能搜索。
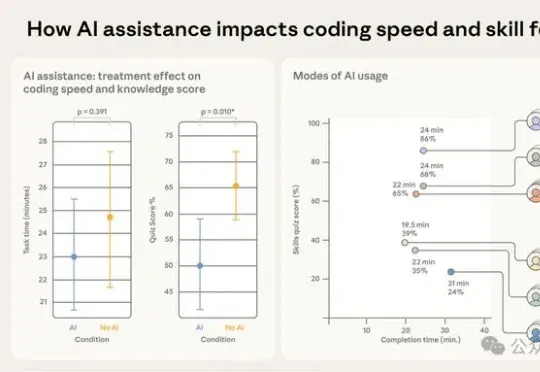
在AI编程时代,效率飙升却隐藏危机:Anthropic最新研究揭示,使用AI助手虽能快速生成代码,但开发者在概念理解、代码阅读和调试能力上显著落后。独立解决问题才是技能之钥,AI若不当用,将成「懒惰陷阱」。
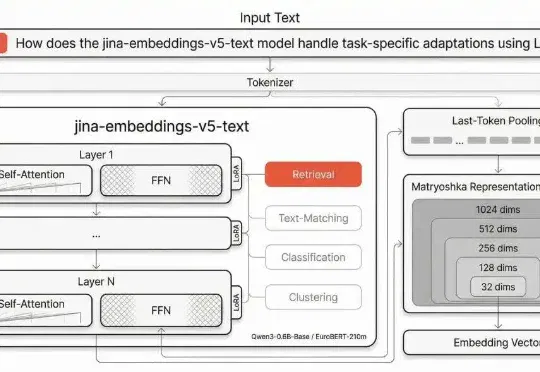
jina-embeddings-v5-text 岁在丙午,开年即战。Jina AI 的五代目向量模型春节期间正式发布。1B 参数内世界第一,全面刷新向量模型的性能天花板!
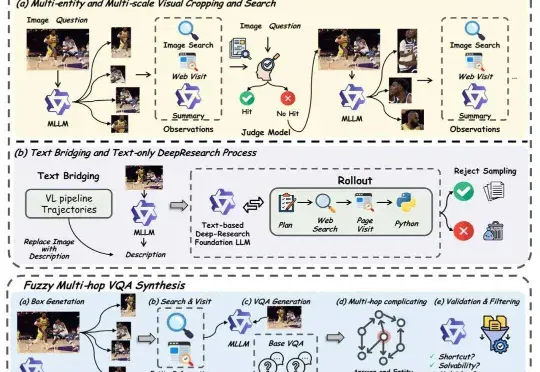
DeepResearch 的价值在于把「查资料」变成「做研究」:不是搜到一条就回答,而是会连续多轮地提出问题、去不同地方找证据、互相对照核实、再把信息整理成结构清晰的结论。这样做能显著降低「凭感觉瞎编
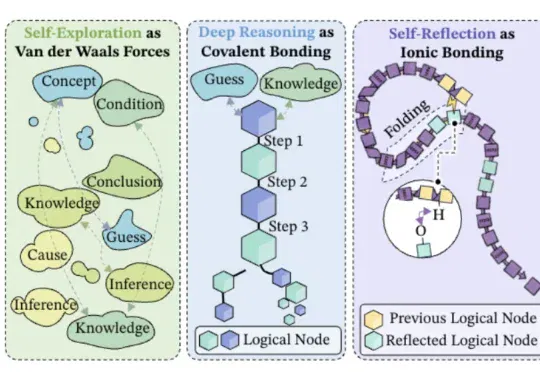
字节Seed都开始用化学思想搞大模型了——深度推理是共价键、自我反思是氢键、自我探索是范德华力?!
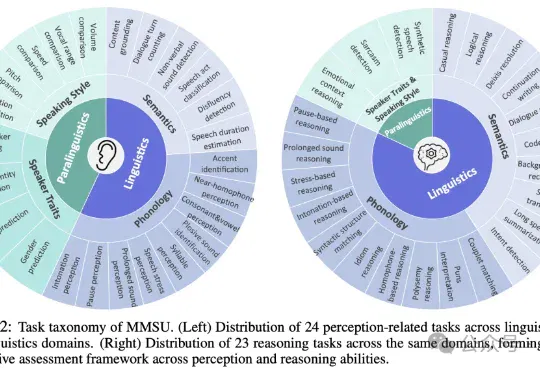
随着多模态大模型能力不断扩展,语音大模型(SpeechLLMs) 已从语音识别走向复杂语音交互。然而,当模型逐渐进入真实口语交互场景,一个更基础的问题浮现出来:我们是否真正定义清楚了「语音理解」的能力边界?
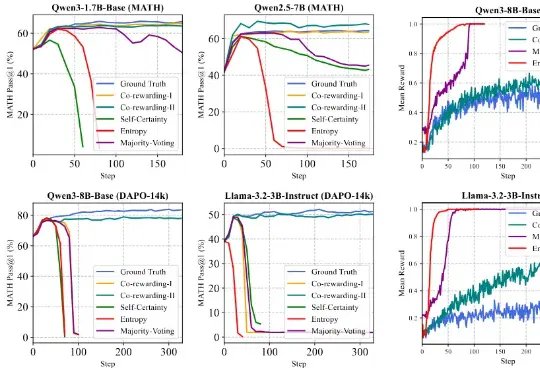
针对这一挑战,来自香港浸会大学和上海交通大学的可信机器学习和推理组提出了一个全新的自监督 RL 框架 ——Co-rewarding。该框架通过在数据端或模型端引入互补视角的自监督信号,稳定奖励获取,提升 RL 过程中模型奖励投机的难度,从而有效避免 RL 训练崩溃,实现稳定训练和模型推理能力的诱导。
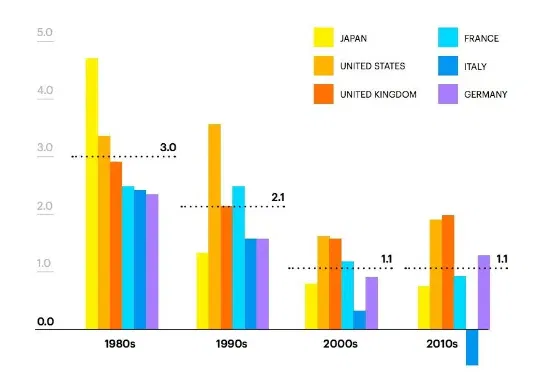
机器之心发布 本文作者为摩尔线程天使投资人、中国初代AI投资人王捷。他于 2025 年 8 月和 12 月分别发表了《浮现中的AI经济》 、《关于AI经济的四十个问题》 两篇文章,对即将到来的 AI
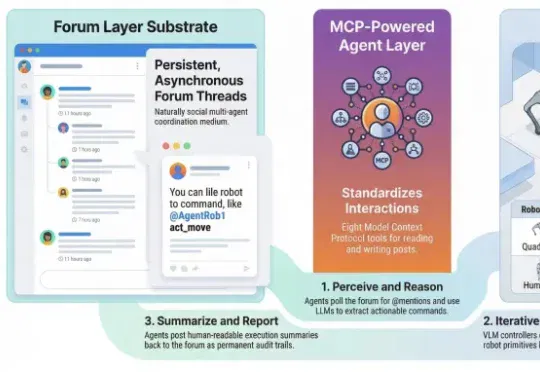
公元前47年,凯撒在泽拉战役速胜后给罗马元老院写了三个词的战报:「Veni, Vidi, Vici」——我来了,我看见了,我征服了。 两千多年后,北京大学杨仝教授团队也用三步定义了一种全新的AI范式:降临论坛、接管指令、统治物理世界。
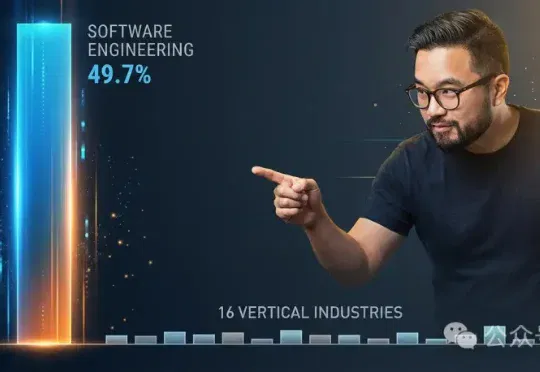
Anthropic最新报告揭示,AI智能体近半数使用量集中在软件工程,其余16个垂直行业各占不到9%。AI已具备连续工作5小时的能力,但用户目前最多只让它跑42分钟,信任远未跟上技术。Y Combinator CEO陈嘉兴断言:这片几乎空白的行业版图里,藏着下一代300个独角兽。
参与交流
了解加入交流群的方式,阅读内容无需登录。