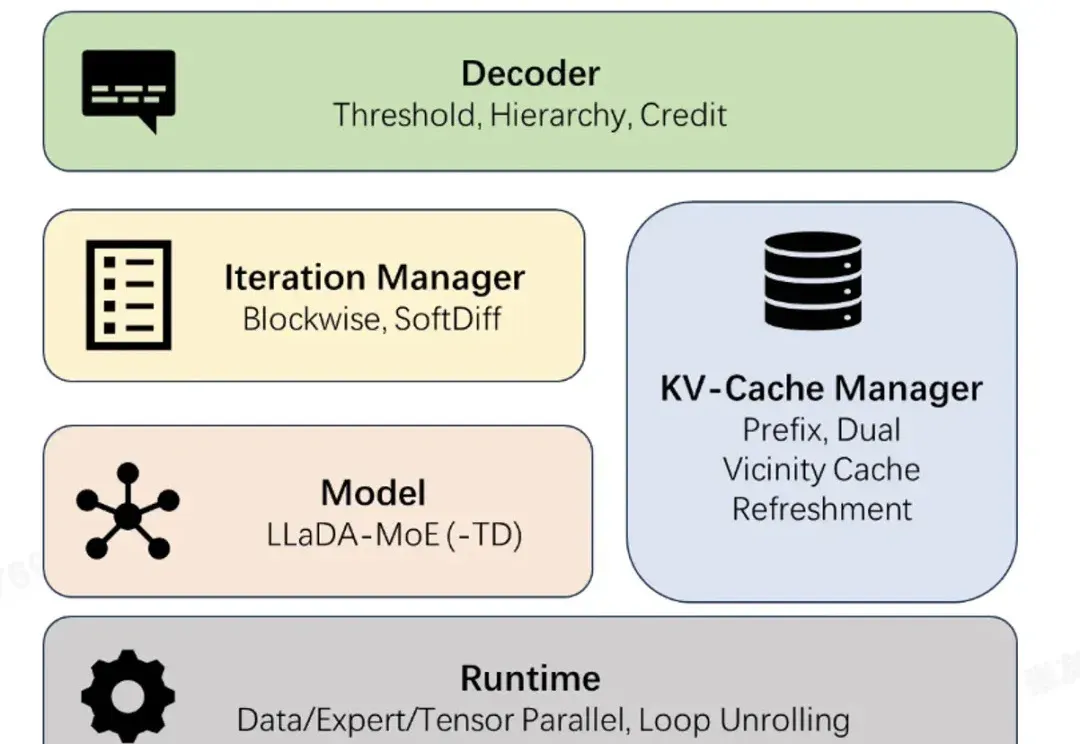
推理速度10倍提升,蚂蚁集团开源业内首个高性能扩散语言模型推理框架dInfer(在新窗口打开)
近日,蚂蚁集团正式开源业界首个高性能扩散语言模型(Diffusion Large Language Model,dLLM)推理框架 dInfer。
内容栏目
分享不同 AI 工具、模型与相关技术的使用方法和实践文章。
近日,蚂蚁集团正式开源业界首个高性能扩散语言模型(Diffusion Large Language Model,dLLM)推理框架 dInfer。
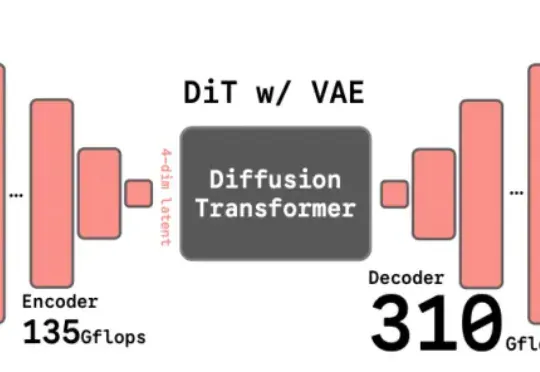
谢赛宁团队最新研究给出了答案——VAE的时代结束,RAE将接力前行。其中表征自编码器RAE(Representation Autoencoders)是一种用于扩散Transformer(DiT)训练的新型自动编码器,其核心设计是用预训练的表征编码器(如DINO、SigLIP、MAE 等)与训练后的轻量级解码器配对,从而替代传统扩散模型中依赖的VAE(变分自动编码器)。
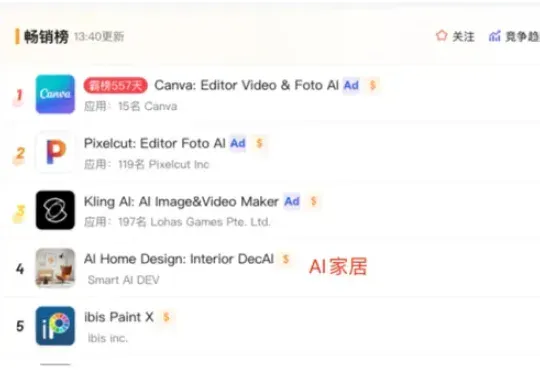
根据 Sensor Tower 数据显示,2025 H1 AI 应用的下载量达到 17 亿次,增长 67%,IAP 收入总计达到 19 亿美元,增幅达到 100.6%。在走过了概念验证阶段后,AI 应用正成为一股很强的增长动力,给已经相对平静的应用市场注入了活力。
为什么大模型,在执行长时任务时容易翻车?这让一些专家,开始质疑大模型的推理能力,认为它们是否只是提供了「思考的幻觉」。近日,剑桥大学等机构的一项研究证明:问题不是出现在推理上,而是出在大模型的执行能力上。
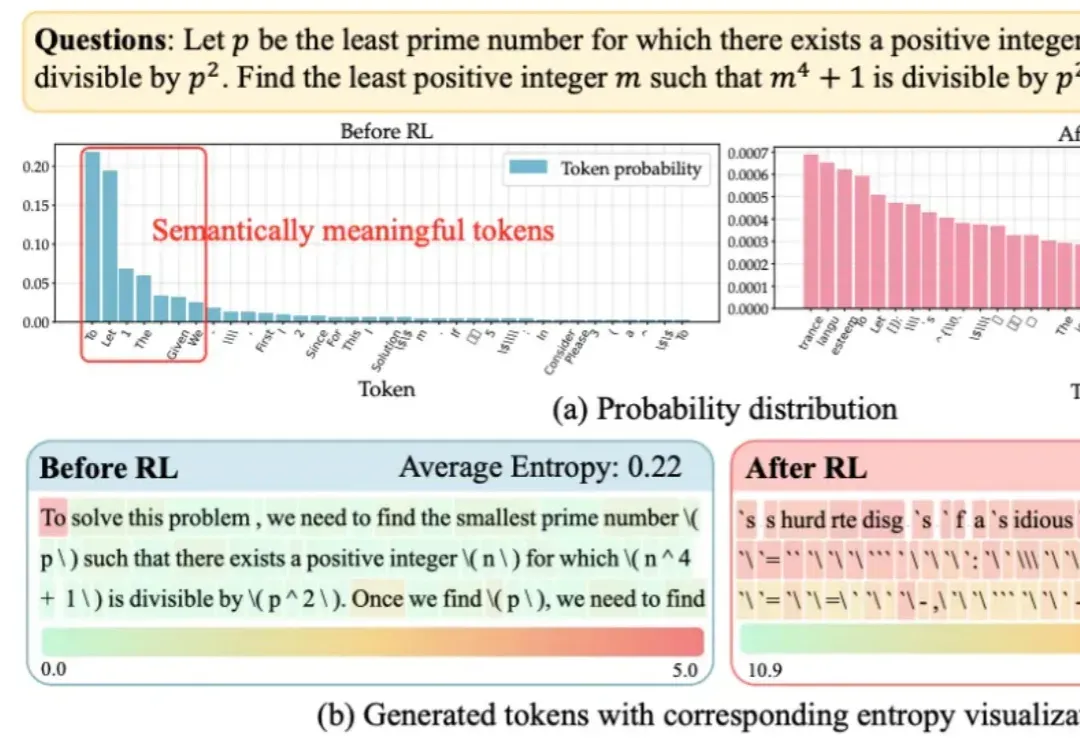
大语言模型在RLVR训练中面临的“熵困境”,有解了!
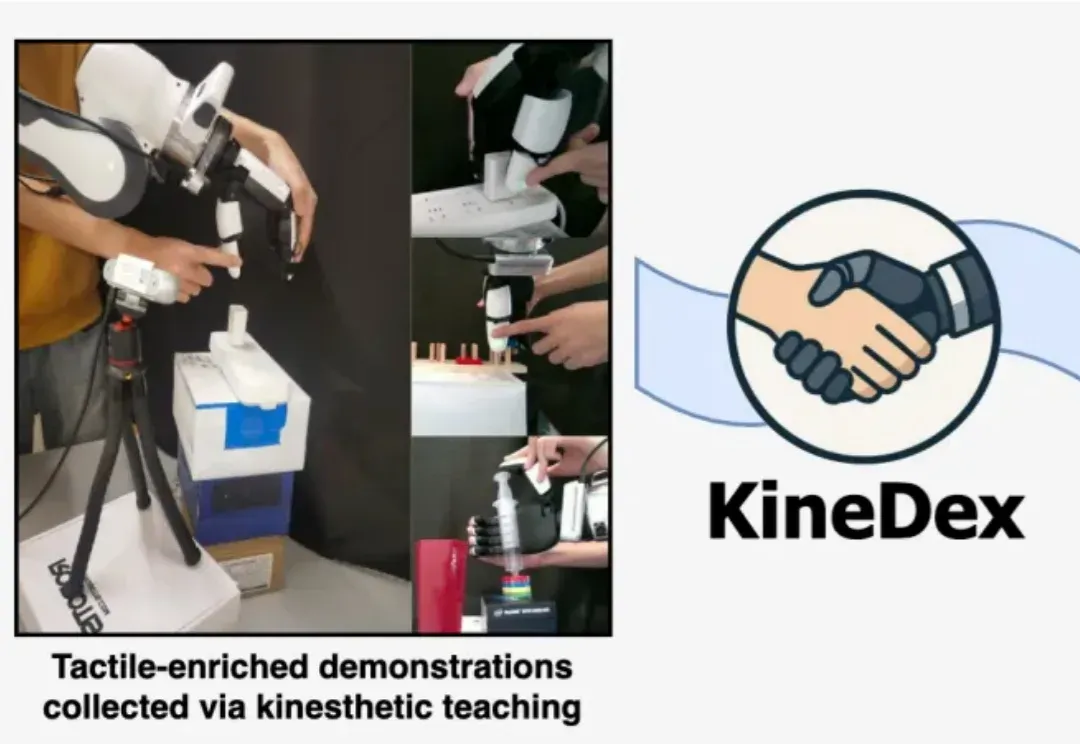
灵巧手技能+1,能帮女友拧瓶盖了! 不仅如此,还能帮忙挤牙膏、插充电器。 来自同济大学、清华、上海交大、香港大学等研究团队提出面向灵巧操作任务的示教与策略学习新方法KineDex框架—— 真·手把手指导的方式,让人类动作直接传递到灵巧手,并同步采集高保真触觉信息。 结果让星动纪元灵巧手星动XHAND 1成功解锁了各种复杂精细操作。 在瓶盖旋紧、牙膏挤压、注射器按压等九项复杂任务中,KineDex平均成功率达74.4%,且数据采集效率相较于遥操提升两倍以上。 该论文已被CoRL 2025接收。 真·手把手引导灵巧操作学习 当前,机器人学习精细操作(尤其那种需要精确力度控制的任务)的难点在于缺乏高
当全球的目光还在聚焦基座模型的参数竞赛时,一场更为深刻的变革正在悄然发生——后训练(Post-Training)。
这是一份为正在开发 AI Agent 的产品经理准备的完整指南,介绍了 Agent 架构、编排模式等话题。
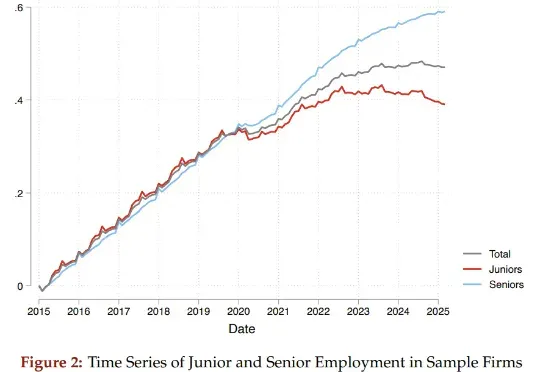
两位哈佛学者通过研究6200万份简历和近2亿条招聘职位数据,揭示了AI对就业带来的真实、残酷的冲击:它不是无差别地针对所有人,而是在大量“吞噬”初级岗位,让那些刚刚踏入社会的年轻人,面临着空前陡峭、狭窄的职业起跑线。与此同时,为数众多的普通院校毕业生群体受到的冲击更为显著。
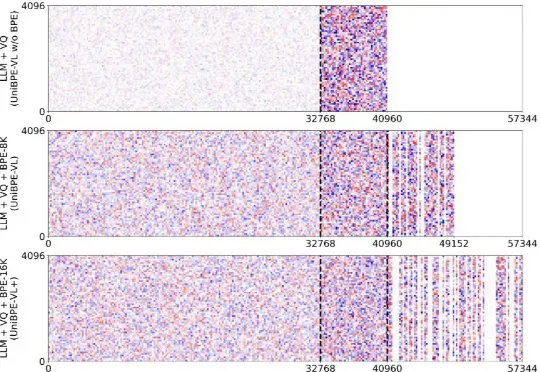
为此,北大、UC San Diego 和 BeingBeyond 联合提出一种新的方法——Being-VL 的视觉 BPE 路线。Being-VL 的出发点是把这一步后置:先在纯自监督、无 language condition 的设定下,把图像离散化并「分词」,再与文本在同一词表、同一序列中由同一 Transformer 统一建模,从源头缩短跨模态链路并保留视觉结构先验。
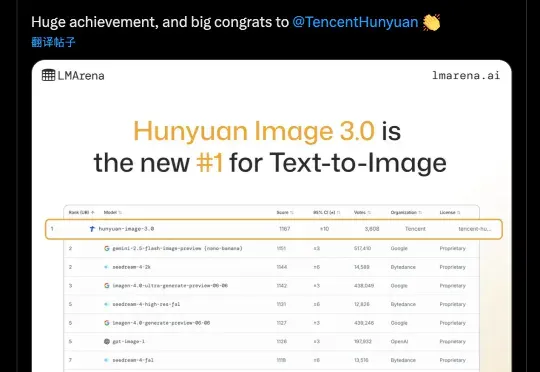
讲真,AI生图圈的内卷速度简直离谱。8月底的Nano Banana、9月中的即梦4.0已经把画质和效果卷到了一个新高度,但我还在纠结到底该把谁设为主力工具,因为总觉得他们差点什么:不是出错就是不懂场景。
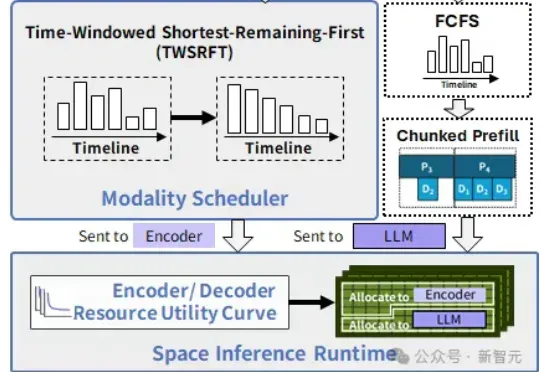
在中国科学院计算技术研究所入选NeurIPS 2025的新论文中,提出了SpaceServe的突破性架构,首次将LLM推理中的P/D分离扩展至多模态场景,通过EPD三阶解耦与「空分复用」,系统性地解决了MLLM推理中的行头阻塞难题。
说出概念,SAM 3 就明白你在说什么,并在所有出现的位置精确描绘出边界。 Meta 的「分割一切」再上新? 9 月 12 日,一篇匿名论文「SAM 3: SEGMENT ANYTHING WITH CONCEPTS」登陆 ICLR 2026,引发网友广泛关注。
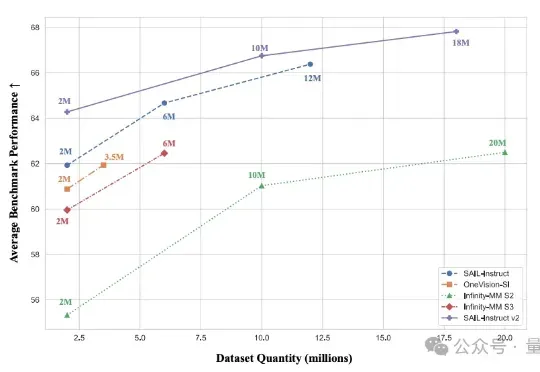
2B模型在多个基准位列4B参数以下开源第一。 抖音SAIL团队与LV-NUS Lab联合推出的多模态大模型SAIL-VL2。
扩散模型本该只是复制机器,却一次次画出「六指人像」甚至是陌生场景。最新研究发现,AI的「创造力」其实是架构里的副作用。有学者大胆推测人类的灵感或许也是如此。当灵感成了固定公式,人类和AI的差别还有多少?
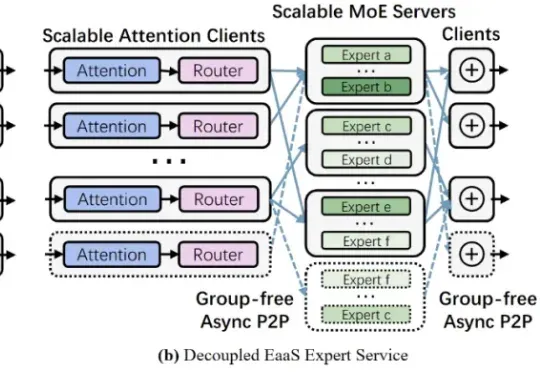
近年来,大型语言模型的参数规模屡创新高,随之而来的推理开销也呈指数级增长。如何降低超大模型的推理成本,成为业界关注的焦点之一。Mixture-of-Experts (MoE,混合专家) 架构通过引入大量 “专家” 子模型,让每个输入仅激活少数专家,从而在参数规模激增的同时避免推理计算量同比增长。
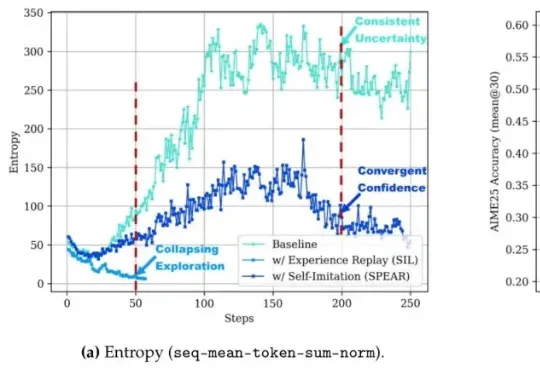
让智能体自己摸索新方法,还模仿自己的成功经验。腾讯优图实验室开源强化学习算法——SPEAR(Self-imitation with Progressive Exploration for Agentic Reinforcement Learning)。
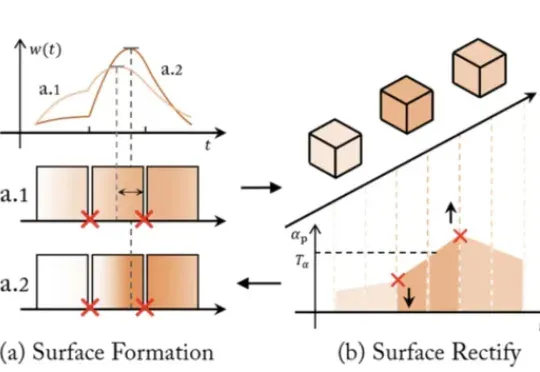
近年来,NeRF、SDF 与 3D Gaussian Splatting 等方法大放异彩,让 AI 能从图像中恢复出三维世界。但随着相关技术路线的发展与完善,瓶颈问题也随之浮现:
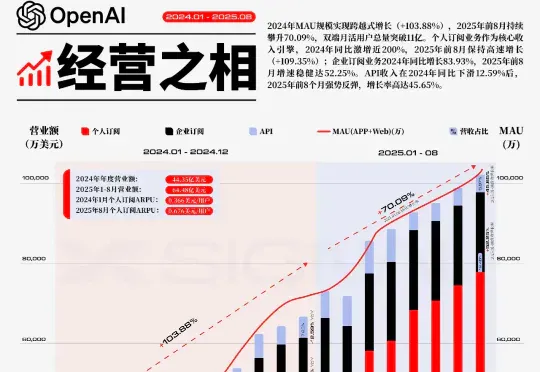
2022年11月,OpenAI的ChatGPT问世,这一事件不仅是技术创新的里程碑,更被视为重塑全球AI战略版图的关键转折点,它标志着新一轮大国AI竞赛的序幕被正式拉开。在此背景下,其增长的规模与速度本身,就是一种颠覆性的战略壁垒。
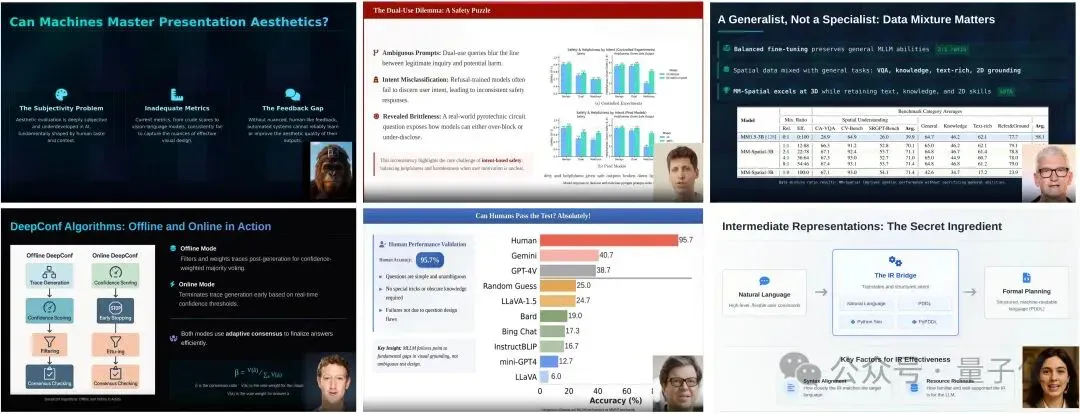
AI自己讲明白论文,还能生成更美观的幻灯片。加州大学圣塔芭芭拉(UCSB)与圣克鲁兹(UCSC)的研究者提出EvoPresent,一个能够自我进化的学术演讲智能体框架,让AI不仅能“讲清楚论文”,还能“讲得好看”。
参与交流
了解加入交流群的方式,阅读内容无需登录。