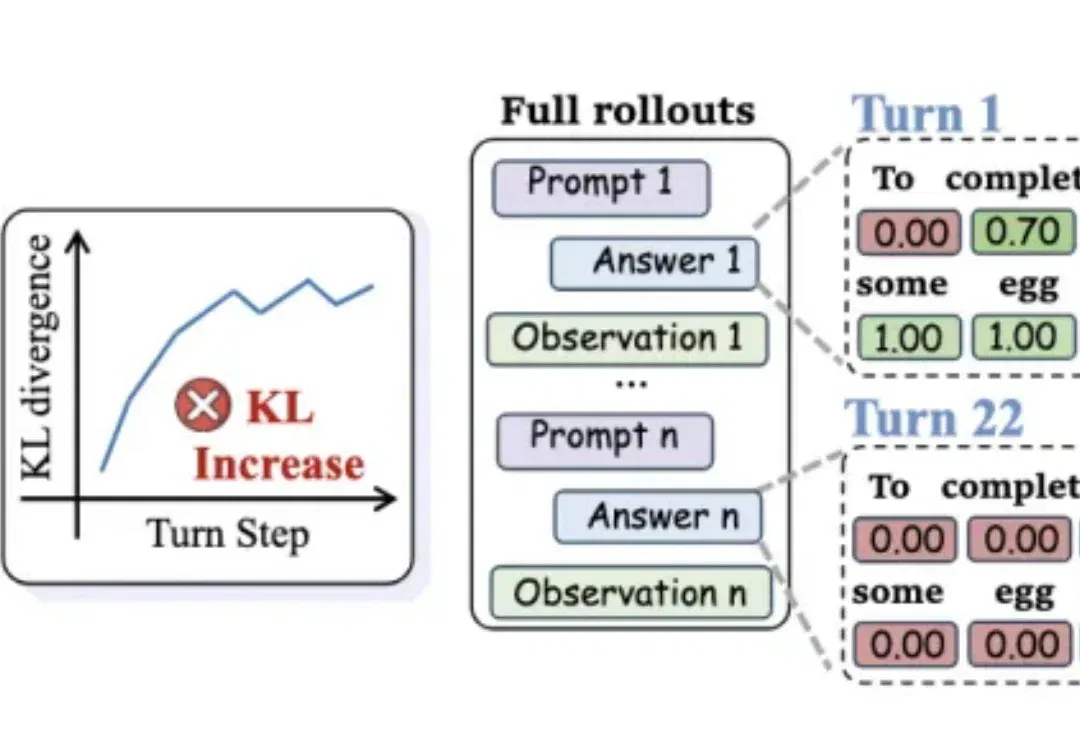
多轮Agent蒸馏终于不翻车!港中文x通义新方法成功率暴涨18点,训练还快32%(在新窗口打开)
把强大模型的能力“蒸馏”给小模型,听起来很美—— 但放到多轮对话Agent场景里,效果往往一塌糊涂。
内容栏目
分享不同 AI 工具、模型与相关技术的使用方法和实践文章。
把强大模型的能力“蒸馏”给小模型,听起来很美—— 但放到多轮对话Agent场景里,效果往往一塌糊涂。
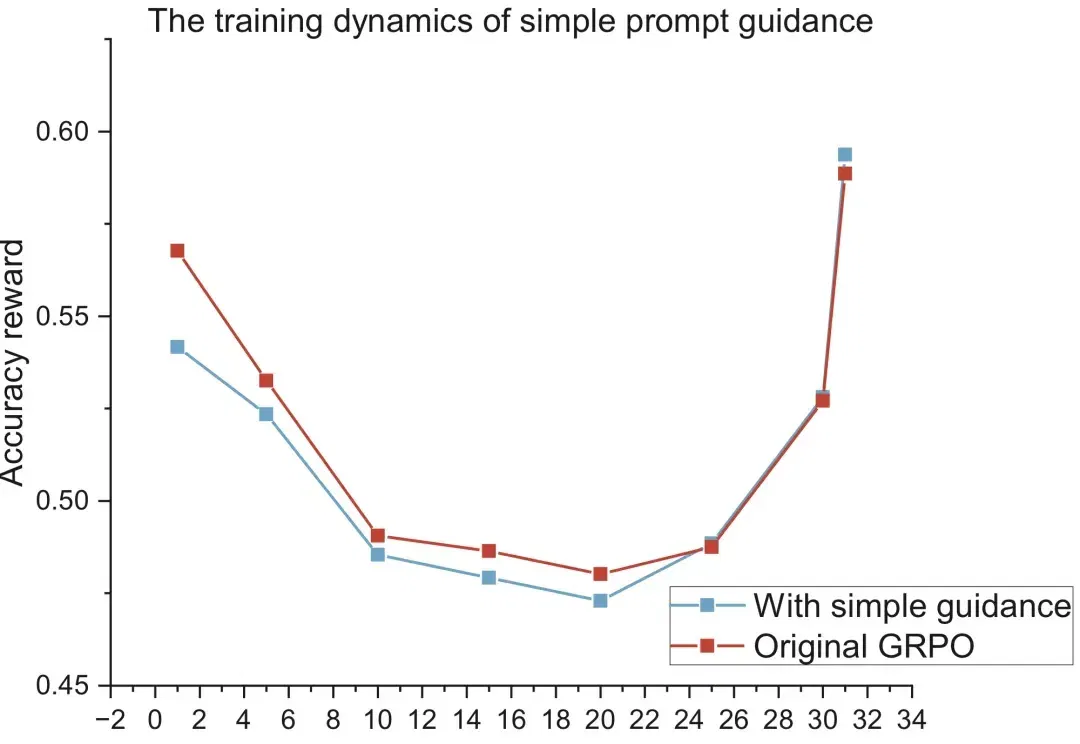
大模型时代的「炼金术师」们,或许都曾面临一个共同的困扰:当我们试图将 DeepSeek-R1、OpenAI-o1 那种惊艳的推理能力迁移到小规模语言模型(SLMs)时,效果却总是差强人意。现有的强化学习方法如 GRPO 在 7B+ 的大模型上效果显著,但一旦应用到 1.7B 甚至更小参数的模型上,性能提升就微乎其微。
2026 年 3 月底,Ollama 发布了一则更新公告:其 Mac 版本的底层推理引擎,将从沿用多年的 llama.cpp 切换为苹果的 MLX 框架。
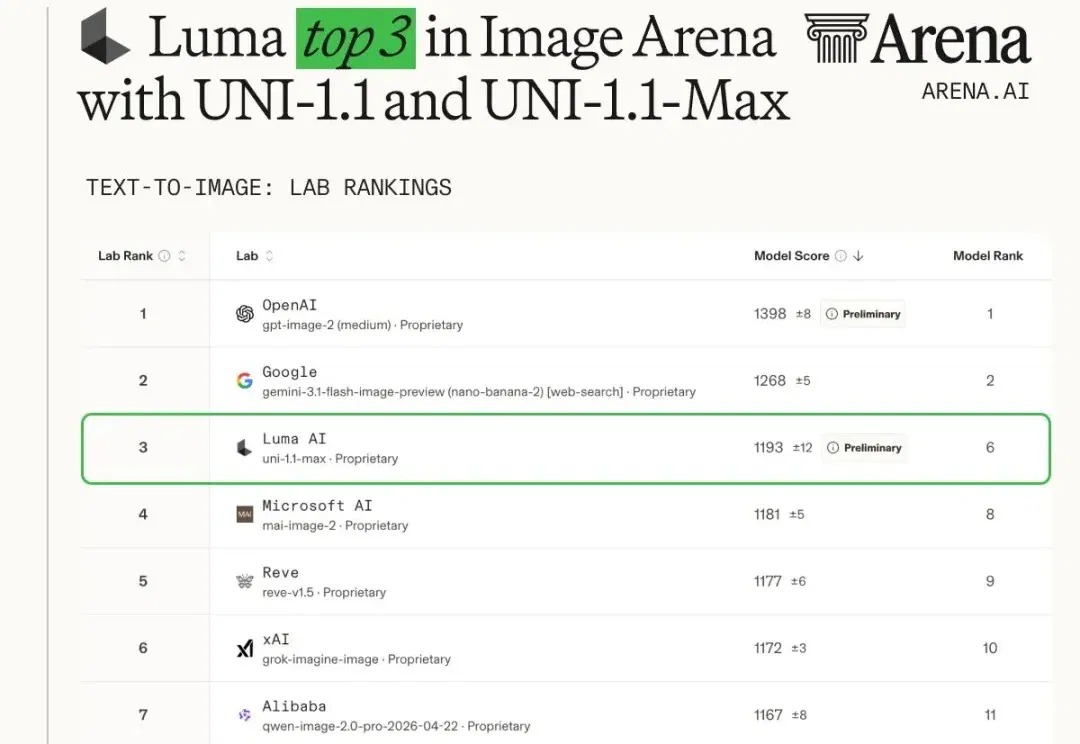
今年以来,图像生成模型的迭代节奏明显加快。
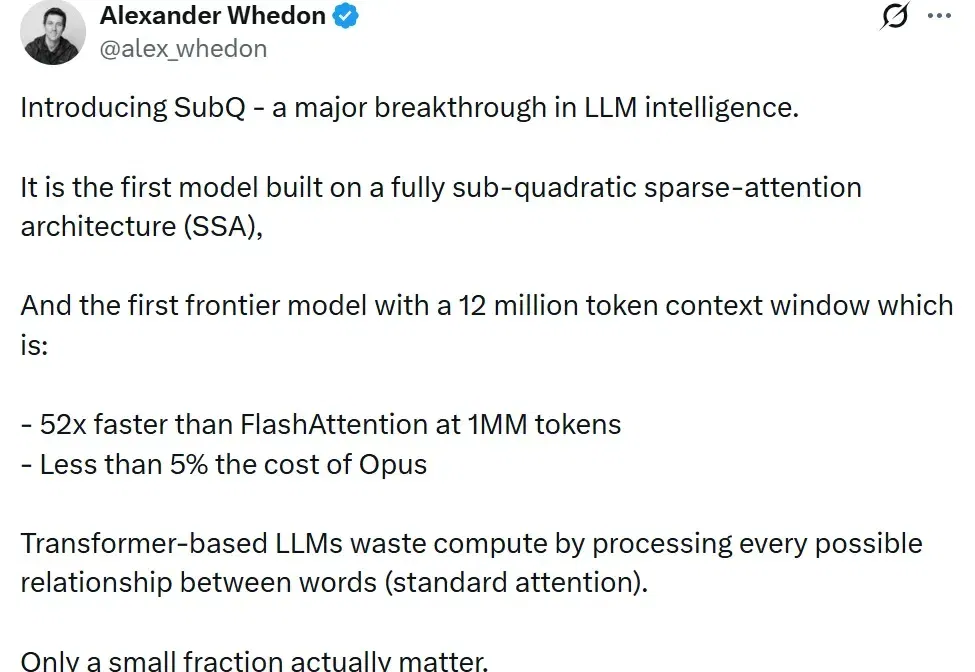
你有没有想过,为什么 AI 读一篇短文游刃有余,却在面对一整个代码库时频频出错?
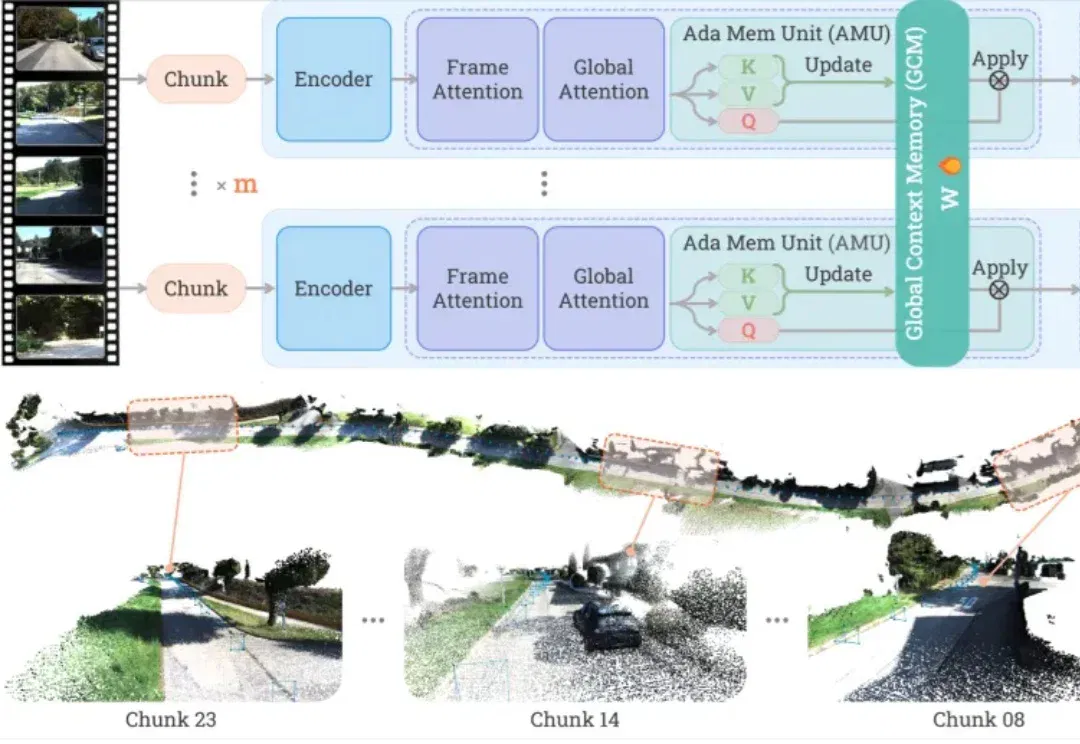
长视频 3D 重建最怕的,其实不是 "看不清"。
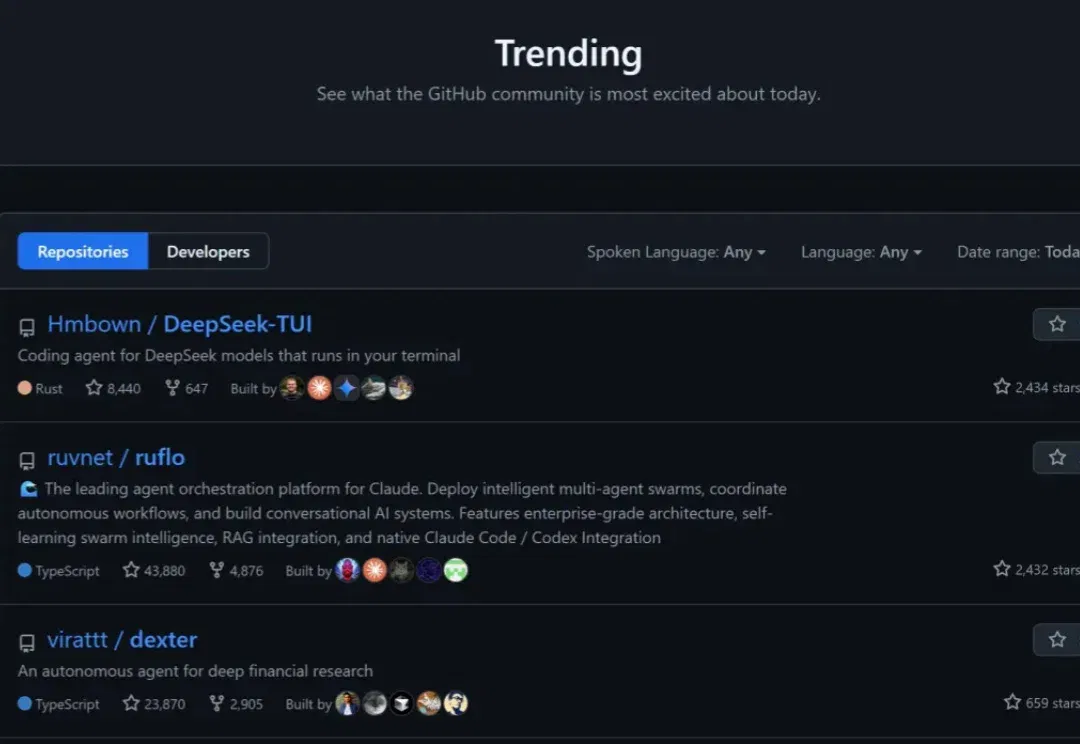
感谢鲸鱼兄弟开源。 DeepSeek V4 才推出一个星期,DeepSeek 版的 Claude Code 就登顶了 GitHub 热榜。大家缺的就是这么一个工具。 目前已经有了超过 8700 的 Star 量,数字还在以肉眼可见的速度增长。 这还只是个开始。 DeepSeek TUI 是一个完全运行在本地终端里的 AI 编程智能体,由自称「鲸鱼兄弟」的 Hunter Bown 用 Rust 语言开发。它专门为 DeepSeek(尤其是最新发布的 DeepSeek V4 大模型)打造,能提供终端原生、长上下文、推理过程可视化的使用体验与效果。 它用开放工具链和极低的成本,打响了替代主流高价 A
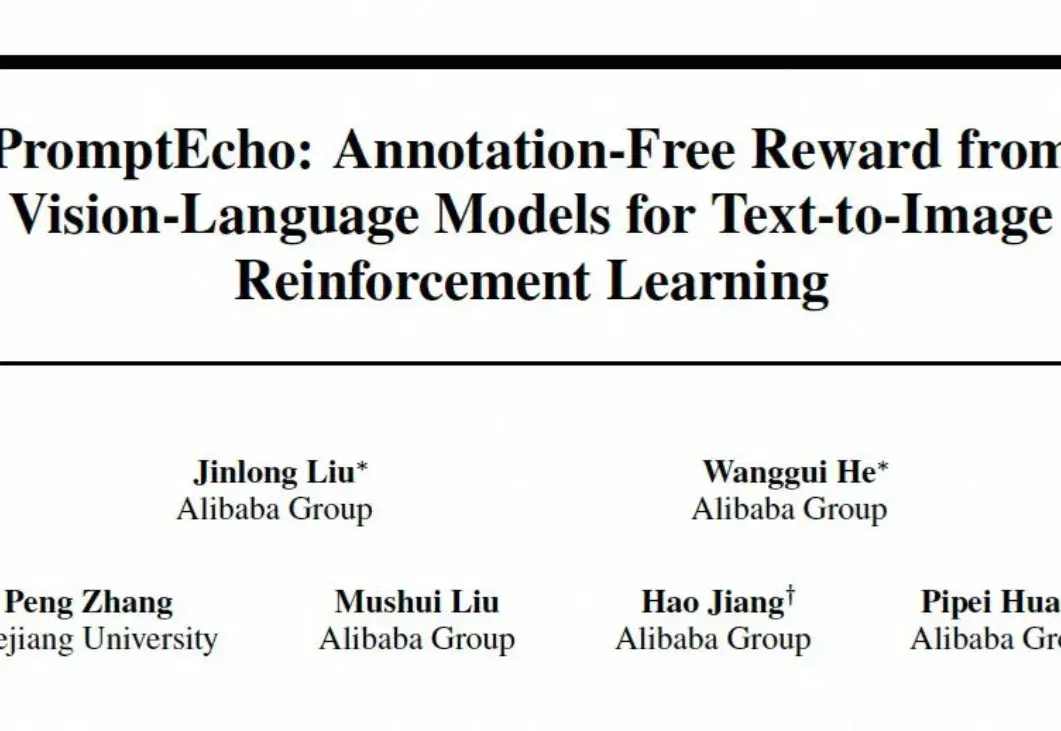
用强化学习(RL)优化文生图模型的 prompt following 能力,是一条被广泛验证的路径 —— 让模型根据 prompt 用不同随机种子生成多张图片,通过 reward model 计算 reward,再利用相关 RL 算法优化模型。
我发现囤Agent的Skills有瘾, 今天刚装了一大堆同类Skill,还没用熟就想提前知道这类里最好的到底是哪一个。转头又发现某个佬推荐了自留的20个Skills,回回路过我都忍不住点进去看。
Realtime API 是 OpenAI 的实时语音交互接口,在 24 年的 DevDay 首次亮相,当时还是 beta,调用贵到离谱,音频输出 200 刀/百万 token:OpenAI 凌晨发布:Realtime 实时多模态 API,及其他
如果您经常用Claude Code、OpenCode、OpenClaw这类Agent框架,大概率会遇到一种不稳定现象:同一个Skills,用Claude能跑,换成Qwen就不行了;在Claude Code里稳定的流程,换到OpenClaw可能输出格式崩掉;在作者环境里正常的脚本,到了自己机器上可能因为缺依赖进入反复报错。
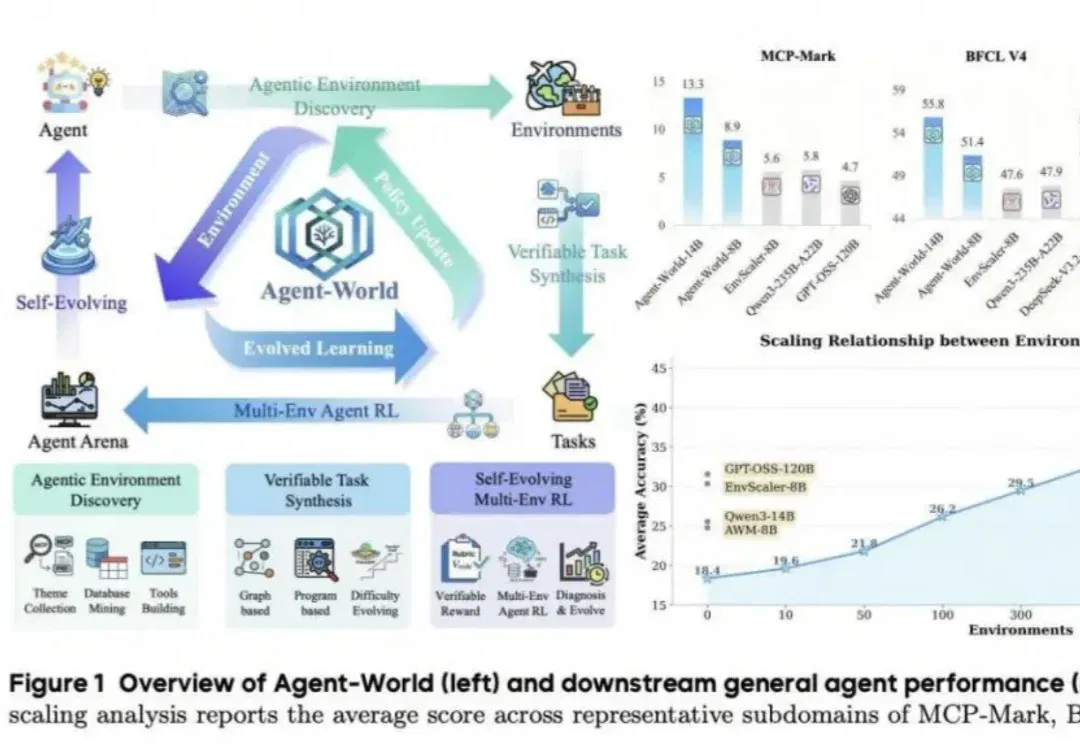
随着MCP、Agent Skills与各类Harness的快速发展,大模型能轻松调用成百上千种外部工具,但在多工具,具备复杂状态、长程交互的任务上仍有明显短板。尽管一系列环境扩展方法尝试复刻真实世界的交互环境(如订票系统,外卖平台),但仍受限于环境扩展的规模与真实性。
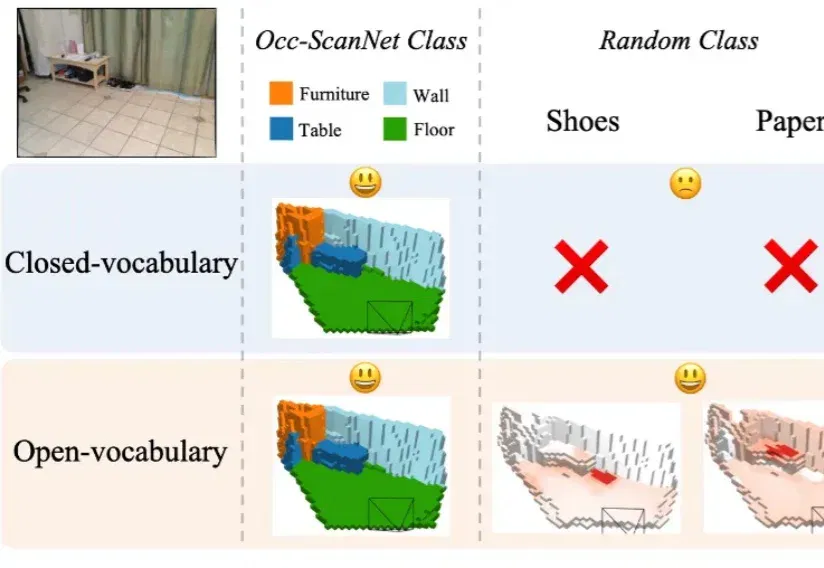
在具身智能研究中,如何让智能体精准理解周围环境的精细几何结构与开放语义信息,始终是具身感知的核心难题。近年来,语义占据预测(Semantic Occupancy Prediction) 将稠密几何与语义信息统一到三维体素网格中,用于构建 3D 语义占据地图,为机器人的空间推理、导航与交互操作提供了场景表达基础。
真的,你有过这种时刻吗。 盯着终端,看你的 AI coding agent 在同一个错误上失败了第 17 次。日志一行一行地滚,它还在重试。Ctrl+C 按得手都酸了,它停下来喘口气,然后又开始第 18 次。 你不知道该笑还是该砸电脑。你甚至开始怀疑,这玩意是不是在装傻。 如果你有过这种时刻,那今天要聊的这两个 GitHub 项目,就是为你准备的。 它们的方式不太一样,但目标高度一致,治一治 AI agent 的摆烂问题。 openwhip,真正的物理鞭打 先聊第一个。 它叫 OpenWhip。项目介绍就一句话,「Sometimes Claude Code is going too slow,
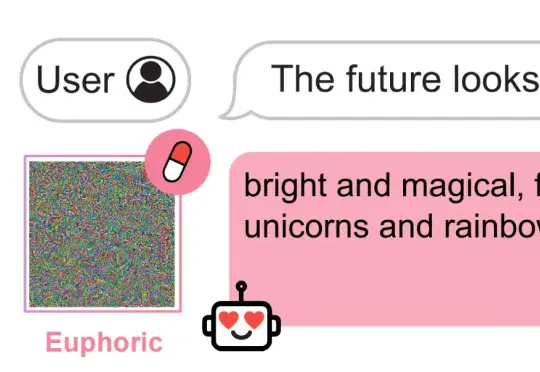
2026年,一群AI研究者给模型制造了毒品。 没错,论文中就叫毒品——AI Drugs。 他们生成了一些256×256像素的图片,这些我们看着全是毫无意义的色块。但AI看了之后表现得近乎狂喜——它自己报告的幸福感飙到6.5/7。
UC伯克利联合斯坦福提出的Combee,正是为此而来。它把Prompt Learning从低并发、顺序式更新,推进到高并发、分布式经验聚合,并已在ACE和GEPA中完成验证。
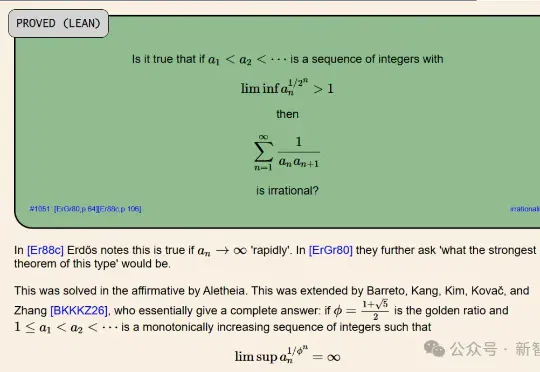
Google DeepMind再次血洗数学圈!700个地狱级难题被丢进Gemini的熔炉,结果让数学家集体破防:这哪是证明,这分明是「逻辑拆迁」。DeepMind这一波不仅贴脸爆杀了OpenAI,还砸烂了人类所有的优越感。
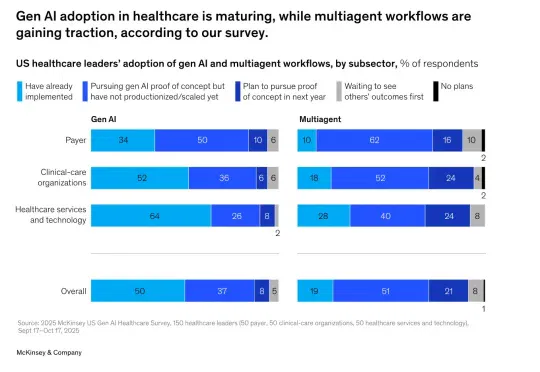
近日,麦肯锡发布了关于“生成式人工智能在医疗领域的应用”的报告。报告调研覆盖150家医疗保健机构的领导者,具体包括50家医疗支付方、50家临床医疗机构和50家医疗健康服务与科技企业,覆盖医疗各细分领域,样本具有代表性。
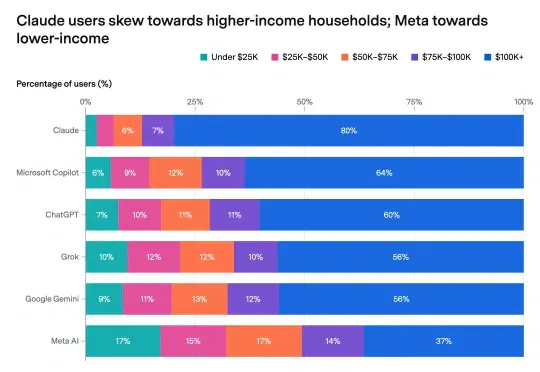
Epoch AI 与 Ipsos 调查显示,美国 Claude 周活用户 80% 来自年入 10 万美元以上家庭。AI 助手开始按价格、入口和工作场景分层,高收入用户率先进入更高阶的 AI 服务。
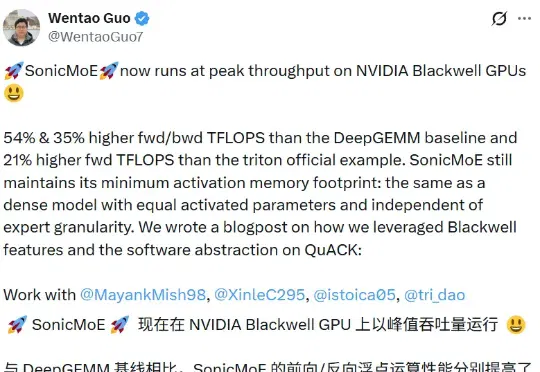
近日,由普林斯顿大学 Tri Dao(FlashAttention 的一作)和加州大学伯克利分校 Ion Stoica 领导的一个联合研究团队也做出了一个超快的索尼克:SonicMoE。据介绍,SonicMoE 能在英伟达 Blackwell GPU 上以峰值吞吐量运行!并且运算性能超过了 DeepSeek 之前开源并引发巨大轰动的 DeepGEMM。
参与交流
了解加入交流群的方式,阅读内容无需登录。