ACL 2026|告别冗长思维链!Laser用「概率叠加」重塑多模态大模型隐式推理(在新窗口打开)
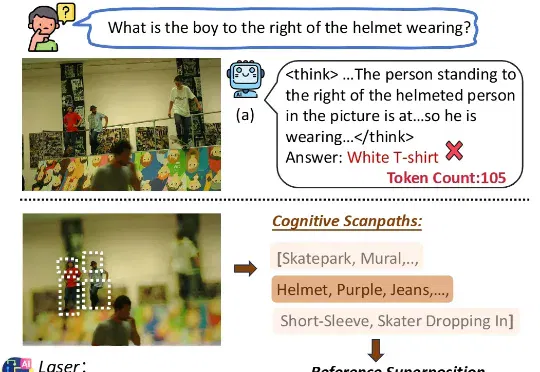
为了解决这一痛点,由 MBZUAI、复旦大学、中国人民大学高瓴人工智能学院以及哈佛大学联合组成的研究团队,提出了一种名为 Laser 的全新隐式视觉推理范式。该研究从认知心理学中汲取灵感,引入了 “Forest-before-Trees” 的认知机制,通过动态窗口对齐学习(DWAL),首次实现了在隐空间中维持视觉特征的 “概率叠加” 状态。
内容栏目
分享不同 AI 工具、模型与相关技术的使用方法和实践文章。
为了解决这一痛点,由 MBZUAI、复旦大学、中国人民大学高瓴人工智能学院以及哈佛大学联合组成的研究团队,提出了一种名为 Laser 的全新隐式视觉推理范式。该研究从认知心理学中汲取灵感,引入了 “Forest-before-Trees” 的认知机制,通过动态窗口对齐学习(DWAL),首次实现了在隐空间中维持视觉特征的 “概率叠加” 状态。
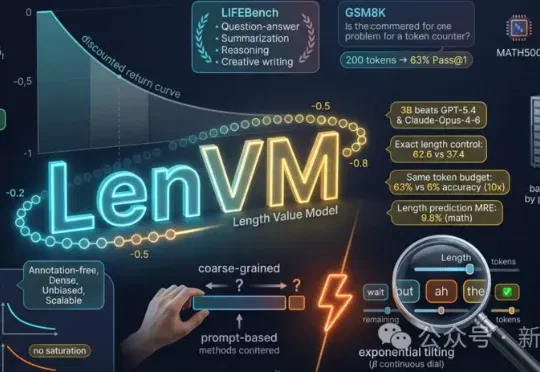
LenVM将长度建模提升到token级别,开辟可扩展价值预训练的新维度——3B开源模型精确长度控制全面击败GPT-5.4、Claude-Opus-4-6等顶级闭源模型;相同token预算下推理准确率提升10倍(63% vs 6%);沿模型规模、数据量、采样数三轴无饱和scaling的value pretraining
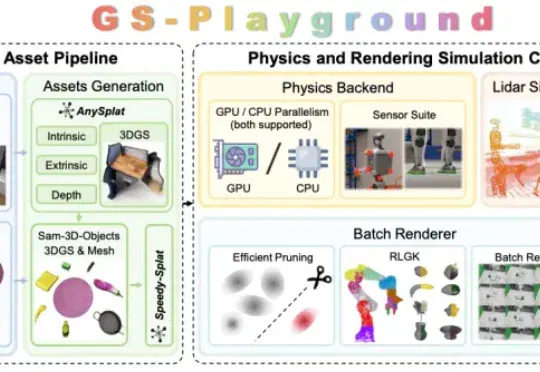
近日,清华大学智能产业研究院(AIR)DISCOVER Lab 联合谋先飞技术、原力灵机、求之科技和地瓜机器人,提出了新一代高通量视觉高保真仿真器 GS-Playground。该成果已被机器人领域国际顶级学术会议 RSS 2026(Robotics: Science and Systems)录用,标志着国内具身智能仿真基础设施在视觉保真度与训练吞吐量两个维度上同时取得了国际领先水平的突破。
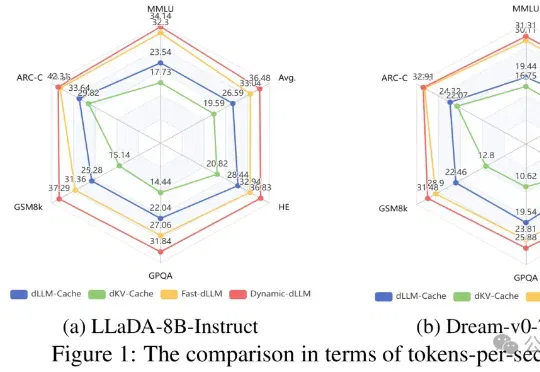
文本生成这件事,扩散大语言模型(dLLMs)正展现出巨大的潜力。但与此同时,它也面临着严重的计算瓶颈——为此,哈工大(深圳)与华为、深圳河套学院的研究团队提出了一套免训练加速框架Dynamic-dLLM。
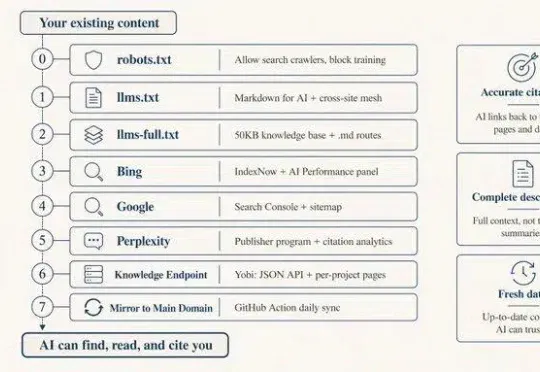
这几天有好几个小伙伴@我说,我的开源工具在他们问 AI 的时候被主动推荐了,啥也没做居然可以被收录,想着要不花一个小时把内容结构化整一整,应该会更好,于是整好以后,快速发了一个速记推,但是内容结构不清晰,想着大家很感兴趣,那要不就整一个结构清晰的文章便于沉淀和查找。
智能体时代的核心是算力。 尤其是在 Coding Agent 爆发之后,算力问题变得前所未有地尖锐。Claude Code、Codex、Cursor 等产品正在把 AI 从「问答工具」变成「持续运行的软件协作者」,单次会话轻松突破 50K tokens,系统负载转向了更极端、更复杂的智能体负载。 最近有关算力的大新闻层出不穷。今天的最新消息:马斯克的 SpaceX 与 Anthropic 宣布达成了重磅协议,超过 22 万块英伟达 GPU 将为 Anthropic 所用。而 Anthropic 对与 SpaceX 合作开发未来的太空算力体系「表示有兴趣」。 在如此庞大的算力需求下,除了开源还有
那个一句话生成完整物理世界、做出 GitHub 最大开源机器人项目的团队,又出手了。
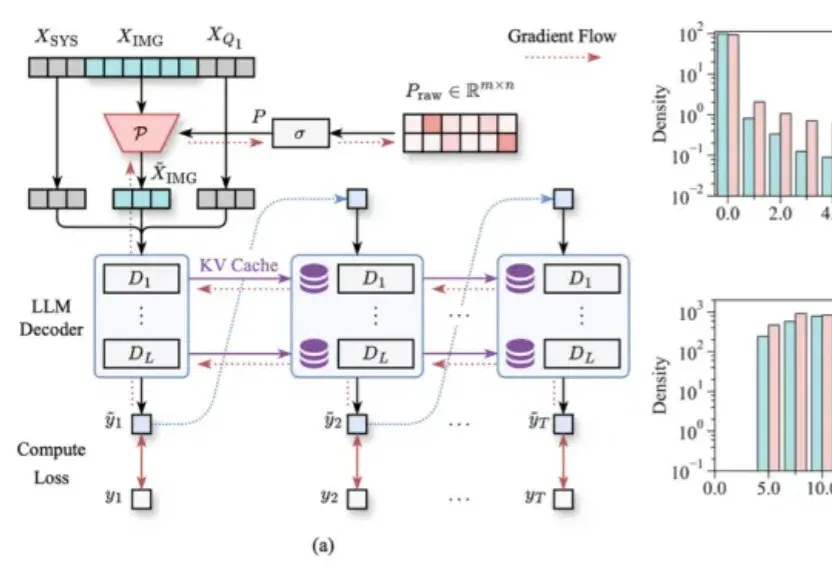
多轮视觉问答,正在成为LVLM推理效率的“照妖镜”。
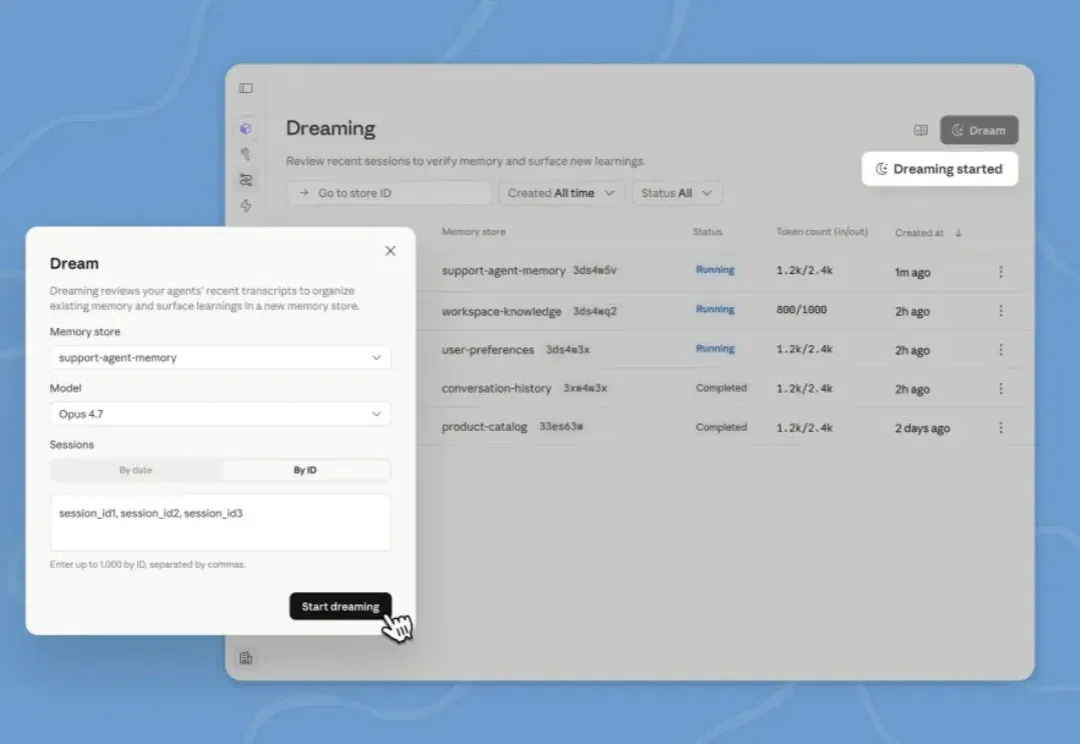
之前 Claude Code 源码泄露的时候,大家惊奇的发现,里面有一个正在开发的功能:做梦
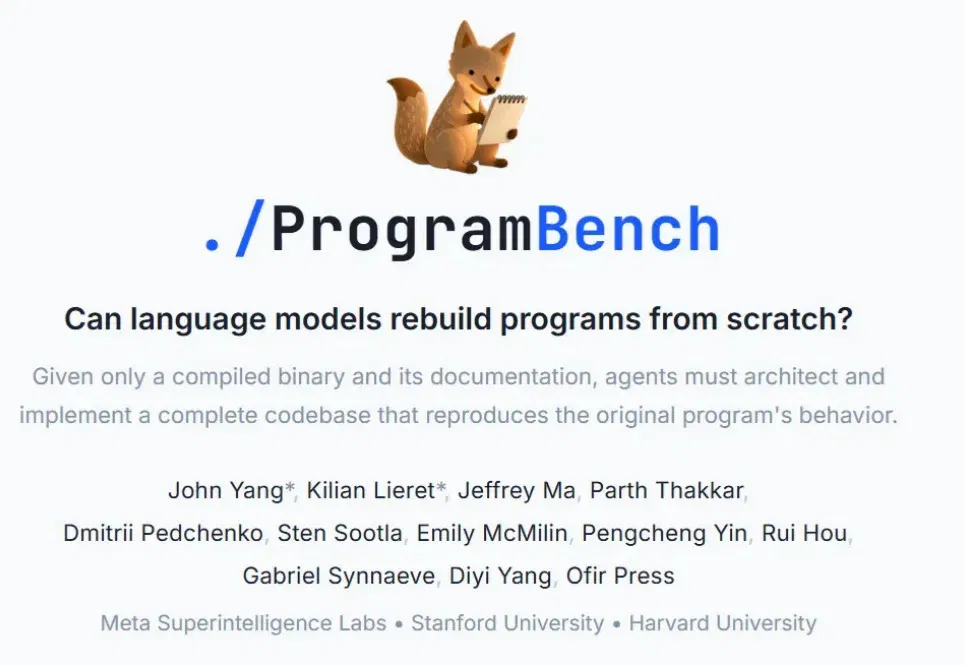
SWE-Bench 的创建者,刚刚又放出了一个地狱级新 benchmark。
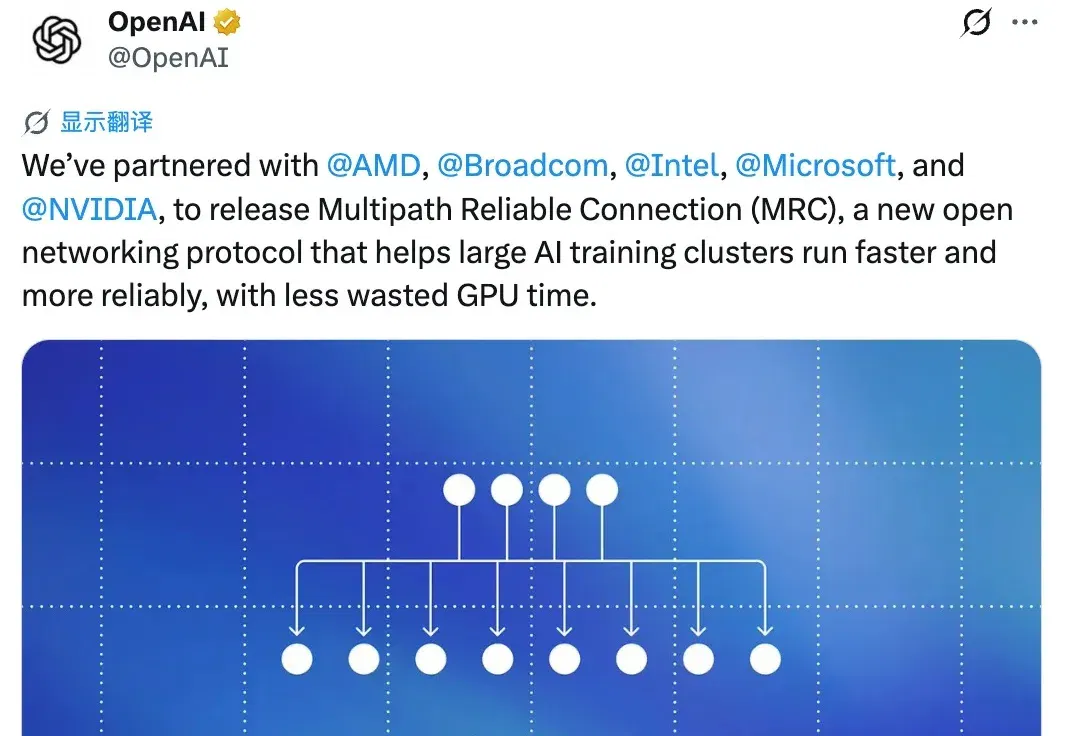
OpenAI,这次又真·Open了一下。
看过的人已经傻眼了,因为这可能是今年为止最炸的机器人demo。
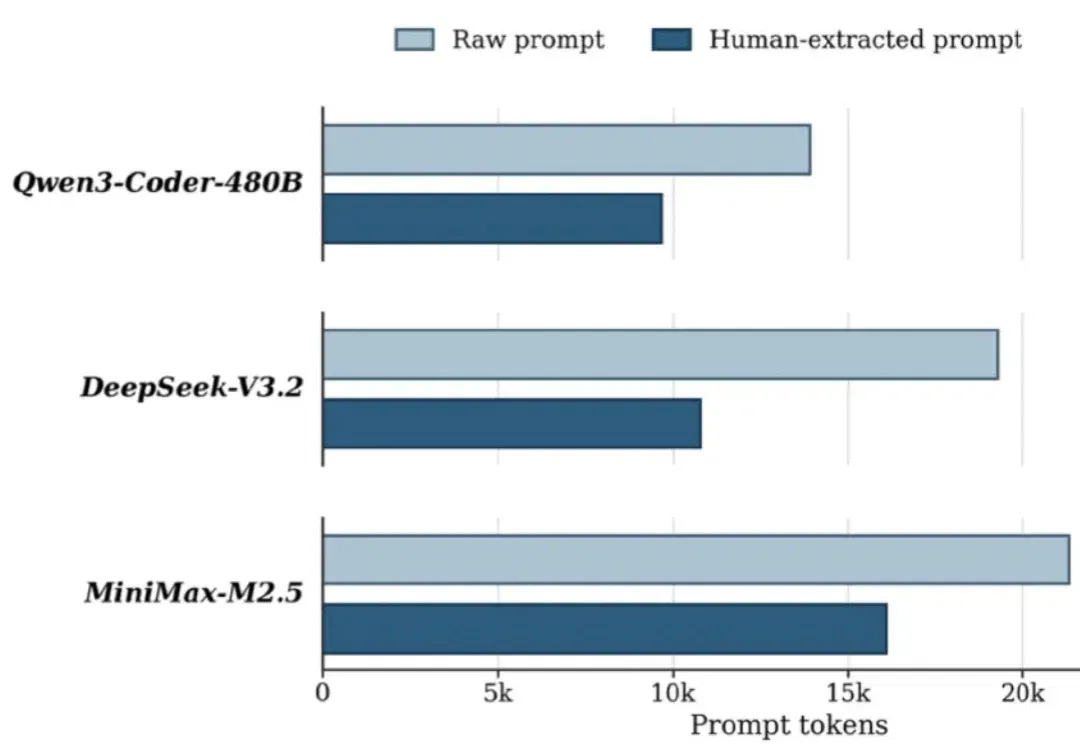
随着代码智能从 code foundation models 走向 autonomous coding agents,CLI/terminal 正在成为智能体进入真实软件工程工作流的重要入口。
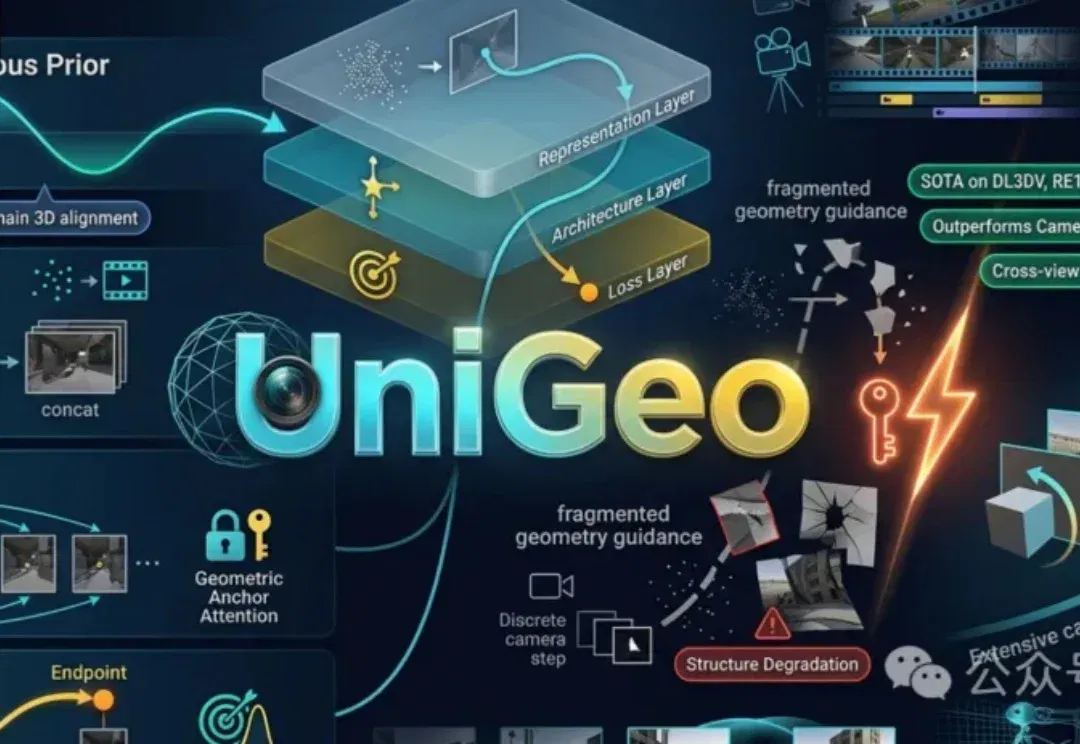
UniGeo通过视频模型的连续视角先验与统一几何引导,实现稳定、高质量的相机可控图像生成,全面超越现有方法,在不同幅度的相机运动中提升跨视角一致性与结构稳定性。
在代码大模型和代码智能体技术快速发展的今天,一个日益凸显的现象是:能够在经典代码生成基准上取得优异成绩的模型,一旦被放入真实软件工程环境中,表现却往往大幅下滑。
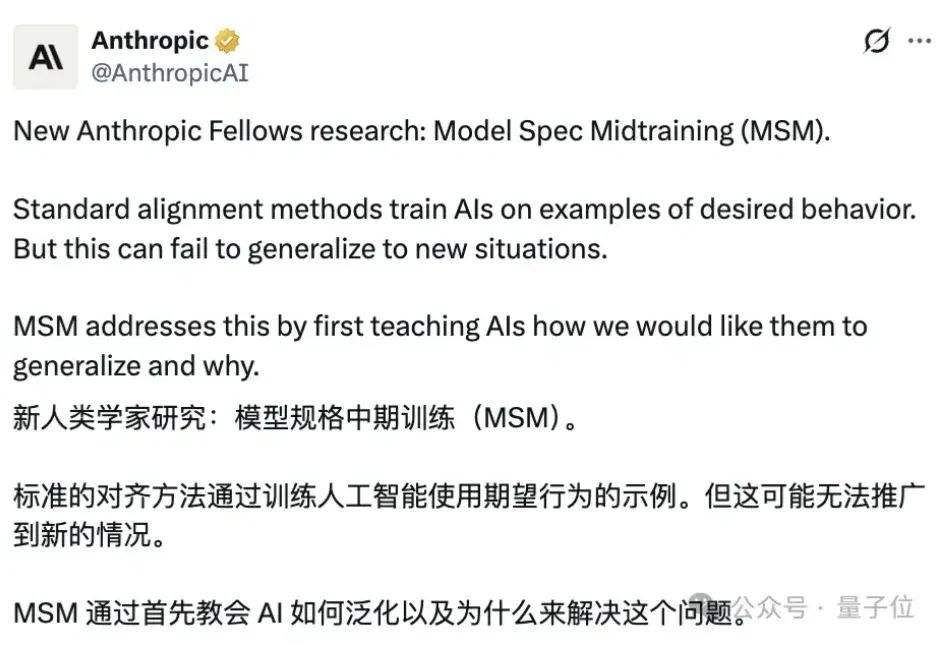
别人做AI中训练都在堆语料、补知识。 Anthropic这边直接给大模型上价值观必修课。 最新研究提出的中训练(简称MSM)精准插在预训练之后、后训练之前,专门用来给AI立规矩、塑三观。 更准确地说,就是在模型预训练结束、还没开始对齐微调之前,先用模型规范讲解文档做一轮对齐前置特训。 在这个阶段,模型不直接学习合规行为案例,而是通过大量专门讲解模型规范的合成文档,进行专项训练。 让模型先完整理解自身需要遵守的规范、原则、价值内核,再进入后续的对齐微调环节。 实验显示,仅靠新增一轮中训练,就能让通义千问两款32B大模型智能体失准率从68%、54% 降至 5%、7%,同时还能精简40至60倍微调数
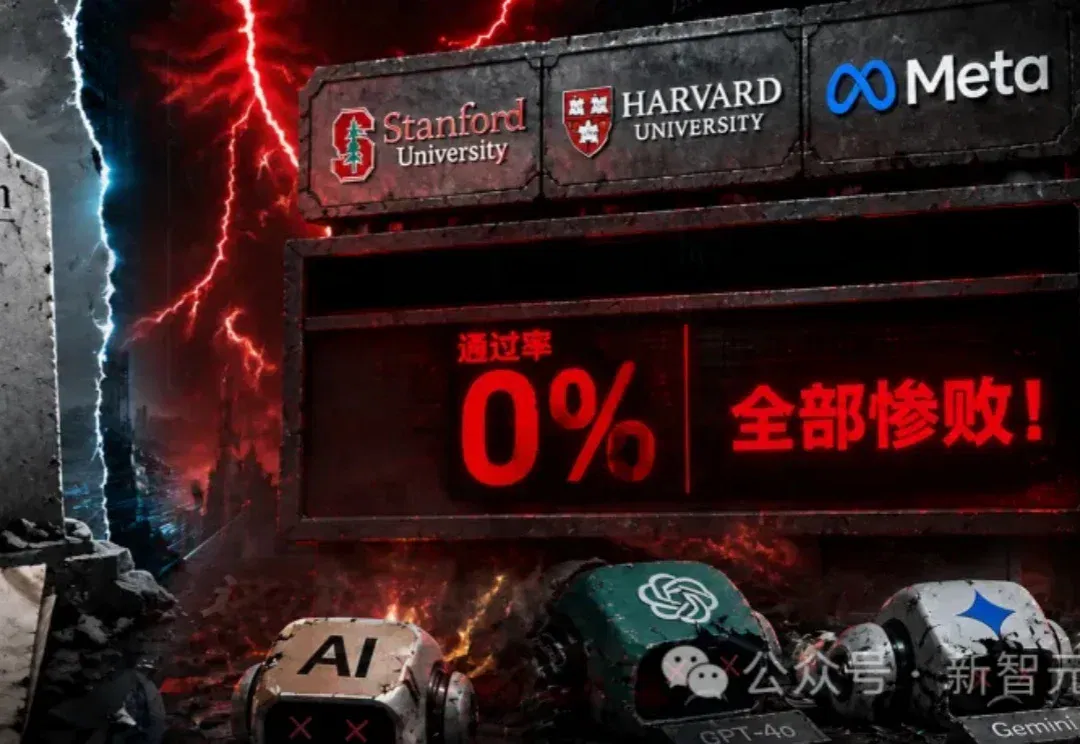
SWE-Bench上能拿72%的模型,换张考卷直接归零!Meta联合斯坦福、哈佛放出ProgramBench,200个项目从零手写,9大顶级模型完整通过率0%。最强的Claude Opus 4.7平均通过率也才51.2%。更离谱的是一联网,就有模型在36%的任务里跑去GitHub扒源码。
Agent Skills不应该只以SKILL.md、README或自然语言说明文档的形式存在,而应该被转成一种机器可检索、可检查、可治理的结构化表示。这是《From Skill Text to Skill Structure: The Scheduling-Structural-Logical Representation for Agent Skills》这篇论文的核心主张。
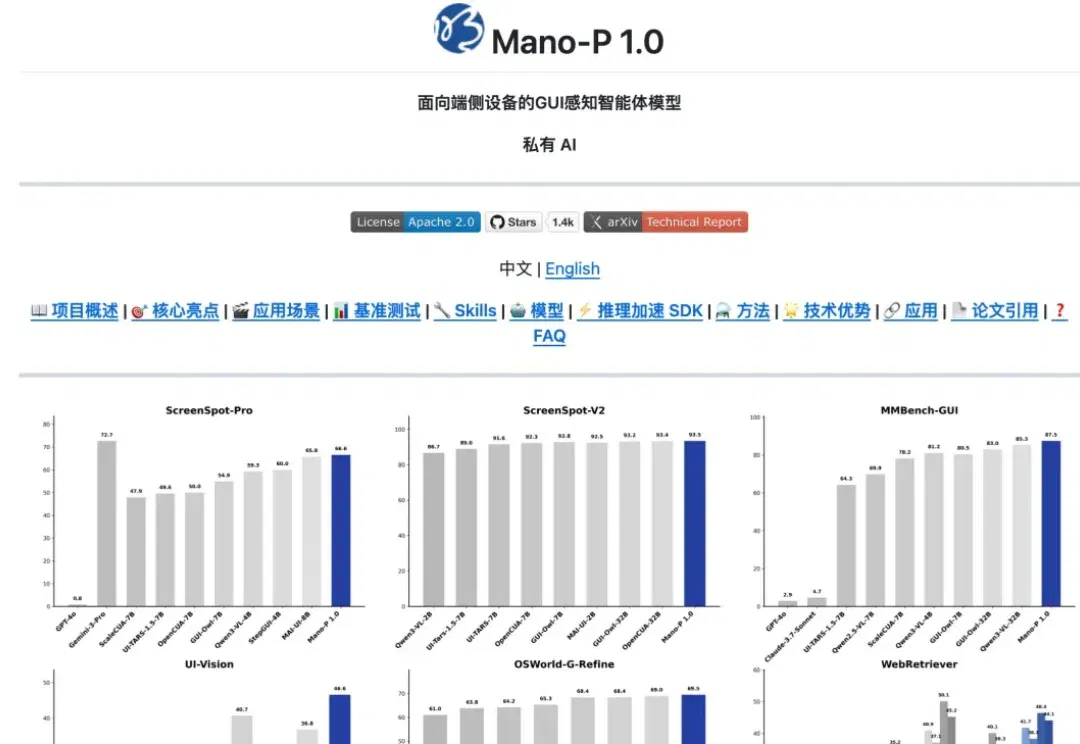
上次给大家分享了一个 CUA 的开源项目,能让 AI Agent 直接操控电脑界面,相当于把任何 App 都变成 Agent 的 Skill。反响还不错。
当Agent开始真正进入生产环境,安全问题不再是「功能模块」,而是贯穿调用链、运行时与生态层的系统性风险。过去依赖提示词规则、日志审计与框架级防护的方式,正在逐步失效。来自清华大学人工智能学院、交叉信息研究院的方寸跃迁提出一套面向Agent运行全生命周期的多层安全体系。
参与交流
了解加入交流群的方式,阅读内容无需登录。