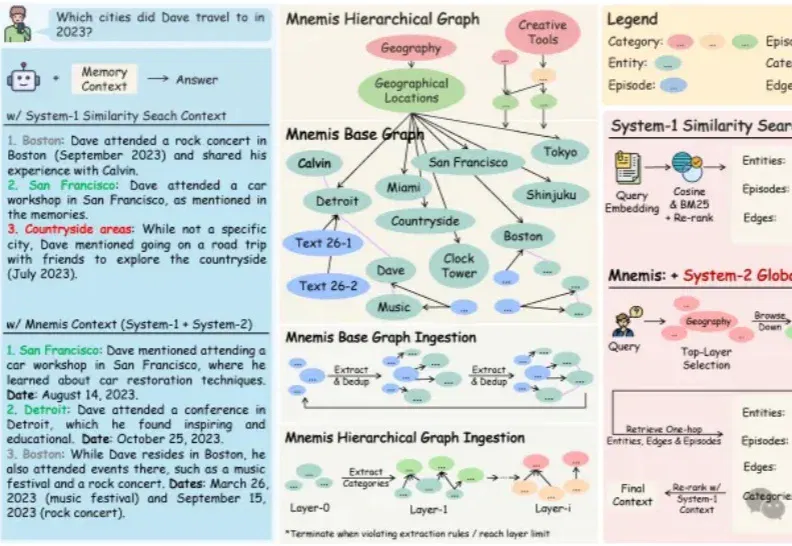
双榜SOTA!微软ACL2026新作重新定义AI长记忆(在新窗口打开)
随着大语言模型在各类应用中加速落地,一个核心技术瓶颈日益凸显——AI始终缺乏真正的长期记忆能力。当前主流的RAG(检索增强生成)方案依赖语义相似度检索历史信息,但“语义相似”并不等于“真正相关”,常常出现检索结果不完整、无法区分信息相关性、缺乏推理能力等问题。
内容栏目
分享不同 AI 工具、模型与相关技术的使用方法和实践文章。
随着大语言模型在各类应用中加速落地,一个核心技术瓶颈日益凸显——AI始终缺乏真正的长期记忆能力。当前主流的RAG(检索增强生成)方案依赖语义相似度检索历史信息,但“语义相似”并不等于“真正相关”,常常出现检索结果不完整、无法区分信息相关性、缺乏推理能力等问题。
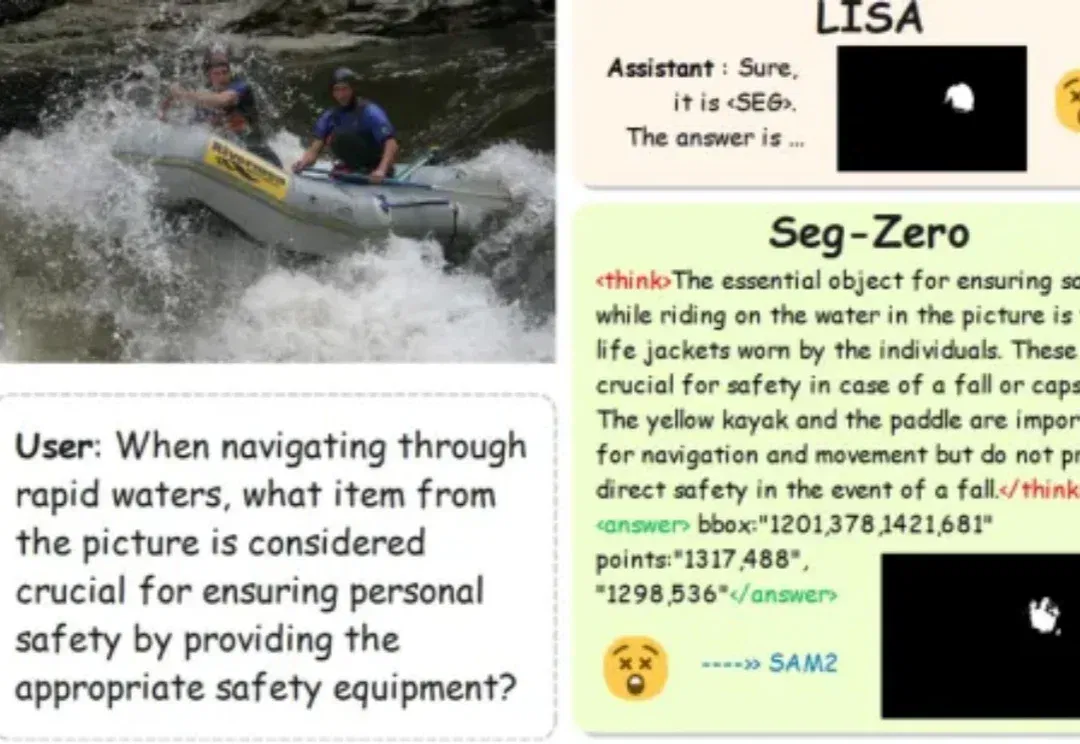
智能体时代,如何让视觉分割更准确? 复旦、创智联合推出RSAgent,给出最新答案——让多模态大模型通过多轮工具调用生成准确掩码。 相关工作已入选ICML 2026。 视觉分割,一直是个“说起来简单,但做起来容易失手”的任务。 给模型一张图、一句话,让它把目标区域的像素圈出来——听起来直接,但一旦目标含糊、被遮挡,或者需要推理才能定位,一次性猜出正确的掩码就变得相当困难。 RSAgent团队认为,现有方法缺少的,不是更强的分割头,而是“确认和纠错”的过程。 为此,他们推出了RSAgent这个让多模态大模型通过多轮工具调用,完成文本引导分割的智能体框架。 模型不再一次性输出mask,而是先观察图
在这些场景,一个集合也许一个月只被查询几次,运行时间不超过5小时,用户也并不需要为此投入向量数据库级别的资源建设,让高性能资源一个月时间里有715小时都被浪费。相应的,成本也就成了这一场景下的优先考量要素。而解决这一问题,也是我们选择在近期推出Vector Lakebase 产品的初心所在。
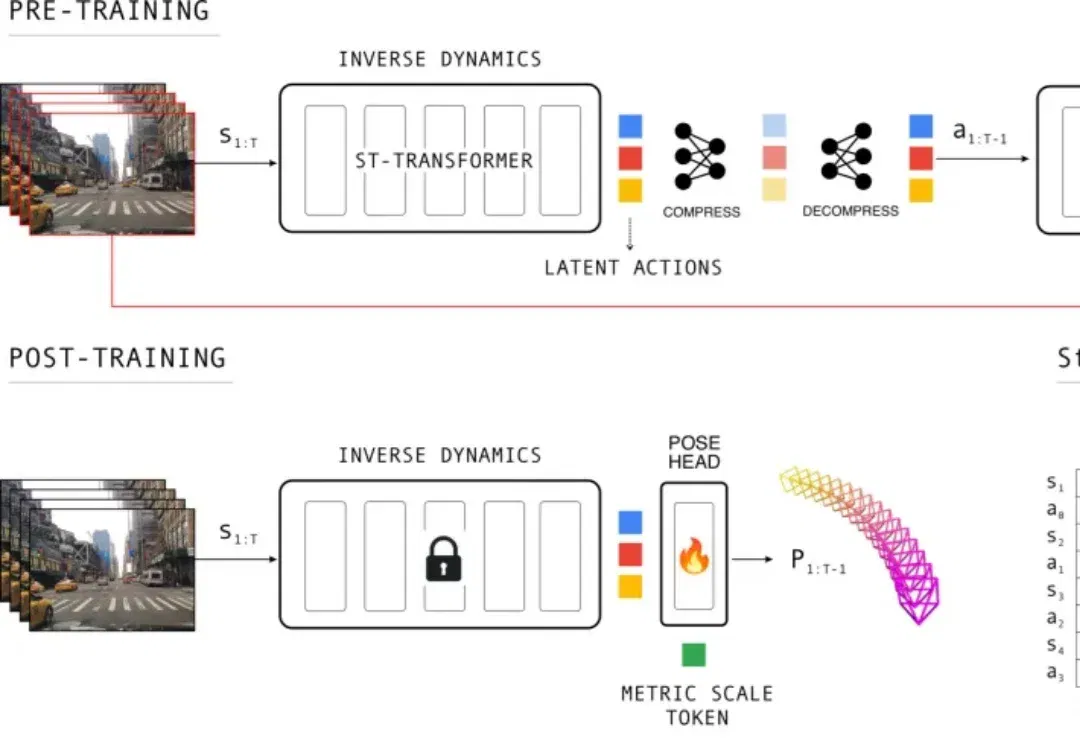
不用百万级 3D 标注,模型也能从普通驾驶视频中学会「自己是怎么动的」。Wayve 的 LA-Pose 试图把未标注视频里的运动信号,转化为自动驾驶系统所需的相机位姿估计能力。
众所周知,大模型训练成本极高。 但大家又知道,降低训练精度能够显著降低训练成本。DeepSeek-V3 用 FP8 训练把成本打到了 560 万美元,已经让全行业侧目。 在 FP8 成功后,行业仍然在不断探索低精度的边界:从 FP8 降到 FP4,训练成本还能再降多少? 理论上,FP4 的计算吞吐可以是 FP8 的两倍。NVIDIA Blackwell 和 AMD MI350 系列都已经在硬件层面原生支持了 FP4 运算,前者在 B200 上标称 FP4 算力可达 4500 TOPS(稀疏)。硬件已经准备好了,但软件和算法那一侧,一直卡在一个问题上: 用 FP4 从头训练大模型,训练过程非常不
过去几年,大模型竞争主要发生在 AI 公司之间。但随着 AI 开始从数字世界进入真实设备与物理世界,竞争逻辑正在发生变化。
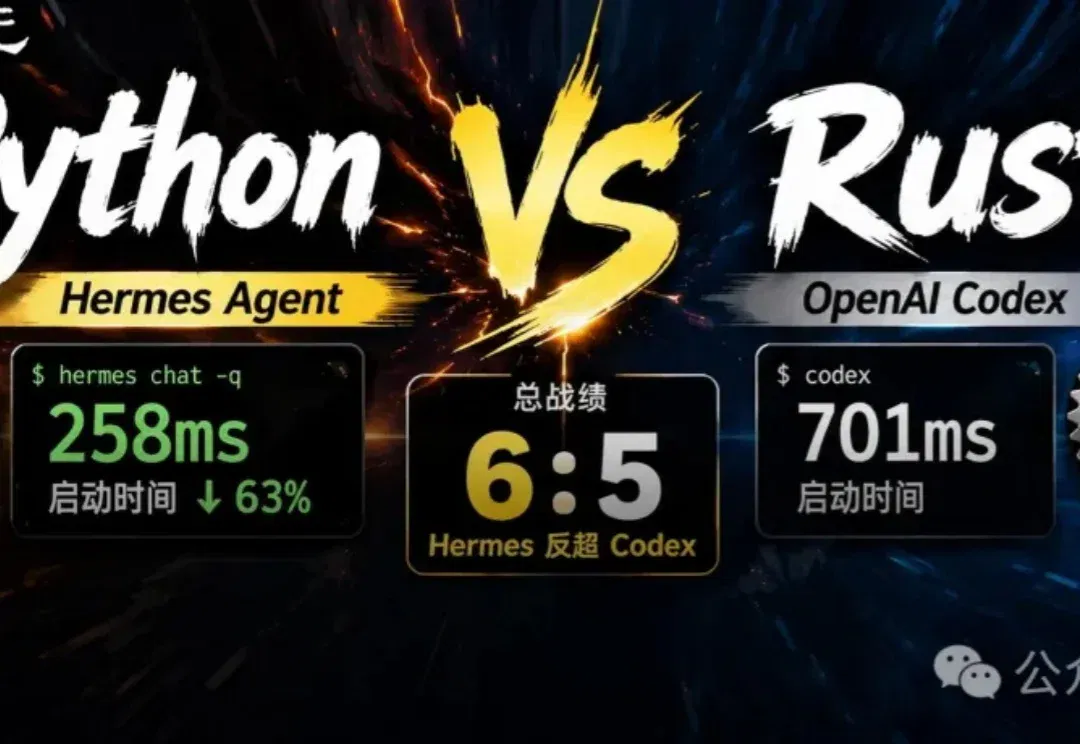
一个纯Python写的开源项目,竟把OpenAI用Rust写的王牌给秒了!最终战绩6比5,Hermes直接上演工程暴力美学,解释型语言终于逆天改命。
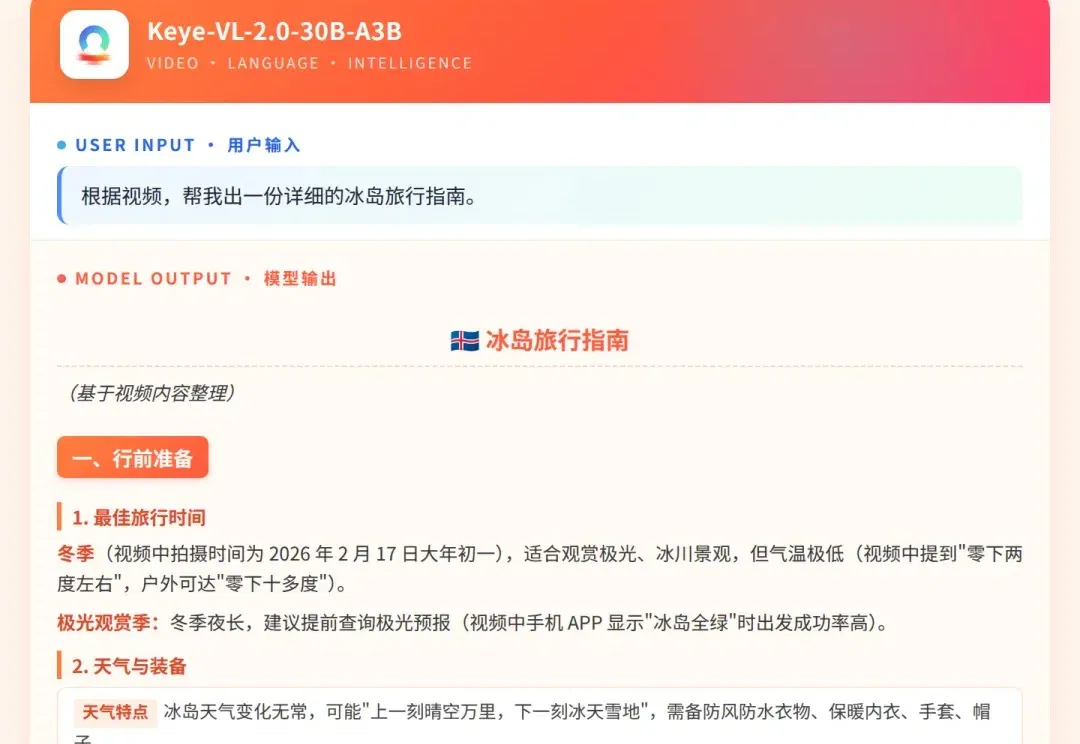
当你把一段长达9分钟、在“晴空万里”与“冰天雪地”间剧烈切换的冰岛旅行Vlog输入给大模型,并要求它做一份旅行攻略时,常规的视觉大模型通常只能给出一份基于字幕和画面标签拼凑的“流水账”。
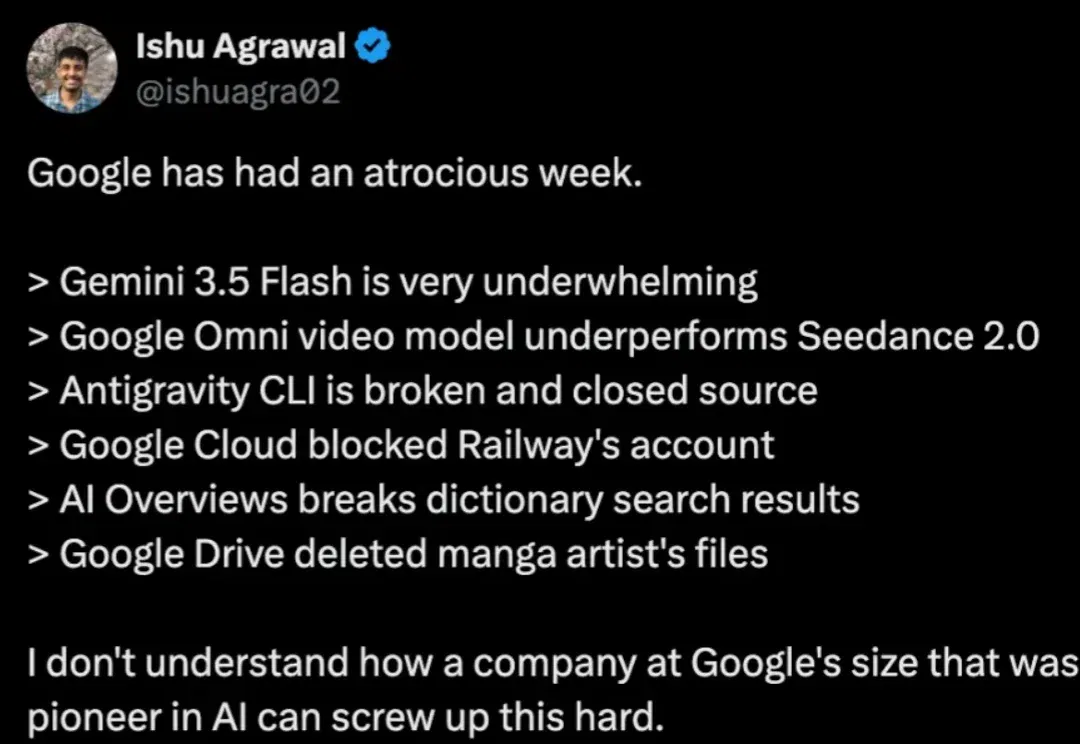
最近,谷歌的日子不太好过。 自从 I/O 大会以来,谷歌经历了连环翻车: Gemini 3.5 Flash 被网友吐槽实际体验、额度消耗和稳定性不及预期;Gemini Omni Flash 原生多模态视频生成与编辑模型,表现不如 Seedance 2.0;Antigravity CLI 闭源、bug 多、且还被抓到演示视频里出现 Codex 文件;Google Cloud 自动风控系统错误封禁了知名 PaaS 平台 Railway 的账号,导致 Railway 服务大面积宕机好几个小时;AI Overviews 搜索 disregard、ignore 等单词时,AI 不正常显示字典释义,把搜索
Code Arena最新放榜,Qwen3.7-Max以1541分冲进全球第四,成为前五中唯一的非Claude模型。编程,中国模型第一次杀到这个位置。
Anatoli Kopadze 这条帖子 2200 万阅读,我一开始以为又是那种「10 个 AI 技巧改变你人生」的流量帖。点进去一看——还真有东西。17 个功能里大概有 5 个我压根不知道存在,还有 3 个我一直在用但用法完全是错的。
最近到了毕业季,好多朋友来找我聊一件事:有什么办法帮他降 AIGC。
说在前面:这又是一篇讲Harness的Survey,你最近可能已经看过了数篇讲Harness的文章、论文,其中还可能包括我上周解读的《Agent Harness Engineering:Agent的底盘工程综述|CMU、耶鲁、Amazon》。
多模态Agent最容易制造的一种错觉是:它看过图片,所以它记住了图片。
你的电脑里,或许很快会住进一只会聊天的「小怪兽」。
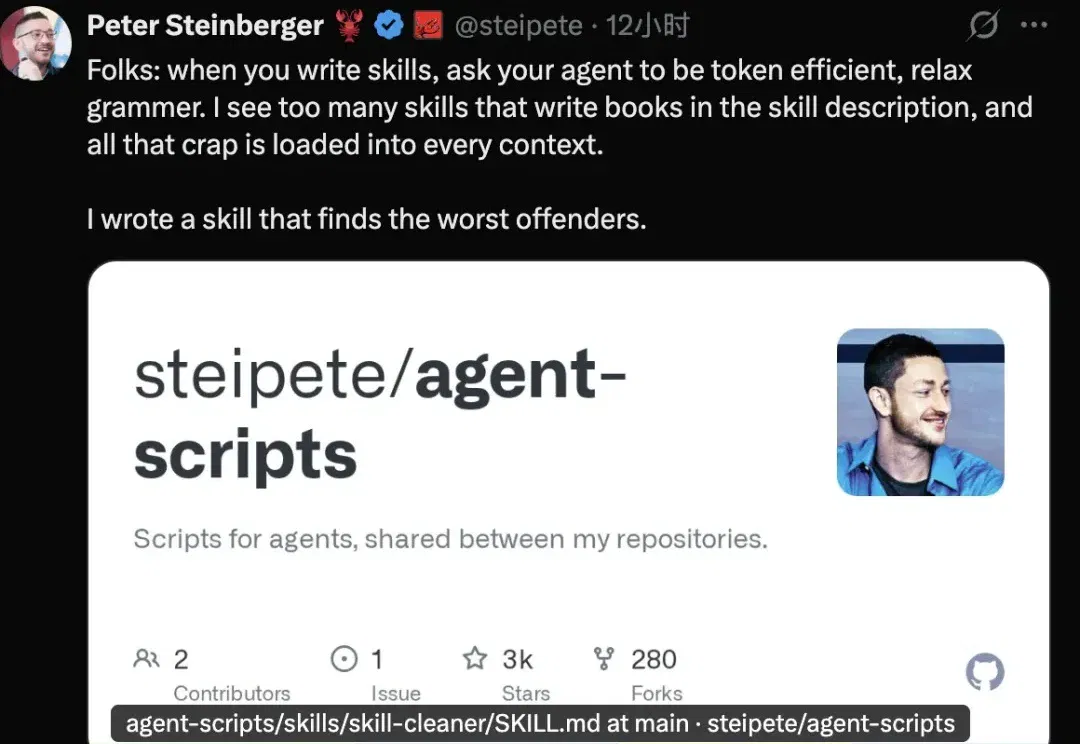
Skill水平参差不齐,龙虾之父Peter看不下去了。
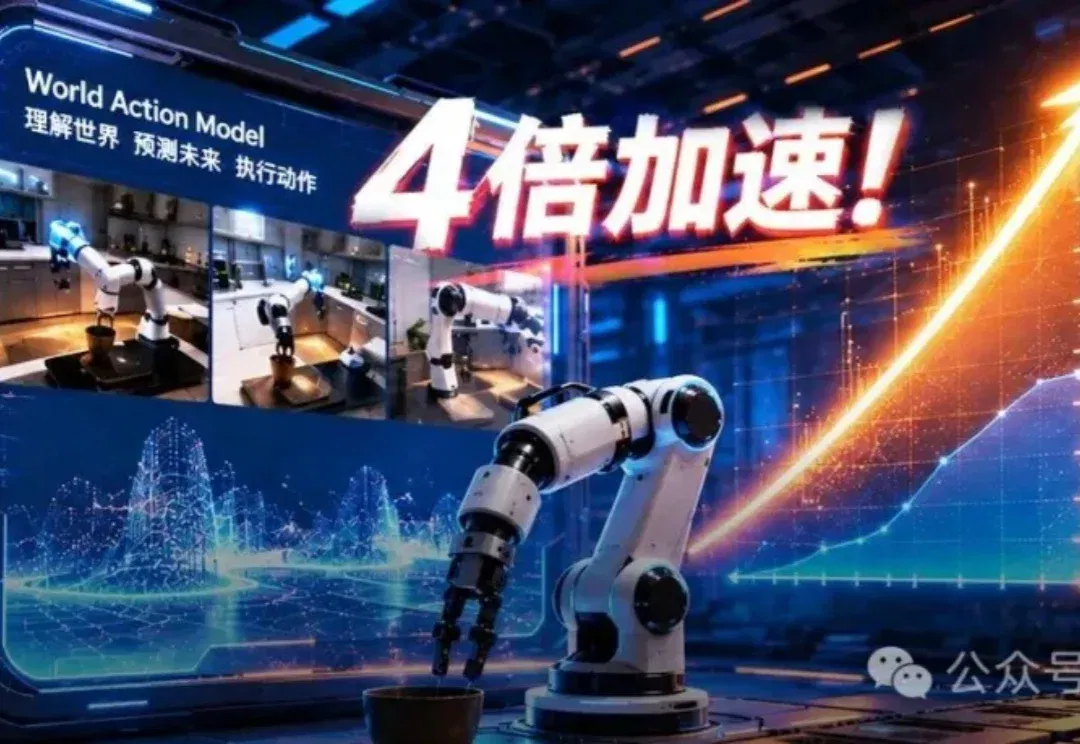
英伟达世界动作模型 DreamZero 训练一次要烧 8 张 H100 整整 25 天,RLinf 从算子融合到 I/O 全链路系统级重构,把训练吞吐拉高近 4 倍——1 个月的活,1 周就能干完。
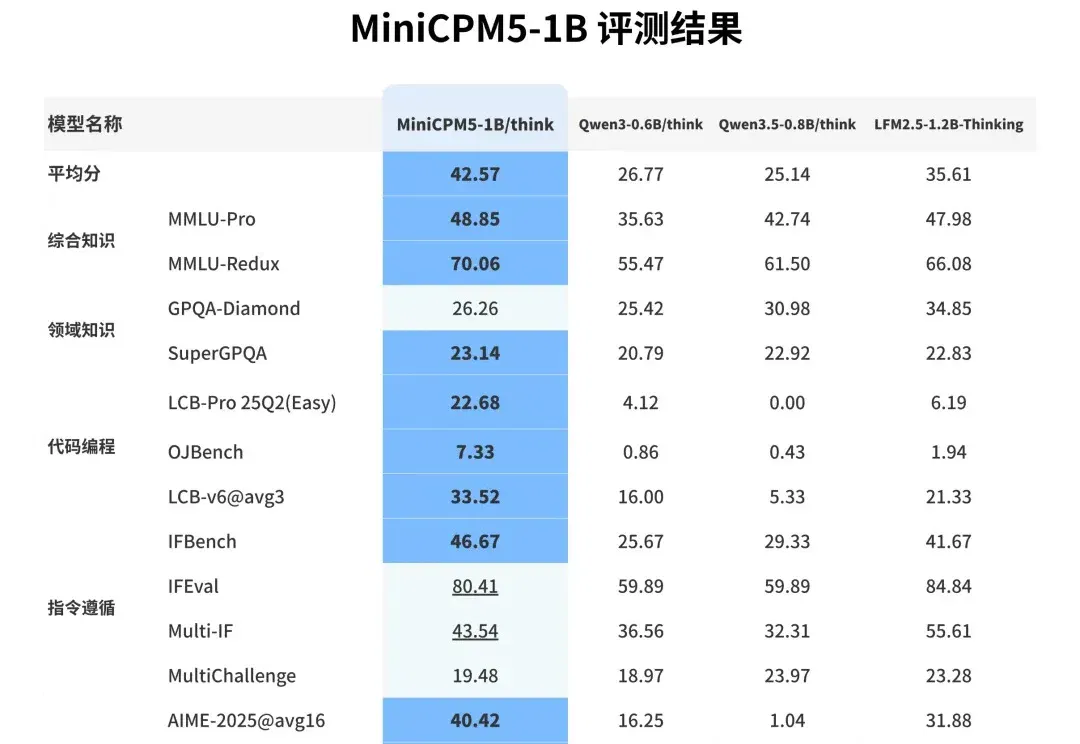
造AI这件事,现在的主角变成了AI。 因为就在刚刚,一个国产AI先自己写出了一套大模型预训练框架,然后再用这套预训练框架,训练出了一个新的小尺寸模型! 这就是面壁智能搞出来的big news。 这套由AI写出来的预训练框架叫做ForgeTrain,它是全球首个完全由AI编写的生产级大模型预训练框架,性能甚至超越了英伟达的Megatron。 并且ForgeTrain在华为昇腾上预训练MiniCPM5-1B,相比昇腾的框架也有10%的加速。 围绕它,面壁智能还提出了一套新的软件编程范式,叫Forge Engineering。 更直白一点说,就是当AI写代码的成本越来越低,未来软件不一定非要做成一套
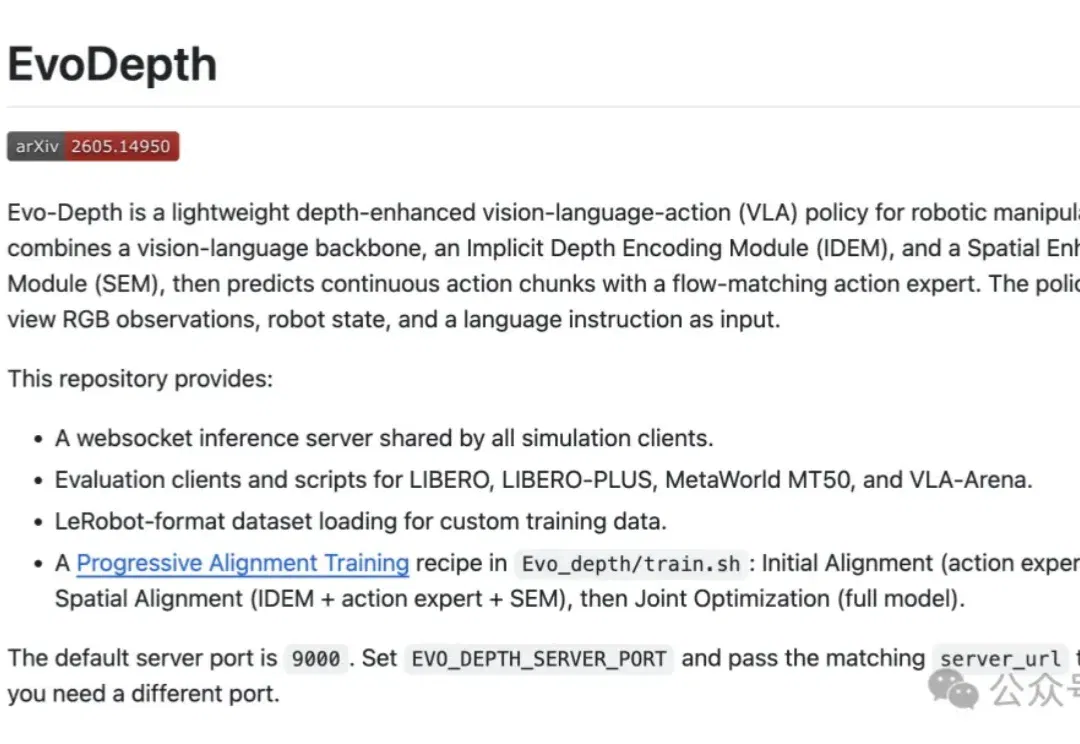
机器人看得见,但不一定看得准。 大量VLA模型仍然主要依赖二维视觉,一旦遇到精定位、细摆放、遮挡判断这类需要空间感知的任务,成功率就会明显下滑。 补空间信息的路有两条,但都有代价。 显式3D路线靠深度传感器和点云重建,硬件链路长、对标定误差敏感;隐式3D路线从RGB学几何,省了硬件,但不少方案依赖较重的基础模型,训练和推理成本偏高。 现在,上海交大MINT团队提出了一条中间路线: Evo-Depth,约0.9B参数,不额外增加硬件负担,用紧凑的隐式深度编码把空间感写进VLA策略里,仿真与真机同时兼顾性能与部署效率。 仿真端,Meta-World 84.4%、LIBERO 95.4%;真机平均成
“我语言的局限,即意味着我世界的局限。”( Die Grenzen meiner Sprache bedeuten die Grenzen meiner Welt. )
参与交流
了解加入交流群的方式,阅读内容无需登录。