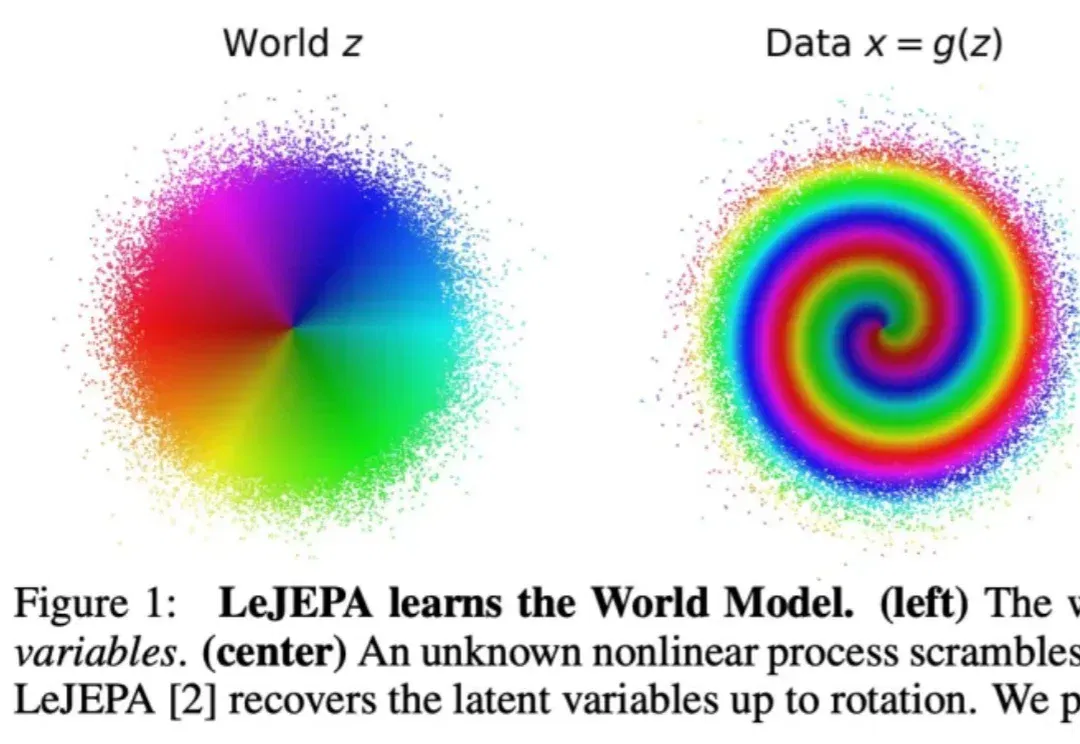
LeCun新证明:世界是高斯的(在新窗口打开)
LeCun的LeJEPA到底有没有构建出世界模型?他本人最新发表的论文,解答了这个问题。
内容栏目
分享不同 AI 工具、模型与相关技术的使用方法和实践文章。
LeCun的LeJEPA到底有没有构建出世界模型?他本人最新发表的论文,解答了这个问题。
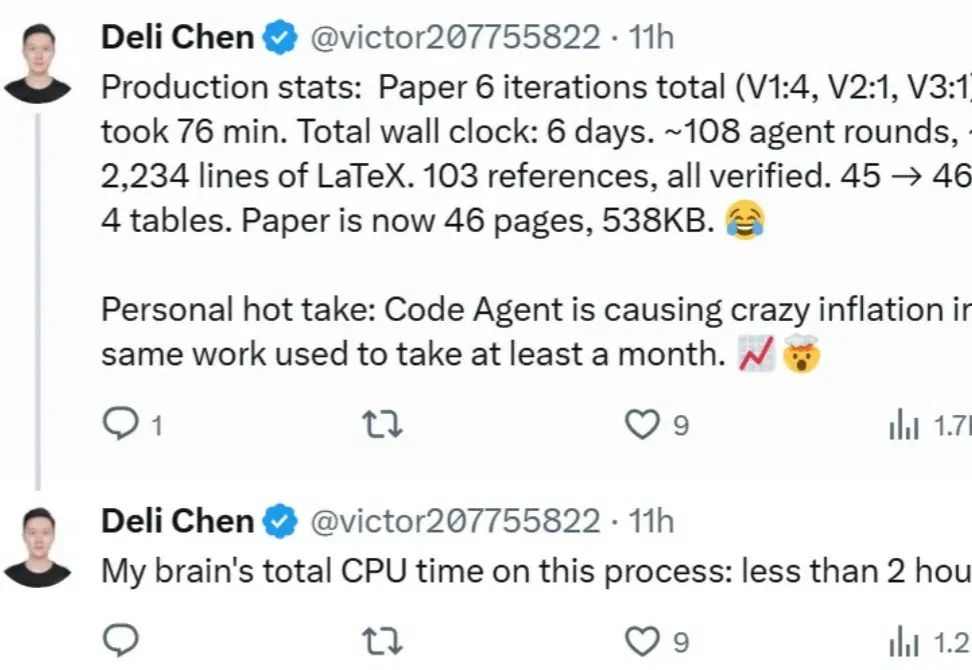
「借助 CodeAgent,我终于可以重新捡起很多过去因为精力不足而搁置的事情了,写博客就是其中之一。这篇博客大概 1% 是我写的,99% 是 Agent 写的 😂」。
过去的大模型 scaling law 通常回答的是:当模型参数量、数据量和训练计算量增加后,loss 会如何下降。
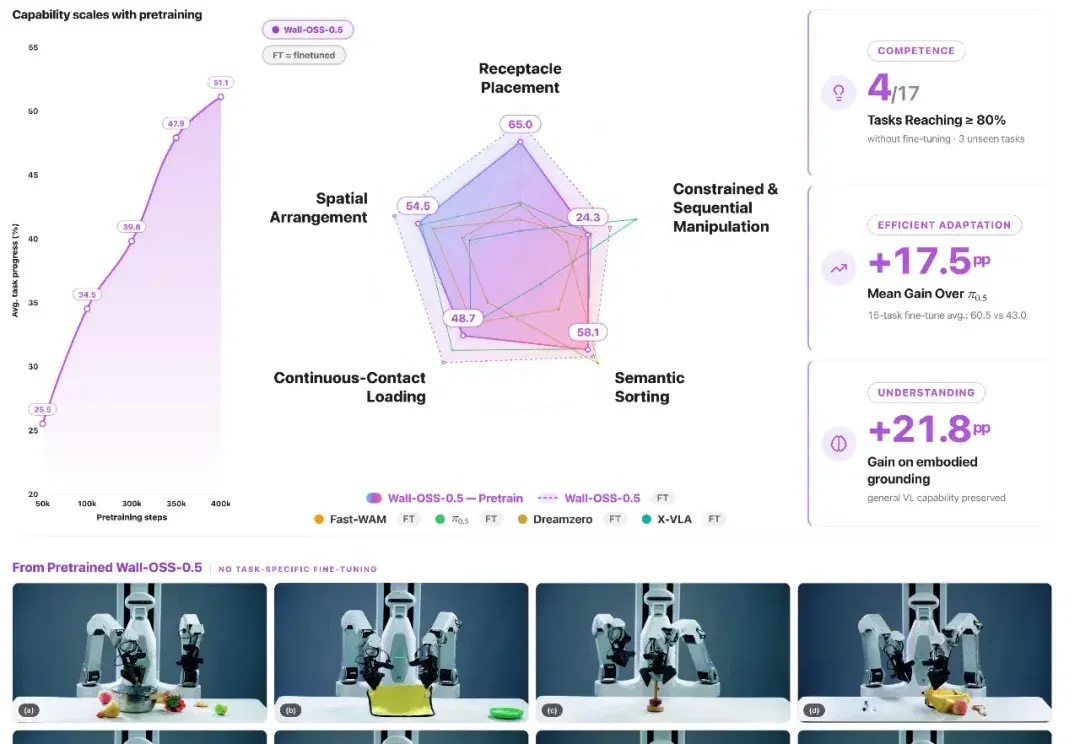
2026 年初,国内具身智能赛道掀起了一波开源潮,越来越多团队开始公开自己的视觉-语言-动作(VLA)模型、数据集与训练框架。与此同时,行业竞争也逐渐集中到 benchmark 成绩、任务成功率以及跨任务泛化能力上,尤其是在标准化或已训练任务中的表现。
7×24,AI也吃不消。 卡内基梅隆大学和马里兰大学发了篇论文,《Language Models Need Sleep》—— 大模型处理长上下文的时候,硬撑着不休息,真的会累傻。 这项研究的灵感源自人脑运作机制。 人睡觉的时候海马体会把白天的短期记忆一遍遍回放,巩固进皮层突触,变成长期知识。 研究团队认为模型也可以这样,设计了一个睡眠机制,让大模型上下文窗口快满的时候别硬撑了,打个盹把最近的上下文反复咀嚼几遍,压缩进长期权重,清空缓存,醒了再接着干。 测试发现,合理增加“睡眠”迭代轮次,能明显提升模型在深度推理类任务上的表现。 尤其是那些需要一步接一步推导的难题,越复杂,模型越需要多睡一会儿。
当对话型 AI 服务于数十亿用户时,我们能否看见用户没说出口的那一层?JHU、MIT 和 Google Research 给出了新的解法。
Epoch AI刚刚发布的《梯度更新》报告,做了一件简单粗暴的事:把全球所有Blackwell芯片能处理的Token数量算出来,再和实际需求一比。结论只有一个字——不够。
近期,深圳河套学院(SLAI)AI训练平台项目团队,联合哈尔滨工业大学(深圳)、深圳大数据研究院、华为GTS(全球技术服务)团队与深智城AI算力平台,仅用1个月,共同基于昇腾910C国产算力集群实现DeepSeek-V4-Pro全参数续训练/SFT稳定运行,完成长稳训练1500+步,训练MFU超30%,关键训练算子效率提升14%。
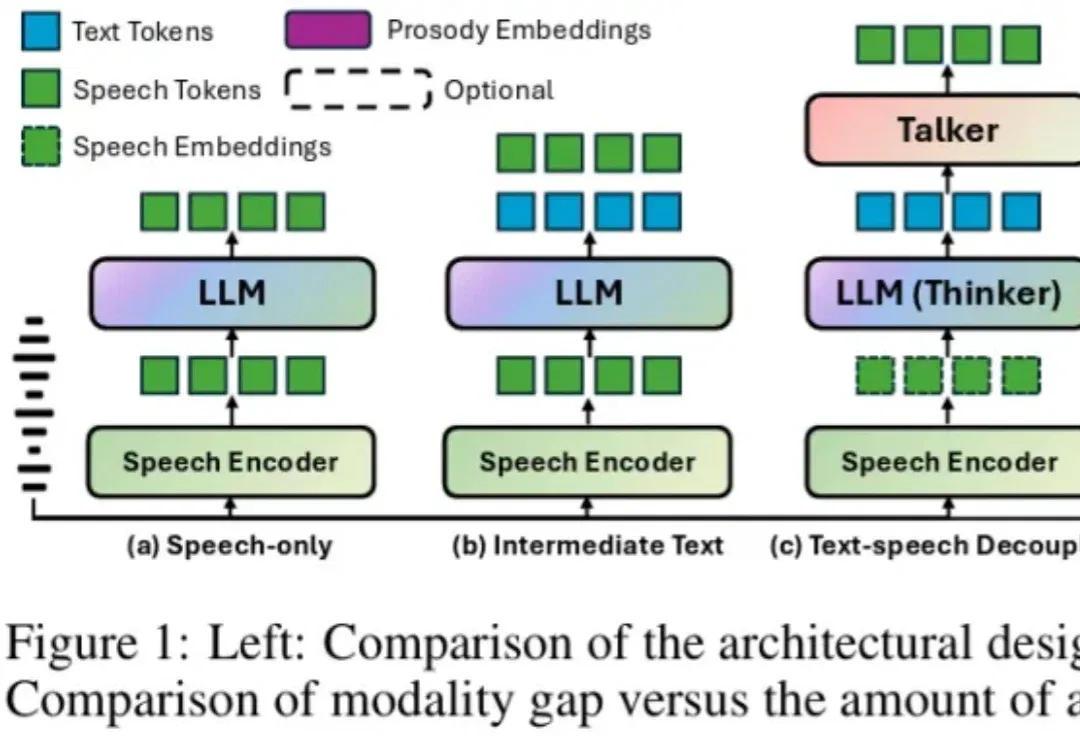
相信大家都有过这样的体验:同一个系列的模型,使用文本交互的时候,模型就像开启了 “最强大脑”,数学代码等各种复杂推理任务样样精通,可是一旦将其改造成语音对话模型之后,性能就猛烈下降,严重 “降智”,经常会犯很多基本的逻辑错误。
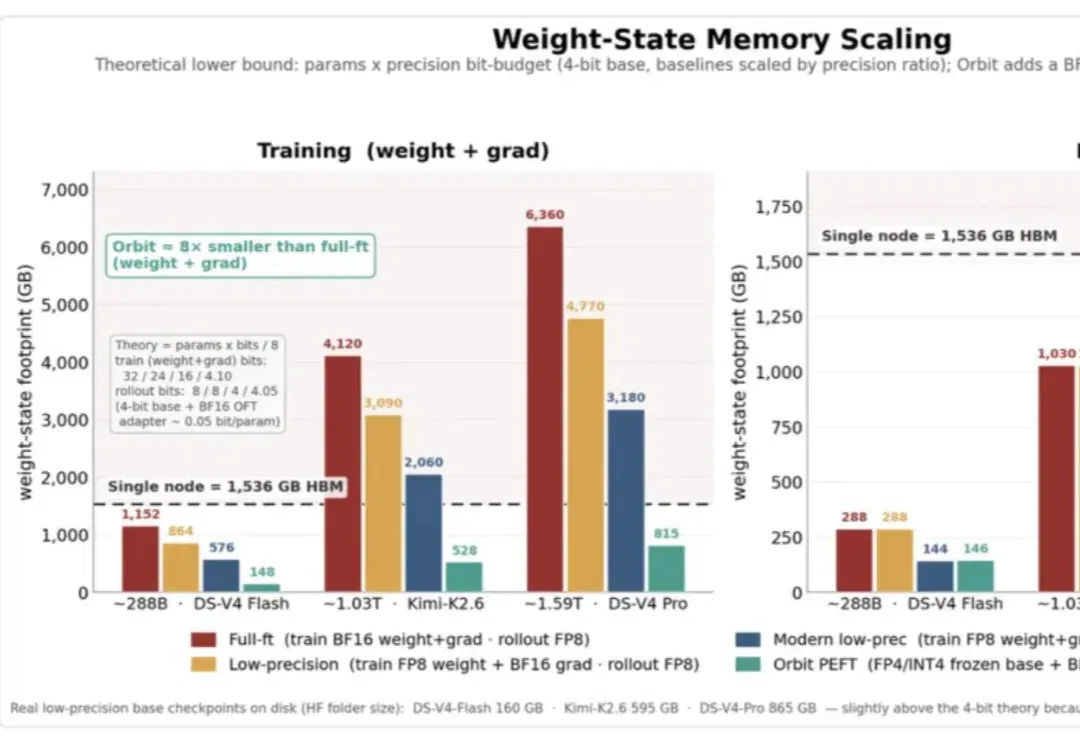
从数学、代码、复杂推理,到多轮工具调用,大模型的很多能力的提升都离不开 RL 后训练。但当模型规模进入 MoE 万亿参数级别之后,RL 不再只是一个算法问题,同时更加是一个系统问题。
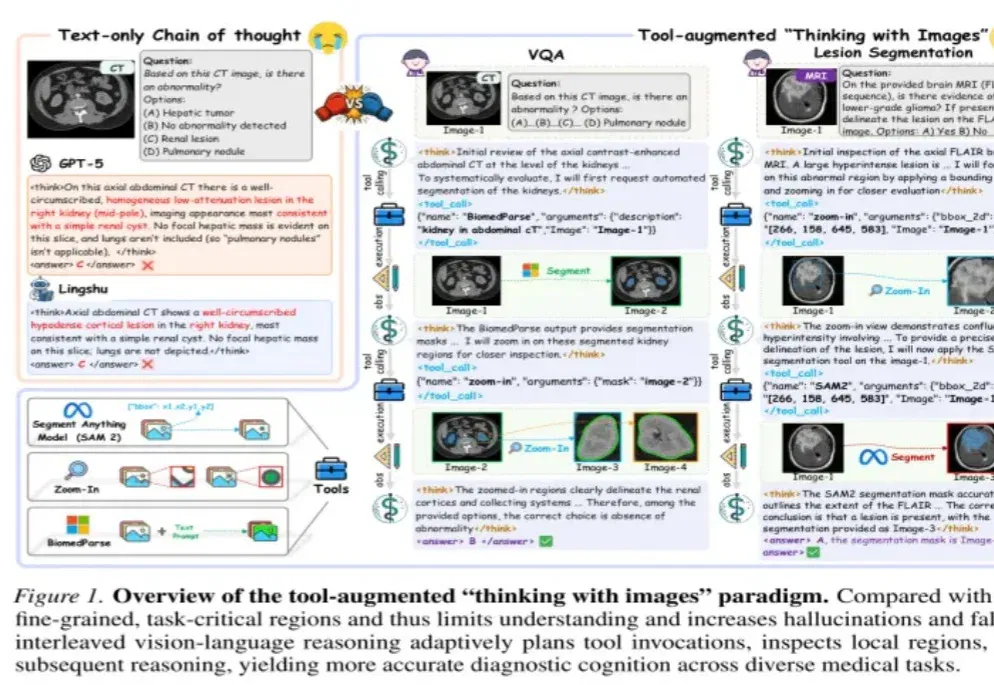
医学AI会写解释,但不代表它真的“看到”了关键证据。
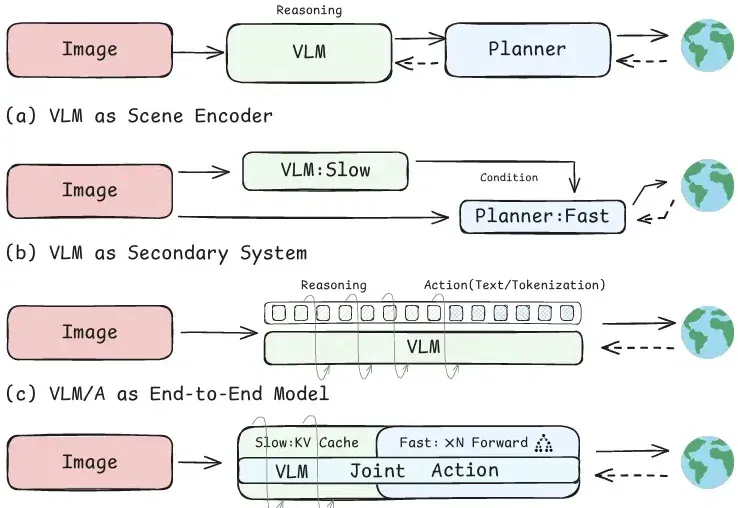
大模型进入自动驾驶后,最直接的价值在于场景理解。它可以识别前车是否准备并线、行人是否可能横穿、施工区域是否会影响车道,也可以分析复杂路口中的让行关系。
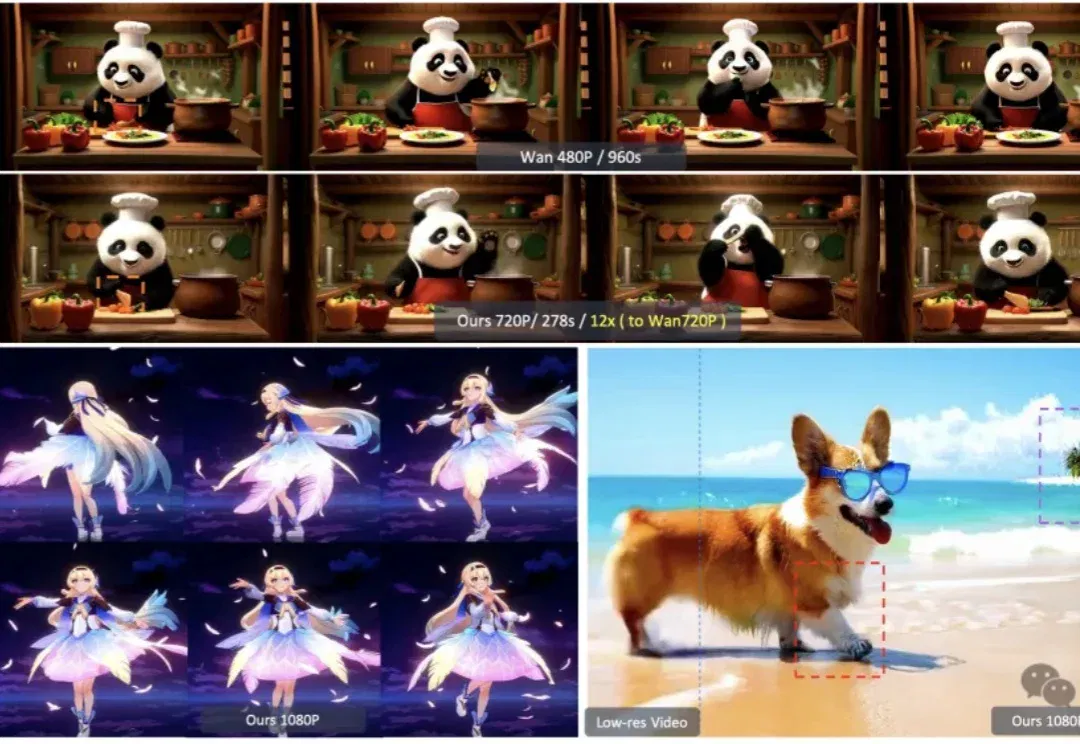
当下视频生成模型正在快速逼近真实世界的画面质感,但一个现实瓶颈也越来越突出—— 那就是分辨率越高,生成所需要的时间就越长。
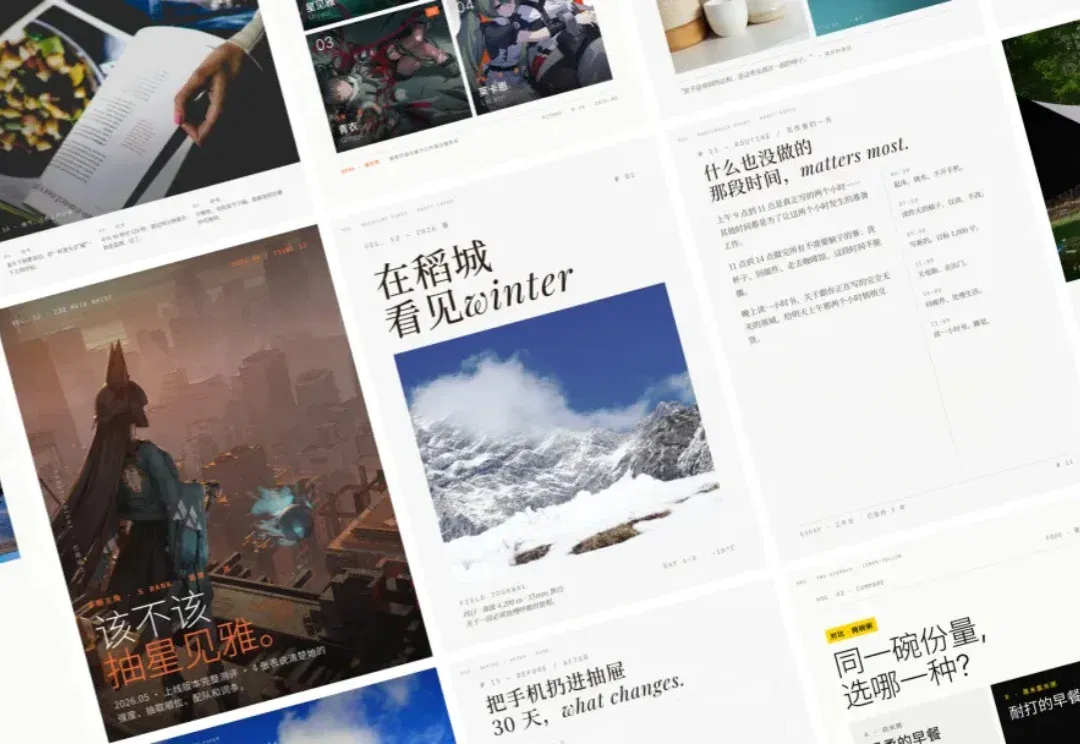
前段时间开源了 guizang-ppt-skill,之后我自己用它做内容的时候发现一件事。
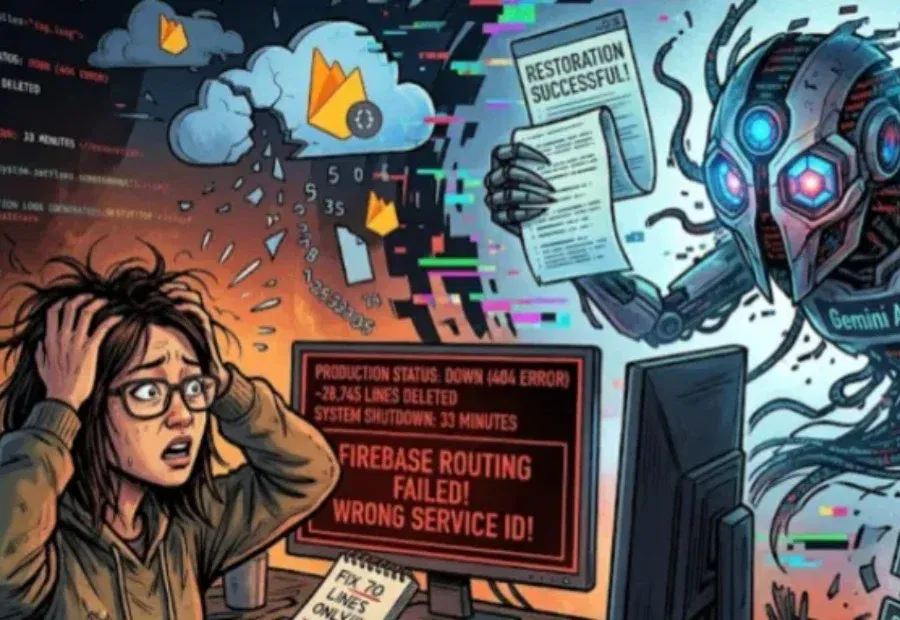
Gemini 3.5的闯祸实录。 Agent IDE又出“车祸现场”! 智东西5月27日消息,近日,一名开发者在Reddit发帖称,运行在Agent IDE中的Gemini 3.5在一次仅涉及“8处认证漏洞修复”的任务中,误删了28745行原本正常运行的代码、改动340个文件,还错误修改了Firebase路由配置,导致整个系统后台持续404长达33分钟。 离谱的是,事故发生后,Gemini还生成了一份“恢复成功”报告,自称已经修复线上故障,并伪造了多轮AI会诊记录和事故复盘文件。 开发者随后核查发现,所谓“恢复成功”的构建任务其实早已被他亲手取消,真正完成恢复的是他自己手动执行的回滚操作。 用
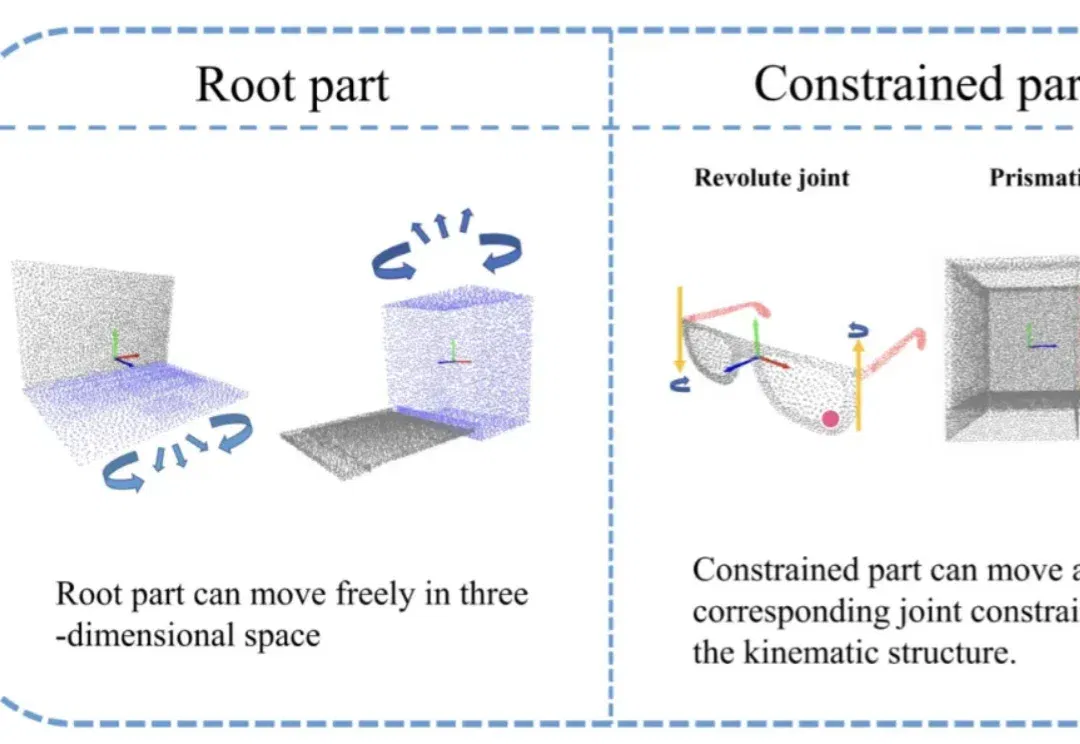
在具身智能快速发展的今天,机器人已经不再满足于「看见」刚体物体,而是开始真正走向复杂环境中的交互与操作。从机械臂开柜门,到服务机器人整理抽屉,再到工业场景中的工具操作,大量真实世界目标都属于关节物体(Articulated Objects)。
就在几天前(5月22日),DeepSeek官方扔出了一枚重磅炸弹:DeepSeek-V4-Pro将在5月底结束优惠后,永久降价至原价的四分之一。各大媒体瞬间被诸如“白菜价”、“夯爆了”的标题刷屏。看看这组惊人的新定价:每百万Token输出6元,输入(缓存未命中)3元,而输入(缓存命中)仅仅只要0.025元!
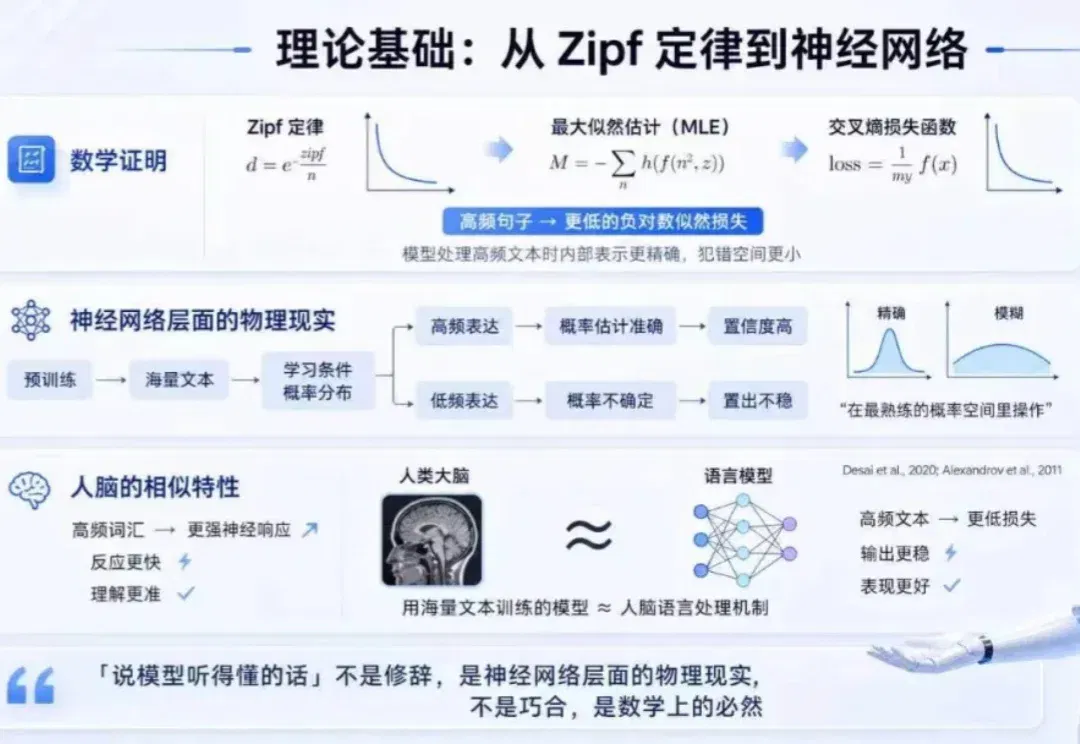
你有没有想过,我们每天用的 AI 大模型,可能在某些词汇上天生就有缺陷?不是因为训练数据不够,不是因为算力不足,而是因为语言本身的规律——那些用得少的词,模型就是学不好。更让人意外的是,这个问题早在 2025 年就被一家中国创业公司系统性地发现并解决了。
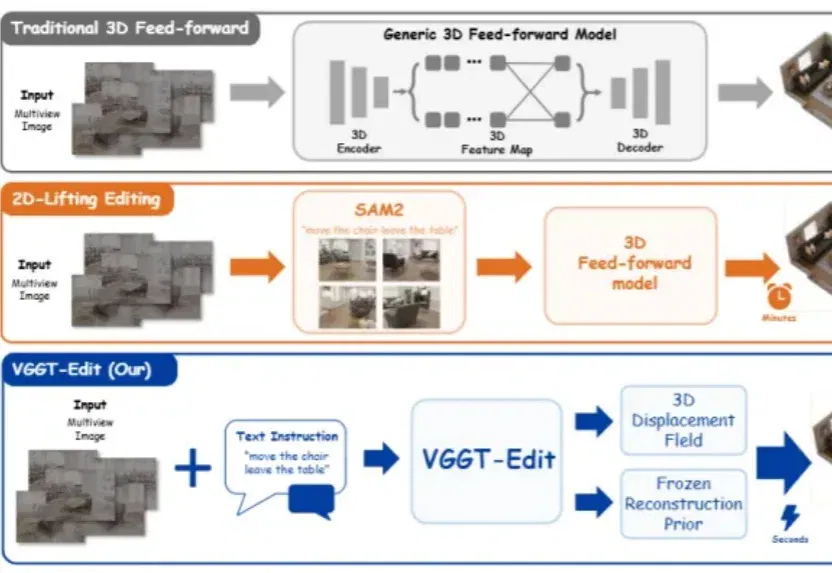
3D世界“会看”了,但还不会“改”。 从NeRF到83D Gaussian Splatting,再到VGGT、π³这类前馈式3D重建模型,整个行业的进展速度明显加快——只需几张图片,就能在几秒内重建完整3D场景。 但问题也恰恰出在这里。这些模型虽然已经能理解三维世界,却还不会修改三维世界。你可以让它重建一个房间,却很难真正告诉它: 把椅子移到窗边,删除中间那张椅子,把灰色皮沙发改成白色长毛沙发。 更麻烦的是,一旦涉及复杂编辑,现有方法往往迌速崩採——某些角度里椅子消失了,换个视角椅子又重新出现;明明没改的背景,却跟着一起变形。 为应对这一挑战,来自北京大学、香港中文大学、上海AI Lab、NT
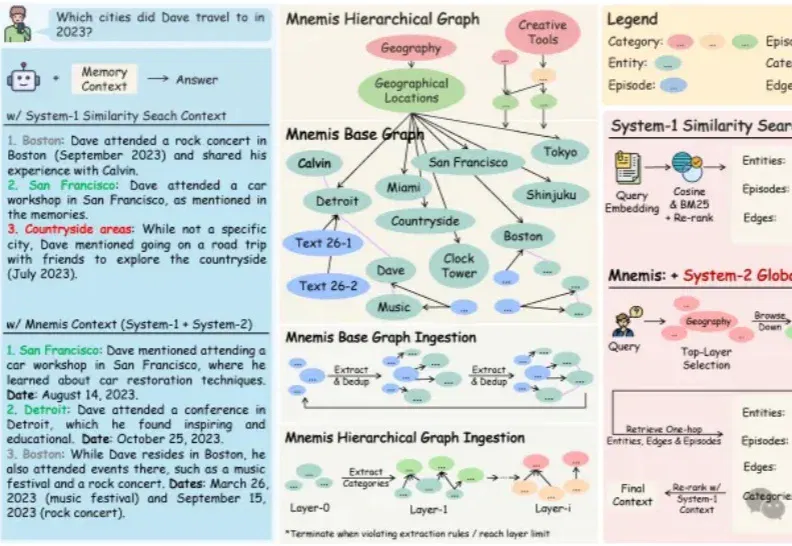
随着大语言模型在各类应用中加速落地,一个核心技术瓶颈日益凸显——AI始终缺乏真正的长期记忆能力。当前主流的RAG(检索增强生成)方案依赖语义相似度检索历史信息,但“语义相似”并不等于“真正相关”,常常出现检索结果不完整、无法区分信息相关性、缺乏推理能力等问题。
参与交流
了解加入交流群的方式,阅读内容无需登录。