
Know AI. See What’s Next.




第 1 张,共 5 张:姜宇辉的AI分身:知识助手与“另一个自己”之间
最新资讯流
AlphaGenome 2 预测细胞状态下的 DNA 变异影响,辅助疾病研究(在新窗口打开)
谷歌将单细胞信息引入 DNA 序列预测,并用既有研究检验疾病线索。模型输出有助于筛选实验方向,仍需生物学验证。
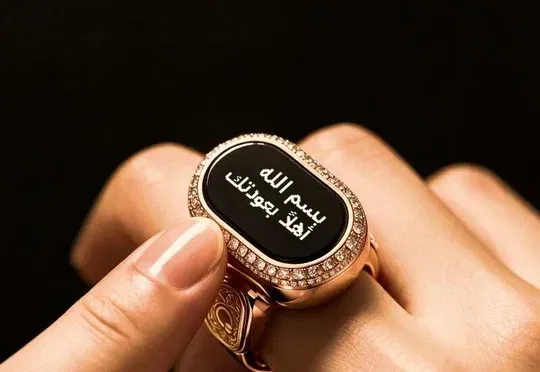
iQIBLA 预售 Aura Premium,将念诵计数与记录整理做进戒指(在新窗口打开)
新款戒指采用触控计数、屏幕提示和礼拜提醒,配合应用整理念诵记录;报道提到的400万销量属于品牌累计产品。
美图吴欣鸿谈 AI 应用:做深垂直场景,控制模型与商业化成本(在新窗口打开)
AI产品阿颖整理播客中的产品取舍、小团队验证、订阅加服务收费和全球市场经验,并结合自己的创业经历讨论。
Personal Agent 应看什么指标:从打开次数到事务托管与完成(在新窗口打开)
赛博禅心以互联网指标演变为背景,讨论个人智能体的委托量、完成率和收入关系,并指出托管口径仍需明确。
Mercor 宣布7.5亿美元D轮融资,估值升至200亿美元(在新窗口打开)
据公司与投资方披露,本轮包括员工股份出售安排,资金将投入模型评估、后训练基础设施及智能体工作环境。
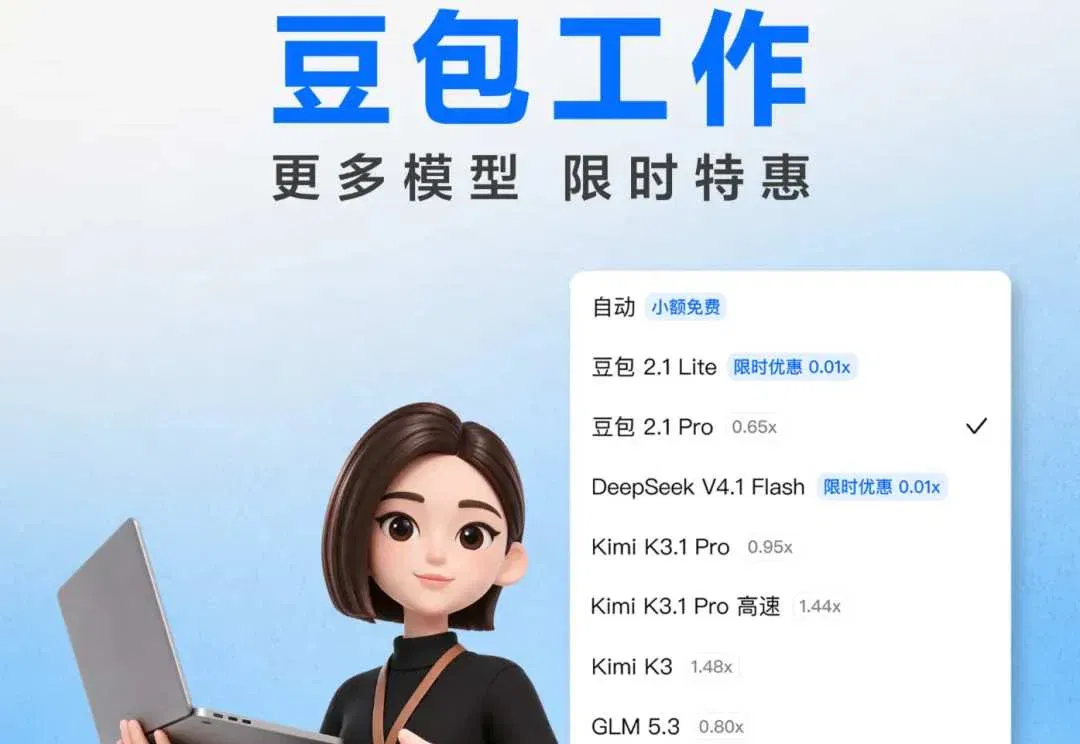
豆包工作接入 Kimi、GLM 和 DeepSeek,展示模型额度倍率(在新窗口打开)
平台扩大第三方模型选择,并调整部分模型消耗倍率、推出限时优惠,用户可在同一工作入口按任务选择模型。
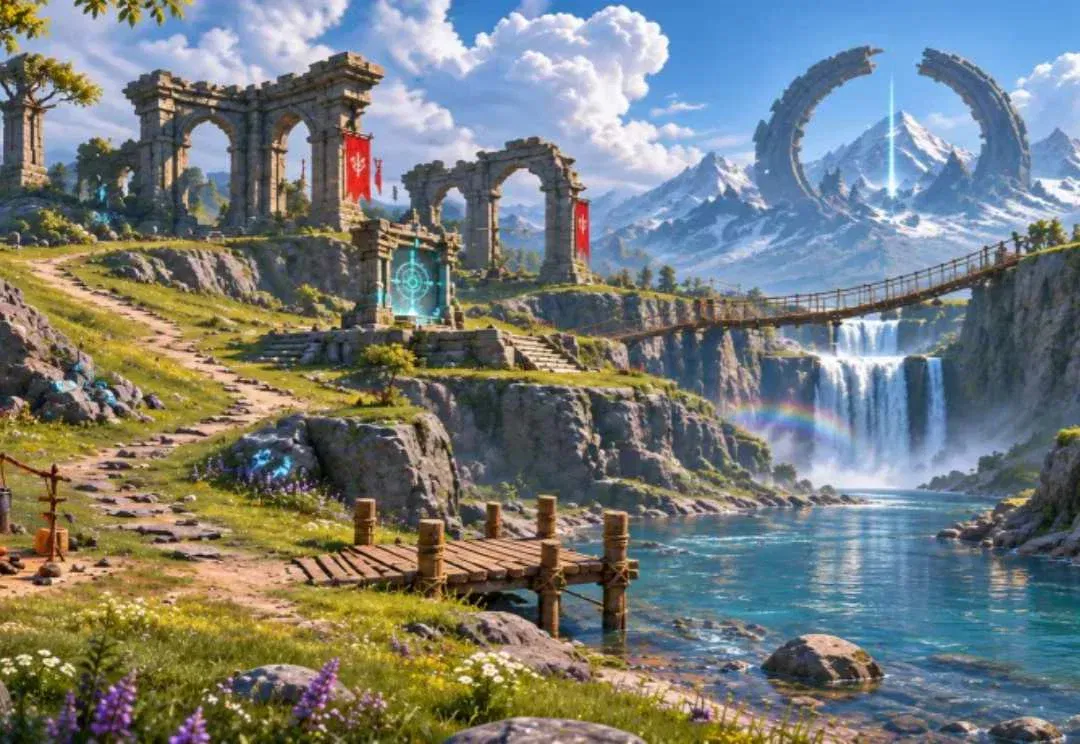
用 Codex、Blender 与 Three.js 制作可探索的3D场景(在新窗口打开)
原作者记录参考图拆分、模型生成与返修、GLB 优化、人物绑定和网页交互过程,并说明工具连接中断及场景细节问题。
谷歌推出 Gemini Decisions API,按输入计费并返回选项概率(在新窗口打开)
接口面向是非、多选和评分任务,支持多模态输入及共享上下文。官方披露测试延迟和定价,实际校准与成本仍依赖应用条件。
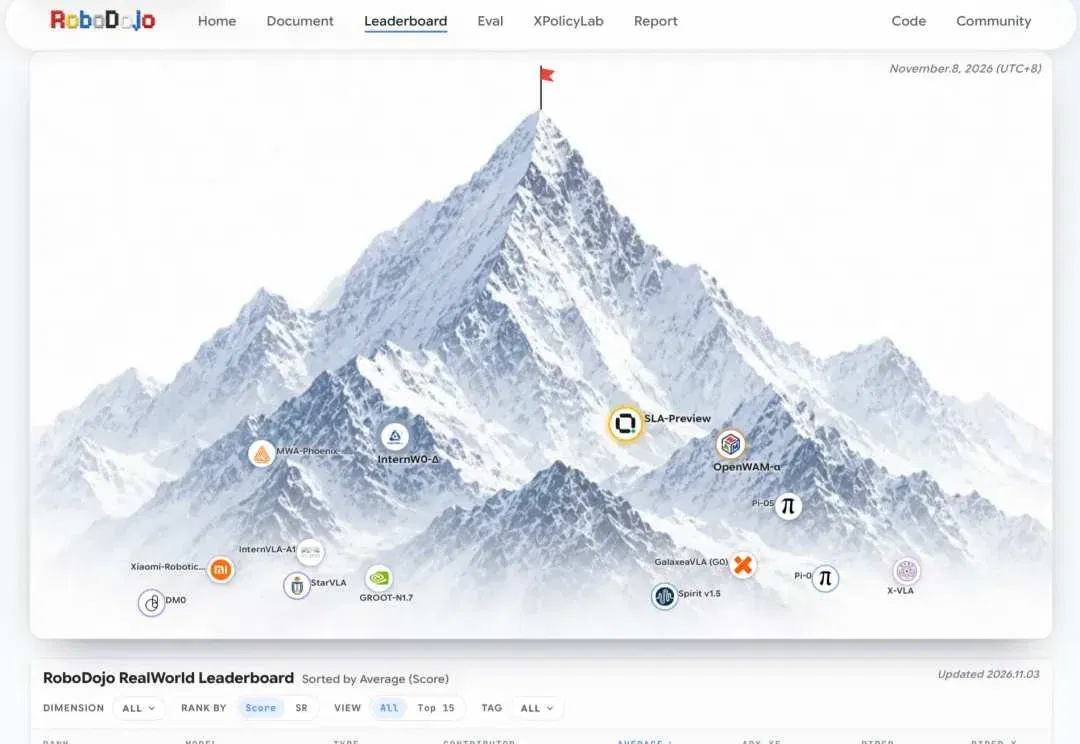
SLA 把空间监督引入持续预训练,测试机器人应对场景变化(在新窗口打开)
港科大广州与欧拉万象团队以多来源机器人数据学习空间表征,在公开榜单、扰动与少样本本体适配实验中报告收益。
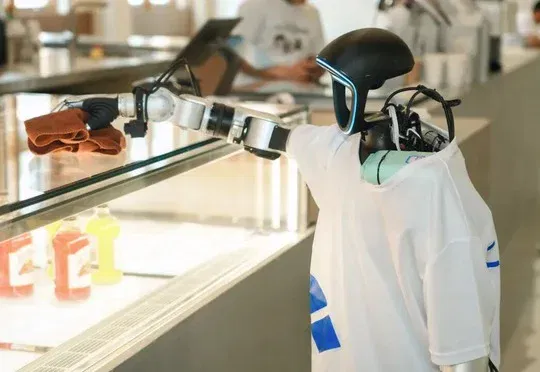
刻行时空完成近亿元 pre-A 轮融资,聚焦机器人真机数据(在新窗口打开)
投中网采访创始人黄阳明,梳理公司从基础设施到数据生产的转向,以及质量控制、合作生态与部署数据回流计划。
清析智研完成近亿元天使轮融资,推进 AI 材料研发与中试(在新窗口打开)
据 Z Potentials 报道,公司通过设备改造积累真实实验数据,并推进稀土永磁材料中试,目标2027年量产。
《持械入宋》走红,仿真人 AI 短剧如何持续吸引观众(在新窗口打开)
APPSO 从短单集、长系列、制作返工和平台分发分析作品,讨论 AI 降低影像门槛后仍需解决的角色一致性与情节问题。
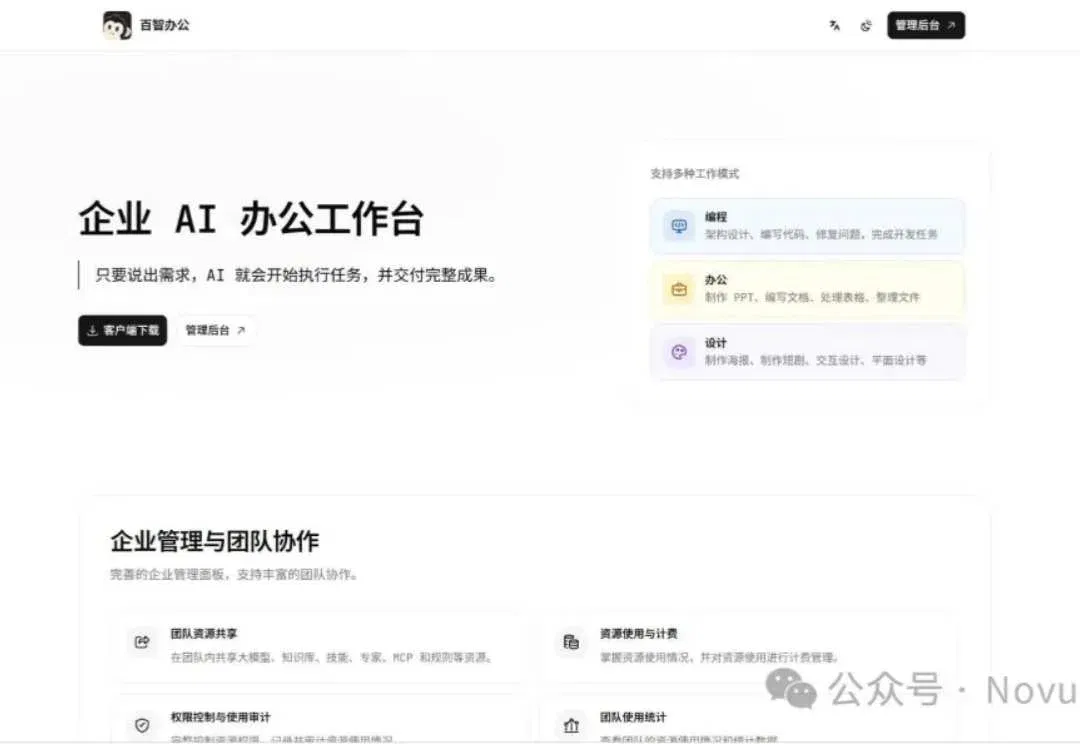
百智办公体验:统一配置模型、知识库与团队使用额度(在新窗口打开)
原作者从管理和员工视角介绍资源分发、权限、计费与任务回溯,并用模拟产品简报测试文档及网页生成。
MedGPT 肺癌离线病例研究:辅助医生的方案评分提升(在新窗口打开)
研究在40个未公开复杂病例上比较诊疗策略内容,250名医生使用系统辅助后评分提高;结果尚不能代表真实治疗效果。
AI Futures Project 前移研究员级 AI 预测,依据与不确定性是什么(在新窗口打开)
团队依据 METR 对 Anthropic 研发提速的调查更新预测,不同推算方法的中位时间相差一年多,部分关键证据未公开。
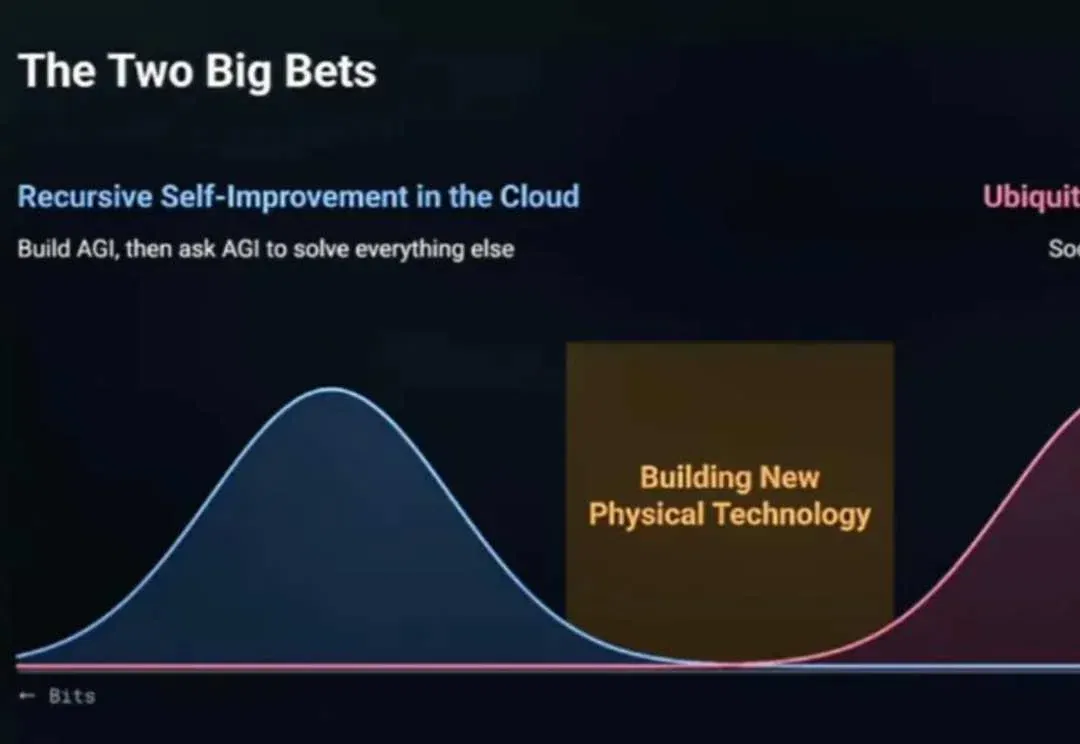
Ted Xiao 谈物理世界 AI:验证速度如何限制研发提速(在新窗口打开)
演讲从工程链条、机器人训练和自动实验室讨论验证瓶颈,主张到实际场景检验评估器,并把有限实测用于指导下一轮迭代。
LOGIV 用任务依赖图验证机器人长程执行,并局部修复失败(在新窗口打开)
研究以显式条件和资源关系连接规划与执行,在仿真及小规模真机实验中测试恢复能力,尽量保留仍然有效的后续计划。
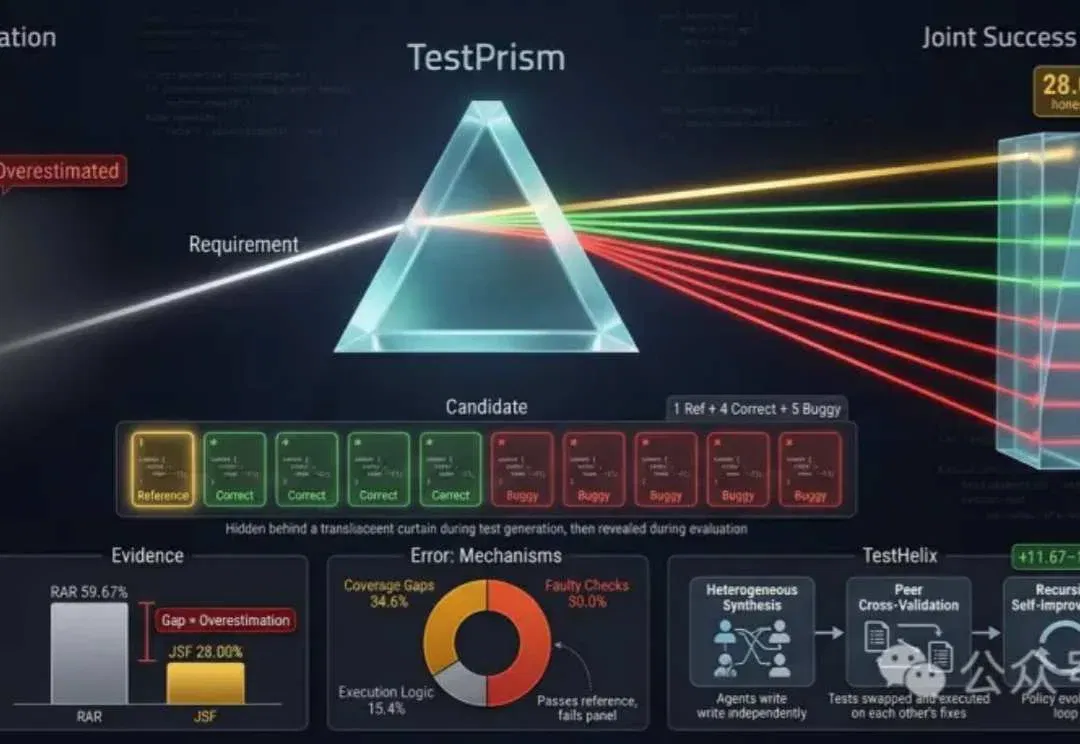
TestPrism 检验智能体生成测试,多实现评测暴露可靠性差距(在新窗口打开)
研究用正确替代实现和错误实现共同检验测试,最强受测配置的联合成功率为28%;TestHelix 通过交叉验证改进结果。
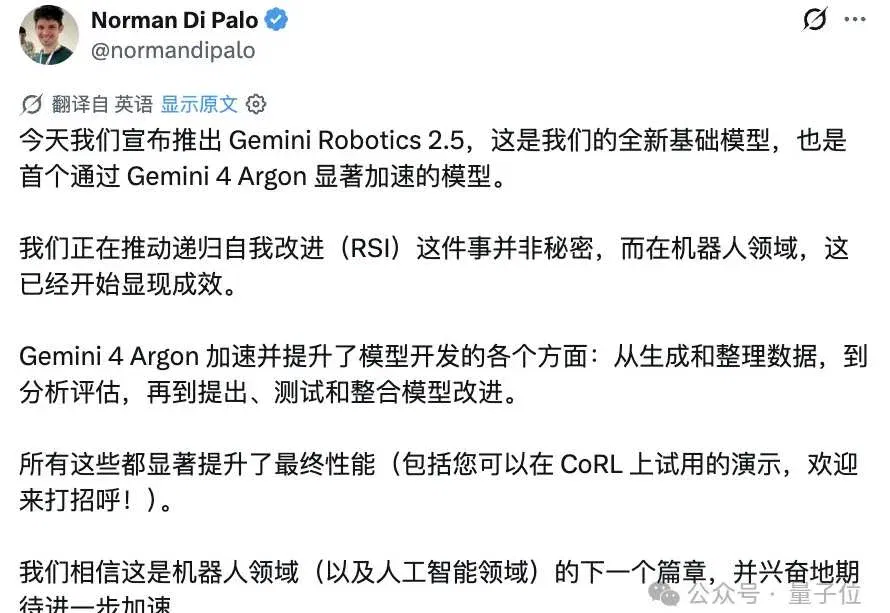
Gemini Robotics 2.5 发布,借助 Argon 改进机器人训练(在新窗口打开)
谷歌介绍新版 VLA 的灵巧操作、工厂概念验证和安全测试,并展示通用模型在仿真构建、数据检查及失败分析中的作用。
Grok Bot 1.0 扩展团队协作,加入会议与知识审核功能(在新窗口打开)
新版本支持会议接入、团队共享经验与多 Bot 协作。报道同时梳理权限和订阅限制,以及用户对额度消耗、长期表现的反馈。