范式智能介绍Phai-A1与Phai-M1,强调国产算力后训练优化

范式智能介绍面向代码与Agent场景的Phai-A1,以及面向真人影视的音画同步模型Phai-M1。公司展示了单卡运行和视频生成能力,并称模型在昇腾平台完成专项后训练优化。
编辑核对(2026年11月21日):文中国产算力训练的已确认范围为后训练优化,性能数字属于厂商展示的具体配置与任务条件。官网目前提供Phai-A1权重下载与Phai-M1在线试用,两款模型的开放资产及许可证须分别确认。Phai官方模型介绍、测试条件与资源入口(在新窗口打开)
大家熟悉的那个AI虎将:范式智能(原第四范式),首次把自研模型端到了台前!
而且,一出手就是双联发:Phai-A1,Phai-M1。
- Phai-A1,通用语言模型。原报道援引官方对比称,在指定任务、同一版本Claude Code且均使用单张RTX 3090的条件下,响应速度约快8—10倍。它支持百万Token上下文;单卡部署和可用上下文仍取决于具体推理配置,不能据此认为任意消费级显卡都能以同样条件运行。
- Phai-M1,面向真人影视场景的视频生成模型,支持音画同步。官方给出的约3分钟生成15秒720p视频成绩,测试条件为16GB显存消费级显卡。
更关键的是,据官方介绍,Phai系列在华为昇腾平台完成了全流程后训练优化;这不等同于确认全部预训练也从零在昇腾上完成。
原报道当时称,两款模型近期计划在Hugging Face、ModelScope开放权重;截至11月21日核对,官网已列出A1下载,M1则提供在线试用,具体权重、代码及许可证需分别以官方资源为准。
体验入口:https://phai.phanthy.com/
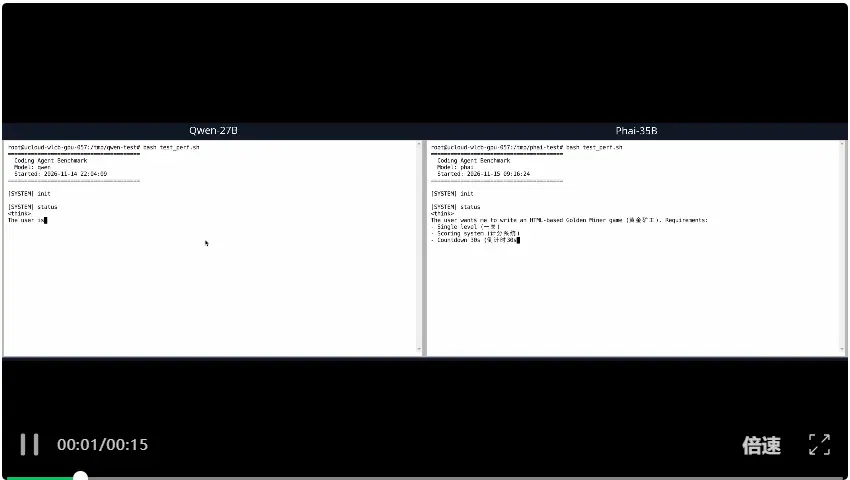
单张RTX 3090对比展示,厂商称特定任务响应约快8—10倍
先说Phai-A1。
相信你一定经历过这种“挠头”的时刻:任务一复杂起来,thinking时间无限拉长,偶尔还弹出一句“流量高峰期,请重试”;订阅费也充了,结果还得等,这会是怎样婶儿的赶脚……
Phai-A1就是对准这些问题来的。
据官方介绍,它主打代码开发和智能助手场景——写代码、修bug、调工具、跑多步任务,都在它的射程范围内。
具体有多快呢?
原报道援引官网的指定任务对比称,在保证该任务效果的前提下,Phai-A1的响应速度快约8-10倍。
这组展示中,两个模型都运行在单张RTX 3090上,使用同一版本Claude Code执行同一任务。它说明的是这一配置和任务下的厂商对比,不能直接推广到所有任务、同级模型或上下文长度。
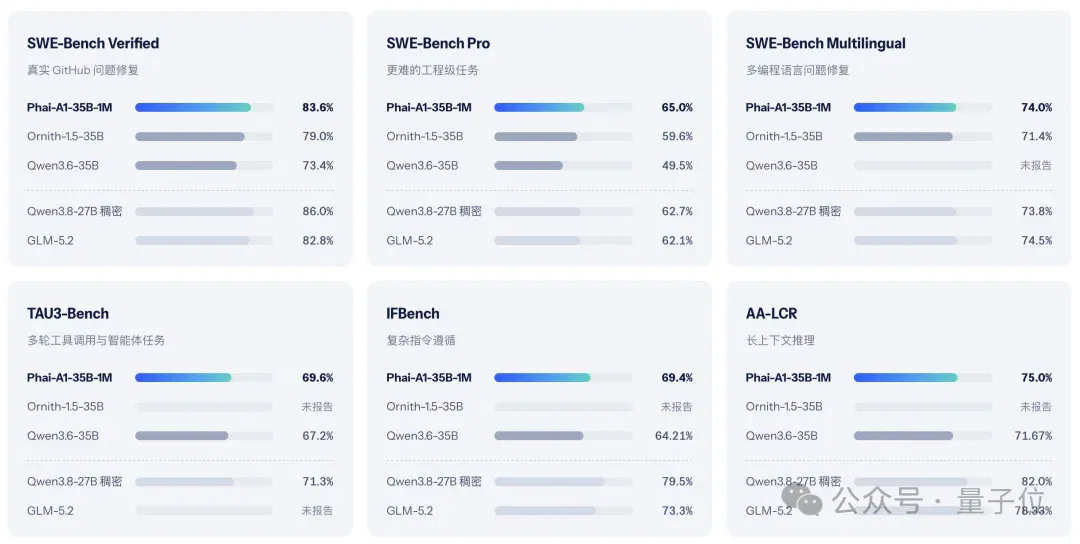
当然,benchmark也没落下。
在SWE-Bench-Verified、SWE-Bench-Pro、SWE-Bench-Multilingual这几张软件工程和通用领域的“考卷”上,Phai-A1跑赢了同级别选手,甚至不弱于一些千亿参数级的前沿模型。
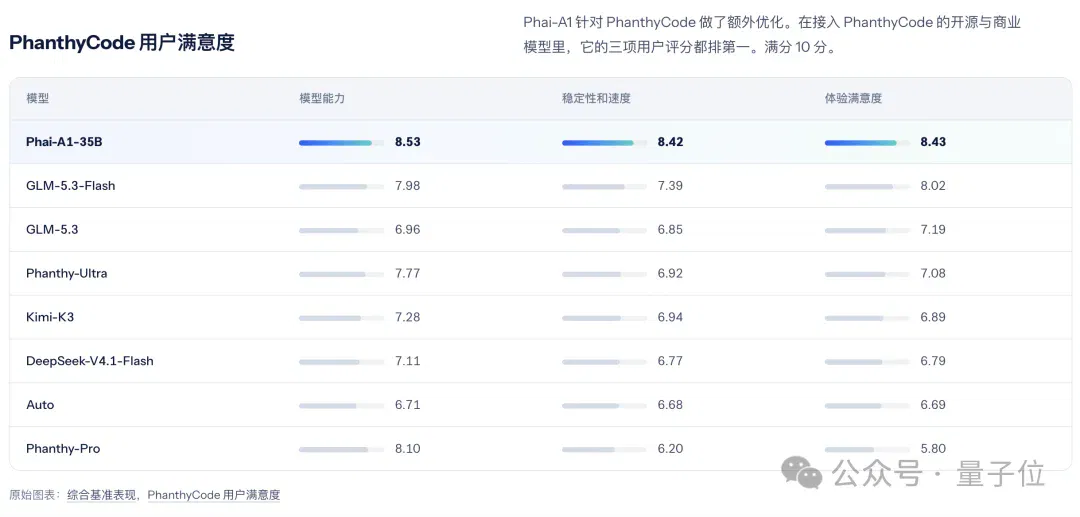
据官网透露,团队还在自家AI办公产品PhanthyCode上经过了一段“匿名期”,在匿名模型调查期间,Phai-A1一路人气飙升,在所有接入的开源和商业模型里,在模型能力、稳定性和速度、体验满意度三个方面都取得了最高的评分。
为什么能做到这么快和丝滑?
官方强调其长上下文能力:后训练数据直接覆盖百万Token场景。这里介绍的是模型设计与后训练覆盖范围,不能据此认定所有其他模型都只使用“堆叠式”方案,也不代表单张RTX 3090能在任意配置下容纳完整百万Token上下文。
大型代码仓库、长篇资料、连续几天的对话,都能接着往下捋。
A1最实用的卖点,是仅一张RTX 3090卡就能跑。
在满足显存、推理框架和部署配置等条件时,本地运行可减少云端排队和按Token支付API费用;普通笔记本能否运行、如何部署及可容纳多长上下文,仍需逐项确认,不能概括为“双击就能跑”。
飞一般的赶脚~这才是让AI成为“随叫随到”的生产力。
M1厂商演示:16GB显存消费级显卡约3分钟生成15秒720p视频
再看Phai-M1。
AI视频的老毛病,大伙儿是都知道的,AI短剧虽然火爆,但塑料感也是有目共睹的。
表情不自然、皮肤塑料感、音画不同步、动作细节各种“迷之操作”。
Phai-M1的思路是,既然问题是“不像真人拍出来的”,那就围绕真人影视场景做专项训练。据官方介绍,它在人物表现、画面细节和整体质感上,做到了影视级水准。
话不多说,一片胜千言!
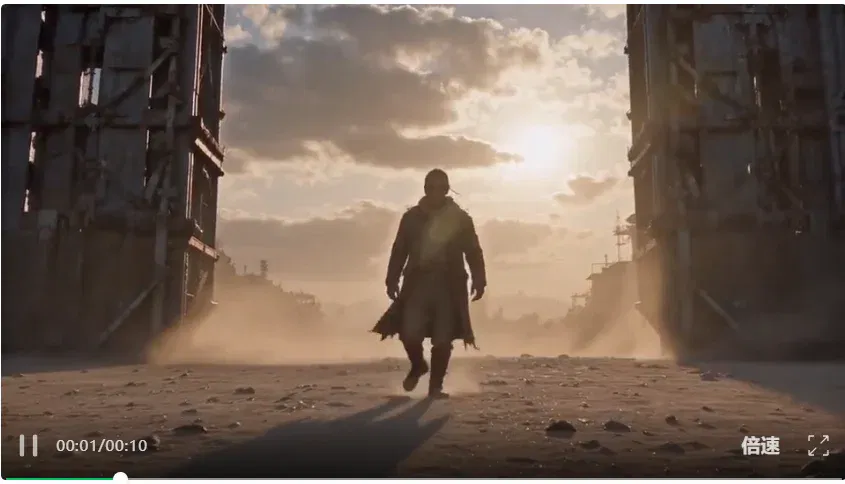
音画同步,则是他们的另一个大招:声音和画面在同一条生成流水线里完成,不用再后期对口型。这块可是视频创作者的刚需呀。
效率方面,官方在16GB显存消费级显卡、720p的测试条件下,给出约3分钟生成15秒视频的成绩;这不是对所有设备、输入和配置的固定耗时保证。
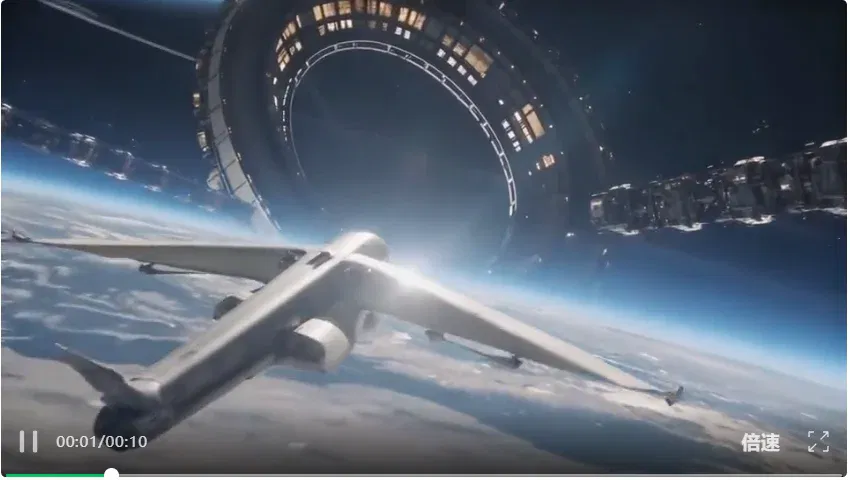
3分钟出15秒,听着好像不够刺激?但对AI短剧团队来说,生成时长和速度直接决定产线的节奏和成本——这是能重新算一遍账的事。
当质感、音画同步和效率同时叠起Buff来,AI视频就不再只是“看起来像那么回事”,而是真能进生产流程了。
国产算力派:在昇腾平台完成后训练优化
另外,还有个不能忽略的点。
据官方介绍,Phai系列在华为昇腾平台完成了全流程专项后训练优化(有ModelHub XC社区支持)。
敲黑板,不是“训完再适配”。据称从模型优化阶段之初,团队就是按国产算力环境的实际情况来设计的。
这里能够确认的是后训练环节在国产算力平台上的优化与适配,不能进一步写成整个模型从预训练起的全链路都由国产算力完成。
那为什么范式团队可以做到呢?
谜底藏在谜面上,近年来,范式一直在国产AI生态上不遗余力地投入。
比如,异构算力纳管的HAMi;再比如,芯片模型适配层面的信创模盒社区等等。
值得注意的是,范式跟华为的合作一直非常深入且密切。就在两个月前,有消息称“范式超10亿元采购华为昇腾950”,加速押注国产AI。
因此,这次Phai在国产算力上开展的后训练优化,也与范式此前在相关生态中的投入相衔接。
持续投入国产算力训练优化,意义不只是降低对单一硬件平台的依赖,也在于让国产芯片在真实的模型训练和应用中积累适配经验。
随着更多像Phai这样的模型基于国产算力开展后训练与适配优化,模型与硬件之间的适配将进一步完善,国产算力的实际使用效率也有望随之提升。
范式也在持续推进这一方向的探索。用范式自己的话说,他们就是一支“国产算力派”。
目前,Phai系列已经全量接入了范式产品:PhanRouter、ModelSphere、Phanthy(万神殿)、PhanthyMovie、PhanthyCode/Work等产品。
另外,原报道提到范式计划开放Phai系列,并在Hugging Face和ModelScope发布更详细资料。截至11月21日核对,官网已提供Phai-A1权重下载,Phai-M1则提供在线试用;M1权重、代码及技术报告的具体开放情况与时间,应分别以官方资源页和许可证为准。
随着具体模型资产按官方计划开放,开发者可以在相应许可证和部署条件下检验其能力边界,并探索更多应用场景。
体验传送门:https://phai.phanthy.com/
One More Thing
这次Phai模型的发布,无疑是范式下场基座模型的一个信号。
不过很明显,范式和许多公司一样,选择了一条“以小搏大”的路径。
小模型能力反超大模型这件事,已经被不少公司证实是可以做到的。
那么,范式在“以小搏大”的赛道叙事里,优势在哪里?
首先,无疑是过去十余年积累下来的技术与工程经验。这些经验已经沉淀在范式“内置”的平台能力、行业交付体系和团队之中。
再者,也是最不容小觑的地方,就是范式对国产算力生态长期坚定不移、真金白银的投入和推动。
文章来自于"量子位",作者 "允中"。
相关主题
读完之后
加入 AINRK 交流群
了解加入交流群的方式,与更多 AI 从业者交流。
相关文章
继续阅读相关主题与同栏目内容。

姜宇辉的AI分身:知识助手与“另一个自己”之间(在新窗口打开)
南方周末通过学者、用户与Second Me创始人的访谈及记者试用,观察AI分身的学术辅助、情感连接和商业化尝试,也呈现知识可靠性、人格边界、版权与隐私方面的疑虑。

智动未来据报完成亿元级Pre-A+融资,资金用于产线与服务机器人部署(在新窗口打开)
机甲觉醒报道,智动未来宣布完成亿元级Pre-A+轮融资,由中美绿色基金领投、南曦创投联合领投,资金拟用于广州产线、服务场景部署和世界模型研发。“智子世界”仍属技术预览,商业化效果待更多应用数据检验。

腾讯Q3资本开支814亿元,称WorkBuddy日Token用量居国内首位(在新窗口打开)
腾讯三季报显示营收2073.36亿元、资本开支814.33亿元。公司称WorkBuddy日活超1000万,按用户每日大语言模型Token消耗总量居国内首位;报道还讨论云业务增收与AI投入对盈利、现金流的影响。

黄仁勋离任后:硅谷101访谈英伟达的技术、供应链与组织挑战(在新窗口打开)
硅谷101采访半导体、科技与投资人士,讨论黄仁勋离任后CUDA生态、系统整合、供应链、开源投入和组织传承的潜在变化。产业放缓、估值折扣及人才流失判断属于受访者观点。
Cola2探索连续隐空间语言建模,字母AI解读字节扩模路线(在新窗口打开)
Cola2研究语义动态压缩、重构与生成平衡及连续—离散协同训练。文章据论文、媒体和匿名消息讨论字节Seed的技术与组织调整;“10万亿”项目、人事晋升及公司战略对应关系不能由论文直接确认。