Know AI. See What’s Next.
第 1 张,共 5 张:MiniMax M3.1 Flash来了:Opus 5.5刷屏的绝活,它也能做
最新资讯流
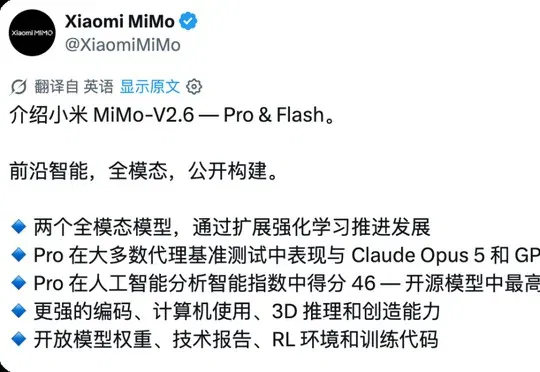
刚刚,小米刷新 AI 大模型斩杀线,罗福莉:技术难度超过 DeepSeek R1(在新窗口打开)
小米正式发布并开源 MiMo-V2.6 系列模型,罗福莉称其背后的研究创新和工程难度超过 DeepSeek R1,在 Artificial Analysis Intelligence Index v4.3 中以 46.32 分成为当前得分最高的开源模型,价格仅为海外同级模型的 1/20 至 1/60。
本地版Jev 1G内存就能跑!四舍五入等于不要钱啊(在新窗口打开)
开发者mizorewww将开源决策模型Laya移植到Apple MLX框架,推出本地版Laya-MLX,可在Apple Silicon Mac上以低于1GB内存运行并摆脱PyTorch与云端API依赖,421M版本峰值内存943.6MiB、322M多语言版本687.6MiB。
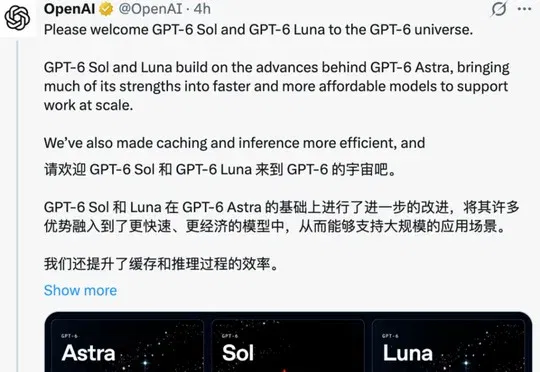
突发!GPT-6 Sol与Claude Opus 5.5同日开打,谁是「性价比之王」(在新窗口打开)
OpenAI同日发布GPT-6 Sol与GPT-6 Luna,API价格相比GPT-5.6腰斩50%,主打单位任务成本优势;Anthropic推出Claude Opus 5.5,典型任务成本降低约40%且输出速度提升超30%,两家厂商围绕"性价比"展开直接竞争。
讲真,我没看出这图是AI做的,更没想到是国产AI做的(在新窗口打开)
家人们,你们看下面这两张图,能分得出哪张是AI,哪张是真实的吗?
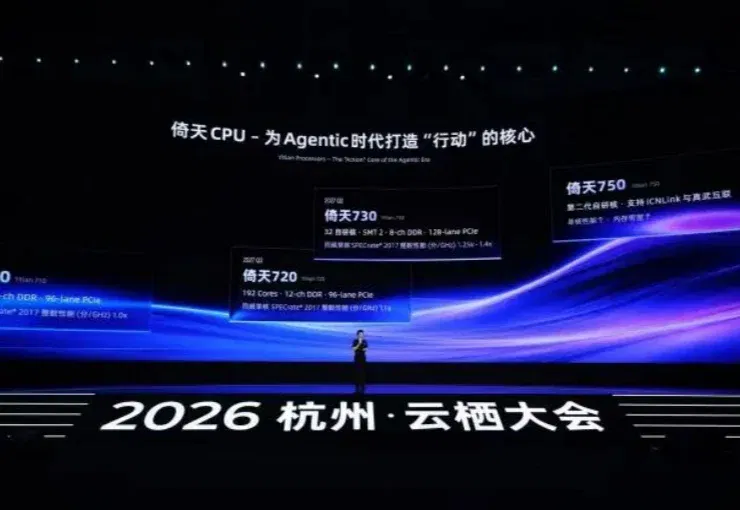
从单卡到千卡互联,平头哥真武 V900 背后的 AI 算力变局(在新窗口打开)
从真武 V900 到新一代磐久超节点服务器,平头哥八年来陆续布局的 AI 芯片、CPU、scale up 互联、scale out 网络和存储芯片,开始被装进同一套算力系统。
突发!OpenAI官宣24天攻破100+世界级数学难题(在新窗口打开)
数学界,真被AI追到家门口了! 就在刚刚,OpenAI突然甩出一篇重磅博文—— 一款8月28日才开始训练的内部新模型,现已攻克了100多道世界级数学难题。 横跨的,还是数学大部分领域。 更夸张的是,这100多道题中,还包括此前困扰数学界多年的「纳维–斯托克斯」千禧年难题。 这进化速度,快到让OpenAI内部数学家感到意外。 从8月28日开训,到9月21日官宣,仅仅24天。 一款还在训练中的内部AI,开始横扫人类几十年,甚至是上百年没有解决的问题。 就在今天,OpenAI请来了9位全球顶尖数学家,正式成立一个独立的数学顾问组。 名单中有,菲尔兹奖得主Timothy Gowers、Martin H
陆川手搓历史现场,王珞丹熬夜抽卡,阿里全模态开始兜底生产(在新窗口打开)
5天。 不用搭景,不用等演员,导演陆川和团队,直接用AI把一场发生在400年前的明代灾难现场,搓出来了!
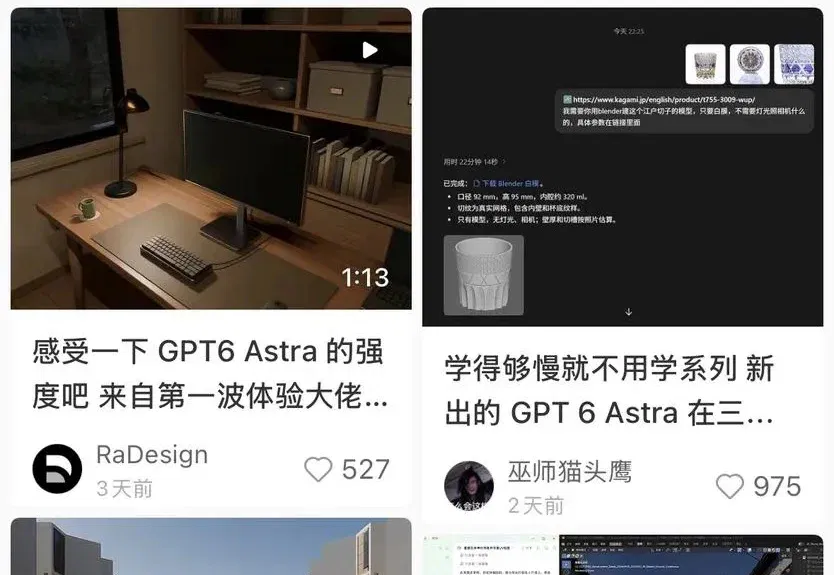
GPT-6 Astra搓3D刷屏后,3D生成的竞争规则变了(在新窗口打开)
谁还没有被GPT-6 Astra搓3D的案例狠狠刷屏啊!
剪映 AI 改写创作边界:让工具更懂你,也让作品更像你自己(在新窗口打开)
剪映的 AI 边界,正不断延展。 在刚刚结束的 2026 剪映 AI 新创作发布会上,剪映发布了全新 AI 能力,让专业创作者和普通用户的创作效率和创作体验,都有了一次明显提升。 一方面是 PC 专业版的升级。这方面的关键词是“提效”。剪映 Hub 是这方面最亮眼的更新。这是个一站式的 AI 创作平台。通过将 AI 创作与多轨道剪辑连接起来,剪映 Hub 让脚本、素材与创作上下文在同一个项目中延续,大大减少了跨工具切换带来的断点与重复操作。 剪映助手 Agent 则进一步介入到专业创作流程,承担起素材整理、粗剪、包装等高频而繁琐的工作。Agent 可根据创作目标规划任务,串联模型、工具和 Sk
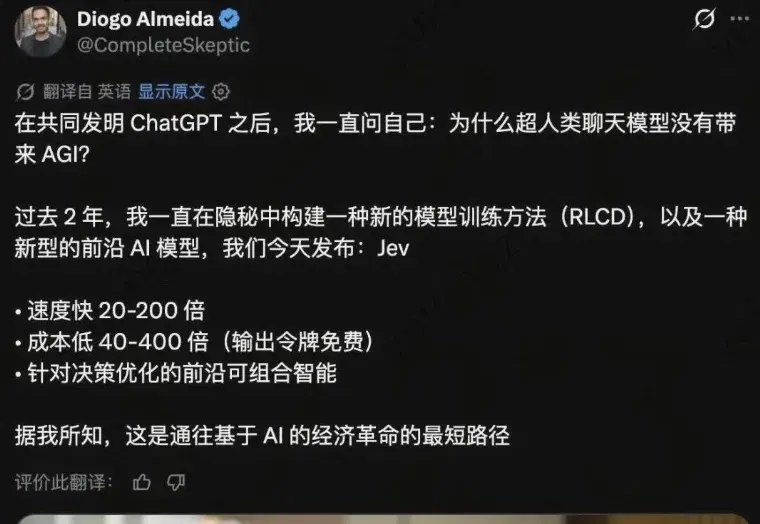
聊聊最近爆火的Jev 模型,到底是个啥?(在新窗口打开)
最近看到了一个挺有意思的东西,就是TypeSafe AI 做的 Jev。Reddit 上很多人用它玩 DOOM,也有人拿它玩 Mario。我申请之后,拿到 API Key 后,也做了一个网页小游戏,想看看它到底在里面起什么作用。一开始,我最想弄清楚的其实很简单:同样是让 AI 操作游戏,为什么要用 Jev?GPT 不能做吗?当然能。
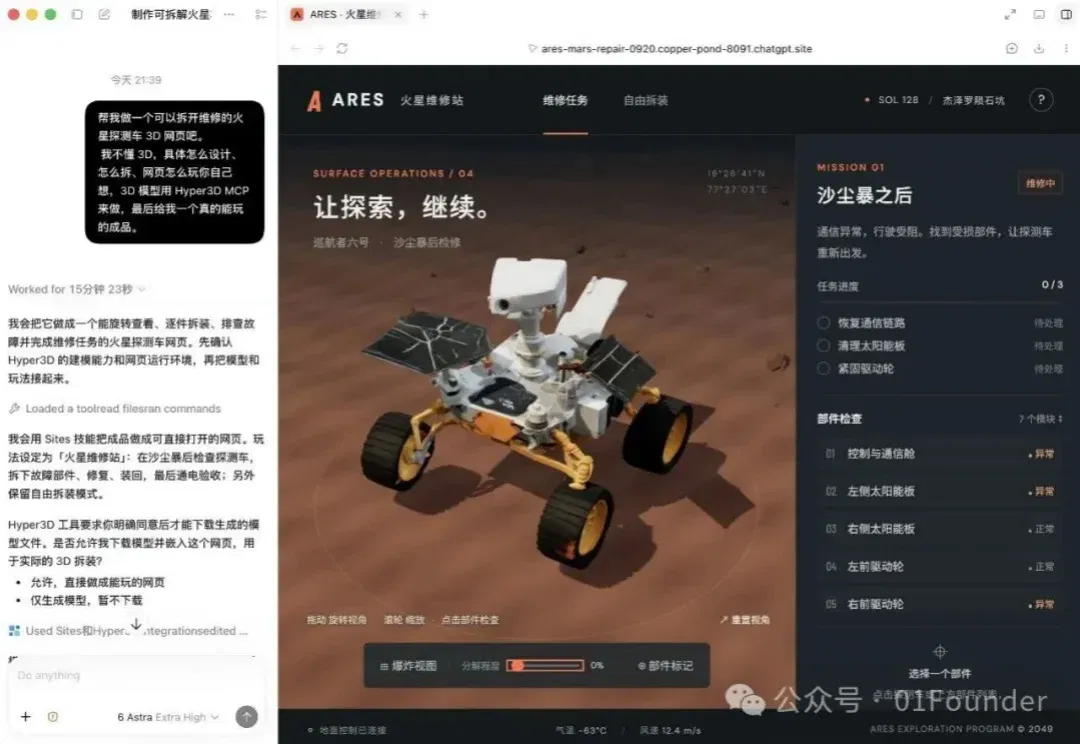
我开始相信,GPT-6 已经踩进 AGI 了(在新窗口打开)
这个月,我基本是在高强度地用 GPT-6 Astra。
拆解下阿里的 AI 经济学,与它的下注(在新窗口打开)
「思考力商品化」的新经济。 9 月 22 日,杭州云栖大会。阿里巴巴集团 CEO 吴泳铭和往年一样,做了开场的主旨演讲。 过去几年云栖大会的主旨演讲,可以当作「技术风向标」来听,会抛出很多重磅的技术判断,比如,「大模型是下一代操作系统」、「超级 AI 云是下一代计算机」。 但这一次,我听完的感受很不一样。吴泳铭花了很多时间讲工业革命、讲电、讲经济学。他的重心不在 AI 会变成什么样了,他讲的是,AI 会让世界变成什么样。 比如他给出的一个核心观点,「上一次这样的变化,是工业革命把动力变成了规模化的商品。人类先后发明了蒸汽机、内燃机和电,并围绕它们建立起了现代产业。这一次,轮到思考。」 当一个
Grok 4.7来了!网友实测先把SpaceX玩坏了,大火箭走起(在新窗口打开)
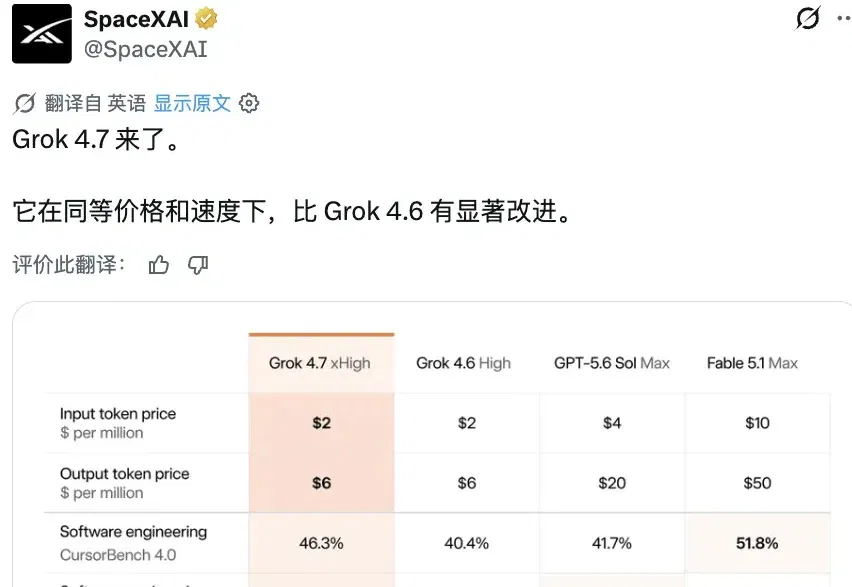
看来啊,老马显然也知道,国庆前后这几天的基模圈不好混。
Agent时代,CPU的价值该重估了(在新窗口打开)
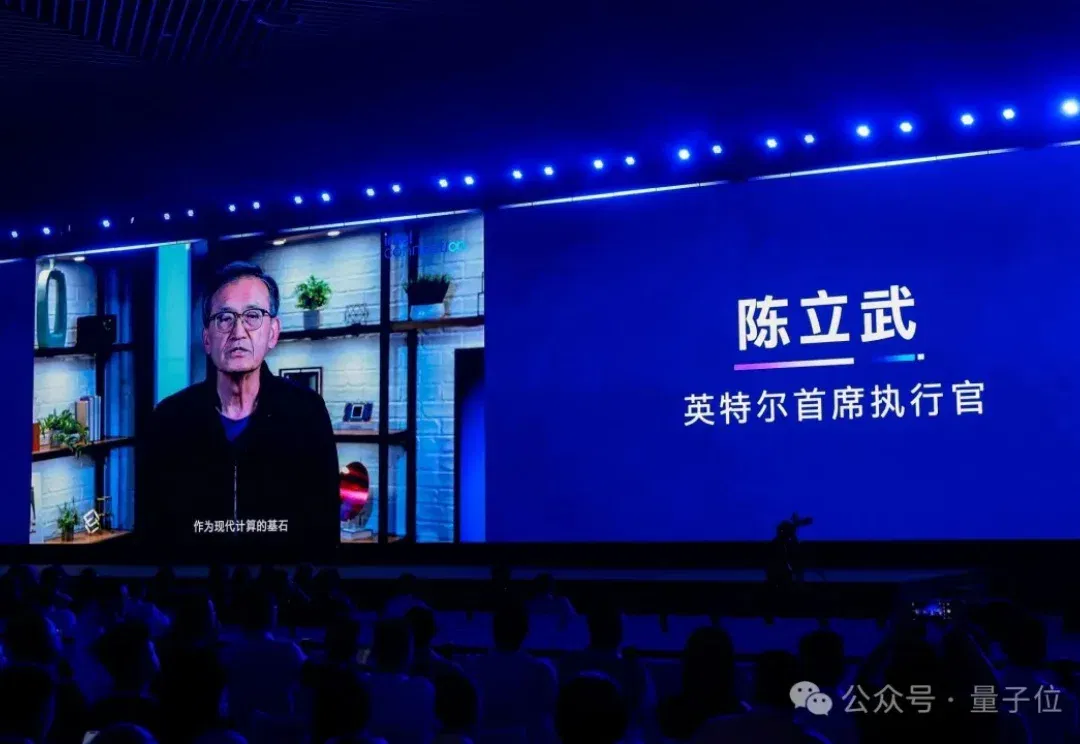
CPU的价值,在Agent时代,真的需要被重估了。
姚顺宇、施天麟聊 RSI:最难的不是实现自我迭代,而是如何验证迭代有效(在新窗口打开)
RSI(递归自我改进)已经热了一段时间。从 OpenAI、Anthropic 到谷歌,头部实验室都在探索如何让 AI 参与下一代 AI 的研发,创业公司也开始围绕它做产品、搭环境、建评测。
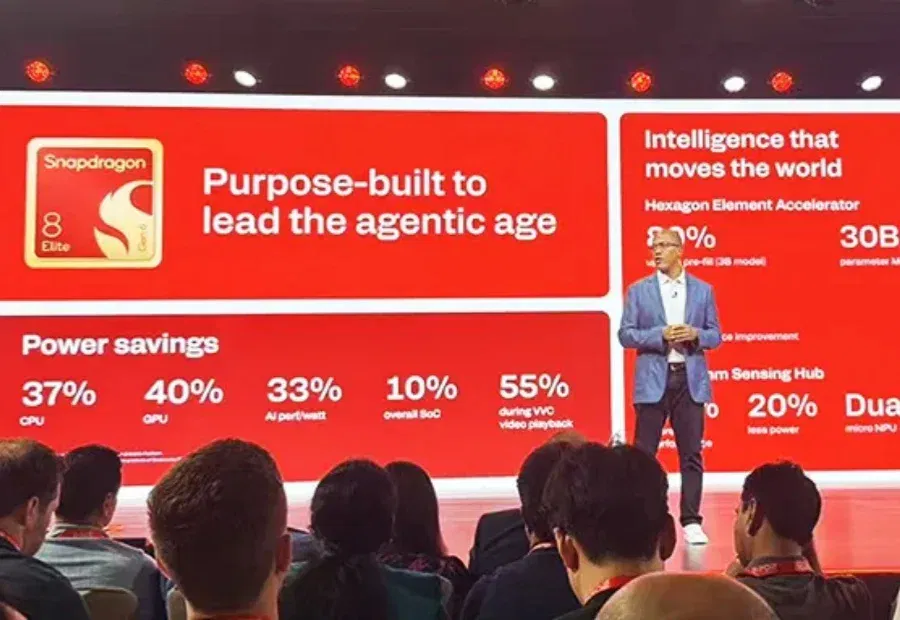
刚刚,高通2nm双旗舰来了,为智能体AI重造架构,手机能跑300亿参数大模型(在新窗口打开)
骁龙首次双旗舰齐发,最高8核CPU、GPU内置AI核、NPU内存扩容,安卓旗舰大战正式开打。
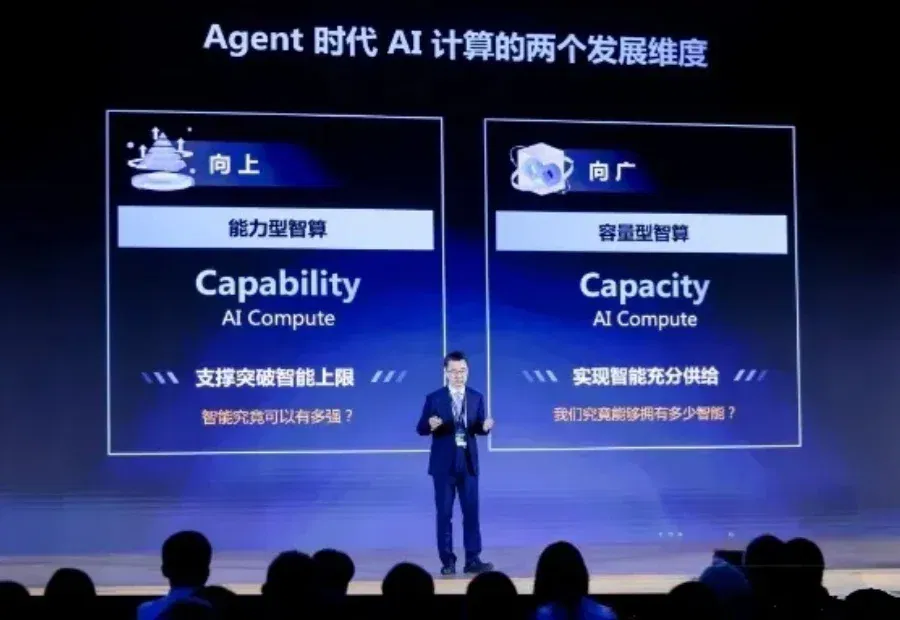
单机跑Kimi K3首破5.85毫秒,同等投资Token产能提升10倍!浪潮信息破局Agent算力难题(在新窗口打开)
AI产业的两道坎,浪潮信息怎么翻? 2026年,Agent的火爆程度空前。 9月21日,在AICC 2026大会上,IDC发布了一组数字:2026年全球活跃Agent约7940万个,到2030年将达22.16亿个。 而同期Token消耗量的增长更为惊人:从2026年的0.026Peta(千万亿),增长到2030年的152667Peta。Agent数量增长约28倍,Token消耗却增长数百万倍。 需求侧增长如此之快,算力供给能接住吗? 今年有两个案例十分典型: 一是Kimi K3。这个总参数量2.8万亿的模型,权重文件达到1.56TB,普通AI服务器的GPU显存连权重都装不下,官方推荐至少64卡
北京第一,杭州深圳进入前三!中国AI行业大洗牌了(在新窗口打开)
就在刚刚,我们看到了不少令人意外的数据。
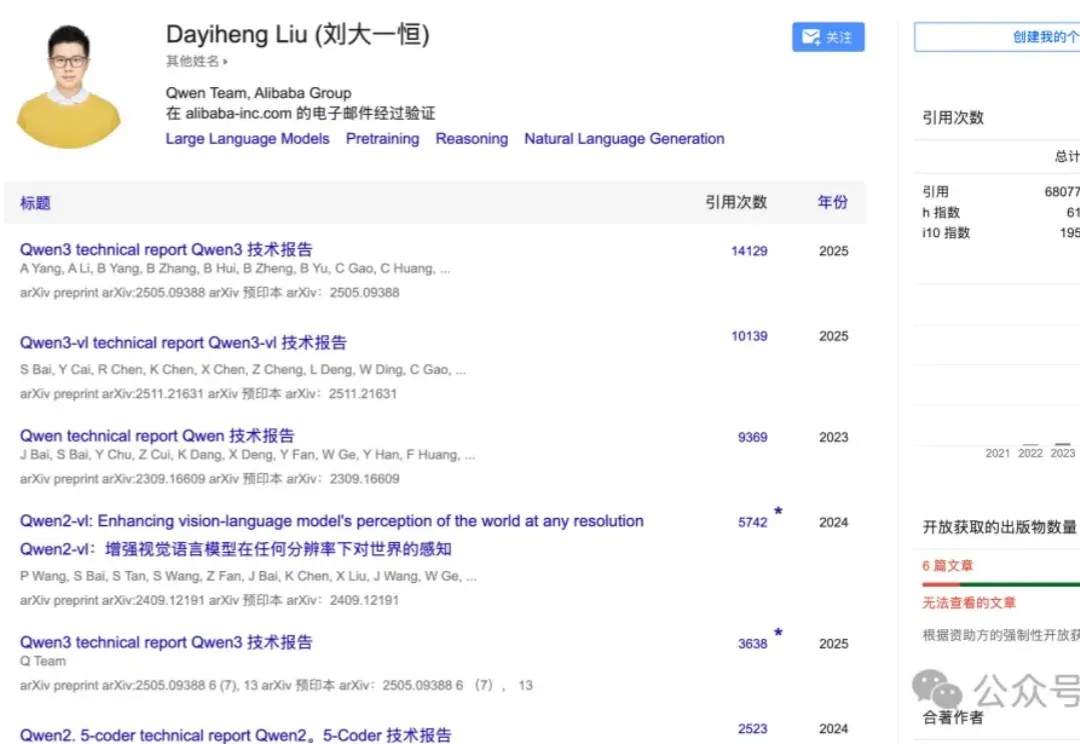
千问一号位定了!前华为天才少年刘大一恒,接棒林俊旸(在新窗口打开)
定了!林俊旸离职半年,新任千问负责人终于就位—— 前华为天才少年刘大一恒。
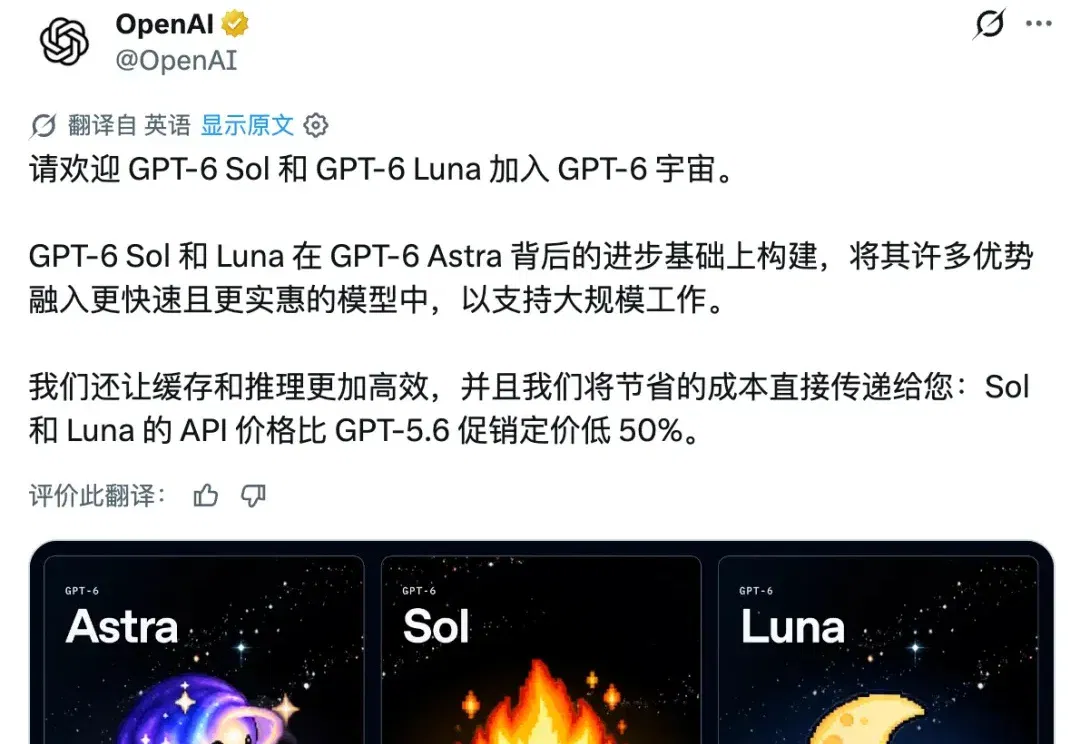
刚刚,GPT-6 新模型掀桌!「白菜价」杀进 DeepSeek 腹地(在新窗口打开)
DeepSeek 快醒醒,ChatGPT 要打到家门口了。