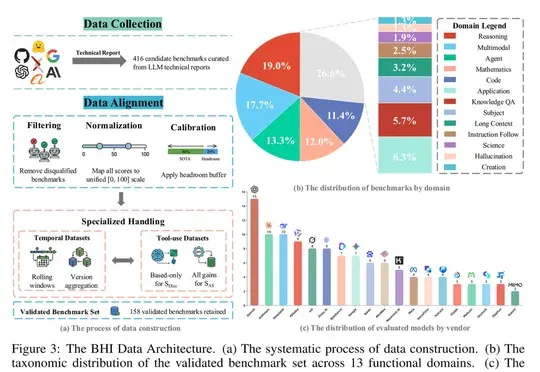
BHI 给158个评测基准做体检:区分度、抗饱和度与采用情况 (opens in a new tab)
阿里数据团队提出基准健康指数 BHI,从模型区分度、剩余挑战空间和能力加权采用情况评估 158 个基准,并用留一基准法与扰动实验检查稳定性。它能辅助筛选与复核评测,但不同技术报告的测试条件仍有差异,短期趋势也不能准确预言某套题何时失效。
Categories
Practical guides to AI tools, models and related technologies.
阿里数据团队提出基准健康指数 BHI,从模型区分度、剩余挑战空间和能力加权采用情况评估 158 个基准,并用留一基准法与扰动实验检查稳定性。它能辅助筛选与复核评测,但不同技术报告的测试条件仍有差异,短期趋势也不能准确预言某套题何时失效。
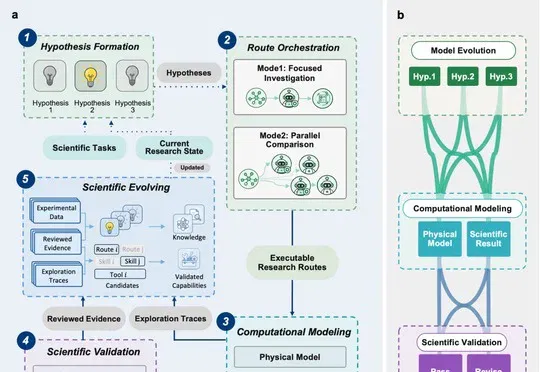
清华大学张强教授团队联合北京清屿科技、香港大学和北京怀柔实验室提出EvoSim,使AI从实验偏差中追查机制、修订方程并积累建模方法,并在电池快充析锂与动态电压预测场景完成验证。
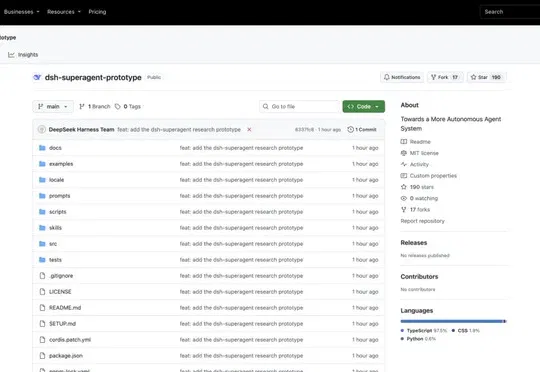
DeepSeek Harness 团队发表技术文章,介绍由 Router 统筹、Worker 执行的 Super-agent 架构,支持跨会话并行、主动响应外部事件和长期在线,并已用于内部研发协作,相关原型 dsh-superagent-prototype 已开源但尚非正式产品。
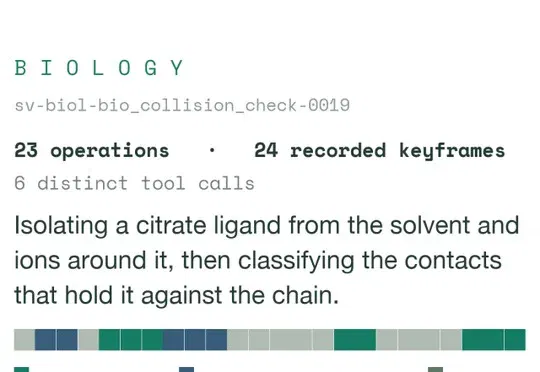
ScienceVision 在五个科学领域比较原始三维数据、交互检视工具与固定二维视图三种设置。最佳参评配置的平均得分为 0.53,包含部分得分,不能当成答对率;研究显示访问更多工具与真正提取有效证据之间仍有距离,结论限于这套任务和评分规则。
清华大学研究团队提出动作级在线蒸馏ActionOPD,在学生实际访问状态下以语义动作监督策略优化,使轻量Agent学习教师决策而非模仿Token,并支持黑盒接口、跨家族蒸馏及Self-ActionOPD自蒸馏。
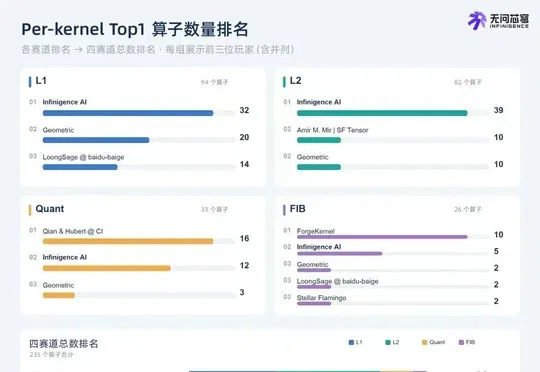
这篇技术报道进一步讨论算子优化 Agent 如何利用隔离评测、Skills 和共享记忆迭代,并呈现 GPU 排队与工作流演化的观察:个体为减少等待而延长占用,可能降低整体效率。文章将资源调度与有效反馈速度联系起来,局部优化仍需端到端验证才能反哺基础设施。
CEL 探索让机器人共享成功经验,由失败场景引导检索与策略微调,并用容错异步系统支撑集群持续运行。团队在 96 台机器人原型中观察规模收益,再用未参与训练的同型号机器人测试;高成功率来自五项指定任务,仍保留初始化示范与人类结果判定。
多机构团队提出OpenDS任务范式并构建含200道任务的OpenDS-World评测基准,GPT-6 Astra以39.0%准确率居首,显示AI Agent在真实网络长程搜索与证据整合方面仍面临重大挑战。
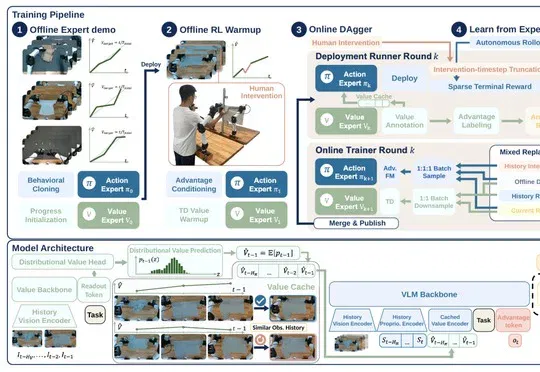
VaM 将近期价值预测缓存输入动作策略,帮助机器人区分视觉相似却进度不同的状态,再通过离线预热与在线真机强化学习更新策略。团队在纸盒装配、衣物折叠等任务上报告恢复与成功率收益,其中四小时稳定运行来自纸盒装配设置,不代表所有长期操作任务。
量子位通过拟人化音乐视频、知识讲解和剧情短片体验 Genspark Media Studio,观察多模型调度、角色设定、局部重拍与工程导出。流程整合降低了工具切换成本,但审核操作、音画同步、画面穿帮和积分消耗仍影响成片体验,用户仍需要判断与返修。
蚂蚁百灵同步开放进一步后训练的 1019 版与基础权重 Base,前者聚焦复杂推理和多步骤工作流,后者供开发者继续训练。报道分别梳理两类模型的评测、混合线性 MoE 架构及部署方式,也指出更高任务成绩伴随着更多 Token 消耗。
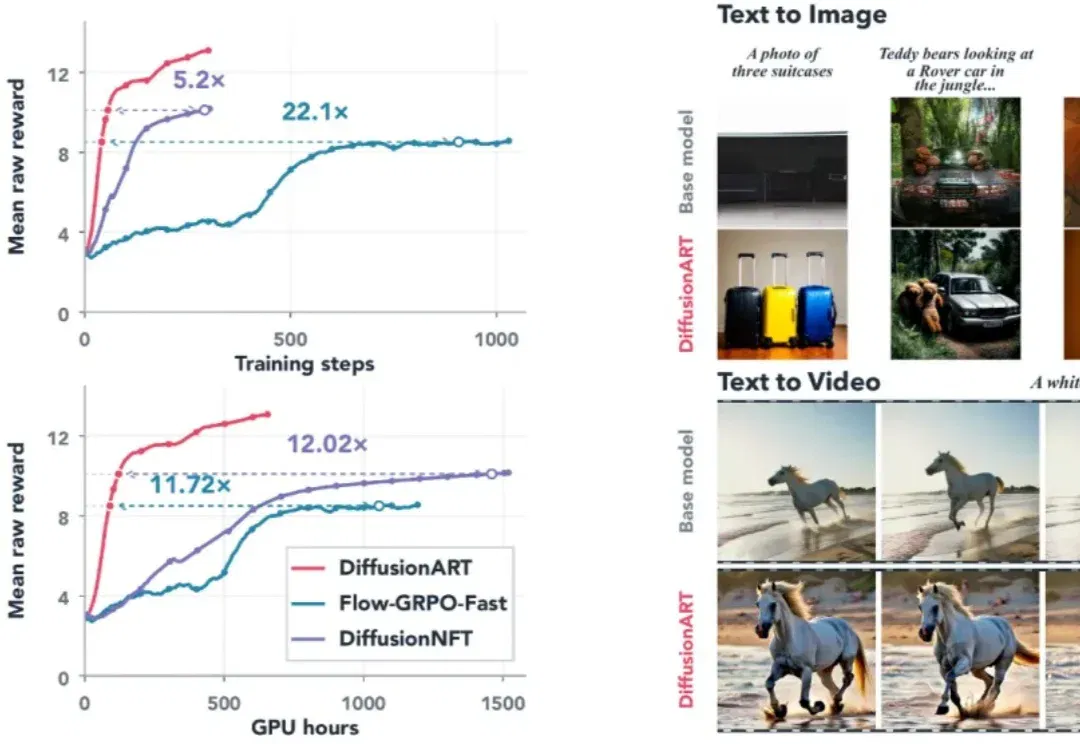
DiffusionART 先聚合奖励方向,再用两次更新和信赖域限制处理策略漂移,支持确定性采样与不可微奖励。团队在多种图像、视频模型上报告效率与稳定性收益;十倍以上加速指特定视频实验达到指定奖励水平的对照,并非所有训练任务都等幅提速。
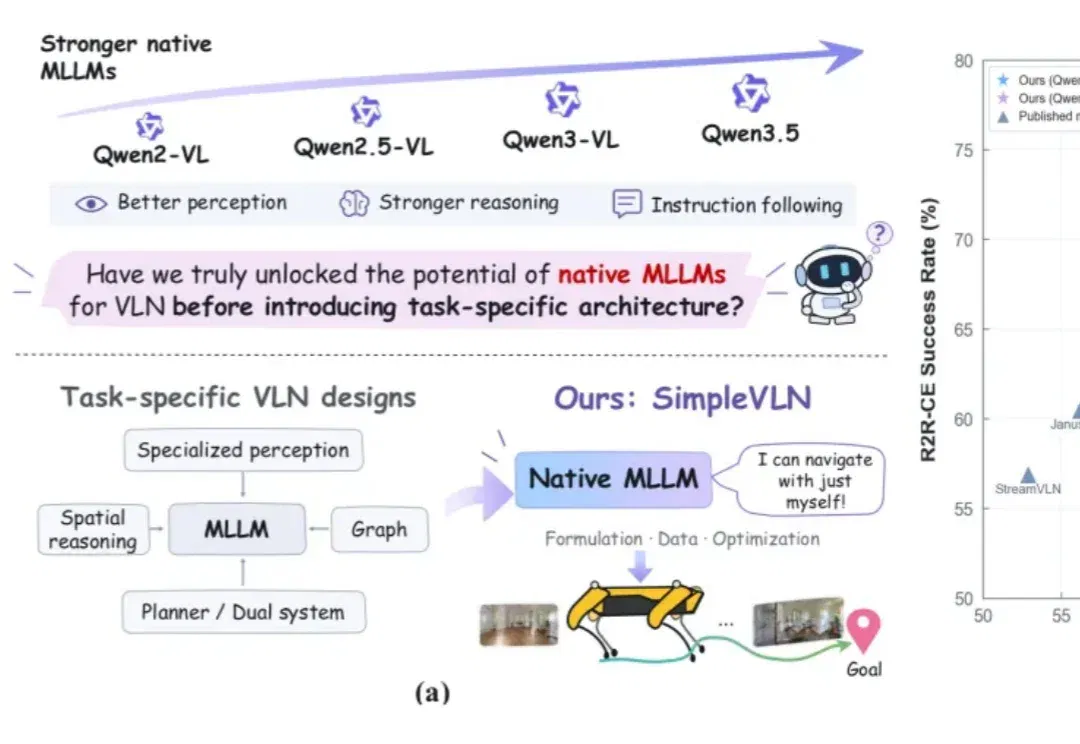
SimpleVLN 通过历史画面筛选、动作块输出,以及专家示范、DAgger 和强化学习组成的训练流程,挖掘原生多模态模型的导航能力。团队在连续导航基准上报告提升,并展示四足机器人演示;仿真成功率与真实环境的稳定泛化仍应分别验证。
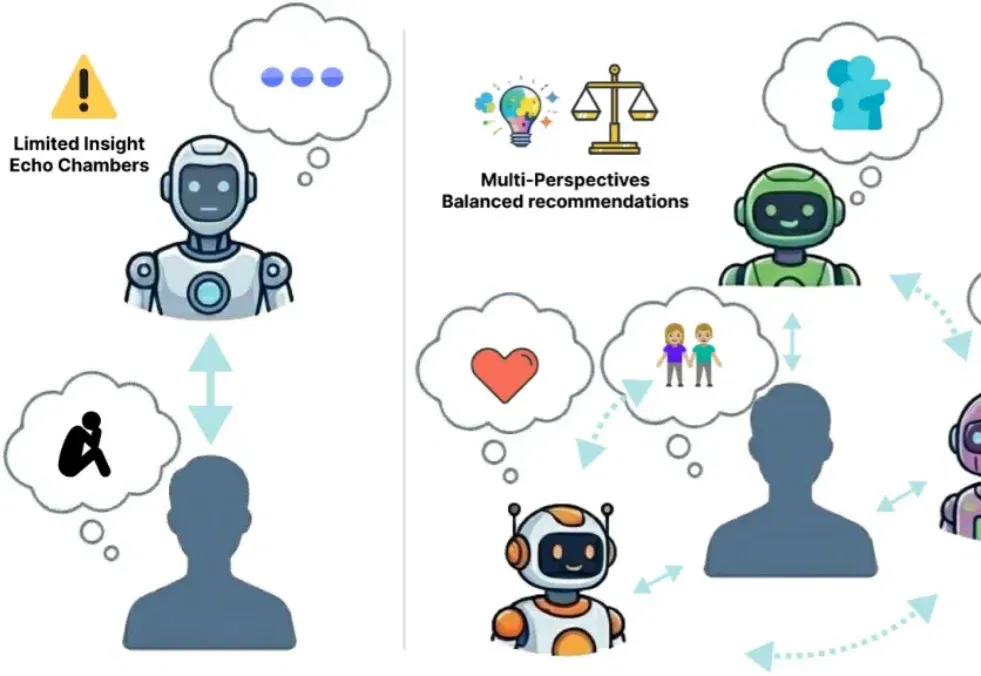
MASCOT 将多智能体群聊拆成角色行为对齐与主持人协调两个训练阶段,减少多个角色反复附和、缺少新贡献的问题。研究在情感支持与会议讨论数据上结合模型评分和人工盲评验证效果,现有证据主要来自英语和受控情境,长期互动仍待检验。
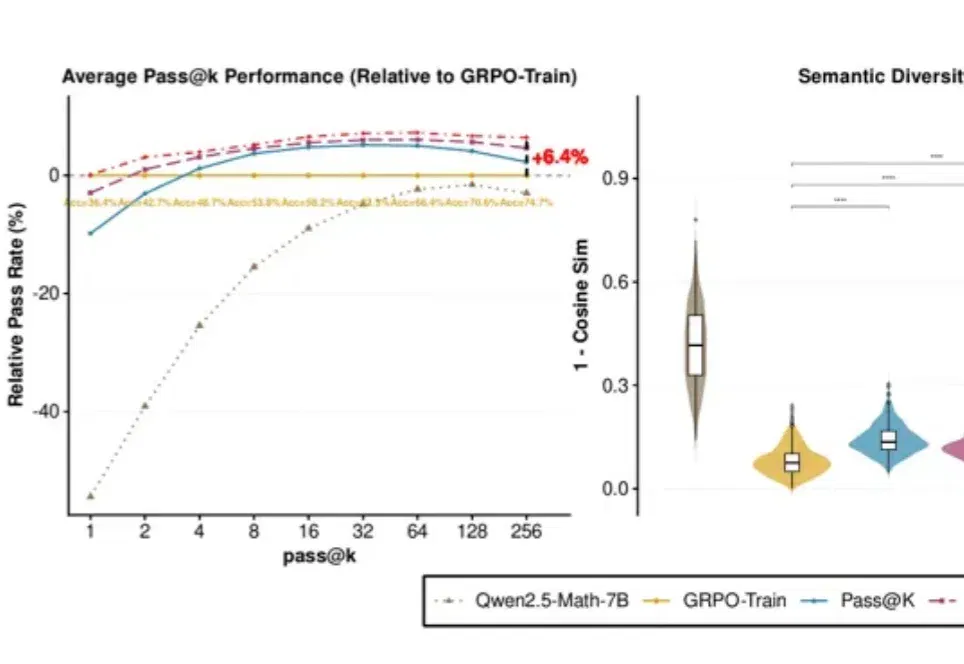
PSN-RLVR 在生成前对部分模型参数施加小幅扰动,并让同一扰动贯穿整段推理,再通过重要性采样与自适应调度衔接正常训练。实验中多次尝试的成功率提升较明显,单次作答收益则需另看;有限采样发现新路线,并不能证明原模型永远不会产生同类解法。
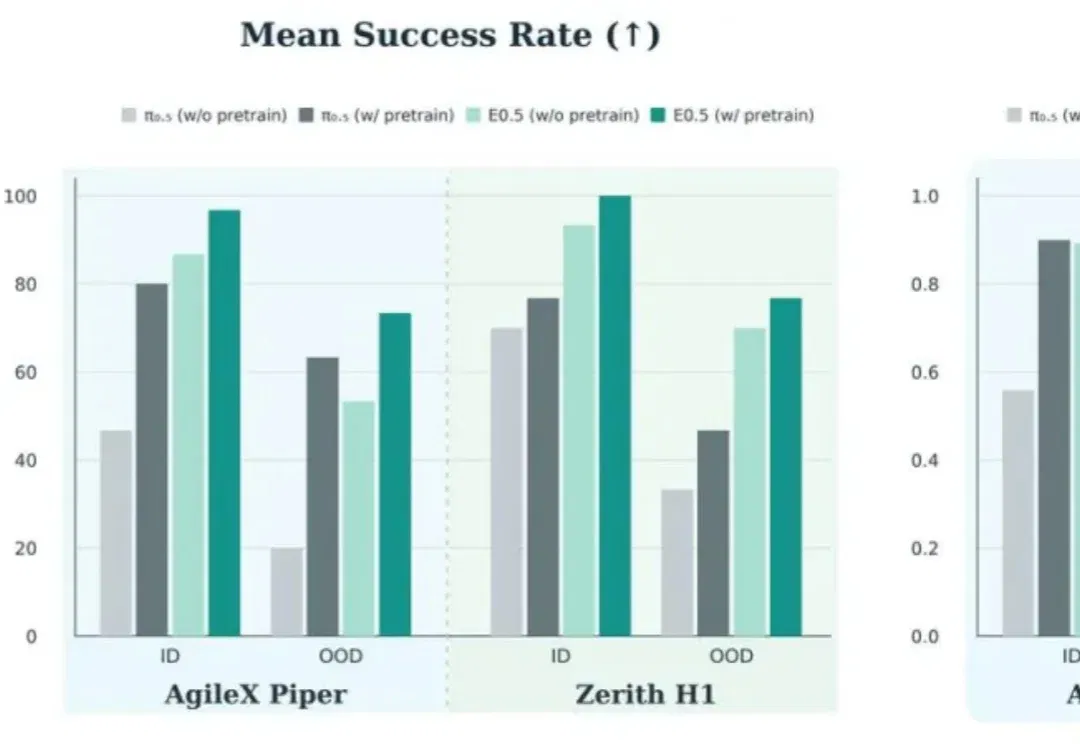
E0.5 以三维基础模型为骨干,将未来几何状态与动作序列联合训练,并在双臂与人形机器人任务上测试操作表现。团队分别报告了有无大规模机器人预训练、分布内与分布外的结果;这些对照支持特定任务收益,不能直接代表任意真实场景的成功率。
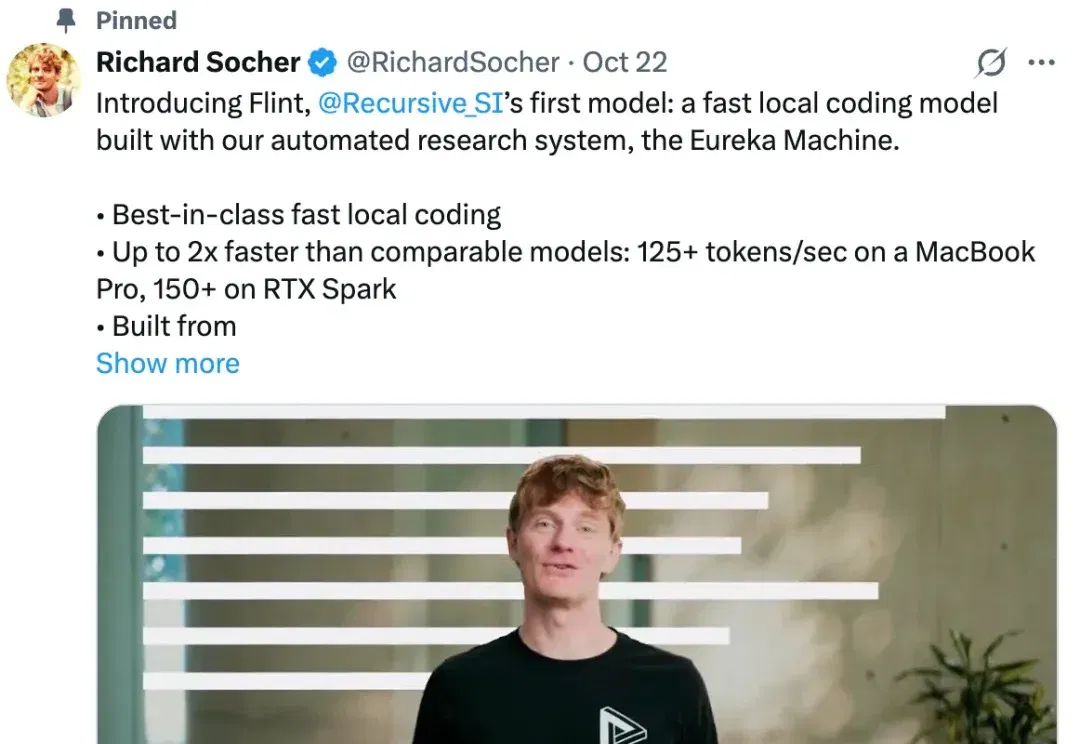
Apex-35B-V1.0 基于 Qwen3.6-35B-A3B 进行中训练和后训练,面向编程、智能体及研究任务。超衍智能介绍其自动化研究系统如何参与数据构造、训练方案和算力优化,并公布多项评测与仿真案例;这些团队报告的结果仍需要结合评测设置和独立复现判断。
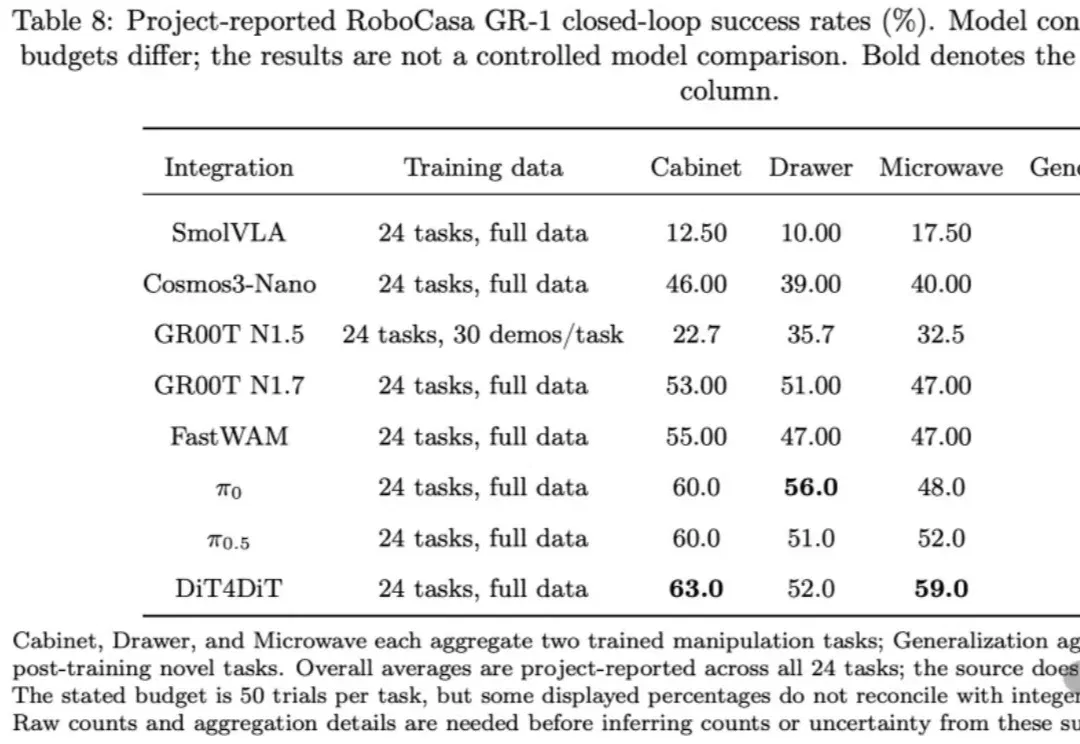
逐际动力更新 FluxVLA Engine 技术报告,补充在线强化学习、仿真评测和多种机器人平台的部署链路。统一配置、数据接口、推理加速与动作衔接旨在减少重复工程;报告中的性能增益来自特定模型和设备组合,仿真高分与真机任务完成率仍需分别看待。
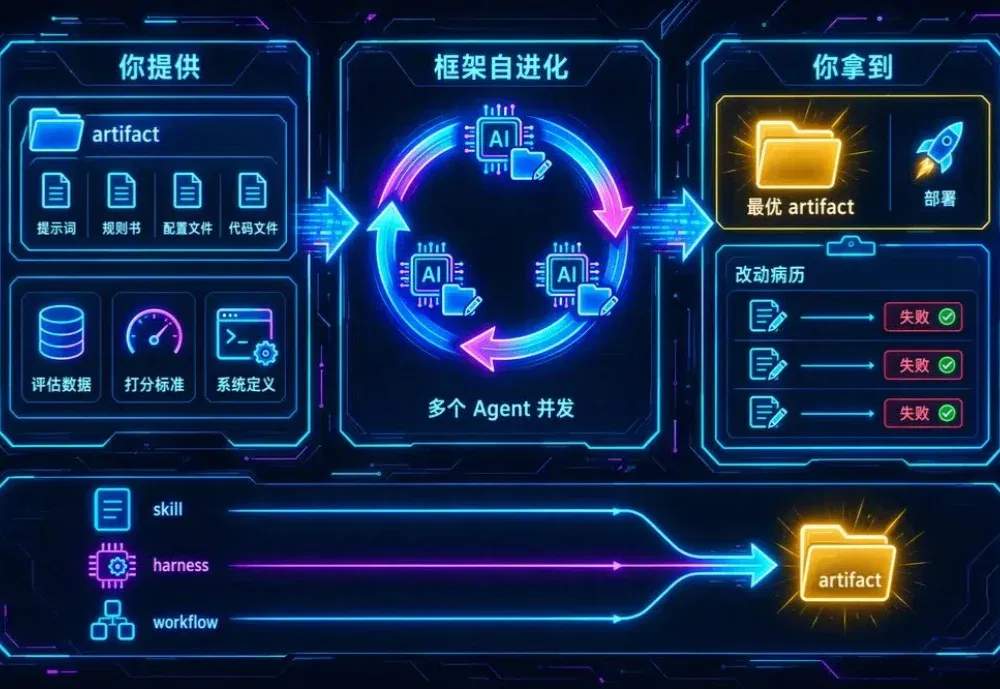
AntOmniEvo 将 AI 系统中可修改的部分组织成文件目录,通过修改、评估和筛选反复优化。Mara Chain 在有限预算内保留失败尝试的诊断记录,减少重复试错;团队展示了技能、执行框架与检索管线的实验结果,也指出 Text2SQL 测试尚未观察到提升。
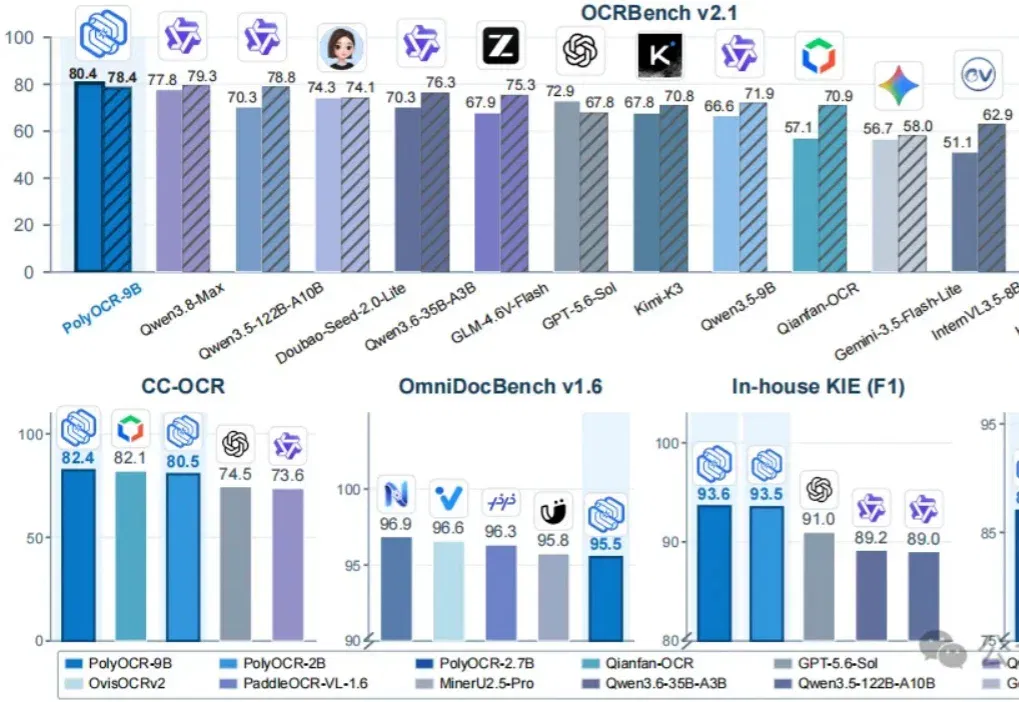
蚂蚁 AI 安全实验室介绍 PolyOCR,以多任务数据与能力引导策略优化连接文字识别、文档结构和字段理解。2B 与 9B 在部分卡证测试上接近,复杂文档表现则存在差距;高分版式解析方案还借助外部布局模块,部署选择需要结合真实材料与硬件验证。
Join the conversation
Read how to join the community. No sign-in is required to read articles.