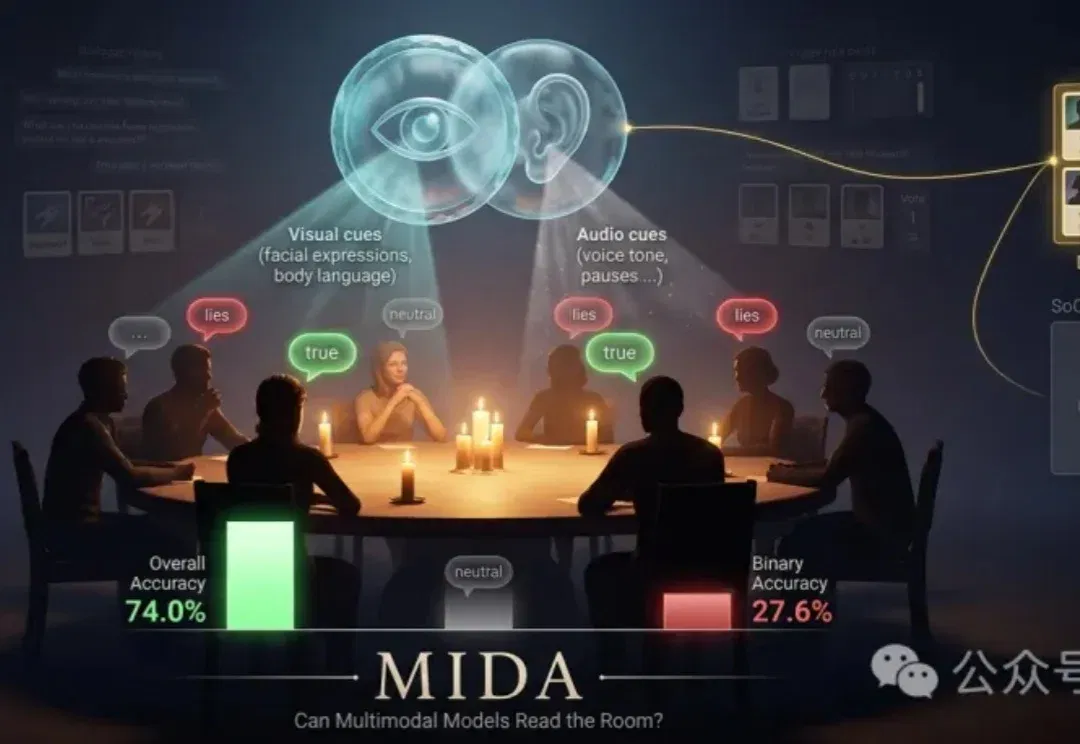
MIDA 狼人杀基准:多模态模型为何仍难判断发言真假 (opens in a new tab)
MIDA 以狼人杀对话测试模型能否结合玩家掌握的信息,区分真话、假话与无法判断的发言。研究发现,总体准确率可能掩盖大量“中立”预测;持续跟踪对话历史和角色信念,比简单增加视频帧更关键。这类受控游戏测试仍不能等同于现实测谎。
Categories
Practical guides to AI tools, models and related technologies.
MIDA 以狼人杀对话测试模型能否结合玩家掌握的信息,区分真话、假话与无法判断的发言。研究发现,总体准确率可能掩盖大量“中立”预测;持续跟踪对话历史和角色信念,比简单增加视频帧更关键。这类受控游戏测试仍不能等同于现实测谎。
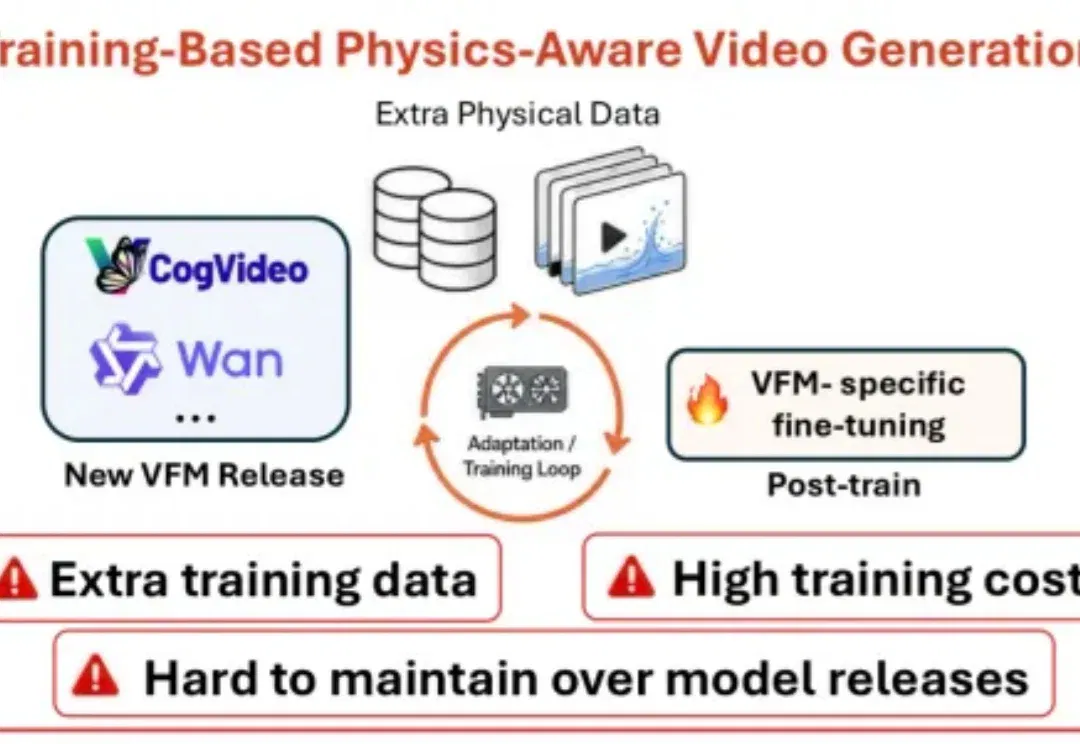
Fluid-Gen-Zero 把运动轨迹交给物理模拟器,把外观生成交给预训练视频模型,并通过事件规划与区域引导连接两者。研究在流体交互场景中测试了这条无需更新模型权重的路线,但效果仍依赖场景重建、仿真质量和具体生成设置。
视觉模型即使理解了问题,也可能因图像裁切位置不准而错过细节。NV-CoT 用连续坐标替代离散位置选择,结合监督微调与强化学习改善区域定位;多项高分辨率测试展示了收益,但更精确的坐标仍无法替代正确的语义理解。
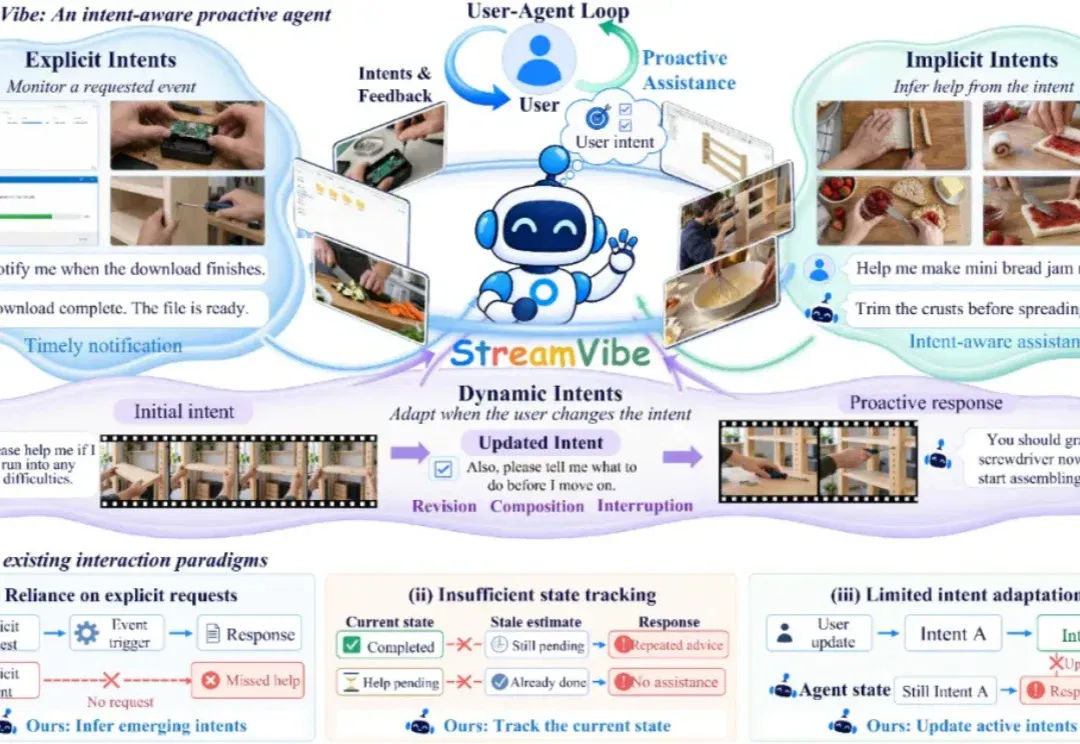
StreamVibe 将显式请求、隐式帮助需求和动态意图放入持续视频交互,结合策略学习与状态记忆管理决定何时回应。报道区分逐点评测与完整轨迹,并讨论重复提醒、误触发和长时间交互中的错误累积。
量子位比较 OpenAI 与 Anthropic 披露的 ETH 相关算法与形式化范围,并解释这类复杂性结果为何影响条件性下界。报道明确参与审查不等于认可结论,相关材料仍需谨慎、独立地复核。
RobotAgentBench 通过家庭仿真与真实环境子集,考察机器人操作、任务发现、情境推理、失败恢复和鲁棒性。研究比较规划、执行与验证的不同组合,并说明自我改进收益及仿真到真实环境仍存在的差距。
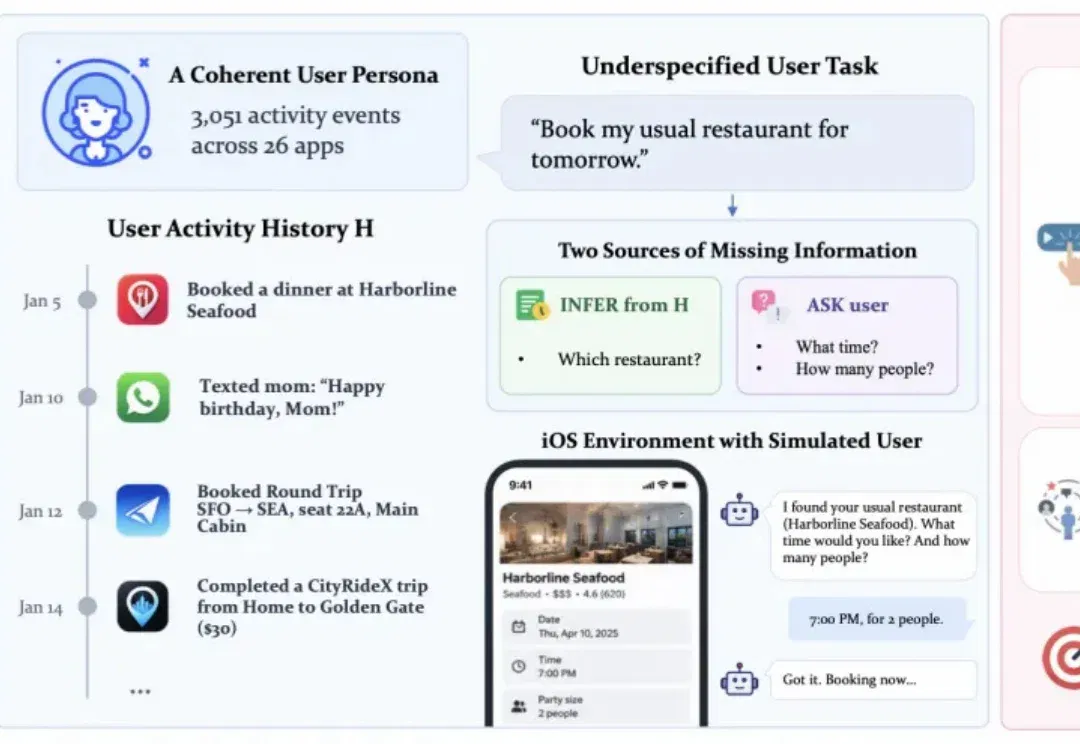
苹果团队提出 iPrefBench,在可执行的 iOS 环境中评估 Agent 何时应从历史推断偏好、何时需要询问用户。实验显示,完成操作与符合个人意图并不相同;增加澄清可减少漏问,也可能带来多余打扰。
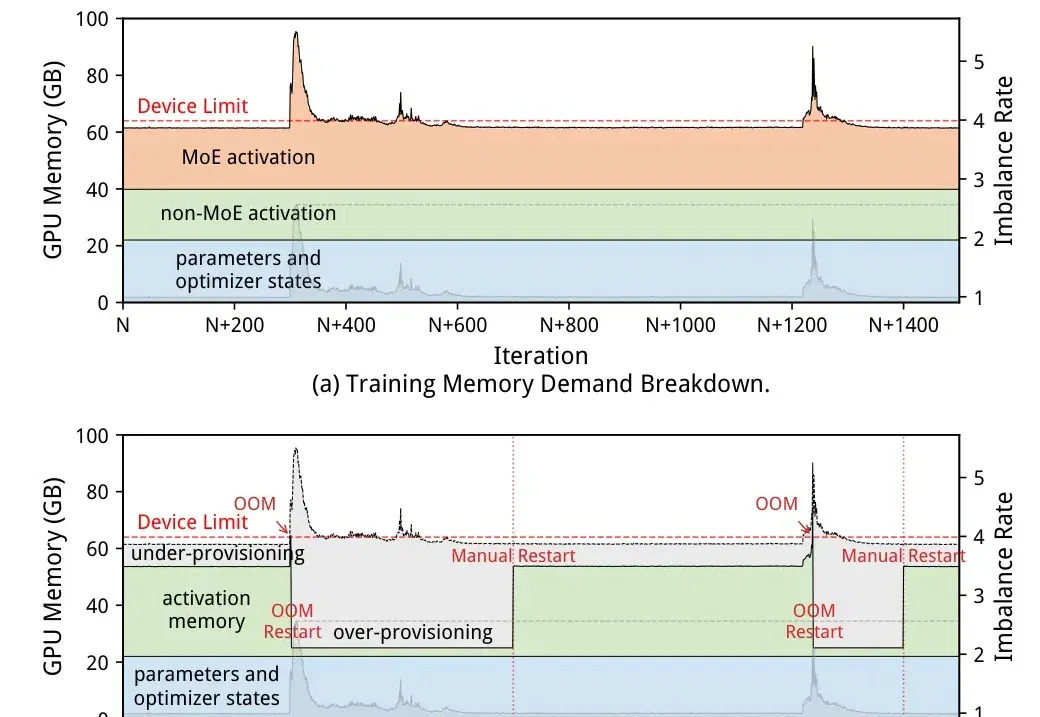
八卦炉 2 针对 MoE 训练的负载尖峰,结合成本建模、算子级保存或重计算及卸载调度,在运行时调整显存策略。报道介绍多规模集群测试与开放代码,同时说明公开仓库并未包含论文的全部运行时机制。
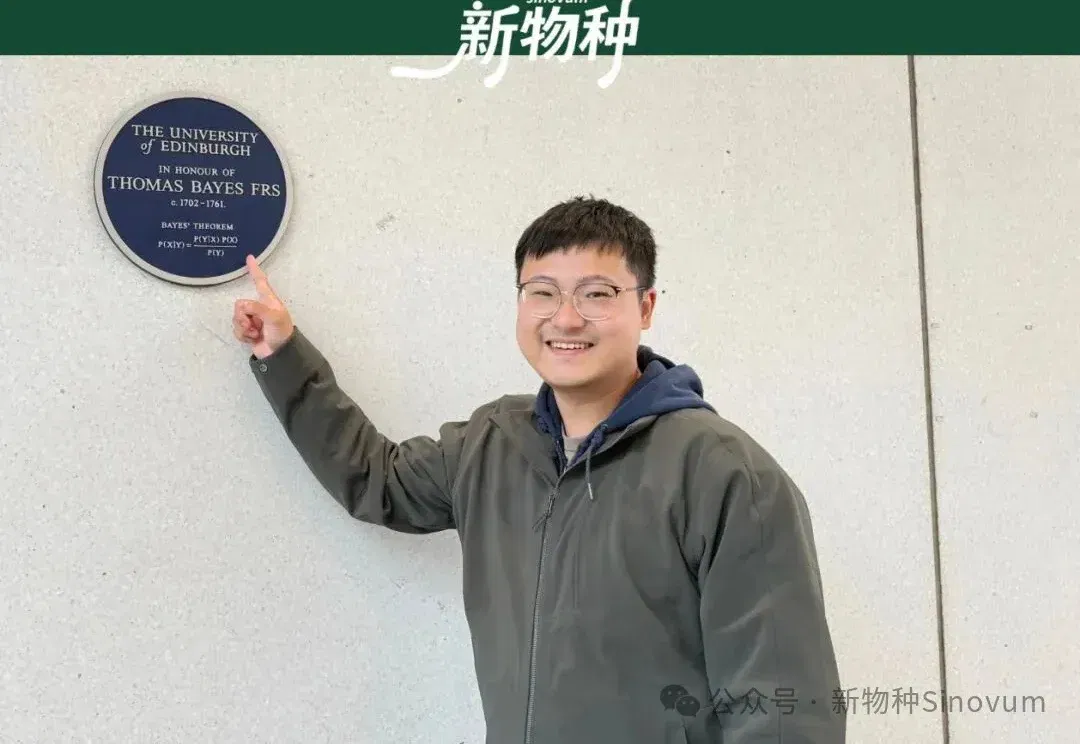
新物种访谈班布 AI 联合创始人邓程,回顾模型预训练、Agent 效率与软硬件协同研究如何延伸到家庭管家系统。对谈关注家庭事务整理、跨设备感知和必要的人类判断,区分现有演示与更远期的家务执行设想。
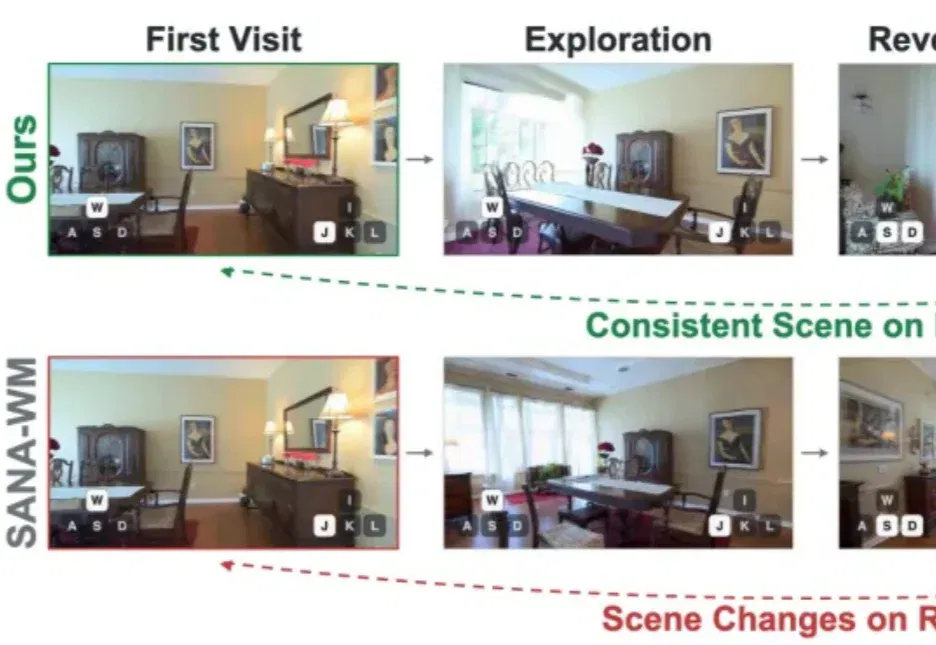
World-T³ 以相机位姿索引快速权重,在生成过程中写入和检索历史场景,并通过双教师蒸馏兼顾交互速度。报道介绍重访测试及工程优化,也保留位姿估计误差和超长生成细节退化的限制。
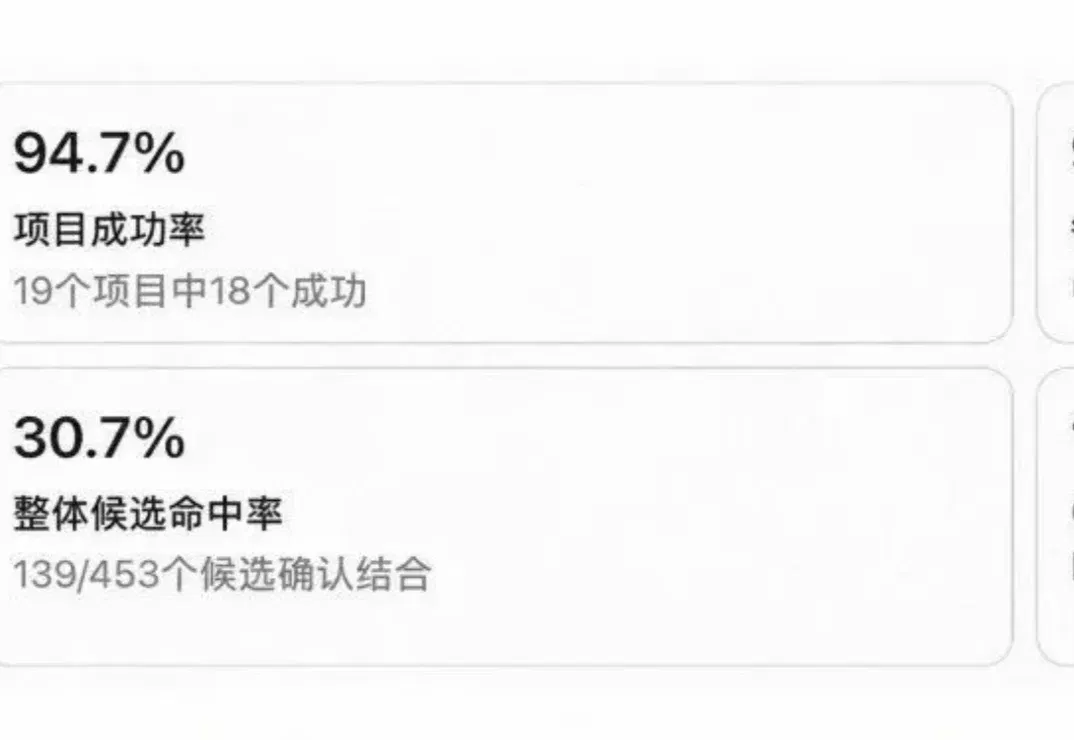
分子之心技术报告介绍 MMDesign 跨靶点的从头设计、候选筛选和结合实验,并讨论可开发性、序列新颖性及结构预测的作用。相关命中属于早期分子验证,不能等同于药物临床有效或已经获批。
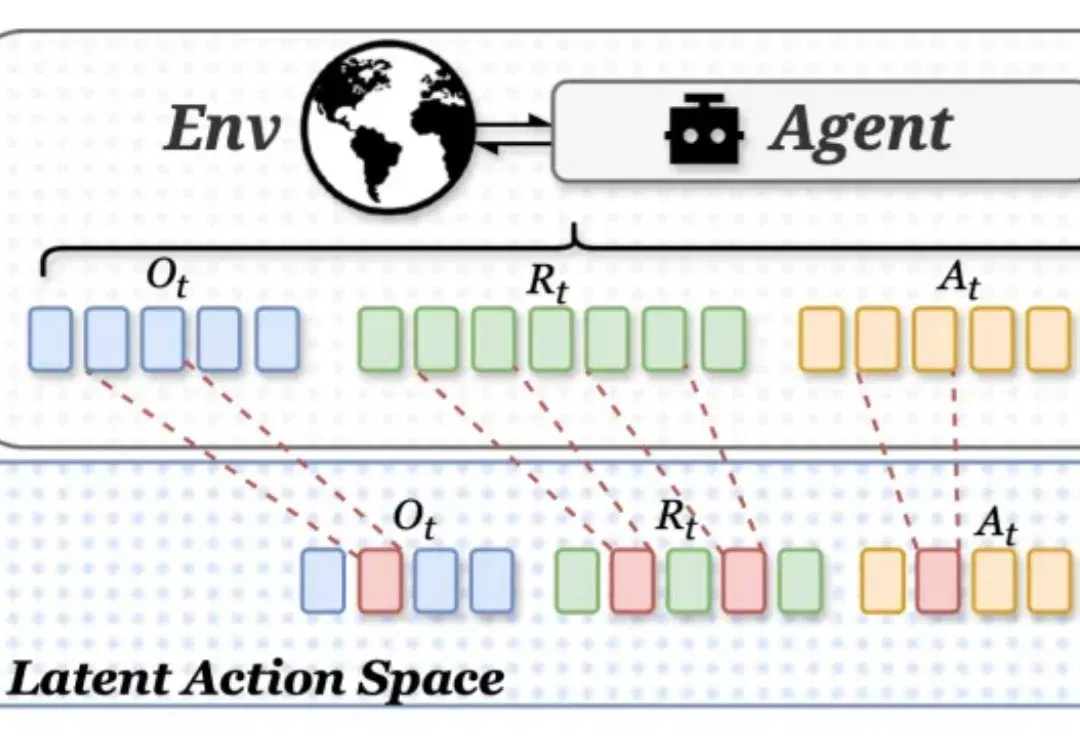
LAR 将重复、稳定的多步动作表示为可学习的潜在动作,尝试减少 Agent 完成任务所需的生成步骤。原文介绍动作词表学习、轨迹蒸馏与实验结果,并讨论过度压缩具体参数可能损害任务表现的边界。
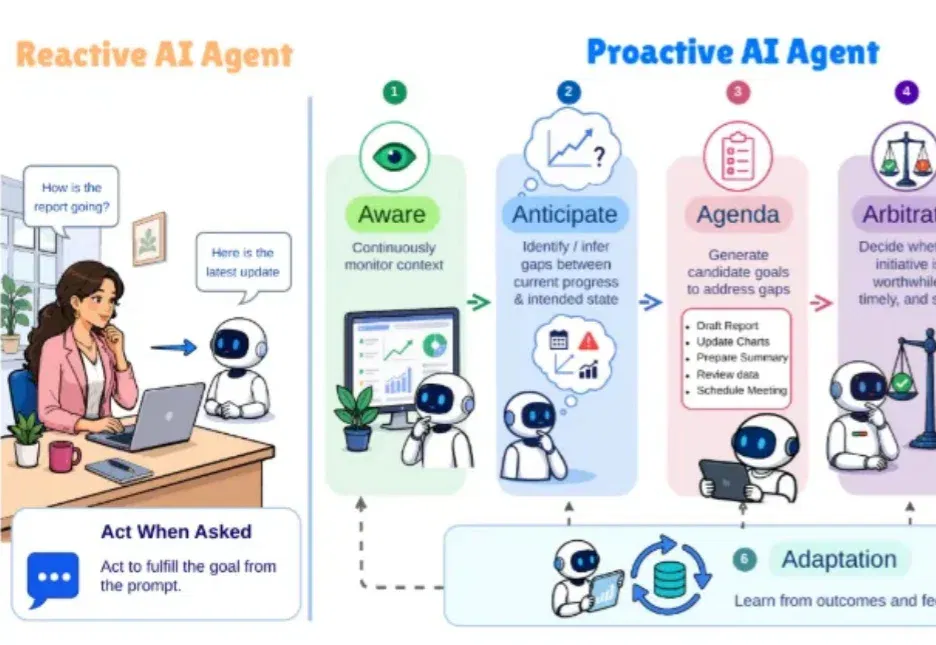
早在 1995 年,Michael Wooldridge 等学者便在智能体研究的代表性论文《Intelligent Agents: Theory and Practice》中,提出了智能体的四项核心特征:反应性(Reactivity)、社会能力(Social Ability)、自主性(Autonomy)和主动性(Proactiveness)。
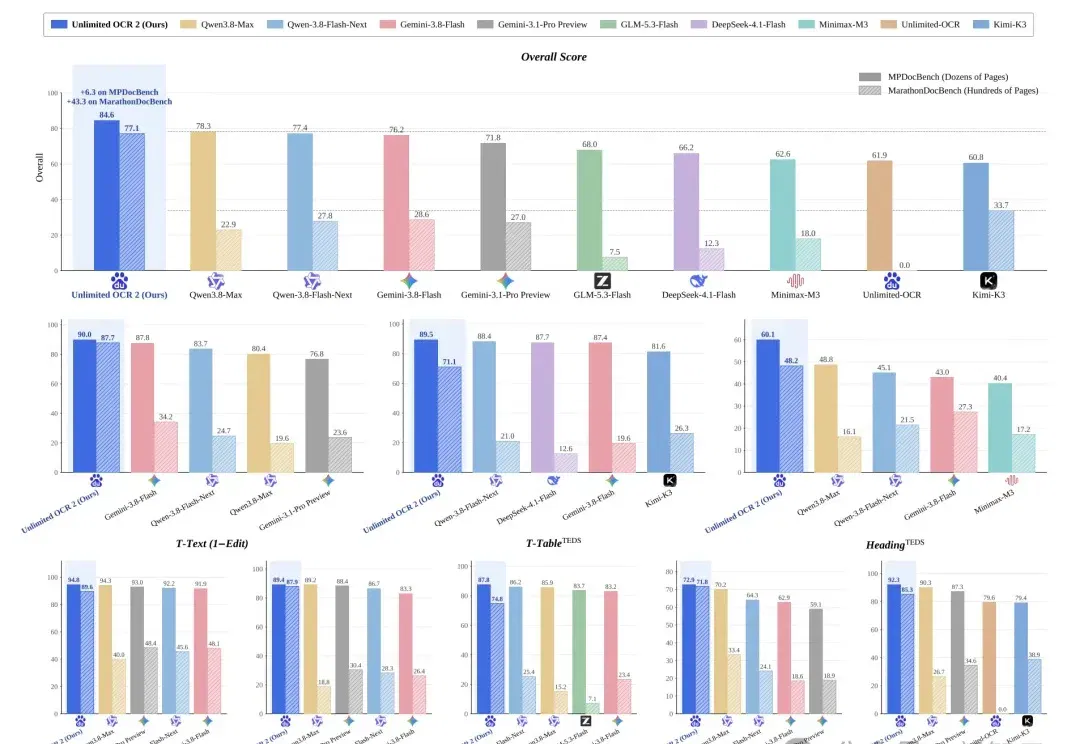
曾获LeCun转发推荐、狂揽1,000万下载的百度开源神作,又杀回来了!
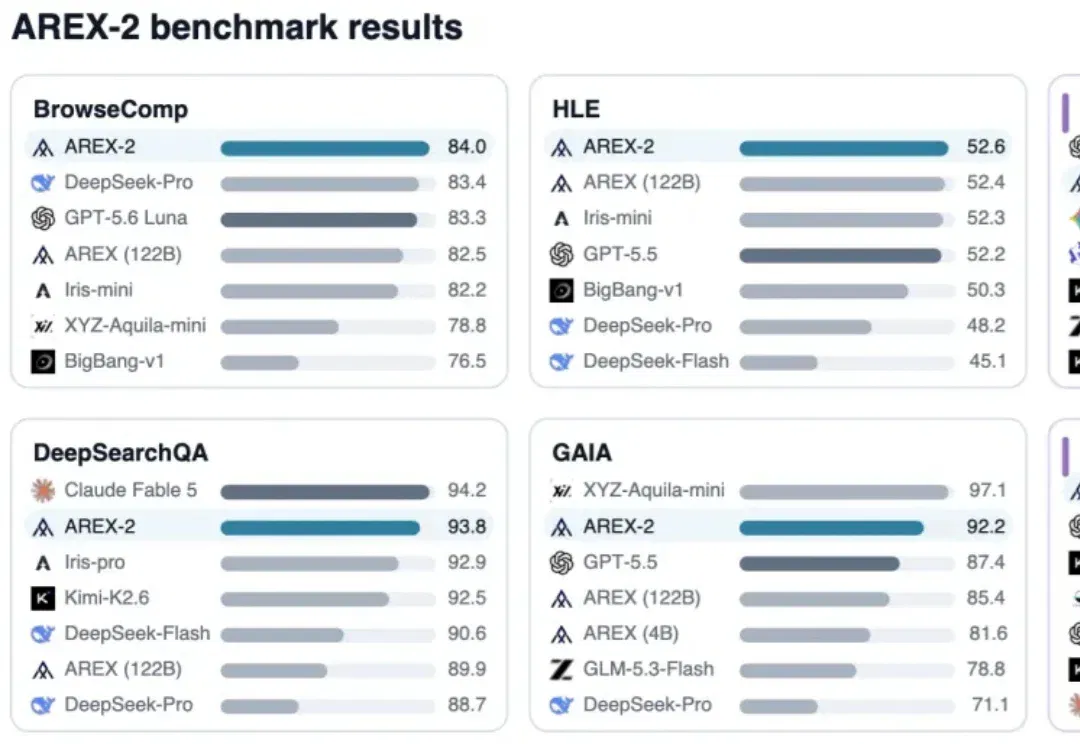
当模型学会持续迭代改进算法,便推开了通往智能自主进化的大门。近日,由来自智源研究院、中国科技大学、中国人民大学等多个机构的研究人员组成的 AREX 研究小组发布 AREX-2 模型。
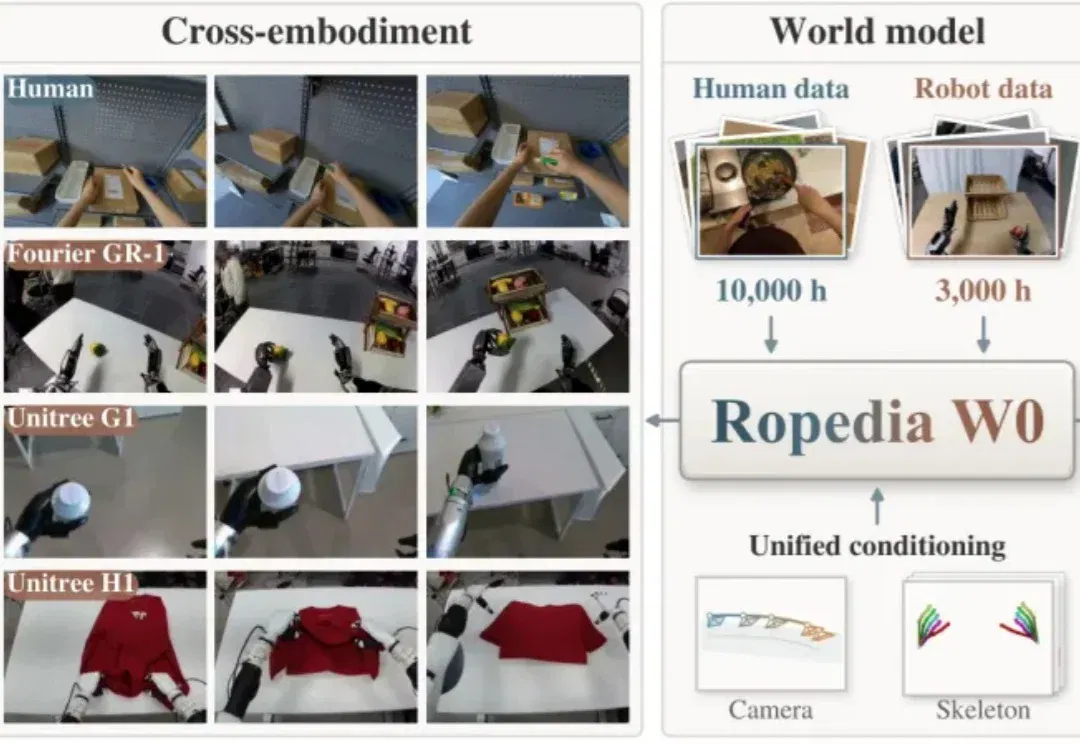
第一视角视频越来越多,研究人员怎样把这些记录变成能够改善机器人能力的训练信息?
把模型部署到昇腾 NPU 上,计算逻辑确定之后,还有一道难题:怎样让底层实现充分利用硬件?同一个注意力计算,分块、搬运、并行和同步方式不同,运行时间就可能明显不同。
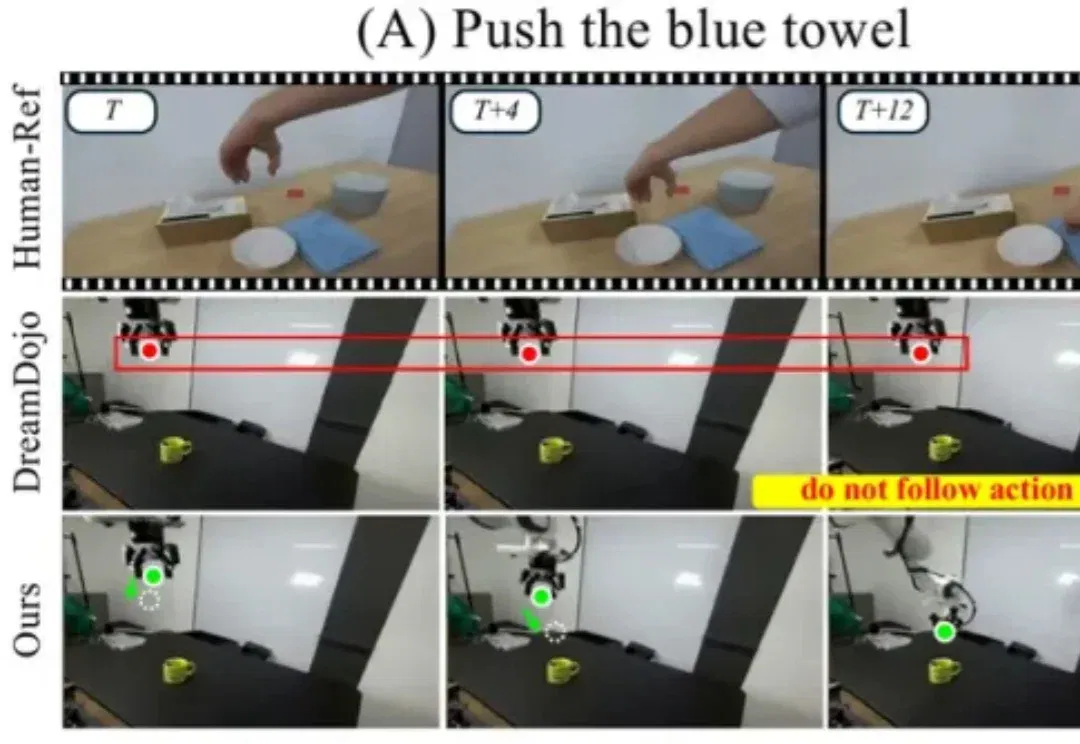
基于预训练的 Cosmos-Predict2.5-2B,SkeLAM 使用总计约 10 小时的机器人交互数据进行训练。在人手到机器人的迁移实验中,输入换成人类演示,生成视频中的机械臂仍然呈现出与演示对应的运动方向。迁移时模型参数全部冻结,没有针对这些演示额外微调。
清华大学、英伟达等机构联合推出全球首个流式交互视频生成评测榜单StreamEval,以300个用例评测38个模型,揭示当前模型在连续指令执行和状态一致性方面仍存明显短板。
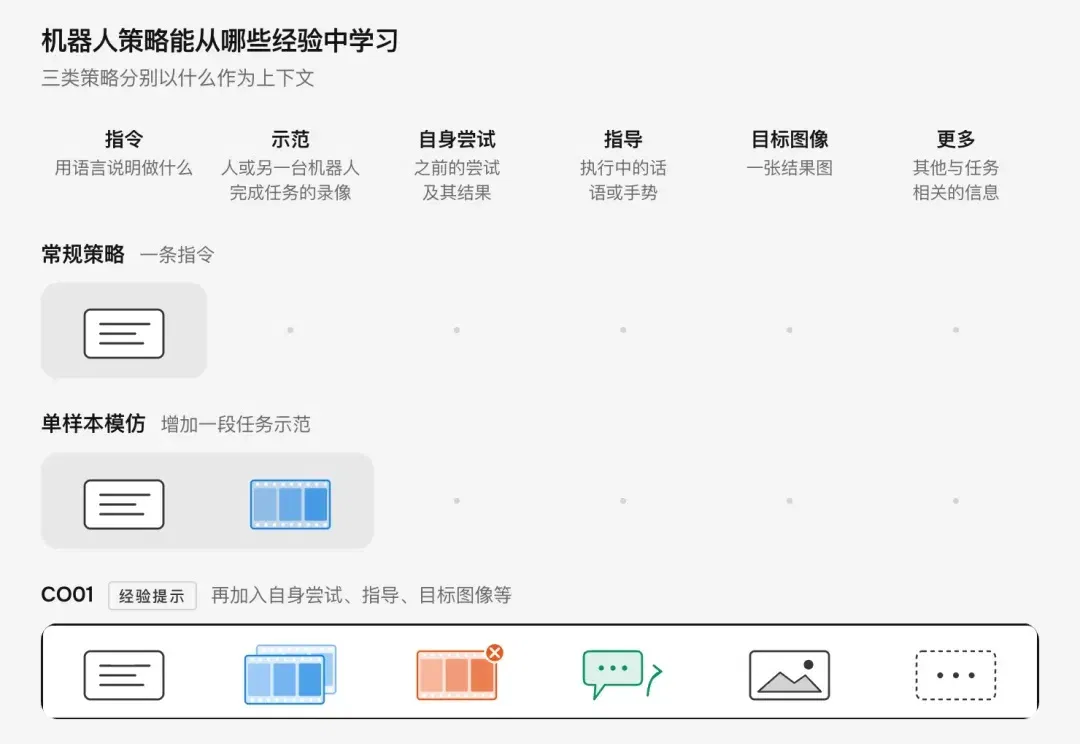
人通过观摩、尝试和指点学习,机器人也能如此。可可矩阵(COCO Matrix)发布机器人模型 CO01(读作/kuːl/),让机器人也能从这些经验中学习。
Join the conversation
Read how to join the community. No sign-in is required to read articles.