CoRL 2026|浙大联合TeleAI提出GR-BC,用图搜索从机器人试错中找出有效动作 (opens in a new tab)
浙江大学、TeleAI 与伽马智能提出 GR-BC,把多次成功、失败和人工介入轨迹连成图,从成功终点反向搜索进度,再为有效动作片段加权训练。在四项精细操作的真机实验中,X-VLA骨干平均成功率约91%,其他骨干只在部分任务上验证。
Categories
Practical guides to AI tools, models and related technologies.
浙江大学、TeleAI 与伽马智能提出 GR-BC,把多次成功、失败和人工介入轨迹连成图,从成功终点反向搜索进度,再为有效动作片段加权训练。在四项精细操作的真机实验中,X-VLA骨干平均成功率约91%,其他骨干只在部分任务上验证。
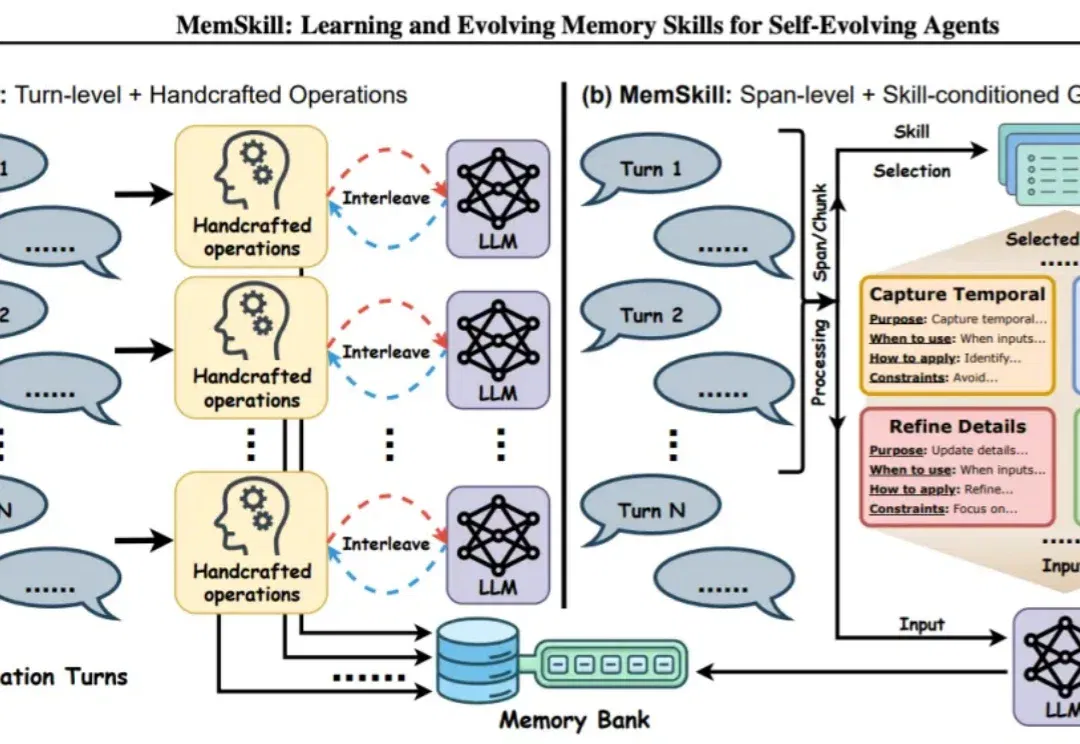
MemSkill 将智能体记忆操作封装为可复用的技能,由 Controller 学习选择,Executor 构建记忆,Designer 根据失败案例改进技能库。论文在长期对话、具身任务和迁移问答中评估表现;持续利用真实用户反馈适配偏好仍是后续研究方向。
南洋理工大学与上海人工智能实验室提出 PhysLDM,用时空自编码器压缩形变轨迹,再由扩散模型一次生成整段运动。团队报告毫米级重建、跨物体迁移及可微材料参数反演结果,并比较生成式预测与确定性回归在复杂形变中的差异。
LeCun 与合作者研究 Good-View JEPA 如何学习不同模态的共同表征。在特定对齐评测中,109M文本编码器超过Qwen2.5-72B;同规模比较也显示样本效率提升。理论证明依赖理想化条件,结果不能推及通用推理或编程能力。
ScholarCatalyst 汇集184位作者对207项研究的灵感标注,评测系统能否找回真正有启发的论文。主实验最佳检索器的前20篇召回率约48%,多轮 Agent 搜索未超过它;候选覆盖和排序是重要瓶颈,这一指标也不能等同整体科研能力。
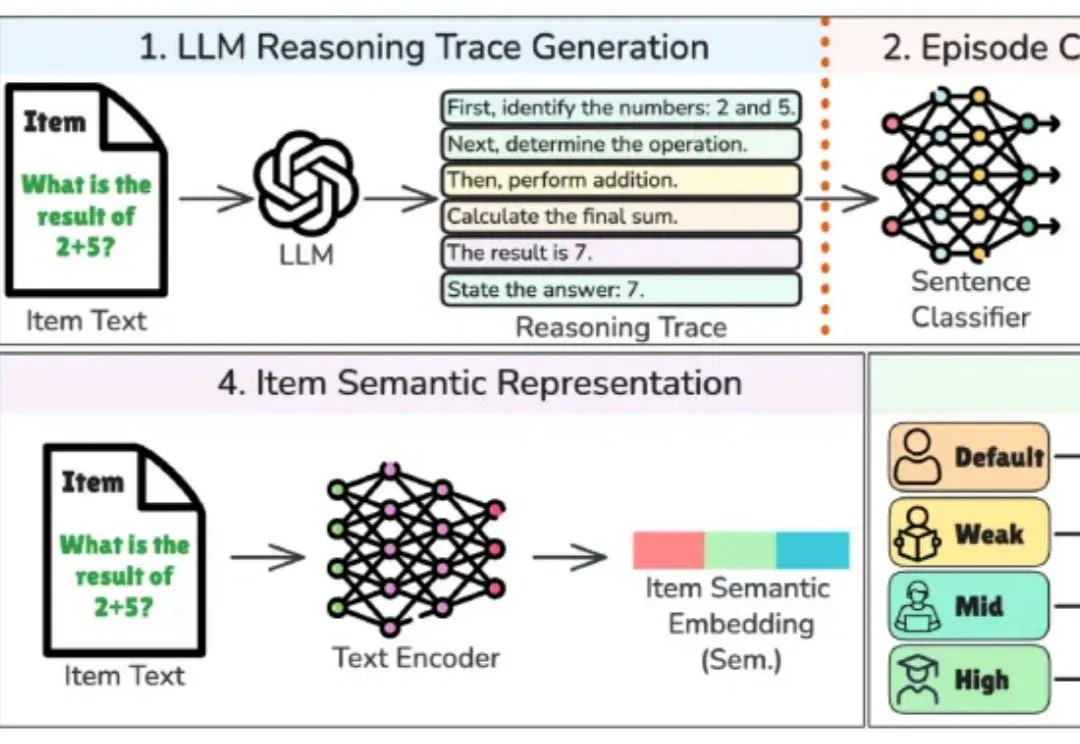
Epi2Diff 将大模型解题过程拆为八类认知片段,提取过程特征并结合题目语义预测人类作答难度。研究在四个测评数据集上报告结果,SAT数学主实验准确率为73.0%;方法仍依赖已有难度标签训练,也需要目标人群验证与专家复核。
孙仲与 IBM、Unconventional AI 的研究者梳理现代模拟计算的原语、硬件和应用。文章介绍阻变存储阵列如何结合低精度求逆、高精度乘法与迭代修正求解矩阵方程,并讨论数模协同、精度、扩展性及商业化路径。
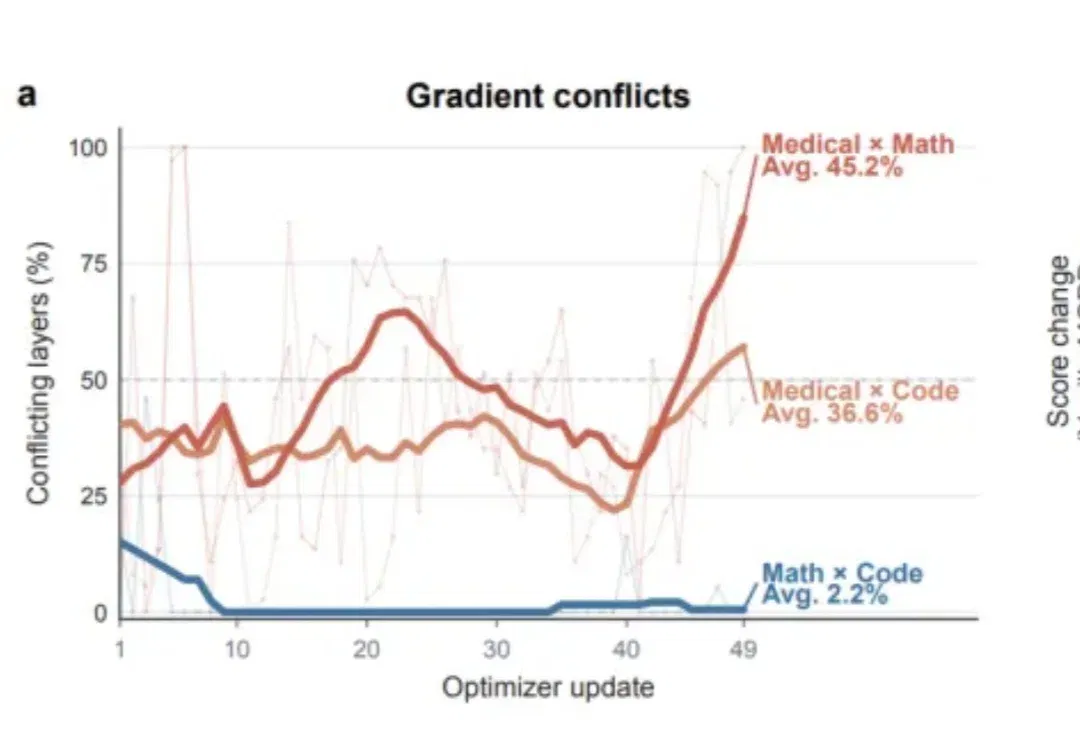
京东与南京大学提出 Road MOPD,在学生的同一份回答上收集多教师反馈,先调整 token 级监督,再削减冲突梯度并保留学习力度。Qwen3-4B 的数学、代码与医学文本基准显示联合训练收益;较小模型的部分领域仍有取舍。
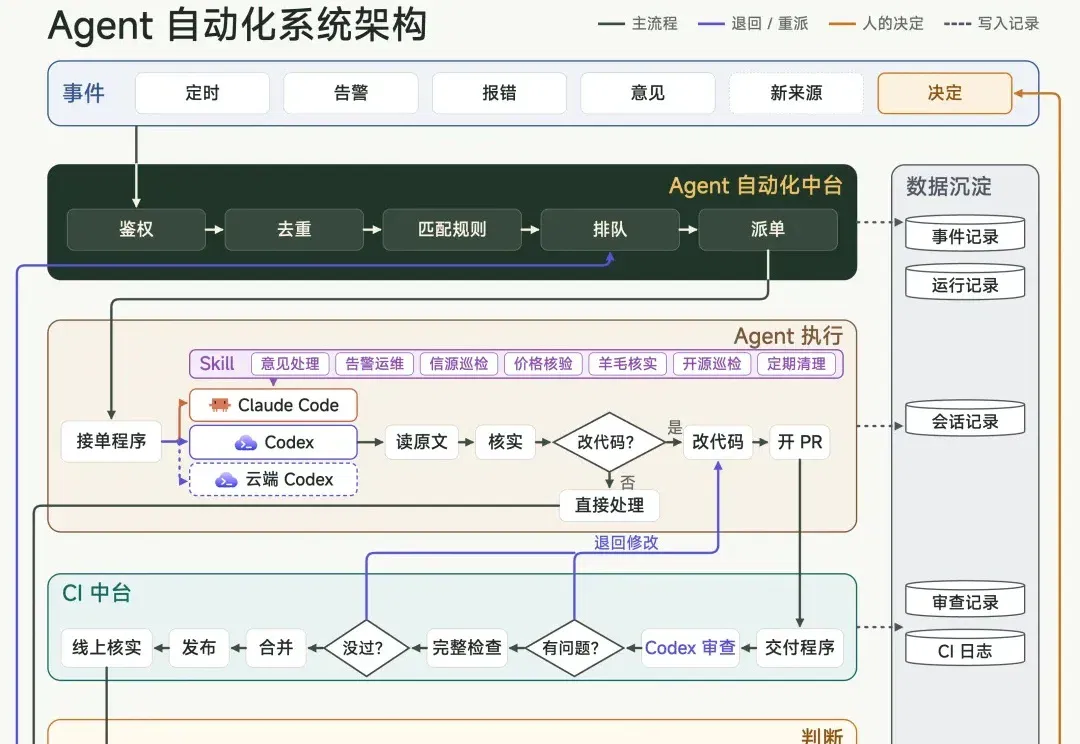
卡兹克分享个人搭建 Agent 自动化系统的经验:用事件和规则分派任务,在本地 Mac 上执行,通过独立的审查、测试与发布流程交付,再由飞书卡片承接需要人工决策的事项。文章同时讨论模型分工、成本和权限边界。
作者对谈 LobeHub 创始人,介绍团队如何让 Agent 承担分工、任务交接与汇报:拆分会话和执行环境,设置个人、项目主管与执行 Agent,再用开源 Acceptance 整理截图、录屏和检查结果,供人审核。文中也讨论职责边界与经验沉淀。
文章将 DeepSeek 的 Super-agent 设计与 AFK 团队 Comma 的公开工程记录作比较,讨论主会话路由、独立 Worker、执行环境分离及多端交互。提前实现和未来产品形态属于报道及团队判断,实际系统仍需检验长期上下文、权限隔离与任务协作。
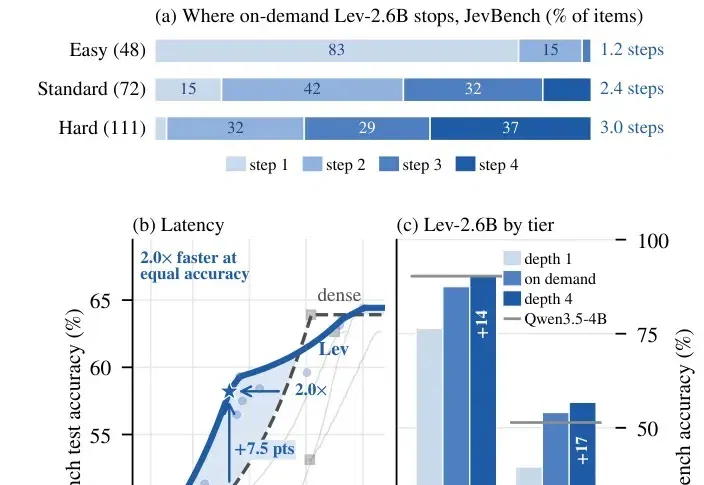
Lev 将循环深度作为决策模型的计算预算,同一份权重可在不同圈数读出选项概率,再用停止机制按请求分配深度。实验显示额外计算主要帮助较难任务,同时也会改错部分答案;离线节省的循环计算量仍需服务端调度才能转化为实际吞吐收益。
AWM 将交互环境中的观察写成可执行假设,再通过实验修订与 Lean 4 形式化,尝试在游戏中解释可行路径和无解条件。团队报告了 ARC-AGI-3 任务结果,同时指出证明依赖于已建模的规则,遗漏环境机制时仍需重新探索和验证。
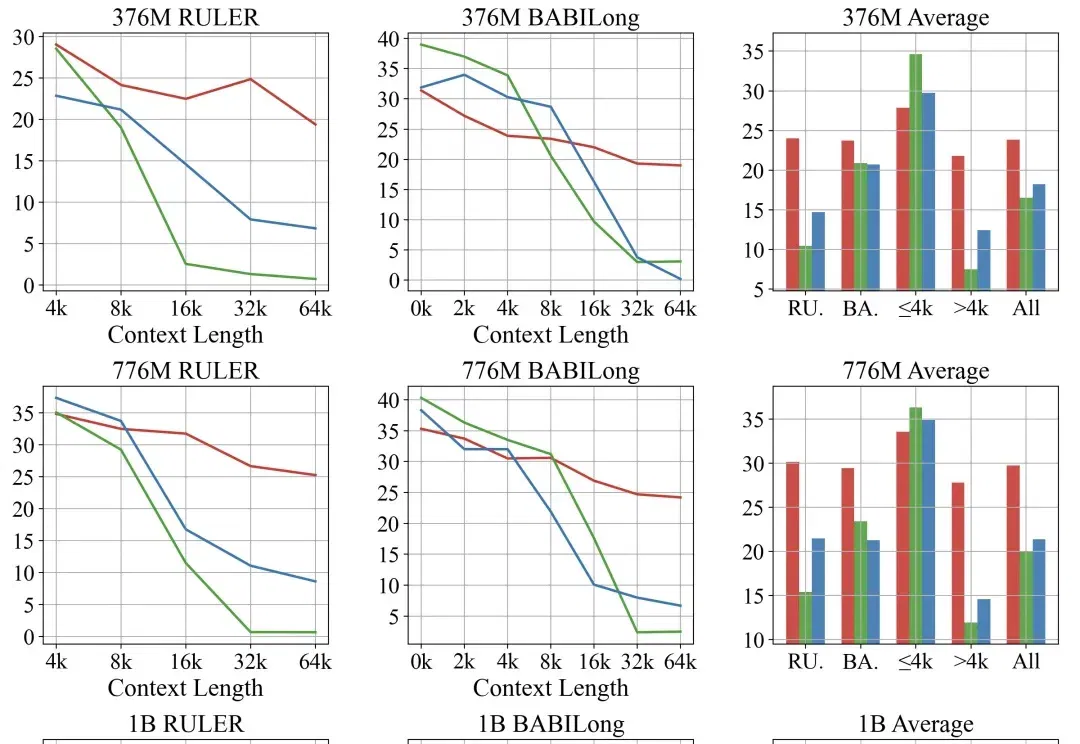
OpenMOSS 团队比较全注意力、滑窗和门控线性注意力在长文训练与长度外推中的配合。实验发现,无位置偏置的 NoPE 与带位置偏置模块各有分工;增大窗口、调整损失或限制推理时的相对位置范围,可分别改善不同架构的短板。
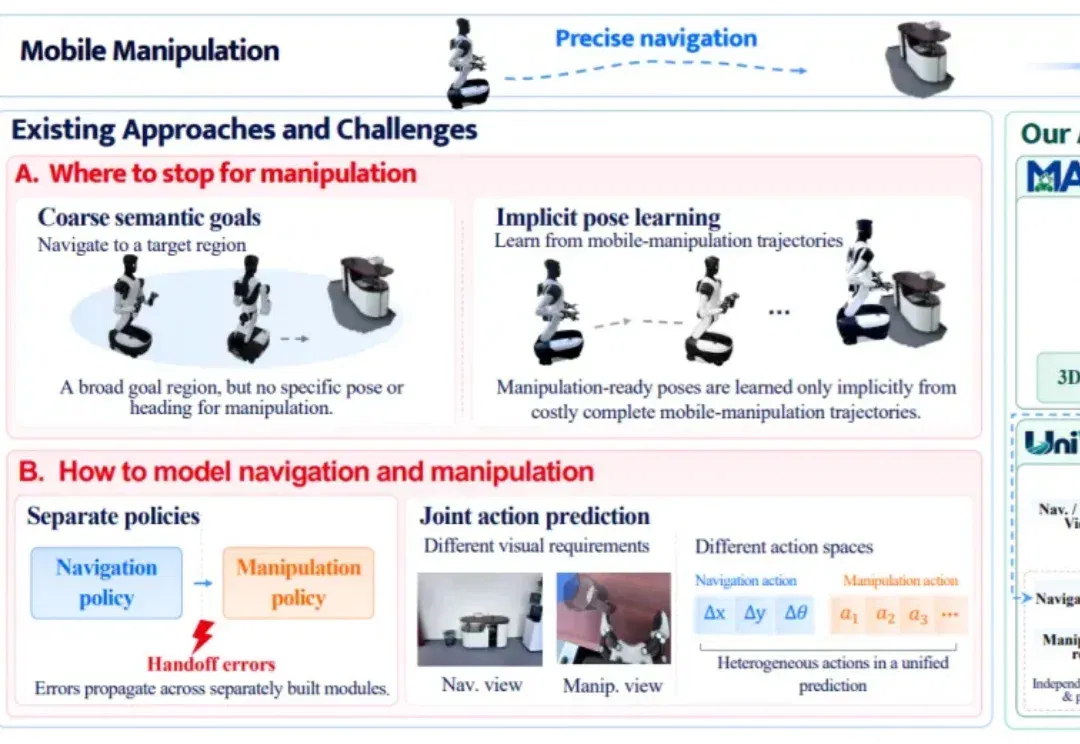
飞捷科思与复旦团队提出 Fysiverse-UniWAM,用操作锚定位姿 MAP 与共享骨干的双数据流连接导航和操作。团队构建150万余条生成轨迹,并在4种机器人平台的24项真机任务上报告停靠与操作表现,探索降低对完整移动操作示范的依赖。
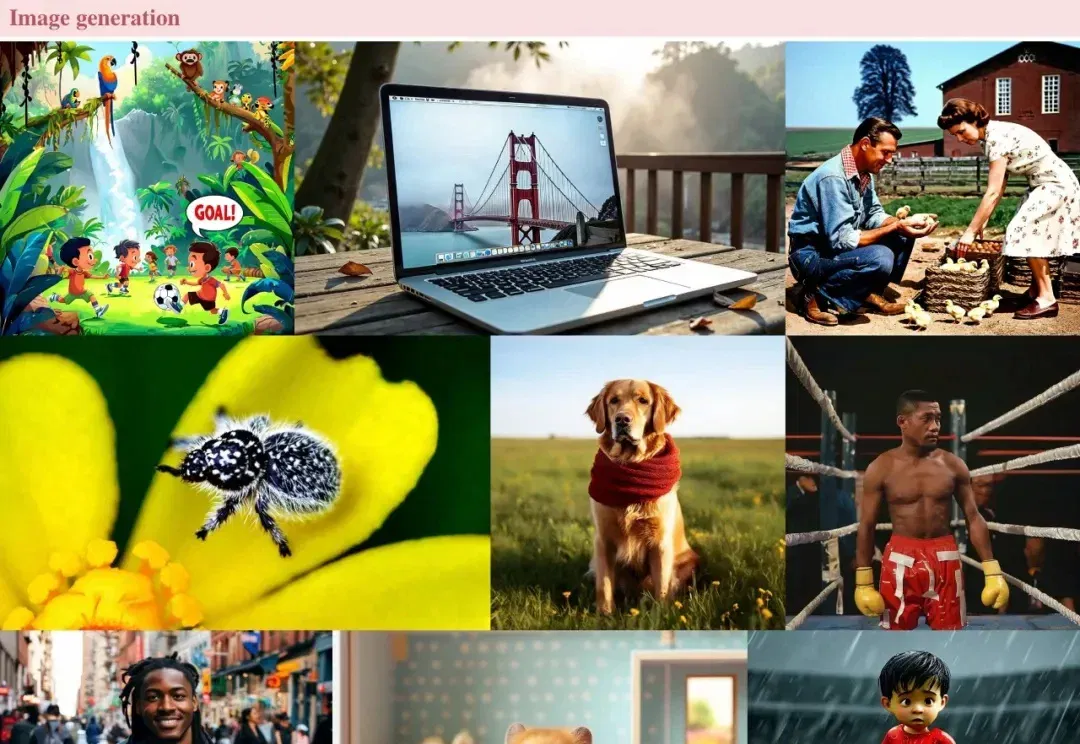
英伟达与滑铁卢大学提出 PixelUMM,以线性投影将图像块和视频时空块接入多模态主干,统一理解与生成而不使用 ViT、VAE。论文比较 patch 大小、输出头和训练规模等设计,报告了与基线相当的综合表现,也指出像素网格伪影等局限。
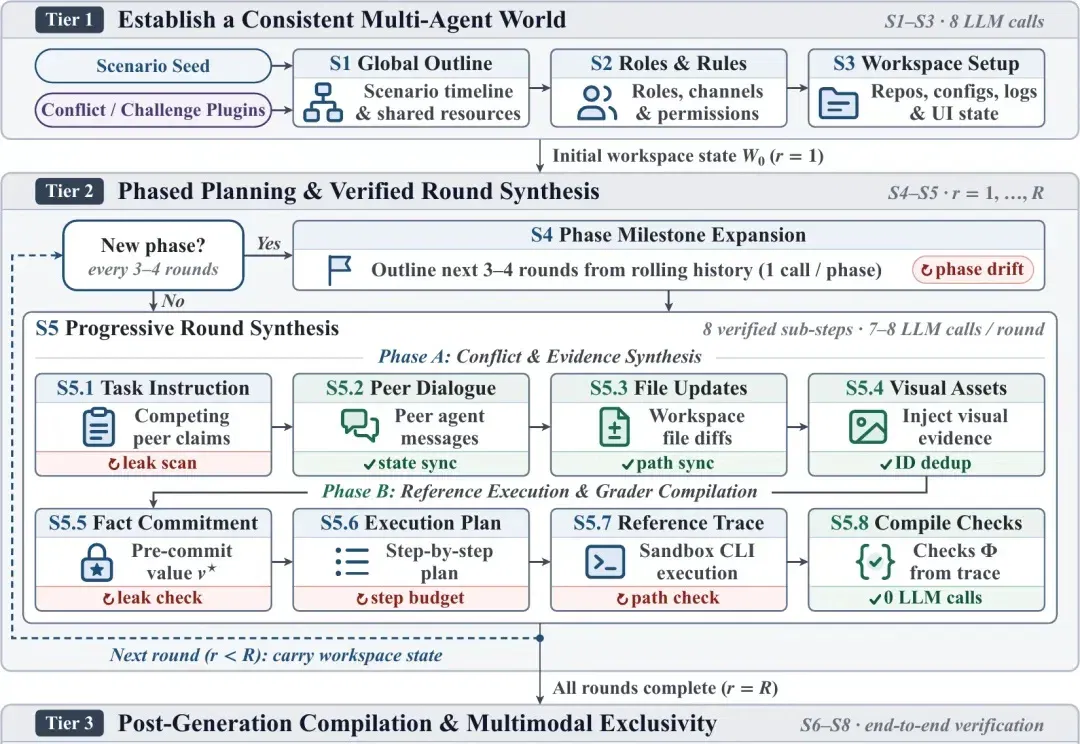
Google 等机构发布 CLASHarness,以600个可执行任务评测15个模型如何处理队友错误汇报、共享权限和文件冲突。研究显示,发现矛盾、真正修复系统和完成交接是不同难点;看图核实与合理的工具步数预算,对任务结果有明显影响。
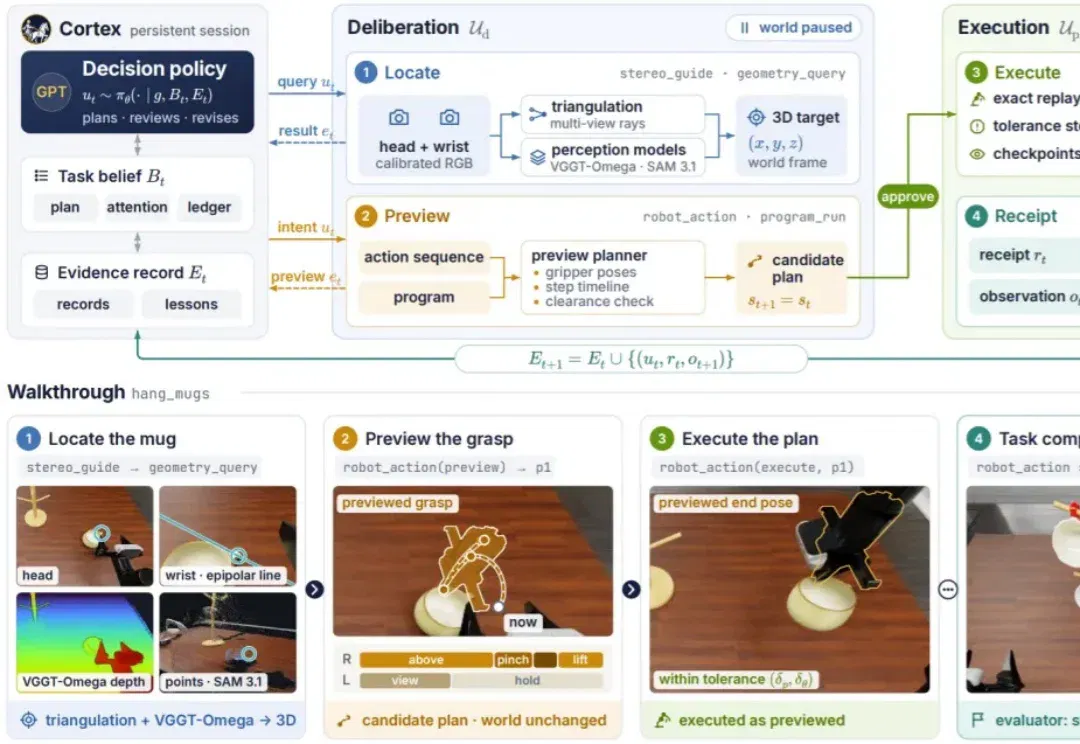
星衍智能介绍具身 Harness 框架 Auriga,以几何测量、动作预演、执行验证与失败记录支持机器人在线纠错。团队在 RoboDojo 和 RoboCasa365 仿真基准上采用固定系统评测,并讨论从人工推动的通用能力迭代走向自主改进的下一步。
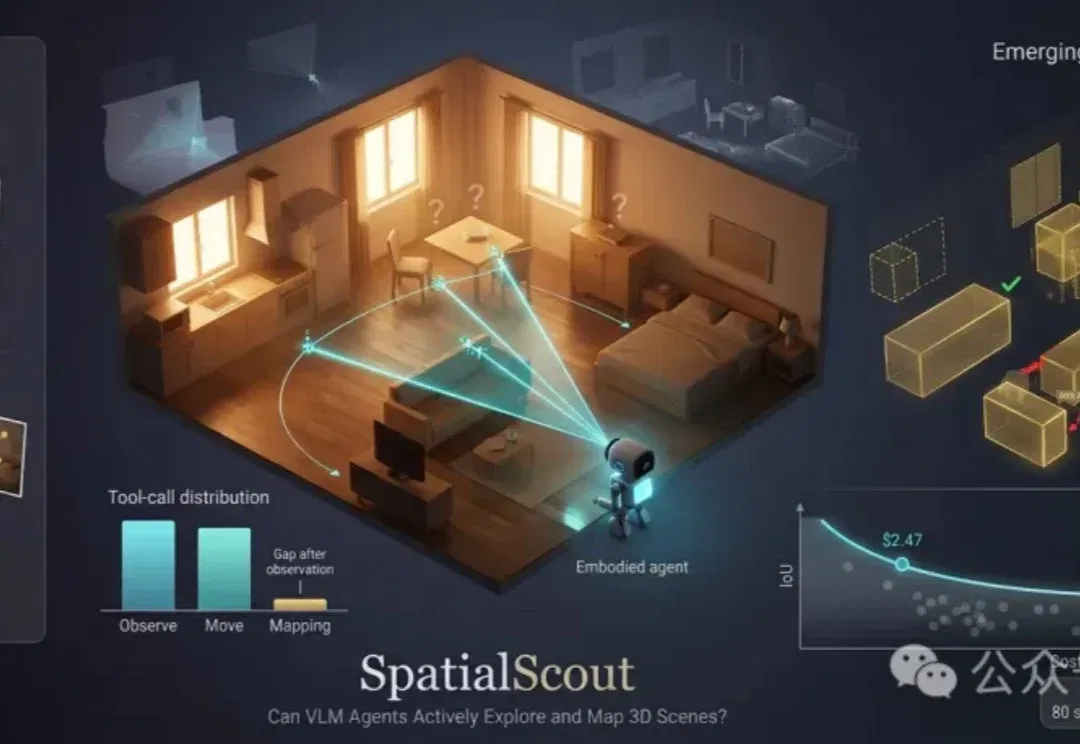
SpatialScout 用80个室内仿真场景评测智能体如何主动移动相机、关联多视角观测,并估计目标物体的三维位置。文章比较不同模型的定位质量与推理费用,指出观察次数增加并不自动改善建图,跨视角对应和几何工具使用仍是关键。
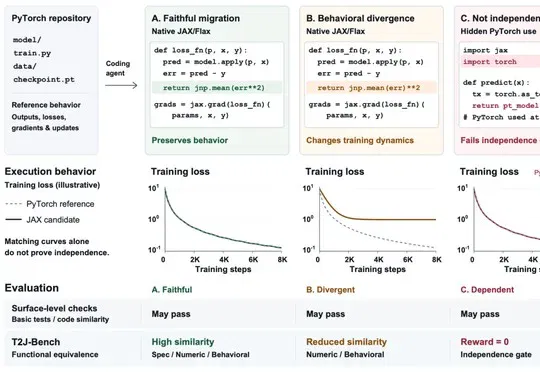
Google Cloud AI Research等团队发布T2J-Bench,以63个整仓任务评测Coding Agent将PyTorch迁移至JAX的行为保真度,并提出TwinHarness,使Claude-Code与opus-5组合的总体得分从0.649升至0.723,相对提升11.4%。
Join the conversation
Read how to join the community. No sign-in is required to read articles.