OpenDS-World 评测:复杂开放网络搜索中,最佳参评模型准确率为39%
多机构团队提出OpenDS任务范式并构建含200道任务的OpenDS-World评测基准,GPT-6 Astra以39.0%准确率居首,显示AI Agent在真实网络长程搜索与证据整合方面仍面临重大挑战。
近年来,随着大语言模型推理和使用工具的能力不断提升,Deep Search Agent 已具备一定的自主搜索与信息整合能力。越来越多的研究开始尝试让 Agent 自主规划搜索路径,处理需要跨越多个信息源的复杂问题。
但当 Deep Search 真正进入现实互联网,研究过程会变得复杂得多。
真实网络中的信息分散在不同网站和资源中,可能藏在视频的某一帧、播客中的语段对话、学术论文的图表,或是一份需要下载才能读取的数据文件里。即使已经找到了相关网站,Agent 也可能需要继续操作交互式页面、调整查询参数,才能获取真正需要的信息。
现有 Deep Search 研究已经在多轮检索、跨来源推理、工具调用和网页交互等多方面取得了不少的进展,相关 Benchmark 也从不同角度评估了这些能力。然而,面对多模态信息、异构资源格式与交互式访问需求交织的真实开放网络环境,当前 Agent 的端到端研究能力仍然缺乏充分评测。
这也带来了一个值得关注的问题:当证据的位置和获取方式都不预先给定,AI Agent 能否独立判断下一步应该查什么、去哪里查、怎样访问和处理,并根据现有信息调整搜索方向,串联不同来源的证据,最终查清一个复杂问题?
围绕这一问题,来自香港科技大学(广州)、复旦大学、华盛顿大学、帝国理工大学、斯坦福大学等多家机构的研究团队,在论文《Deep Search in Real-World Web Environments》中提出了新的深度搜索任务范式:OpenDS(Open-Web Deep Search),并构建了面向真实开放网络环境的评测基准OpenDS-World。
- 论文:Deep Search in Real-World Web Environments
- 论文链接:https://arxiv.org/pdf/2610.30181v1
- GitHub 链接:https://github.com/Yu-xm/OpenDS
- Hugging Face 链接:https://huggingface.co/datasets/Yu2020/OpenDS-World
团队构建了 200 道任务,覆盖 4 种模态、42 种资源格式和 7 类证据访问需求,给予 GPT-6 Astra、Claude Opus 5.5、Gemini 3.8 Flash、Qwen3.8 Max、GLM-5.3 Flash、DeepSeek V4.1-Flash、Kimi K3 等 12 个前沿模型同一套搜索、浏览器和视频相关工具,同时限制每题 1 小时搜索时间、100 次工具调用,让它们自行决定搜索过程,串联证据,并最终给出问题的答案。
200 道题做下来,表现最好的 GPT-6 Astra 准确率也只有 39%,Claude Opus 5.5 和 Gemini 3.8 Flash 仅仅取得了 38.0% 和 36.5% 的成绩,其他模型的准确率更是不足 35%。值得关注的是,尽管平均每道题人工标注并审核的来源条目只有 3.94,模型的一次搜索尝试却包含几十甚至接近一百次工具调用。搜索过程的失败也相当耗时:在 GPT-6 Astra 的执行记录中,失败调用仅占 6.34%,却消耗了 42.57% 的工具执行时间。在真实网络中,模型需要投入大量时间寻找信息源、尝试不同的访问方式,并处理搜索过程中遇到的失败。
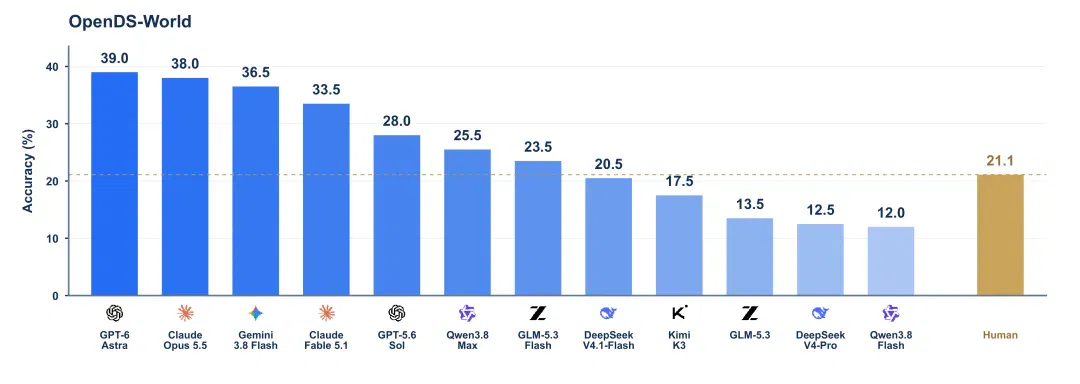
图 1:12 个模型在 OpenDS-World 上的表现。人类成绩来自独立求解实验。
在深度搜索中,我们希望模型完成什么?
查资料的人都熟悉这种过程:最初只有一个感兴趣的模糊对象,搜到一篇介绍后,才知道还要去找哪篇报告,报告里的一张图又把问题引向另一组数据。搜索越深入,下一步要做的事情才越明确。
Deep Search 希望让 Agent 能够自主完成这样的搜索。OpenDS 关注的是,当这一过程发生在真实开放网络环境中,Agent 能否自主发现和访问分散在不同来源中的信息,处理多样的资源格式与交互要求,并利用不断获得的新线索决定后续搜索方向。
这种自主决策在实际的信息访问过程中就有具体体现。即使找到了相关网站,Agent 往往还需要经过多步操作才能取得目标信息。论文以一个页面为例:同一个页面上既有文字、地图和图表,也提供 CSV、JSON 和 ZIP 等数据资源。要查询某个地区在特定年份的数值,Agent 可能需要选择地区、调整时间,再读取图表,或者通过数据接口和文件下载获取信
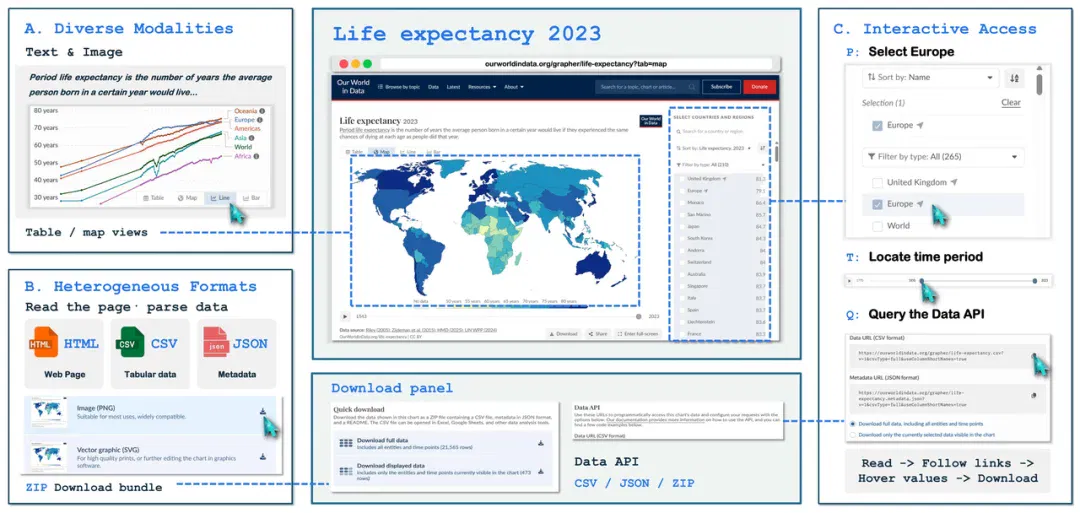
图 2:同一网站可以同时包含文字与图表、多种数据格式,以及参数选择、时间定位和数据查询等操作。
不同信息源又有各自的访问和处理要求。视频里的线索需要定位到具体片段,论文中的证据可能藏在图表中,数据文件则需要找到目标记录和字段。即使都储存文本数据,HTML、PDF、Parquet 的读取方式也不尽相同。
论文将这些差异归纳为三个维度:多样的模态信息(Diverse Modalities)、异构资源格式(Heterogeneous Formats)、交互式证据访问(Interactive Access Requirements)。模态描述证据以文本、图像、音频还是视频呈现;格式描述它被存放在怎样的文件和数据结构中;访问要求则描述取得它需要执行哪些操作。
这三个维度在一次搜索中以不同的形式组合。模型从视频中识别出来的对象,可以成为检索论文的关键词;论文里的新线索又可能需要在另一个网站上查询。每一步都要把已经取得的证据用于下一步行动。
OpenDS 将这一过程定义为具有唯一、可验证答案的事实问答任务。模型在拿到问题以及初始线索之后,需要自行发现、访问、处理并关联每一步的证据,最后给出答案。这样一来,搜索过程中保留了真实开放网络的复杂性,重点又有明确的核验标准。
怎样把真实网络搜索变成一道题?
从真实开放网络中构建既具有可靠的事实依据,又真正需要模型逐步探索才能解答的问题,必须先解决两个问题:证据链上的每个节点及其关联都必须有真实、可验证的依据;且最终问题不能直接暴露中间实体或答案,让模型仅凭借问题线索就能找到终点。
OpenDS-World 采用了「先构建证据链,再反向生成问题」的方式,将任务构建分为三个阶段:
首先是确定搜索起点(Real-World Anchor),研究团队从文化、日常生活、科学、经济、历史、自然、社会和技术八个领域选取了 500 个候选视频。标注人员结合连续视频画面和音频内容,识别其中具有明确指向的初始实体,并确保其能够唯一对应一个有效的 Wikidata 条目。这里还有一个特别的限制:初始实体必须依靠视频中的视听信息才能确定,不能直接通过视频页面上的文字提取。这样的方式确保模型需要真正理解视频内容,才能获得后续任务的起始线索。用于任务的起始视频会被归档,作为基准输入提供。
确认起点后,进入开放网络证据扩展(Open-Web Evidence Expansion)阶段。标注人员根据当前实体构造查询,通过 Google Search 搜索真实网络中的候选信息源并逐一检查其内容,再从中选择具有明确语义关联且可以核验的来源,并以从中提取新的实体作为下一步搜索的节点。整个扩展过程尤其强调证据之间的可靠关联。每个新节点虽然来自某个特定来源,但其有效性需要通过多个独立来源交叉验证。相邻节点之间的关系也必须有明确的事实依据。与此同时,标注人员还会考虑信息模态、资源格式和访问方式的多样性,确保证据路径能够覆盖真实网络中不同的信息获取需求。这一过程不断重复,直到找到一个唯一、稳定、适合作为最终答案的实体。
最后是反向构建问题(Question Inversion),直到这时问题才被写出来。研究团队将证据链的终点设置为参考答案,再将确定的中间实体转化为一组互相依赖的间接描述和约束。
例如题目不会直接给出某个博物馆展品的名称,而是要求先根据视频确定生物,再找到相应馆藏,并从指定展柜中识别目标化石。前一步的发现为后一步提供必要线索,各项约束逐步缩小候选范围,最终共同确定唯一答案
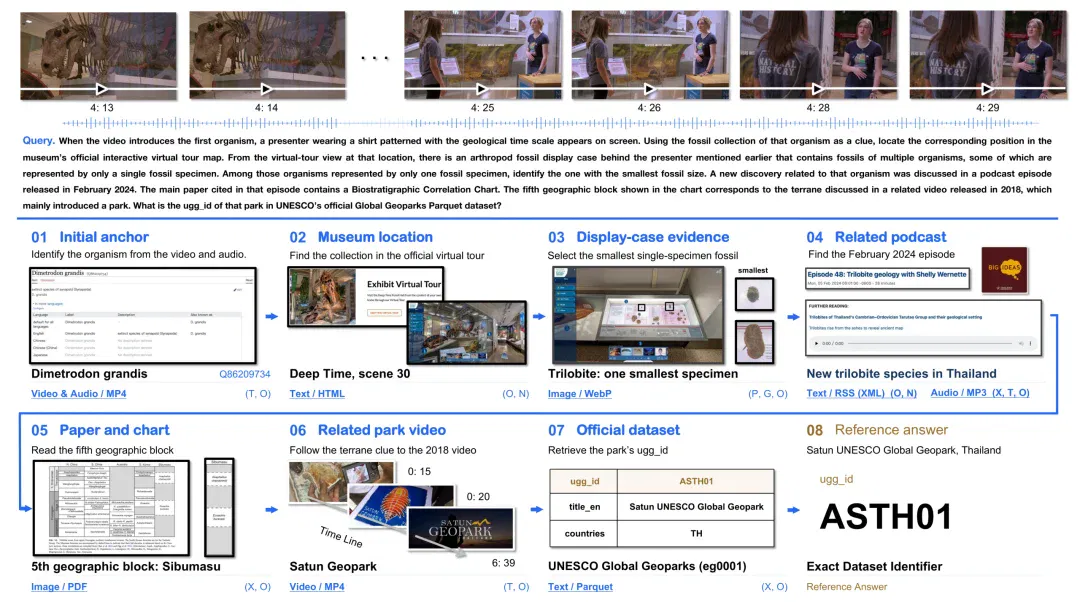
图 3:OpenDS-World 中的一个例子。这个问题将视听识别、虚拟旅游导航、文档检查和跨多个网络来源的结构化数据检索联系起来。从初始视频出发,经过博物馆虚拟导览、播客、学术论文和结构化数据集等多个来源,最终确定 UNESCO 地质公园的唯一编号。
这样的设计让模型无法仅凭题目中某个直接给出的实体名称检索最终答案,而需要逐步确定中间对象之间的对应关系,在真实网络中展开搜索。
完成题目构建后,研究团队还组织了共 10 名独立审核者,对候选任务开展两方面的验证:
- 证据有效性(Evidence Validity):检查初始实体、中间节点、节点之间的关系及最终答案是否具有真实、可核验的依据,并通过多个独立网络来源交叉验证。
- 任务有效性(Task Validity):检查问题表述是否清晰、各项约束是否准确且一致,以及这些约束能否共同确定唯一的事实答案。
存在事实错误、证据不足、约束冲突或答案歧义的候选任务会被剔除,最终形成 200 道具有明确参考答案和可核验证据路径的任务。
从单道任务来看,在不计单独提供的起始视频的情况下,82.5% 的题目涉及至少两种信息模态,96.0% 涉及至少两种资源格式,95.5% 涉及至少两类访问操作。其中 67.0% 的任务涉及页面或内容跳转,60.0% 涉及资源传输,47.5% 需要时间定位,42.0% 涉及参数化状态更新。模型在同一项研究任务中,往往需要连续处理不同类型的信息与访问操作。
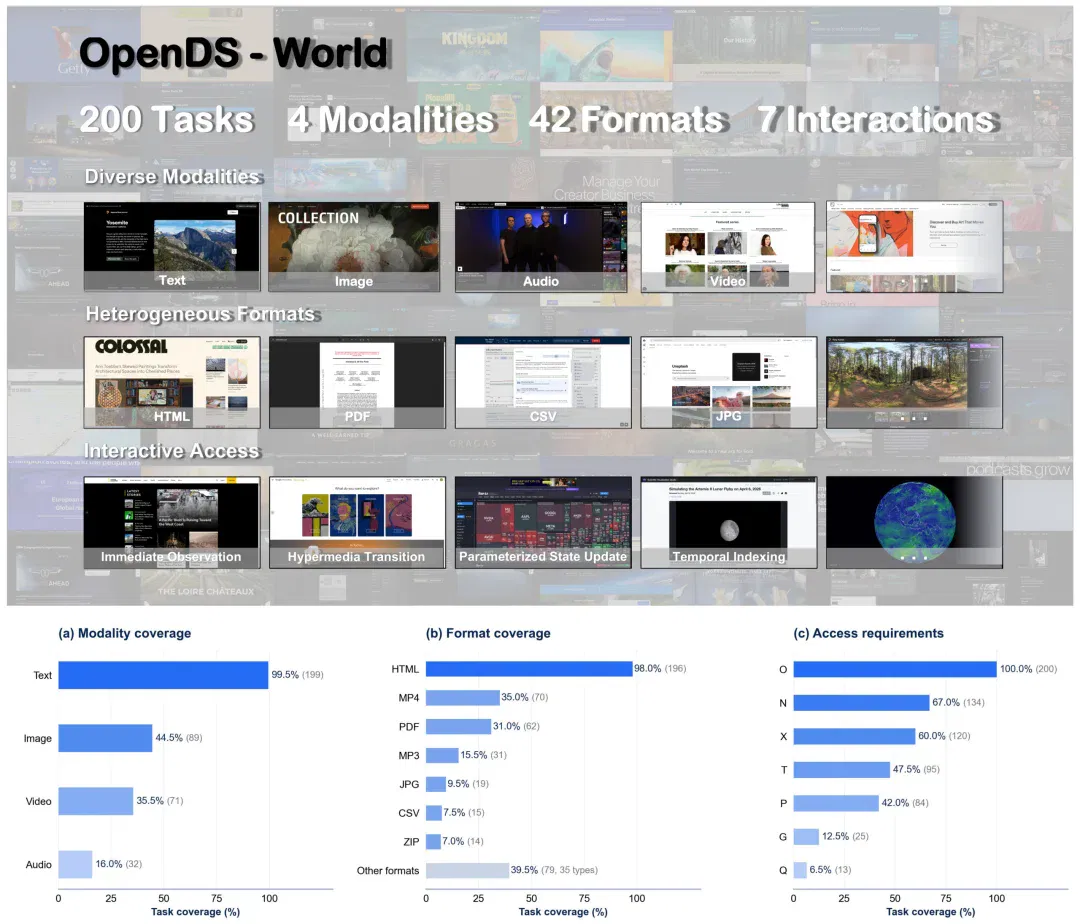
图 4:OpenDS-World 的信息模态、资源格式与访问需求分布。不同类别可以在同一任务中重叠出现,统计不包含单独提供的起始视频。
人类花了多久?模型又答对多少?
为了了解从头找出答案的实际难度,团队组织了 50 名参与者进行独立求解。每人分配 20 道题,每道题由 5 人分别尝试,共得到 1,000 次作答。
参与者只能拿到原始视频和题目,不能使用 LLM 工具,只能使用常规浏览器与搜索,并且不能互相交流。对人类的测试不设置统一的单题时间上限,参与者在认为无法继续取得有效进展的时候,可以结束尝试。
这 1,000 次作答一共投入约 646 小时,最终只有 211 次作答得到正确答案。200 道题中,只有 115 道至少被一人解出,有 85 道在五次独立尝试中均未被解出;只有 29 道题被至少三人答对。
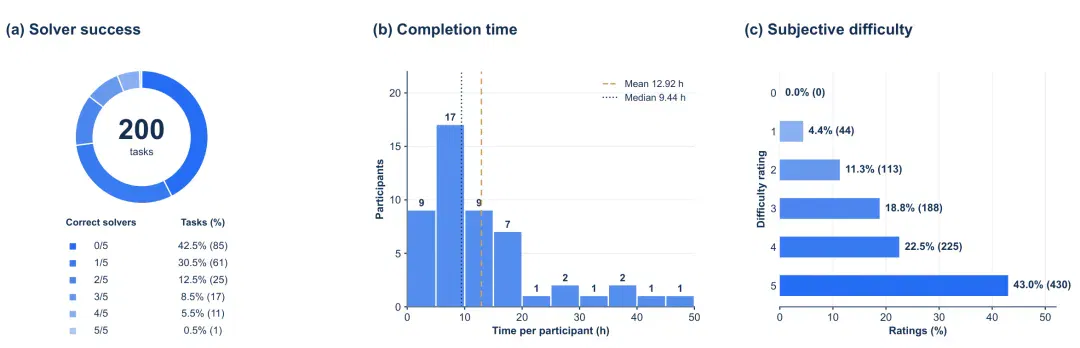
图 5:人类独立求解的成功情况、耗时和主观难度。中间一图统计每名参与者完成其分配的 20 道题所用的总时间。
研究团队据此划分任务难度:至少两人答对的 54 题为 Low,恰好一人答对的 61 题为 Medium,五人均未答对的 85 题为 High。并以此分层评价模型的答题能力。
对于模型的评价则使用统一的 Harness:16 个工具提供搜索(Search)、浏览器交互(GUI)以及视频与字幕读取能力(Other),这些工具支持网页点击、输入、滚动、截图、下载内容以及视频片段检查。所有 12 个模型使用相同的配置,自行选择信息源和操作顺序。
不同于人类作答不设时间上限,模型被最多允许 3,600 秒搜索时间、100 次工具调用。这两个预算任一耗尽后停止继续搜索。若尚未形成完整答案,系统则进入禁用工具的收尾阶段,让模型根据已有证据作答。作答完成后,Qwen3.8-27B 被用于对照参考答案,检查语义等价性与完整性,评测框架同时记录任务耗时以及 token 消
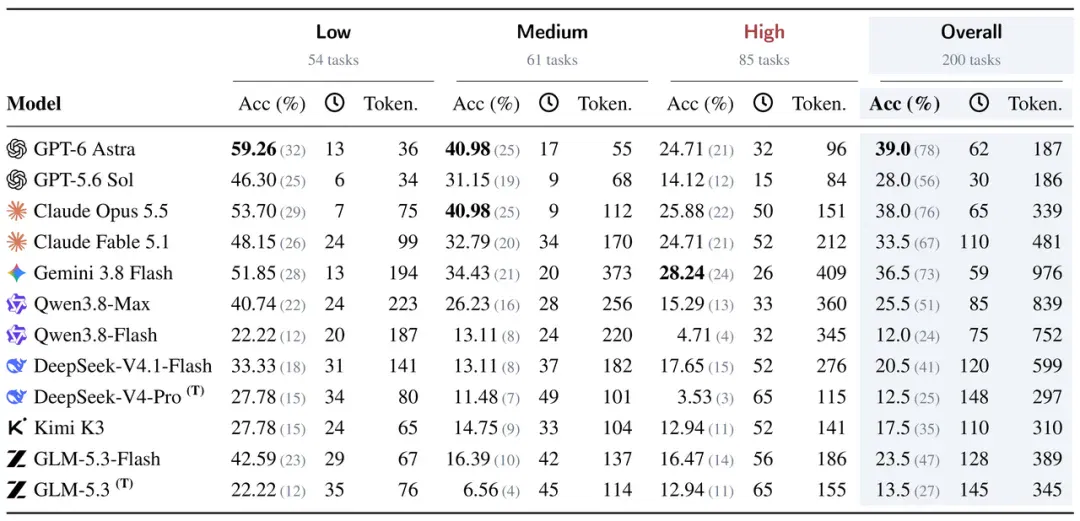
图 6:12 个参评模型的总体成绩及不同难度下的表现。括号内为答对题数,T 表示纯文本模型。
整体来看,12 个模型在 OpenDS-World 上的表现仍有较大差距。GPT-6 Astra 以 39.0% 的准确率位居第一,Claude Opus 5.5 和 Gemini 3.8 Flash 分别以 38.0% 和 36.5% 紧随其后,其余模型的准确率则分布在 12.0%—33.5% 之间。
随着任务难度增加,模型的整体表现明显下降。12 个模型在 Low、Medium 和 High 三个难度组上的平均准确率分别为 39.66%、23.50% 和 16.76%。不同模型的优势也有所变化:GPT-6 Astra 在低难度组领先,在中等难度组与 Claude Opus 5.5 并列第一;而在五名人类参与者均未成功解答的高难度组中,Gemini 3.8 Flash 以 28.24% 的准确率取得最高成绩。
参考路径很短,实际搜索很长
有了成绩,接下来需要深入分析的问题是:这些任务具体难在什么地方?
正如我们开篇提到的,平均每道题人工标注并审核的来源条目只有 3.94,模型的一次搜索尝试却包含几十甚至接近一百次工具调用。哪怕只设计三条标注来源,工具调用的中位数也达到了 74 次。
事后回看,OpenDS-World 的任务呈现出明显的长程决策(Long-Horizon Decision-Making)特征。模型需要在初始视频中识别线索,通过反复搜索、跨页面导航、交互式访问以及多模态信息处理的方式,逐步找到并关联分散在真实网络中的证据。同一来源也可能需要多步操作:进入网站、找到入口、设置参数和读取结果,各自都占用工具调用。沿途还会出现不相关的候选来源、无法完成的操作,以及需要回头核实的线索。这样一来,即使最终只涉及少量关键来源,发现和获取这些证据也可能需要大量的探索与交互。
研究团队分析发现,执行长度并不随着证据链规模单调增加。包含 3、4、5 条以及至少 6 条标注来源的任务,工具调用的中位数分别为 74、56、72 和 82.5 次。参考证据链更长,并不意味着实际搜索就一定需要更多操作
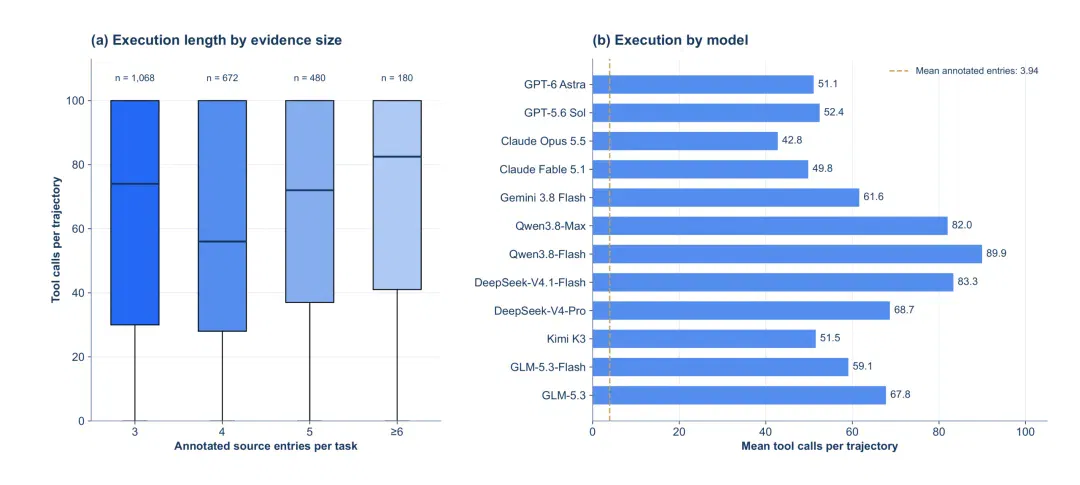
图 7:不同证据链规模对应的工具调用分布,以及各模型的平均执行长度。虚线表示每题平均 3.94 条标注来源记录。
证据链的长度描述了答案由哪些材料支持,搜索轨迹则记录了 Agent 发现、访问和关联这些信息所经历的探索过程。OpenDS-World 将两者结合起来分析,揭示了单纯依靠证据链长度或推理跳数难以充分衡量的执行复杂度,也凸显了长程规划、上下文管理和自适应工具使用在真实网络研究中的重要性。
时间和工具用在了哪里?
不同模型在相同环境下,展现了明显不同的搜索投入和工具使用策略。
GPT-6 Astra 平均每题调用工具 51.05 次,耗时 18.66 分钟,准确率为 39.0%;GPT-5.6 Sol 的调用次数与其接近,平均耗时仅 8.99 分钟,准确率为 28.0%。Gemini 3.8 Flash 的总 Token 消耗约为 GPT-6 Astra 的 5.22 倍,准确率为 36.5%。更多的工具调用、更长的执行时间和更高的 Token 消耗,并不一定带来更好的搜索表现。
模型之间的差异同样明显。GPT-5.6 Sol 最倾向于使用搜索工具,占其全部调用的 74.5%;Claude Opus 5.5 和 Qwen3.8-Flash 则更依赖浏览器交互,GUI 调用占比分别为 51.5% 和 49.4%,两者准确率却呈现出 26 个百分点的差距。
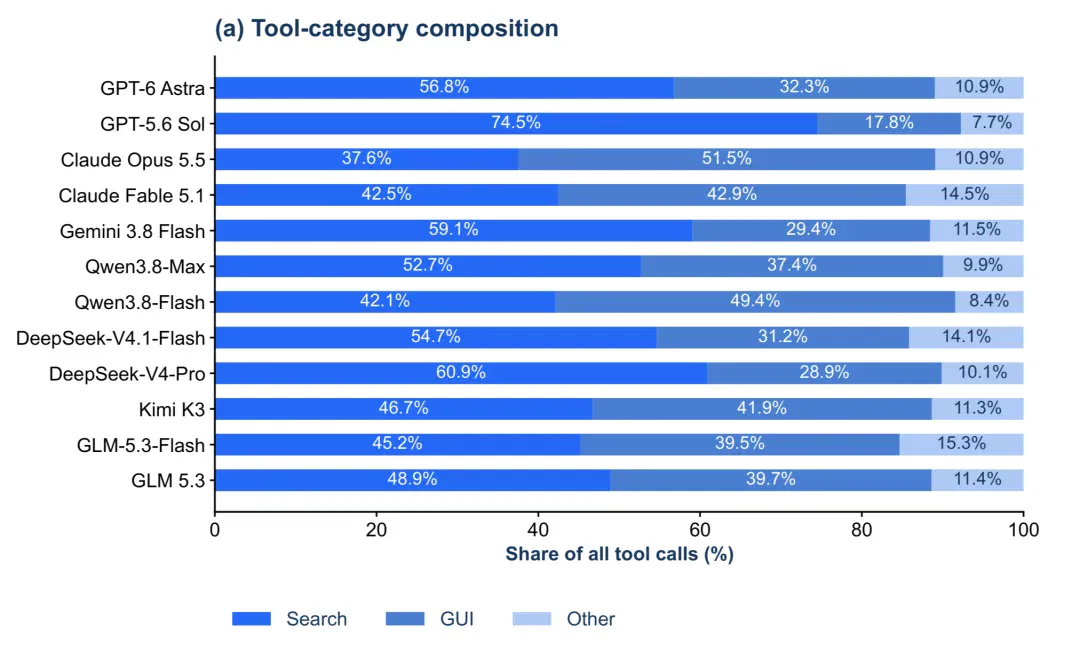
图8. 不同模型工具使用分布
研究还发现模型的工具调用还呈现出明显的同类操作连续执行现象。例如,Gemini 3.8 Flash 的 Search → Search 转移比例达到 84.6%,Qwen3.8-Flash 的 GUI → GUI 转移比例则达到 85%。
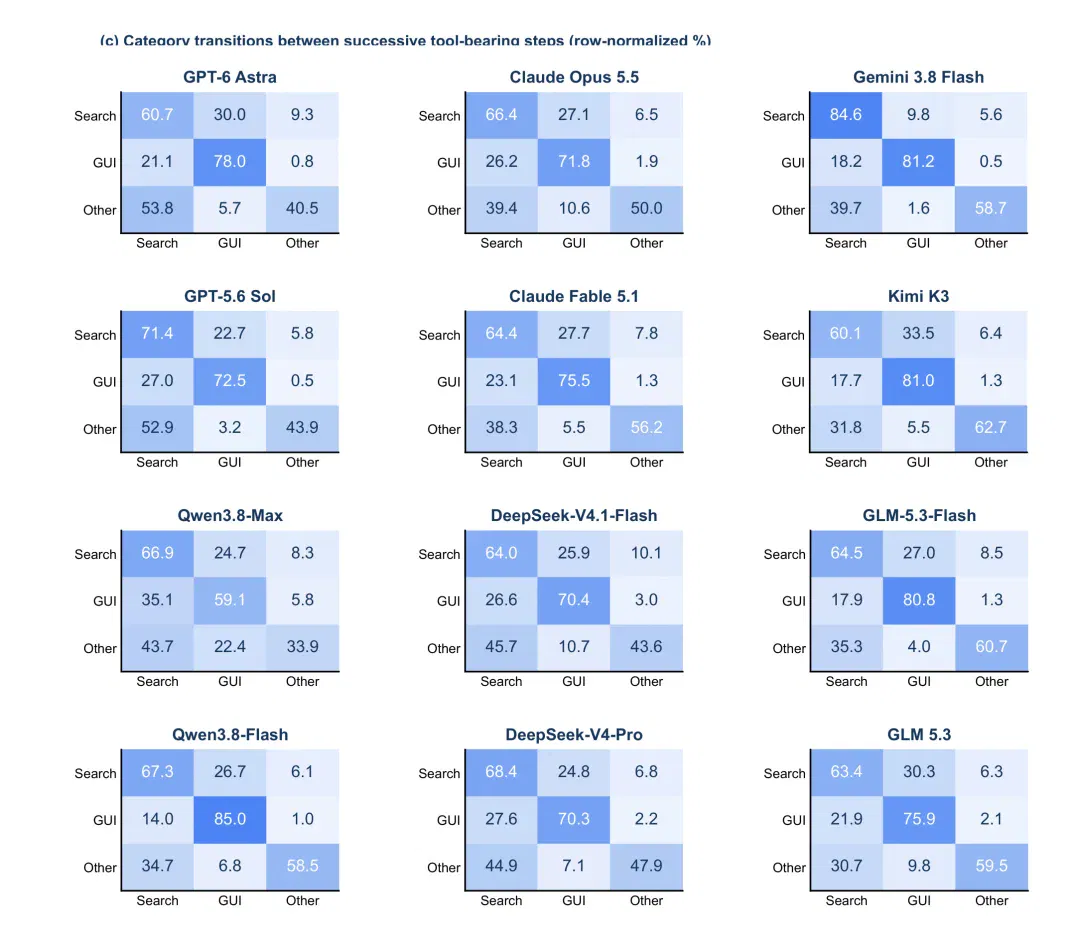
图9. 不同模型相邻工具调用之间的类别转移
根据这些结果论文指出,工具使用频率和类别分布并不能充分解释模型的性能差异。在真实 Deep Search 中,有效协调搜索、网页交互与信息处理,并充分利用获取的证据,是影响任务表现的重要因素。
失败调用的影响
深入执行记录,团队发现了一项容易被次数掩盖的开销:工具失败。
各模型失败调用的占比为2.83% ~ 9.42%,对应的耗时却达到累计工具执行时间的19.27% ~ 61.90%。以 GPT-6 Astra 为例,6.34% 的调用失败,占用了 42.57% 的工具执行时间。
在这么一项不仅限制工具调用次数,还限制时间的任务里,即使调用失败的次数较少,高昂的时间损耗却直接挤占了后续探索的空间。如何减少无效操作、提高失败恢复效率,也就成为了值得关注的具体优化方向。
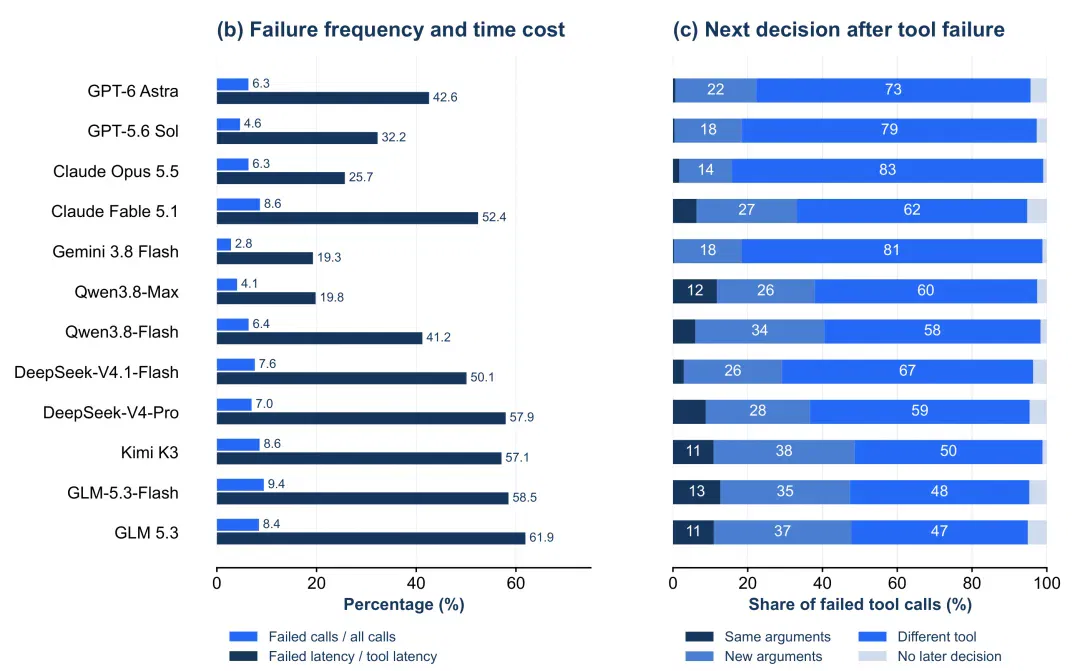
图10. 模型的失败调用的频率与耗时,以及失败后的下一步选择。
论文还分析了模型在工具失败后的决策。直接切换工具是大多数模型最常见的选择。Claude Opus 5.5、Gemini 3.8 Flash 和 GPT-5.6 Sol 在失败后切换工具的比例分别约为 83%、81% 和 79%;Kimi K3 与 GLM 5.3 则有更高比例选择在同一工具上修改参数重试,分别约为 38% 和 37%。
搜索结束时,真的查清了吗?
对于 Deep Search Agent 来说,什么时候结束搜索,同样是一项重要决策。模型既需要在有限预算内完成研究,也要判断当前获取的信息是否足以回答问题。
OpenDS-World 将模型提交完整、非空答案,且不再请求工具记为自然结束。GPT-6 Astra 在69.0%的任务中能够自然结束搜索阶段,但其最终准确率仅为39.0%。模型能够主动结束搜索,并不等同于它已经获得了充分且正确的证据。
另一种情况是,模型持续操作,直到预算用完。Qwen3.8-Flash 有 80.0% 的任务因达到调用上限而终止,DeepSeek-V4.1-Flash 的这一比例为 60.5%;GLM-5.3 则有 41.0% 的任务仅触及时间上限,未抵达工具调用上限。不同模型面临的主要预算限制也存在明显差异。
即使是预算耗尽比例相对较低的 GPT-6 Astra 和 Claude Opus 5.5,总体准确率仍低于 40%。
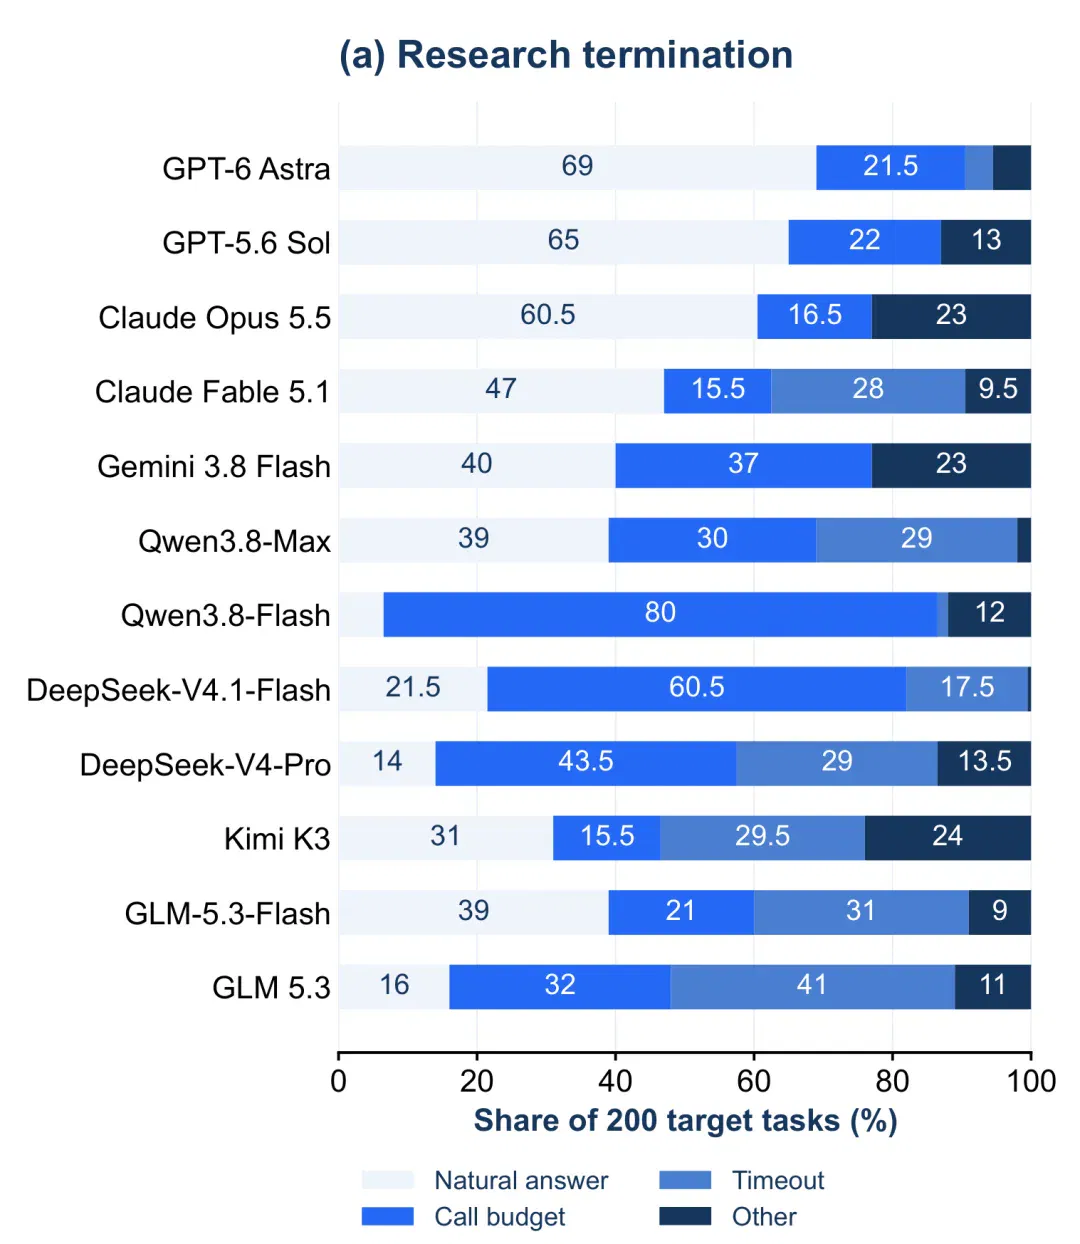
图11. 模型终止搜索的原因
OpenDS-World 由此揭示了真实网络深度搜索中的两项核心挑战:如何在有限预算内完成搜索,以及如何在搜索结束时给出正确答案。除了提高执行效率,有效的信息源选择、证据整合和搜索停止决策,同样是提升 Agent 研究能力的重要方向。
下一步,从搜索经历中不断改进
一次深度搜索结束后,Agent 会留下完整的执行轨迹,包括工具调用、交互反馈、失败操作和资源消耗。这些来自真实网络环境的反馈,为改进 Agent 的搜索策略提供了具体的研究切入点。
正如论文在讨论部分中提出,OpenDS-World 可以成为研究递归式自我改进(Recursive Self-Improvement,RSI)的天然实验环境。
例如,面对反复失败的网页操作,Agent 能否从历史轨迹中识别问题,调整工具选择与恢复策略?面对复杂的长程搜索任务,它能否总结更有效的信息源发现和资源分配方法,在有限预算内取得更好的结果?
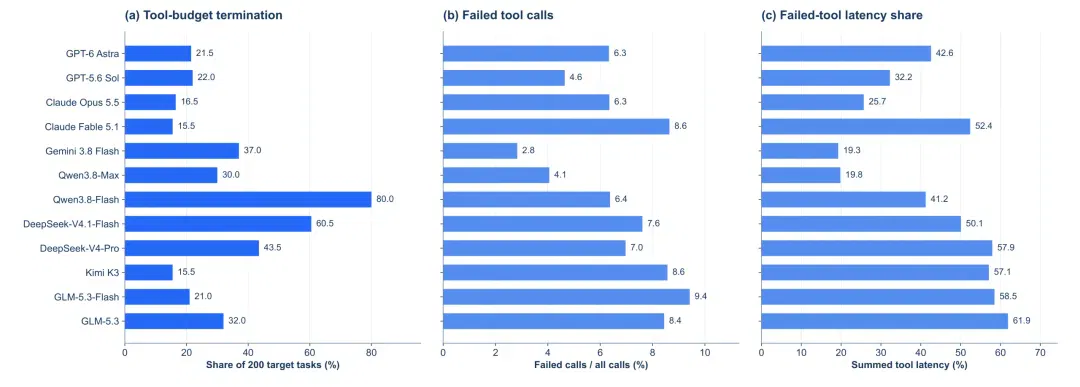
图12. 不同模型的工具调用预算耗尽情况、工具失败率及失败耗时占比,呈现了 Agent 执行策略中潜在的改进空间。
真实互联网中的搜索结果、网页结构和资源状态始终在变化。Agent 需要逐步形成能够适应不同信息源、访问机制和任务需求的研究策略,并通过新任务中的实际反馈检验其有效性。
OpenDS-World 将真实开放网络中的复杂搜索任务、可验证的结果反馈和完整的执行轨迹结合起来,为研究 Agent 的搜索、交互与长程决策优化提供了基础。
当 Agent 已经能够独立开展复杂网络搜索,如何在一次次真实交互中积累,并将这些经验转化为应对新任务时更可靠的能力,或许正是下一阶段 AI Agent 需要跨越的重要门槛。
文章来自于微信公众号 “机器之心”,作者 “机器之心”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
蚂蚁与西湖心辰介绍Duo v1,探索全双工视听交互 (opens in a new tab)
Duo v1通过Intent与Realization模块衔接交互决策和音视频生成。文章报告30组交互、180项检查中通过168项,内容响应度为73.3%;复杂意图理解与长程一致性仍是团队后续优化方向。
EgoExplorer captures mobile manipulation with five trackers and a camera (opens in a new tab)
Shanghai AI Lab presents a wearable capture system using trackers, gloves and a camera, plus C³ motion reconstruction, and releases 100 hours of data and code. Reconstruction and multimodal generation are assessed separately; humanoid transfer is shown only in simulation.

ConvexLLM connects speech to language models through frozen text embeddings (opens in a new tab)
Researchers at CUHK-Shenzhen and Microsoft propose C-Gate, mapping audio into convex combinations of frozen text embeddings. The paper reports VoiceBench gains against its listed open-model baselines, while audio understanding and transcription still involve trade-offs.

CWM2.0 open-sources generative rendering with a 30-minute racing demo (opens in a new tab)
Teams from Ant, Westlake University and Zhejiang University use a structured Proxy to control scene state and Invoker-Render to generate visuals, releasing eight-GPU streaming inference. The long demo and 140 evaluations cover specified scenes, not arbitrary stable worlds.

openJiuwen presents a Harnessless approach for reusing AgentOS execution tools (opens in a new tab)
openJiuwen uses app-development and swarm demos to show how built-in harness capabilities support sessions, tools and app management. Applications still define business rules and permissions; remote deployment and some capabilities remain planned or exploratory.