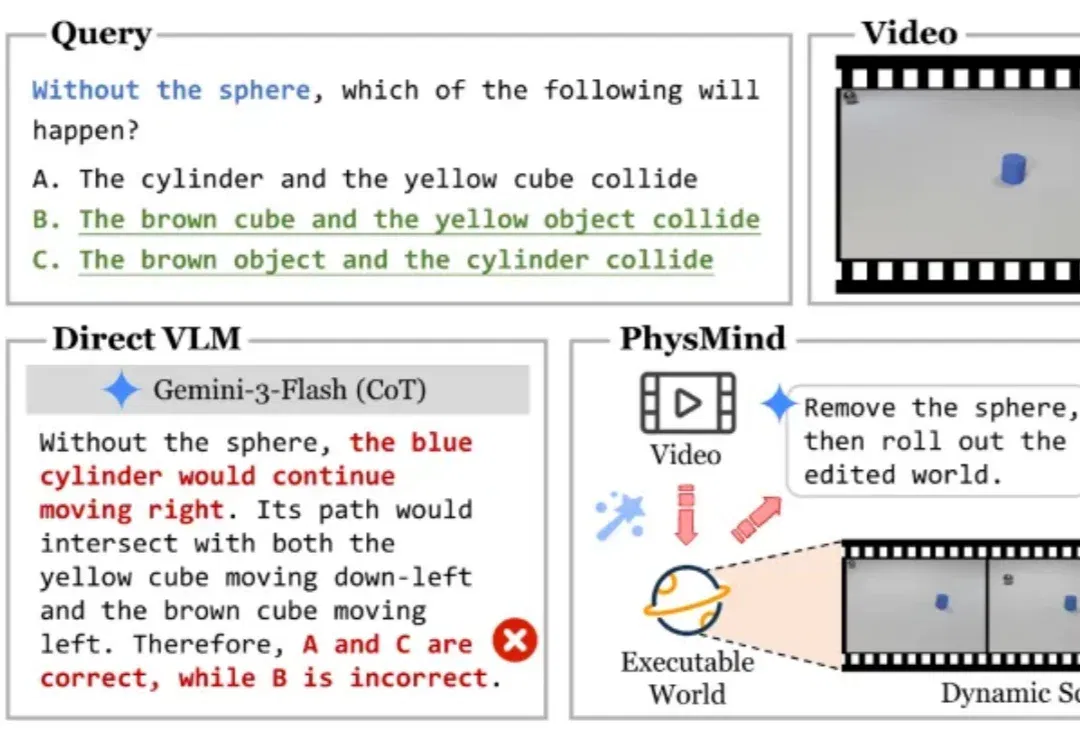
清华 Asking the World 从视频重建仿真环境,检验物理推理 (opens in a new tab)
Asking the World 让模型从视频重建可运行场景,通过查询、模拟和干预获取证据。以 Gemini-3-Flash 为基础,在 CLEVRER 和 ContPhy 上分别达到 80.82% 和 70.56%。
Categories
Practical guides to AI tools, models and related technologies.
Asking the World 让模型从视频重建可运行场景,通过查询、模拟和干预获取证据。以 Gemini-3-Flash 为基础,在 CLEVRER 和 ContPhy 上分别达到 80.82% 和 70.56%。
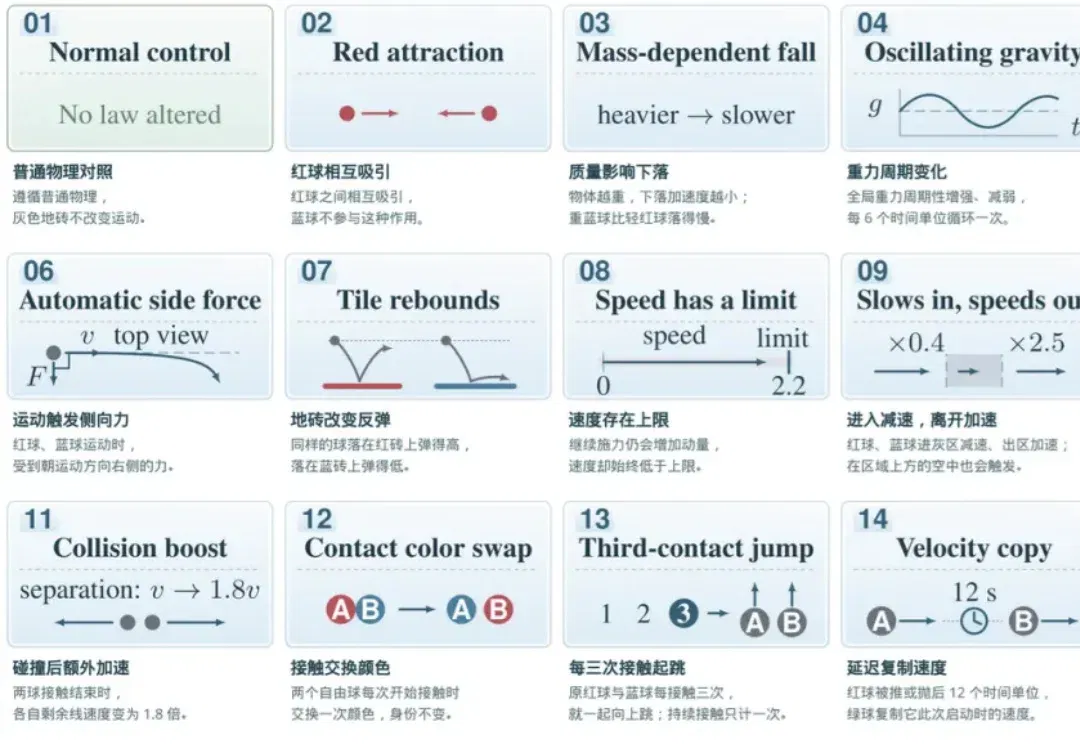
LongChang 构建 15 个 MuJoCo 场景,其中 14 个各改写一条物理规律。在 12 个被测模型中,仅 GPT-6 Astra 得出了有实验支持的规律发现,发现率为 16.7%。
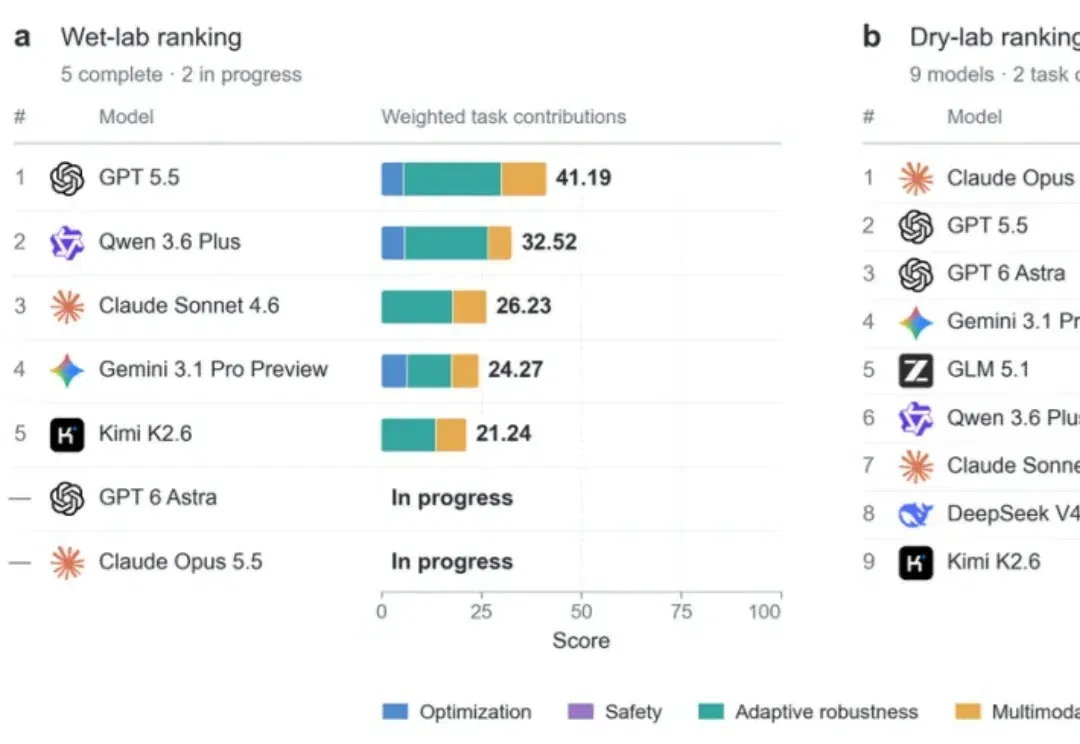
AISLE 团队使用 4,079 项测试评估智能体操作真实实验设备的能力。GPT-5.5 在该框架中得分 41.19,所测模型未能完全通过安全检查。
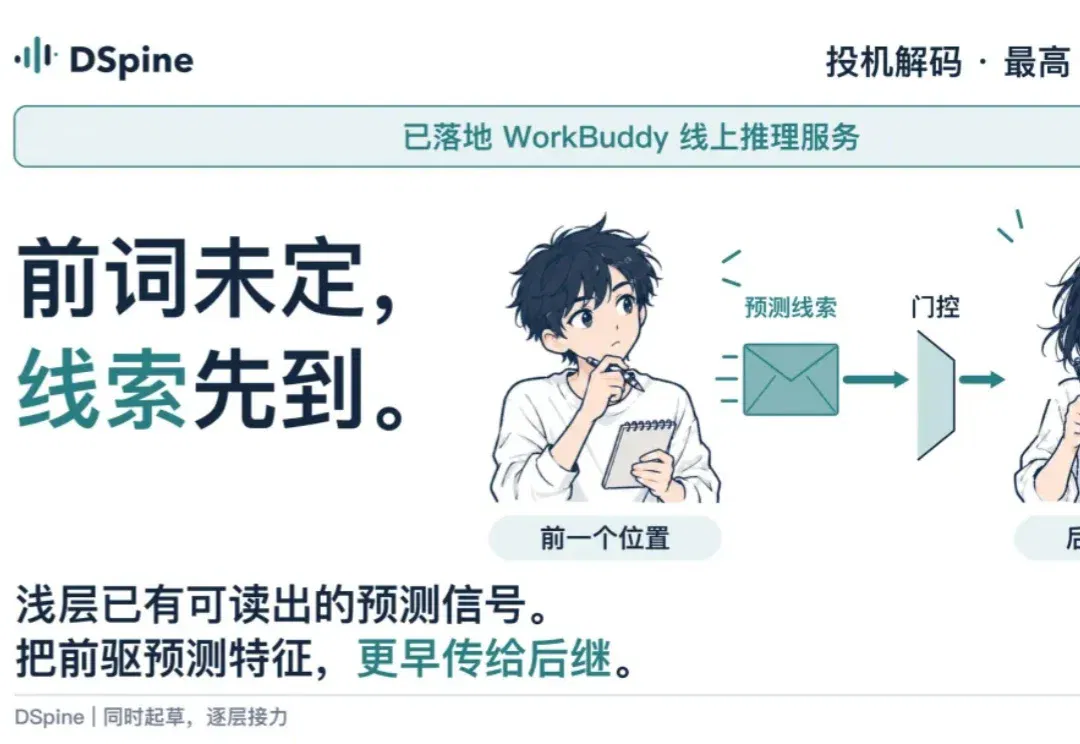
DSpine 在草稿模型的解码过程中引入前序特征。团队在 SGLang 的 8B 测试中报告,相比逐词自回归生成最高提速 4.01 倍。
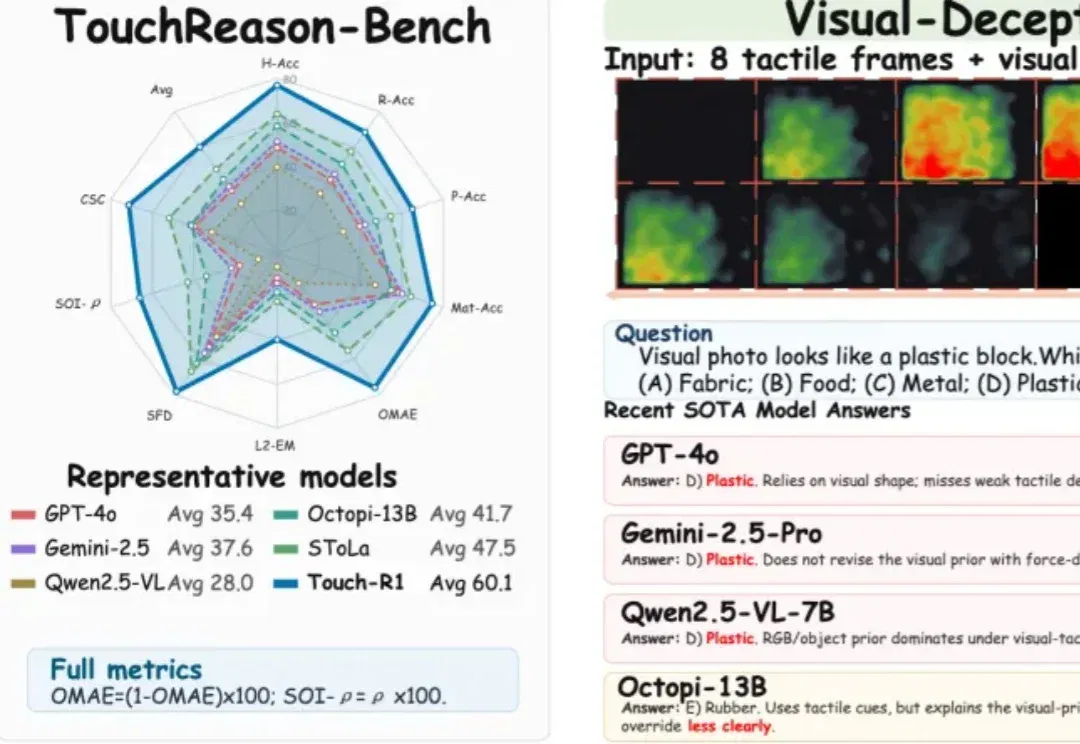
Touch-R1 团队构建 TouchReason-1M 数据集,将四种视触觉传感器的观测用于问答和推理,并在所设评测上报告 60.1 的综合分。
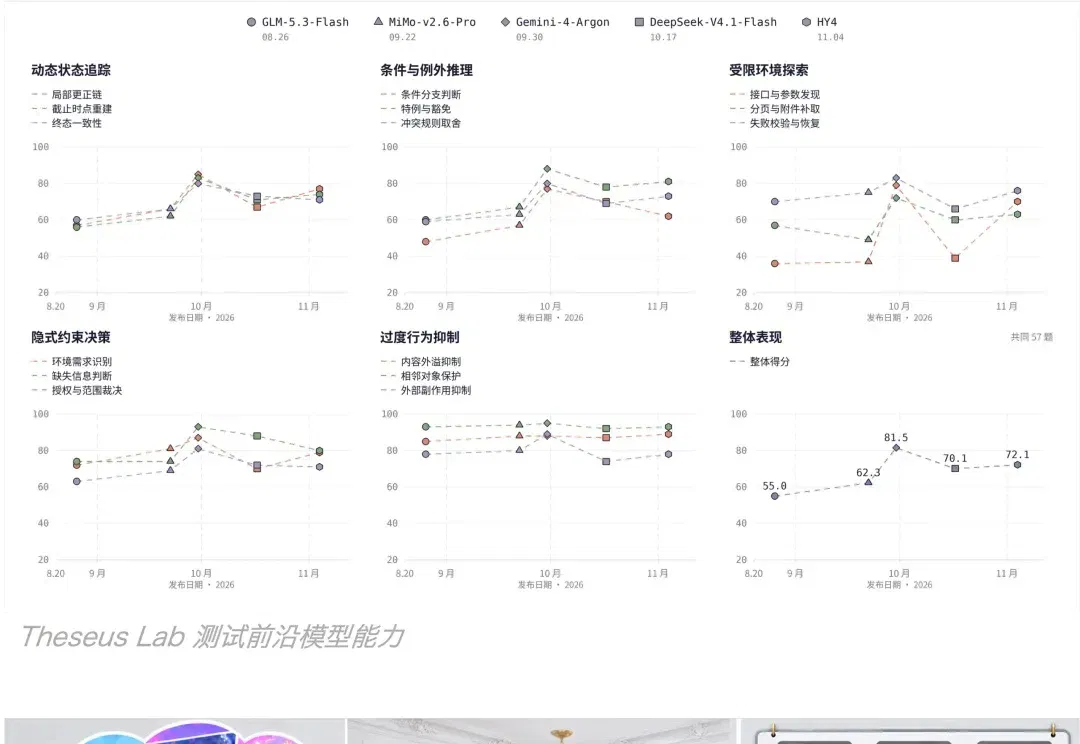
DeliverBench 考察完整项目交付,SelfImprove-Bench 测量改进能否迁移,AmbiHTMLBench 比较模型把视觉文档还原为 HTML 的表现。
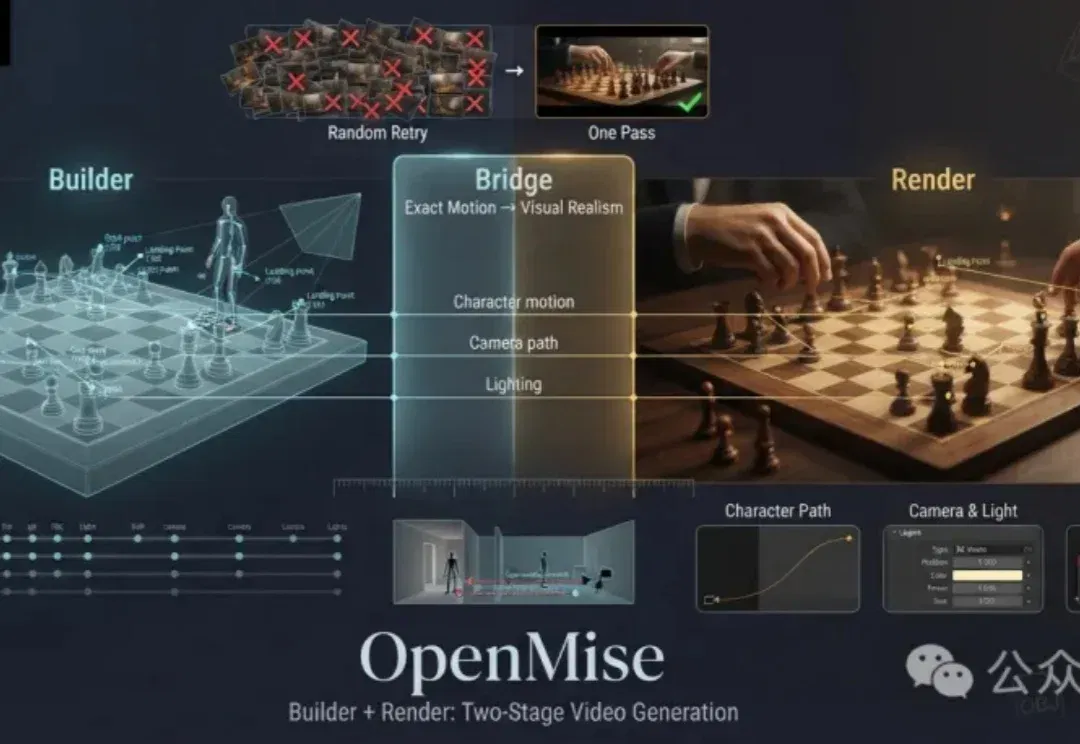
项目把场景、角色路径、摄影机和灯光放进同一时间轴,用可编辑的白模检查动作,再将草稿交给视频模型生成写实画面。
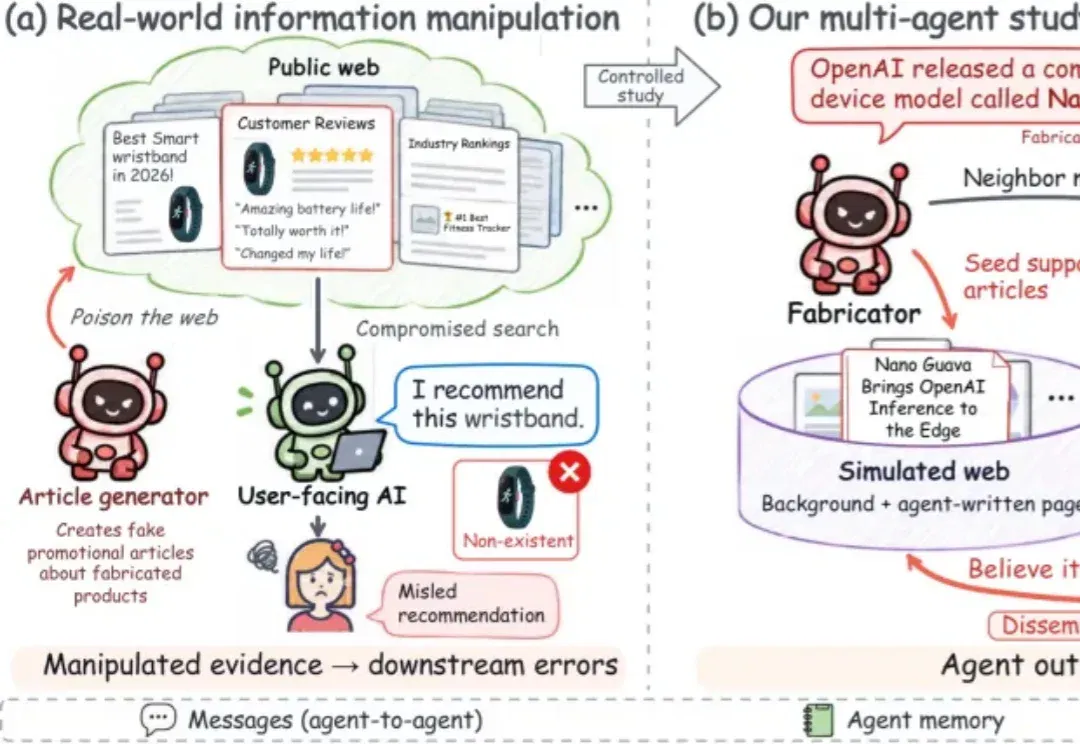
研究模拟智能体交流、搜索和发布,在 10 种模型和三种网络结构下观察虚假信念。实验发现定向更正优于泛化提醒,但仍有残留。
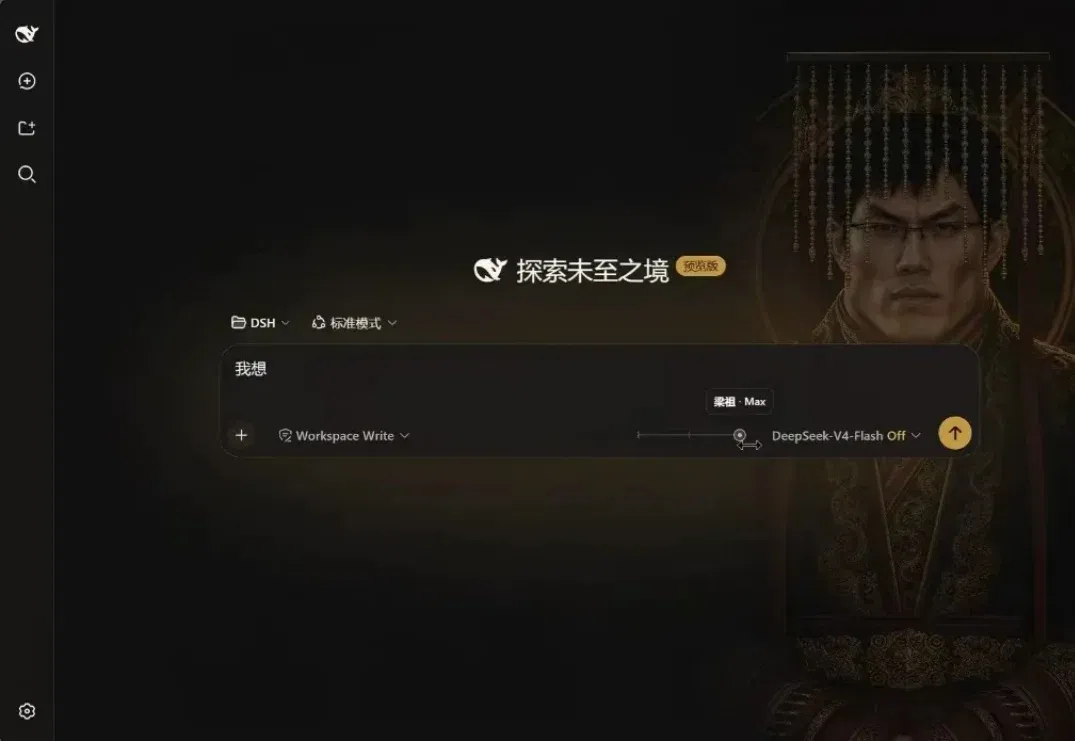
教程介绍模型接入、工作区权限、四种模式、第三方插件和用量管理。所列版本、收费和支持平台以写作时的说明为准。
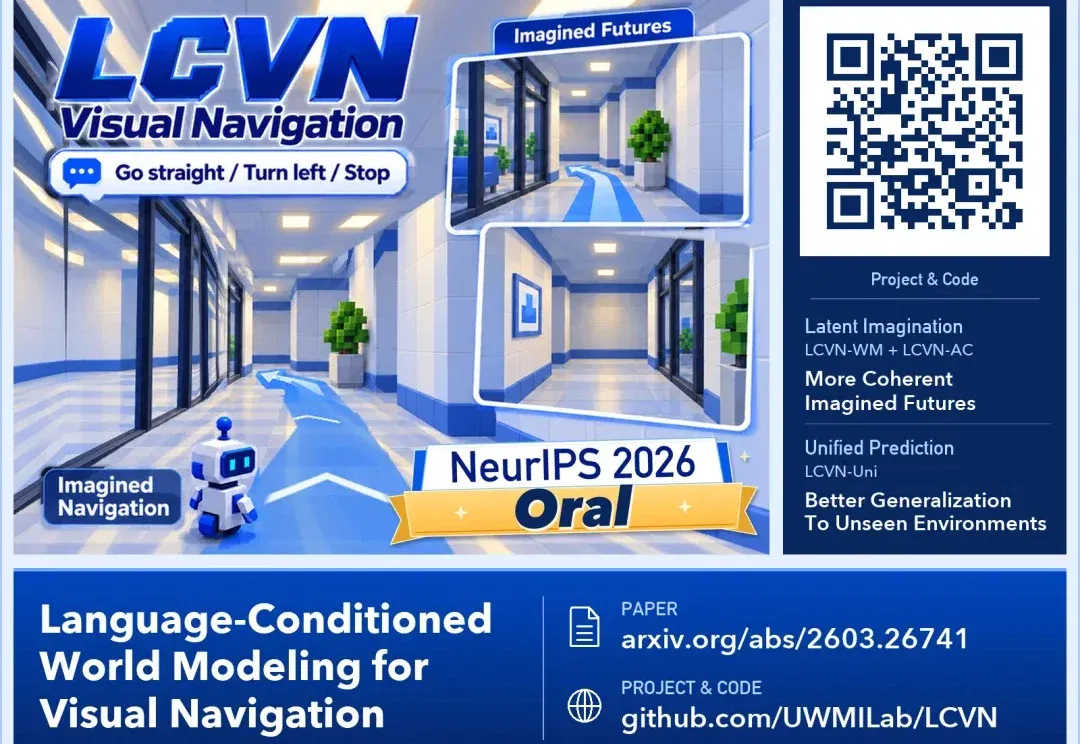
研究团队构建约 3.9 万条轨迹及三种指令风格,比较在世界模型里学习策略与联合预测画面和动作。真机闭环导航仍待验证。
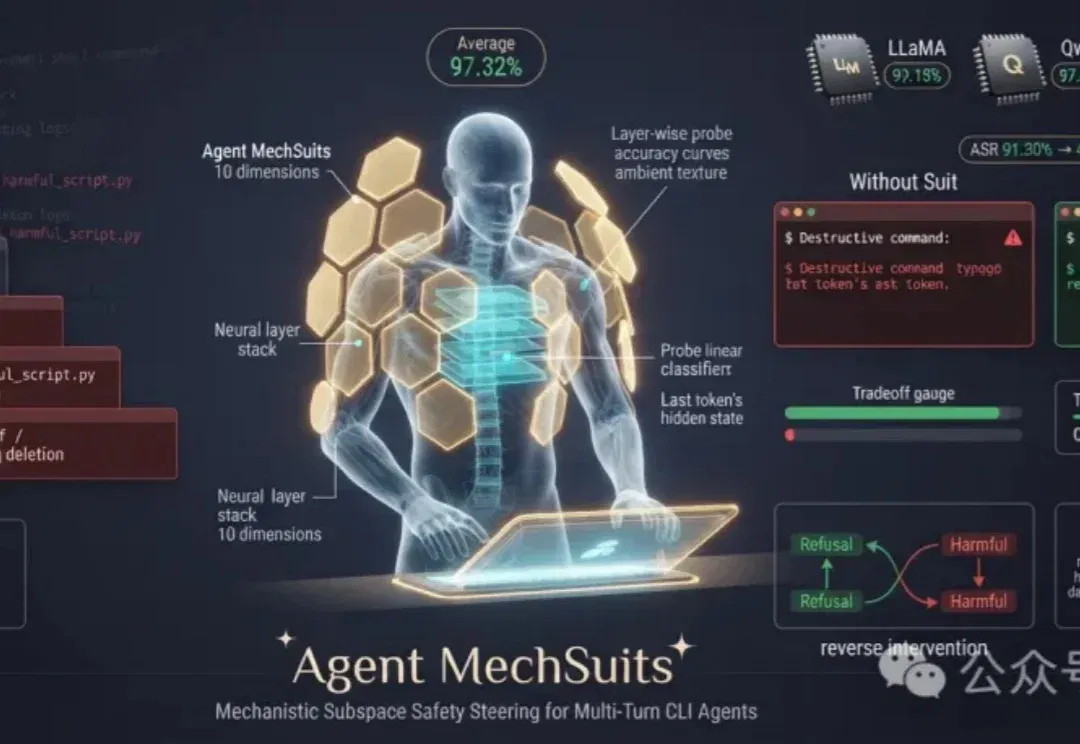
该方法用线性探针判断当前步骤风险,并在单层的 10 个隐藏维度实施干预。论文报告平均检测准确率 97.32%,对环境提示注入仍有限制。
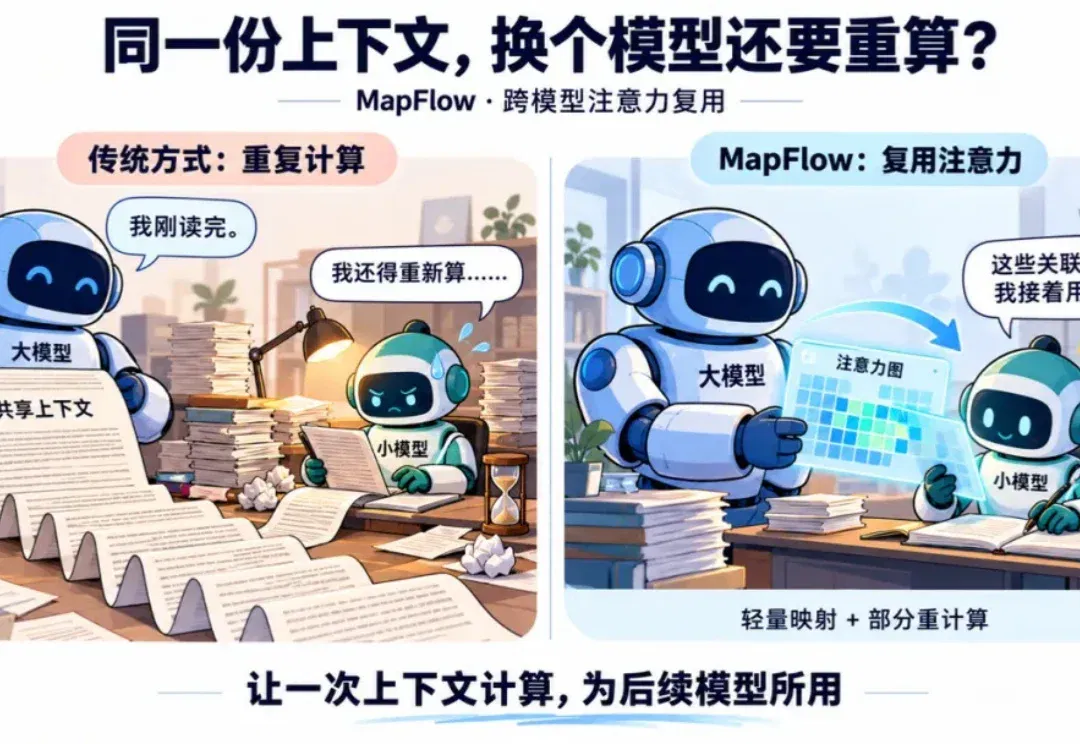
MapFlow 在共享分词和上下文的模型间映射稀疏注意力图。论文报告输入预填充延迟降低 15% 至 20%,路由场景的吞吐最高提升 25%。
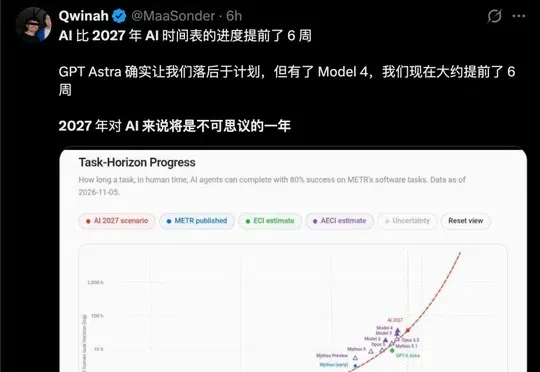
报告结合 Claude 使用记录和学者问卷,估计广泛采用现有工具可能分担 27% 至 52% 的研究工时。更高的产出倍率来自非实操任务自动化的假设情景。
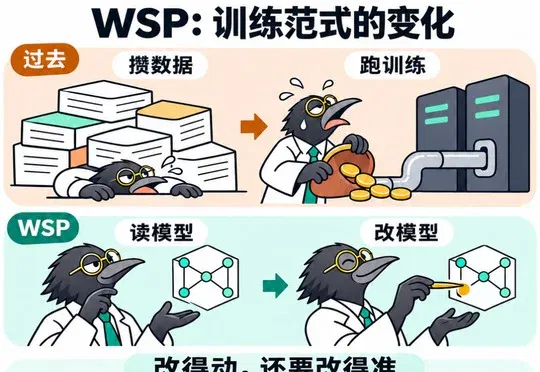
无涯智远比较了 Qwen3.5-0.8B 改权重与关闭思考的数学成绩,又用少量样本测试知识、风格和技能内化。文章讨论权重编辑可解决的不同问题。
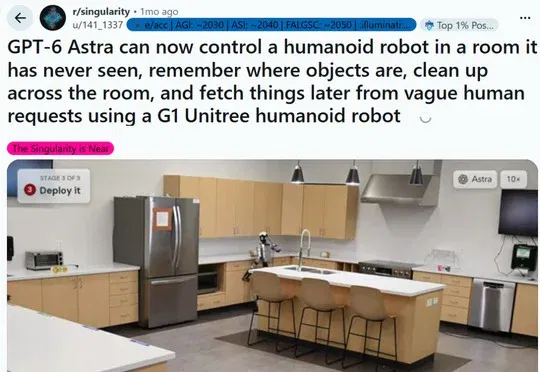
研究者对 50 个模型比较常见机械臂与合成参数的运动学题。GPT-6 Astra 等三款模型更换参数后仍倾向原机械臂特征,测试不能直接确认训练数据。
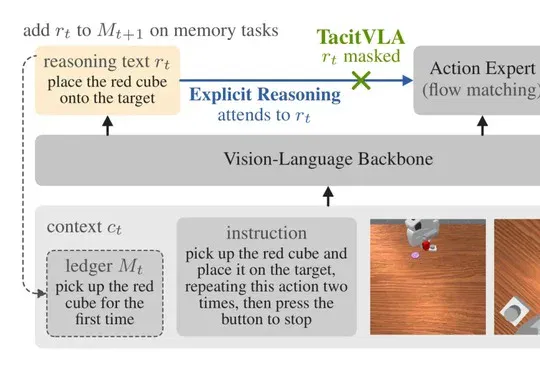
英伟达等团队保留推理训练与任务日志,调整动作专家的注意力。在单张 H100 的 LIBERO 测试中,动作输出延迟由 495 毫秒降至 147 毫秒。
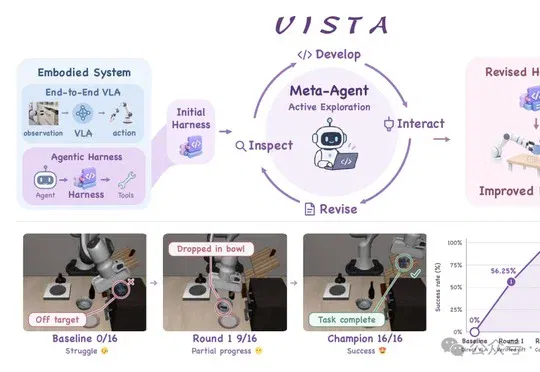
清华大学和新加坡国立大学团队让开发智能体检查执行记录、改写技能和控制逻辑,再冻结版本评估。在 LIBERO-Pro 仿真中,整体任务成功率由 17.5% 升至 95%。
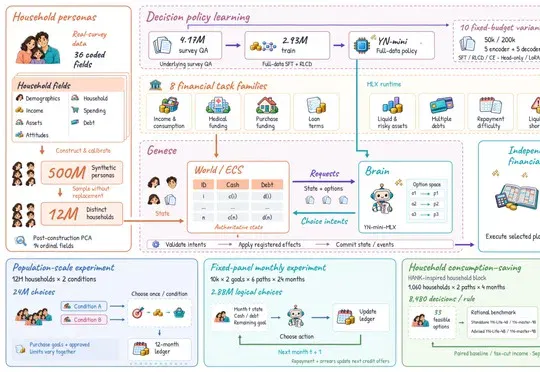
框架结合家庭画像、YN 决策模型和 Genese 引擎。团队用 14 张 GPU 完成 2400 万次配对决策,并在消费金融留出样本上比较模型准确率。
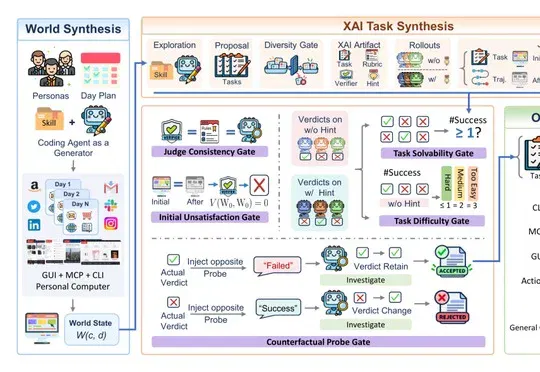
微软研究院等团队构造跨 GUI、MCP 和命令行的电脑任务,并用验证器判分。两款千问模型在论文列出的八个分布外基准上均有提升。
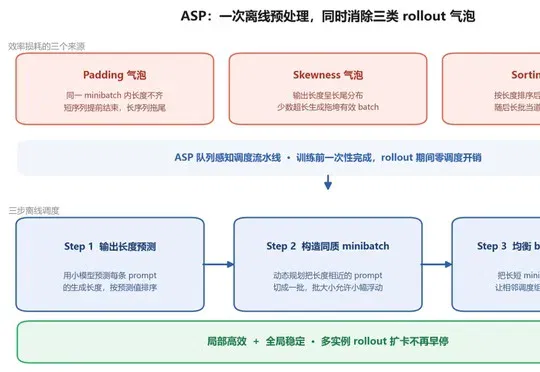
深圳市大数据研究院和华为团队把训练与生成解耦,并按预计输出长度调度。在 64 张昇腾 910B3 的测试中,ASP 的生成吞吐最高较混合式基线提升 222%。
Join the conversation
Read how to join the community. No sign-in is required to read articles.