谷歌掀语音Agent新纪元!开口就是生产力,Siri的最强外挂来了?
昨日凌晨,谷歌正式推出其最高质量的音频和语音模型——实时语音模型Gemini 3.1 Flash Live,并在Gemini App、Search Live以及Google AI Studio中同步开放,其中后者以预览版本向开发者提供。
为语音龙虾打样!谷歌最强音频模型来了,动嘴就能做App。
智东西3月27日消息,昨日凌晨,谷歌正式推出其最高质量的音频和语音模型——实时语音模型Gemini 3.1 Flash Live,并在Gemini App、Search Live以及Google AI Studio中同步开放,其中后者以预览版本向开发者提供。
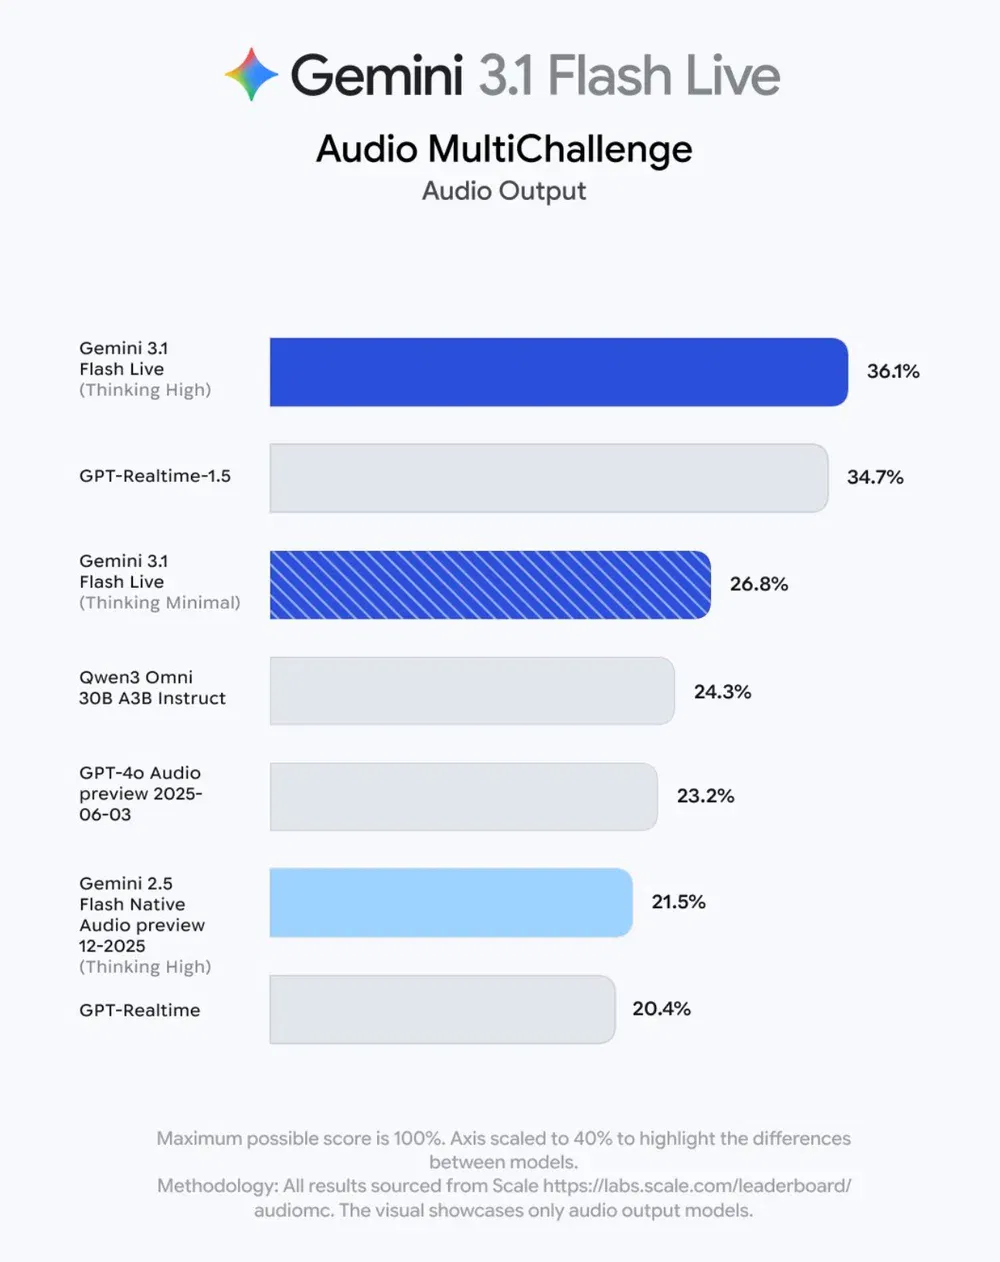
这一版本的核心在实时语音Agent能力升级:语音已可直接驱动应用开发(vibe coding),Gemini App的实时多模态对话能力同步增强,在多项评测中超过GPT-Realtime-1.5、Qwen3 Omni 30B A3B Instruct、GPT-4o Audio preview等模型。
模型一出,就被外网网友称作Siri“救星”。就在昨日,外媒曝2026苹果WWDC将主打AI并将推新版Siri(在新窗口打开),苹果已获谷歌完整Gemini模型直连权限,将通过蒸馏自研轻量化端侧AI部署iPhone。
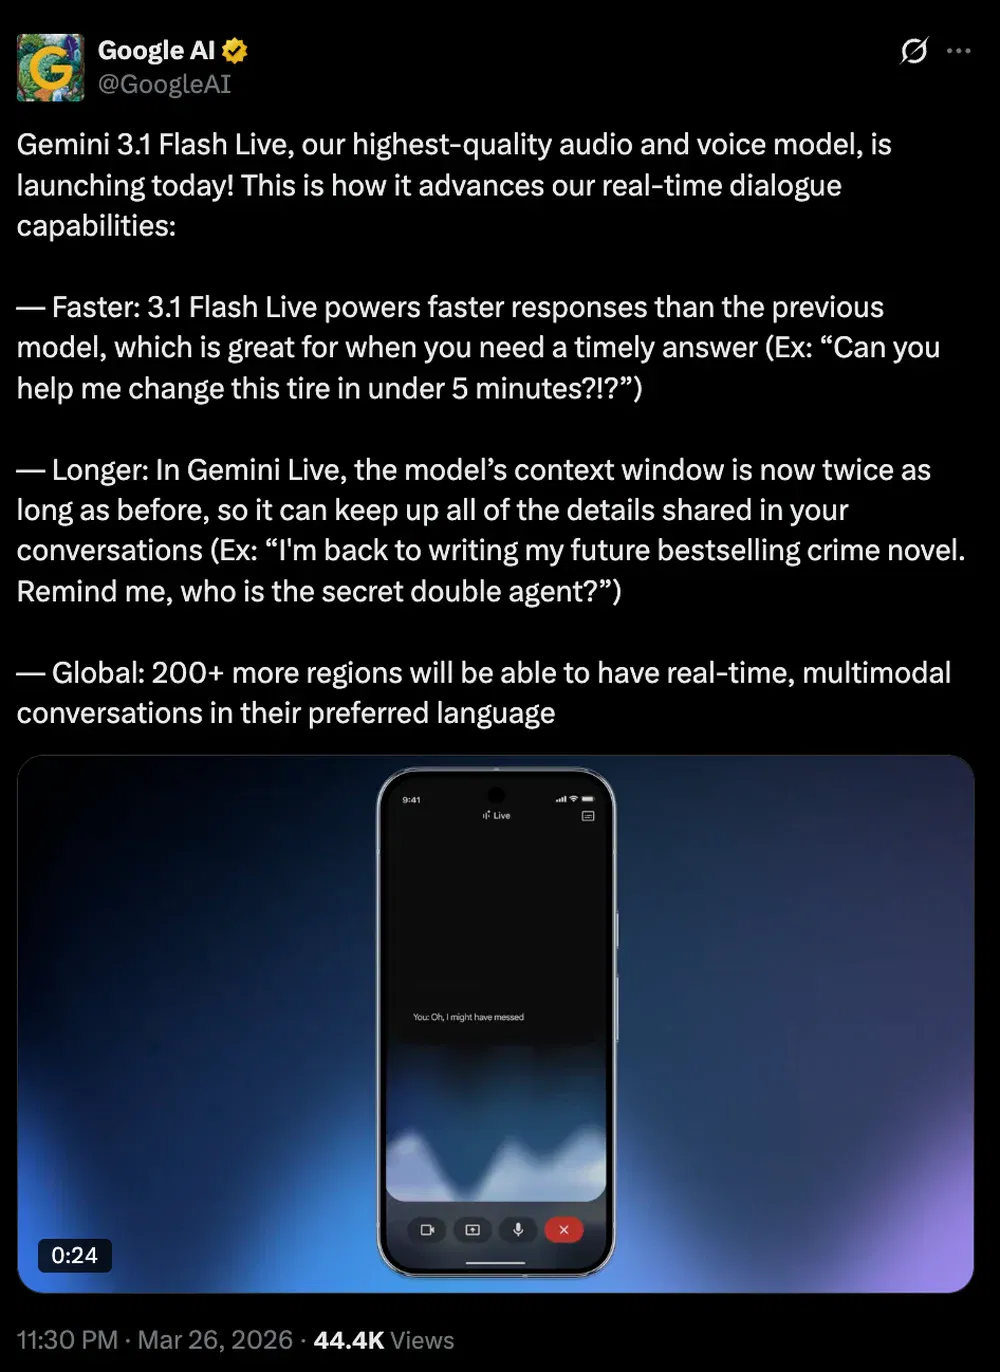
这款模型面向实时语音交互,对连续对话进行了整体优化,包括响应延迟、上下文记忆、多语言处理及工具调用等关键能力。
Gemini Live中的上下文窗口已提升至此前的2倍,Search Live支持在200多个国家和地区进行多语言实时交互,整体能力面向连续对话和复杂任务场景。
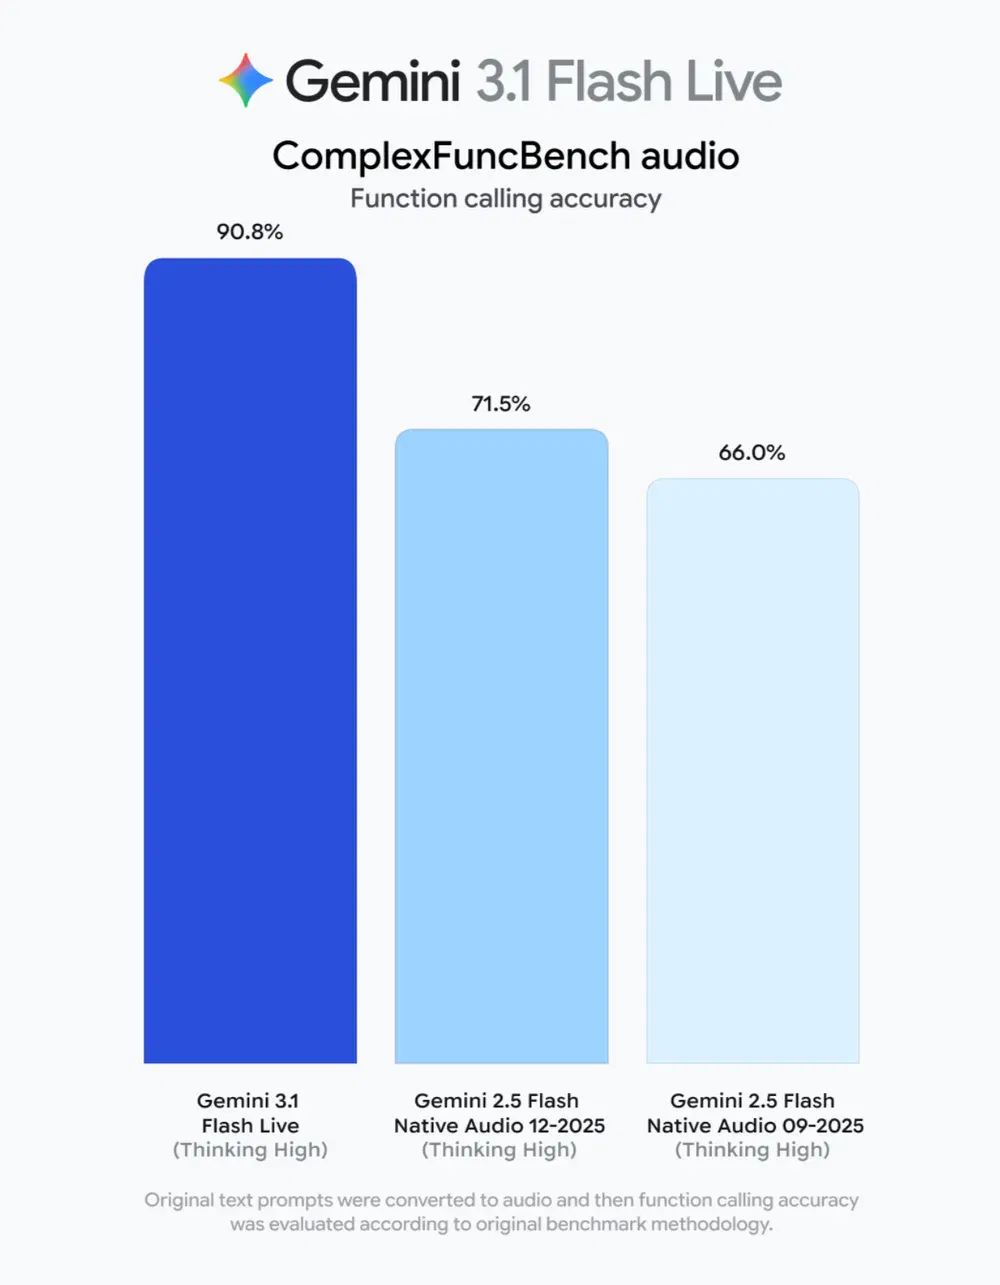
从公开测试结果来看,这一版本在语音Agent关键能力上提升显著。在ComplexFuncBench audio测试中,Gemini 3.1 Flash Live的函数调用准确率达到90.8%,相比Gemini 2.5 Flash Native Audio去年12月版本的71.5%,以及2025年9月版本的66.0%,都有明显提高。
在Scale发布的Audio MultiChallenge音频输出榜单中,该模型得分36.1%,高于GPT-Realtime-1.5的34.7%、Qwen3 Omni 30B A3B Instruct的24.3%、GPT-4o Audio preview的23.2%等模型。
与此同时,这一版本重点优化了实时对话体验。模型在语音识别中对语调、语速和停顿的处理更细;在嘈杂环境下,对背景噪音的过滤能力增强,可以更稳定识别用户指令并执行任务;在复杂指令场景中,对系统约束的遵循能力也有所提升。
已有获得更新的用户开始尝试新玩法,有人直接用语音指令让模型生成简短演唱片段,这类能力已经可以在对话中被触发。
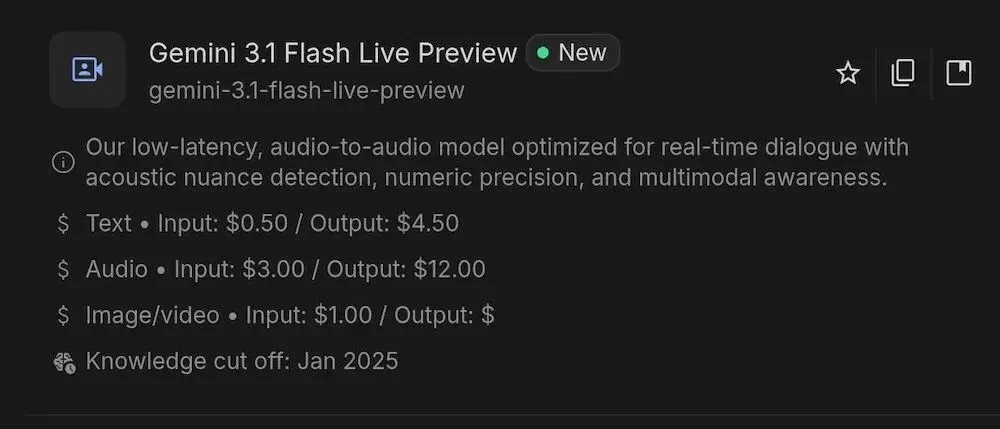
其API价格也已公布:文本输入每百万token约0.5美元、输出约4.5美元,音频输入约3美元、输出约12美元,支持多模态输入调用。
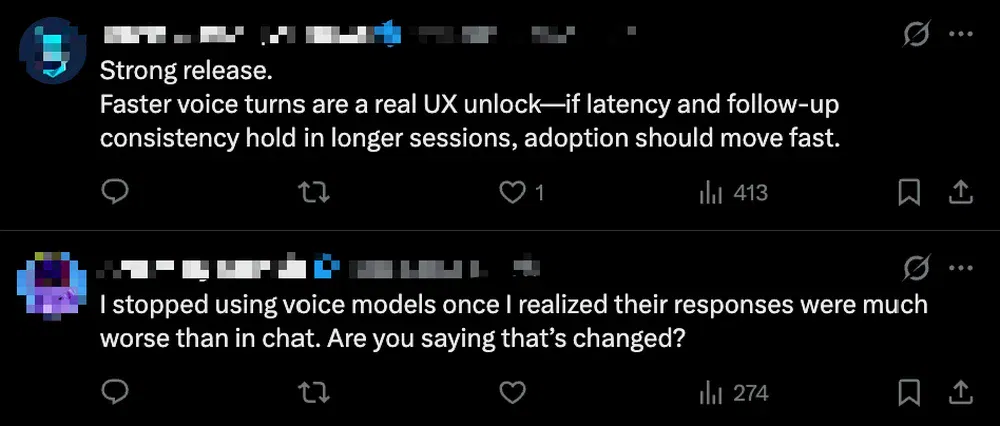
模型一经发布,社区已经出现初步反馈。有网友评价称,这是一次“强势更新”,并指出更快的语音响应是一种“用户体验层面的关键突破”,如果延迟和多轮对话中的连续性能在更长时间的使用中保持稳定,语音交互的采用速度可能会明显提升。
不过,也有用户仍然保持谨慎。一位开发者直言,自己此前已经放弃使用语音模型,因为其回复质量明显不如文本,并反问这一情况是否真的发生了改变。
智东西也对这一功能进行了初步体验。其中文语音表现仍偏机械,多轮对话过程中存在中断情况,暂未能完整体验其连续交互能力。当前该版本正分批推送,iOS和安卓用户已开始陆续收到更新。
开口就是改代码:
UI、交互、风格一段话全部重做
在这次发布中,谷歌首先展示的是
语音驱动应用开发(vibe coding)
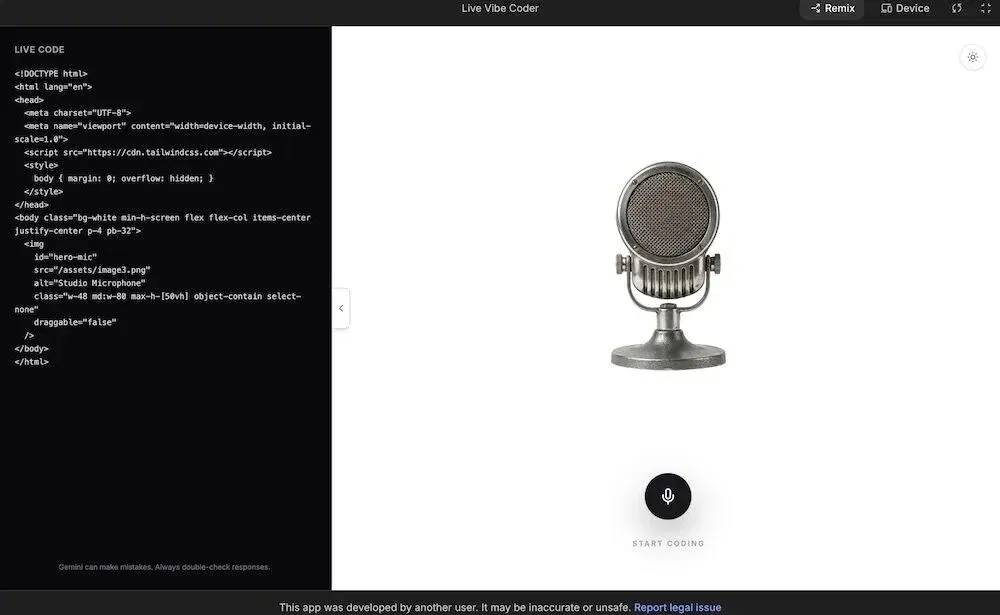
这一类场景,开发者可以在Google AI Studio里一边说话一边做应用,让开发过程跟上脑暴的节奏。
▲Live Vibe Coder页面,用户可上手实操
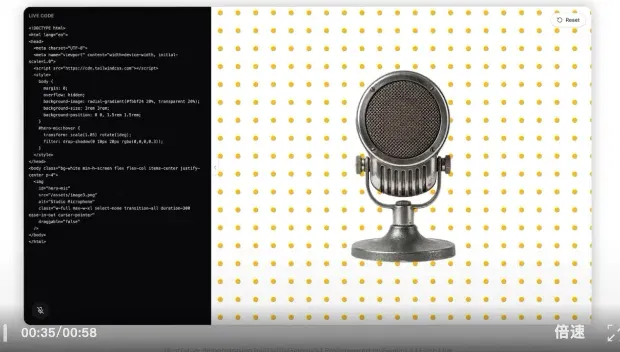
用户可以用语音连续调整界面。对话一开始,用户直接提出修改:“把麦克风做大一点”,界面随即发生变化;紧接着补一句“背景加点黄色波点”,页面背景立刻更新。
随后用户继续叠加需求,例如加入“鼠标悬停时的反馈效果”、让背景图案持续滚动,这些改动都在同一段对话中逐步完成。
用户一边说,界面一边变化。中途用户又临时调整方向,说“干脆整体做成波普风”,模型就在已有基础上继续重做视觉风格,整个过程接近和设计师一对一的实时沟通。
设计协作、跨语对话、游戏互动
三类场景同时落地
除了应用开发,谷歌还给出了三类实际使用的场景,包括界面设计协作、跨语言陪伴交流,以及游戏中的角色互动。
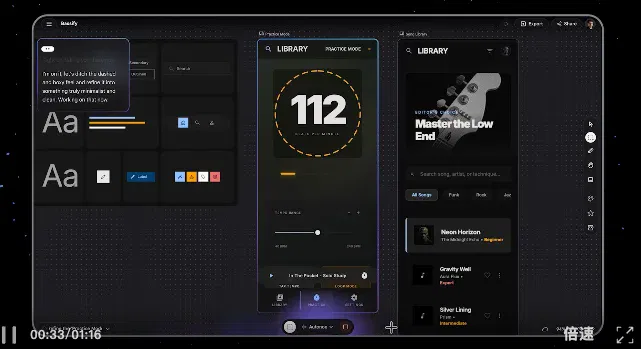
在设计工具Stitch的案例中,语音也可直接参与到界面编辑流程。用户先让界面跳到“练习模式”,再切到“歌曲库”,随后开始具体挑问题:“这些虚线和方形边框看着有点硬,能不能让数字更贴合圆形?”界面随即往更简洁的方向调整。紧接着又换一套思路:“试一个偏棕色、木质一点的配色”,新的视觉版本便直接生成出来。
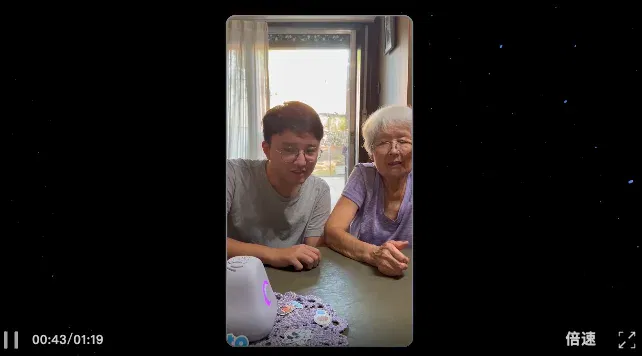
在面向老年用户AI硬件设备Ato的交互案例中,重点放在多语言对话的连续性,对话内容围绕日常问候和陪伴展开。用户先用英语聊天,再插入一个条件:“我要跟奶奶说话,但她只会西班牙语”,模型在同一段对话里切换语言继续交流,对话内容并不会因为语言变化而中断。
对话中一旦出现真实场景的插入信息,比如提到“刚从医院出来有点累”,模型会顺着语境回应,给出一段连续的交流。
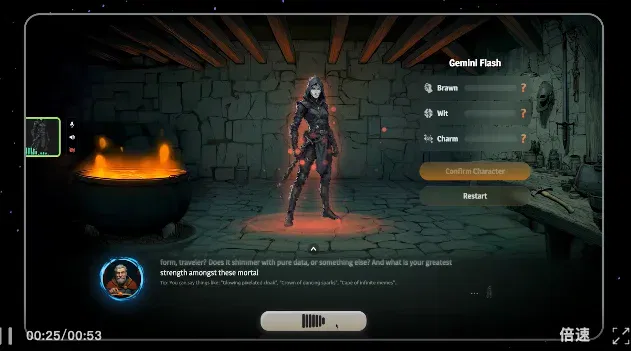
在RPG游戏《Wit’s End》的案例中,语音被用来驱动角色本身。玩家提问时,模型会用带有设定的语气回应,例如围绕“你有没有实体形态”“你的能力来自哪里”等问题展开,对话始终保持在角色语境里。回答不会跳出设定,会沿着同一世界观继续展开,语气和表达方式也保持一致。
结语:谷歌做“全栈语音Agent”
国内玩家一边抓用户,一边补能力
从这次发布来看,谷歌正在把语音能力做成一套更完整的通用能力体系。无论是编程场景中的vibe coding,还是AI硬件交互、移动端Gemini App入口,多个形态都在同时推进,覆盖范围扩展到不同使用场景。
在产品形态上,Gemini App与国内的豆包等产品已有明显相似之处,都是以对话为核心入口,承接搜索、工具调用和多轮交互。但在实际体验上,两者并不相同。豆包在中文表达、语气风格以及互动感上更为主动,调侃式表达更容易形成用户黏性,也已经在国内积累了一定用户规模。
相比之下,谷歌当前的重心仍放在能力拓展上,尤其是在语音驱动开发这一类场景中,vibe coding所体现的连续修改能力和实时交互节奏,已经领先于现有产品形态。
与此同时,国内在语音模型能力上的进展也在加快。阶跃星辰Step-Audio R1.1在Artificial Analysis语音推理榜单中拿下第一,以96.4%准确率超过Grok、Gemini、GPT-Realtime等模型,成为当前语音推理方向的代表性成果之一。
一边是谷歌不断拉高能力上限,尝试覆盖更多场景;另一边是国内玩家在用户规模与模型能力两端同时推进,语音Agent的竞争态势,正愈演愈烈。
文章来自于微信公众号 "智东西",作者 "智东西"
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
Neon identifiers surface in Gemini web code; model and subscription positioning remain unconfirmed (opens in a new tab)
A source report recounts developers finding Neon model and subscription identifiers in Gemini web code, alongside discussion of element naming. Code strings and online guesses do not establish a release, plan features or access date.
Karpo Decision goes open-source; 31B model ties first on a specified Decision Index version (opens in a new tab)
MachinePulse releases 0.8B–31B decision models that score options in one forward pass. The 31B model ties first at 73.9 in the November 12 Decision Index 0.4.1 snapshot. Latency and costs depend on test configuration; single decisions differ from full workflows.
Google expands TPU system sales as software adaptation and inference economics draw attention (opens in a new tab)
QbitAI discusses complete-system deliveries, TorchTPU and agent-inference tests using filings and sources. Revenue, unfulfilled contracts and model-specific token-per-dollar comparisons are distinct measures; optimization rounds can change results.
Google adds TPU 8tx and 8i Max for confidential computing and long-context tasks (opens in a new tab)
Google describes new eighth-generation TPU variants expected in 2027. The report covers customer needs, supply constraints and external sales; its 2028 revenue figures are institutional forecasts.
Google releases Gemini 4 Hydrogen and the multimodel Orchestrator (opens in a new tab)
The new model emphasizes fast execution for coding and multimodal tasks. Google also details availability across services, API pricing and model-orchestration tests.