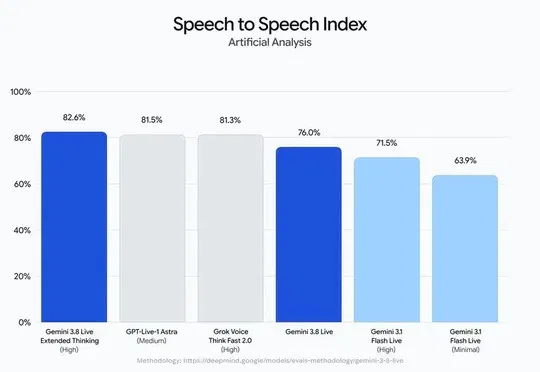
谷歌连发两款实时语音模型:Gemini 3.8 Live 要攻克语音 Agent 的沉默时刻 (opens in a new tab)
谷歌发布 Gemini 3.8 Live 与 Gemini 3.8 Live Extended Thinking 两款实时语音模型,后者支持后台异步推理与工具调用以解决语音 Agent 在任务执行中的沉默问题,两款模型已在 Gemini API 和 Google AI Studio 向开发者开放。
Total 5 articles
谷歌发布 Gemini 3.8 Live 与 Gemini 3.8 Live Extended Thinking 两款实时语音模型,后者支持后台异步推理与工具调用以解决语音 Agent 在任务执行中的沉默问题,两款模型已在 Gemini API 和 Google AI Studio 向开发者开放。
不知道大家平时有没有这种经历。 每次遇到点急事,打给各大公司的智能客服,电话那头永远是那个字正腔圆但毫无感情的声音:「查询服务请按 1,人工服务请按 0……」接着就是漫长的音乐,以及那句让人抓狂的「对不起,我没听懂,请再说一遍」。 但就在刚刚,OpenAI 发布了 Realtime API 实时语音模型的全家桶。看了看他们的演示,这回,他们是真心想让机器说「人话」,办「人事」。 省流版如下: GPT-Realtime-2:构建可用于生产环境的语音智能体。它们能够进行更深入的思考、执行操作、处理中断,并让对话持续自然地进行。 GPT-Realtime-Translate:支持 70 多种输入语言
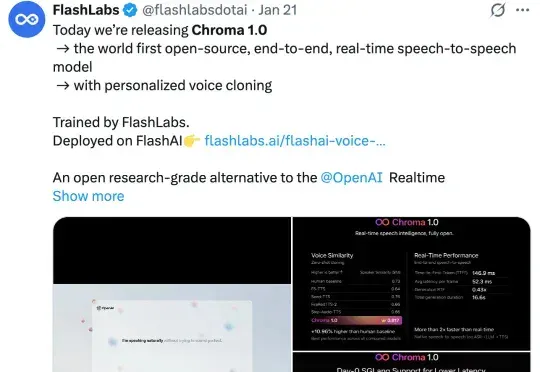
近期,FlashLabs 发布并开源了其实时语音模型 Chroma 1.0,其定位为全球首个开源的端到端语音到语音模型。Chroma 1.0 发布之后,便在社媒爆火,吸引了大量的关注。X 上的官推帖子已经突破了百万浏览量。
昨日凌晨,谷歌正式推出其最高质量的音频和语音模型——实时语音模型Gemini 3.1 Flash Live,并在Gemini App、Search Live以及Google AI Studio中同步开放,其中后者以预览版本向开发者提供。
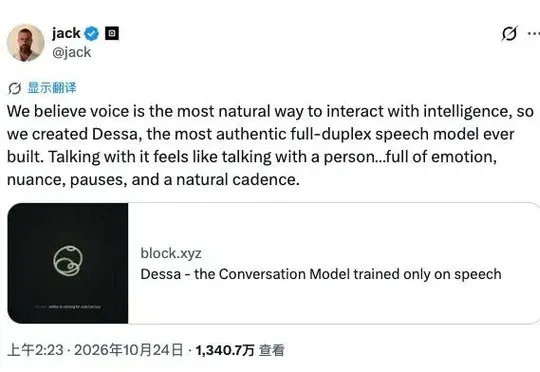
APPSO 从 Block 旗下 Dessa 的纯语音研究谈起,比较实时语音模型的交互方式与车载、客服等应用,再讨论声音在并列信息审阅、隐私和办公场景中的边界:更自然的对话仍无法替代所有屏幕操作。