GAN之父Ian Goodfellow病后归来,剑指高效世界模型
沉寂许久的 Ian Goodfellow,终于再次现身。
沉寂许久的 Ian Goodfellow,终于再次现身。
这位提出 GAN(生成对抗网络)、被称为 GAN 之父的研究者,曾一手开启 AI 生成技术的早期浪潮。但在最近几年由大模型主导的新一轮生成式 AI 竞赛中,Goodfellow 的公开声音却并不频繁。
直到最近,终于有了他的消息。
文章作者共三位:
- Ian Goodfellow 是生成模型时代的开创者,2014 年提出 GAN,开启了 AI 图像生成的第一波浪潮;
- Chris Manning 则是 NLP 先驱、斯坦福教授,自然语言处理领域最具影响力的学者之一,长期推动大语言模型的发展;
- Fan-Yun Sun 是 Moonlake AI 联合创始人兼 CEO,研究方向集中在多模态世界模型。
文中提出利用符号化表示(symbolic representations)以及游戏虚拟世界的数据,可能是构建具备动作条件(action-conditioned)的多模态世界模型的最佳路径。这类模型能够支持对长时序任务(long-horizon tasks)进行可靠的预测与规划。
文章地址:https://x.com/moonlake/status/2029983120087470545
以下是文章内容:
当人类以及其他动物生活在世界中时,它们可以感知周围正在发生的事情。但人类所做的远不止观察:人们还能预测环境中其他生物或物体接下来可能的行为,并据此规划自己的行动以实现某个目标,无论是去获取晚餐,还是说服别人和自己一起踏上一次冒险之旅。要成功完成这些复杂任务,就需要一个高效的世界模型。
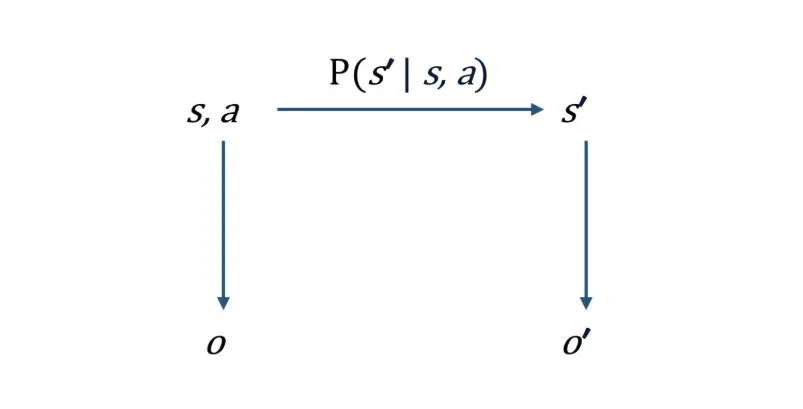
所谓世界模型,是指一种能够表示环境运作方式的模型,包括环境的动态变化(dynamics)以及其中的因果结构(causal structure)。这一概念可以通过强化学习中的模型来形式化描述:在强化学习框架中,环境通常被建模为一个部分可观测马尔可夫决策过程(POMDP)。在这个框架下,世界模型用于近似环境的状态转移函数 P (s′∣s,a),也就是在当前状态 s 下执行动作 a 时,预测下一个世界状态 s 的概率。
借助世界模型,我们可以基于对世界行为的心理模型来进行预测、规划、推理和行动,而无需每次都通过与真实世界直接交互来观察行动的后果。
然而,在现实中,人类并不能直接获得世界的真实状态 s。我们所能获得的,只是对真实状态的一部分观测 o。换句话说,人类始终是在不完全信息的条件下理解和行动于这个世界之中。
人们在观察或测量世界时采取了不同的方法,并利用不同的模态来构建世界模型。例如,一个像 ChatGPT 这样的大语言模型,仅通过文本就能学习到某种形式的潜在世界模型:在其数十亿参数之中,隐含着对物理世界和社会世界的某种表示,以及对因果关系的一定理解,使得模型能够在 token 空间中通过输入和输出,模拟世界中的事件、行为体和环境。
然而,我们所生活的世界并不只是文本,它还包括视觉、声音、触觉等多种感知形式。因此,在这篇文章中,作者重点讨论的是多模态世界模型(multimodal world models)。
在构建多模态世界模型时,我们需要先提出两个关键问题:我们为什么要构建这个世界模型?以及是否能够获得可规模化的数据来源来对其进行训练?
我们为什么要构建世界模型?
构建世界模型的目标,是为了实现能够释放巨大经济价值的 AI 能力,并帮助人们摆脱那些不受欢迎的工作。尽管当今的 AI 在某些复杂任务中已经能够自主运行,但现实世界中的任务往往要求理解行动在时间维度上如何产生后果,而不仅仅是识别观察数据中的模式。关键不仅在于理解世界中各种对象或现象如何同时出现,更在于理解它们之间的因果关系。例如,一个人在房间里对另一个人大喊,可能会让对方感到不开心;但一个人感到不开心,并不会导致房间里另一个人开始大喊。作者认为,在多模态环境中进行因果推理的能力,是通向具身 AGI 最重要的核心能力之一。
当人们谈到多模态世界模型时,很多人会首先想到生成式视频模型(例如 Sora 或 Genie 3)。这些模型通常能够生成视觉效果极为逼真、质量很高的场景,并在视频制作等领域具有广泛应用。但从本质上看,这类模型是在通过像素观测来度量四维世界的变化,并尝试建模连续视频帧之间的关系。
如果只是想表达一辆赛车在急弯中高速转弯、轮胎发出刺耳摩擦声的画面,那么基于像素的世界模型显然比文本更直观。然而,这种方式并不一定能够真正捕捉世界的因果结构。例如:猛打方向盘会导致汽车急转弯,而急转弯又会导致轮胎摩擦发出尖叫声。此外,由于缺乏抽象层和语义结构,纯像素建模在速度和成本上往往效率较低。一些研究(例如《Are Video Generation Models World Simulators?》也指出,即使是当前最先进的模型,仍然会出现物理或空间理解上的问题,比如固体物体漂浮在空中,或两个实体相互穿透等现象。
如果目标是为下一步行动进行规划,那么问题就出现了:我们真的需要一个高分辨率的像素视图来建模世界吗?作者认为,在大量具有经济价值的任务中,其实并不需要如此细致的视觉信息。毕竟,人类即使在各种感官能力存在局限的情况下,也能完成几乎所有现实任务。此外,在很多情况下,仅用几句话描述一个场景(例如汽车急转弯时轮胎发出刺耳摩擦声)就足以支持理解与决策。相关实验也表明,人类在处理视觉信息时往往并不是完整解析所有像素,而是以自上而下、任务驱动的方式进行处理,并依赖于对象层级的抽象表示。在绝大多数情境中,部分信息加上语义理解就已经足够。
因果关系本身可能非常复杂。那么,人类在理解世界方面到底有什么特殊之处,使我们能够不断深化对世界的认识?事实上,许多生物,即使是像乌鸦这样相对简单的动物也能够通过观察世界来形成某种内部世界模型,并据此制定计划实现目标。人类之所以比其他生物拥有更强大的能力,关键在于我们发展出了认知工具(cognitive tools)。其中最重要的是自然语言,以及后来发展出的各种符号表示,例如数学和编程语言。
这些认知工具能够帮助人类以更高效的方式对世界进行抽象,并准确表达因果关系和结果。它们不仅使人类能够更高效地推理世界中真正重要的因素,还让我们能够通过语言沟通和协作,从而影响他人的行为。
更重要的是,工具和抽象可以让模型把表示能力集中在那些真正影响决策的世界要素上,从而在数据和计算效率上都更具优势。与其试图通过原始感官数据完整重建整个世界,不如利用语义层面的抽象来实现更强大、更高效的理解和操作。这一点与如今代码生成模型处理编程语言的方式类似:通过符号系统进行操作,而不是直接处理底层机器状态。
这种表示方式具有高度紧凑的特点,使得模型在面对长时间跨度任务或需要记住大量历史事件的情境时,也能够进行有效预测与推理。
我们可以从哪里获得可扩展的数据来源来训练因果世界模型?
文章指出,数据是构建有效模型中最关键的因素。目前,大多数最先进的视觉世界模型仍然是基于像素的世界模型,但这些模型通常并不具备动作条件(action-conditional)能力。虽然互联网上存在海量视频数据(例如来自 YouTube),但真正记录行动本身及其结果的数据却非常稀缺,而正是这些数据才能帮助模型理解行动会带来什么后果。
目前也有一些研究路径尝试让像素世界模型具备动作条件能力,但作者认为,更具数据效率和计算效率的一条道路,是利用软件抽象来构建多样化的合成世界(synthetic worlds)以增强模型训练。这些合成环境同样可以成为训练动作条件像素世界模型的重要数据来源。
抽象机制可以让模型在更少数据的情况下实现高性能。当下,这些抽象大多以符号表示(symbolic representations)的形式存在,例如代码和自然语言。这些符号可以通过一种高度可扩展的数据采集接口获得,即计算机及其输入设备(例如键盘和鼠标)。此外,符号表示也更适合人类进行精细、有效的控制。由于它们正是人类表达意图的接口,因此可以形成一个同时包含行动(actions)与观测(observations)的数据飞轮。对于一个需要由人类操作的模拟环境而言,必须存在一个有效的交互接口,而这一接口往往最自然地通过人类语言和软件代码这样的符号系统来实现。
最后,作者认为,要成功构建世界模型,一条能够实现商业自我持续发展的路径尤为关键。只有当商业化激励持续推动数据产生和模型改进时,模型能力才能不断提升。类似的模式已经多次出现,例如智能手机中的惯性测量单元(IMU)推动了相关技术发展,以及大语言模型在自然语言处理领域的快速进步。
因此,作者提出,应当从数字世界开始构建多模态世界模型。像游戏这样的交互式媒体既能够提供明确的参与激励(例如娱乐),又具备可扩展的数据采集接口(键盘和鼠标),从而让数据自然积累。这条路径有望最终实现一种模型:在完全成熟的形态下,它不仅能够生成环境,还能用于训练和控制任何具身智能体,无论是在虚拟世界还是现实世界中。目前已经出现了一些迹象,表明这种跨环境的泛化能力正在逐步显现。
展望
文章指出,这并不是在否定像素作为世界表示方式的价值,也不是认为未来只会存在一种统一的世界表示形式。作者强调,更关键的是:世界模型的设计应当围绕我们希望从中学习到的策略(policy)来展开。在此基础上,需要借助合适的抽象方法和工具,使模型能够聚焦于那些真正影响决策的环境因素,从而在数据效率和计算效率之间取得更优平衡。
如果目标是在多模态环境中理解因果关系,那么无论世界模型是用于虚拟世界还是现实物理世界,它都需要优先满足一些关键属性。例如:在长时间尺度上保持空间和物理状态的一致性,并能够推动世界状态的演化,使其真实反映行动带来的后果。
文章最后提到,这正是 Moonlake 当前正在探索和构建的方向。
文章来自于“机器之心”,作者 “陈陈”。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
Mei Tao proposes agentic world models linking planning and feedback (opens in a new tab)
AI Tech Review outlines Mei Tao's AWM concept, connecting language models, multimodal representations and embodied feedback. Team demos illustrate the idea; visual consistency does not establish physical accuracy or reliable real-world execution.

Oxford researcher proposes cognitive symbionts for wearable AI augmentation and governance (opens in a new tab)
Hao Fei's perspective paper proposes cognitive symbionts and AI-Augmented Human Intelligence, covering long-term memory, wearables, proactive help and governance. Privacy, low latency and lifelong companionship are design goals, not verified product guarantees.
SingularityBench tests AI infrastructure optimization; Opus 5.5 exceeds five selected baselines (opens in a new tab)
SingularityBench compares agents with selected systems on six infrastructure tasks. Opus 5.5 with Claude Code scores about 1.25 overall; this does not establish complete recursive self-improvement or superiority over all human engineering.
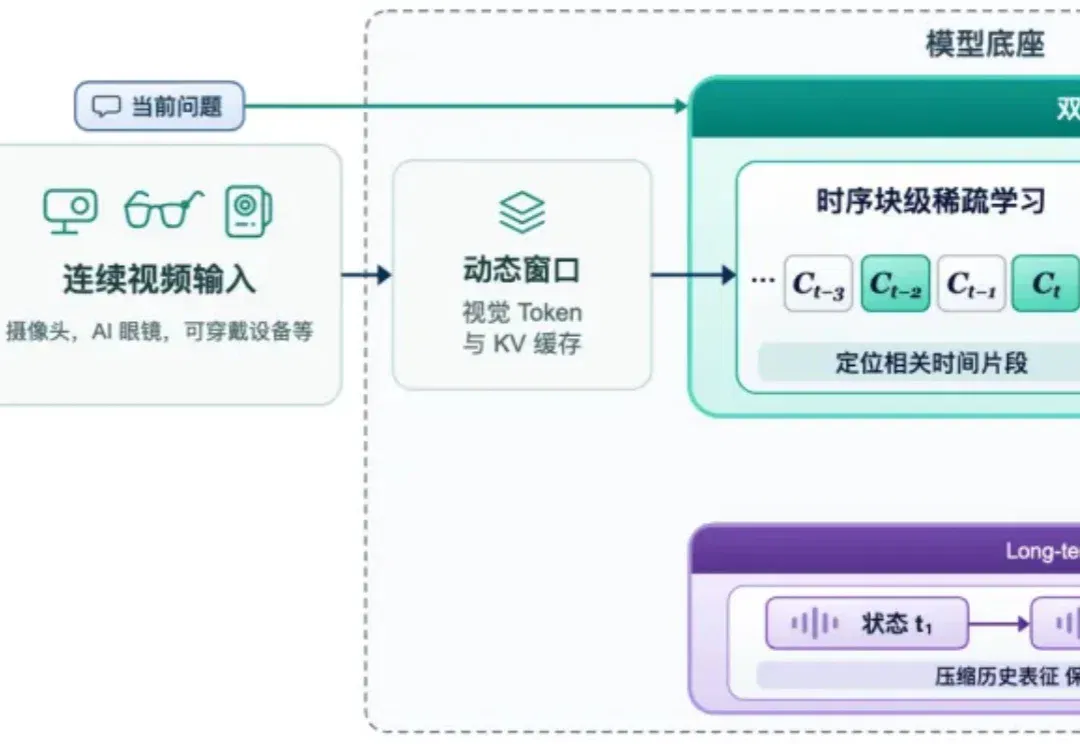
Weitu AI presents a streaming-video brain combining sparse perception and long-term memory (opens in a new tab)
Weitu AI selects temporal segments and spatial features to control compute costs, reporting OVBench and S-EMBER results and exploring continuous video understanding for glasses, offices and industry. Outcomes depend on devices, deployment and task conditions.
Report traces falsely attributed papers and journals’ misuse of researchers’ names (opens in a new tab)
Synced summarizes a THE investigation and researchers’ responses about false authorship, indexing and verification. The journals’ lack of response remains attributed to the source; AI-detector scores alone cannot establish origin or identity.