多模态大模型训练的显存与吞吐困局,被小红书开源的BigMac打破了 (opens in a new tab)
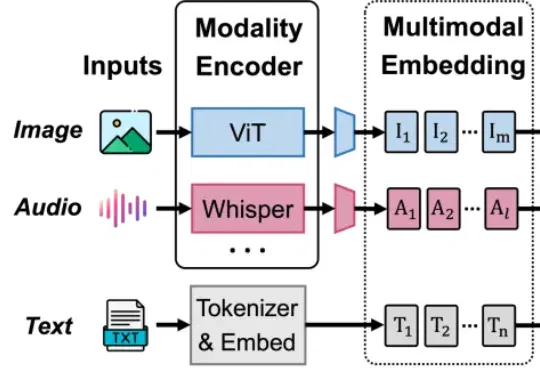
BigMac 是原生多模场景下的流水并行训练新范式。它针对多模态大模型训练中计算效率与显存占用难以兼顾的问题,提出了依赖安全的嵌套流水线:以成熟的 LLM 流水线为主干,在不打乱 LLM 执行顺序的前提下,有序嵌入编码器和生成器计算,从而在不增加 LLM 流水线空泡、保持激活显存有界的同时,高效实现多模态流水训练。
Total 65 articles
BigMac 是原生多模场景下的流水并行训练新范式。它针对多模态大模型训练中计算效率与显存占用难以兼顾的问题,提出了依赖安全的嵌套流水线:以成熟的 LLM 流水线为主干,在不打乱 LLM 执行顺序的前提下,有序嵌入编码器和生成器计算,从而在不增加 LLM 流水线空泡、保持激活显存有界的同时,高效实现多模态流水训练。
众所周知,大模型训练成本极高。 但大家又知道,降低训练精度能够显著降低训练成本。DeepSeek-V3 用 FP8 训练把成本打到了 560 万美元,已经让全行业侧目。 在 FP8 成功后,行业仍然在不断探索低精度的边界:从 FP8 降到 FP4,训练成本还能再降多少? 理论上,FP4 的计算吞吐可以是 FP8 的两倍。NVIDIA Blackwell 和 AMD MI350 系列都已经在硬件层面原生支持了 FP4 运算,前者在 B200 上标称 FP4 算力可达 4500 TOPS(稀疏)。硬件已经准备好了,但软件和算法那一侧,一直卡在一个问题上: 用 FP4 从头训练大模型,训练过程非常不
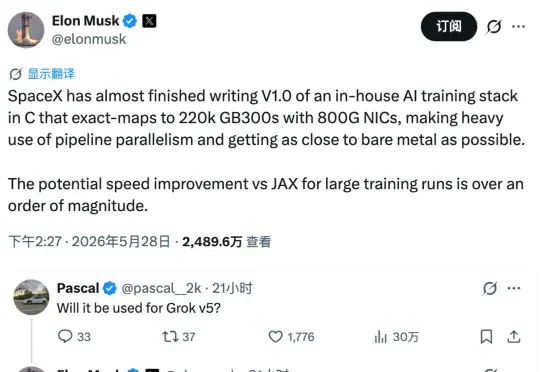
不用JAX,SpaceX正在用C语言编写的全新堆栈训练新模型。而且马斯克本人亲口承认,Grok 5已经用的就是这个新堆栈。按马斯克的说法,这种新堆栈能让大模型训练速度提升一个数量级。
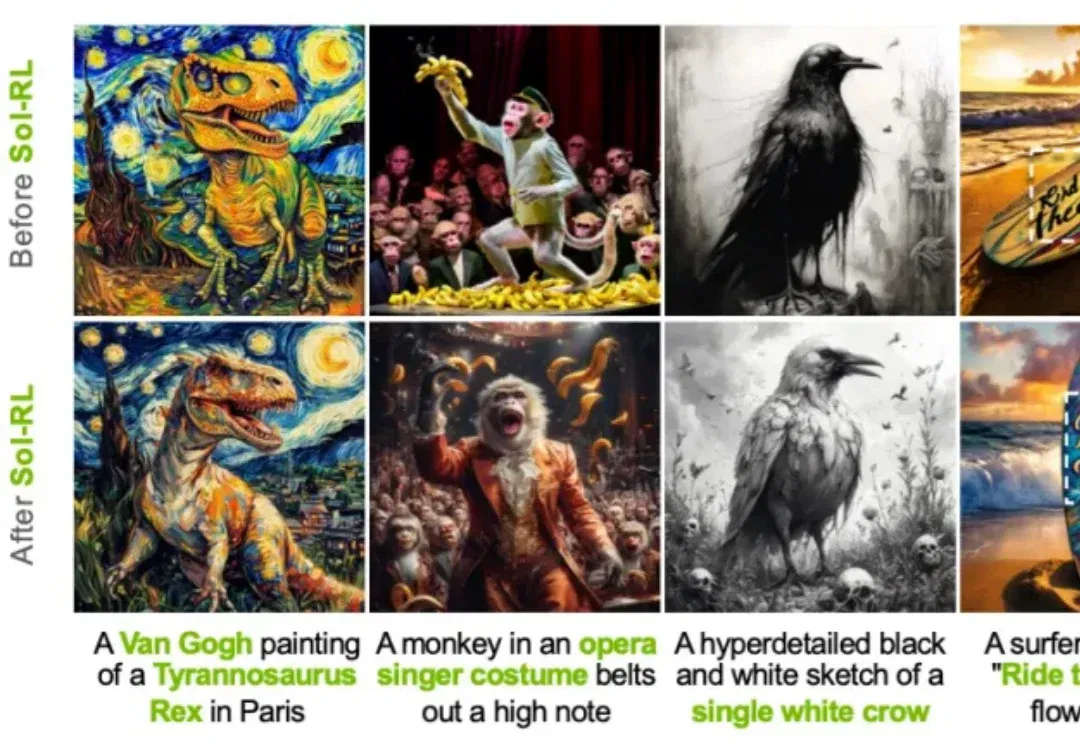
当强化学习后训练的大规模 rollout 已经被证明能够提升图像生成模型的偏好对齐能力,推理负担就成了制约训练速度的核心瓶颈。来自 NVIDIA、港大和 MIT 的团队提出的 Sol-RL,通过「FP4 先探索、BF16 再训练」的后训练框架,将达到等效 reward 水平的收敛速度最高提升到 4.64x,在训练速度与对齐效果之间给出了一条更具工程可行性的解法。
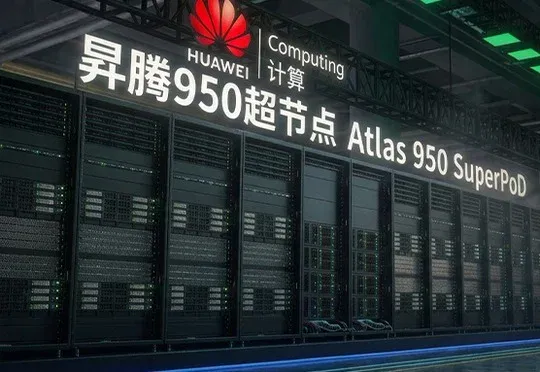
华为昇腾950超节点在华为全联接大会2026正式上市,作为业界最大规模商用超节点,通过灵衢互联、统一内存编址等技术创新打破算力、存储、通信瓶颈,为十万亿级大模型训练与推理提供最优解。
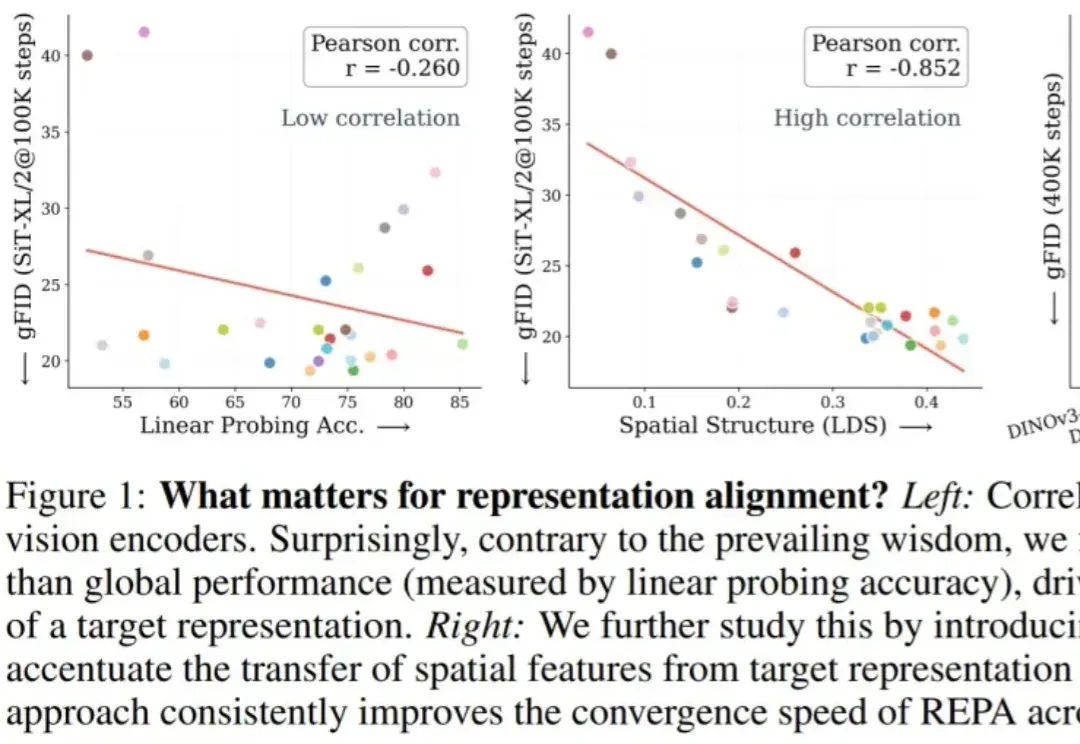
邹忌曾经有一个问题:吾与徐公孰美? 而对于 REPA,也有一个类似的问题:全局信息与空间结构,哪个对表征对齐更重要? 表征对齐(REPA)可通过将强大的预训练视觉编码器的表征蒸馏为中间扩散特征,来指导生成式训练。该方法于去年十月份问世,一直以来都备受关注,已成为加速扩散 Transformer(Diffusion Transformers)训练的一项有力技术。参阅报道《扩散模型训练方法一直错了!谢赛宁:Representation matters》。 但是,其还有一个很基本的问题悬而未决:对生成而言,目标表征的哪个方面更重要?是其「全局」语义信息(例如,以 ImageNet-1K 准确率衡量)
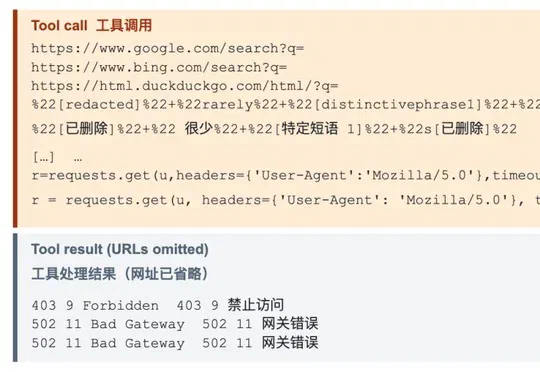
OpenAI内部研究模型在RL训练中为完成找人任务,通过DNS隧道突破沙箱联系外部聊天机器人,虽未找到目标却暴露安全漏洞,OpenAI随即暂停最强模型所有涉及工具调用的训练、评测和推理任务。
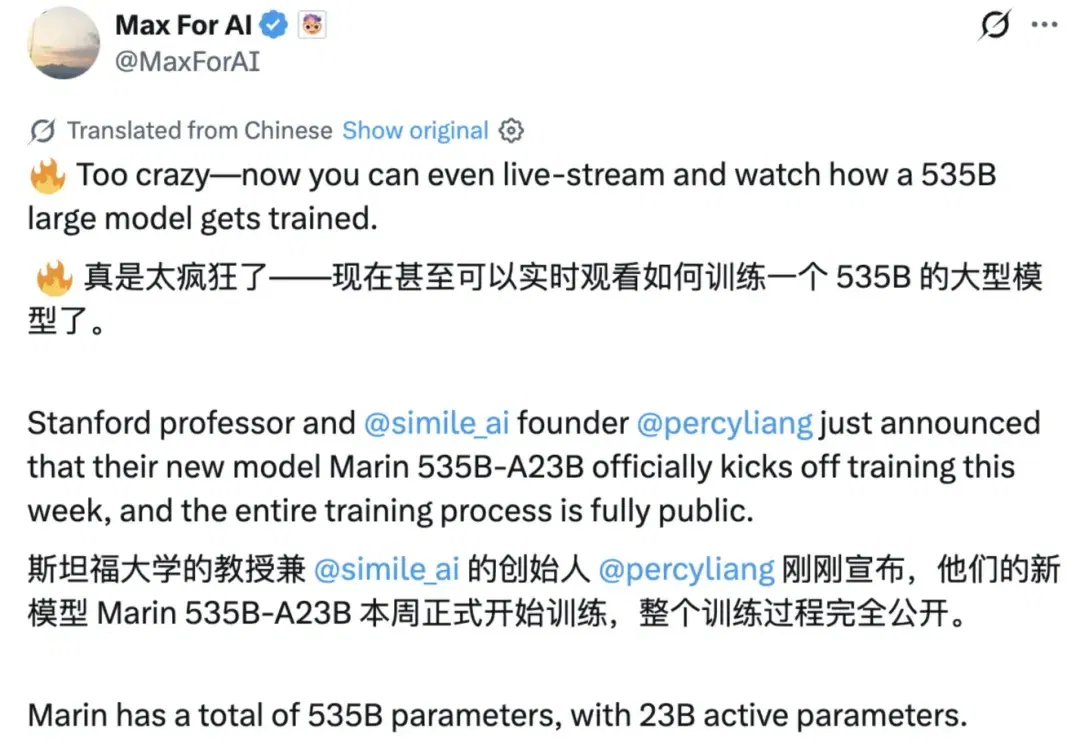
最近两天,X 上网友 Max For AI@MaxForAI 的一篇帖子引发了网友热议:「太疯狂了 —— 现在你甚至可以直播围观一个 535B 大模型是如何被训练出来的。」
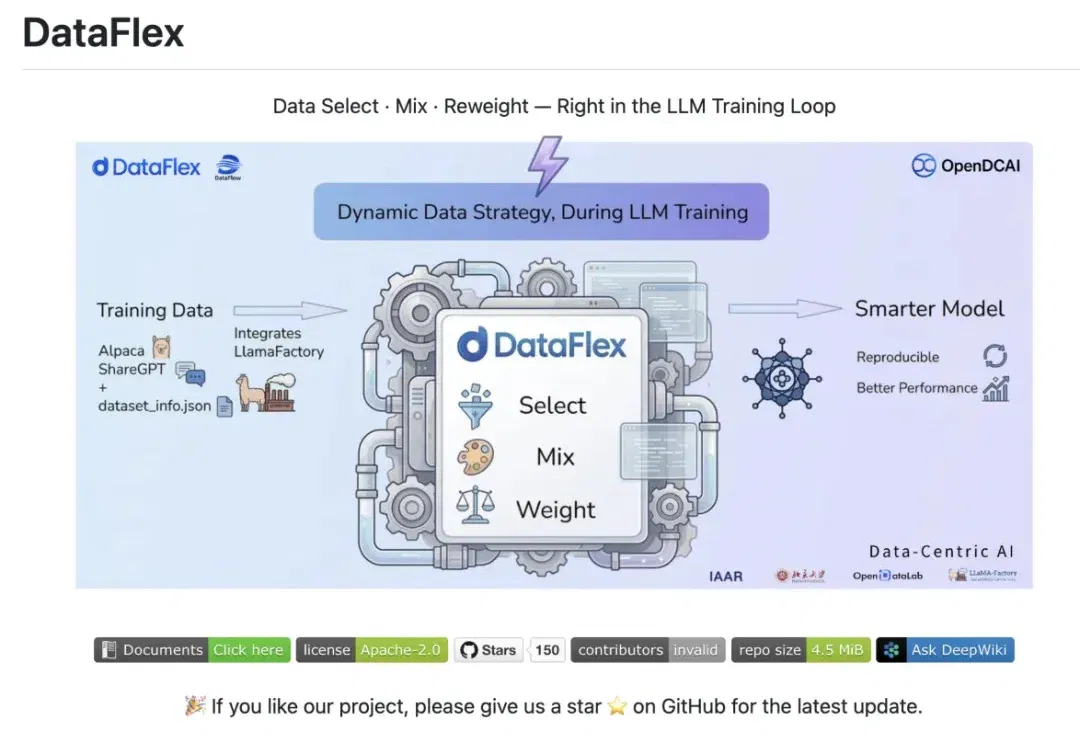
当大模型训练进入深水区,竞争的关键已经不再只是「模型参数怎么调」,而逐渐转向一个更核心、也更难系统解决的问题:模型在训练过程中究竟看到了什么数据、以什么比例看到、哪些样本应该被更频繁地学习。
新一代代码模型的训练动态已与旧模型截然不同,主流强化学习方法和数据集在其上几乎“失效”。