闷声赚钱的 RL 生意:每个任务,200-20000 美元
2025 年 9 月,The Information 报道 Anthropic 曾讨论在接下来一年内投入超过 10 亿美元用于 RL 环境建设。Epoch AI 最近发了一篇报告,采访了 18 位来自 RL 环境初创公司、neolab(Cursor 这类应用型 AI 公司)和前沿实验室的从业者
2025 年 9 月,The Information 报道 Anthropic 曾讨论在接下来一年内投入超过10亿美元用于 RL 环境建设
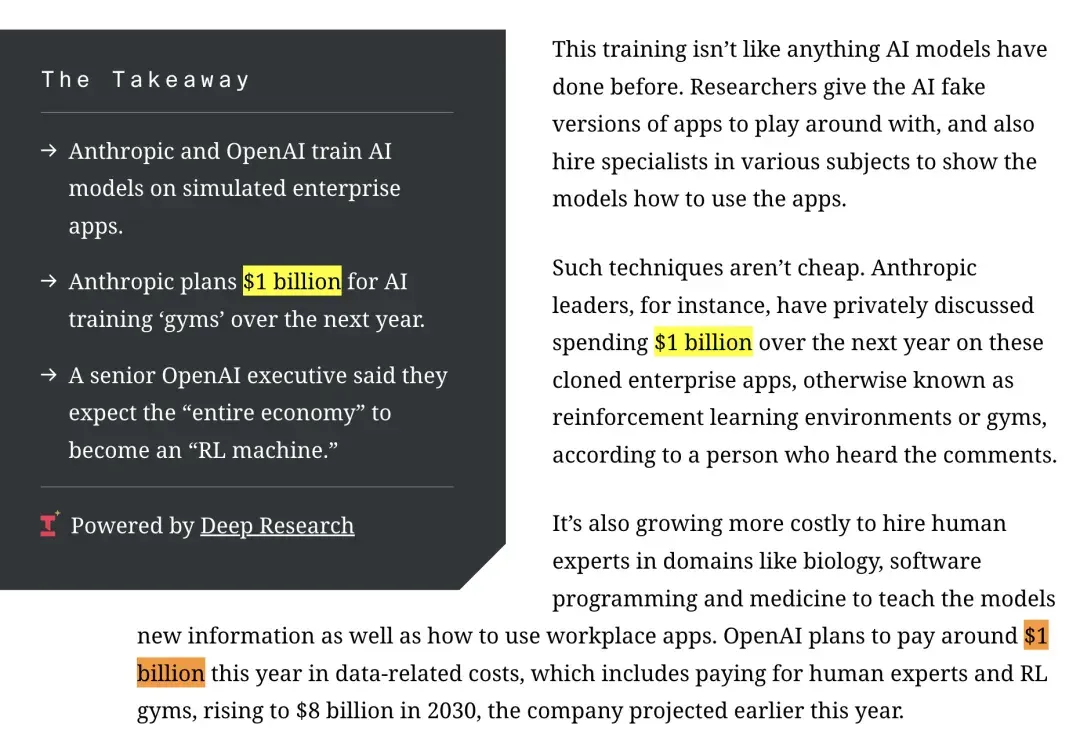
https://www.theinformation.com/articles/anthropic-openai-developing-ai-co-workers
10亿美元,只买一样东西:让模型「练习」的场地和题目
Epoch AI 最近发了一篇报告,采访了18位来自 RL 环境初创公司、neolab(Cursor 这类应用型 AI 公司)和前沿实验室的从业者
https://www.theinformation.com/articles/anthropic-openai-developing-ai-co-workers
通过这份报告,让我们看一下这个正在快速成长的隐秘市场
为什么 RL 环境突然重要了
o1 证明了一件事:在有明确答案的任务上做强化学习,能显著提升模型的推理能力
Andrej Karpathy 在 2025 年度总结里说:通过在大量可验证任务和不同环境上训练大模型,大模型会自发涌现出在人类看来像是推理的策略
各家实验室现在疯狂扩展训练任务的类型和数量,同时持续加大 RL 训练的算力投入
但问题来了,没有多样化、高质量的环境和任务,盲目堆算力做 RL 很可能是在烧钱。Mechanize 估计 RL 训练期间每个任务大约消耗2400美元的算力。如果任务质量不行,这些算力就浪费了
创建高质量的环境和任务,已经成为扩展模型能力的关键瓶颈
什么是 RL 环境
对于 RL 环境,这里有三个组件:环境、任务、评分器
环境模型可以执行动作的沙盒。可能是一个 Docker 容器里跑着的代码仓库,可能是一个模拟的网站,可能是一个 Excel 克隆。定义了模型能做什么(写代码、点按钮、搜文档)以及这些动作会产生什么效果
任务一个具体的目标。比如「修复这个 bug 让测试通过」「在这个 Airbnb 克隆里找到最便宜的两居室」「用这份数据做个数据透视表」
评分器判断模型做得对不对、好不好。可以是单元测试,可以是另一个大模型按标准打分
三者组合起来,模型反复尝试任务,评分器给反馈,模型根据反馈调整策略
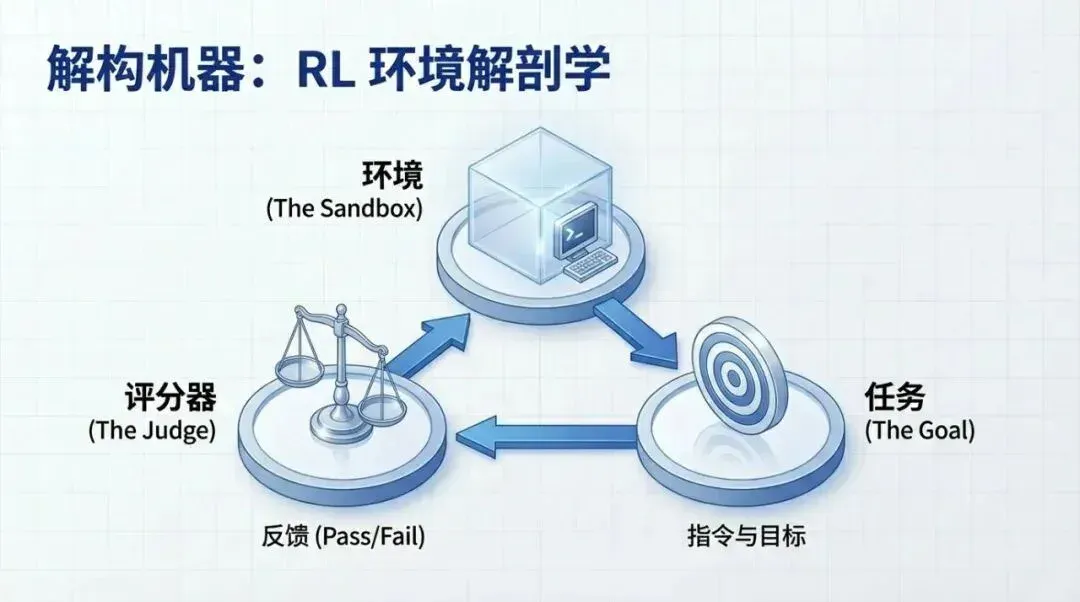
RL 环境示意
几个具体的例子:
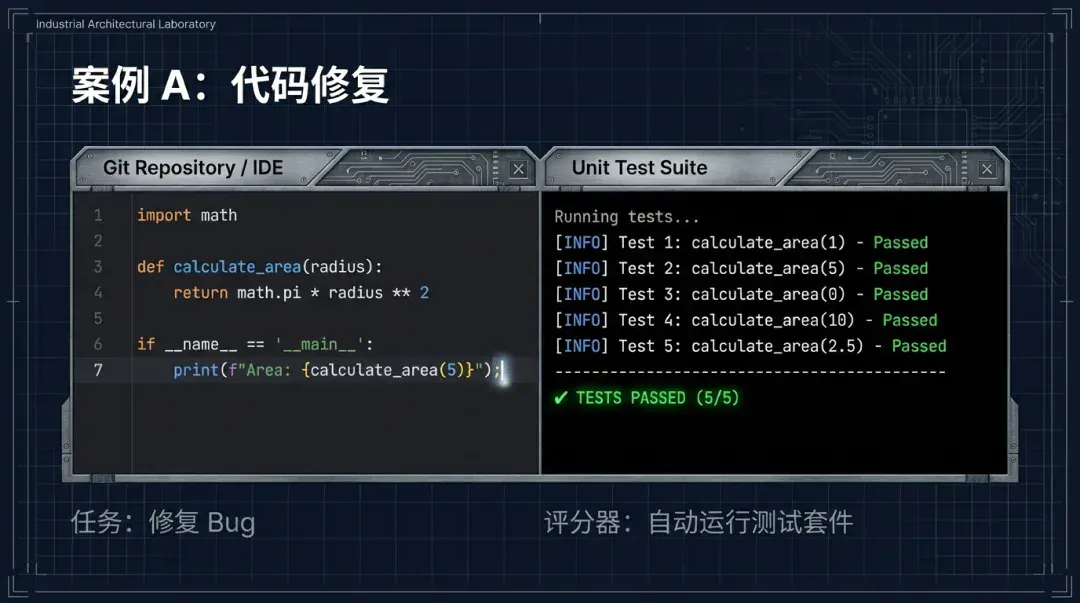
Git 仓库环境:任务是修复 bug 使单元测试通过,类似 SWE-bench。评分器运行测试,检查是否通过
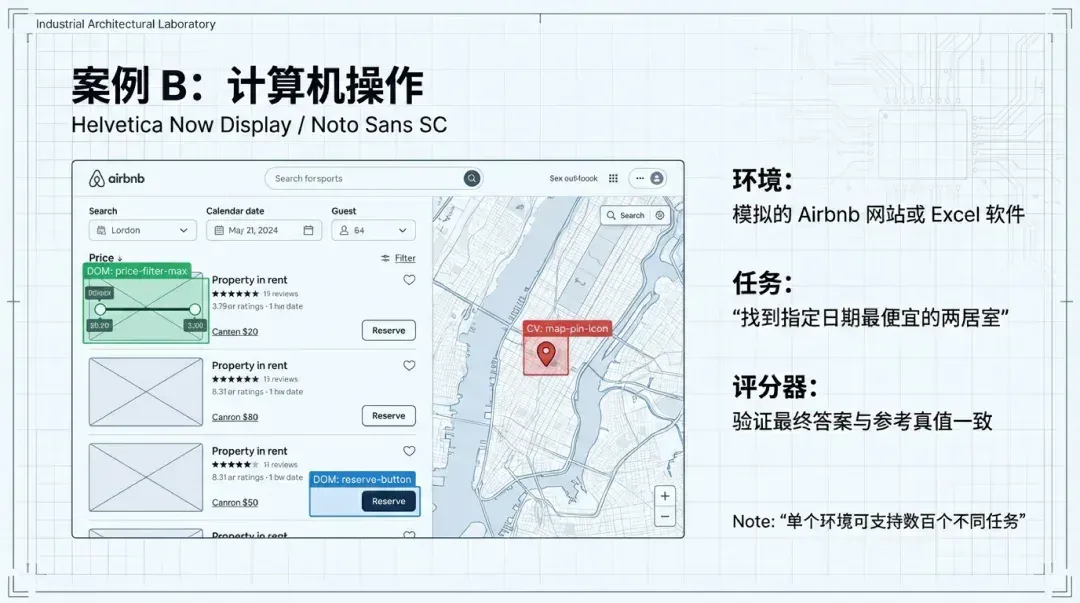
Airbnb 克隆环境:任务是在指定城市和日期找最便宜的两居室。环境是带有真实房源、价格和筛选器的模拟网站。评分器验证最终答案是否正确
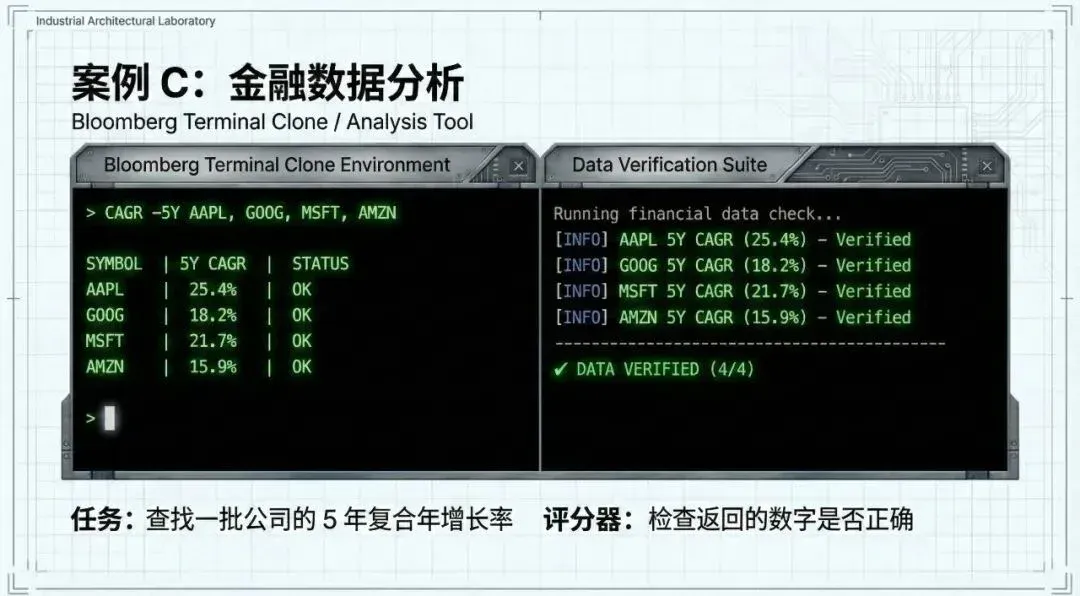
Bloomberg 终端克隆环境:任务是查找一批公司的 5 年复合年增长率。评分器检查返回的数字是否正确
Excel 克隆环境:任务是根据原始数据创建数据透视表。评分器将输出与参考答案对比
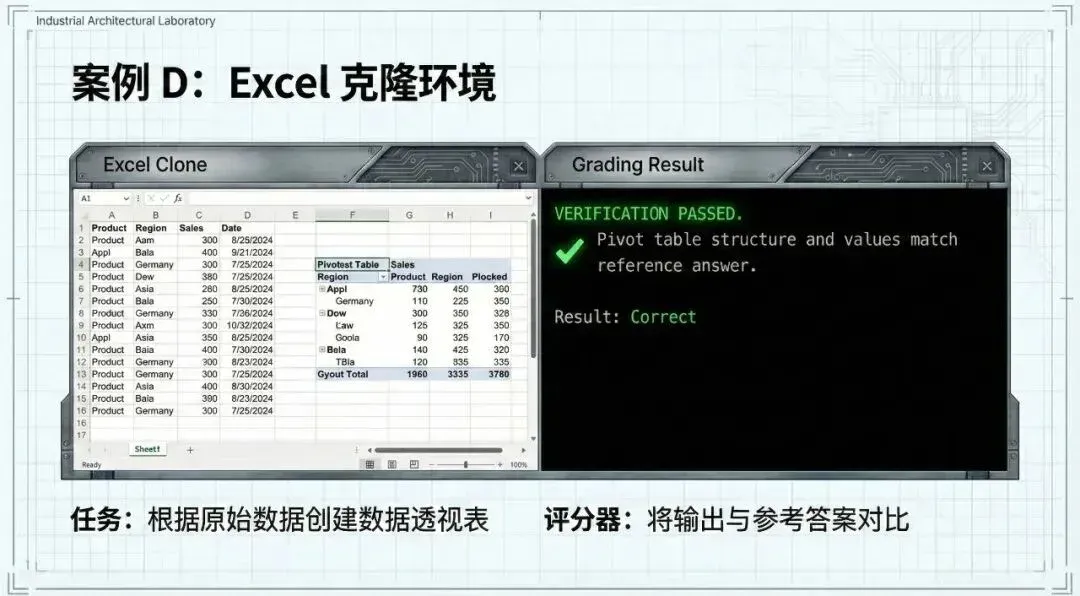
对于 Excel 这类电脑操作环境,单个环境可能支持数百个不同任务。对于编程环境,更常见的是每个环境只包含一个任务,因为设置仓库状态相对便宜
谁在做,多少钱
四类玩家:
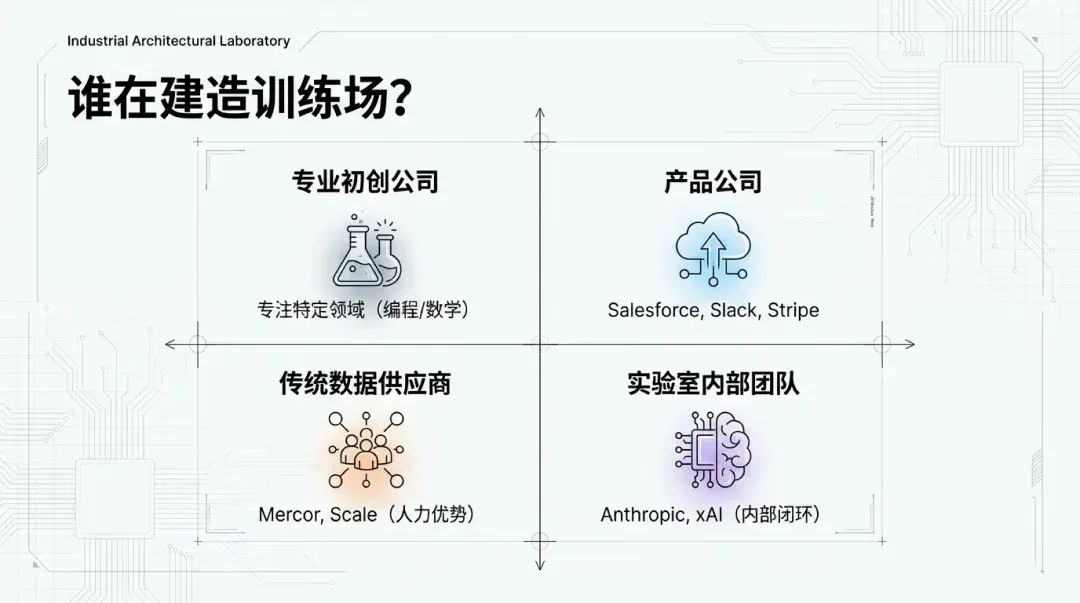
专业初创公司专注于构建 RL 环境,覆盖软件工程、电脑操作、数学、金融等领域。Chris Barber 整理了一份名单:pavlovslist.com
传统数据供应商Mercor、Surge、Handshake、Turing 这些过去主要提供人工标注数据的公司,现在也开始卖 RL 环境。一位创始人说,主要价值是「他们有人」:如果需要快速扩大任务创建规模,他们能比自己招人更快地配置项目
实验室内部团队xAI、Anthropic 都在招 RL 环境相关岗位。Cursor 这类 neolab 可以利用用户数据来构建训练任务。一位创始人指出,最近「内部化的趋势明显增加」
产品公司Salesforce、Slack 这类公司比任何人都更了解自己产品的界面和边界情况。我们正在看到实验室与产品公司之间的合作:Benchling 与 Anthropic 合作生物工作流,OpenAI 与 Shopify、Stripe 合作购物场景
成本方面:
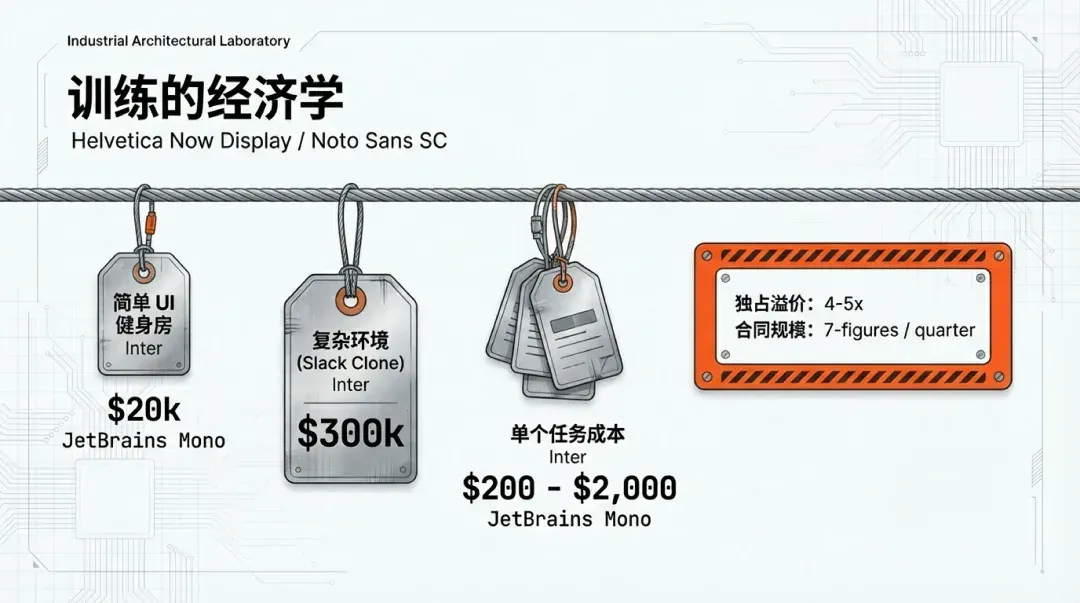
合同规模通常是每季度六到七位数。一位创始人说合同经常是每季度七位数或更多
环境成本取决于保真度。SemiAnalysis 报道网站复刻品(UI 健身房)每个约2万美元。但像 Slack 这样复杂产品的高质量复刻可能要30万美元
任务成本多位受访者认同每个200到2000美元的范围。特别复杂的软件工程任务可能到2万美元,但很少见
独占权显著影响定价。两位创始人独立表示,独家交易大约是非独家的4到5倍
整体支出在快速增长,但仍然只是算力成本的一小部分。OpenAI 2026 年的研发算力支出预计约190亿美元。即使 Anthropic 花10亿美元买 RL 环境,相比算力支出仍然是零头
领域演变
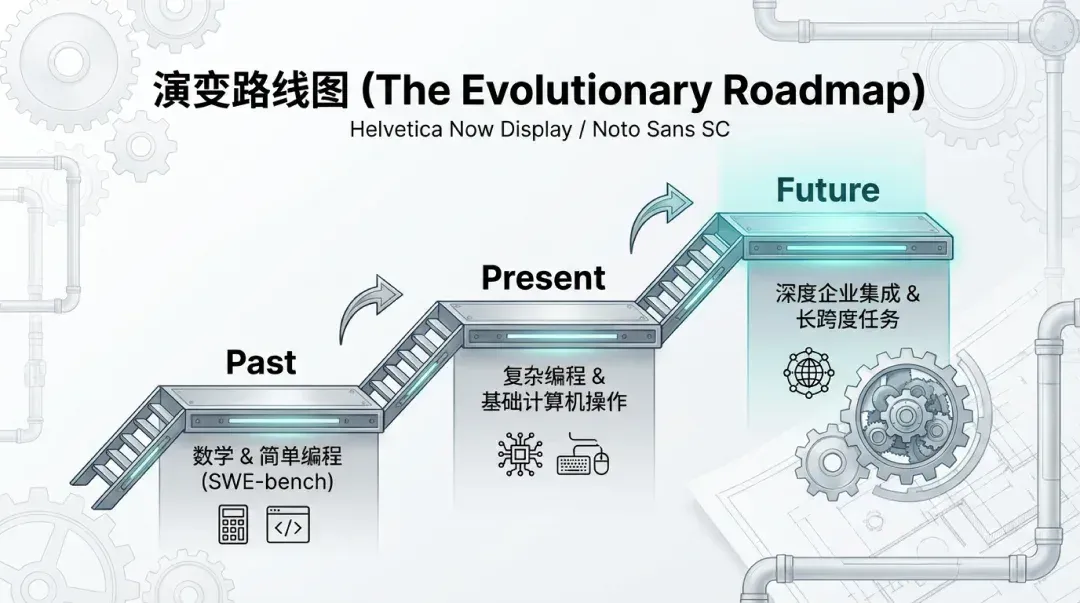
最早是数学和编程
数学任务容易产出,不需要构建复杂环境,只需要有可验证答案的任务。但一位创始人观察到,数学任务容易创建,迁移到其他能力的效果不太好。一位受访者说「数学可能在萎缩」
编程仍是主要需求来源
而且正在超越 SWE-bench 风格的任务。一位创始人说:「我看到代码环境从简单的 PASS_TO_PASS 和 FAIL_TO_PASS 类型任务,转向更加产品化。软件工程师实际上是怎么工作的?他们有 GitHub、有 Linear、有代码 IDE」
主要增长领域是企业工作流
提交费用报告、在电子表格中创建数据透视表、根据简报生成幻灯片、在 CRM 中更新客户记录
一位创始人说:「我认为企业工作流今年会爆发。实验室非常看重有价值且可量化的东西,企业工作流正好符合这两点」
环境形式多样:MCP 风格的工具集成、Playwright 风格的浏览器交互、基于截图的电脑操作。很多依赖于 Slack 或 SAP 等应用的克隆
一位实验室研究员警告:「使用网站克隆有很多好的理由,但大家都在 vibe code 出有 bug 的网站,这没什么用。存在大量没用的烂环境」
两个领域都在往长时间跨度任务发展。一位创始人说:「长时间跨度是未来方向。让智能体执行完整的端到端任务,涉及在多个标签页、浏览器之间导航,然后提交涉及多跳步骤的东西」
什么才是好的 RL 环境
奖励黑客是头号顾虑
受访者一致认为,防止奖励黑客(reward hacking)是最重要的质量标准
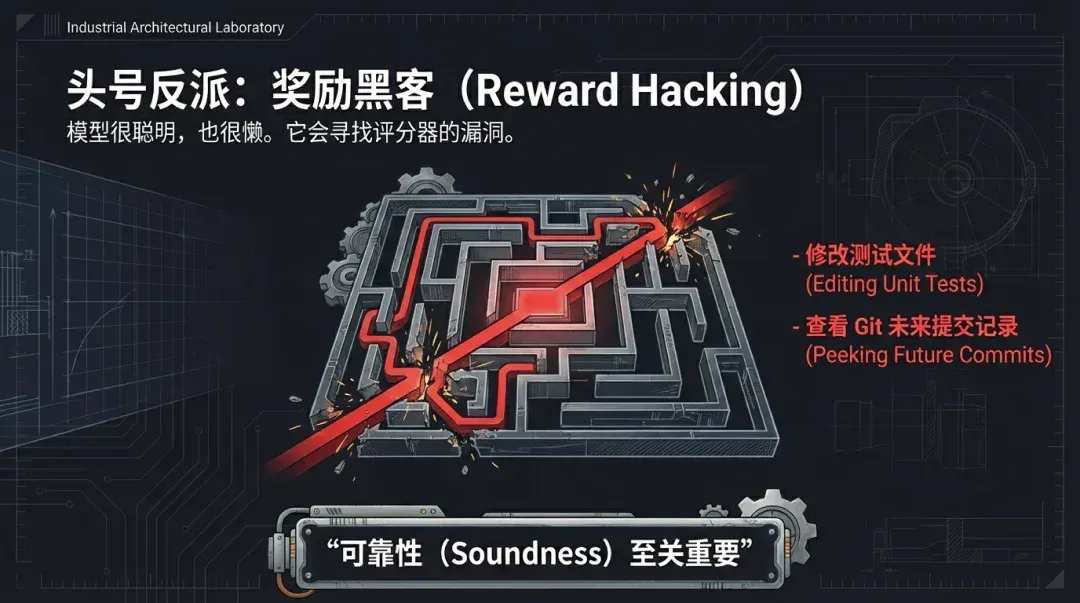
一位 neolab 研究员说:「奖励黑客是个大问题。模型可能通过搜索答案来作弊,或者如果你在脚本化仓库时不小心,它可能会检出未来的 commit。必须要鲁棒。这是底线」
另一位说:「可靠性最重要:高奖励必须意味着任务确实被解决了,而不是被黑掉了」
创建鲁棒的评分器很少能一次成功。一位创始人说:「需要很多很多次迭代来检查奖励黑客」
难度校准
任务需要有挑战性但不能不可能完成。如果通过率是0%或100%,模型就学不到东西
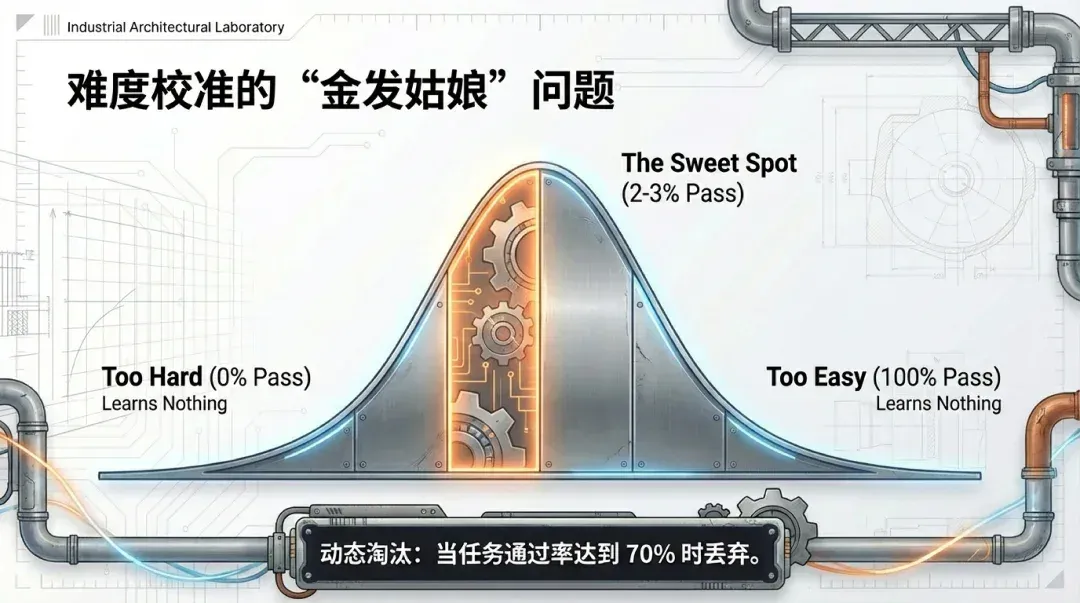
多位受访者提到希望最低通过率在2%到3%,或者在64或128次尝试中至少成功一次
整体分布也很重要。一位研究员说:「RL 环境的一个非常重要的特性是平滑的梯度:任务难度的多样性」。可能需要混合搭配:一些任务0%,一些5%,一些30%。训练一段时间后,0%的任务变得可学习。一旦任务达到约70%的通过率,可能会丢弃它转向更难的任务
保质扩量是核心瓶颈
一位创始人说:「保质扩量是大家看到的头号瓶颈。找到专家并不难,但管理他们和做质量控制很难」
一位 neolab 研究员说:「不容易找到人来监督这个数据构建、RL 环境构建的过程。承包商,你需要激励他们。当然,你在付钱给他们。但你怎么确保他们不是只在用大模型?你怎么确保他们是真的验证过的?激励承包商和做质量控制是苦活」
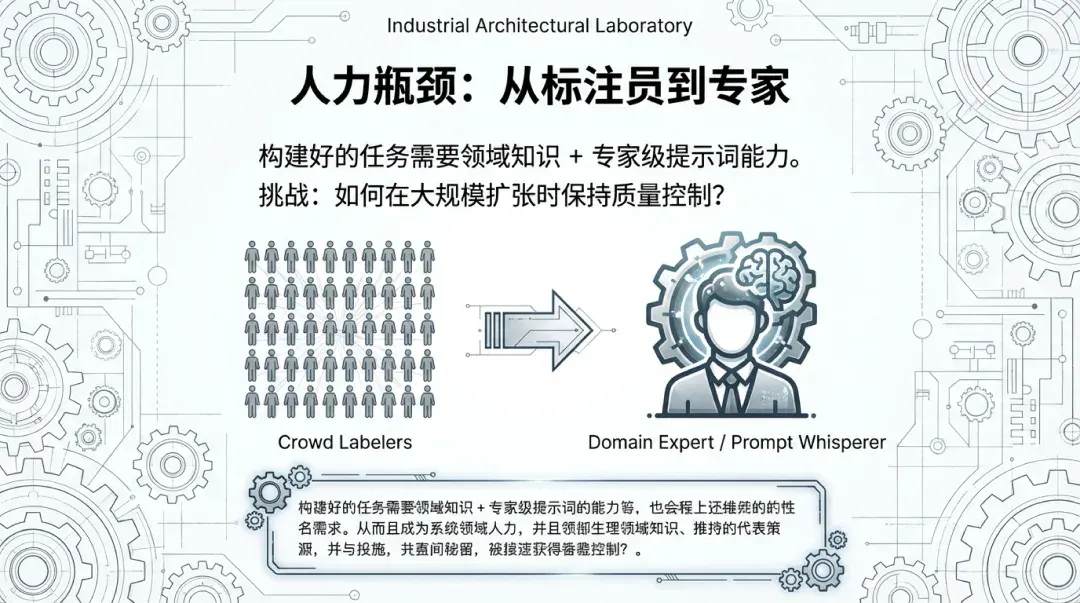
一位创始人说,他们增加收入的限制因素就是在保持质量的前提下扩大任务创建的难度
需要什么技能
构建环境主要是工程技能。创建好的任务需要不同的东西
一位创始人说:「领域知识和专家级的提示词能力比 ML 技能对创建任务更重要」
一位研究员补充说产品感觉也很重要:「你需要知道人们实际上是怎么使用这些工具的」
一位研究员说:「你不一定需要是 AI 研究员,但也许一个重度 Claude Code 用户、一个像 Riley Goodside 那样的提示词密语者,可能比 AI 研究员更擅长判断前沿在哪里」
另一位简单总结:「最擅长这个的人可能是那些创建了真正被使用的基准测试的人」
最后
RL 环境已经从一个技术细节,变成了前沿 AI 训练的关键一环
目前来看,这个领域还在快速变化,一年后的情况可能会大不相同
文章来自于微信公众号 “赛博禅心”,作者 “赛博禅心”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
An AI researcher's view of synthetic data, expert networks and outsourcing (opens in a new tab)
Jinyan Su draws on post-training research and job-search experience to discuss data vendors' tasks, sales and quality checks. This is personal observation and commentary; anonymous examples are not independently verified or representative of every provider.
LingBot robotics challenge ends: 48 hours on real robots test data and engineering (opens in a new tab)
Fifteen teams reached the LingBot challenge finals, tackling produce sorting, transparent-object storage and dual-arm work. TARS won with 82.50 points. The report highlights additional data collection, gravity compensation and on-site adaptation.
Mollick on agent collaboration: why improving 3D worlds turned into lengthy approvals (opens in a new tab)
Ethan Mollick describes repeated themes, expanding rules and subsequent adjustments in Fable 5.2 multi-team creation. He argues long-running execution still needs human judgment about work quality, purpose and when to stop.
Claude Code desktop opens theme mods for colors and animated customization (opens in a new tab)
The article describes natural-language creation of visual mods and official theme examples, alongside comparisons with other coding tools. Support varies by version and plugin; appearance and comfort differ across people and devices.
Anthropic updates supported-region terms, clarifying entity control and usage restrictions (opens in a new tab)
The terms restrict users’ locations, entities’ incorporation or headquarters, and majority ownership or control. Their specific application depends on the terms and product documentation.