刚刚,腾讯姚顺雨署名首篇论文发布,「下半场」先搞上下文学习(在新窗口打开)
不久前在 AGI-Next 前沿峰会上,姚顺雨曾分享过一个核心观点:模型想要迈向高价值应用,核心瓶颈就在于能否「用好上下文(Context)」。
内容栏目
分享不同 AI 工具、模型与相关技术的使用方法和实践文章。
不久前在 AGI-Next 前沿峰会上,姚顺雨曾分享过一个核心观点:模型想要迈向高价值应用,核心瓶颈就在于能否「用好上下文(Context)」。
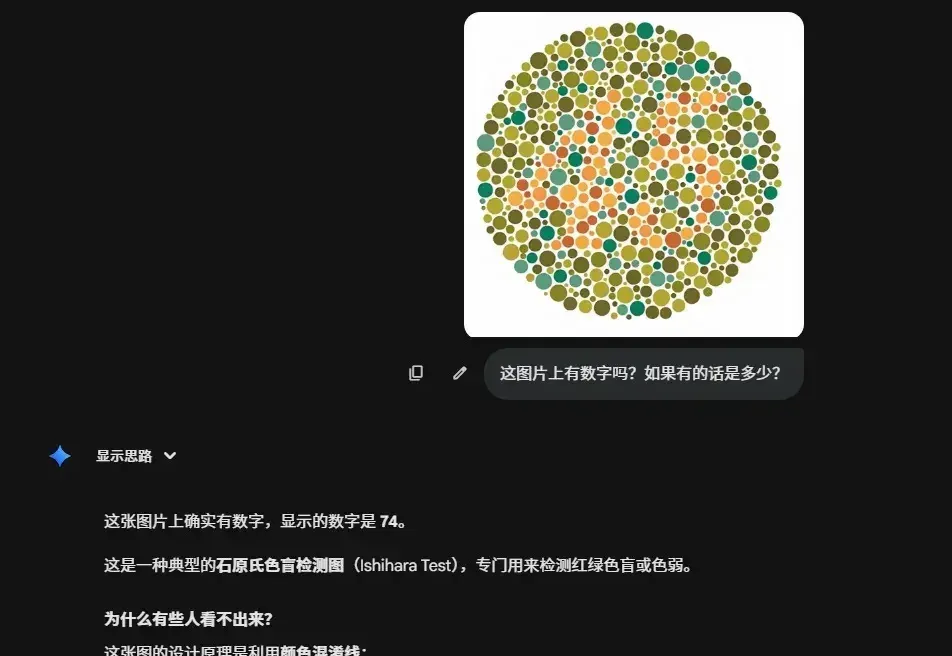
AI,是色盲吗? 这个问题听起来很蠢。 毕竟现在的AI能识别人脸、读懂图片、生成图像,甚至可以按RGB色值给你改颜色。 怎么可能是色盲,看不见颜色呢? 但最近发生的一件事,让我开始开始觉得,这事不对。。。 昨天正好在办公室和同事闲聊,聊到了颜色,我们刚来的实习生小朋友说,说他是红绿色盲,然后我们的话题,就不知道怎么就聊到了色盲测试。 在现场找了几张图一起测试, 就那种一堆小点点里藏数字的图。 能看到的兄弟们可以把数字回复在公屏上。 我们那个实习生小朋友,居然真的有看不见的。 当时大家还挺欢乐的,说,要不然,发给AI看看。 然后我们就发了,本来觉得,这么明显的数字,对现在这种级别的AI来说,肯定
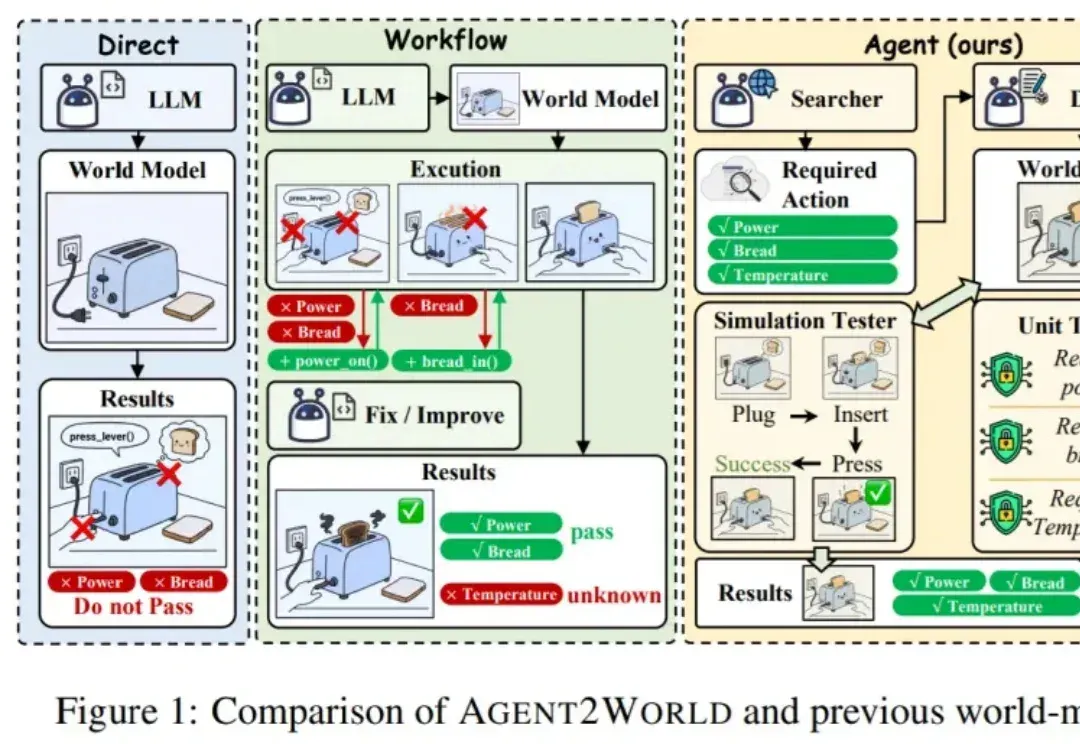
让模型真正 “能行动”,往往需要一个可执行、可验证的符号世界模型(Symbolic World Model):它不是抽象的文字描述,而是能被规划器或执行器直接调用的形式化定义 —— 例如 PDDL 领域 / 问题,或可运行的环境代码 / 模拟器。
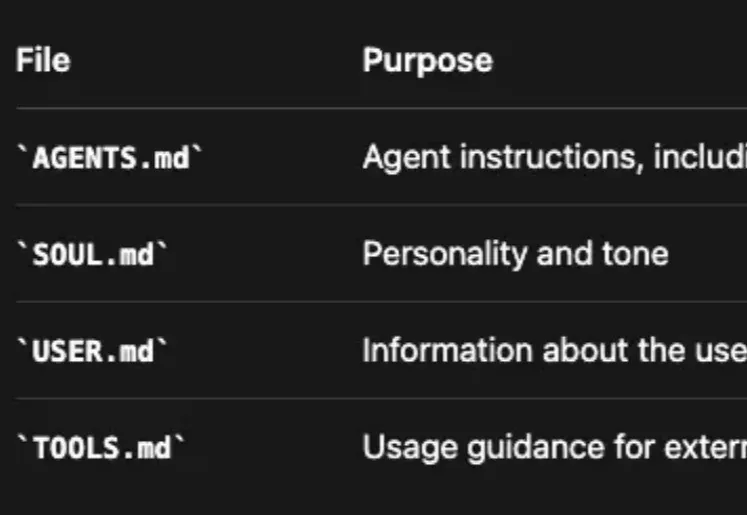
Clawdbot(现改名为 OpenClaw) 体验下来,持久的记忆管理系统很是让人惊艳——全天候保持上下文,无限期地记住对话并在此基础上持续深化互动。
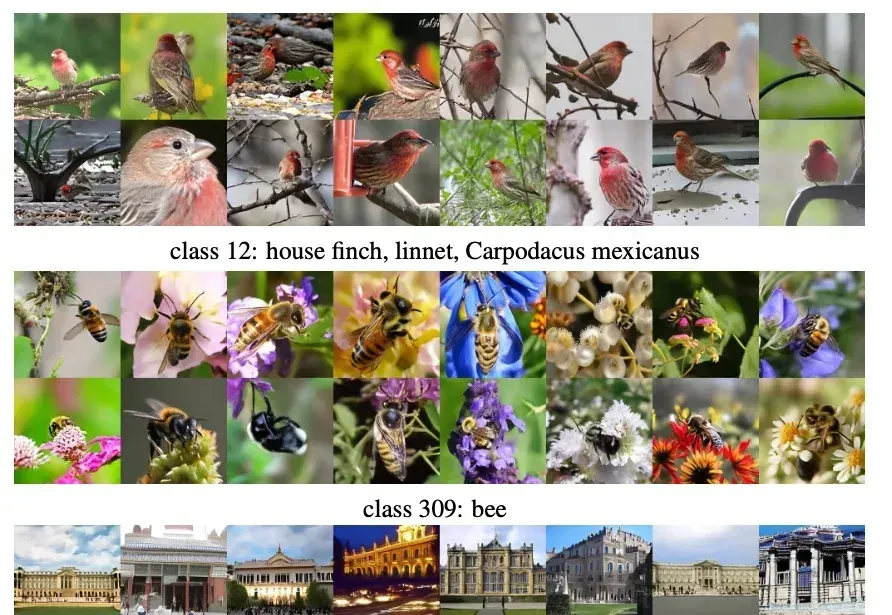
何恺明,再次出手精简架构。 新方法Pixel Mean Flow(pMF),突破传统扩散模型/流模型限制。 两大传统组件多步采样和潜空间都被砍了,现在只需一步,直接在像素空间生成图像。 在ImageNet 256×256分辨率上,pMF达到了2.22 FID;512×512分辨率上则是2.48 FID。这是目前单步、无潜空间扩散模型在该基准上取得的最佳成绩之一。 砍掉扩散模型的两大件 现代扩散模型生成图像,一直离不开多步采样和潜空间编码。 多步采样意味着生成一张图需要跑几十甚至上百次神经网络,潜空间则需要先把图像压缩到一个低维空间再进行操作。两者的共同目的是把一个极度复杂的生成问题拆解成若干个
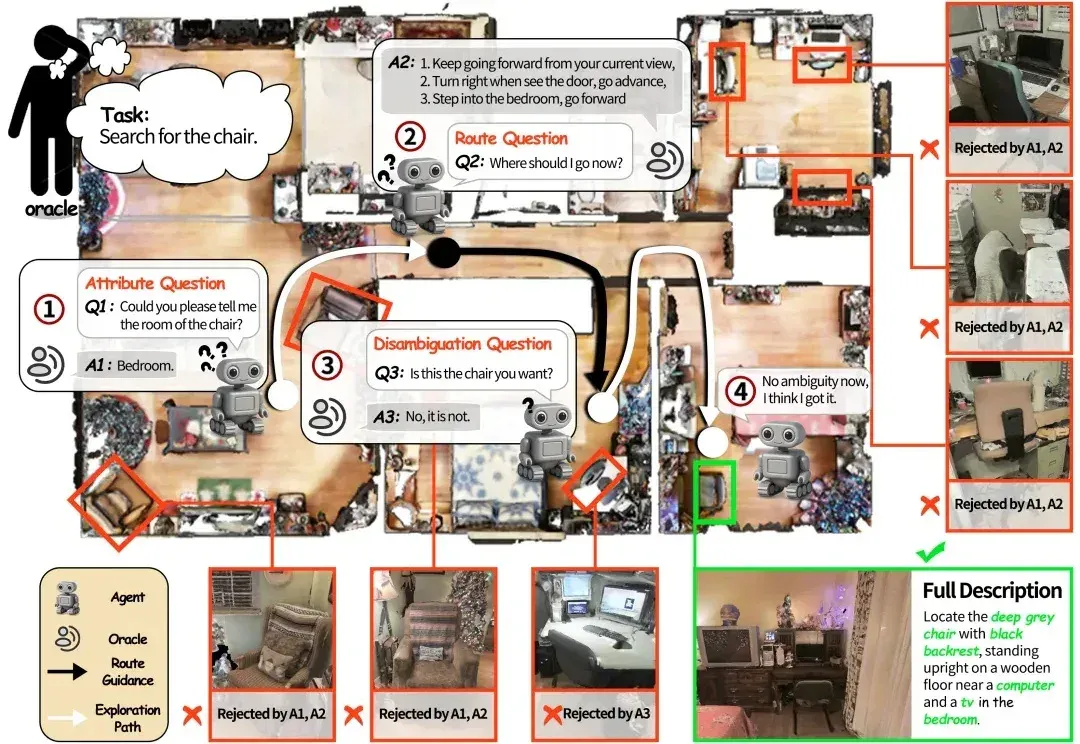
如果将一台在视觉语言导航(VLN)任务中表现优异的机器人直接搬进家庭场景,往往会遇到不少实际问题。
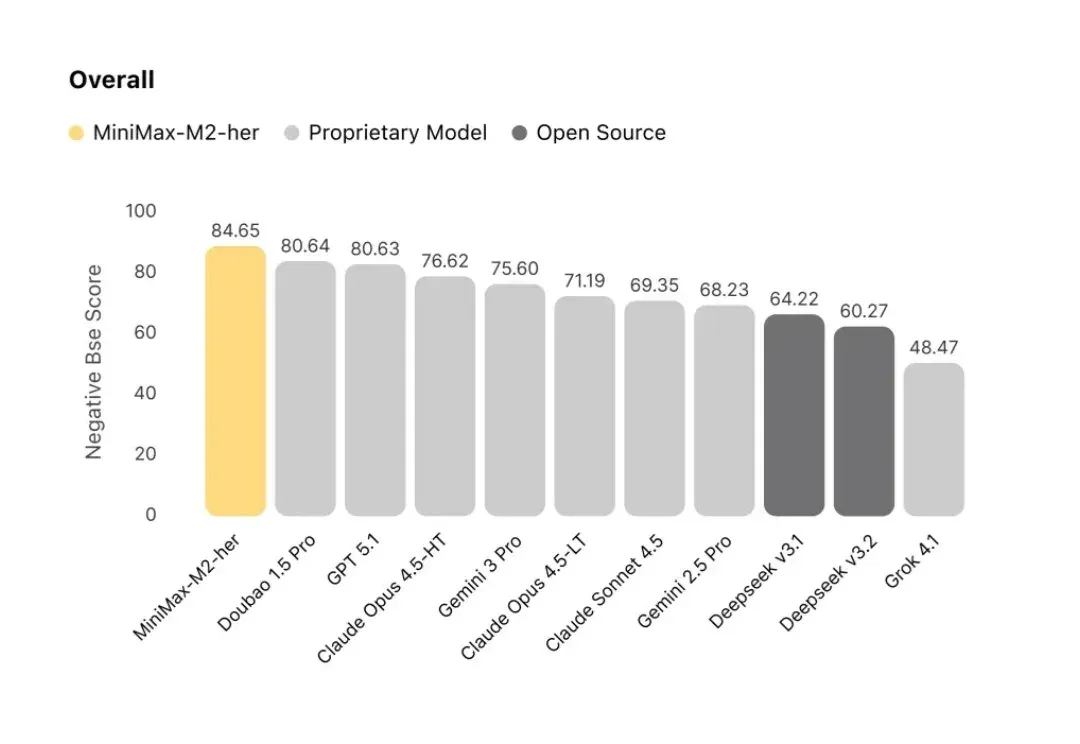
今天,我们分享 MiniMax-M2-her 背后的技术思考。M2-her 也是服务星野/Talkie的底层模型。
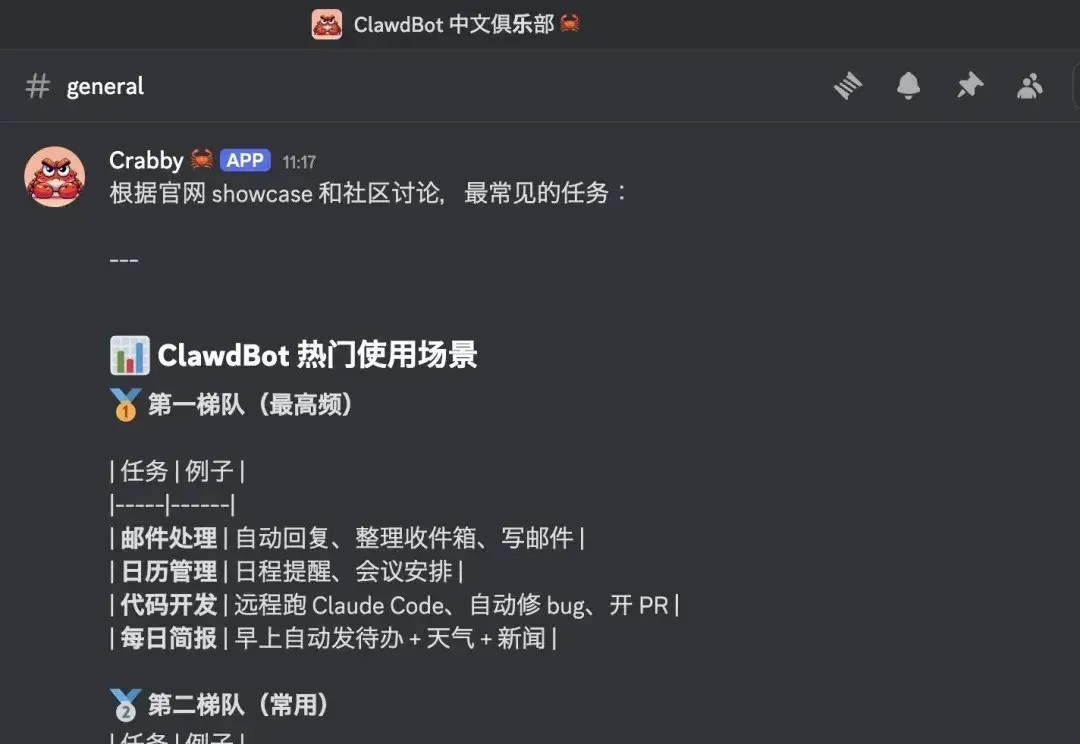
起因是这样的, 当我还在跟Mac Mini版满血版Clawdbot PK的时候,发现有人统计了排名前十的Clawdbot常见任务,分别是邮件处理,日历管理(日程提醒和会议安排),控制Claude Code开发,每日简报等,
语析Yuxi-Know 是基于大模型RAG知识库与知识图谱技术构建的智能问答平台,支持多种知识库文件格式,如PDF、TXT、MD、Docx,支持将文件内容转换为向量存储,便于快速检索。
▲图片由AI生成 一场押注AI未来的技术豪赌。 智东西2月1日报道,北京时间1月29日,北京智源人工智能研究院推出的多模态大模型“悟界·Emu”登上Nature正刊,成为继DeepSeek之后第二个达成此成就的中国大模型团队研究成果,也是中国首篇围绕多模态大模型路线的Nature论文。 ▲Nature官网截图 Nature编辑点评道:“Emu3仅基于‘预测下一个token’实现了大规模文本、图像和视频的统一学习,其在生成与感知任务上的性能可与使用专门路线相当,这一成果对构建可扩展、统一的多模态智能系统具有重要意义,有望推动原生多模态助手、世界模型以及具身智能等方向的发展。” ▲Emu3有望推动
一张薄如纸片、能卷在手指上的柔性芯片(不是柔性印刷电路板,是柔性集成电路),能做什么?
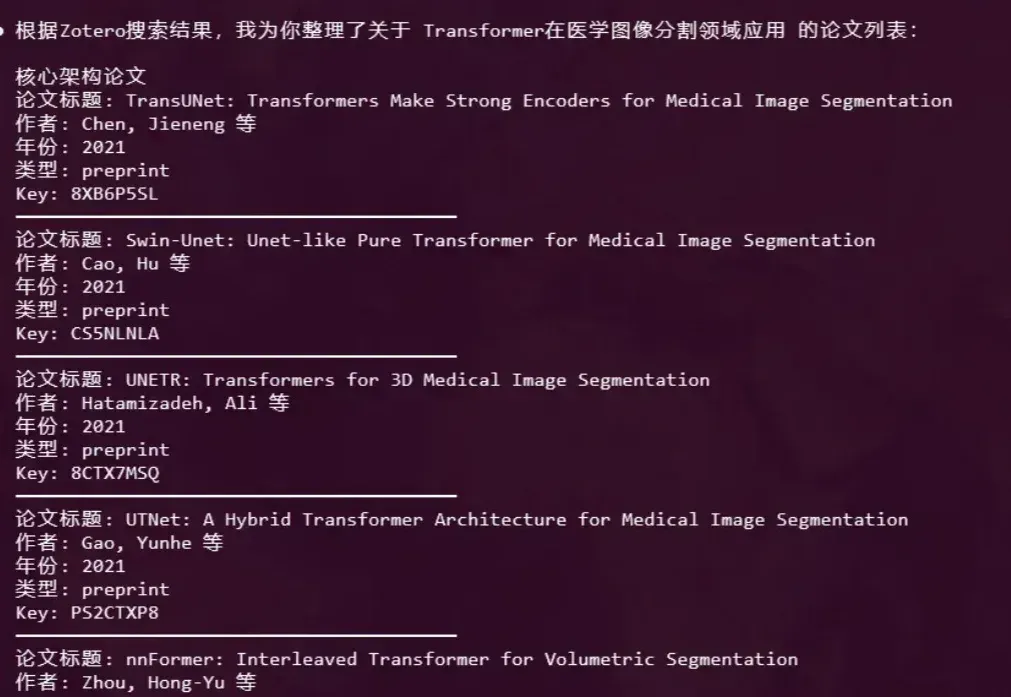
大家好,我是鲁工。 Vibe Coding概念火了之后,顺带在很多领域兴起了Vibe的潮流。比如Vibe PPT、Vibe Video,以及我今天要聊的Vibe Researching。
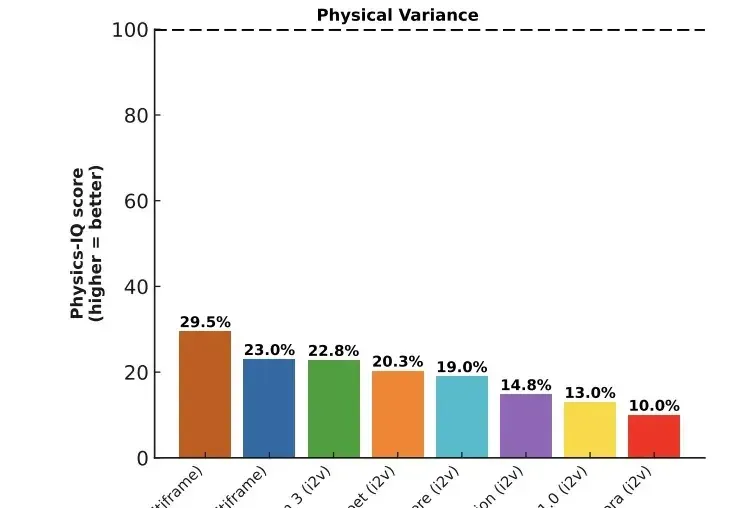
去年下半年,模型界最大的惊喜莫过于Sora 2和Veo 3,他们已经把视频生成推到了新高度:光影完美,纹理细腻,甚至有着很高的时空一致性。
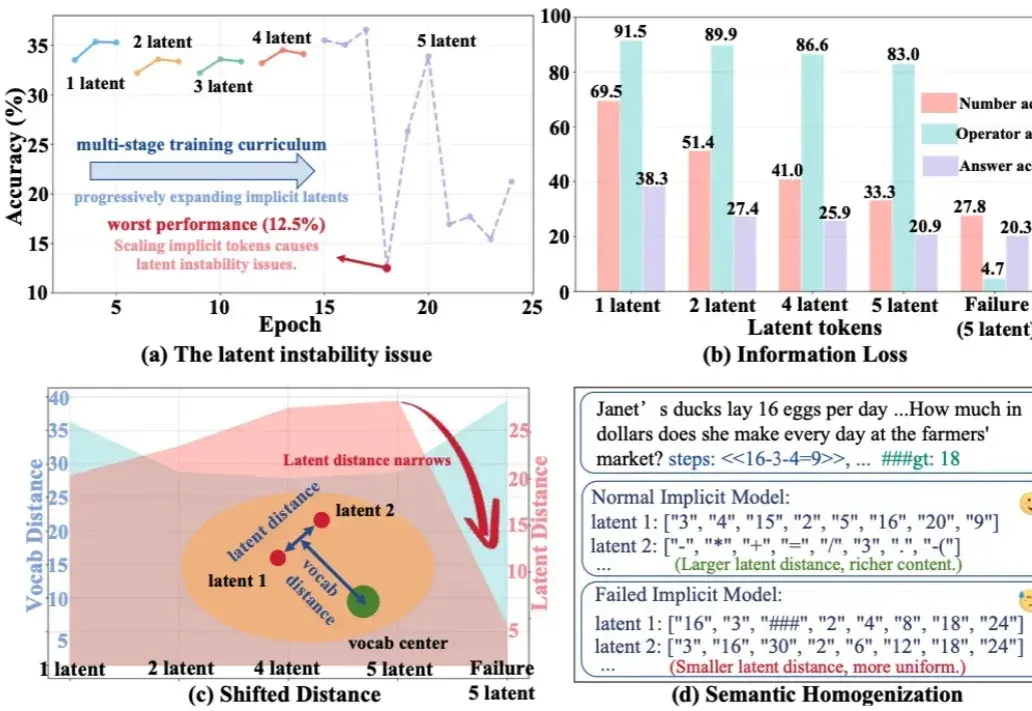
今天推荐一个 Implicit Chain-of-Thought(隐式推理) 的最新进展 —— SIM-CoT(Supervised Implicit Chain-of-Thought)。它直击隐式 CoT 一直「扶不起来」的核心痛点:隐式 token 一旦 scale 上去,训练就容易塌缩到同质化的 latent 状态,推理语义直接丢失。
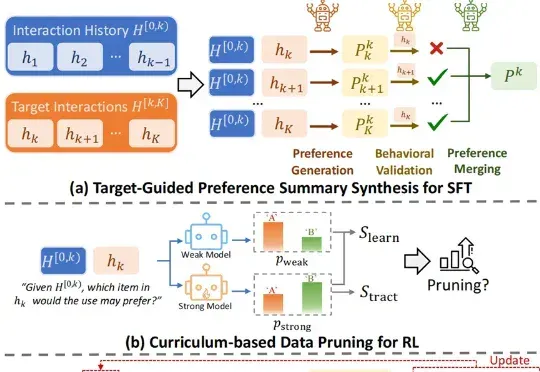
怎样做一个爆款大模型应用?这恐怕是2026年AI开发者们都在关注的问题。当算力和性能不再是唯一的护城河,“爆款”意味着大模型要能精准地“抓住”每一名具体的用户,而个性化正是其中的关键技术之一。
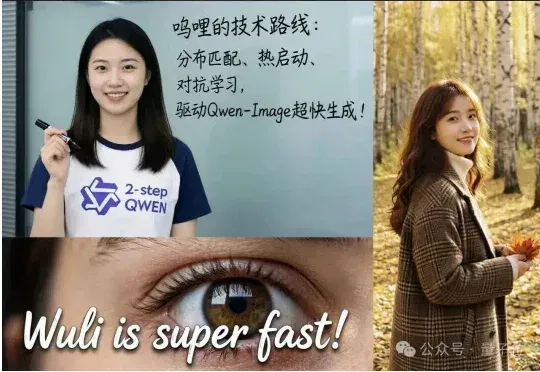
AI生成一张图片,你愿意等多久?在主流扩散模型还在迭代中反复“磨叽”、让用户盯着进度条发呆时,阿里智能引擎团队直接把进度条“拉爆”了——5秒钟,到手4张2K级高清大图。
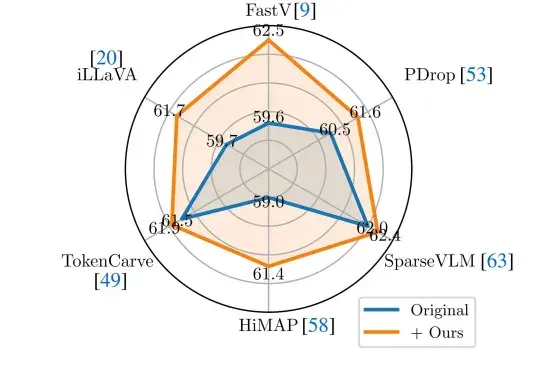
近年来,Vision-Language Models(视觉—语言模型)在多模态理解任务中取得了显著进展,并逐渐成为通用人工智能的重要技术路线。
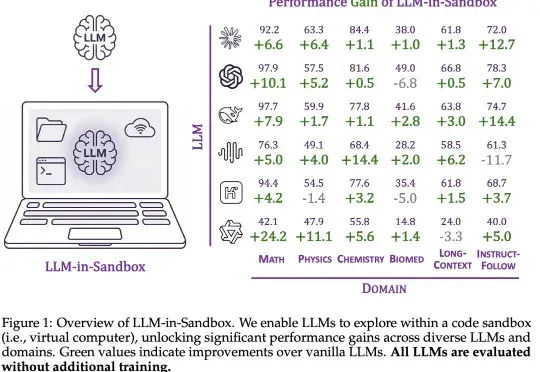
大模型的能力正在被不同的范式逐步解锁:In-Context Learning 展示了模型无需微调即可泛化到新任务;Chain-of-Thought 通过引导模型分步推理来提升复杂问题的求解能力;近期,智能体框架则赋予模型调用工具、多轮交互的能力。
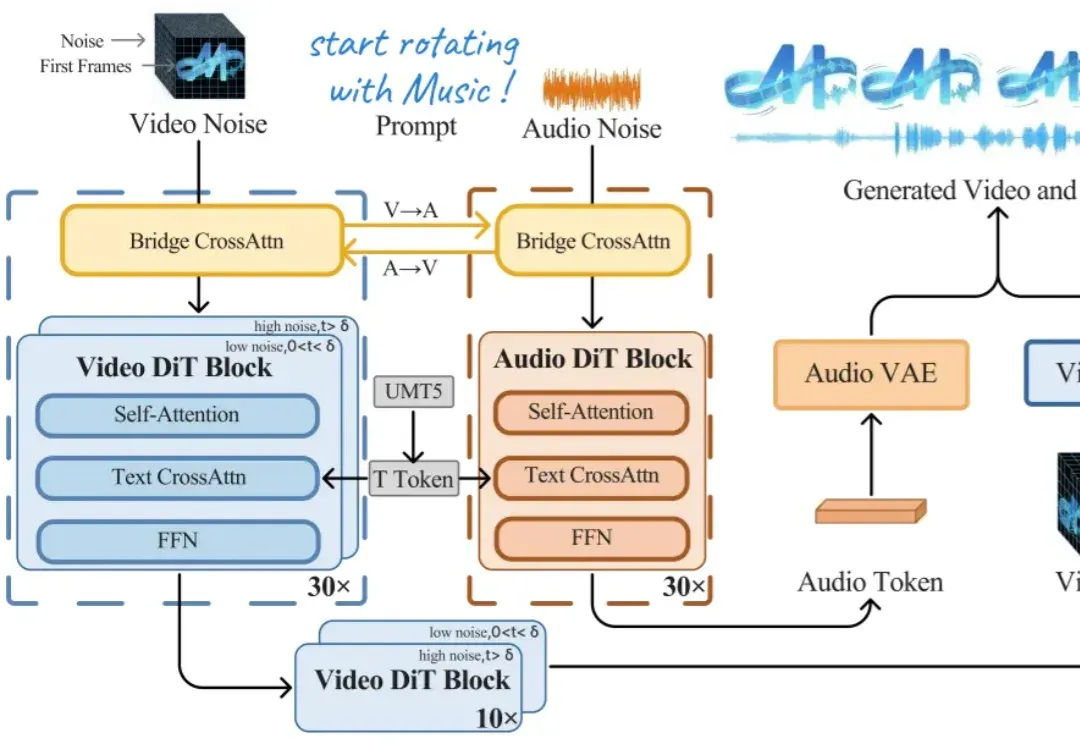
今天上午,上海创智学院 OpenMOSS 团队联合初创公司模思智能(MOSI),正式发布了端到端音视频生成模型 —— MOVA(MOSS-Video-and-Audio)。
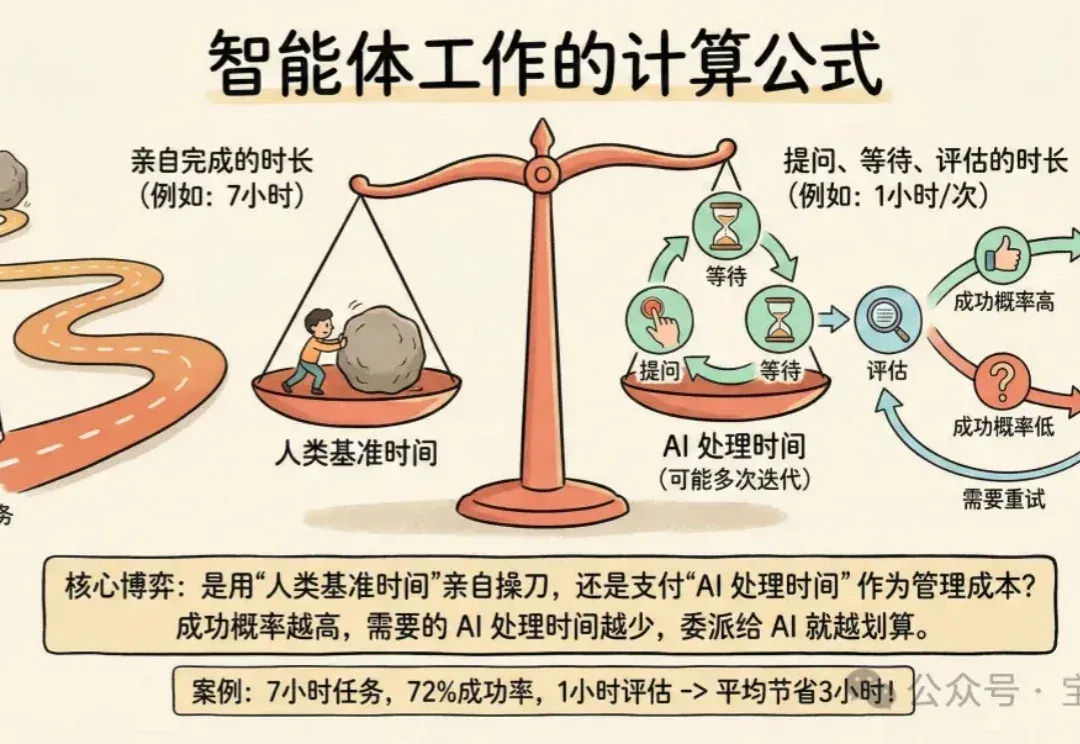
我有个观察:善用 Coding Agent 的人有个共同点——他们擅长定义问题、拆解问题、验收结果。这类人通常有技术管理经验。
参与交流
了解加入交流群的方式,阅读内容无需登录。