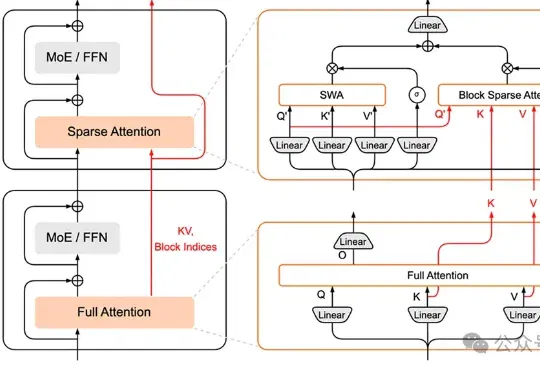
小米给KV Cache减负80%!MiMo团队推出混合稀疏注意力架构(在新窗口打开)
小米MiMo大模型团队,加入AI拜年战场——推出HySparse,一种面向Agent时代的混合稀疏注意力架构。
内容栏目
分享不同 AI 工具、模型与相关技术的使用方法和实践文章。
小米MiMo大模型团队,加入AI拜年战场——推出HySparse,一种面向Agent时代的混合稀疏注意力架构。
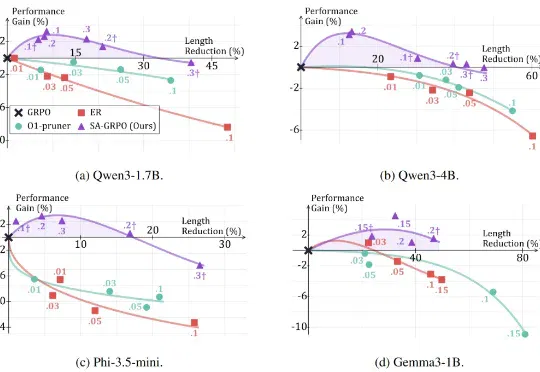
2025 年 1 月 20 日,DeepSeek 发布了推理大模型 DeepSeek-R1,在学术界和工业界引发了对大模型强化学习方法的广泛关注与研究热潮。 研究者发现,在数学推理等具有明确答案的任务
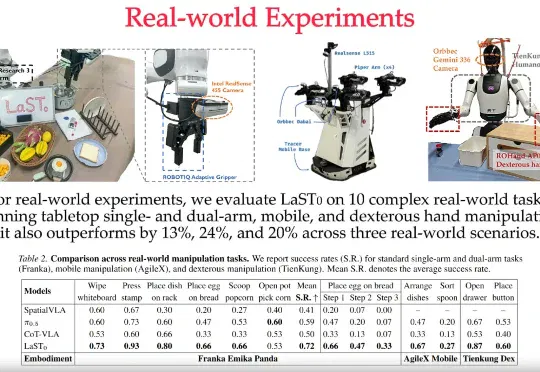
LaST₀团队 投稿 量子位 | 公众号 QbitAI 近日,至简动力、北京大学、香港中文大学、北京人形机器人创新中心提出了一种名为LaST₀的全新隐空间推理VLA模型,在基于Transformer混
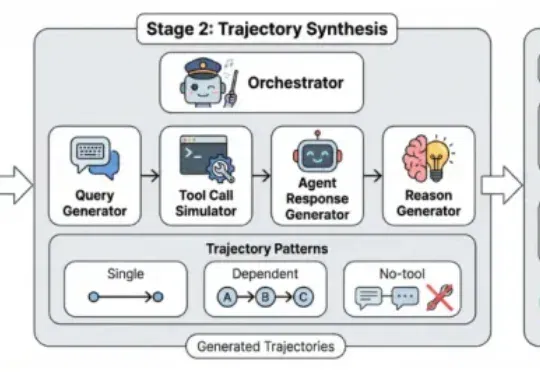
随着 AI 智能体(Agent)能力日益强大,其自主行为带来的安全风险也愈发复杂。现有安全工具往往只能给出「安全 / 不安全」的简单判断,无法告知我们风险的根源。为此,上海人工智能实验室正式开源 Ag
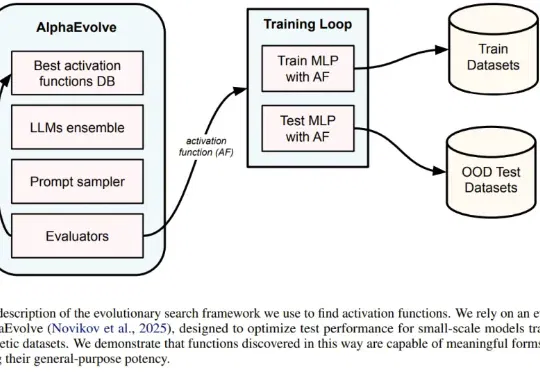
一直以来,神经网络的激活函数就像是 AI 引擎中的火花塞。从早期的 Sigmoid、Tanh,到后来统治业界的 ReLU,再到近年来的 GELU 和 Swish,每一次激活函数的演进都伴随着模型性能的提升。但长期以来,寻找最佳激活函数往往依赖于人类直觉或有限的搜索空间。
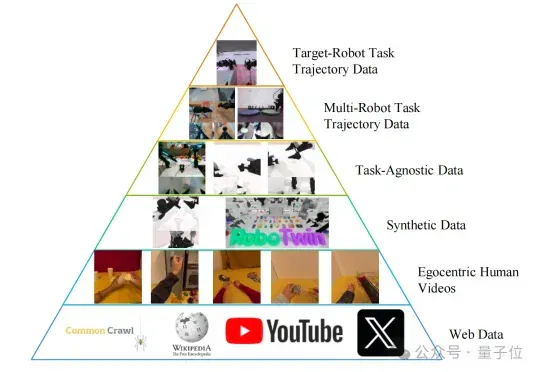
国产开源具身世界模型,直接秒了Pi-0.5,而且还是几位清华硕、博士研究生领衔推出的。这就是由生数科技联合清华大学,正式开源的大一统世界模型——Motus。
过去一年,LLM Agent几乎成为所有 AI 研究团队与工业界的共同方向。OpenAI在持续推进更强的推理与工具使用能力,Google DeepMind将推理显式建模为搜索问题,Anthropic则通过规范与自我批判提升模型可靠性。
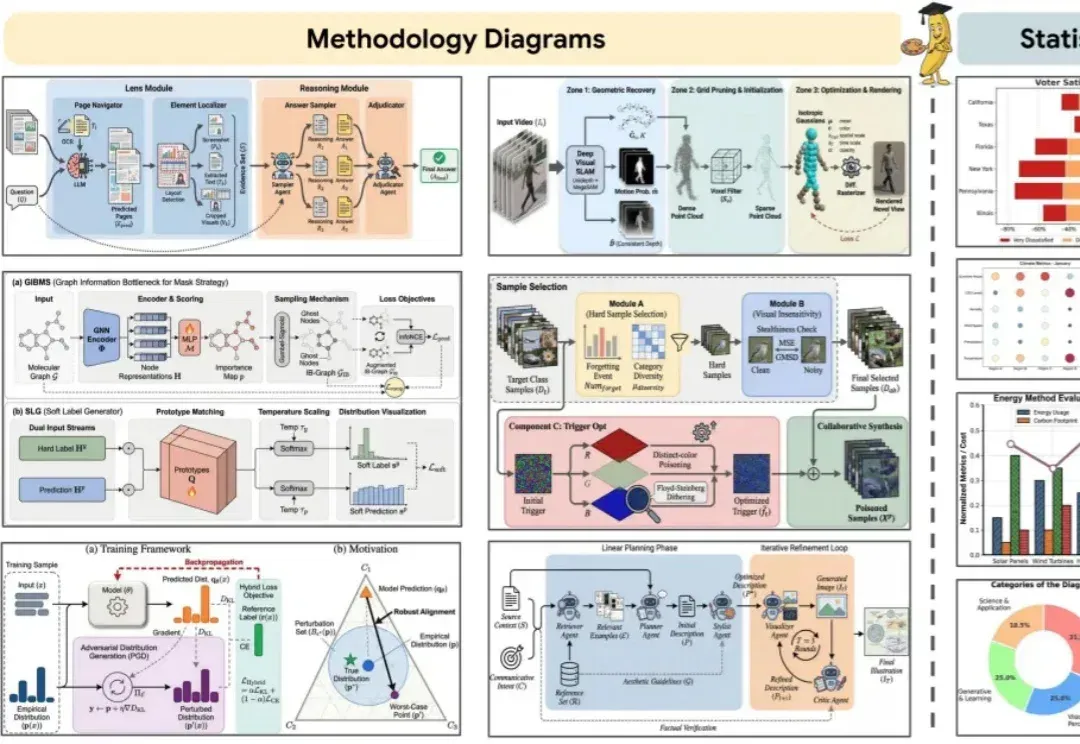
你负责写方法,AI负责画 Figure。 科研打工人,终于等来「画图解放日」。
刚刚,何恺明团队提出全新生成模型范式漂移模型(Drifting Models)。
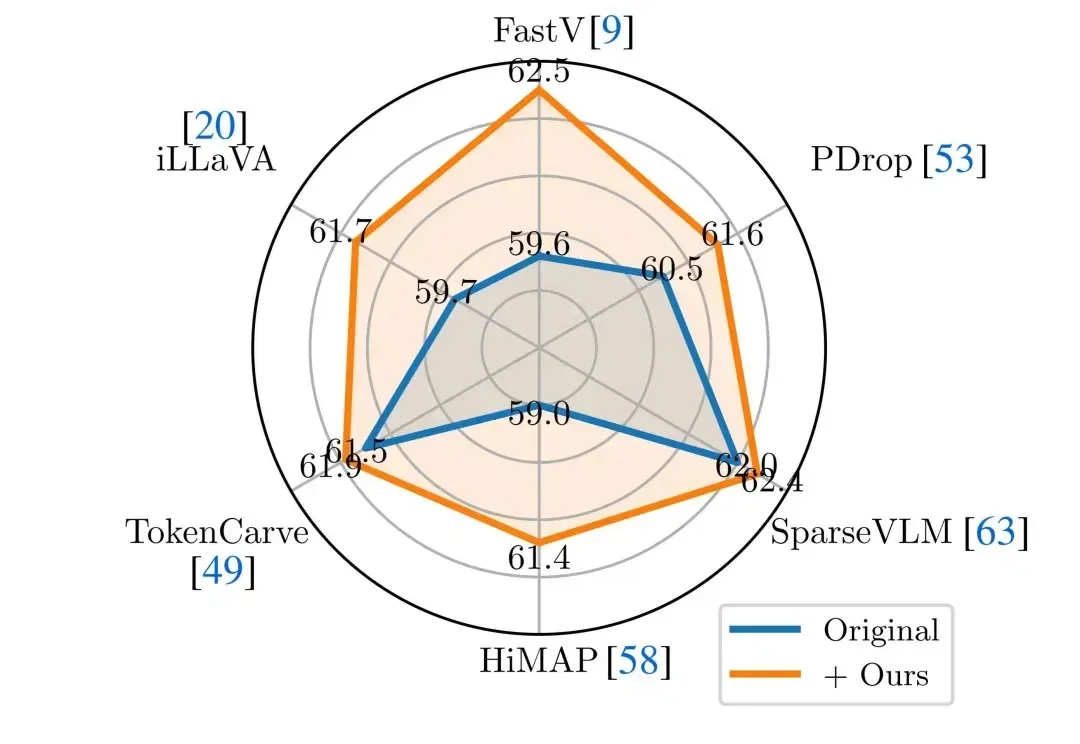
近年来,Vision-Language Models(视觉 — 语言模型)在多模态理解任务中取得了显著进展,并逐渐成为通用人工智能的重要技术路线。然而,这类模型在实际应用中往往面临推理开销大、效率受限的问题,研究者通常依赖 visual token pruning 等策略降低计算成本,其中 attention 机制被广泛视为衡量视觉信息重要性的关键依据。
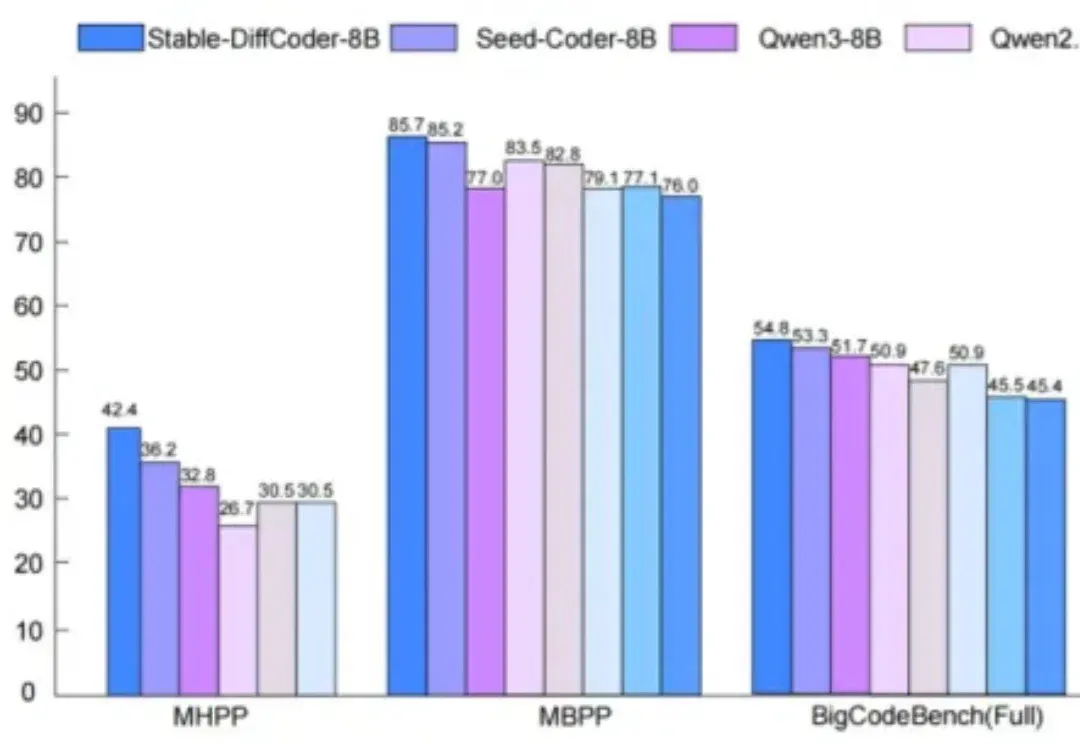
扩散语言模型(Diffusion Language Models, DLLMs)因其多种潜在的特性而备受关注,如能加速的非自回归并行生成特性,能直接起草编辑的特性,能数据增强的特性。然而,其模型能力往往落后于同等规模的强力自回归(AR)模型。
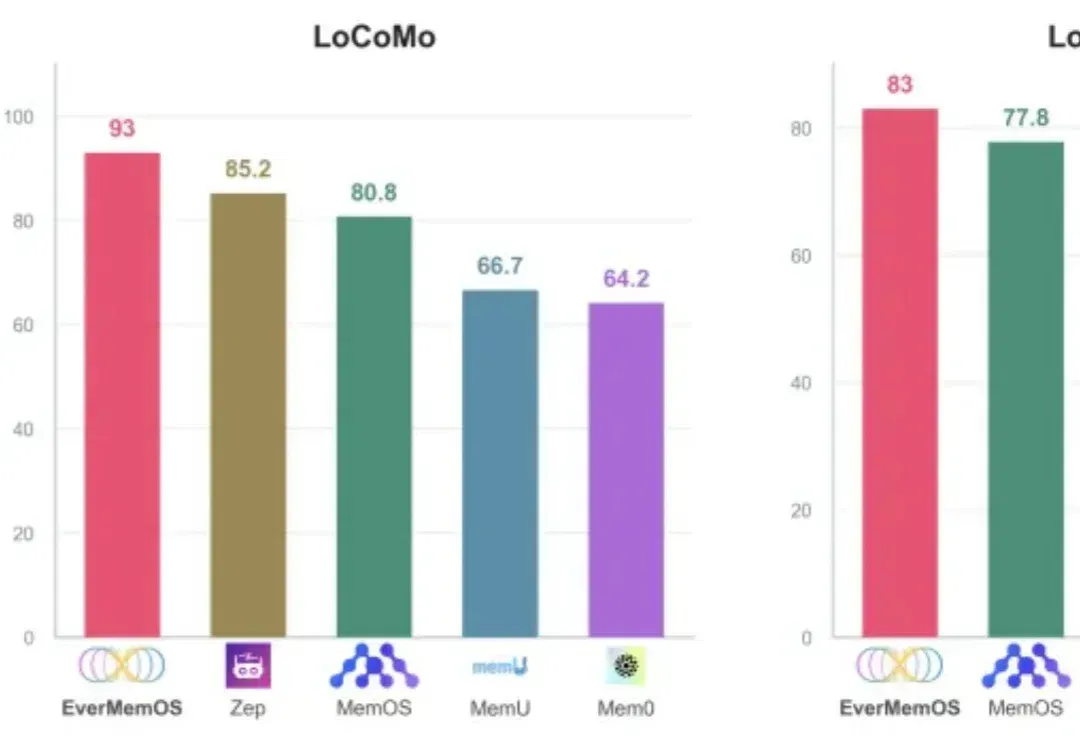
开年,DeepSeek论文火遍全网,内容聚焦大模型记忆。
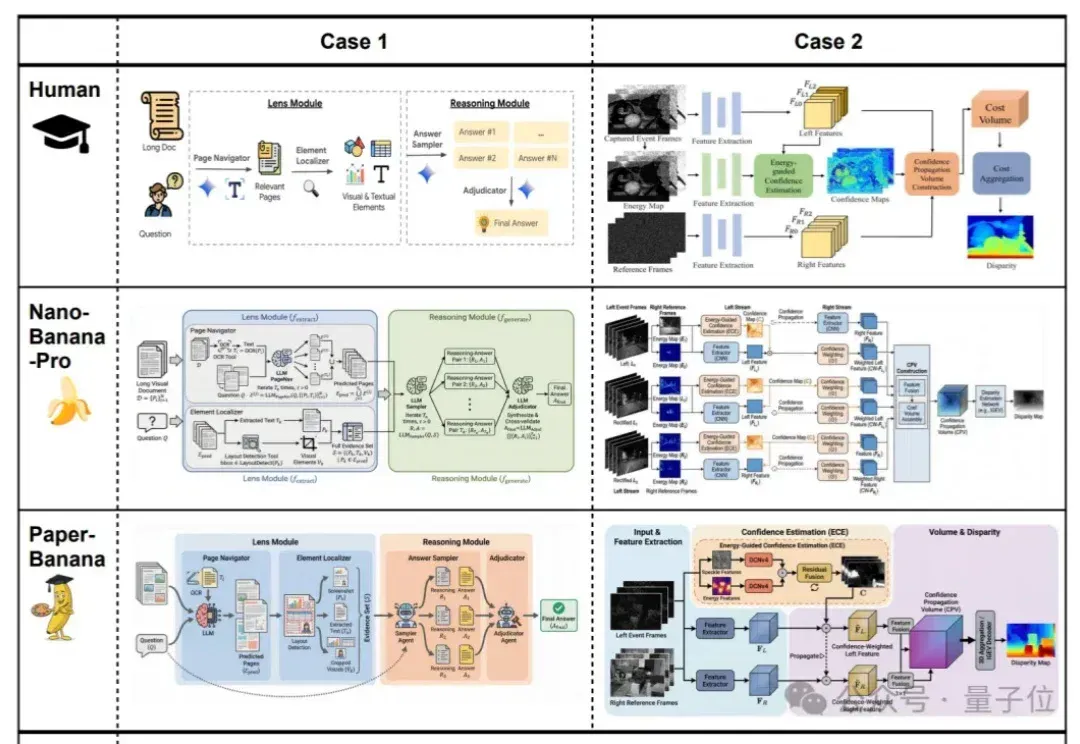
效果好到刷屏的Nano Banana,学术特供版热乎出炉!
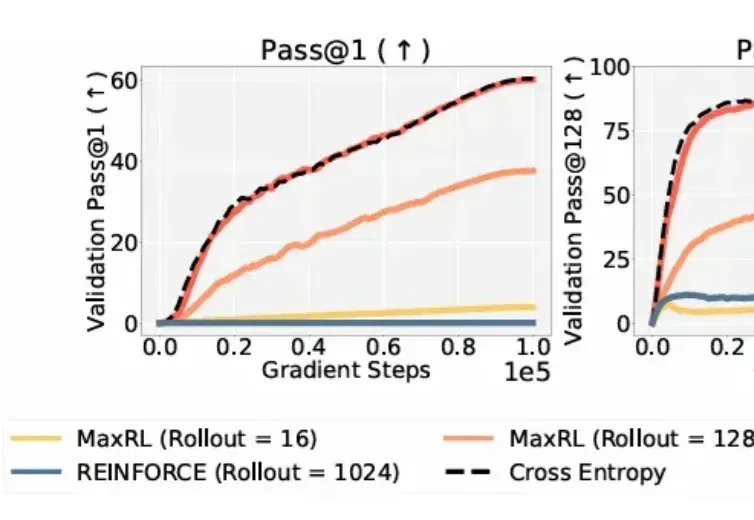
在大模型时代,从代码生成到数学推理,再到自主规划的 Agent 系统,强化学习几乎成了「最后一公里」的标准配置。
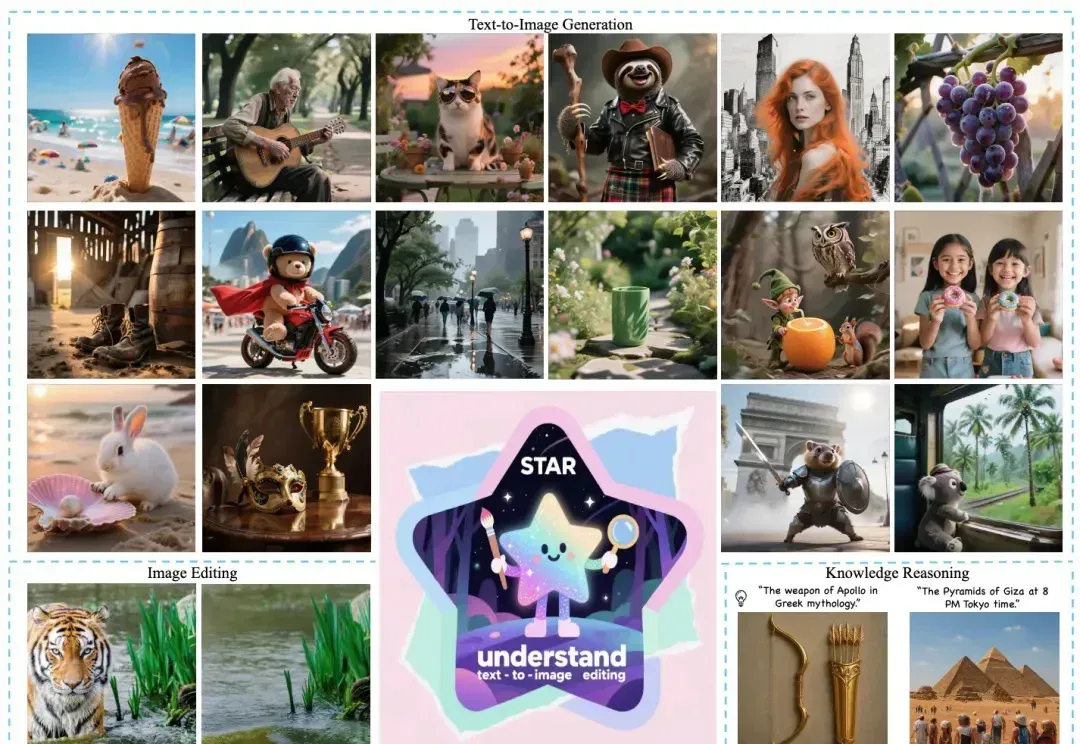
近日,美团推出全新多模态统一大模型方案 STAR(STacked AutoRegressive Scheme for Unified Multimodal Learning),凭借创新的 "堆叠自回归架构 + 任务递进训练" 双核心设计,实现了 "理解能力不打折、生成能力达顶尖" 的双重突破。
英伟达新论文让AI学会先盖房、再装修。 智东西2月3日报道,近期,英伟达宣布其全新3D通用模型论文将发表于2026国际3D视觉会议,论文的预印本已于去年7月发表。这篇论文构建出了一种建构3D世界的新范式,验证了“AI生成的3D合成数据”可规模化替代人工标注数据,能够大幅降低视觉模型预训练的成本。 论文的主要成果为3D-GENERALIST模型,该模型使用统一化框架,将3D环境生成的四大核心要素即布局、材质、光照、资产等统一到序贯决策框架中。研究团队还提出了基于CLIP评分的自改进微调策略,可以让模型在下一轮生成中能自主修正前序错误。 这篇论文的作者有8位华人,第一二作者都是中国留学生,清华“姚
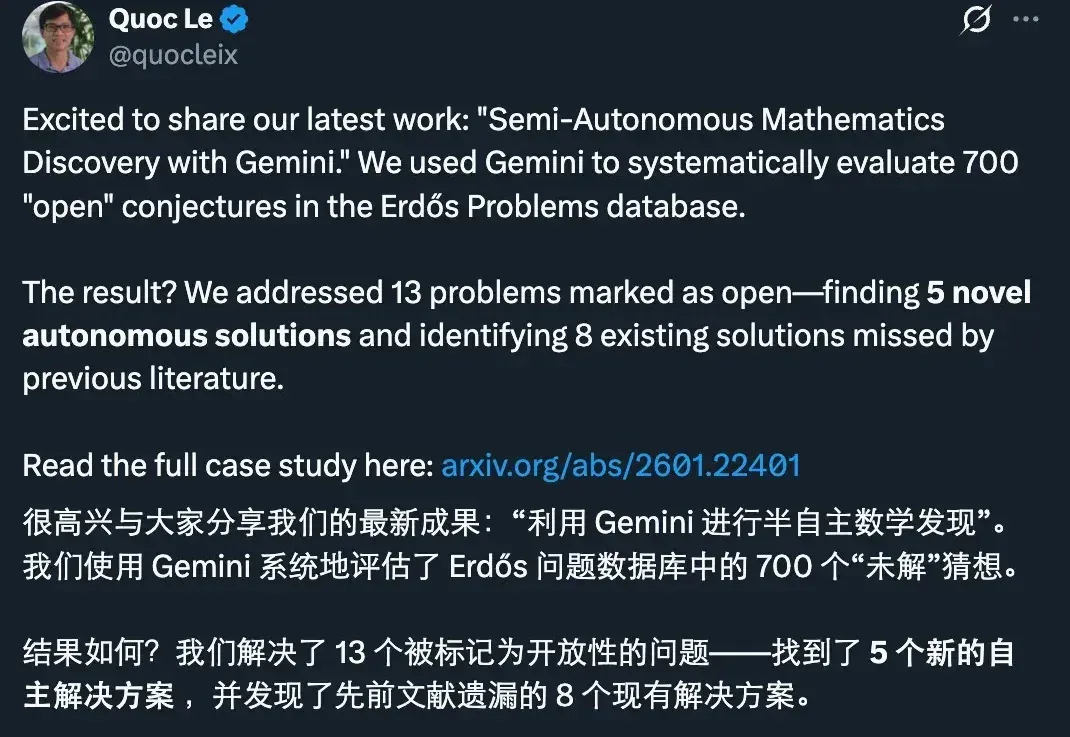
刚刚,谷歌发布了一项新的研究进展:他们用 Gemini 做了一次系统性的数学攻关实验,把目标对准了著名的 Erdős Problems 数据库里 700 个仍被标注为 open(未解决)的猜想。
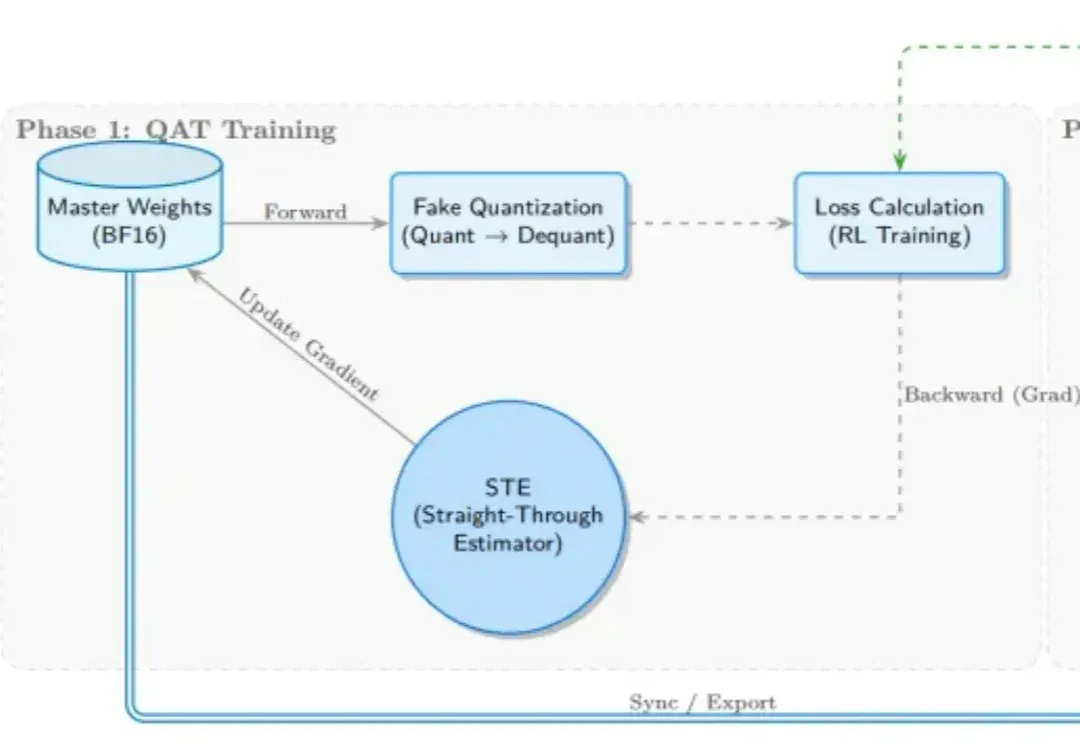
受 Kimi K2 团队启发,SGLang RL 团队成功落地了 INT4 量化感知训练(QAT) 流程方案。通过 “训练端伪量化 + 推理端真实量化(W4A16)” 的方案组合,我们实现了媲美 BF16 全精度训练的稳定性与训推一致性,
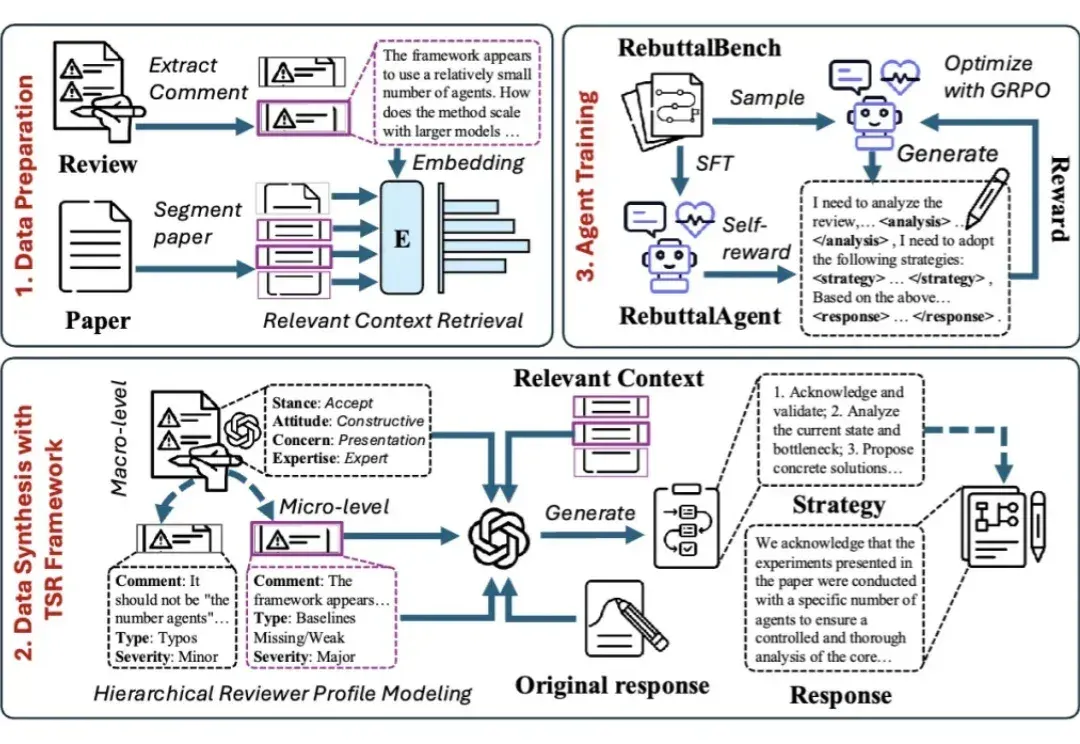
面对同行评审,许多作者都有过这样的经历:明明回答了审稿人的每一个问题,态度也足够谦卑,为什么最终还是没能打动对方?
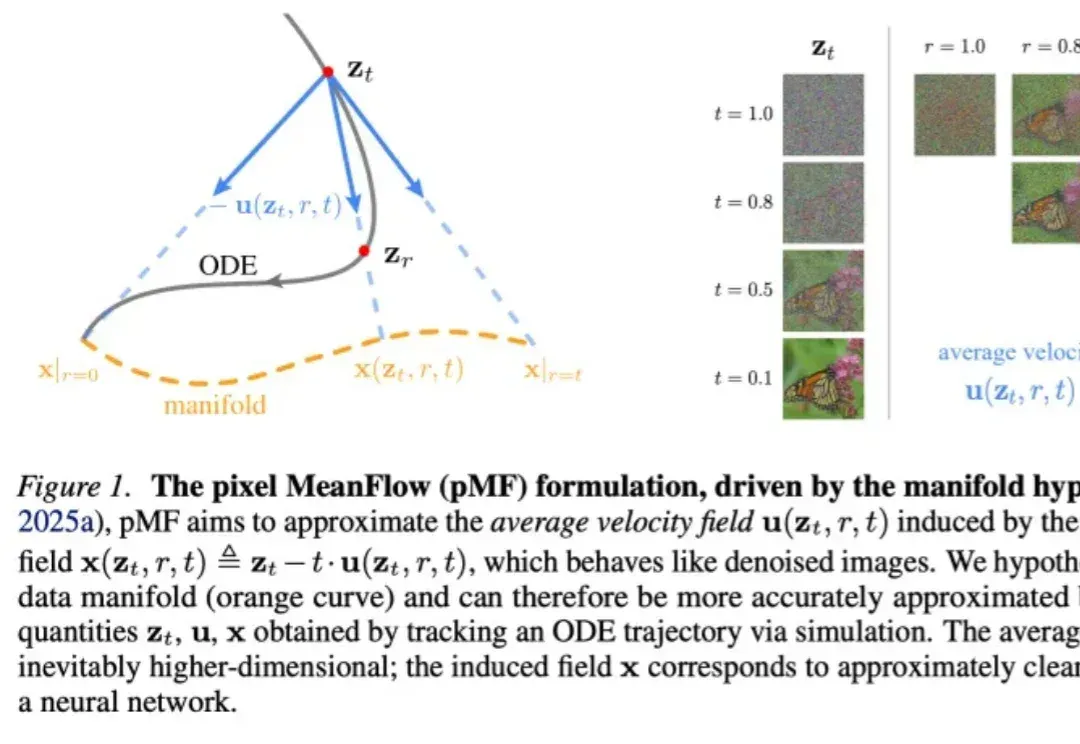
何恺明团队新论文,再次「大道至简」。 此次研究直指当前以 DiT 为代表的主流扩散模型与流匹配模型存在的通病,并提出了一种用于单步、无潜空间(Latent-free)的图像生成新框架。 论文标题:One-step Latent-free Image Generation with Pixel Mean FlowsarXiv 地址:https://arxiv.org/pdf/2601.22158v1 在生成式 AI 领域,追求更高效、更直接的生成范式一直是学界的核心目标。 当前,以 DiT 为代表的主流扩散模型与流匹配模型主要依赖两大支柱来降低生成难度,一是通过多步采样将复杂的分布转换分解为微小
参与交流
了解加入交流群的方式,阅读内容无需登录。