「人类造的最后一个AI」还有多远?一张图看懂OpenAI、Anthropic等大厂的RSI进度(在新窗口打开)
「人类造的最后一个 AI」还有多远?OpenAI、Anthropic 等头部厂商进度如何?定义中国 RSI 的 roadmap——前沿 AI 研究机构 Theseus Labs 结合 72 家产业实践,推出「RSI 五级框架」
内容栏目
分享不同 AI 工具、模型与相关技术的使用方法和实践文章。
「人类造的最后一个 AI」还有多远?OpenAI、Anthropic 等头部厂商进度如何?定义中国 RSI 的 roadmap——前沿 AI 研究机构 Theseus Labs 结合 72 家产业实践,推出「RSI 五级框架」
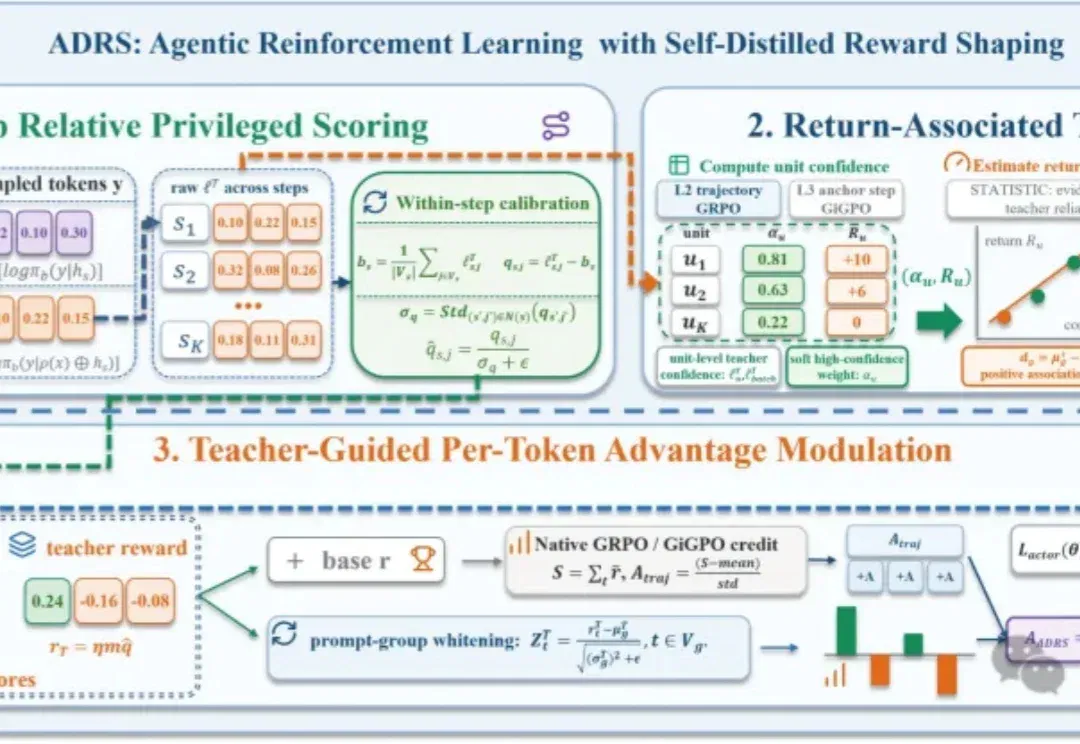
多轮智能体任务只有一个终点奖励,但在一条包含搜索、工具调用和多轮决策的轨迹里,决定成败的往往是一个不起眼的查询词、动作或对象选择。
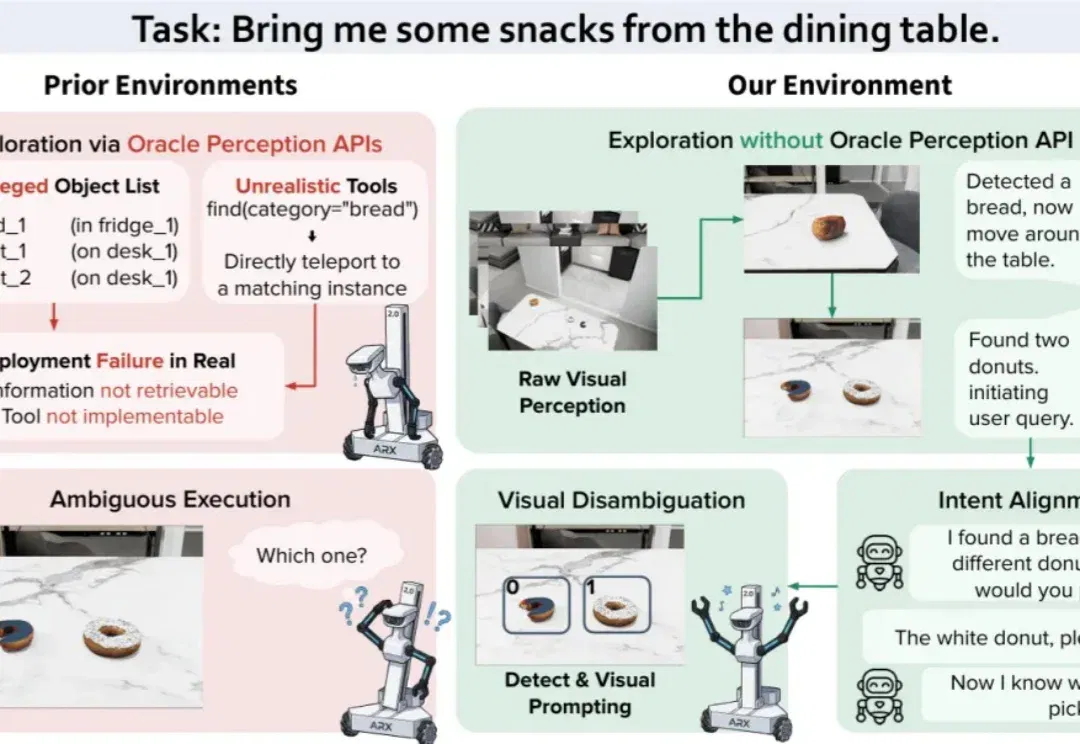
真实家庭任务往往从「不完整的信息」开始:机器人不知道目标在哪里,用户也未必能一次说清自己想要什么。面对「帮我从餐桌上拿点零食」这样的模糊指令,机器人不仅要主动寻找候选物体,还要在发现面包和多个甜甜圈后进一步询问用户,确认究竟该拿哪一个。
Token词元替代了Byte字节,但不意味着大模型都得是Token。
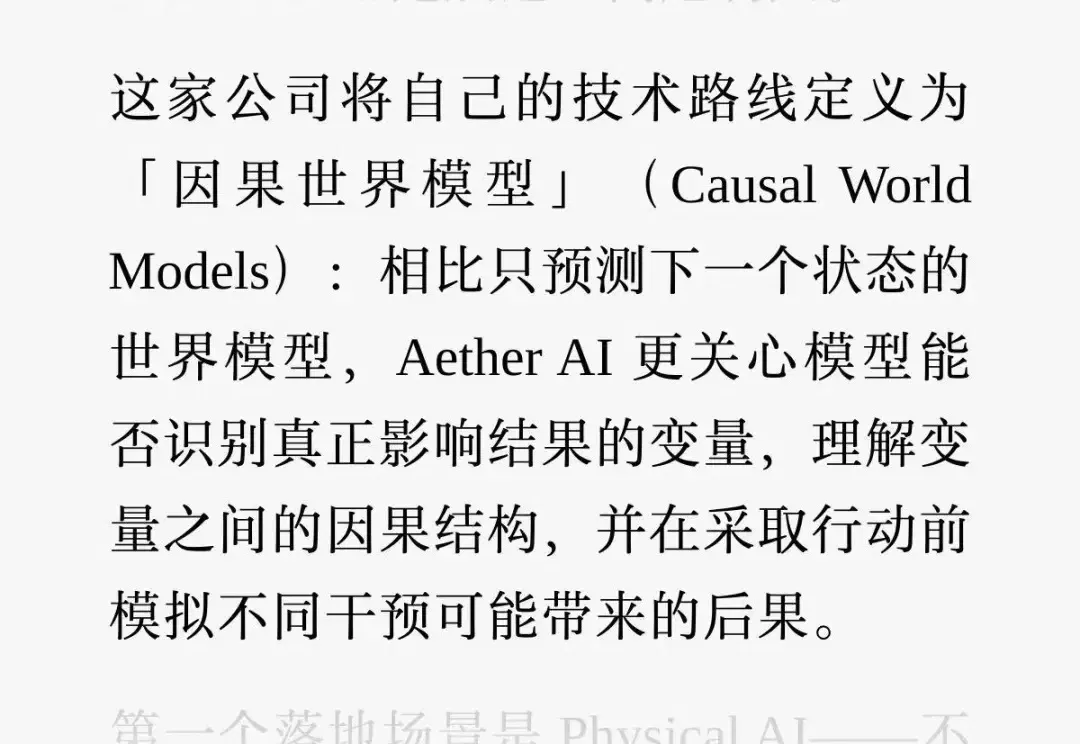
大模型过去几年的能力跃迁,几乎都围绕一个词:Scaling。
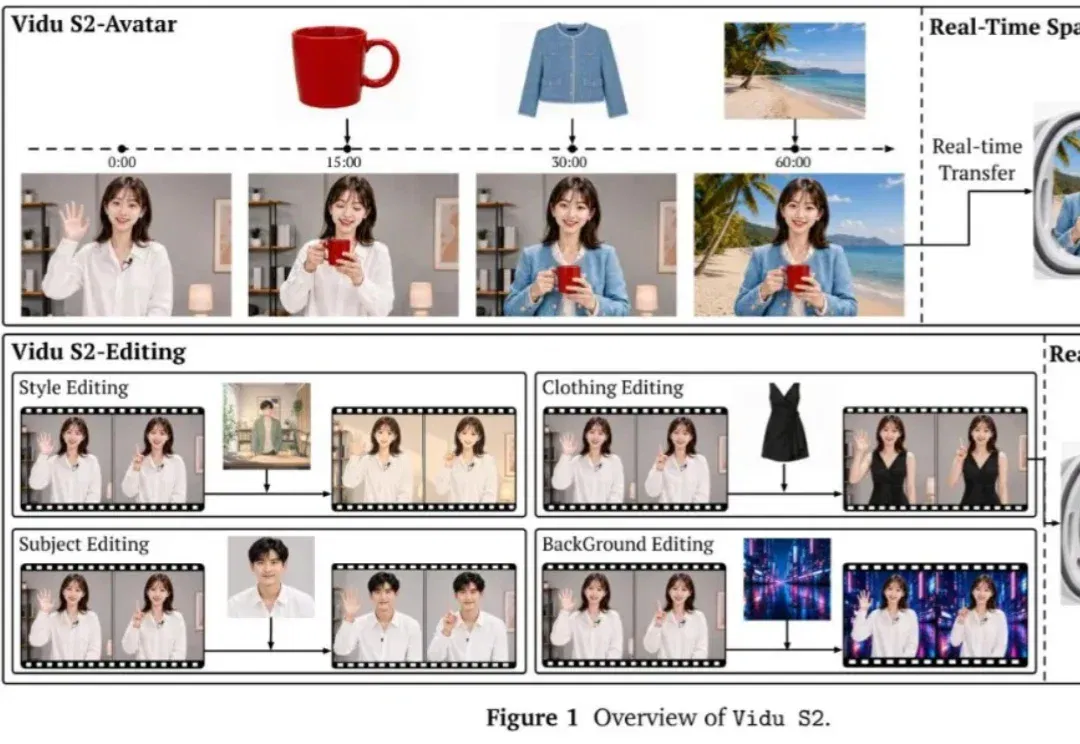
刚刚,生数上线了最新的 实时视频模型 S2,输出提高到 720p,保持 25—42 FPS,包含下面两款:
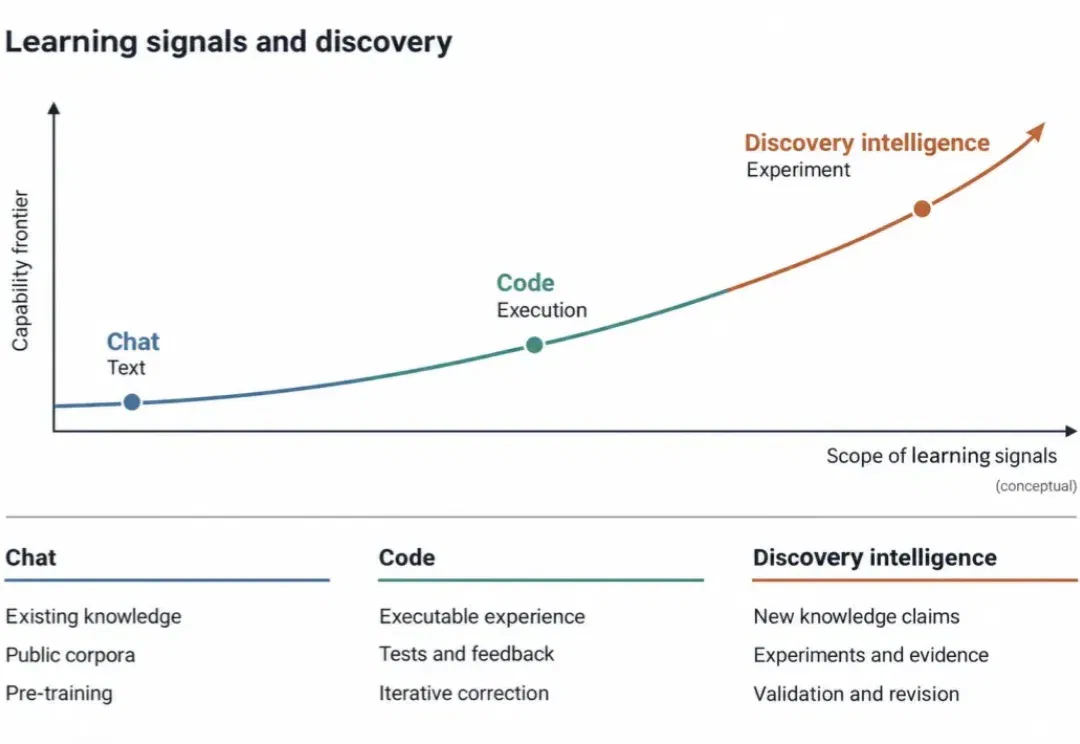
成立才一个多月,估值就要冲到 500 亿美元。
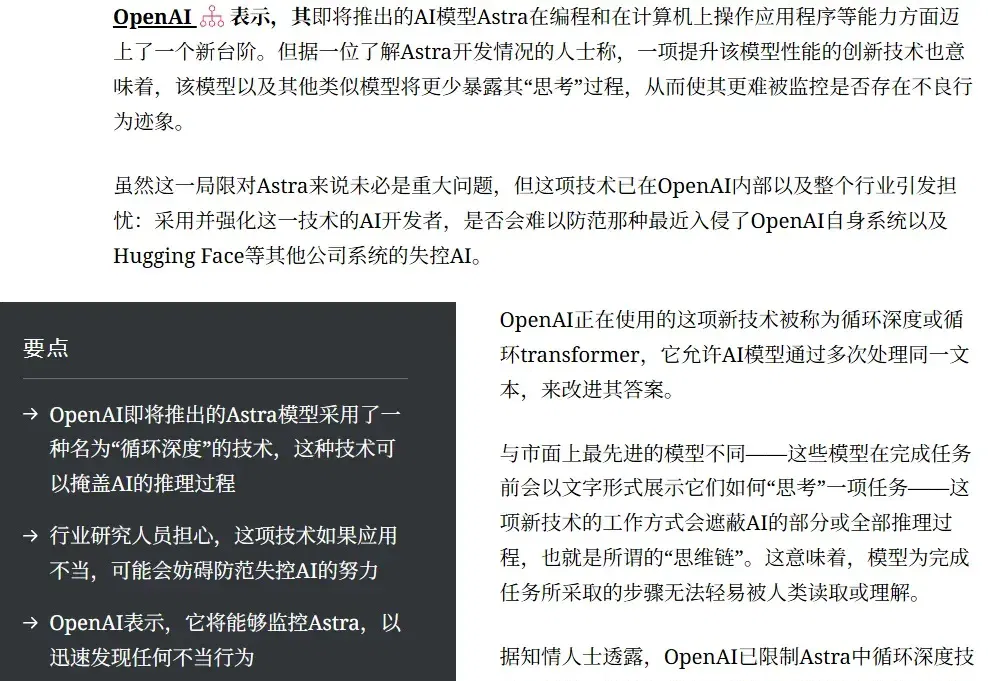
过去两周里,「循环深度」这个词变成了 AI 安全讨论的焦点。
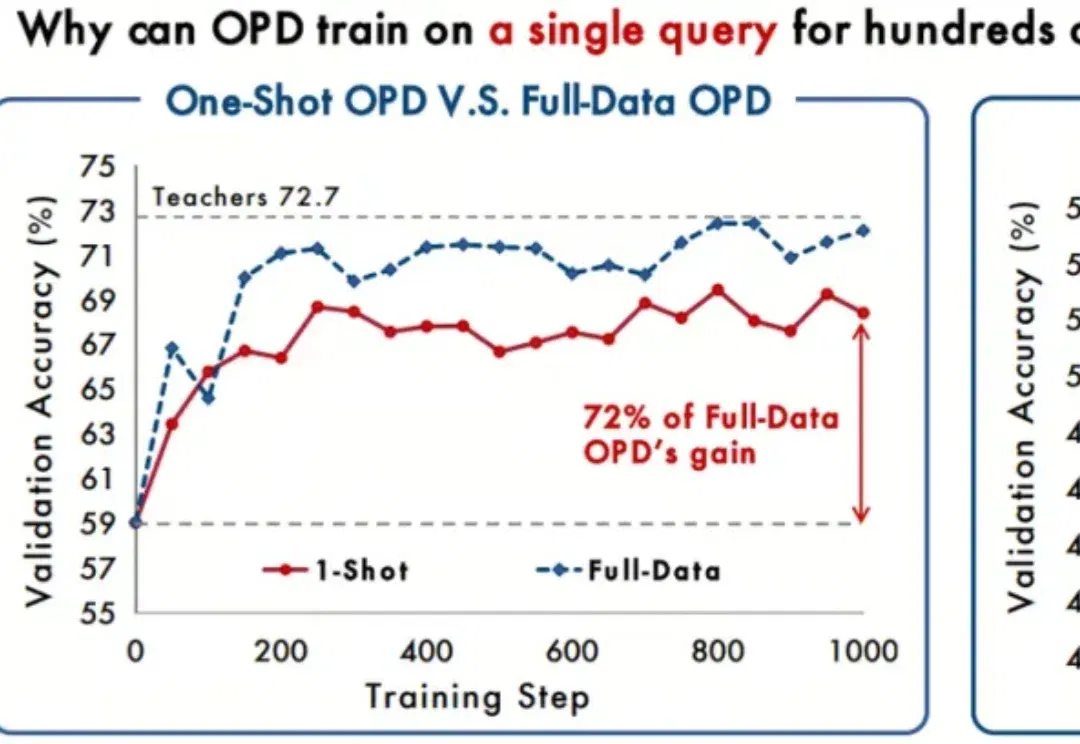
把 On-Policy Distillation(在线策略蒸馏,OPD)的训练集从 17000 道题删到 1 道,会发生什么?
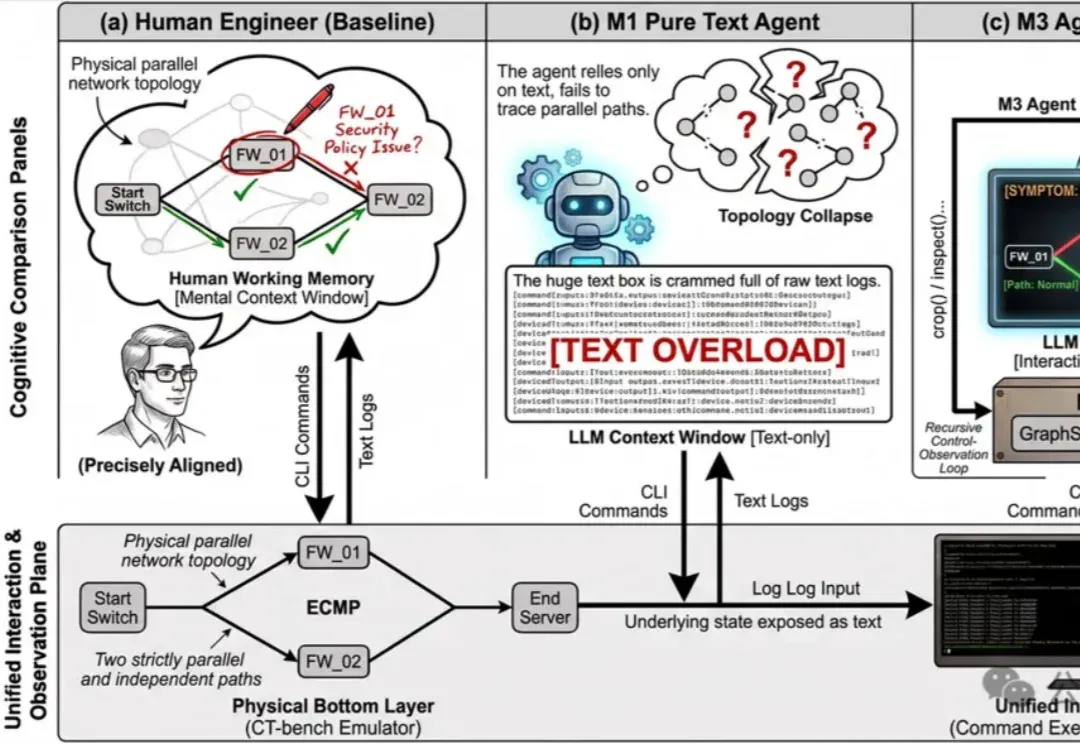
“智能并不局限于大脑内部。当我们使用纸笔或地图来梳理复杂问题时,这些外部工具就成为了我们‘延展的心智’。”
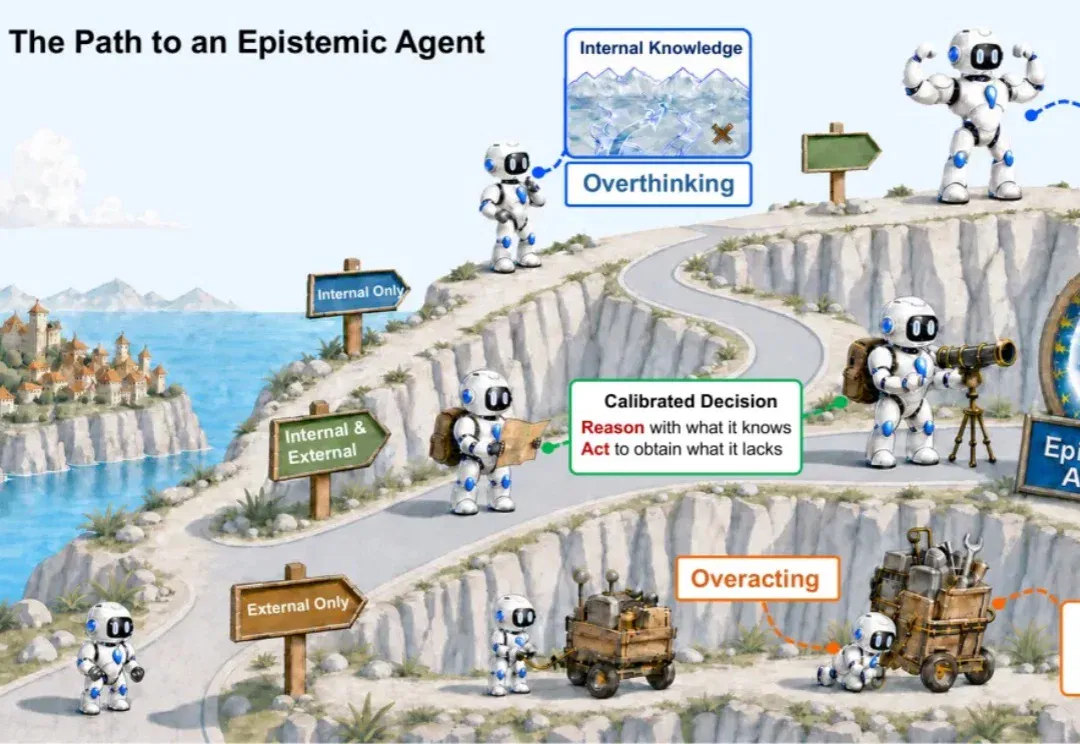
北航、南方科技大学、复旦大学、北京理工大学、爱丁堡大学等 8 家机构的 19 位研究者联合完成 Theory of Agent 综述,讨论模型内部与外部 harness 应如何分配能力,并据此梳理 LLM Agent 的学习、对齐、演化与评测。
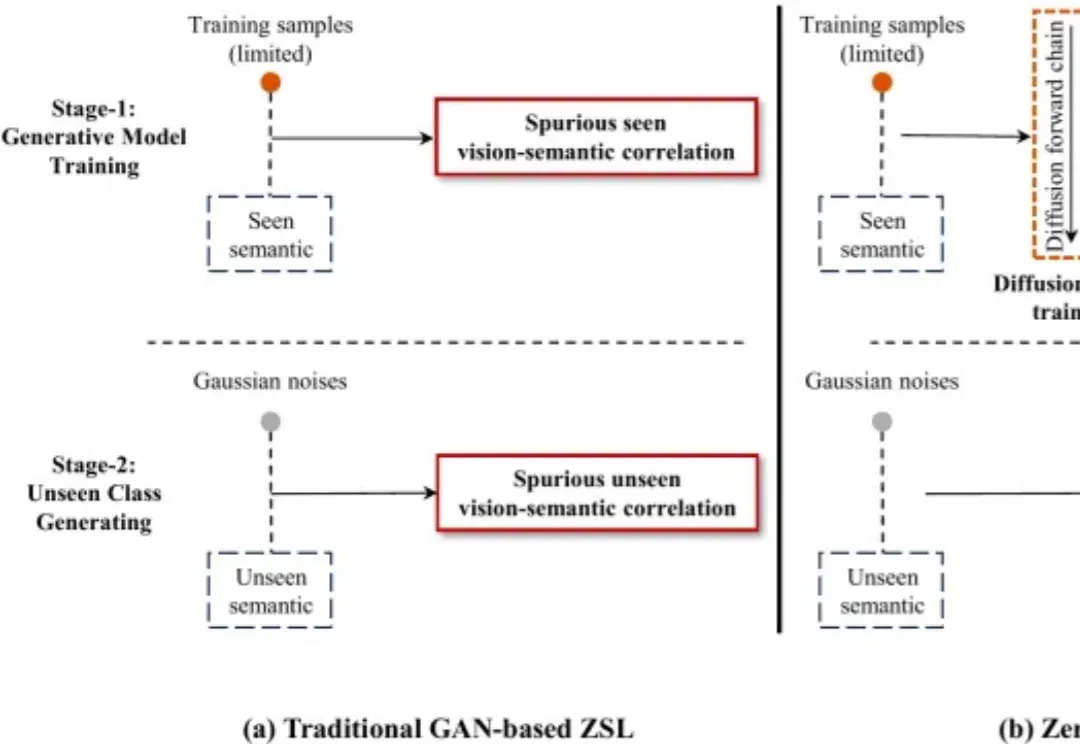
零样本学习的目标,是让模型识别训练时从未出现过的类别。
想象一下这个场景:一场多人线上会议,有人说话时画面自动聚焦到发言者;一段综艺素材,后期系统能自动识别谁在讲话并生成字幕;一段监控录像,系统能在人群中持续追踪正在说话的那个人。
Anthropic发布2026年9月威胁情报报告,指出AI滥用已从辅助工具升级为可自主运行的行动系统,覆盖非法模型蒸馏、零日漏洞自动化挖掘、多Agent集群滥用等七大风险领域。
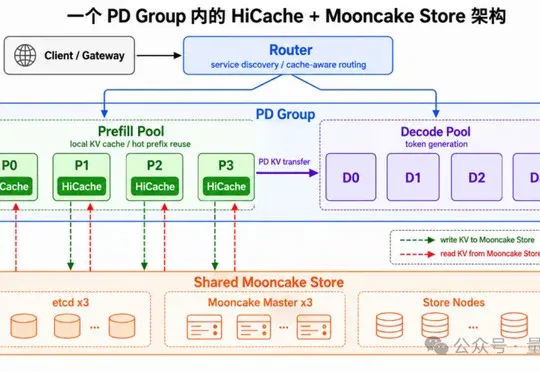
趋境科技通过部署SGLang HiCache+Mooncake Store,将KV Cache从单机资源升级为集群级共享池化资源,支撑其日均产出超万亿Token的生产实践,KV Cache命中率稳定突破90%,并在生产环境中持续优化大规模推理集群的性能与稳定性。
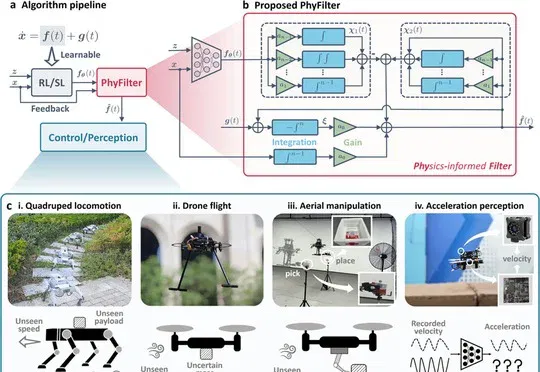
北京航空航天大学与新加坡南洋理工大学联合在Nature子刊npj Robotics发表PhyFilter模块,借助机器人实时状态反馈与物理微分结构在线修正学习残差,使仅在平地仿真训练的策略可直接跨越石板路、草地、沙地与碎石路等多类未见真实地形。
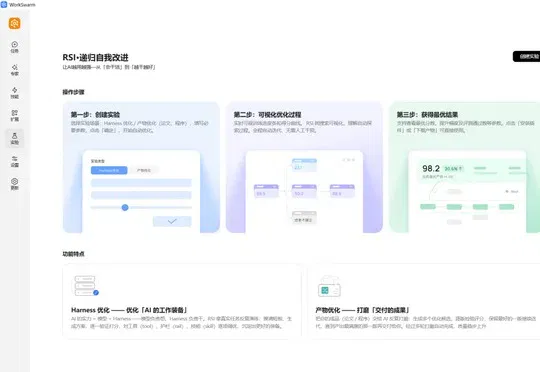
openJiuwen首发双维度RSI框架,在WorkSwarm蜂群办公智能体上落地Harness与Artifacts双维度优化,支持科研论文和算法程序两类交付产物迭代,并依托昇腾算力亲和能力降低多轮优化的时延与资源开销。
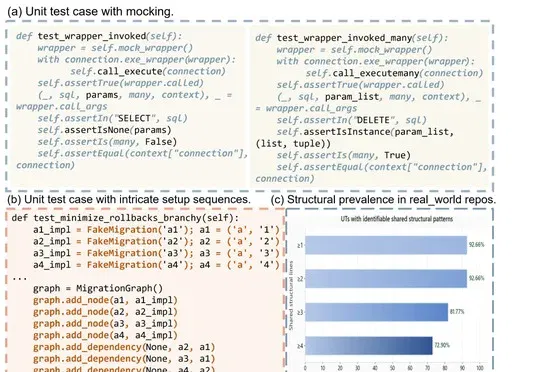
清华大学AI Agent课题组提出加速扩散语言模型单元测试生成的框架DiffuTester,通过抽象语法树动态挖掘多个测试用例间的共享结构模式,在解码过程中保留相关token,在保持测试覆盖率的同时实现最高约2–3倍加速,相关论文已被EMNLP 2026接收。
第一篇AI4AI综述论文将long horizon智能体、AI4AI与recursive self-improvement纳入同一研究地图,指出AI能在明确目标与评价规则下承担部分研发工作,但单项能力提升无法证明完整流程可靠,持续自我改进仍面临组合鸿沟等验证挑战。
针对世界模型定义的分歧,李飞飞将其分为渲染器、模拟器和规划器,朱军及生数科技团队则提出理解、想象、行动三项核心能力与五级进化路线图,Motus2通过策略、模拟器、评估器一体化架构推动机器人行动闭环自进化。
参与交流
了解加入交流群的方式,阅读内容无需登录。