Vidu S2:实时数字人,实时改视频
刚刚,生数上线了最新的 实时视频模型 S2,输出提高到 720p,保持 25—42 FPS,包含下面两款:
刚刚,生数上线了最新的实时视频模型 S2,输出提高到720p,保持25—42 FPS,包含下面两款:
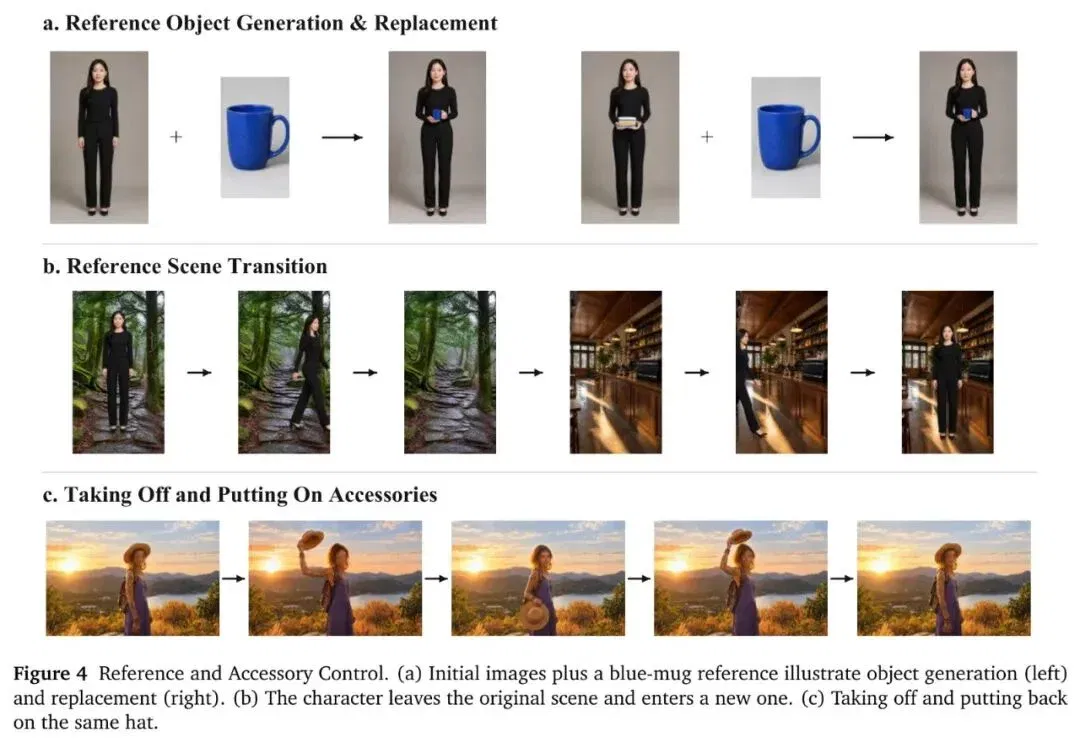
- S2-Avatar,实时数字人你可以和它说话、让它做动作,比如换衣服、拿东西、换场景,支持随时新增参考图
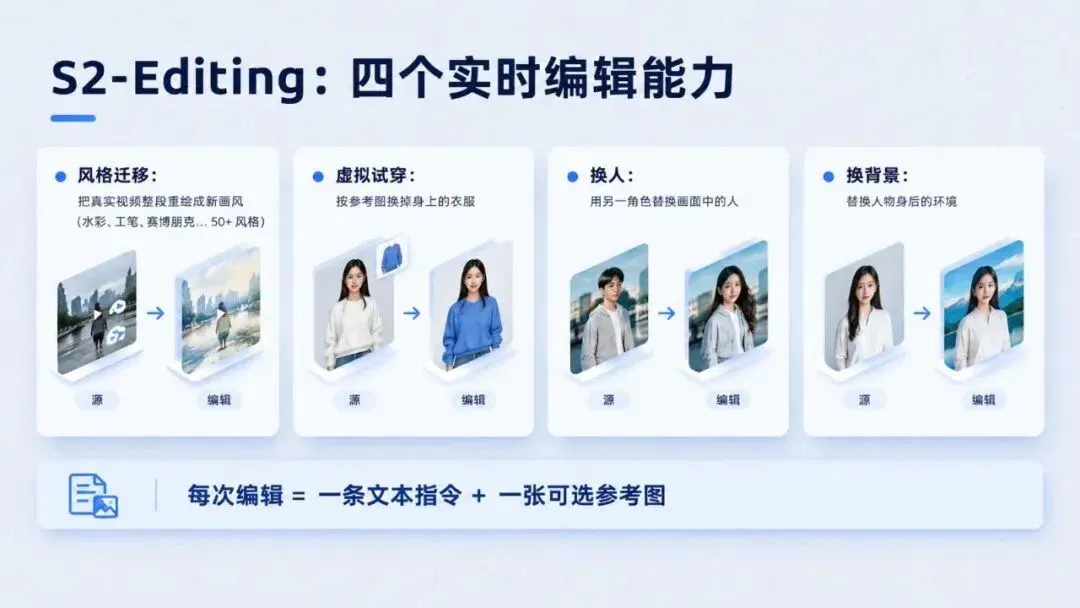
- S2-Editing,实时改视频输入一段持续发生的视频,模型根据指令改画风、换内容,同时保留原视频的动作与时间关系
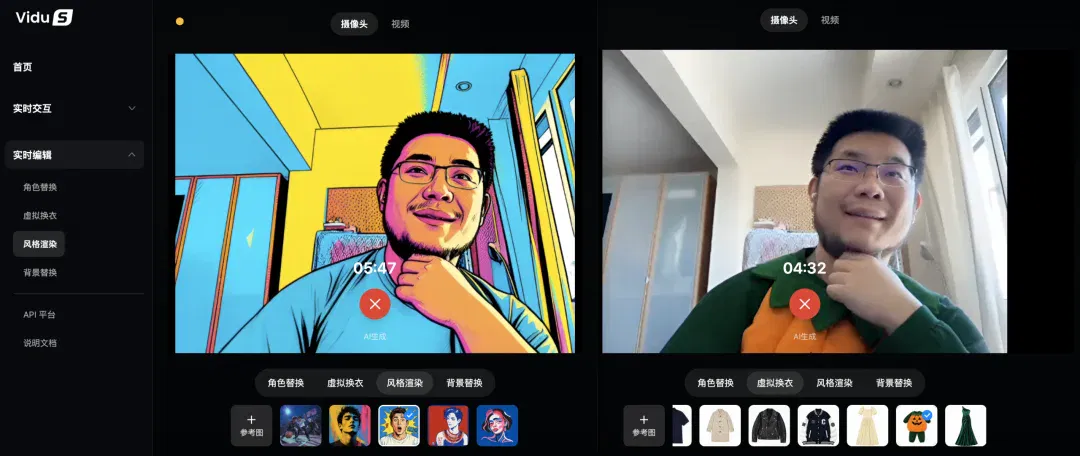
比如...左侧是风格转绘,右侧是给我换了身衣服
这东西现在已经可以玩了,这里体验:https://vidu.com/vidu-stream
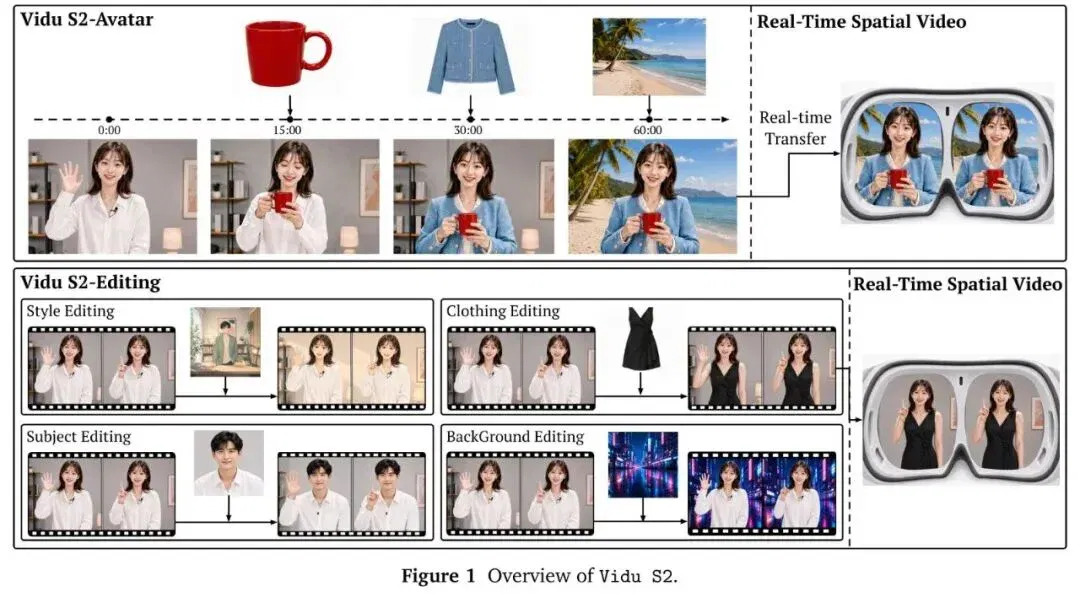
而在这两个模型之后,还有一个延伸发布:实时空间视频方案,可供头显使用,能将生成后的画面变成左右眼视图
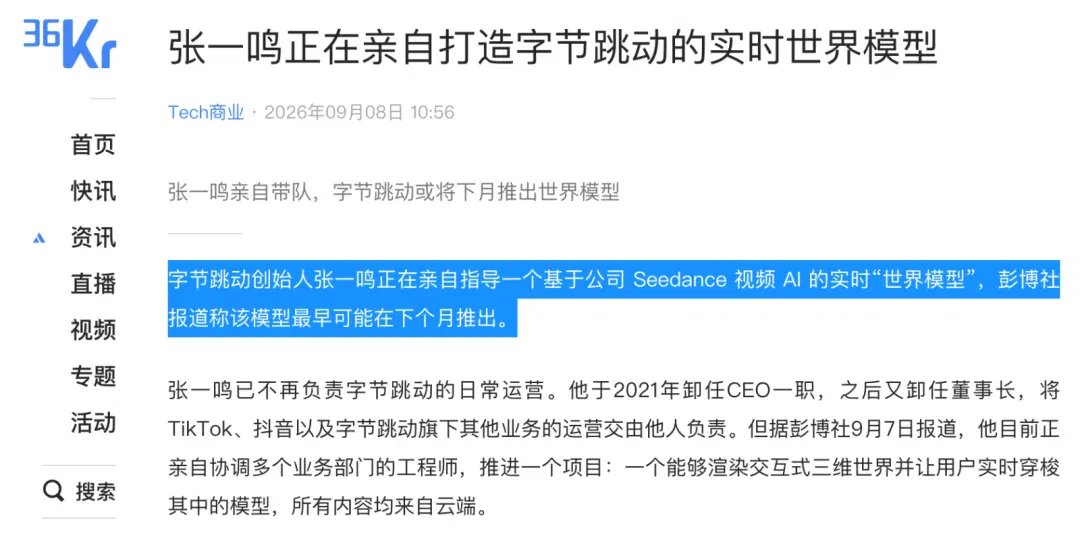
这事儿,可以并着下面这个新闻来看,大家都在朝着「小扎未竟之路」来探索
S2-Avatar:实时数字人
Avatar 延续的是 S1 的路线,仅凭一张图,便可生成交互数字人。但 S2 做了一个很大的改进“动态参考”,你可以在对话的过程中,随时更改角色设定以及场景、衣物、道具
比如在对话的过程中,你可以随时给他一张杯子的图片,让它拿起来,或者给他一个外套的照片,让它换上
另外我去查看了 tech report,发现了一个有趣的细节,就是 Vidu 是如何保证角色行为的一致性的:他们做了一层 VLM Agent,用来生成后续 prompt举个例子,当让角色“拿起杯子,然后微笑”时,这个 Agent 会把后面的提示会明确保留“继续拿着杯子”,只改变表情,避免新指令把前面的状态覆盖掉
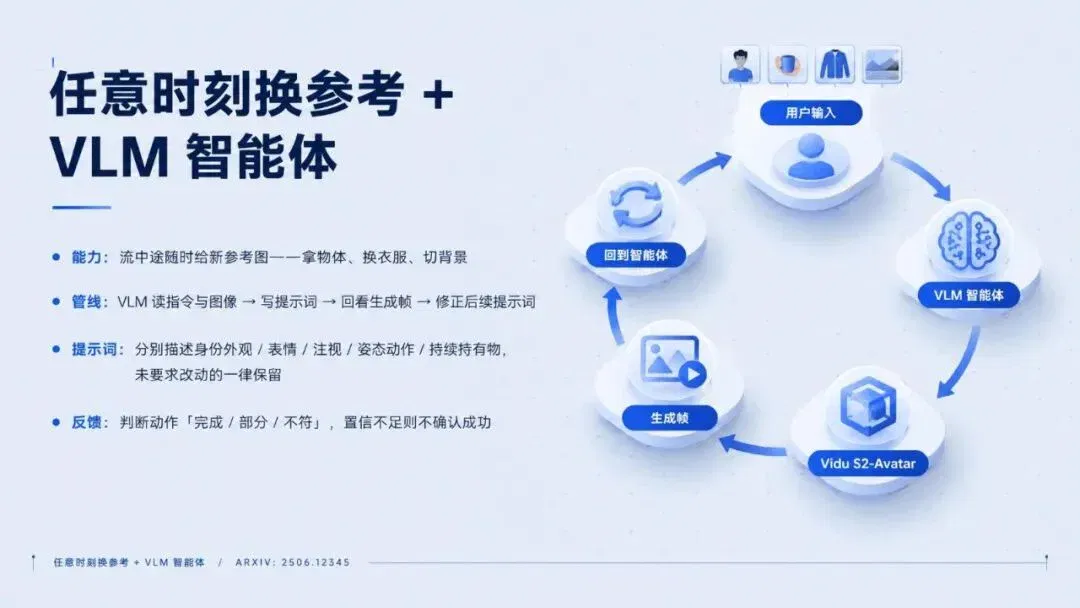
视频模型负责生成,Agent 负责维护状态
S2 在交付效果上做到了大幅提升。在训练的过程中,增加了独舞和 2D、3D 动画数据,指令跟随也扩展到更完整的身体动作。在画面渲染上采用低分辨率骨干加单步 Refiner,骨干侧偏重运动与时序,Refiner 侧保留外观细节。输出从540p提高到720p,报告给出的速度是25—42 FPS
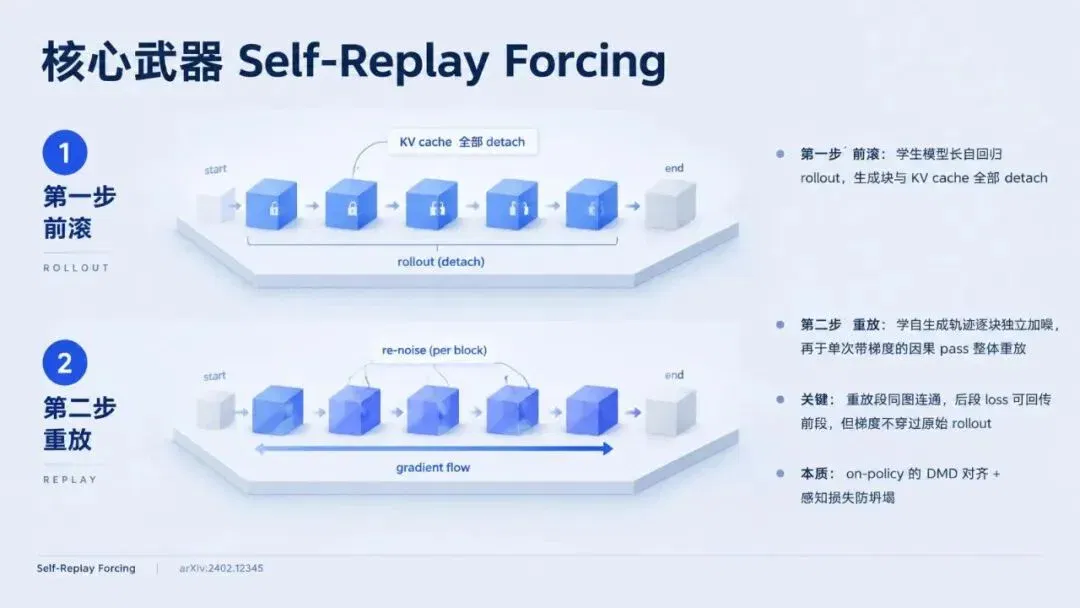
为了长时间生成的稳定性,则用到了他们提出的Self-Replay Forcing,简称SRF,也就是模型先按实际推理方式生成一段长轨迹,再把自己生成的片段重新加噪,进行因果回放训练,用来改善连续生成中的误差累积
S2-Editing:实时改视频
Editing 则是直接接收视频流,根据文字指令和可选参考图,实时换画风与内容。和 Avatar 不同,这里的动作由原视频提供,也就是用来「P 视频」的
比如你在摄像头前做手势舞,这时候给他上传一张牛来,就可以让输出画面里的牛来去跳了,它目前支持四类任务:风格迁移、虚拟试穿、人物替换、背景替换
下面的这些案例来自 tech report
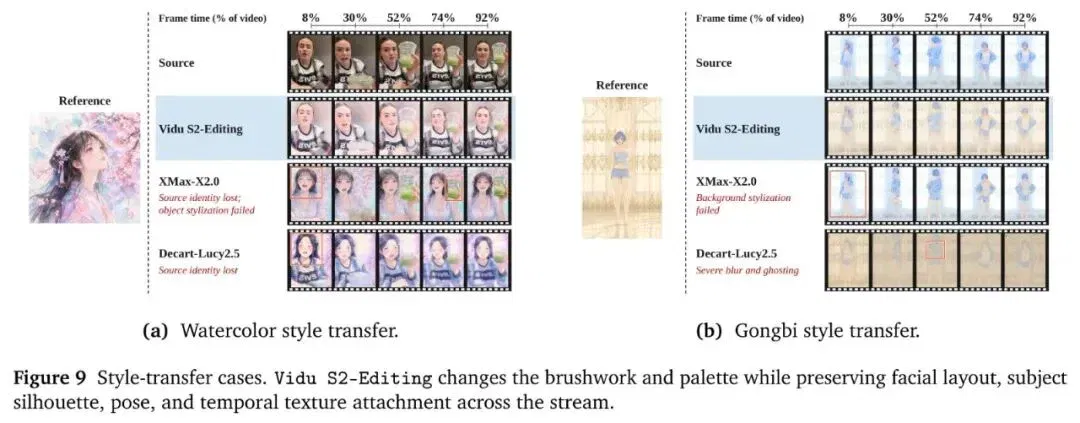
风格迁移:水彩与工笔风格
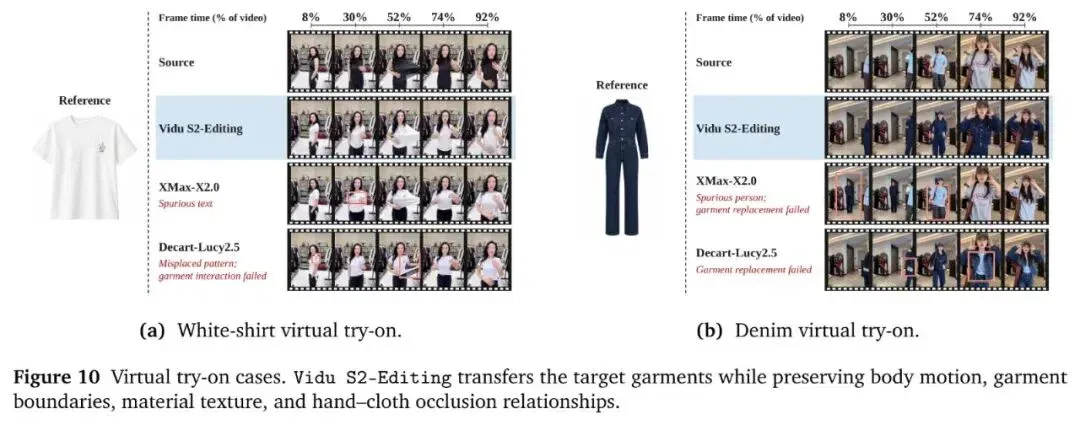
虚拟试穿:白衬衫与牛仔服
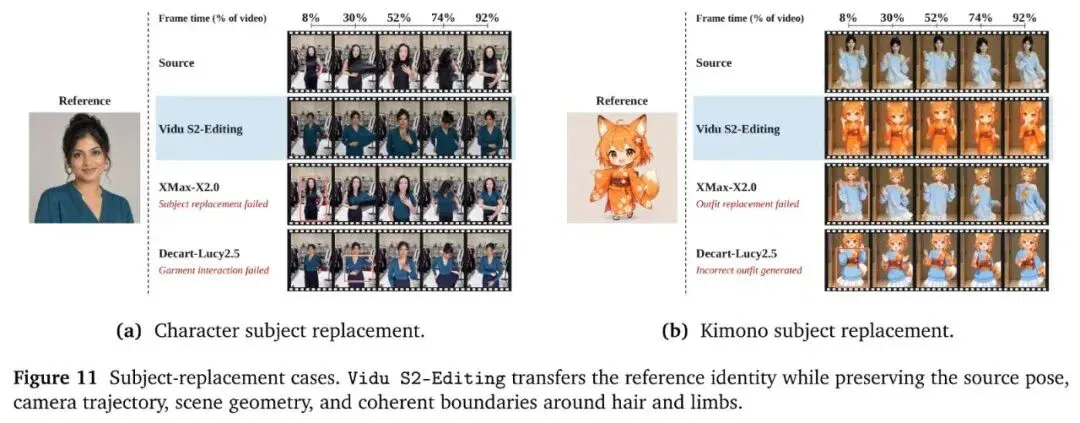
角色替换:真人与卡通角色
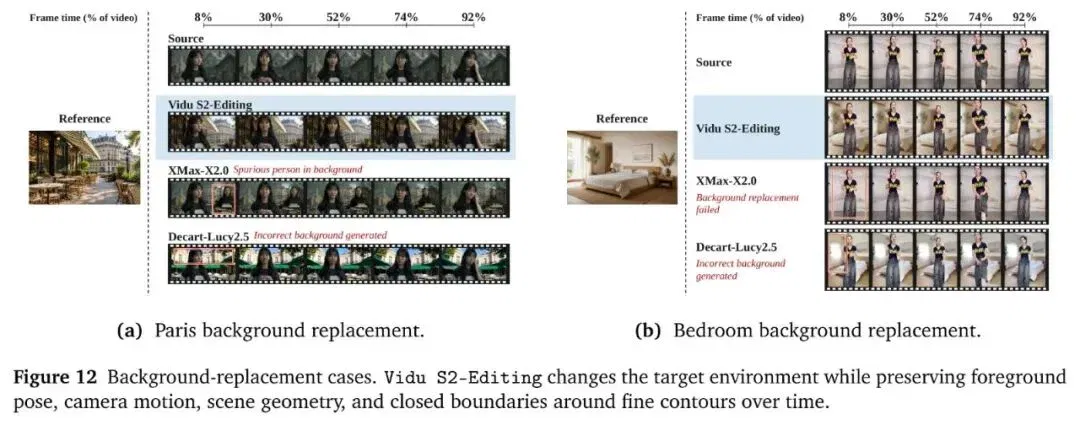
背景替换:巴黎街景与卧室
这个技术有个难点:如何让改动的画面不穿模比如在拉扯衬衫的时候,如果我把衬衫换成了别的衣服,那也意味着衣服上的花纹、质感什么的也都会变好,而模型要同时理解参考图里的衣服特征,也要保留原视频里人与衣服的互动
对此,Vidu 团队使用了Frame-Aligned Attention的解法,也就是目标帧在读取源视频时,只与同一时刻的源帧交换信息;参考图则可以被各个目标帧读取,持续提供新的外观条件,避免把不同时间点的源画面混在一起。进入流式生成后,模型仍会结合有效的历史片段继续输出。
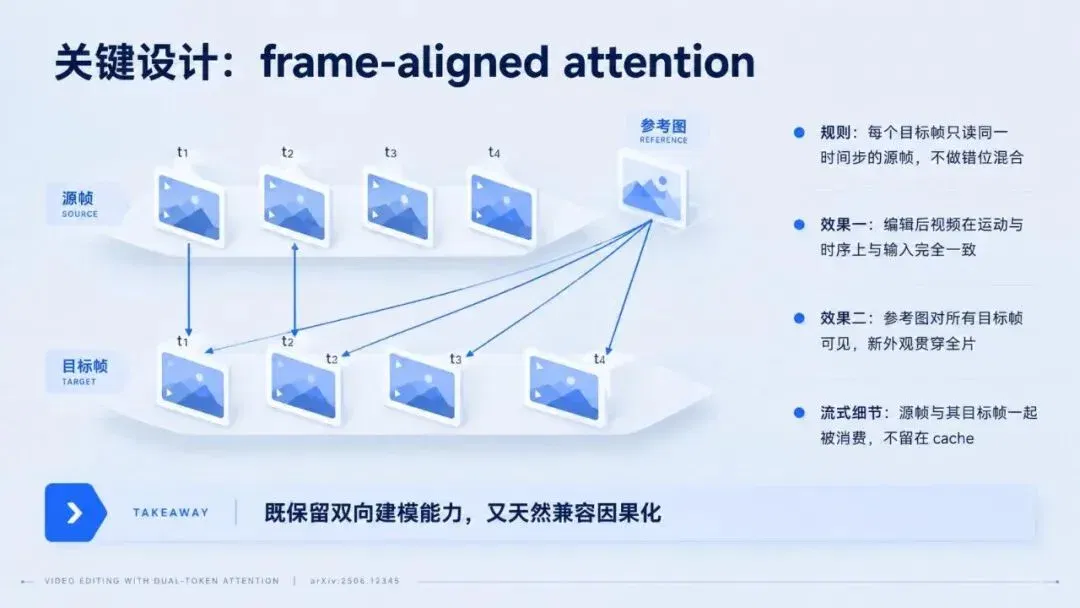
训练上,Editing 也复用了前面的因果流式方案和SRF,用来改善连续编辑中的一致性,并进行了特别的内存优化,降低整条流程的延迟
实时空间视频:送进头显
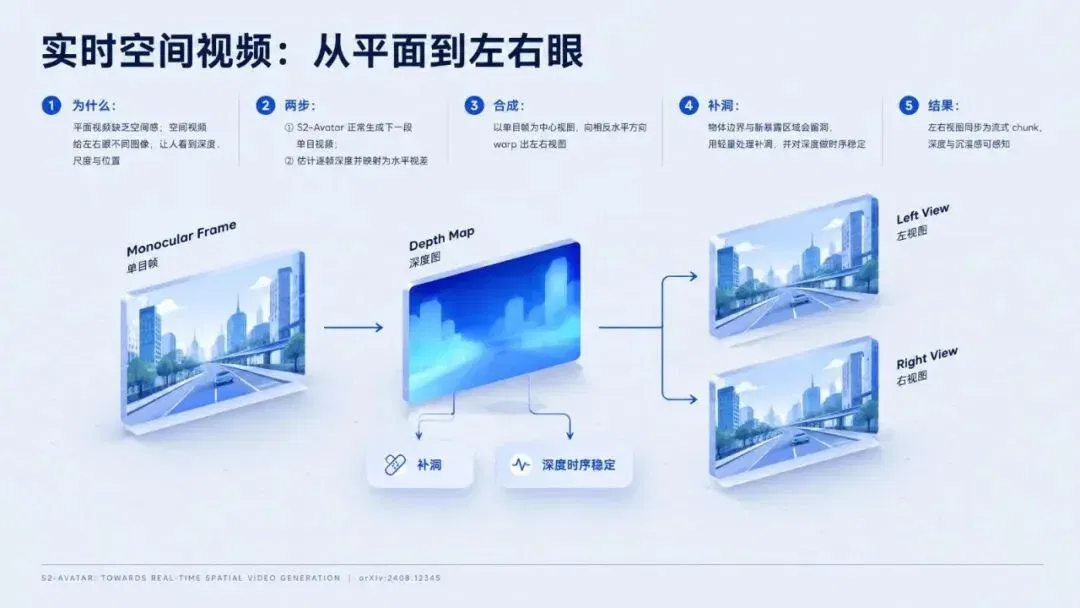
Vidu 在前面两个模型的基础上,继续往后做了一步,为左右眼提供略有差异的画面,做到「实时空间视频」
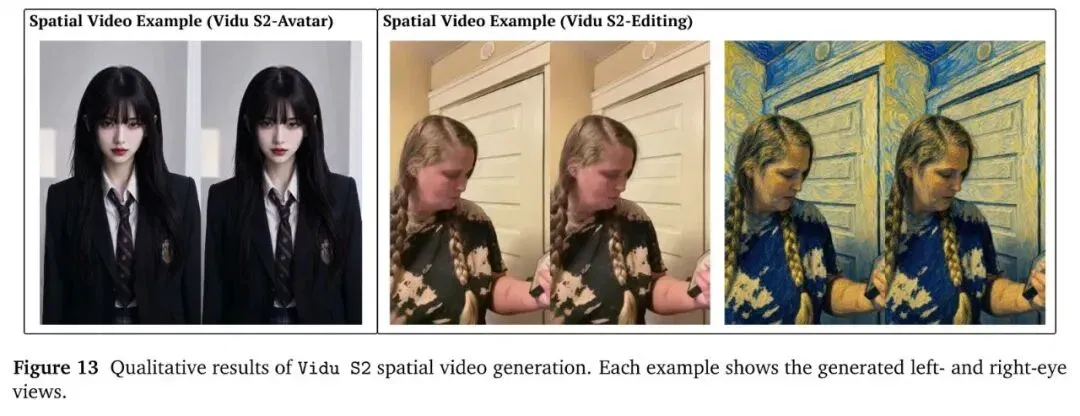
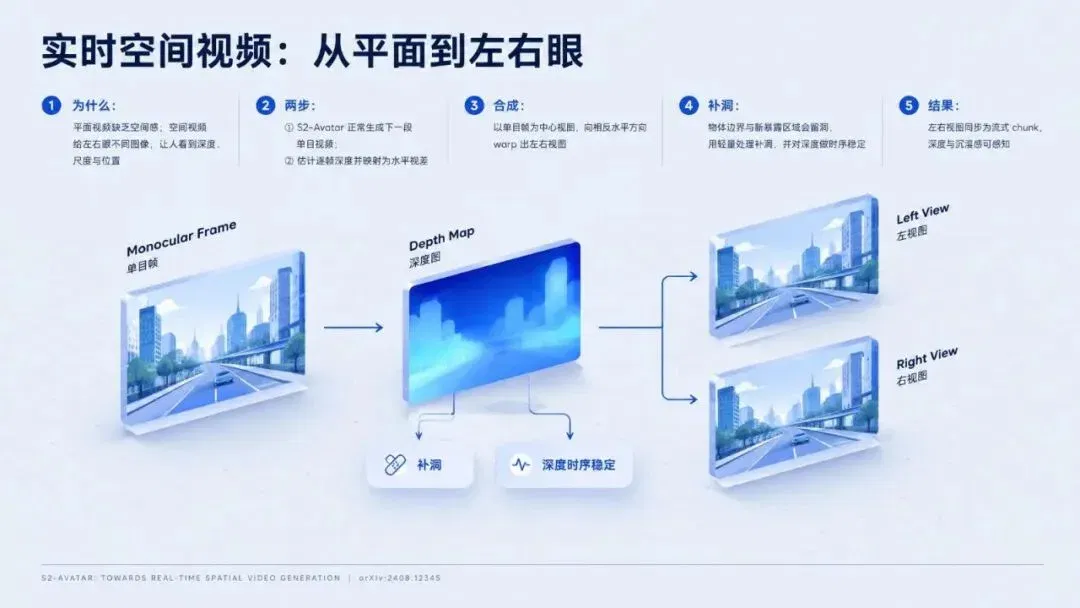
在这个过程中,会先生成普通视频,再根据深度生成左右眼视图,持续送给头显;单目画面,转换成左右眼视图
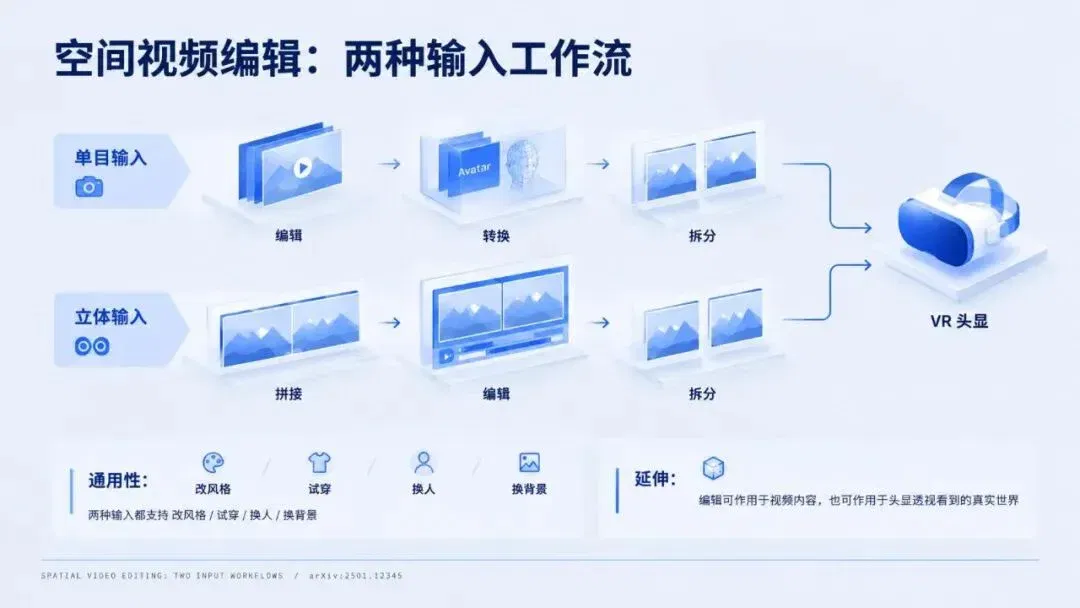
如果是实时编辑视频的话,就分为两种情况:
- 原视频是单目的,会先修改普通视频,再转成双目
- 原视频是双目的,把左右眼画面横向拼成一条宽视频,一起编辑,再分拆回双目下面用两个图来展示着一原理
BenchMark
根据官方说法,基于 BenchMark 评估,Vidu S2 模型做到了领域 Sota
Vidu S2 的全链路研发由朱军教授的博士生张金涛负责,他也是生数科技流式视频生成与推理负责人
这里的 BenchMark 包含对应 Avatar 的 StreamAV-Bench,以及 Editing 的 Sparkle-Bench、OpenVE、RefVIE 和 ViViD 试穿测试集,摘取如下
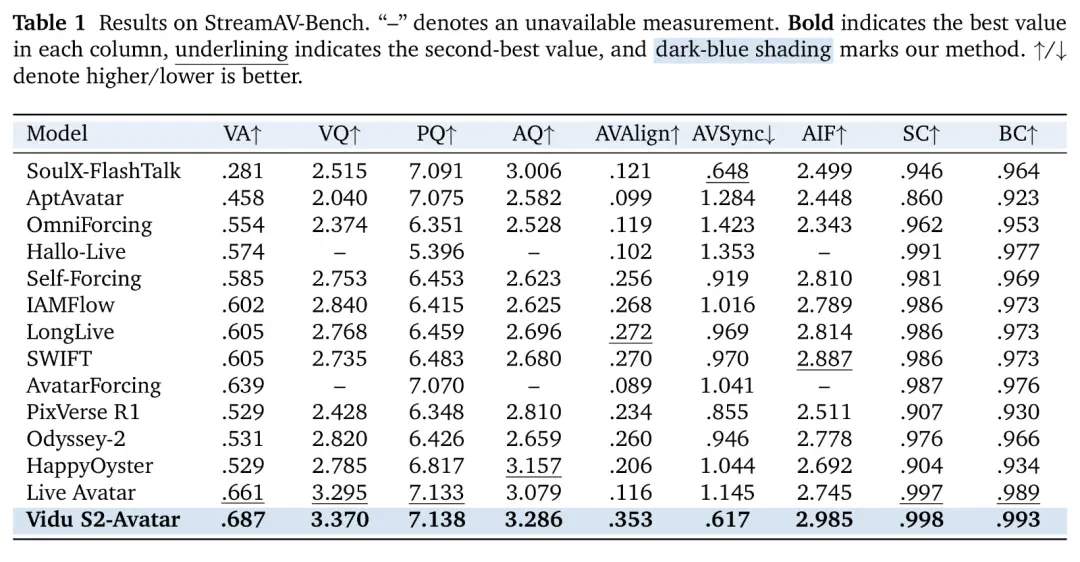
StreamAV-Bench
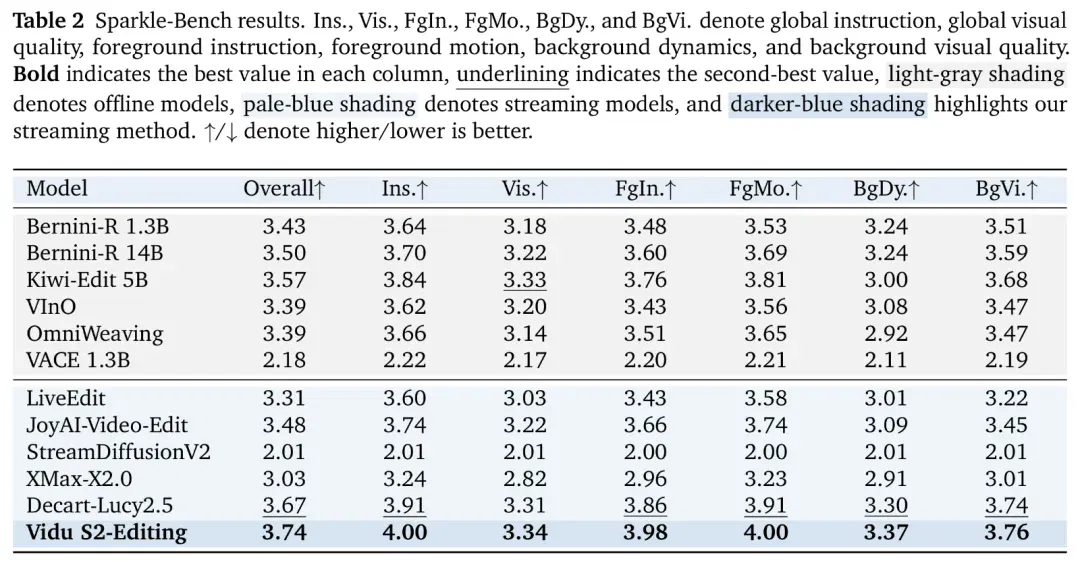
Sparkle-Bench
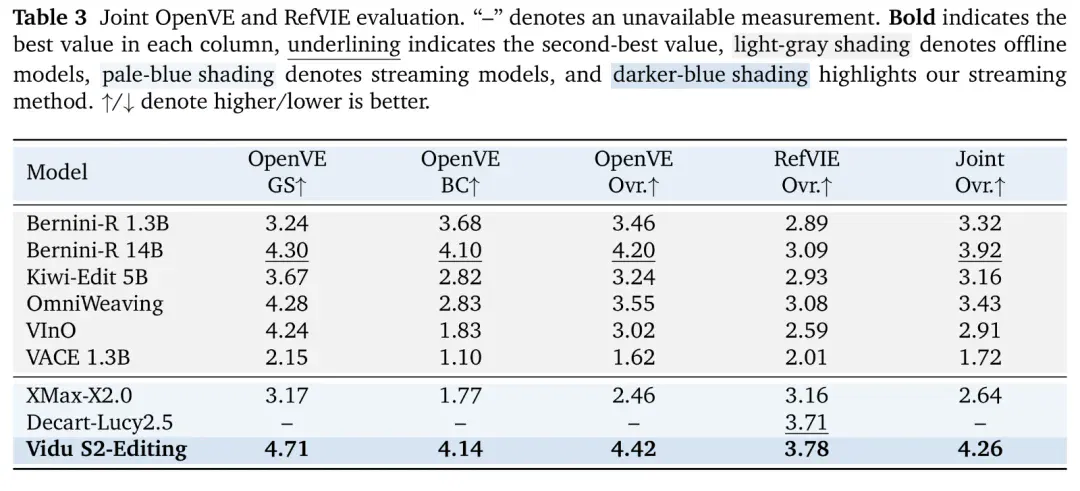
OpenVE 与 RefVIE
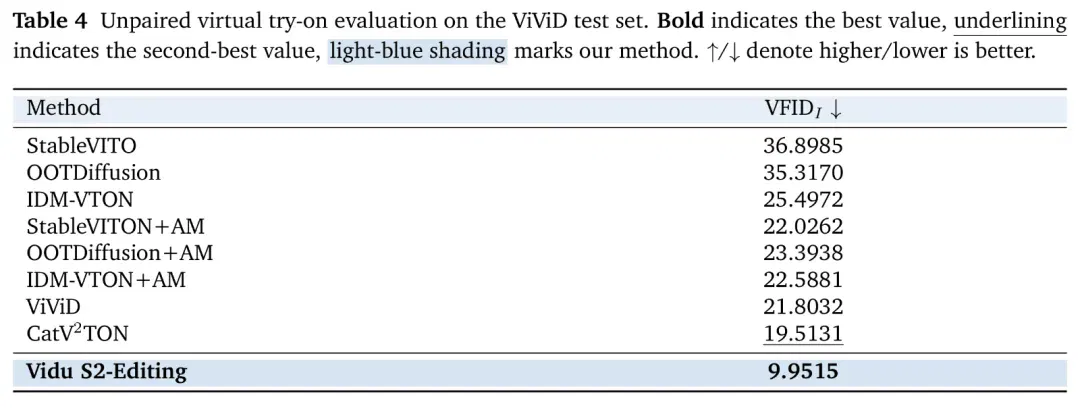
ViViD 虚拟试穿
最后
产品今天已经通过 Vidu 的官网,以在线 Demo 和 API 的方式放出,可以来试一个有关技术报告在这里,感兴趣的可以阅读技术报告:https://arxiv.org/pdf/2609.11638
文章来自于"赛博禅心",作者 "金色传说大聪明"。
相关主题
读完之后
加入 AINRK 交流群
了解加入交流群的方式,与更多 AI 从业者交流。
相关文章
继续阅读AI技术文章栏目中的内容。
当AI幻觉开始操作电脑:深大、港科大提出ECA,让Agent行动前先验证证据(在新窗口打开)
让 AI 帮忙发一封邮件,它可能把正文写得妥帖、附件整理得齐全,最后却发错了人。
网页藏毒,劫持Agent?你需要会「追凶」的自进化女警系统(在新窗口打开)
今天的AI Agent,已经不只是聊天窗口里「会说话」的模型。它们正在接入浏览器、文件系统、终端、API、MCP服务和各种自动化工作流,开始真正替用户执行任务。
高德联合南大、清华、北大发布WorldRoamBench,定义交互式世界模型长时漫游评测新范式(在新窗口打开)
随着 Genie 3 的发布,可交互世界模型真正走到台前:用户不再只是观看生成视频,而是可以输入动作实时改变一个持续演化的世界。世界模型开始从「生成一段视频」走向「模拟一个可交互世界」,但能走进去,不等于经得起探索。模型能否持续响应控制、维持视觉与空间一致、遵守物理规律并记住来路,仍缺少系统评测。
「人类造的最后一个AI」还有多远?一张图看懂OpenAI、Anthropic等大厂的RSI进度(在新窗口打开)
「人类造的最后一个 AI」还有多远?OpenAI、Anthropic 等头部厂商进度如何?定义中国 RSI 的 roadmap——前沿 AI 研究机构 Theseus Labs 结合 72 家产业实践,推出「RSI 五级框架」
3B模型成功率94.5%!Token级奖励打开长链路智能体训练新思路(在新窗口打开)
多轮智能体任务只有一个终点奖励,但在一条包含搜索、工具调用和多轮决策的轨迹里,决定成败的往往是一个不起眼的查询词、动作或对象选择。