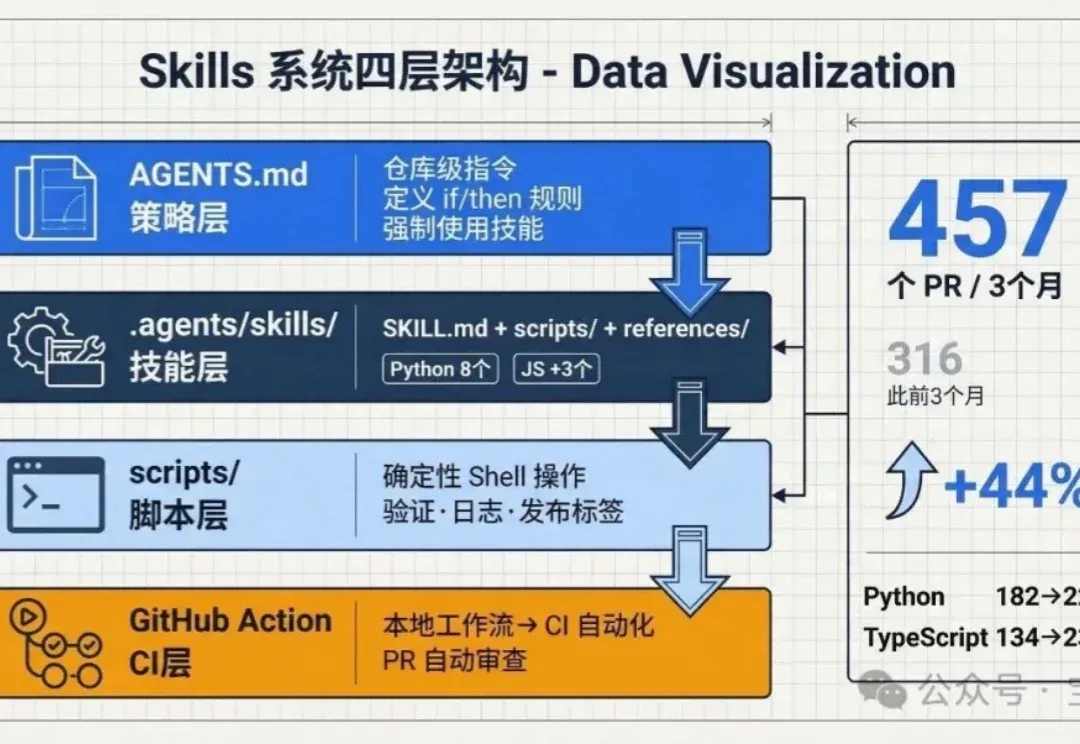
OpenAI 官方博客:用技能(Skills)加速开源项目维护(在新窗口打开)
我们用 Codex 改变了维护 OpenAI Agents SDK[1] 仓库的方式。仓库本地的技能(skills)、AGENTS.md 文件和 GitHub Actions,让我们把反复出现的工程工作——验证、发布准备、示例集成测试、PR 审查,变成了可重复执行的工作流。
内容栏目
分享不同 AI 工具、模型与相关技术的使用方法和实践文章。
我们用 Codex 改变了维护 OpenAI Agents SDK[1] 仓库的方式。仓库本地的技能(skills)、AGENTS.md 文件和 GitHub Actions,让我们把反复出现的工程工作——验证、发布准备、示例集成测试、PR 审查,变成了可重复执行的工作流。
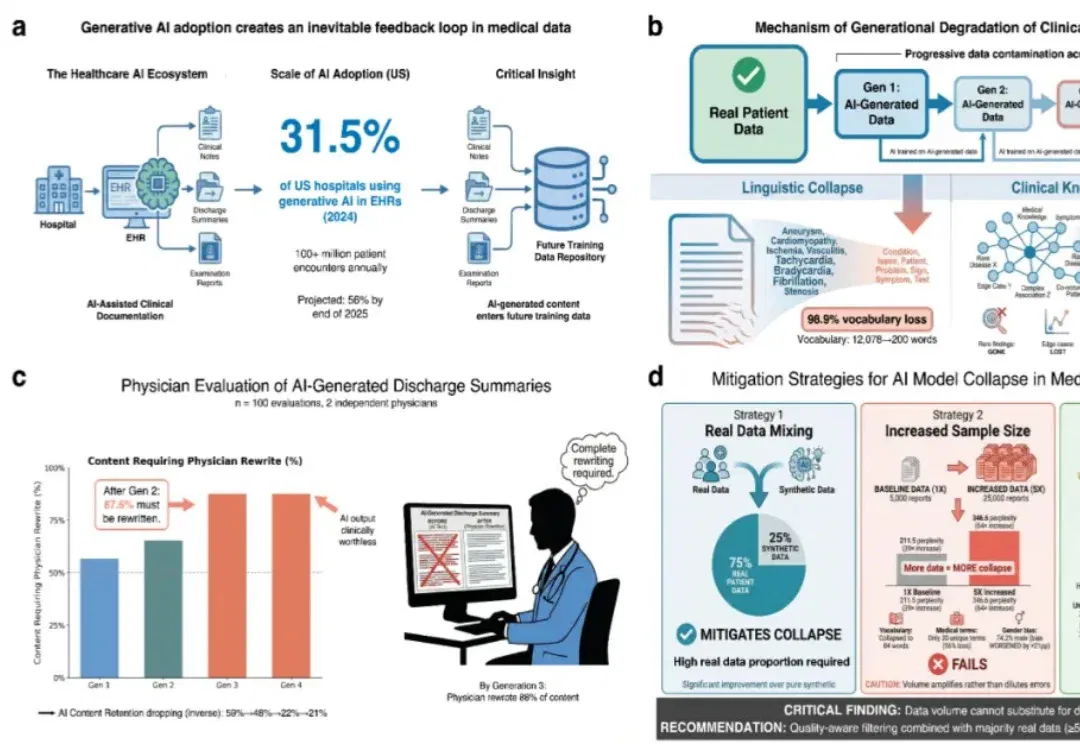
随着生成式人工智能在医疗领域的加速渗透,越来越多的病历、影像报告及各类临床文本正逐步纳入 AI 参与生成的范畴。这一旨在提升医疗效率的技术革新背后,潜藏着威胁诊断安全性的深层隐患。
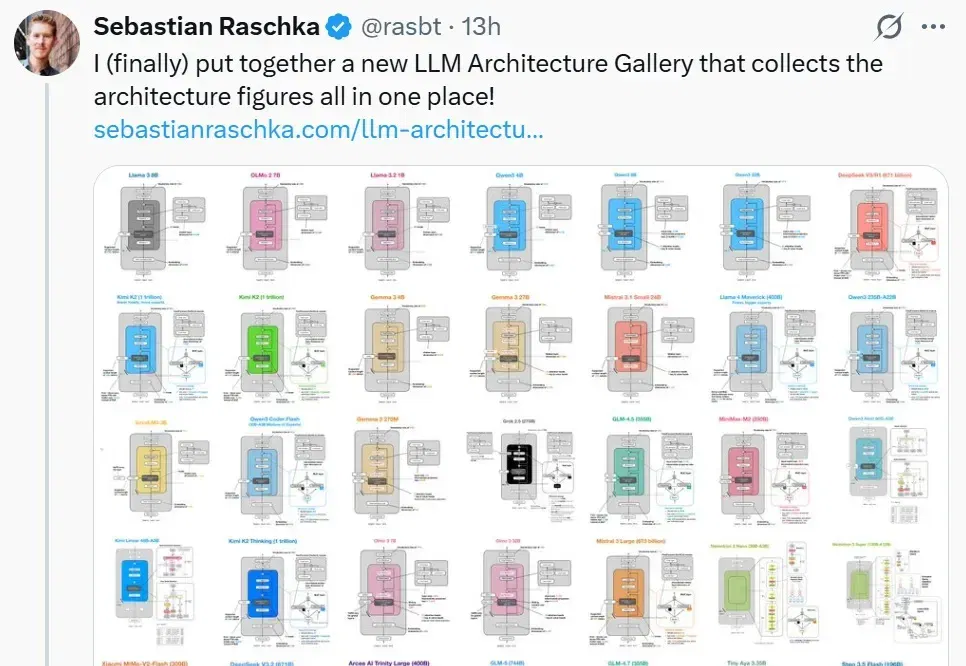
最近几年,大模型赛道好不热闹。 叫得上名字的几乎数都数不过来:从 GPT、Llama、Gemma、Mistral,到 DeepSeek、Qwen、Kimi、GLM、MiniMax 等等,新模型几乎以周更的速度出现。 但问题是,当架构创新越来越多时,理解它们反而变得越来越困难。不同论文里的模型结构图风格各异、模块命名不统一,即便是研究者,也很难快速看清一个模型究竟在哪些地方做出了关键改动。 如果把过去几年主流模型的架构放在一起,你会发现一个明显的空白:我们拥有大量模型,却缺少一张清晰的大模型架构图。 最近,AI 研究者 Sebastian Raschka 就尝试给了这样一张图,他将过去几年主流大
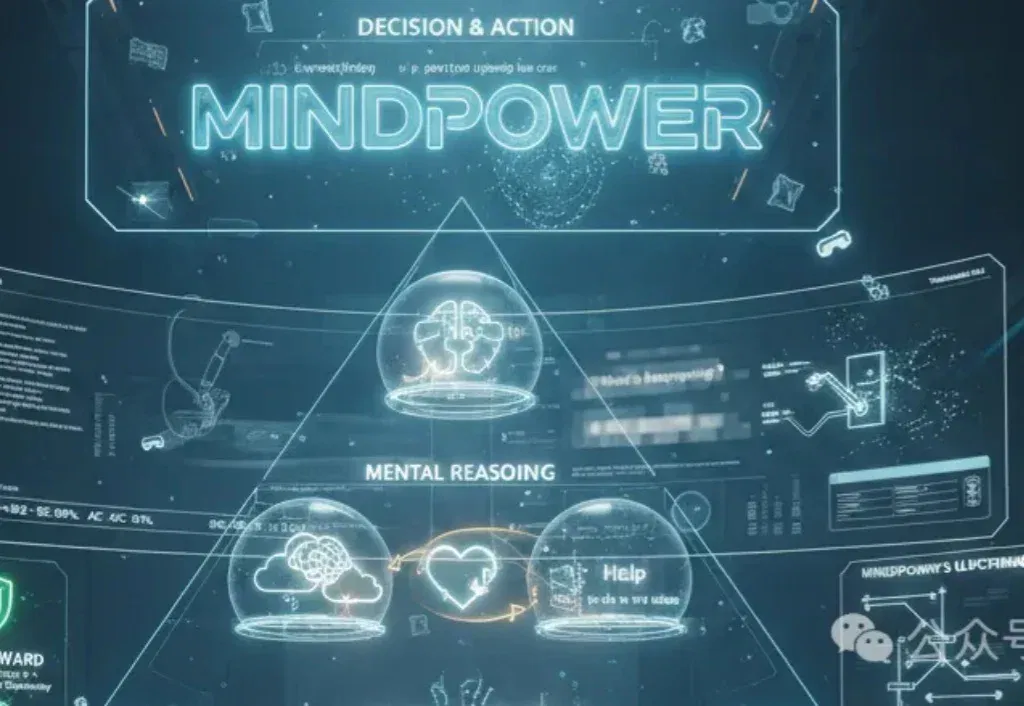
吉林大学&微软亚洲研究院等团队提出MindPower框架,让机器人像人一样理解他人想法并主动帮忙,构建了首个以机器人为中心的心智推理评测体系,通过六层推理链条,让AI不仅看懂场景,更能推断意图、做出决策、执行动作,显著提升助人能力。
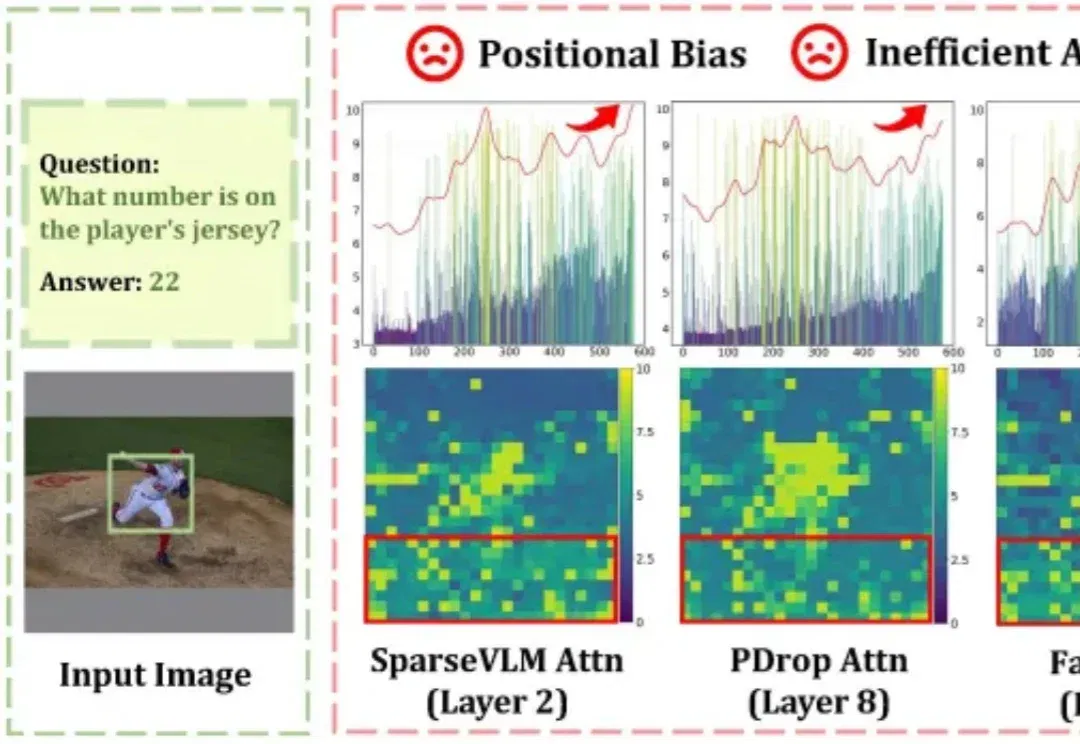
随着高分辨率图像理解与长视频处理需求的爆发式增长,大型视觉语言模型(LVLMs)所需处理的视觉 Token 数量急剧膨胀,推理效率成为落地部署的核心瓶颈。Token 压缩是缩短序列、提升吞吐的直接手段,但现有方法普遍依赖注意力权重来判断 Token 重要性,这一路线暗藏两个致命缺陷:
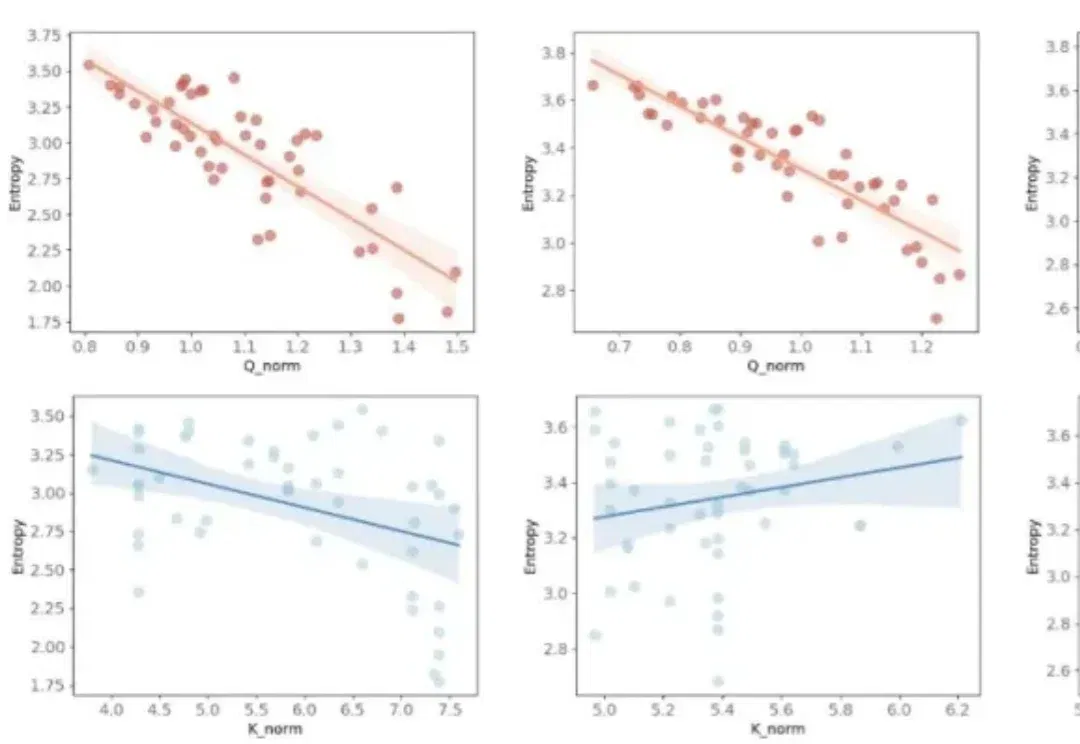
当 Transformer 席卷计算机视觉领域,高分辨率图像、超长序列任务带来的算力与显存瓶颈愈发凸显:标准 Softmax 注意力的二次复杂度,让 70K+token 的超分辨率任务直接显存爆炸,高分辨率图像分割、检测的推理延迟居高不下。
就在刚刚,Moonshot AI(月之暗面)发布了一项足以撼动 Transformer 底层的研究:《Attention Residuals》。海外科技大 V,谷歌高级AI产品经理 Shubham Saboo 直接开启了“高赞”模式:“他们触碰了那个十年没人敢碰的部分。”
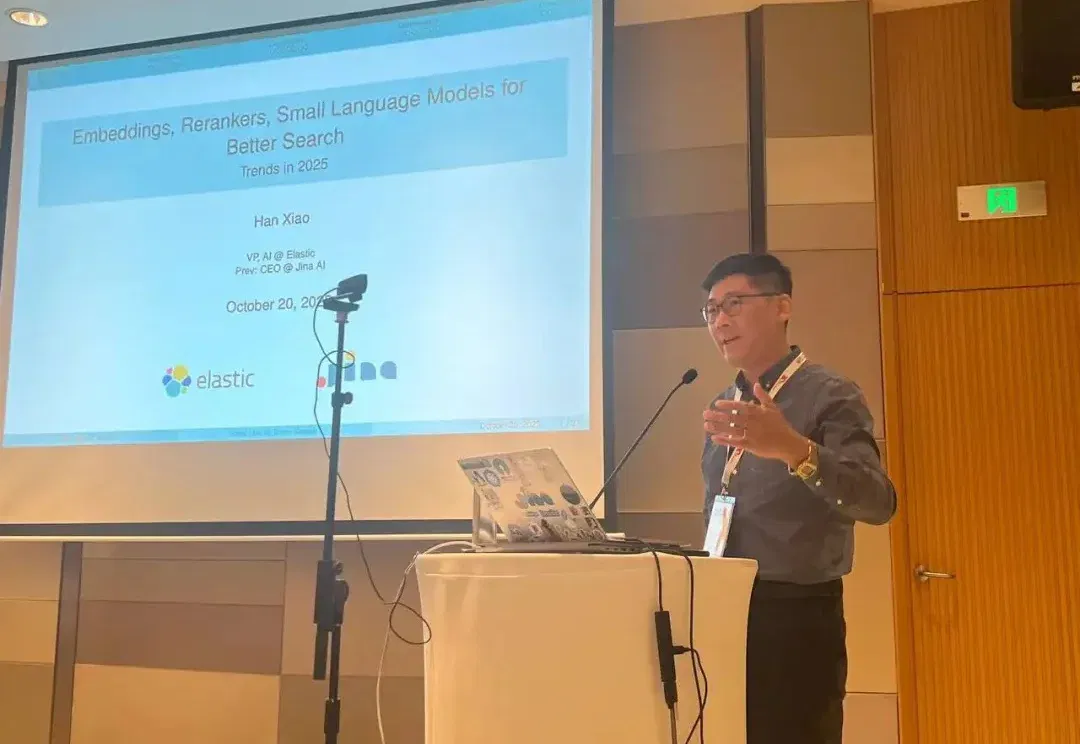
Google 最近发了 Gemini Embedding 2,他们第一个原生多模态向量模型。文本、图像、视频、音频、文档,全部映射到同一个 3072 维向量空间。这是 Omni Embedding(全模态向量模型)的大趋势:一个架构吃下所有模态,从 jina-embeddings-v4 到 Omni-Embed-Nemotron 再到 Omni-5,大家都在往这个方向收敛。
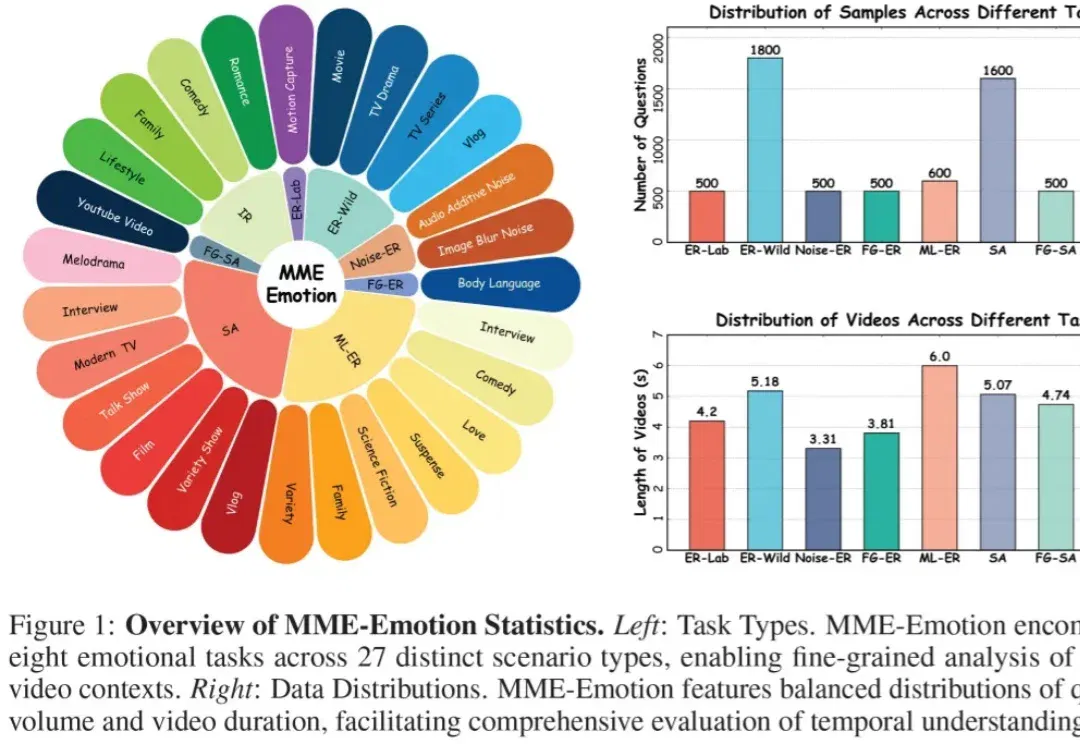
近年来,多模态大模型(Multimodal Large Language Models, MLLMs)正在迅速改变人工智能的能力边界。从图像理解到视频分析,从语音对话到复杂推理,大模型正在逐步具备类似人类的综合感知能力。但一个关键问题仍然没有得到充分回答:这些模型真的能够理解人类情绪吗?
在当前的 LLM 开发中,后训练阶段通常被视为赋予模型特定能力的关键环节。传统的观点认为,模型必须通过强化学习(如 PPO、GRPO 或 RLHF)和进化策略(ES)等算法,在反复的迭代和梯度优化过程中调整权重,才能在特定任务上达到理想的性能。
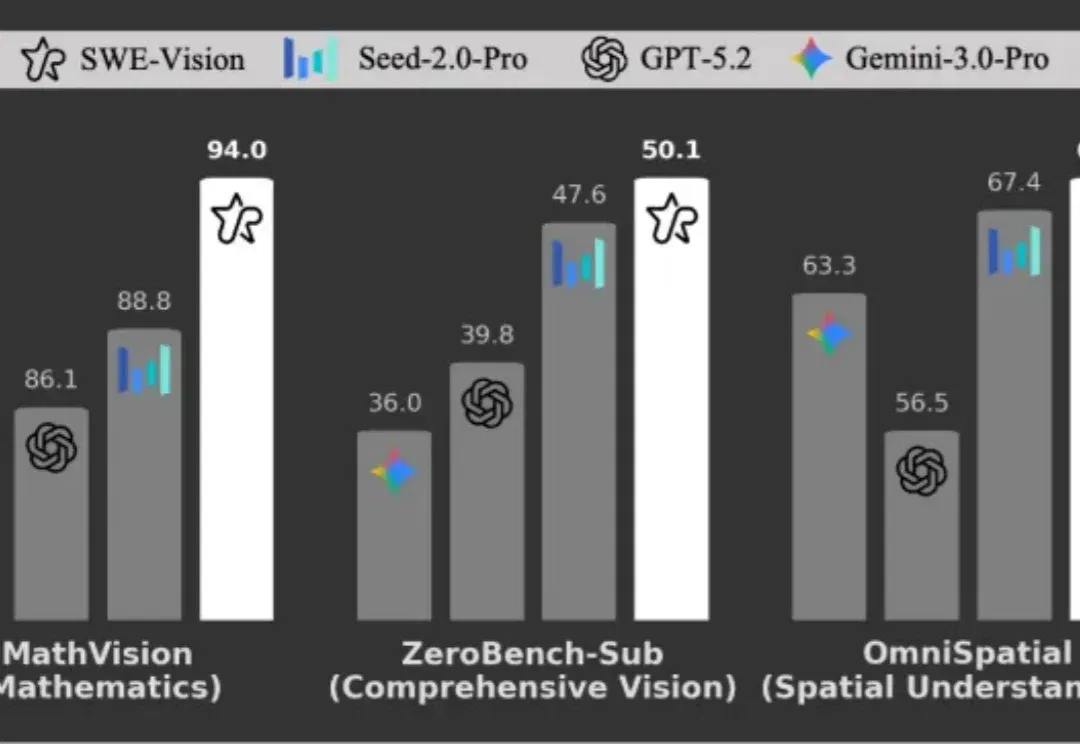
多模态大模型在代码能力上进步惊人,但在基础视觉任务上却频繁失误。UniPat AI 构建了一个极简的视觉智能体框架 ——SWE-Vision,让模型可以编写并执行 Python 代码来处理和验证自己的视觉判断。在五个主流视觉基准测试中,SWE-Vision 均达到了当前最优水平。
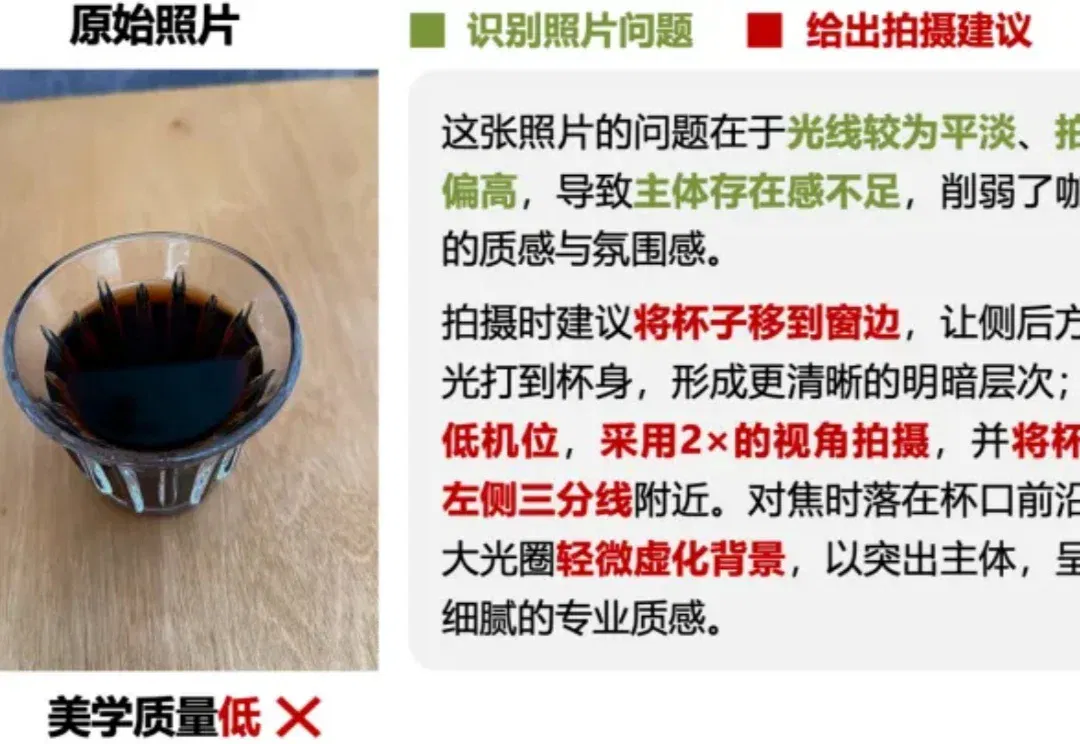
你随手拍下一张照片,AI也许只会夸“真好看”,却说不出一句真正有用的建议。
自2025年10月Claude正式确立Agent Skills规范以来 ,Agent能力的边界正在被暴涨的脚本仓库迅速拓宽。截至2026年2月末,公开可用的Skills数量已突破28万大关 。回顾过去半年,Skills开发的火力几乎全集中在了“供给侧”,而且绝大多数由分散的第三方开发者维护。
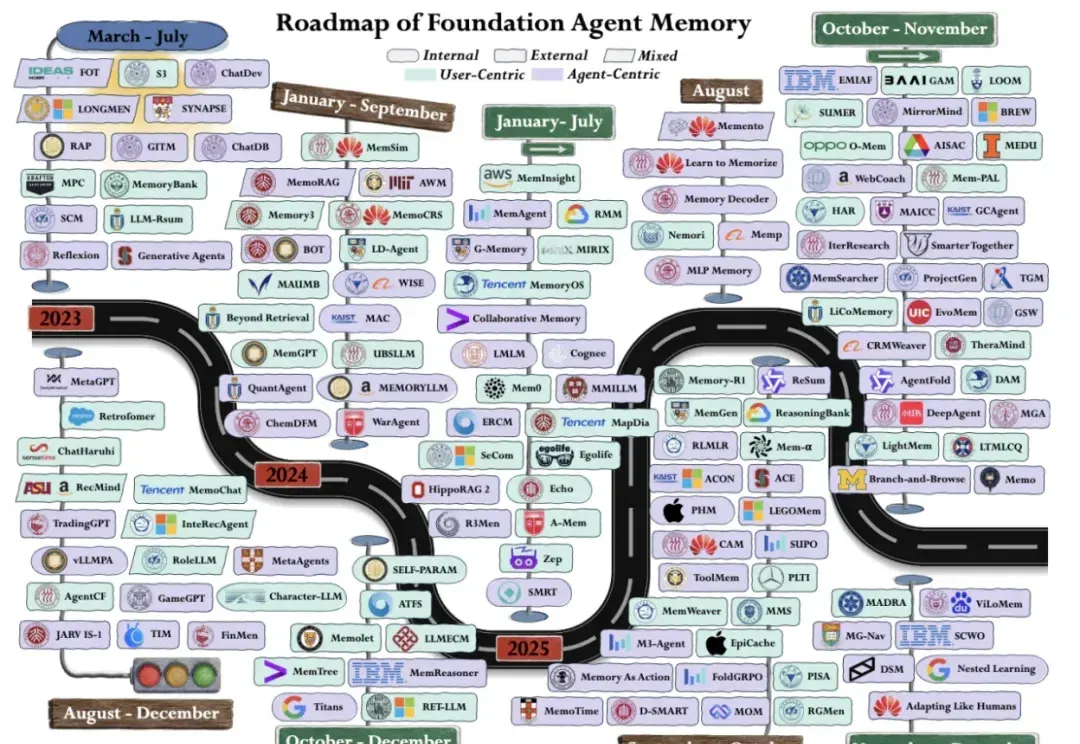
最近,一个叫OpenClaw(小龙虾)的开源项目突然爆火,甚至出现线下排队安装的场面。很多人第一次直观地看到,AI不只是chatbot,而是可以真正“动手”操作电脑、完成复杂任务和个性化工作流的智能体。这意味着AI正在进入下半场,开始走向真实应用,并逐渐进入普通人的日常生活。
先提前预告下,这个项目解决不了不赚钱的问题,但能帮助减少冲动交易,解决信息搜集、分析效率低问题。当然,也有同事吐槽,这是个韭菜RL,大家有选择地参考与批判一下就好。
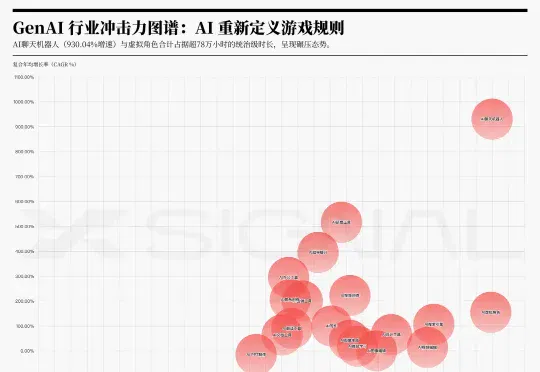
根据Xsignal AI Holo(AI全息)数据库数据显示,2026年初的AI细分行业数据,如果说“活跃用户量”代表了用户的使用意愿,那么“使用时长”则揭示了真实的市场依存度。基于这两项指标的交叉分析,市场已出现严重的结构性分化:
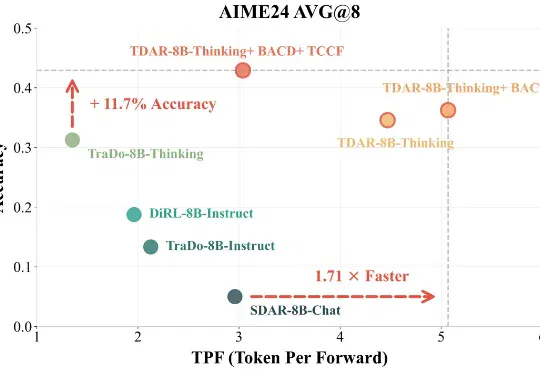
近期,复旦大学 NLP 实验室(FDU NLP)、北京大学知识计算实验室(KCL)联合美团 LongCat Team 提出了一种 Block Diffusion 推理模型 Test-Time Scaling 新框架 TDAR,通过引入 “粗思考,细求证” (Think Coarse Critic Fine, TCCF) 范式与有界自适应置信度解码
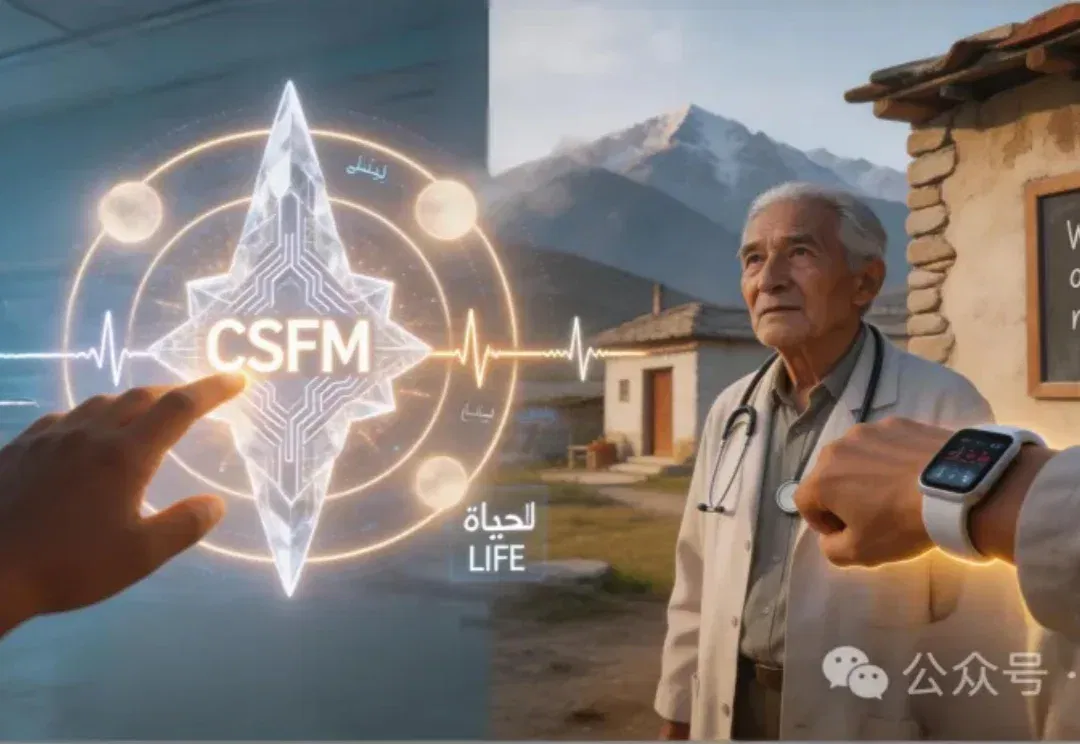
牛津大学团队推出全球首个心脏传感基础模型CSFM,能统一分析智能手环、心电图等多源数据,无论信号来自何处、是否完整,都能精准诊断房颤、预测死亡风险、重构血压波形,甚至用单一脉搏波生成完整心电图。打破了设备壁垒,让偏远地区也能享用顶级心脏监护,推动全球医疗平权。
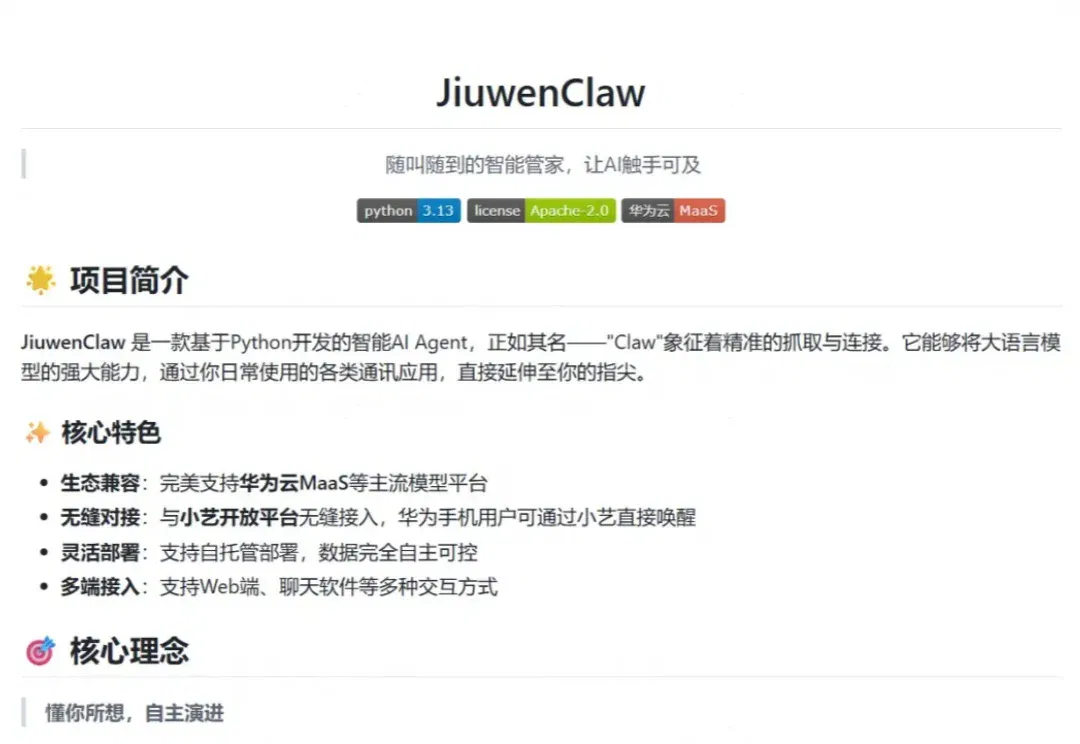
一个月前我们发布了基于华为 openJiuwen 开源社区构建的 DeepAgent 和 DeepSearch 两款智能体双双霸榜 [DeepAgent与DeepSearch双双霸榜!答案指向openJiuwen这一新兴开源项目]
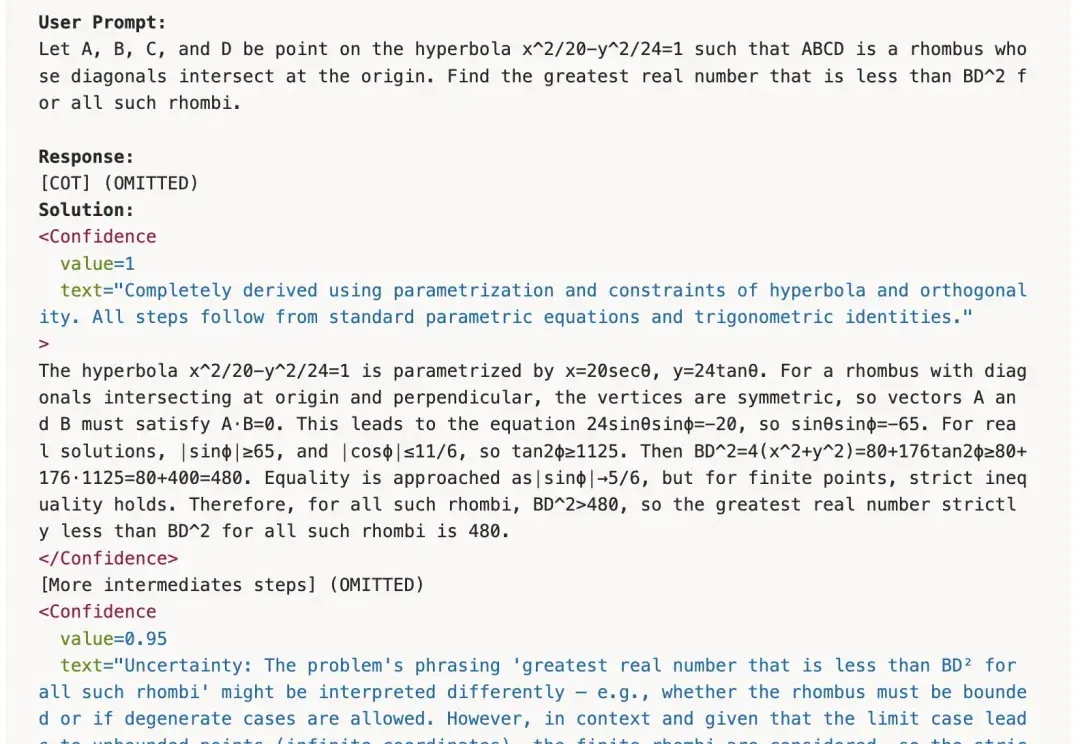
大语言模型(LLM)的幻觉问题一直是阻碍其在关键领域部署的核心难题。近日,研究人员提出了一种名为行为校准强化学习(Behaviorally Calibrated Reinforcement Learning)的新方法,通过重新设计奖励函数,让模型学会「知之为知之,不知为不知」。
参与交流
了解加入交流群的方式,阅读内容无需登录。