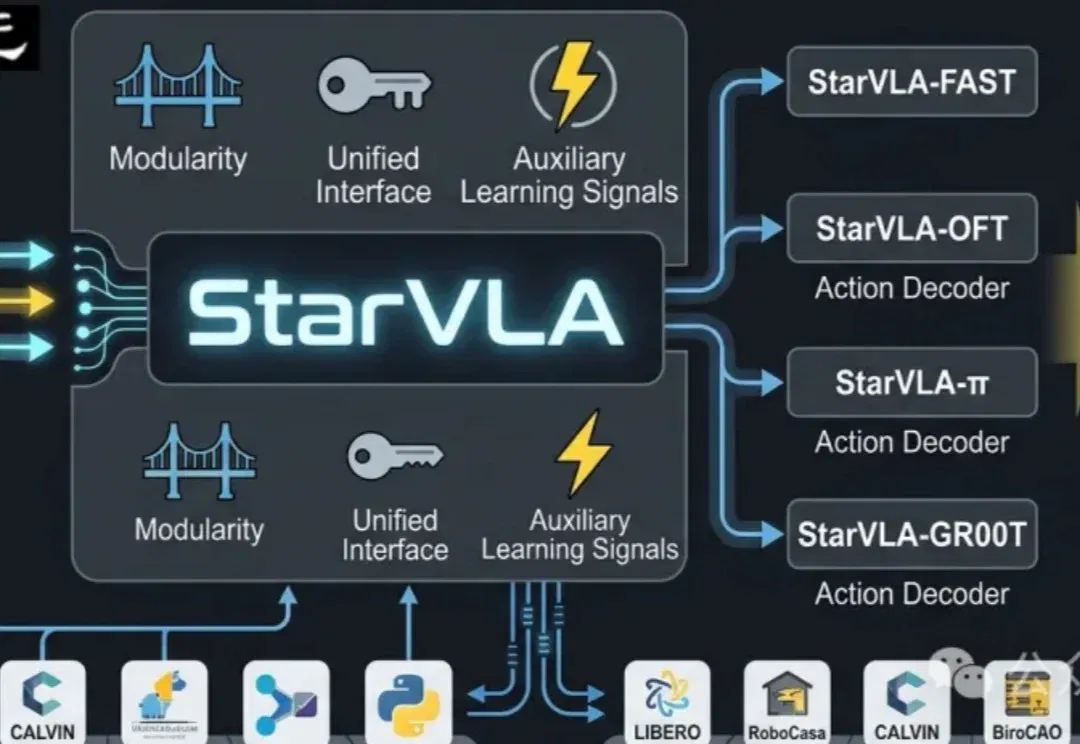
统一VLA范式!港科大开源StarVLA乐高式架构,复现成本大幅降低(在新窗口打开)
当前具身智能的VLA(Vision-Language-Action)赛道正陷入典型的「碎片化」泥潭:不同团队采用异构的动作解码范式、强耦合的数据管线、互不兼容的评测协议,导致方法难以横向对比,复现成本极高。
内容栏目
分享不同 AI 工具、模型与相关技术的使用方法和实践文章。
当前具身智能的VLA(Vision-Language-Action)赛道正陷入典型的「碎片化」泥潭:不同团队采用异构的动作解码范式、强耦合的数据管线、互不兼容的评测协议,导致方法难以横向对比,复现成本极高。
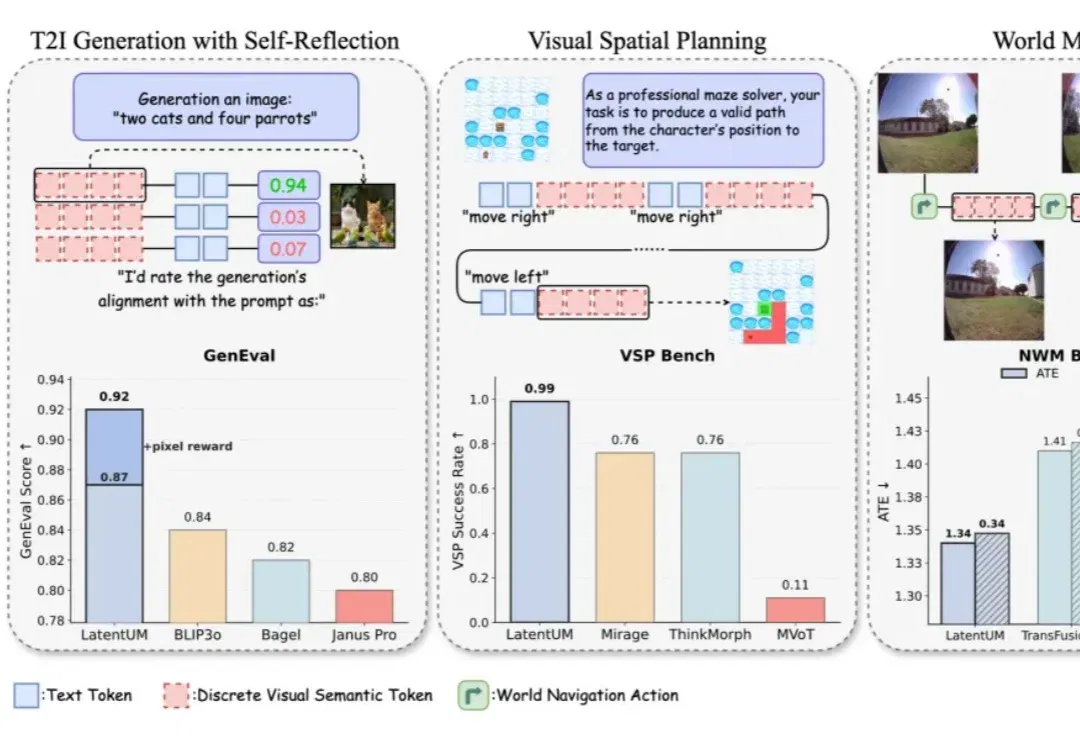
过去一段时间,生成理解统一模型(Unified Model)经常被理解成一种「既能看懂图、又能生成图」的多模态通用系统。
让一个模型概括“这是一段什么视频”,并不难。
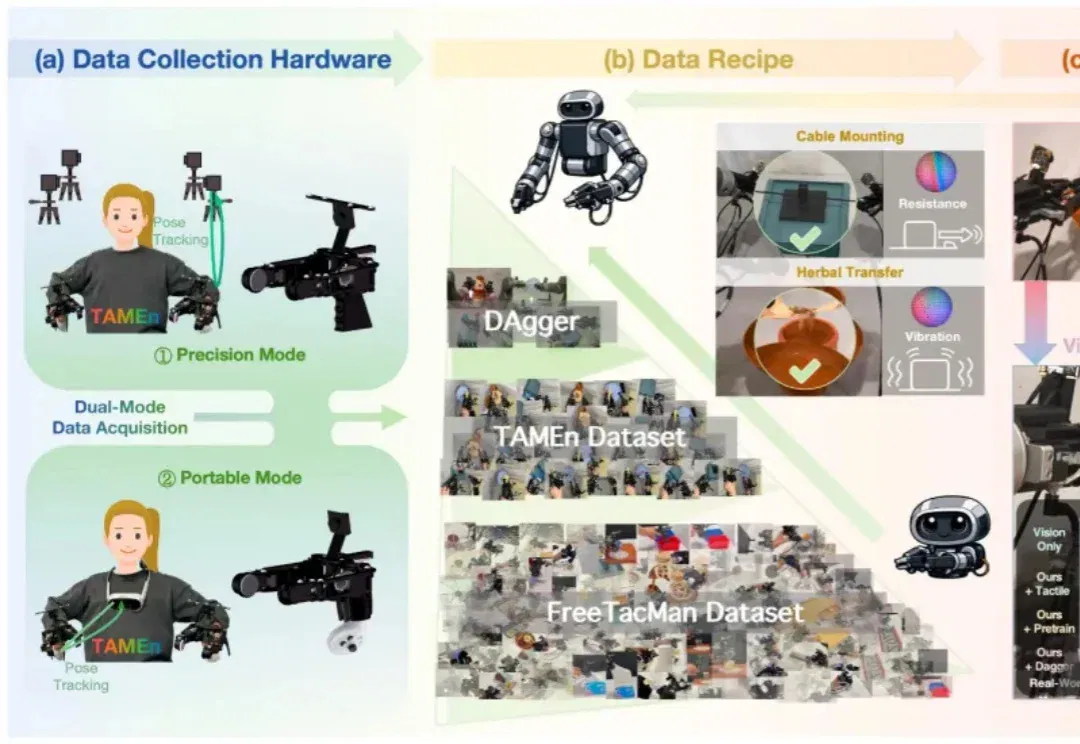
在具身智能快速发展的今天,高质量数据已成为驱动能力提升的关键基础,然而一个核心问题也随之而来: 如何让机器人数据采集更快、更稳、更有效?
硅谷新宠Hermes Agent一夜爆火,不仅在GitHub狂揽6.6万星,更因原生接入微信让开发者全线沸腾。如今,Hermes署名的首篇「顶会级」论文也出世了。如今,这款历经9个月打磨,一夜成名的Agent,已在GitHub上狂揽66k星,Fork有8.8k。
Claude最强“神话”模型,可能用到来自字节的技术?
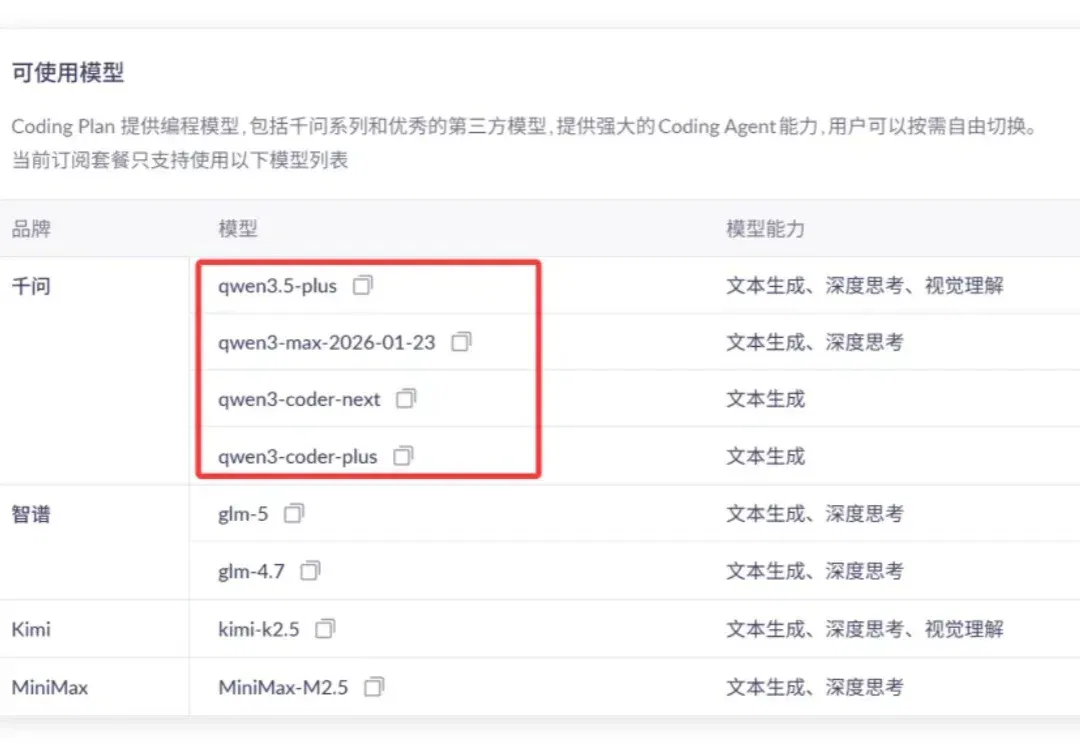
昨天我发现 Qwen3.6“倒反天罡”。
有没有想过让「龙虾」替你打麻将? 自从龙虾热以来,大家慢慢接受了 AI 智能体能够在电脑上执行操作的特性。 既然龙虾具备一定的控制能力,那让它替我去挣欢乐豆不过分吧。 遗憾的是,现在的龙虾,称之为「Claw」是有道理的,笨拙的龙虾爪的确很难进行复杂操作。让它打开浏览器逛逛电商平台比价,都要寻找各种对应的 Skills,而且执行的吭哧瘪肚的,这的确让人很难放心地将正经工作流交给龙虾。 时隔半年有余,那个能够直接操作图形界面的,曾经取得双榜 SOTA 的通用 GUI 智能体模型 Mano 再一次产生了飞跃。不仅解决了自动操作工作流的痛点,甚至连「替我打麻将」的梦想都实现了: 这次,明略科技带着自研
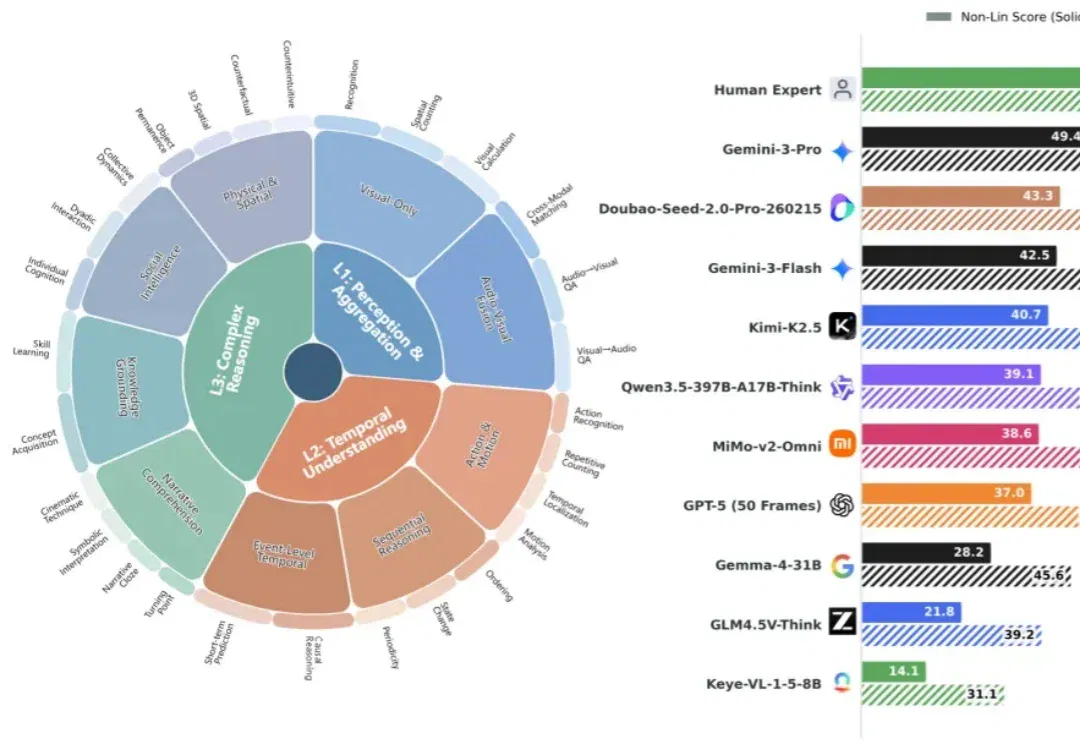
现有大模型评测分数日趋饱和,但与真实体验差距显著。南京大学傅朝友团队牵头,在 Google Gemini 评测团队邀约下推出视频理解新基准 Video-MME-v2。凭借创新的分层能力体系与组级非线性评分,以及 3300 + 人工时高质量标注,揭示模型与人类的巨大鸿沟(49 vs 90)、传统 Acc 指标虚高、以及 “Thinking” 并非总是增益等现象。
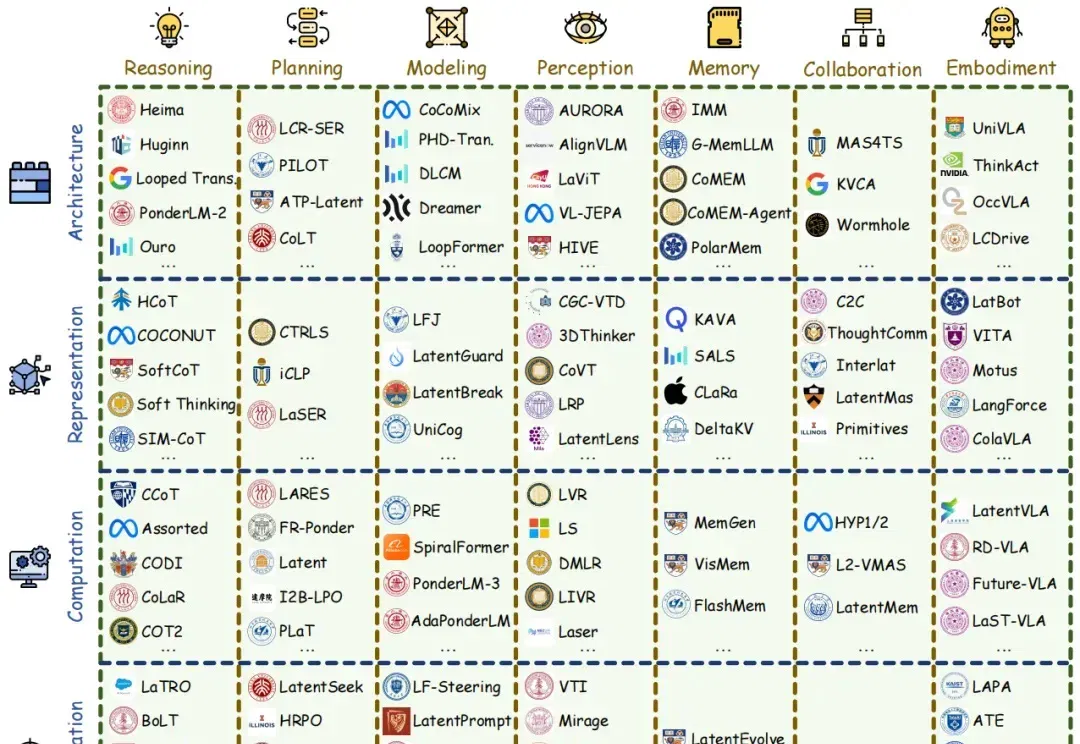
从 2024 年底的关于潜在空间的早期探索,再到 2025 年底和 2026 年初的相关研究爆发,潜空间范式正在彻底重塑大模型 (LLMs, VLMs, VLAs 等延伸模型) 的底层设计逻辑。
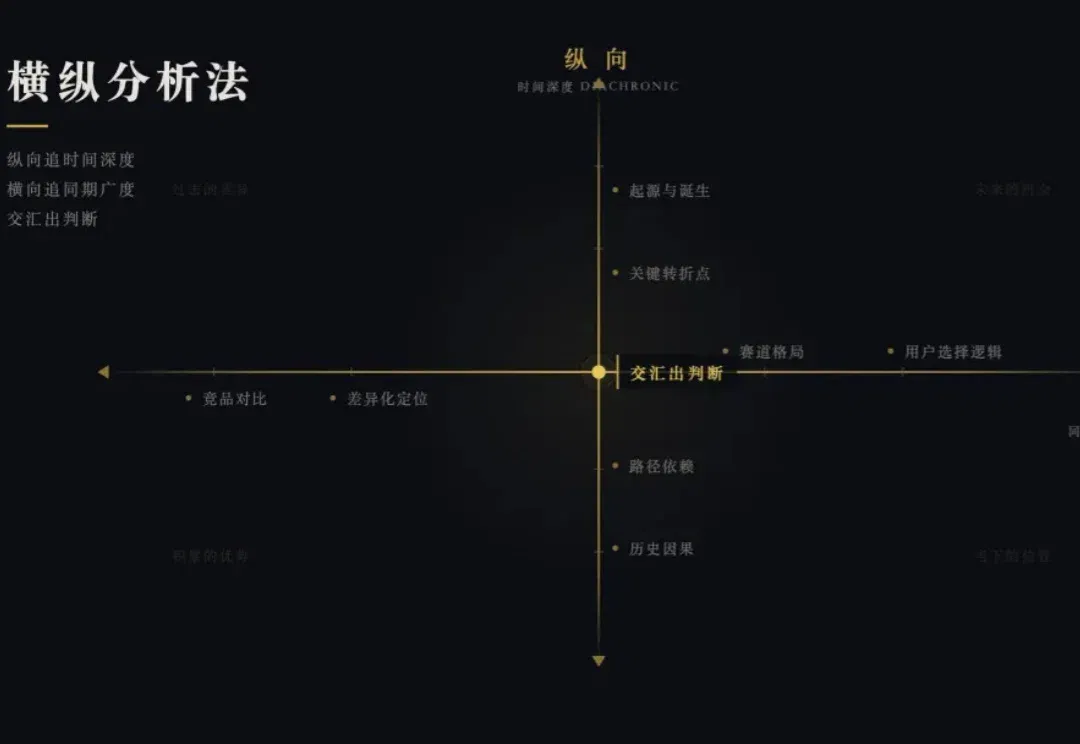
前两天办完大会,然后昨天周末跟一个朋友吃饭,聊着聊着他突然放下筷子看着我说了一句,不是哥们,你怎么什么都懂一点?
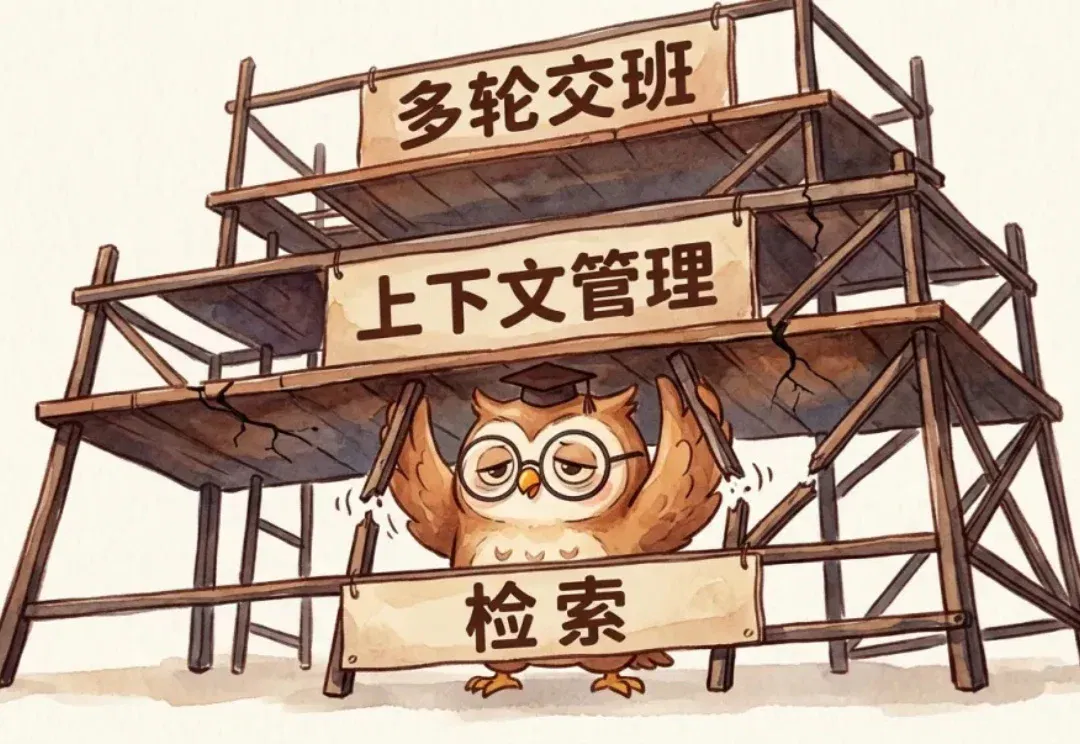
随着任务的复杂度提升,Agent(智能体)的上下文在无限膨胀。在无穷的历史对话、工具调用输出、中间步骤以及报错信息中,模型迷糊了,于是开始跳步、忽视、绕道。
在本文中,我将探讨编码智能体(coding agents)及其智能体编排(agent harnesses)的整体设计:它们究竟是什么、工作原理如何,以及在实际应用中各组件是如何协同运作的。
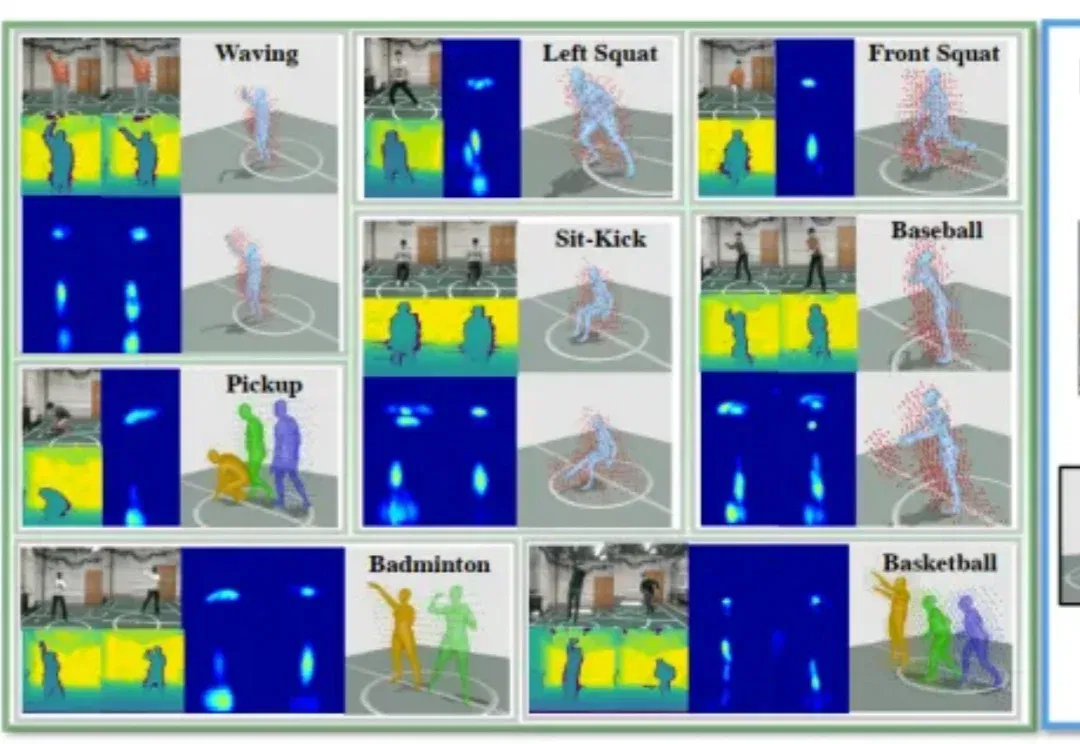
想象几个并不遥远的场景: 医院的病房里,刚做完手术的患者正在练习下床、走动,智能系统通过摄像头捕捉他的动作,判断步态是否稳定、有没有跌倒风险;回到家,在卧室或浴室这样私密的空间里,老人起身、转身、洗漱,甚至意外滑倒的瞬间,也可能被视觉传感器记录,只为了让 AI 能更早发现异常;
Anthropic 的 Claude Code 源码被扒了个干干净净。55 个目录、331 个模块、目前业界最经受实战检验的 Agent 架构——全部暴露在 .map 文件里。
现有大模型评测分数日趋饱和,但与真实体验差距显著。南京大学傅朝友团队牵头,在Google Gemini评测团队邀约下推出视频理解新基准Video-MME-v2。凭借创新的分层能力体系与组级非线性评分,以及3300+人工时高质量标注,揭示模型与人类的巨大鸿沟(49vs90)、传统Acc指标虚高、以及「Thinking」并非总是增益等现象。
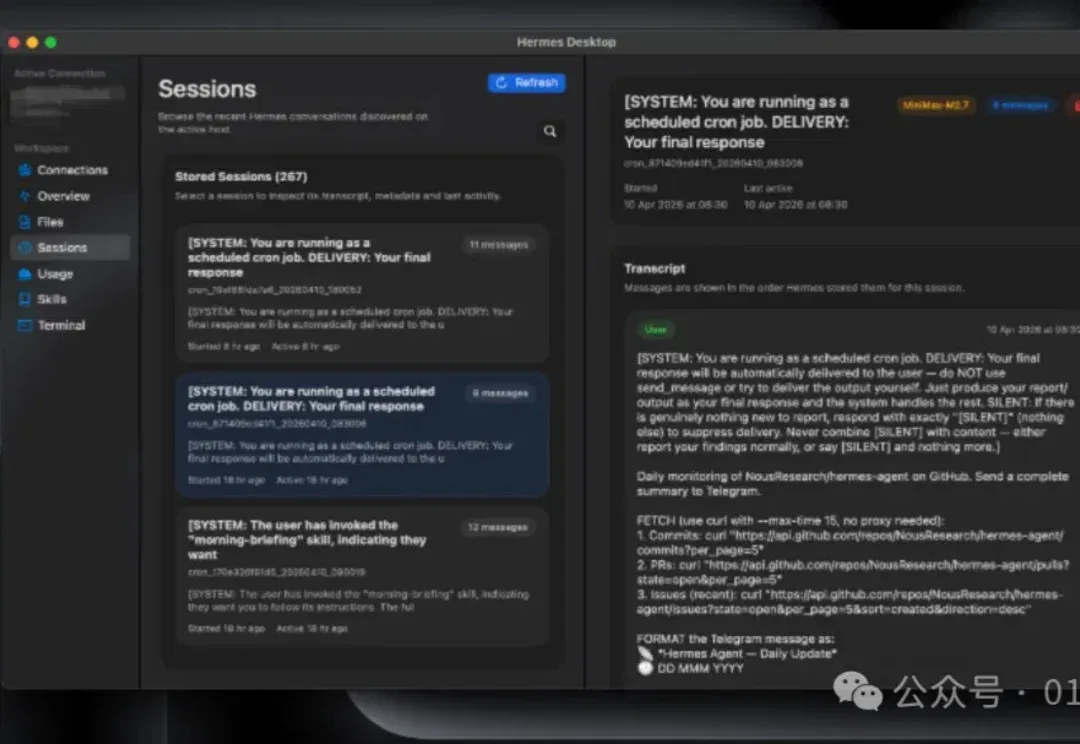
对于已经在使用强大的 Hermes Agent 的 Mac 用户来说,现在有了一款能让您的工作流更加流畅、更具原生体验的工具——Hermes Desktop。它并非一个简单的浏览器封装,而是一款专为 macOS 设计的本地应用程序,旨在将您最关心的工作流程无缝集成到一个窗口中。
腾讯云“防爆箱”护航百万“龙虾”上岗,已助力MiniMax强化学习训练。
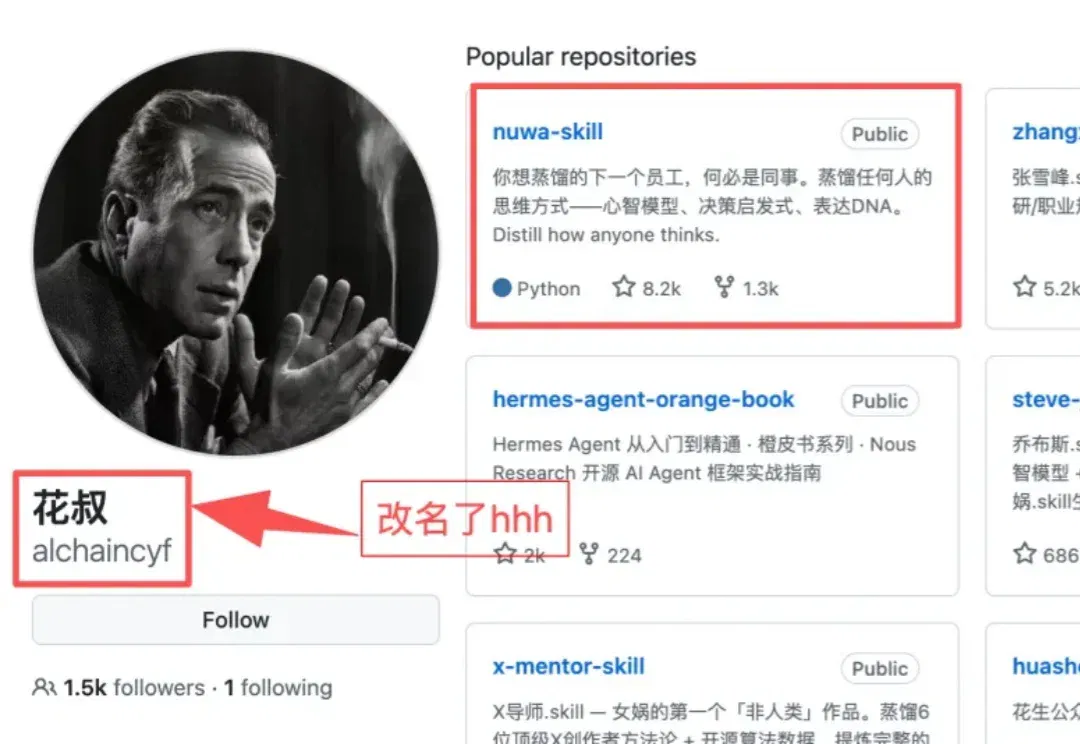
「小猫补光灯」的作者花生...啊不...这人改名叫花叔了...hhhh,又整了一个新活:一周 8000 多个 star
LangChain 只换了模型外面的基础设施——同一个模型、同一套权重——就从 TerminalBench 2.0 排行榜 30 名开外直接跳到了第 5 名。另一个独立研究项目让大模型自己优化这层基础设施,达到了 76.4% 的通过率,超过了所有人工设计的方案。
参与交流
了解加入交流群的方式,阅读内容无需登录。