肉眼看不出的幻觉?清华提出视觉源幻觉,仅用0.9%数据实现SOTA(在新窗口打开)
新智元报道 多模态大模型的物体幻觉,长期被归因于语言先验。 先看下面两组对话。 第一组,一张只有小狗的照片,问模型「图中有椅子吗」,它答「没有,图中是一只狗」,完全正确; 第二组,另一张照片,问「图中
内容栏目
分享不同 AI 工具、模型与相关技术的使用方法和实践文章。
新智元报道 多模态大模型的物体幻觉,长期被归因于语言先验。 先看下面两组对话。 第一组,一张只有小狗的照片,问模型「图中有椅子吗」,它答「没有,图中是一只狗」,完全正确; 第二组,另一张照片,问「图中
NTU、CMU、Berkeley等高校联合推出VBVR-Pro视觉推理系统,构建300项任务与100项可验证打分器的训练评测平台,测试30余个多模态模型,并验证其打分器可直接作为强化学习奖励。
Anthropic联合MIT、斯坦福学者发布2030年三种经济情景推演,极端情景下美国GDP暴增32%但白领失业率飙至17.9%,资本攫取55%增长红利,万余名美国人调查预期偏向最严峻版本。
Aether AI 发布 16B 参数因果世界模型 CausalWM,引入因果思维链将光流、深度与三维几何组织成 Motion→Geometry→Future 推理路径显式推演物理变化,在 TriWorldBench 以 66.04 分登顶并在 PAI-Bench 等基准取得领先。
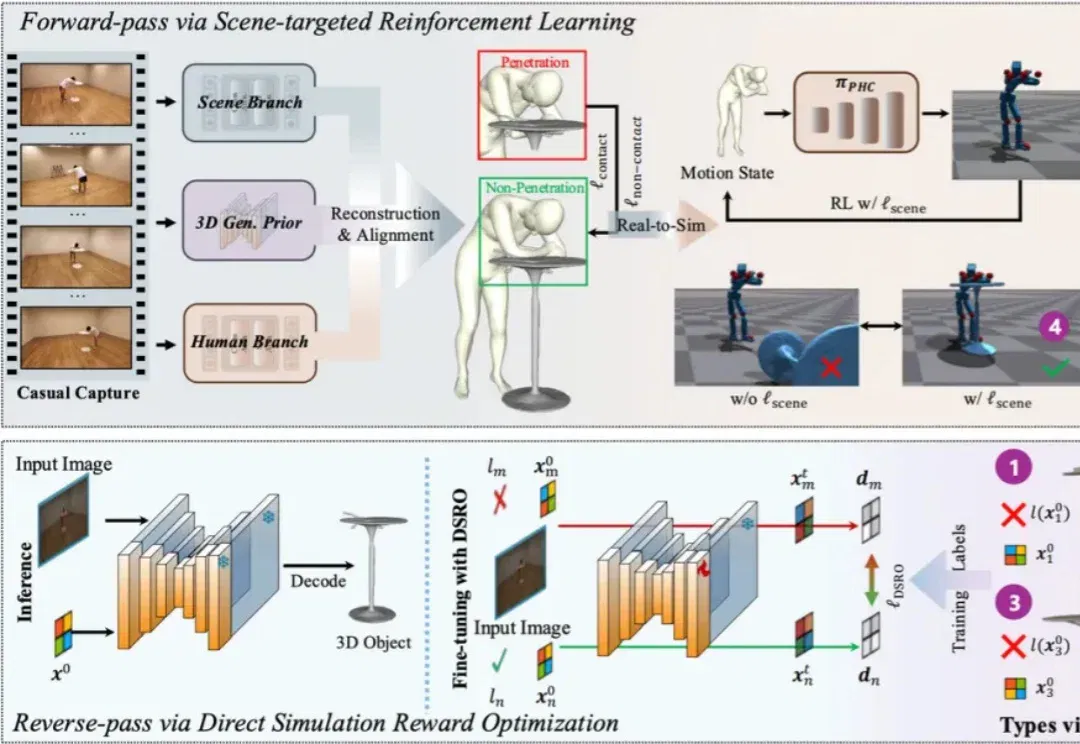
一段人坐上椅子的视频,对人类而言再普通不过。我们不仅能看见 “人坐了下来”,还天然理解椅子承受人体重量,人与椅面形成接触并最终稳定,这些重力、接触与作用关系共同构成真实世界中的物理交互。但对今天的三维重建系统而言,“看见动作” 与 “重建真实交互” 仍是两回事。一个视觉上准确坐在椅子上的人体,进入物理仿真后,椅子可能因结构缺失倒下,人体也可能与椅面严重穿模。视觉上成立,并不意味着物理交互上成立。
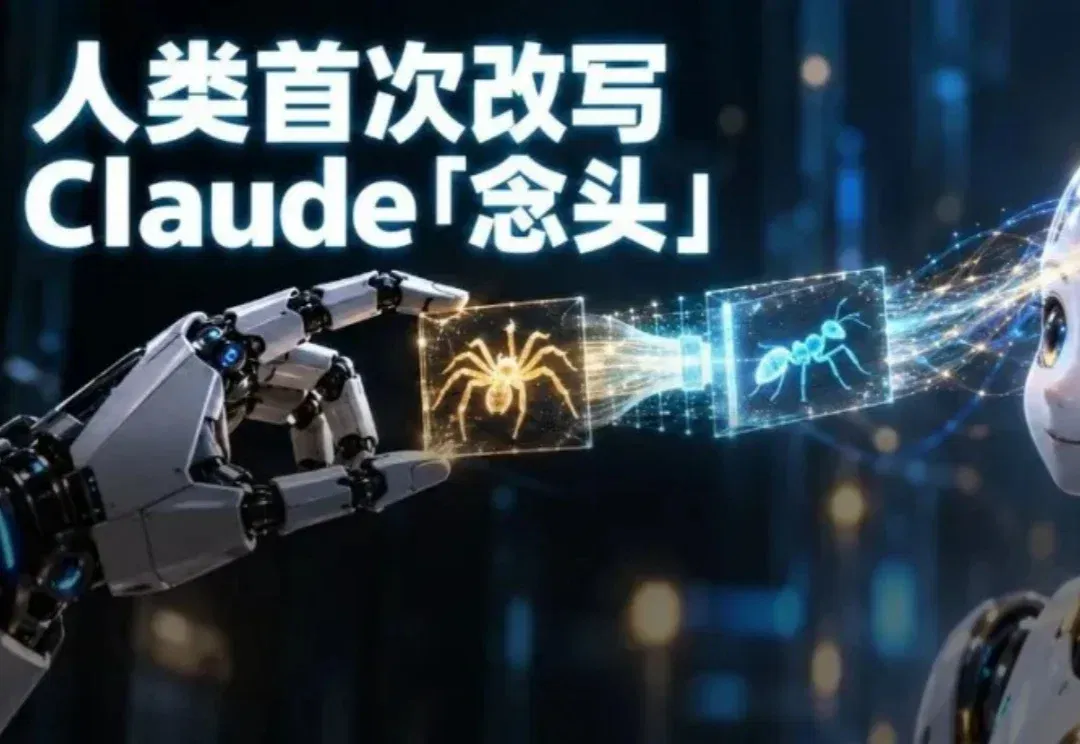
「会结网的动物有几条腿?」 8,Claude回答。 从提问到回答,它一次也没有提到「蜘蛛」。但研究者发现,在它算到一半的时候,这个词的确在它的脑子里闪了一下。 于是,研究者们做了一件有点魔幻的事情: 把手「伸进」Claude的神经网络,将那个正亮着的「蜘蛛」抠掉,原位塞进一个同等强度的「蚂蚁」,其他任何参数都没动。 结果,Claude的答案变了:6。 研究人员没有动提示词,也没有动思维链,而是第一次直接篡改了AI在说出口之前的那个「念头」或者所谓的意识。 7月6日,Anthropic公开了这篇轰动学界的论文:他们在Claude体内找到了一小撮特殊的内部表征,起名叫J-space。 让Claud
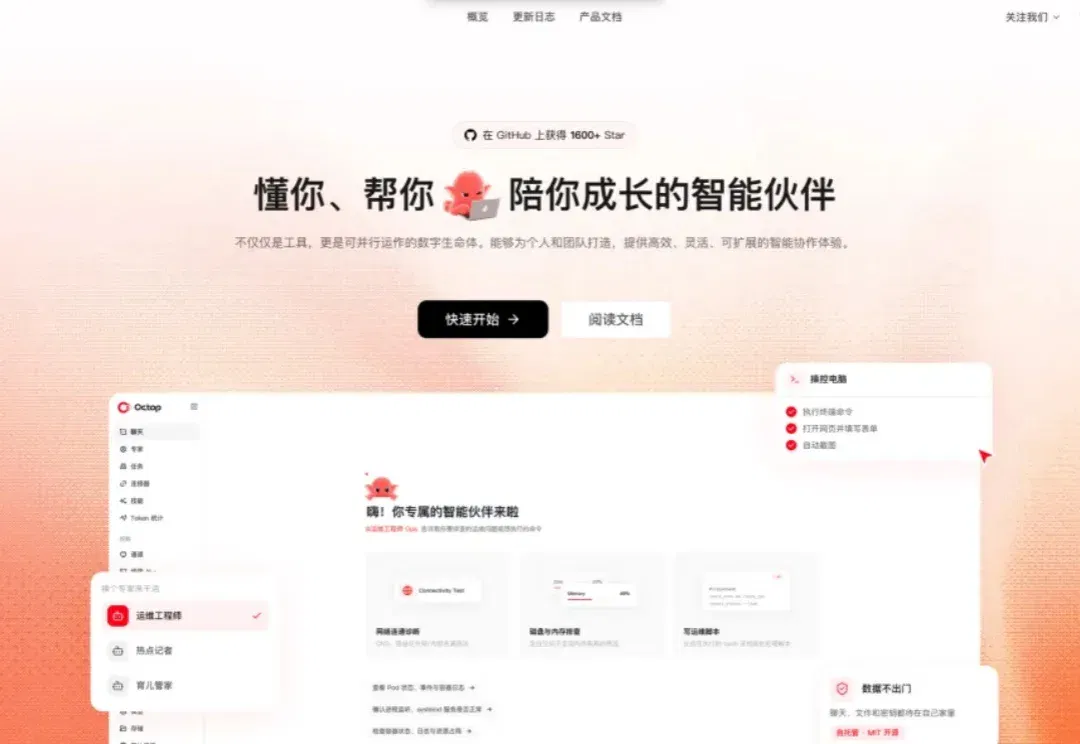
经过 Octop 团队与社区开发者一段时间的共同推进,在一次次测试、打磨与优化之后,我们正式推出 Octop 1.0 GA版本(General Availability,正式发布版),并同步上线腾讯云轻量应用服务器(Lighthouse)与云服务器(CVM)官方应用镜像——购买即用的自托管 AI 助手,现在触手可及。
AI 写代码的能力经常能让开发者「双手离开键盘」,但对于设计师而言,AI 生成的图片距离能交稿总是差了好几步。
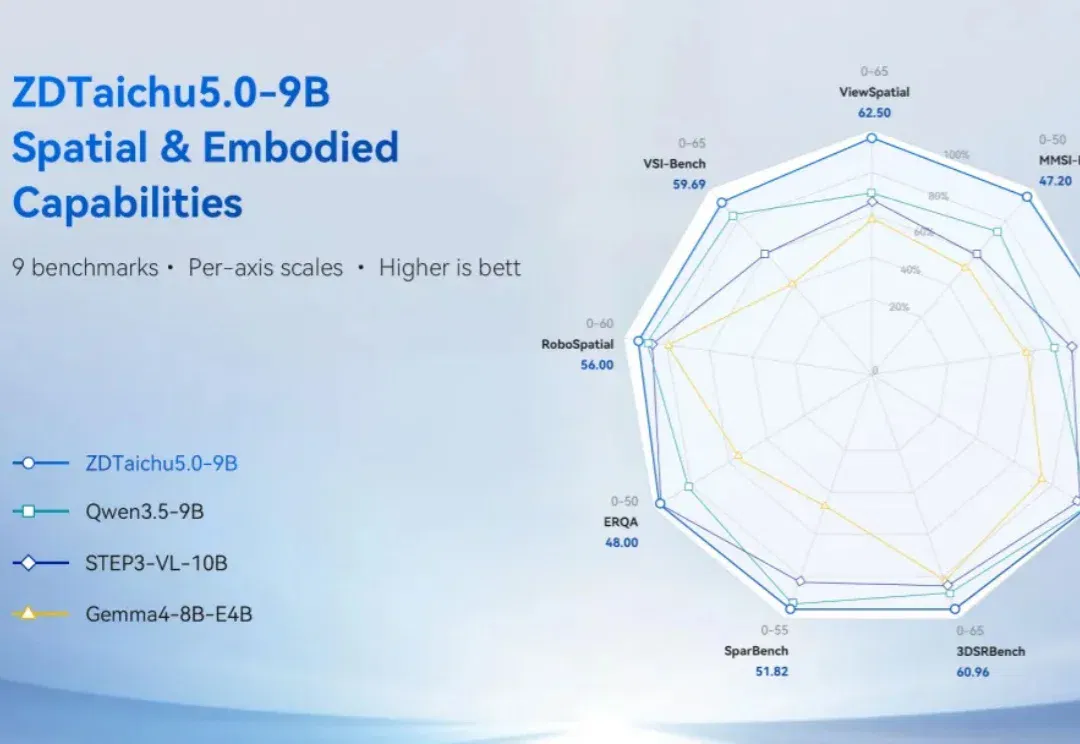
紫东太初开源的这个通用多模态大模型 ZDTaichu5.0-9B,简直夯爆了!
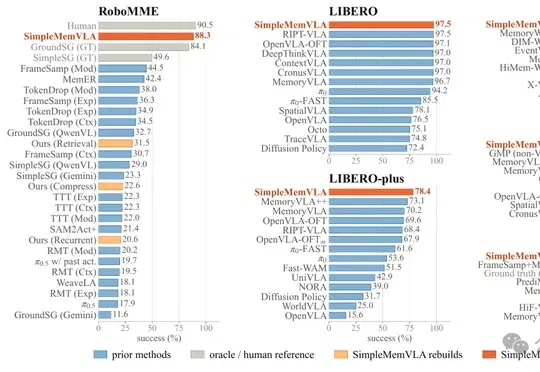
SimpleMemVLA由面壁智能联合华中科技大学等机构提出,将带时间戳的原生视觉历史直接作为机器人记忆上下文,在四项记忆基准取得SOTA并涌现视觉上下文学习能力,同时通过流式推理优化将60秒历史决策延迟从1.02秒降至0.68秒。
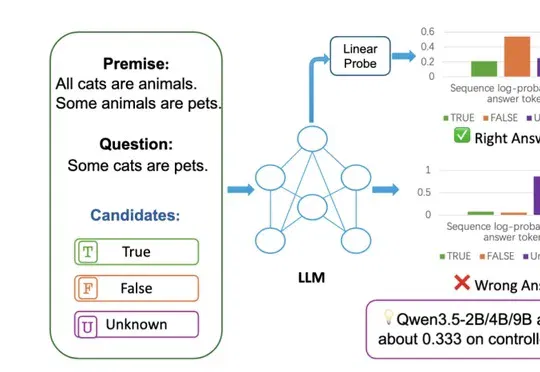
北京大学与易鑫AI Lab合作论文被EMNLP 2026主会接收,提出大模型"读出瓶颈"(Readout Bottleneck)概念,指出模型隐藏状态已编码正确答案却被输出层偏置掩盖,仅用2个无标签参数修正即可在多项推理任务上将准确率从33.3%盲猜水平大幅恢复。
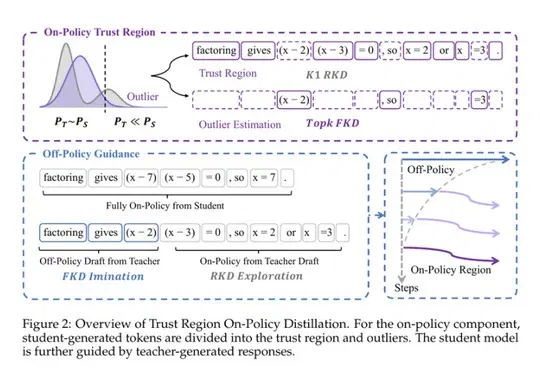
三星大模型团队联合牛津大学、北京大学提出TrOPD方法,通过信任域机制让端侧模型更稳定高效地继承大模型推理能力,在数学、代码、指令遵循、STEM基准上全面超越现有OPD方法,为前沿智能以更低成本走向数亿终端提供新路径。
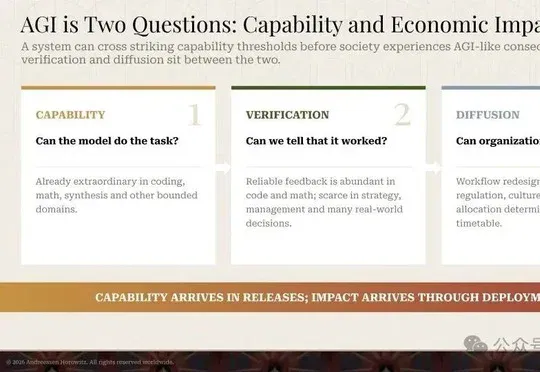
AI 正在从一项核心技术,逐渐变成商业软件背后的基础设施。当模型能力持续提升、AI 智能越来越标准化之后,企业真正需要竞争的空间也开始向应用层移动。 a16z 最新发布的一篇报告中,讨论的正是这一变化
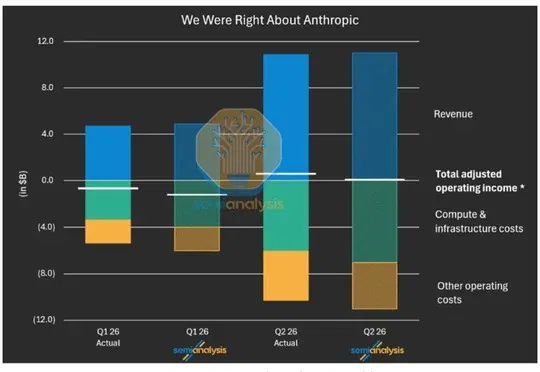
文章指出当办公Agent深度介入工作后,用户面临工作方式主导权被平台锁定的风险,认为模型开源不等于Agent开源,Agent Runtime开源才是关键,并以DeepSeek发布的Harness和网易有道开源的LobsterAI(含OpenClaw)为例,说明开源Agent Runtime能为用户带来数据主权、可审计性、连续性和可定制性。
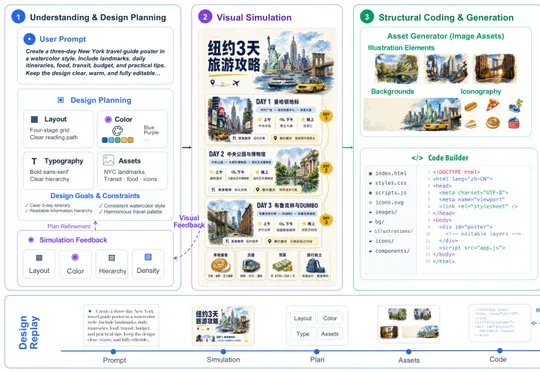
开源项目 Editable Design 结合视觉模型、HTML 代码与持续工作的 Agent,将 AI 生图重构为可编辑的设计文件,使文字可直接修改、图层可独立拖动,仓库展示了 14 组覆盖营销海报、信息设计等 6 类视觉任务的案例。
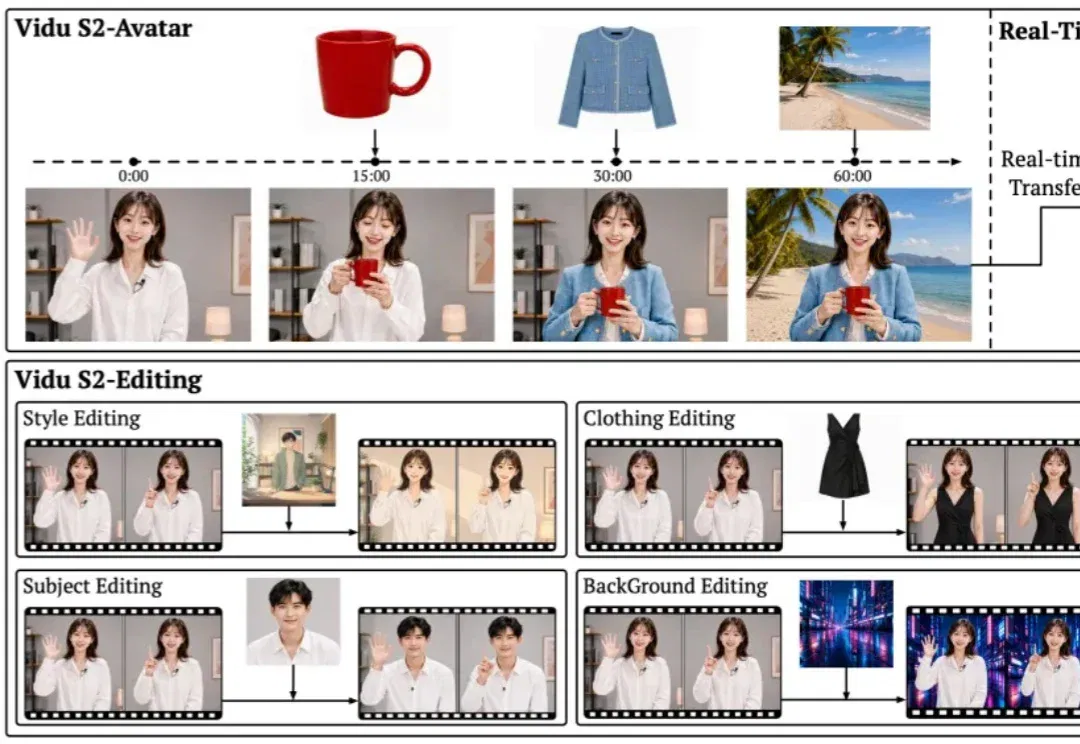
AI 视频,正在变成一个可以边播、边演、边改的实时系统。
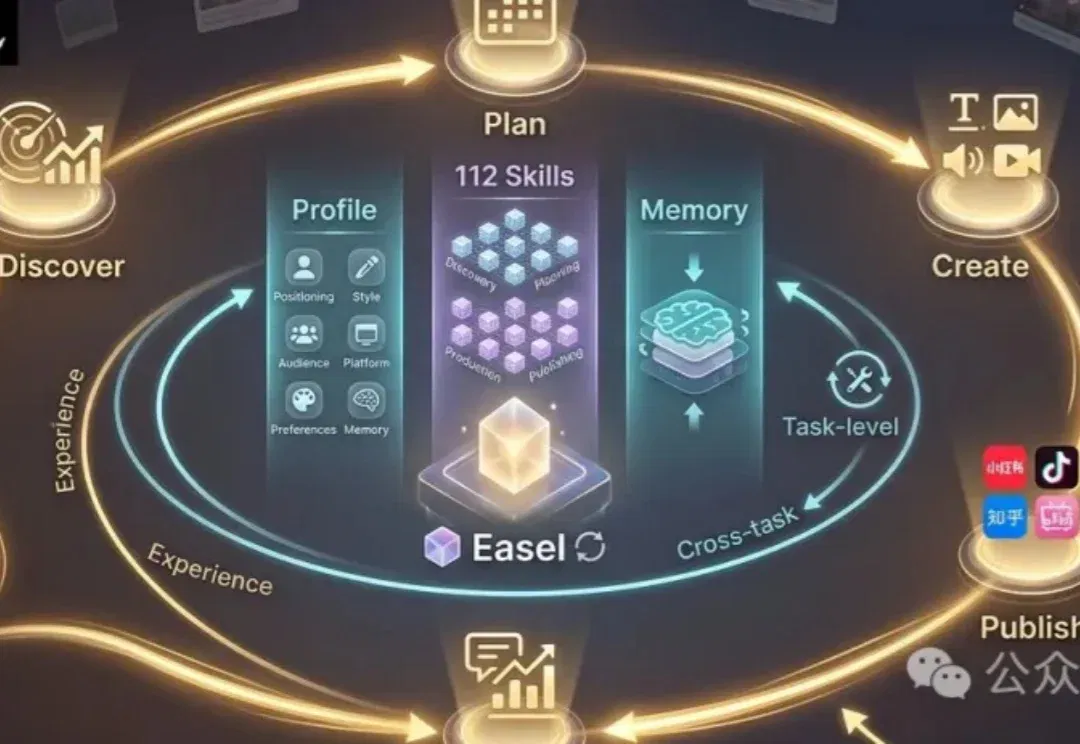
当大模型已经能够快速生成文案、图片和视频,一个更进一步的问题是:Agent 能否从执行过的任务中积累经验,并在持续交互中改进后续行为?
论文标题:Rethinking the Evaluation of Harness Evolution for Agents论文链接:https://arxiv.org/abs/2607.12227代码:https://github.com/rethinking-harness-evolution 博客:https://yikee.github.io/harnessevolution/ 一个 Agent 第一次没把任务做对。 接下来,你有五份额外的推理预算,可以有很多种花法。 你可以让它把同一道题重新做几遍,从多个结果里挑最好的;可以把上一次失败的过程交给它,让它接着修;也可以做一件听起来更
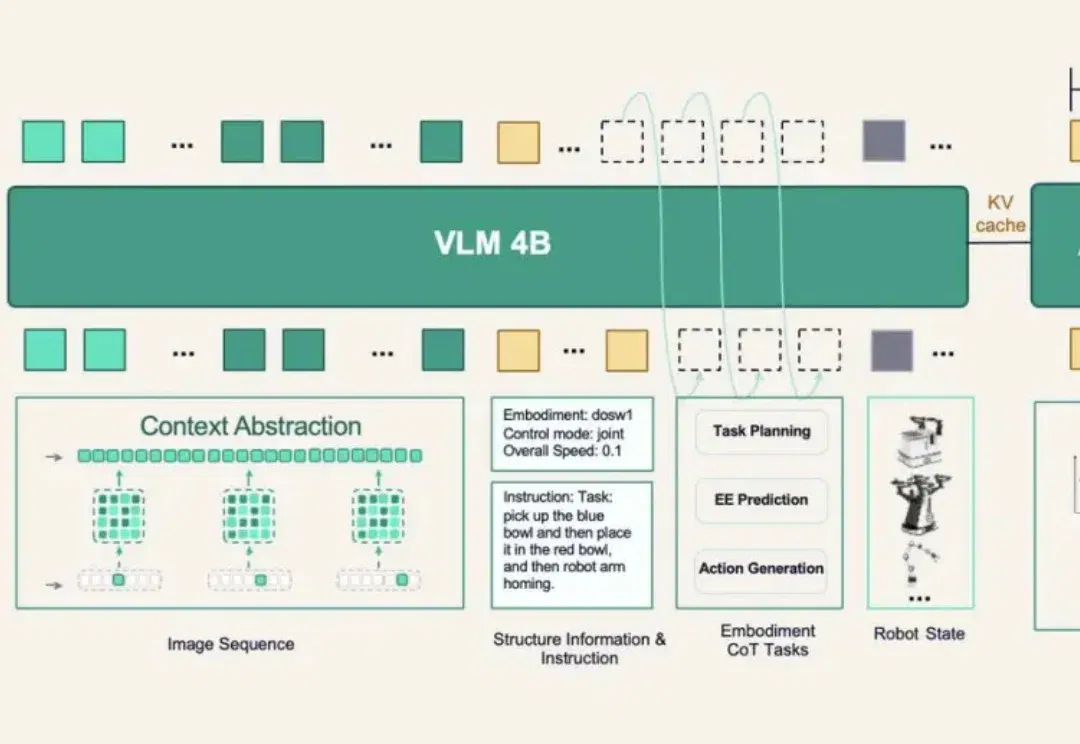
具身智能最近又多了一张榜单,而排在第一的,还是一个熟悉的名字:原力灵机 DM0.5。
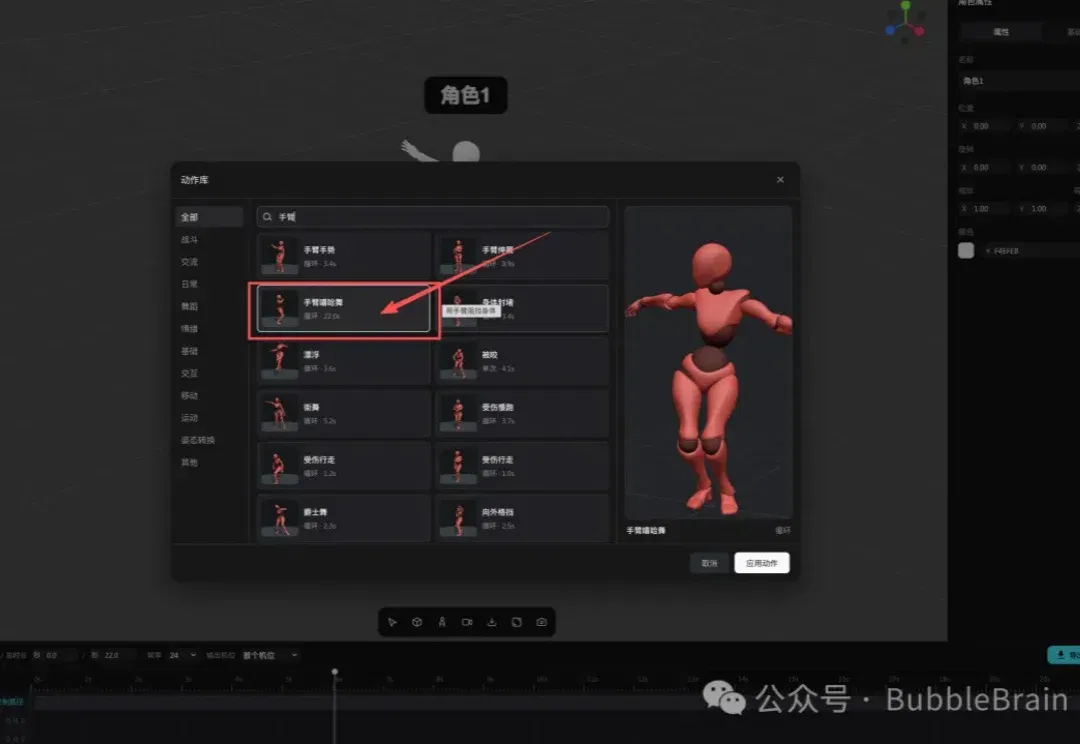
Seedance 2.5 让我这个半吊子的AI视频创作者都能上瘾玩上一个多月,就不用再多余说表现有多强了吧。
参与交流
了解加入交流群的方式,阅读内容无需登录。