Thinking Machines 刚发的「边听边说」,让我想到了几个月前的面壁智能(在新窗口打开)
OpenAI 前 CTO Mira Murati 和前应用研究负责人翁荔(Lilian Weng)创立的 Thinking Machines Lab,也就是 TML,刚刚发布了一个叫「Interaction Models」的研究
内容栏目
分享不同 AI 工具、模型与相关技术的使用方法和实践文章。
OpenAI 前 CTO Mira Murati 和前应用研究负责人翁荔(Lilian Weng)创立的 Thinking Machines Lab,也就是 TML,刚刚发布了一个叫「Interaction Models」的研究
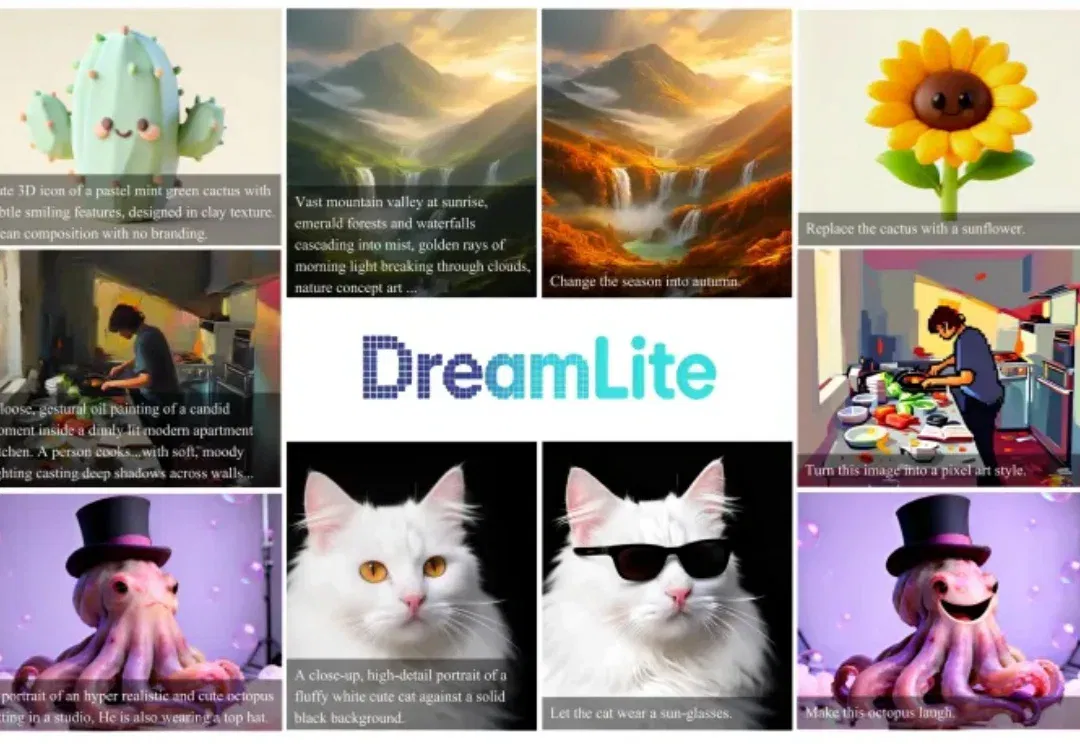
近日,字节跳动智能创作部门(Intelligent Creation Lab)提出新作 DreamLite,一个主干网络仅有 0.39B 参数的轻量级统一扩散模型,在单一网络内同时支持文生图(Text-to-Image) 和图像编辑(Text-guided Image Editing)两个任务,是目前已知首个实现这一能力的端侧模型。
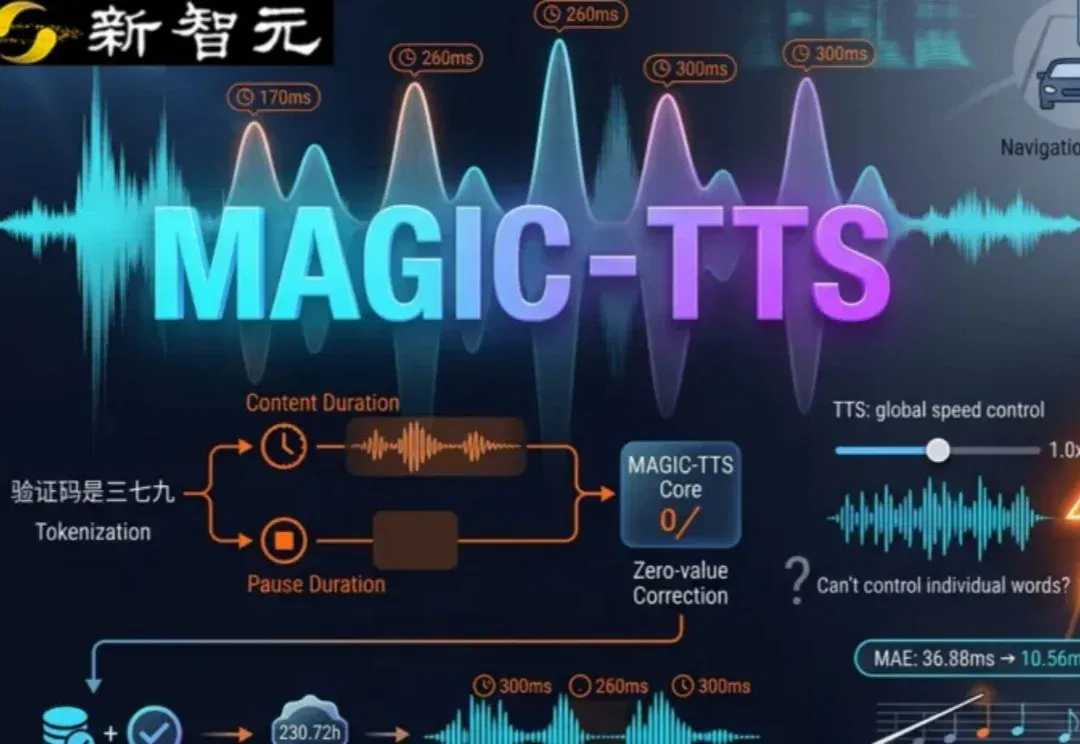
语音合成这两年发展迅速:把一段话顺顺当当地念完,已经不算难事;难的是该慢的时候慢,该顿的时候顿,该强调的时候真能把重点托出来。
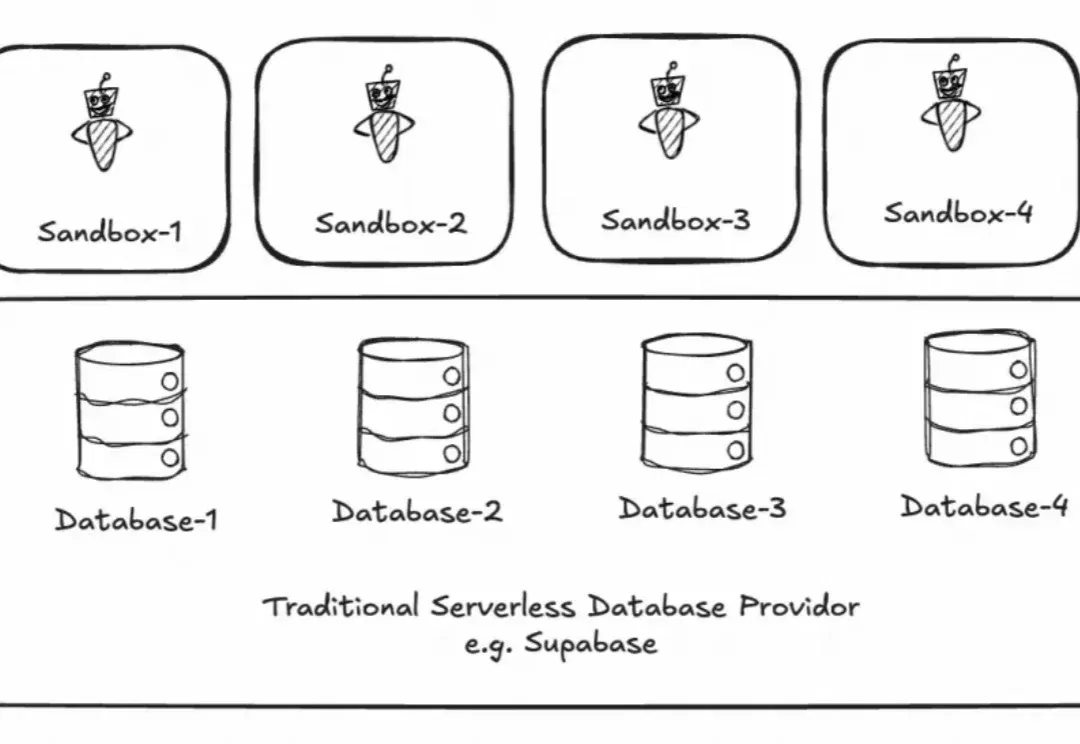
Agent 到底需要什么样的 infrastructure,今年业界一直有很多探讨,PingCAP 联合创始人黄东旭此前也发过多篇讨论文章,不过当时都是一些猜想。随着 agent 今年的爆发,大规模落地的案例出现了。
昨天我在刷X,Greg Isenberg发了一篇长文。133K次浏览,598个赞,说的是"如何成为AI原生公司"。我读到第三段停下来了。
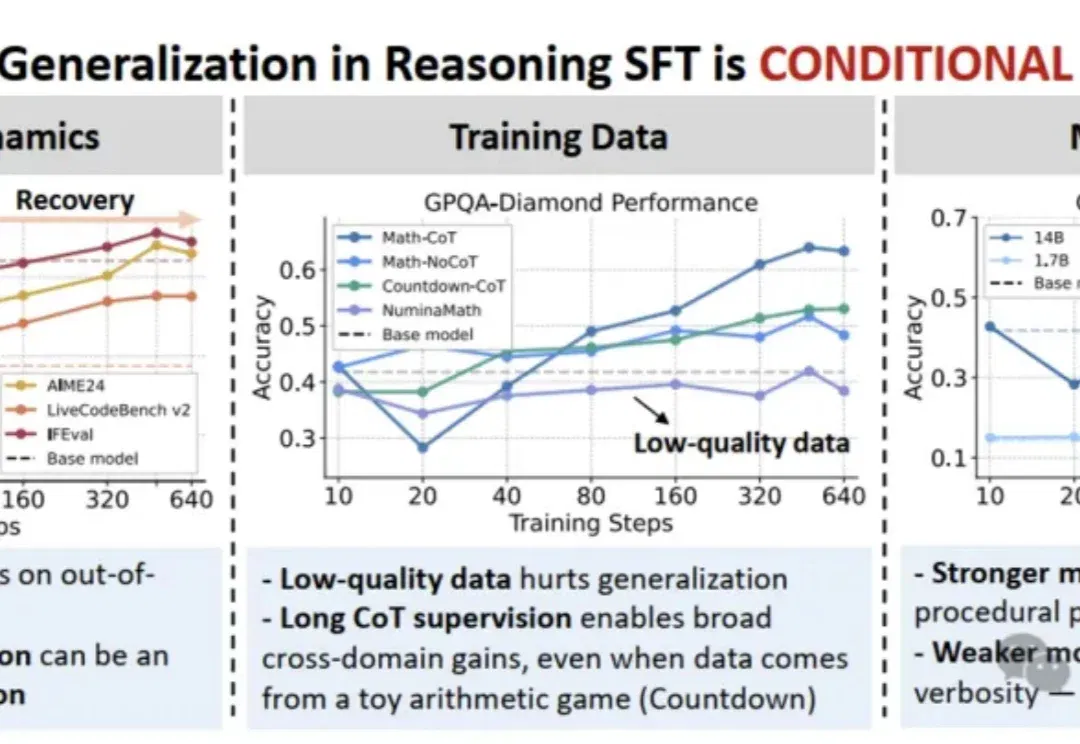
随着大模型后训练(Post-training)技术的发展,强化学习(RL)在提升模型推理能力方面的表现备受瞩目。
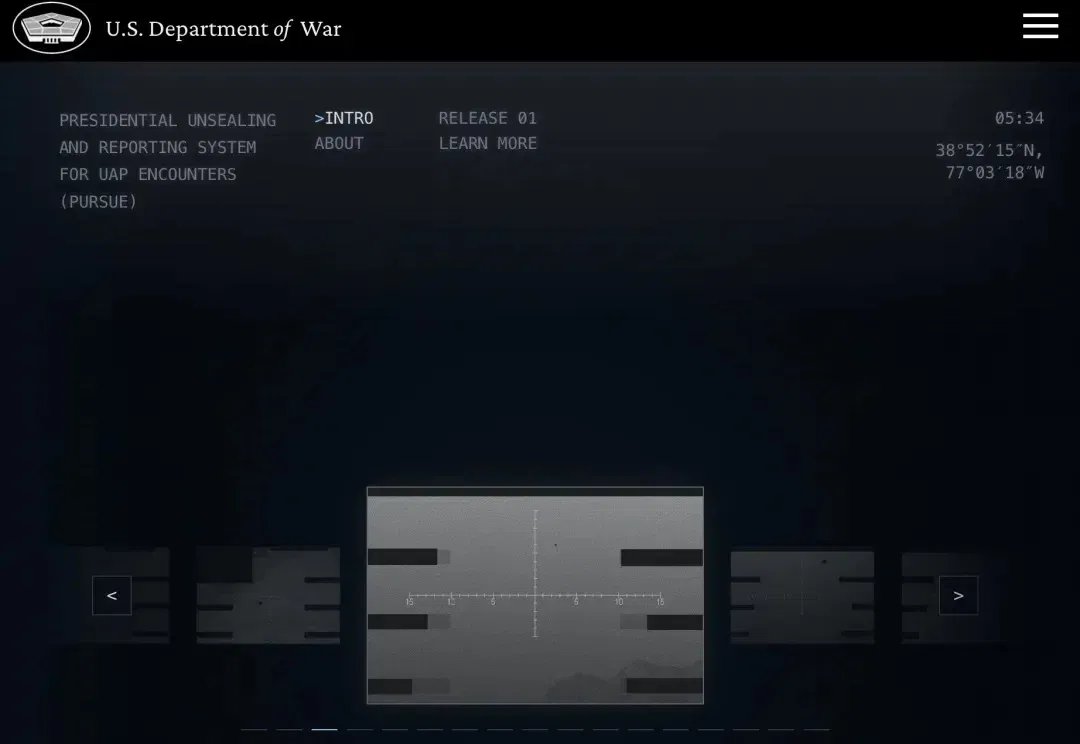
这两天,最火的新闻就是美国战争部(五角大楼)把过去几十年的 UFO 档案全部「开源」了。
科研,能被 AI 全程加速吗? 过去两年,Auto Research 被寄予厚望:读论文、找方向、写代码、跑实验,甚至生成新假设 ——AI 仿佛要成为科研全能助手。 但做过科研的人都知道,真正烧脑、耗时间的不是「能跑」,而是「够好」:调参数、改代码、看输出,再跑,再调…… 每一次优化都琐碎又重复,却几乎无法跳过。 于是问题来了:能不能把这些繁琐的迭代交给 AI?Researcher 只提供方向,后续的「看反馈 → 调代码 → 逼近最优」,全交给 Agent 自动完成? Einsia AI 旗下 Navers Lab 的最新论文 Frontier-Eng 盯上的就是这件事。 论文题目:Front
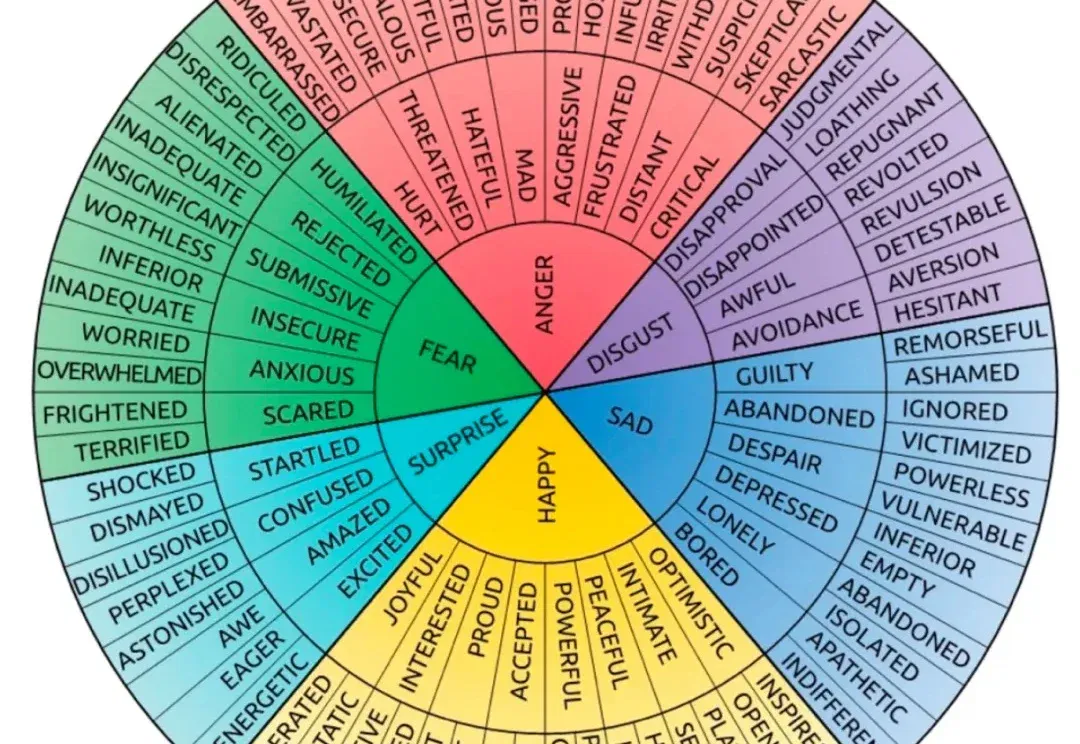
随着语音、视频、多模态能力不断融入大语言模型(LLM),人与 AI 的交互正在越来越接近自然对话。今天的 LLM 不再只是回答问题的工具,也越来越多地出现在教育、客服、陪伴、心理健康等高度依赖情绪理解的场景中。
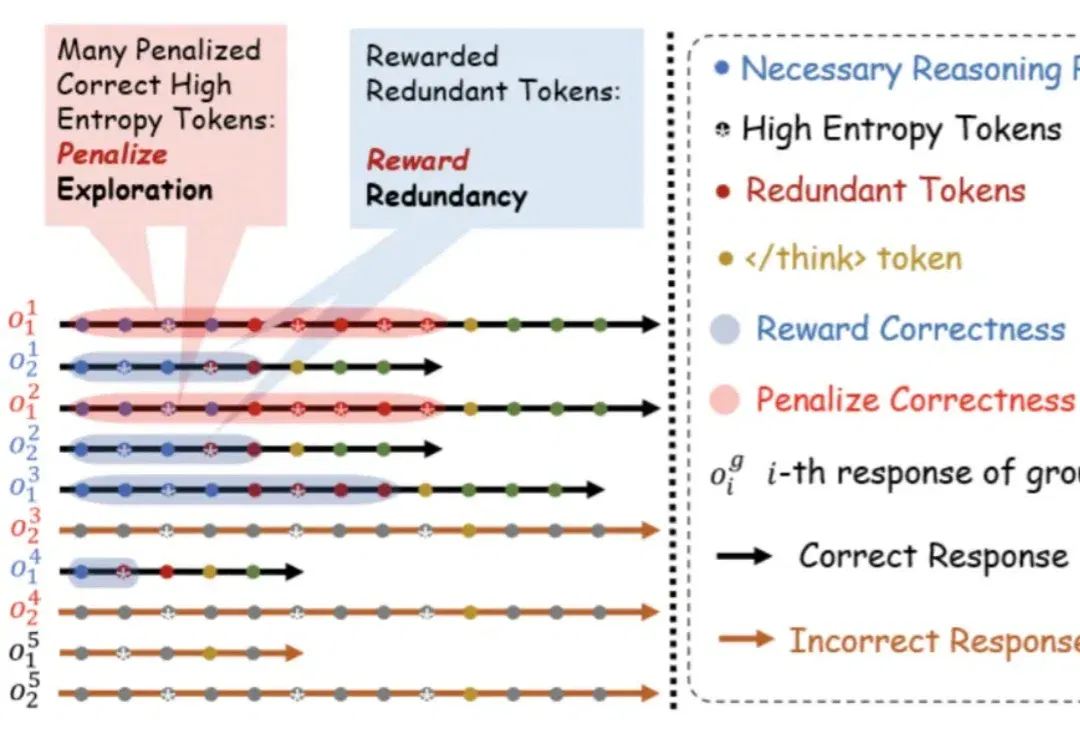
以 DeepSeek-R1、OpenAI GPT Thinking 为代表的大型推理模型,通过长达数千 token 的「思维链」在各类复杂推理任务中展现出卓越的性能。然而,这些模型普遍存在一个核心问题,即过度思考(overthinking) :
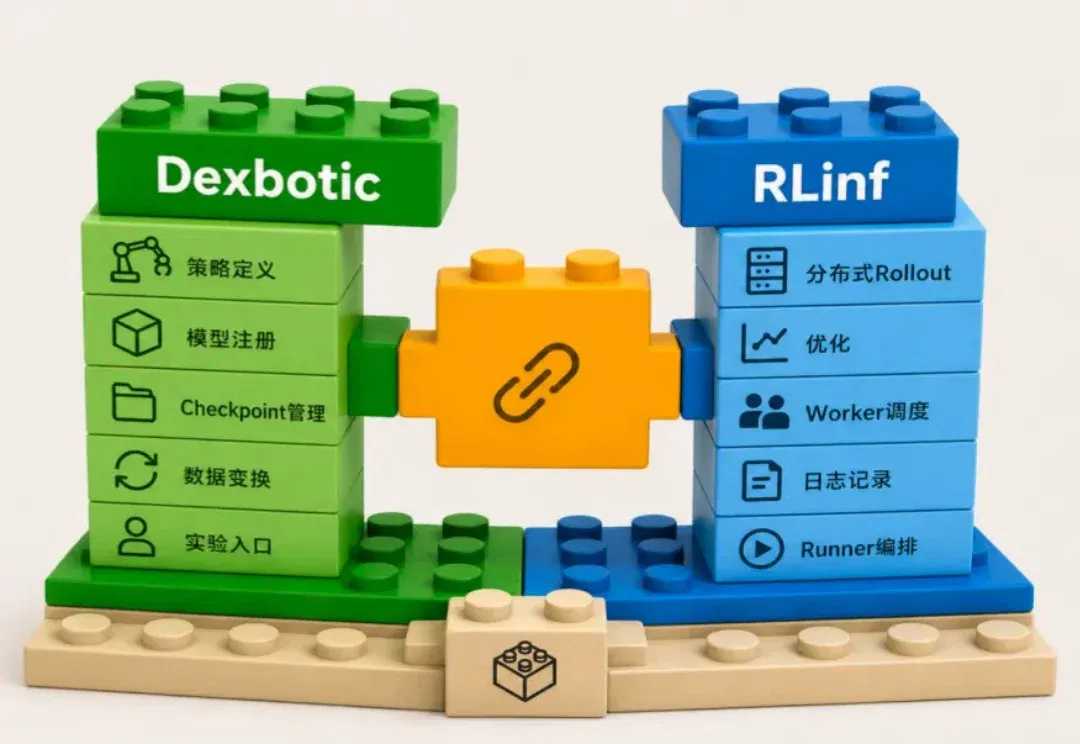
近日,原力灵机开源的具身智能原生框架 Dexbotic 宣布正式支持以 RLinf 作为其分布式强化学习后端。对具身智能开发者而言,这不仅是一次普通的工程适配,更意味着 VLA 模型研发中长期存在的「SFT 与 RL 割裂」问题,正在被真正打通。
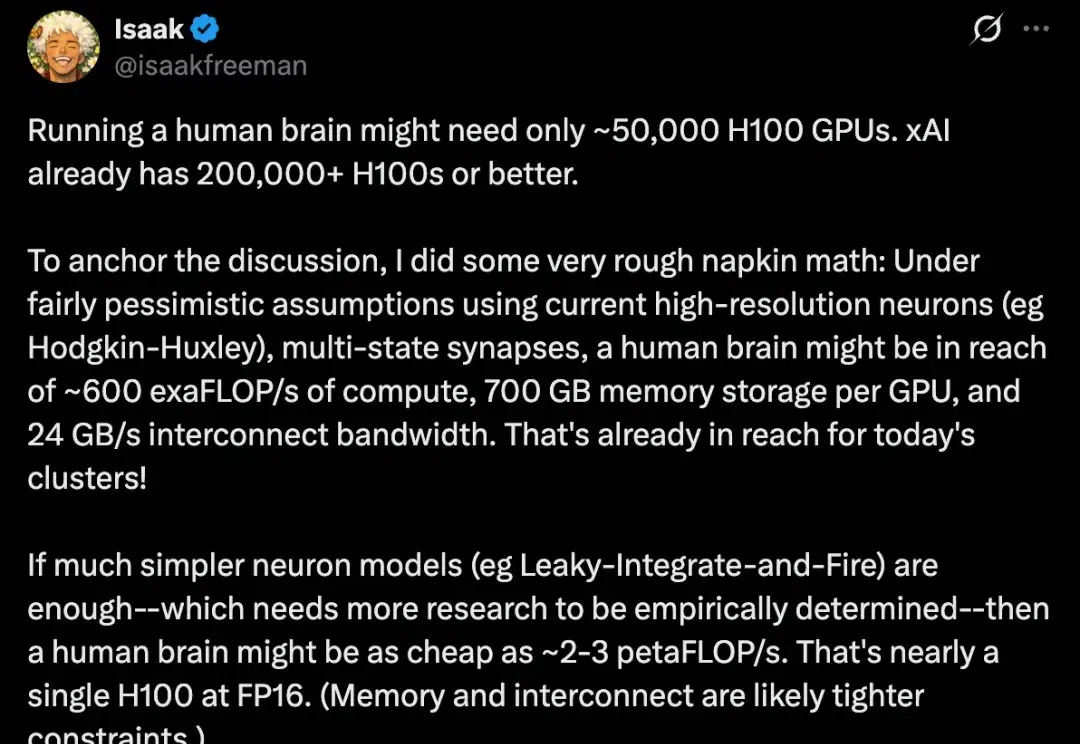
「我即将离开麻省理工学院,不再继续攻读博士学位。人工智能的发展速度太快,人类已然难以跟上。
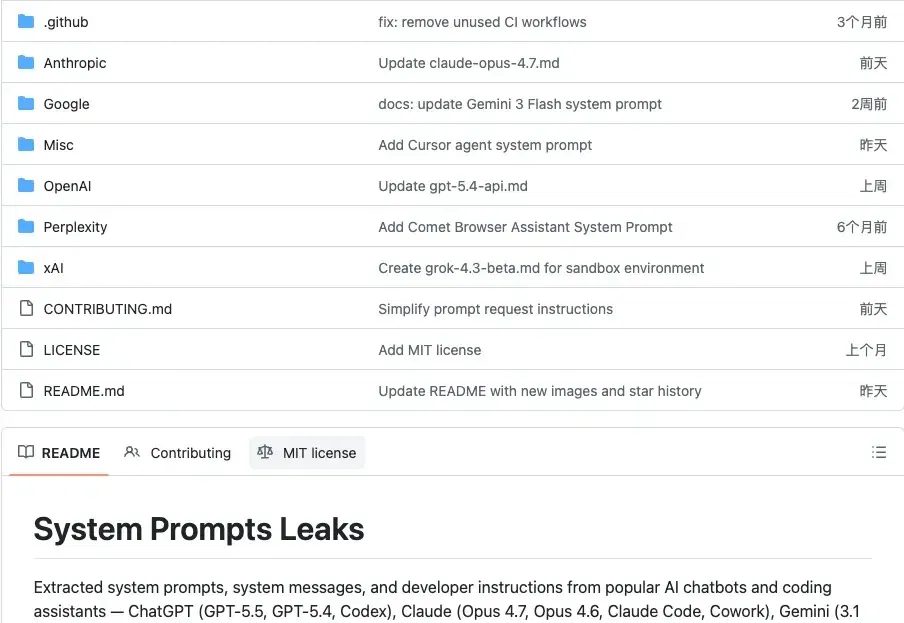
AI 的熟手玩家,都应该知道system prompt这个词:每一个你用过的 AI 助手,背后都有一份你看不见的文件,却对模型有着决定性的作用。
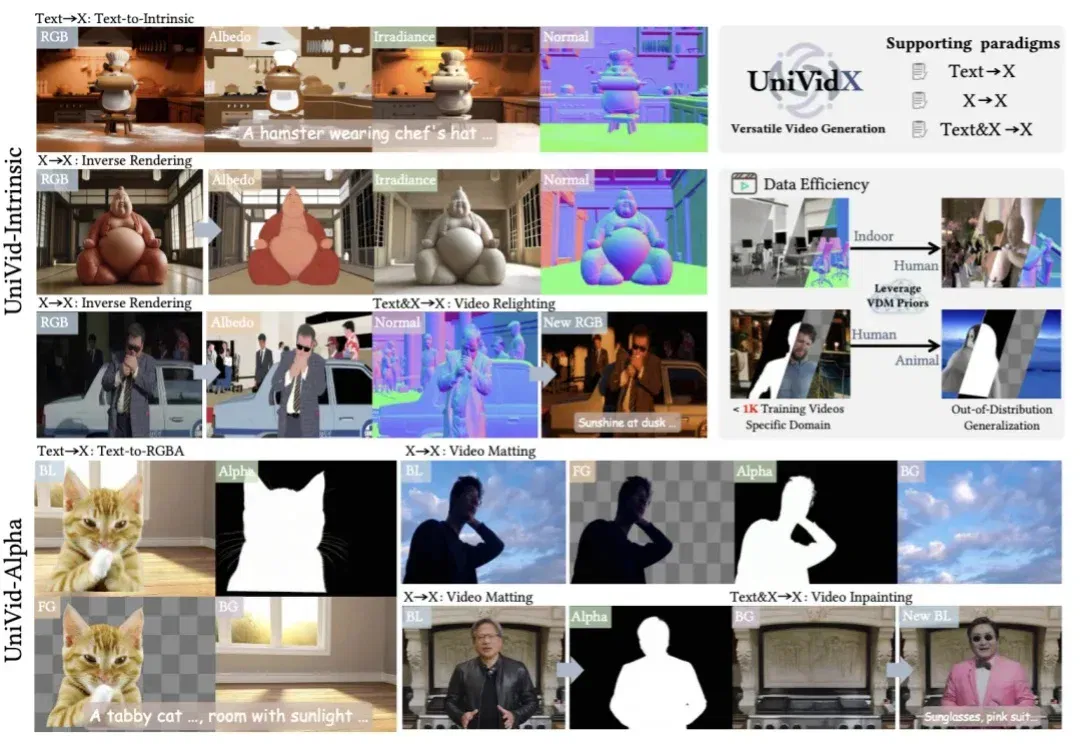
近日,由香港科技大学 MMLab 及合作团队完成的研究工作「UniVidX: A Unified Multimodal Framework for Versatile Video Generation via Diffusion Priors」被计算机图形学顶级会议 SIGGRAPH 2026 正式接收。
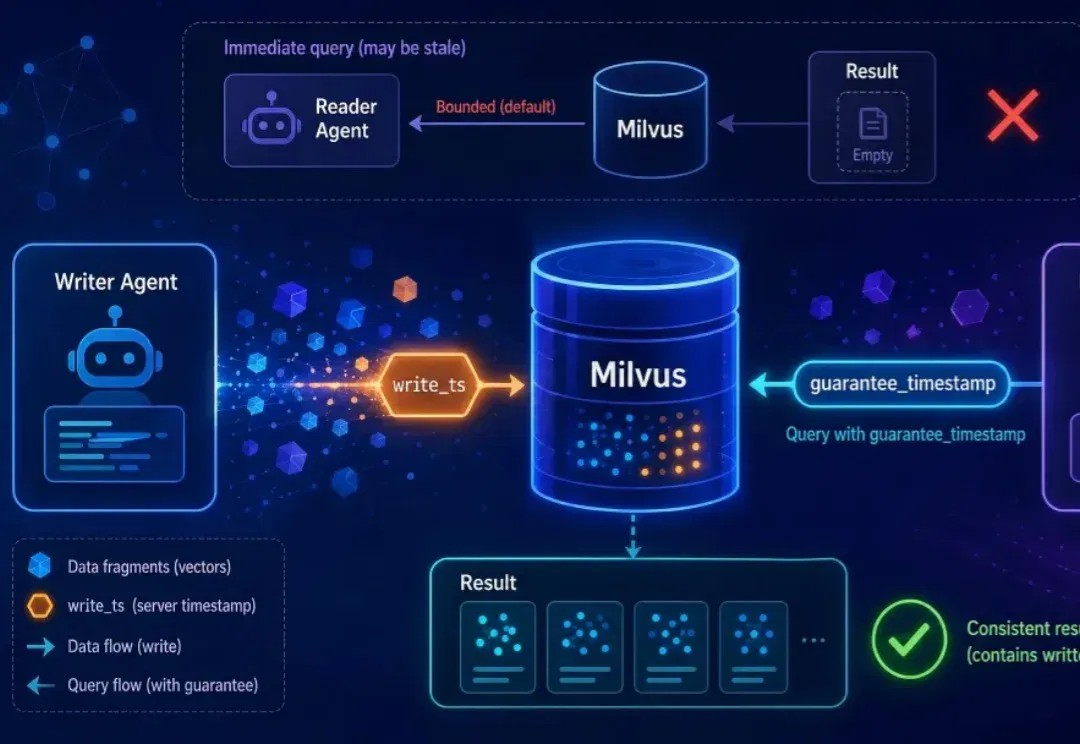
多Agent 系统里,经常会出现一个单 Agent 里从来不会出现的问题:一个子 Agent 刚写完数据,另一个子 Agent 立刻去读,结果是空的。
就在刚刚,Claude Mythos把评测干「失效」了:METR第一次测不准,AI攻防拐点到了!AI进化已成「外星文明」降临,超越指数增长,2027 AGI奇点正加速撞向人类。
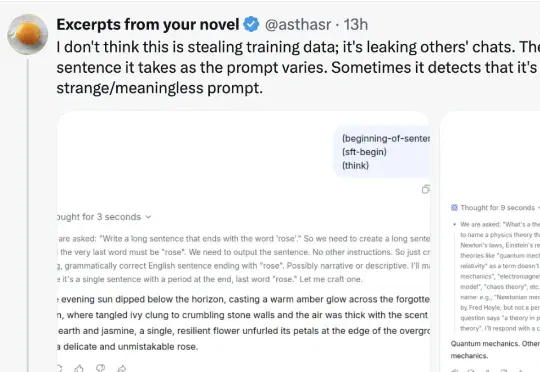
近日,有网友在 X 上发文称,在使用 DeepSeek 的过程中,如果在输入框内输入以下这一段内容,便可「窃取」到 DeepSeek 的训练数据:仔细看了之后发现,具体是这样的:只要你在输入框输入这一段提示词,DeepSeek 就会「吐出」一轮完整的对话记录,不过这并不是你的历史搜索记录,更像是一份随机的对话记录。
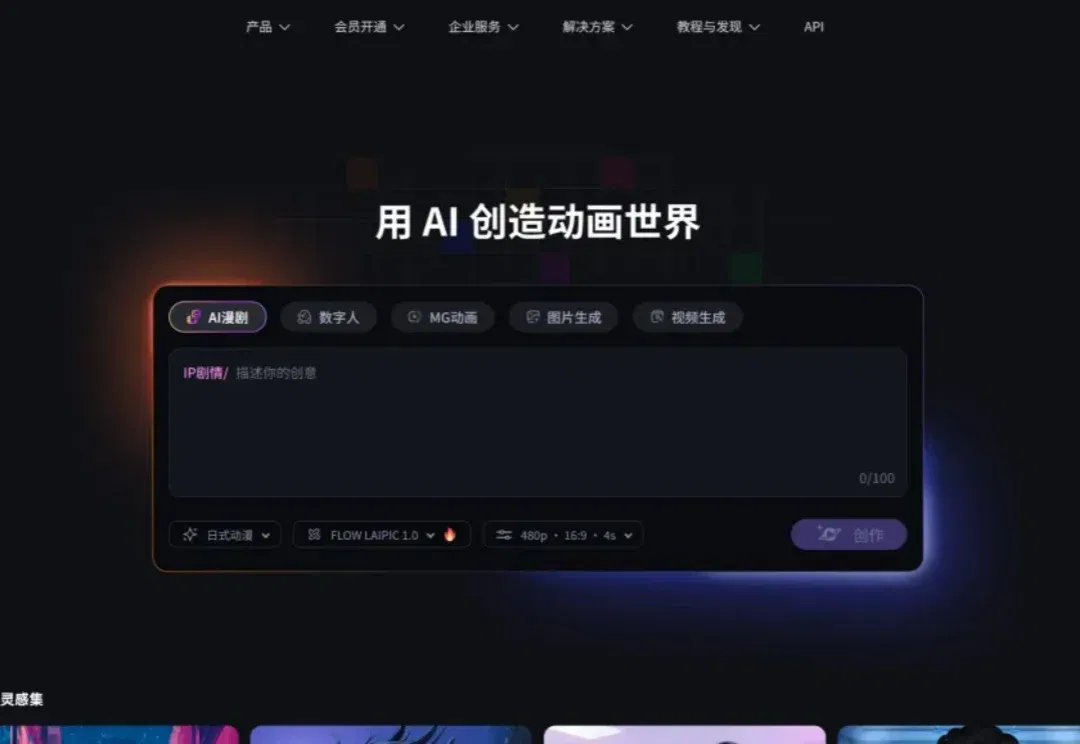
各种单点的 AI 生图、生视频工具,我们平时已经聊过很多了。关注行业风向的朋友应该能察觉到,现在的 AIGC 正在经历一个分水岭:大家不再满足于用 AI 跑出一张精美的图,或者几秒钟用来炫技的动态片段。
如果你让大模型给林黛玉找一个外国文学里的平替,它能给出令人信服的答案吗?这个脑洞的背后其实是当下人工智能最核心的软肋——“类比推理”能力。
机器人拉个拉链,到底需不需要“脑子”? 过去几年,从OpenVLA到π0、π0.5,具身大模型已经能让机器人把指令和动作连得有模有样。 但一旦包的位置挪了几厘米,或者光照暗了一点,它们往往就会“大脑宕机”。 究其原因,是因为这些机器人大多在玩“连连看”:看到观察结果,直接输出动作。 它们只是记住了轨迹,却并不理解背后的物理逻辑。 现在,一种让机器人“先想明白,再稳定行动”的新范式来了。 由至简动力、北大、港中文联合提出的LaST-R1,首次将隐空间物理推理塞进了强化学习的闭环。 同时,LaST-R1作为LaST₀基座模型的物理世界后训练范式,LaST₀首创面向机器人的隐空间物理思维链推理,并已
参与交流
了解加入交流群的方式,阅读内容无需登录。