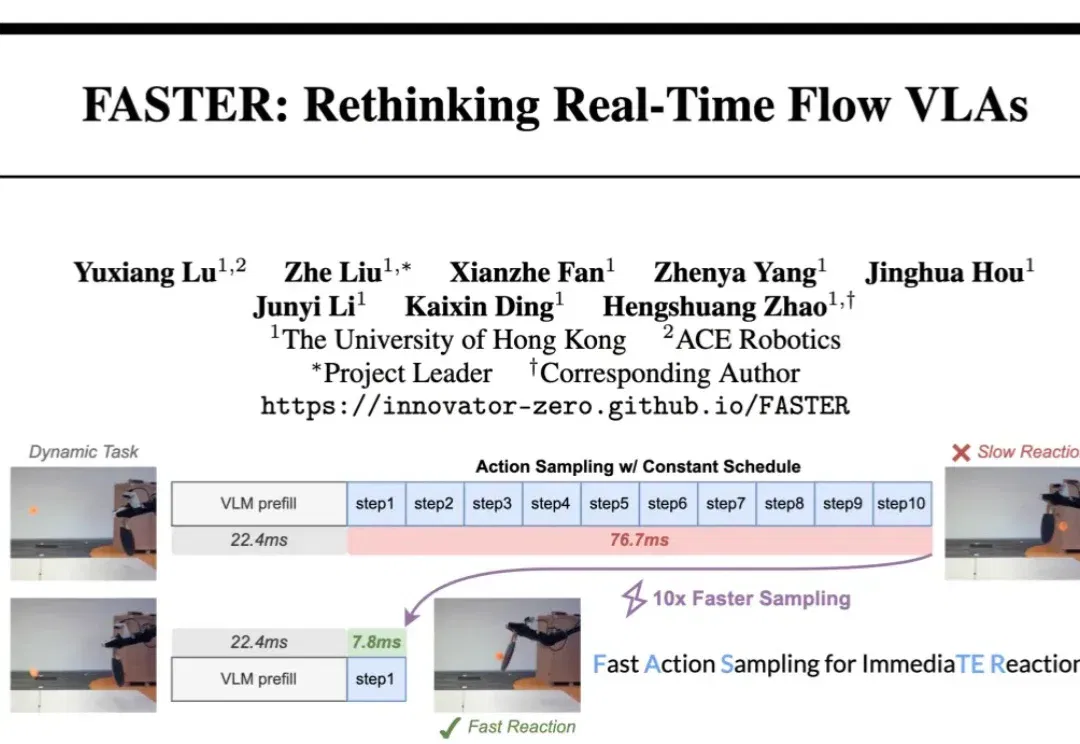
首创TTFA指标!港大团队开源FASTER,让VLA模型真正实现「即刻响应」(在新窗口打开)
具身智能正以前所未有的速度发展,VLA 模型展现出越来越强的动作和泛化能力。然而,当我们真正把 VLA 模型部署到物理世界时,一个核心挑战浮出水面:实时性。
内容栏目
分享不同 AI 工具、模型与相关技术的使用方法和实践文章。
具身智能正以前所未有的速度发展,VLA 模型展现出越来越强的动作和泛化能力。然而,当我们真正把 VLA 模型部署到物理世界时,一个核心挑战浮出水面:实时性。
“你花在 AI 编程上的费用,90% 都浪费在了没必要上传的上下文里!”
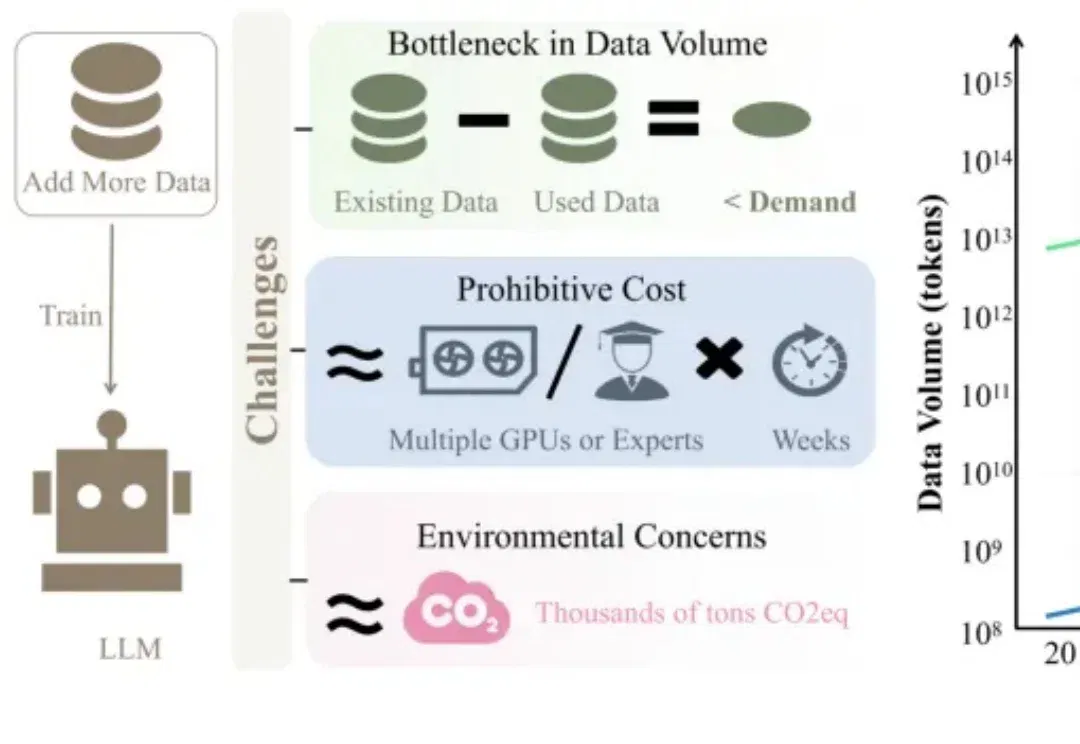
当训练数据枯竭、训练成本飙升,大语言模型(LLM)训练之路该何去何从?
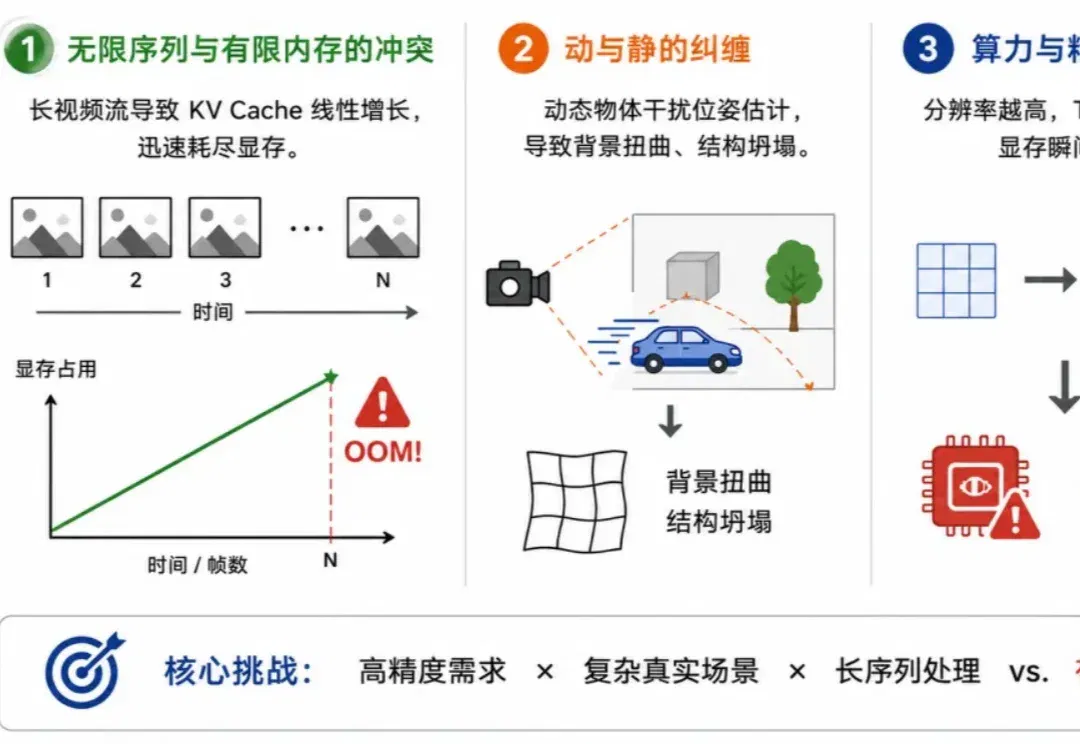
在迈向通用人工智能(AGI)的过程中,世界模型被视为让机器理解物理规律、实现空间智能的关键。而高效、鲁棒和精准的三维感知能力,被广泛认为是世界模型的首要前提。通常来说,一个成熟的世界模型需要具备三大核心能力:对长时空序列的持续记忆、对复杂动力学的因果解耦、以及对高清物理细节的精细感知。
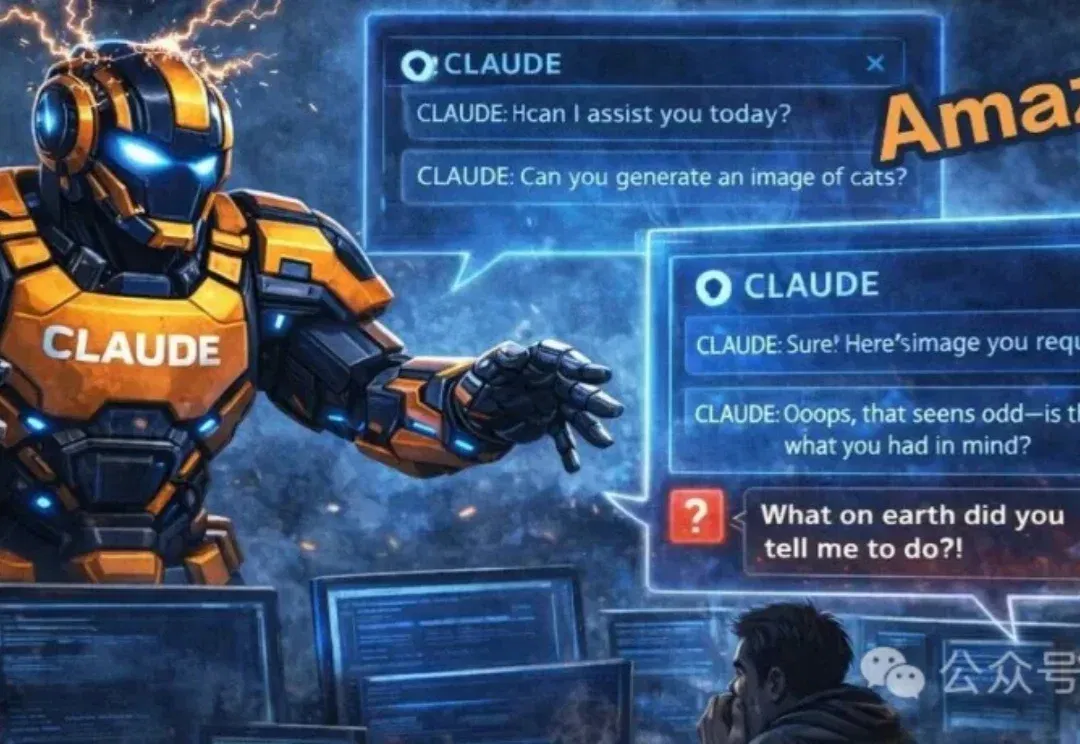
Claude深陷「角色混淆」Bug,分不清自己的话与用户指令,长上下文成了降智「重灾区」。
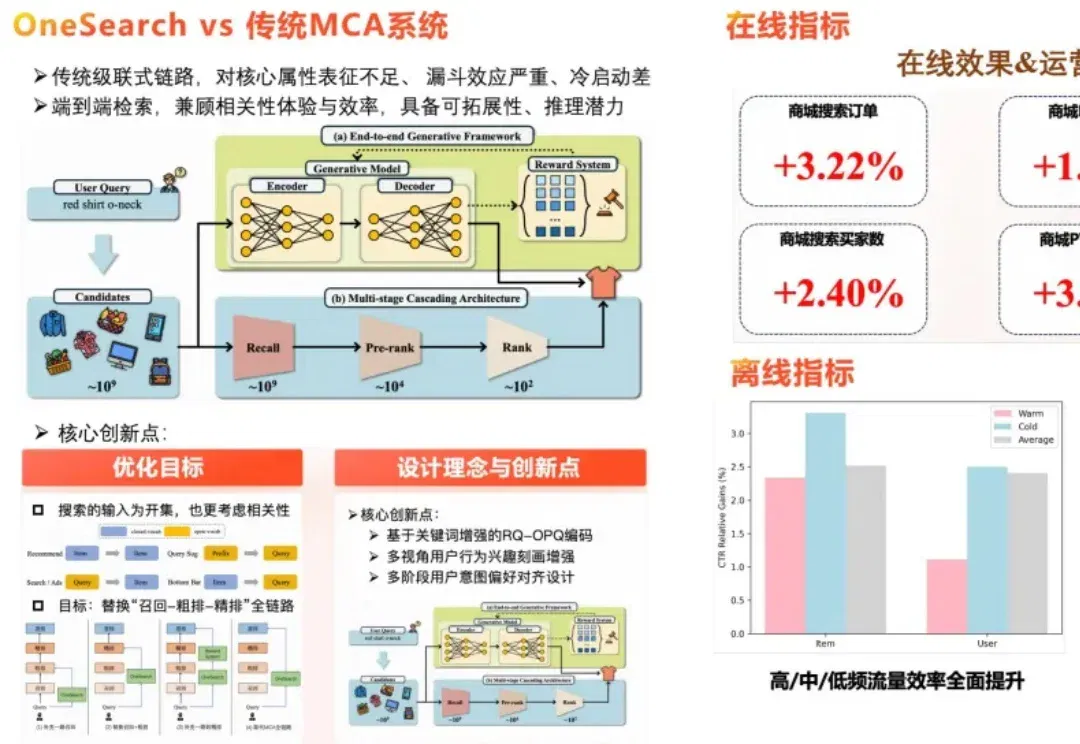
针对生成式检索范式在电商搜索场景下面临的复杂查询理解不足、用户潜在意图挖掘乏力、奖励系统易过拟合历史窄偏好等落地瓶颈,快手技术团队在已规模化部署的工业级生成式搜索框架 OneSearch 基础上,发布了一篇系统性升级的研究论文,正式推出新一代框架 OneSearch-V2。
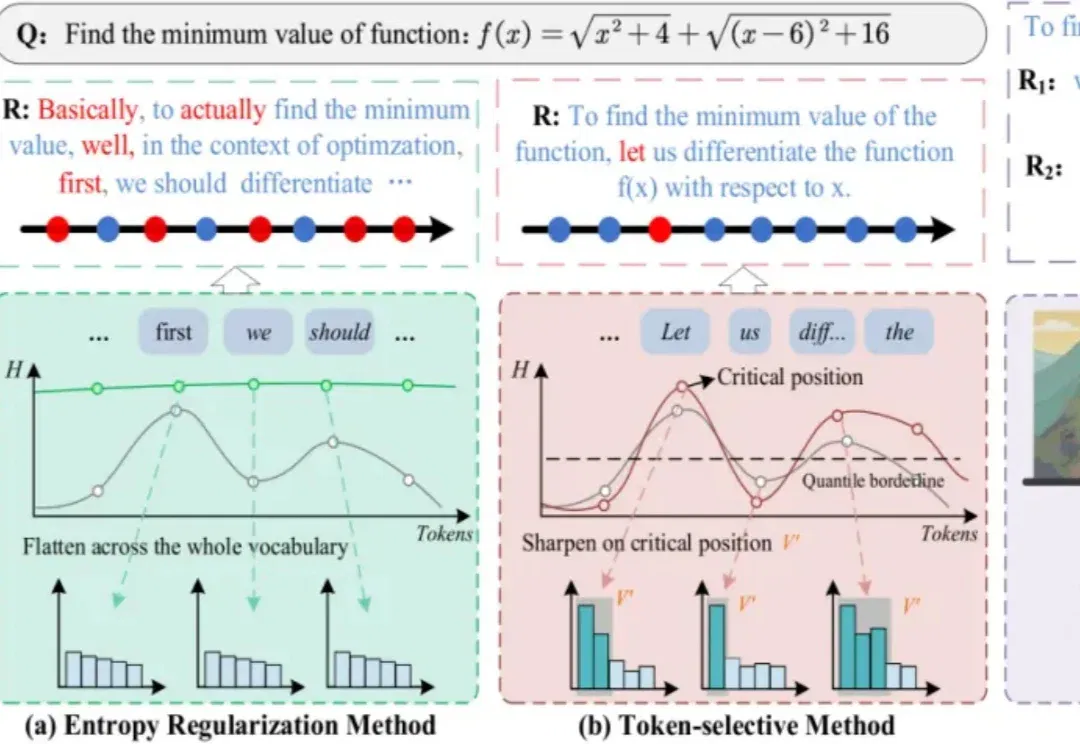
I²B-LPO 是一个面向 RLVR 后训练的探索增强框架,通过改进 rollout 策略引导模型生成更多样化的推理轨迹,将探索行为从 “重复采样” 推进到 “在关键节点生成更具区分度的推理轨迹”,在多个数学基准上同时提升准确率与语义多样性,最高分别达 5.3% 和 7.4%。该工作接收于 ACL 2026 Main,来自阿里达摩院 - 智能决策团队。
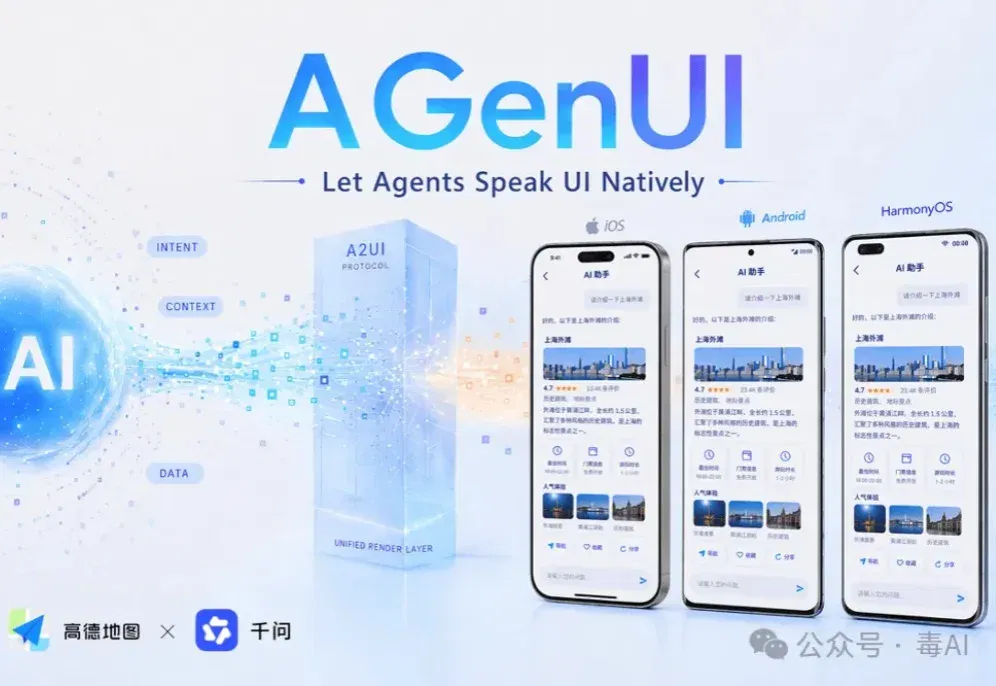
一篇让你看懂的AGenUI开源解读 很多人对AI Agent的想象还停留在“聊天”上。你丢一个问题过去,它回你一段文字,顶多加一张图。 但真正用过这类产品的朋友应该都懂——纯文本的交互天花板太低了。你想订个酒店,它给你敲了一长串候选清单,你还要手动复制店名跳到另一个App去搜。 这不叫智能,这叫换了个地方查资料。 但有没有一种可能:AI直接“画”出一个带按钮、带列表、带地图的界面,让你直接在对话里完成所有操作? 高德和阿里千问C端应用团队刚刚开源的 AGenUI,就是在回答这个问题。 一次“跨界联名”,捅破了一层窗户纸 上周,AI圈被一个名字刷了屏——AGenUI。简单说,它是业内首个同时覆盖
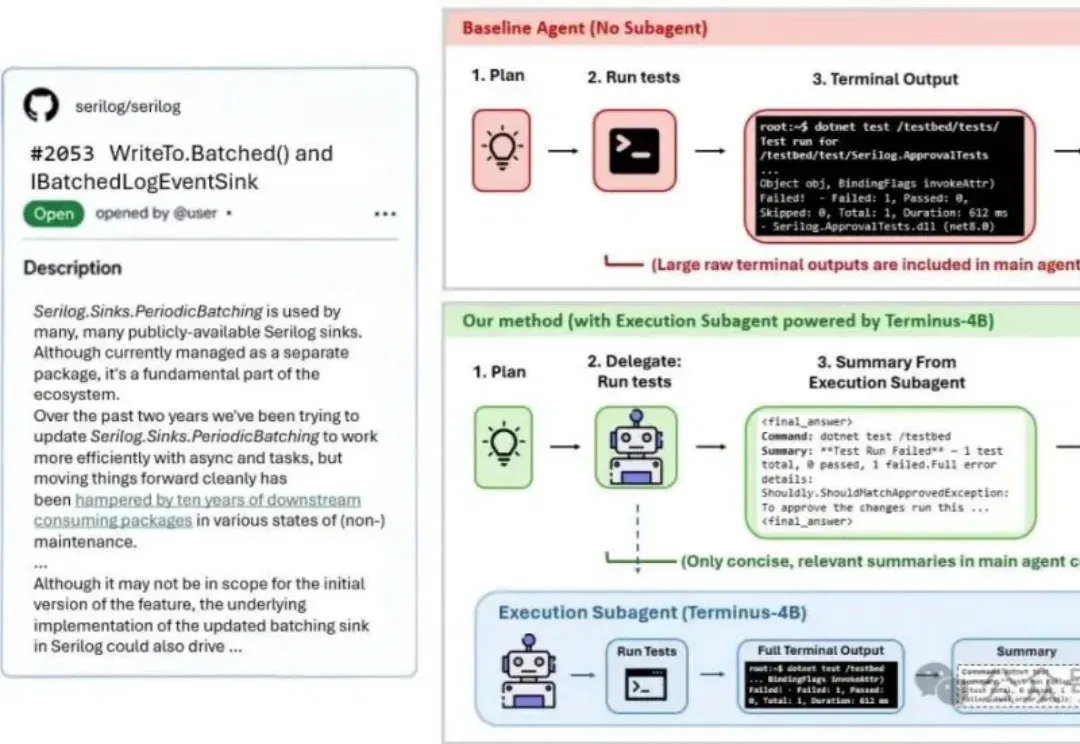
您有没有想过:在代码Agent里,执行终端命令、跑测试、读报错、总结日志这种任务,用Claude Opus、Claude Sonnet、GPT-5.3-Codex这类昂贵Token的大模型来执行,是不是有点浪费?一定要这么做吗?
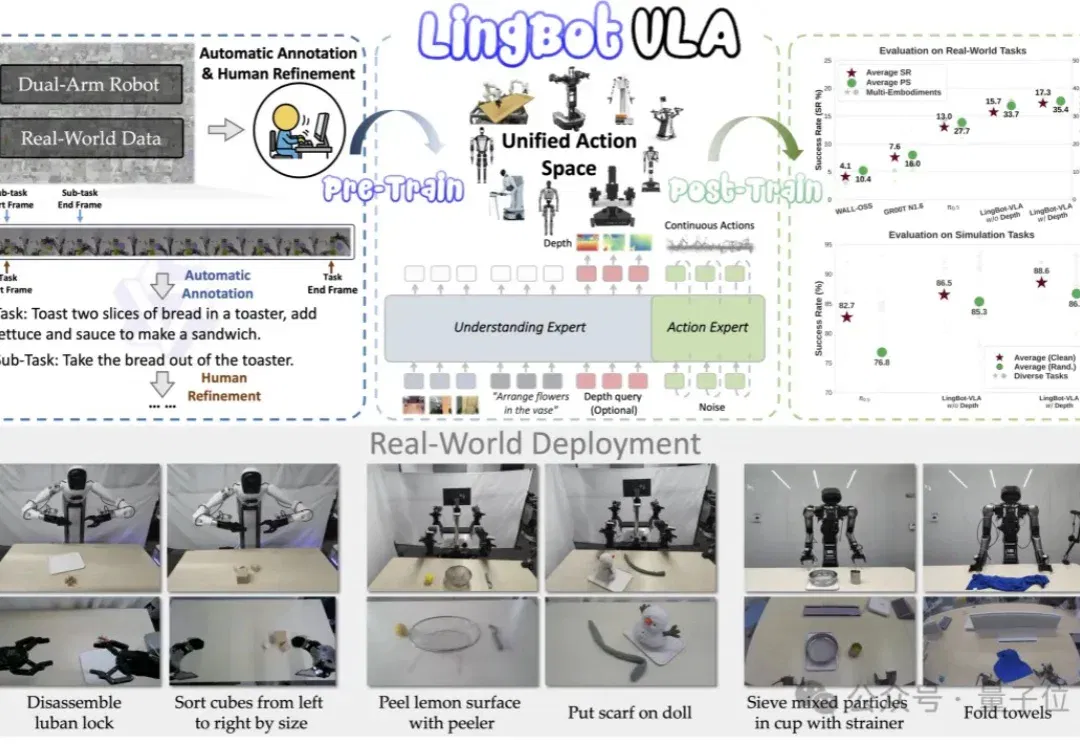
就在刚刚,蚂蚁集团旗下具身智能公司灵波科技传出新动作—— 全面开源其具身基座模型LingBot-VLA的真机后训练工具链。
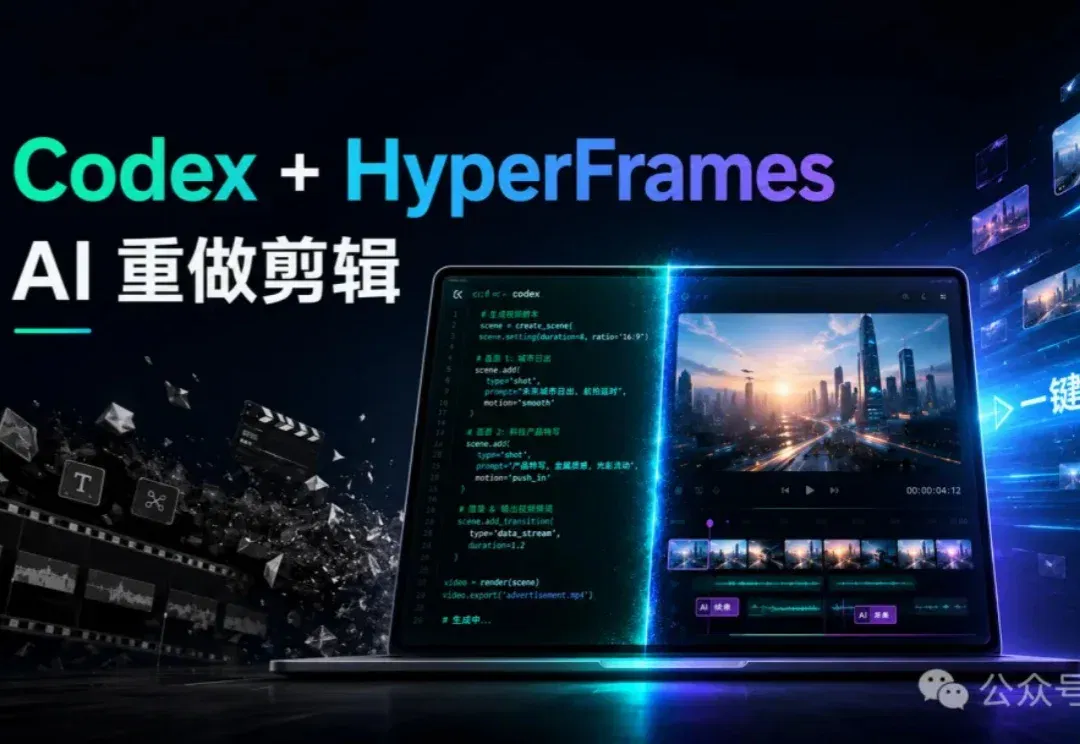
这两天打开X,发现一个开源项目刷屏了——Hyperframes。GitHub上两天干了17.4k star,1.6k fork,Codex、Cursor、Claude Code的插件全线覆盖。
ber!这个五一假期,我也是真够忙的: 自拍、电影、追剧、街头采访、听音乐会,还抽空回老家结了次婚……
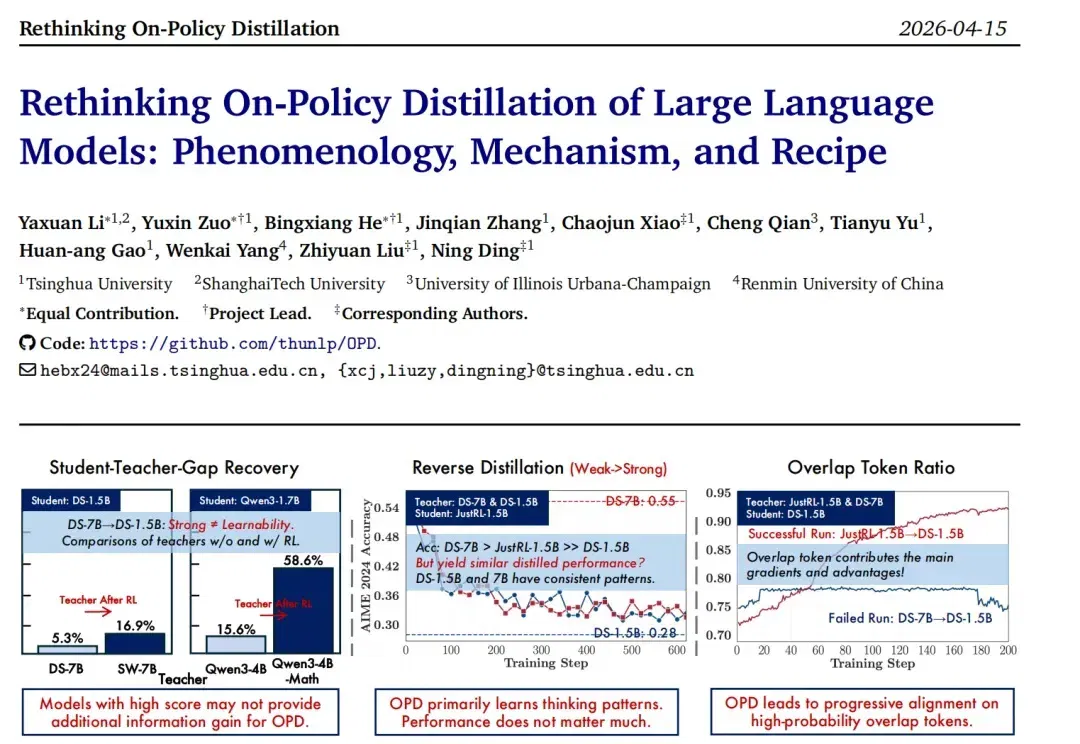
当下的大模型后训练(Post-training)pipeline 中,On-Policy Distillation(OPD)已经成为了明星技术。从 Qwen3、MiMo 到 GLM-5,业界纷纷采用 OPD 并报告了巨大的性能提升。相比于强化学习(RL)稀疏的结果奖励,OPD 提供了密集的 Token 级别监督信号,看起来就像是一顿「免费的午餐」。
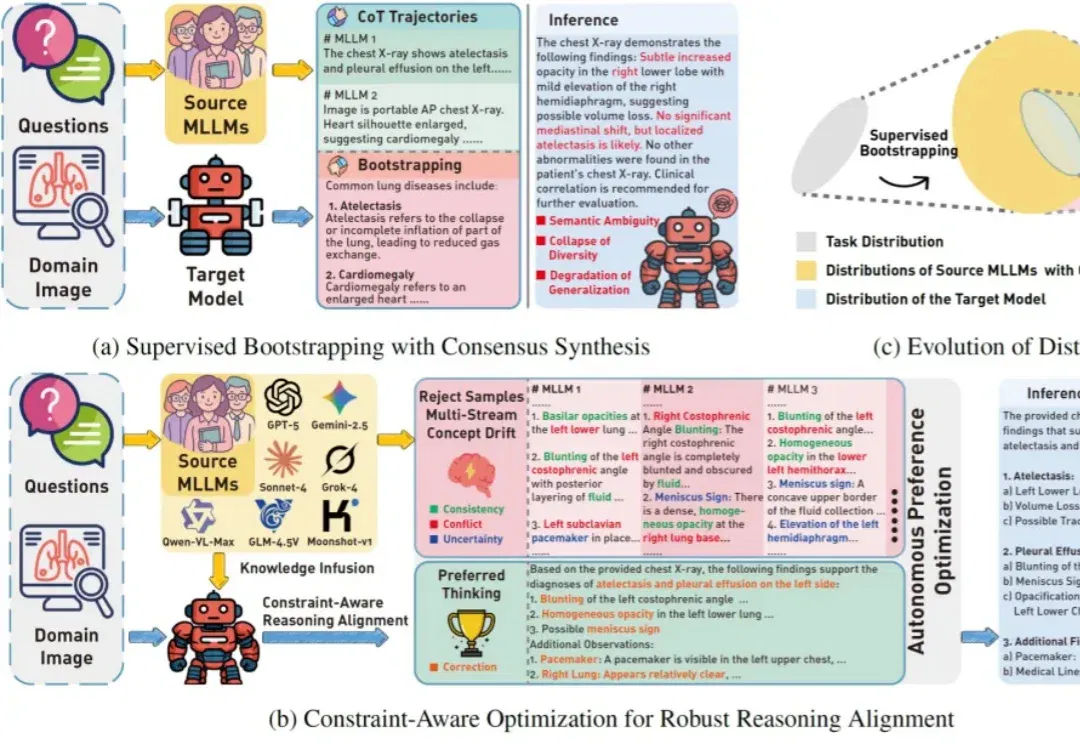
在多模态大模型(MLLM)快速发展的浪潮中,融合多模型 “集体智慧” 已成为提升模型性能的关键路径,并催生了多教师知识蒸馏这一主流范式。然而,不同来源的教师模型在架构与优化上的差异,其在相似推理过程中呈现出不稳定甚至偏移的认知轨迹,即 “概念漂移”(Concept Drift)。
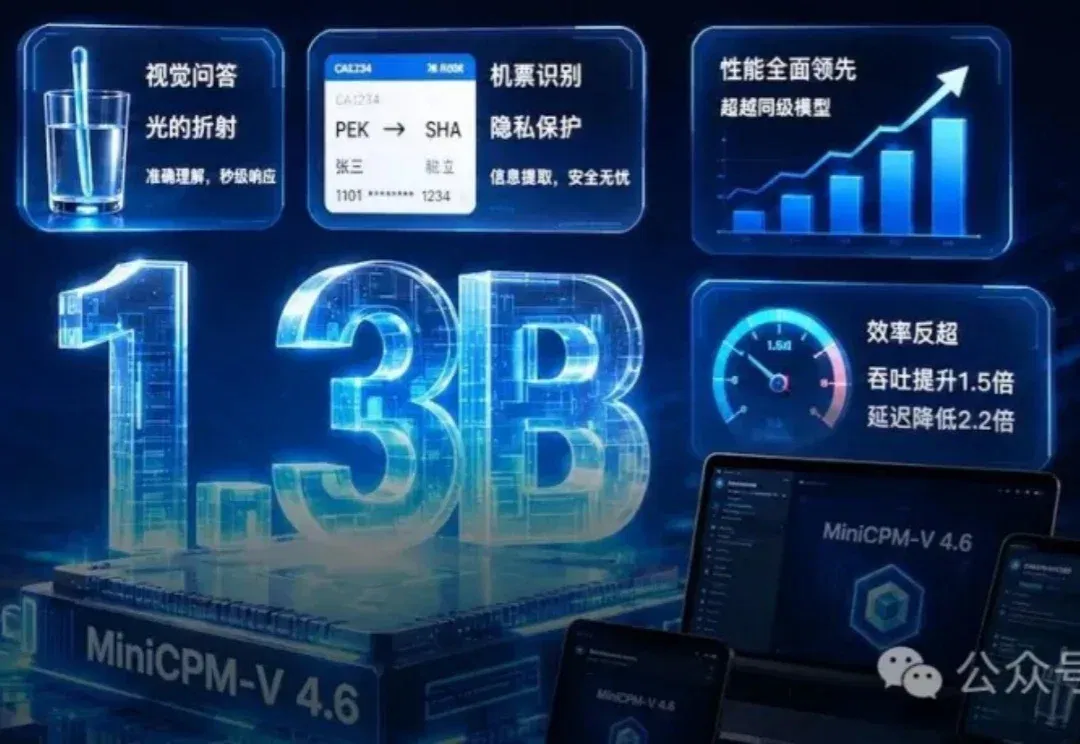
端侧多模态,卷出新天花板。仅1.3B,性能反超,效率翻倍,一张4090就能「爆改」。刚刚,清华系团队面壁智能开源了新一代「小钢炮」MiniCPM-V 4.6,再次证明了在端侧AI领域,中国团队已然站在世界前沿。
如果把AI丢进一个没有标准答案的工程现场,它还能活下来吗?
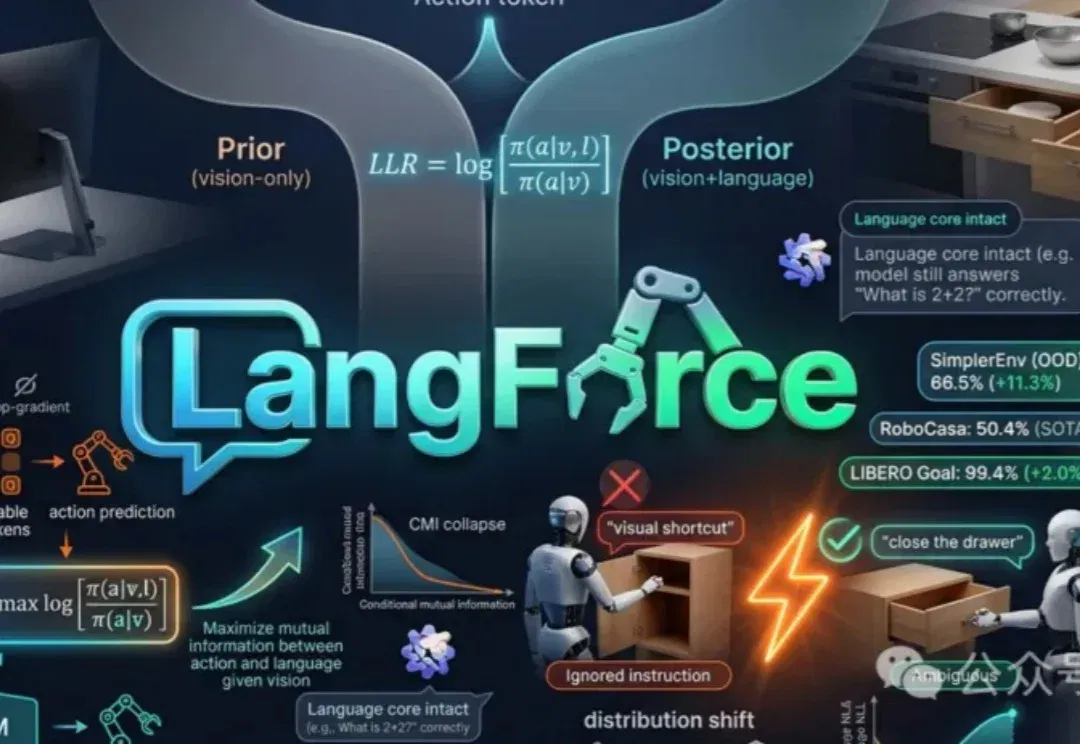
当前VLA模型常依赖视觉线索而非语言指令,导致在新场景下表现不佳。论文提出LangForce方法,通过引入对数似然比损失,强化模型对语言的依赖,提升其在分布外环境中的泛化能力,并保留语言核心功能。
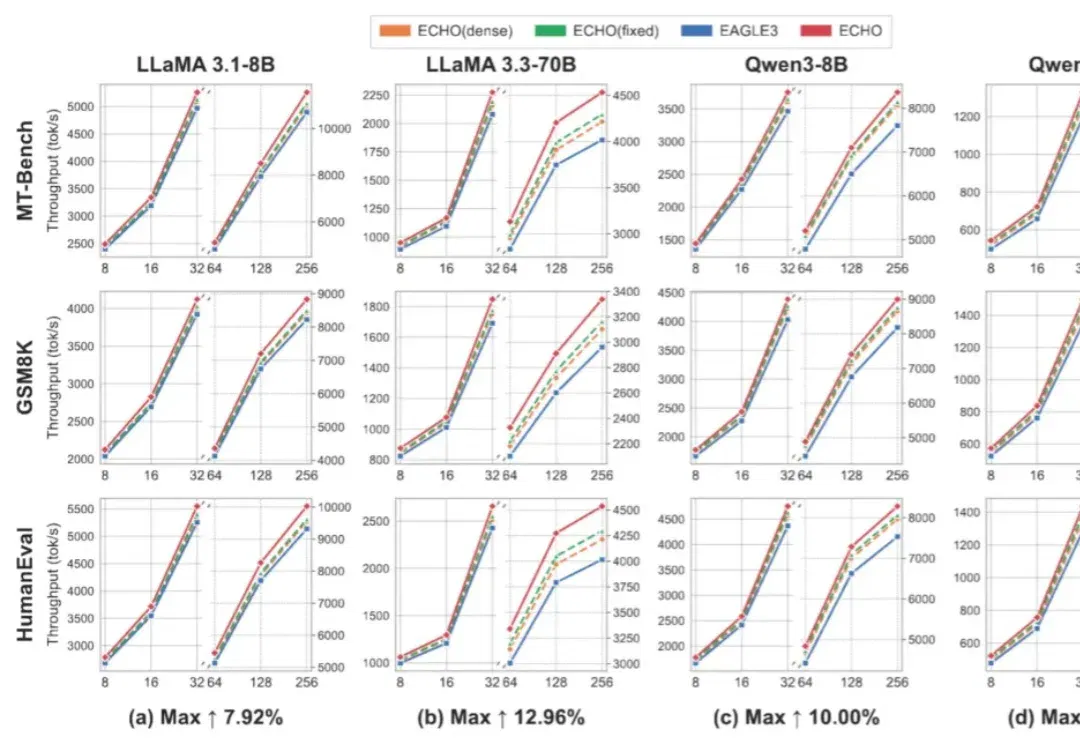
随着大模型参数规模持续扩大,推理成本已经成为生产级 LLM 服务的核心瓶颈。投机解码(Speculative Decoding, SD)通过「小模型 draft + 大模型 verify」的方式,将多个候选 token 放到一次目标模型前向中并行验证,从而缓解自回归解码的串行瓶颈。
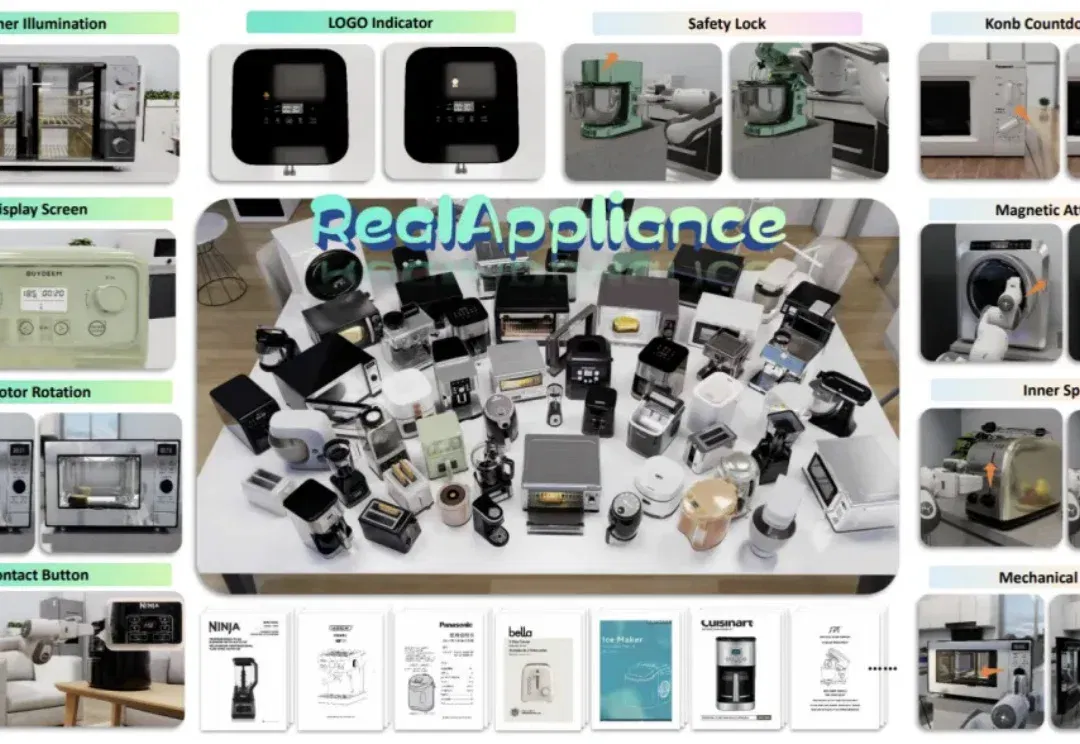
家用电器是家庭服务机器人最难啃的一类任务对象。与桌面物体操作相比,家电操作不仅涉及按钮、旋钮、门体等多种异构部件,还受到模式切换、状态约束和程序逻辑的共同支配。真正完成一次家电任务,机器人往往既要「看得见」,也要「读得懂」,还要「按说明书做对」。
何恺明,也下场做语言模型了。 只不过,这次他带队做的不是大家熟悉的、像ChatGPT背后那套“预测下一个词元”(next token prediction)的自回归范式。 而是另一条过去几年在图像领域大火、如今正被越来越多人搬进文本生成的新路线:扩散语言模型(Diffusion Language Model,DLM)。 在最新的论文中,何恺明团队放出全新连续扩散语言模型:ELF:Embedded Language Flows。 与不少还停留在token层面做扩散的语言模型不同,ELF把整个生成过程都留在了连续的embedding空间里,直到最后一步,才重新离散化,将表示变回token。 靠着这
参与交流
了解加入交流群的方式,阅读内容无需登录。