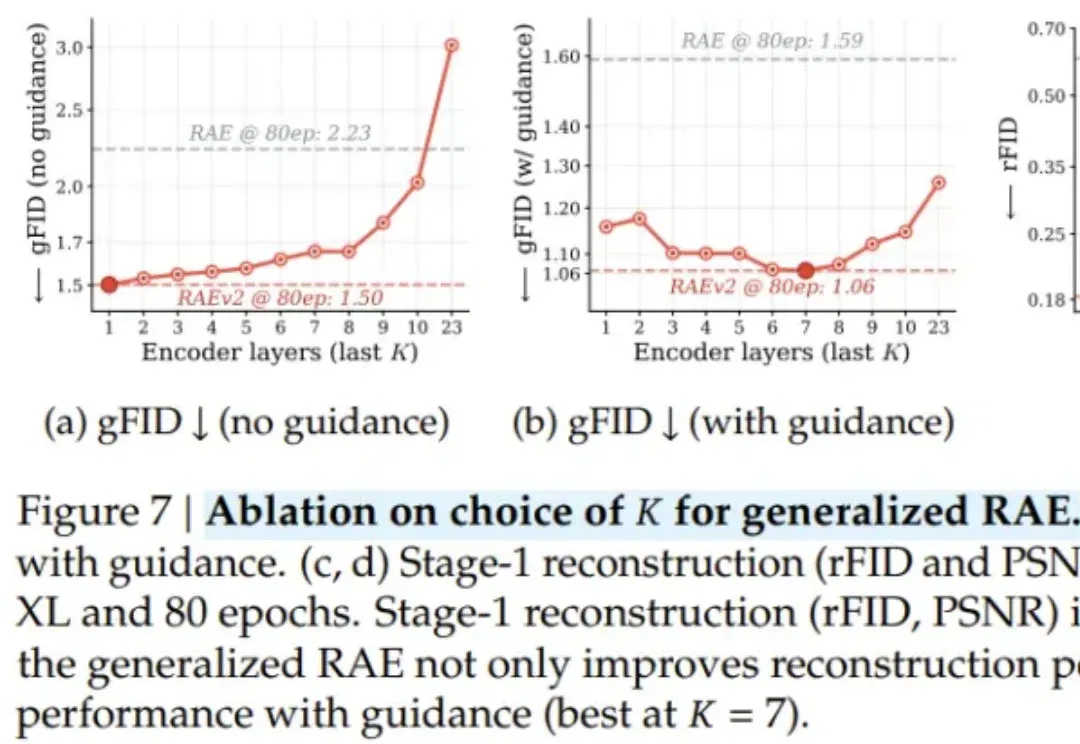
刚刚,谢赛宁团队放出第二代表征自编码器 RAEv2(在新窗口打开)
AI 图像生成通常遵循「能力越强、代价越高」的铁律;与此同时,学界却在悄悄质疑另一个更根本的浪费:传统 VAE 对图像语义几乎一无所知,而 DINOv2、SigLIP 等视觉编码器早已从数亿张图片中习得了丰富的视觉常识。图像生成模型,真的需要从零开始「发明」对图像的理解吗?
内容栏目
分享不同 AI 工具、模型与相关技术的使用方法和实践文章。
AI 图像生成通常遵循「能力越强、代价越高」的铁律;与此同时,学界却在悄悄质疑另一个更根本的浪费:传统 VAE 对图像语义几乎一无所知,而 DINOv2、SigLIP 等视觉编码器早已从数亿张图片中习得了丰富的视觉常识。图像生成模型,真的需要从零开始「发明」对图像的理解吗?
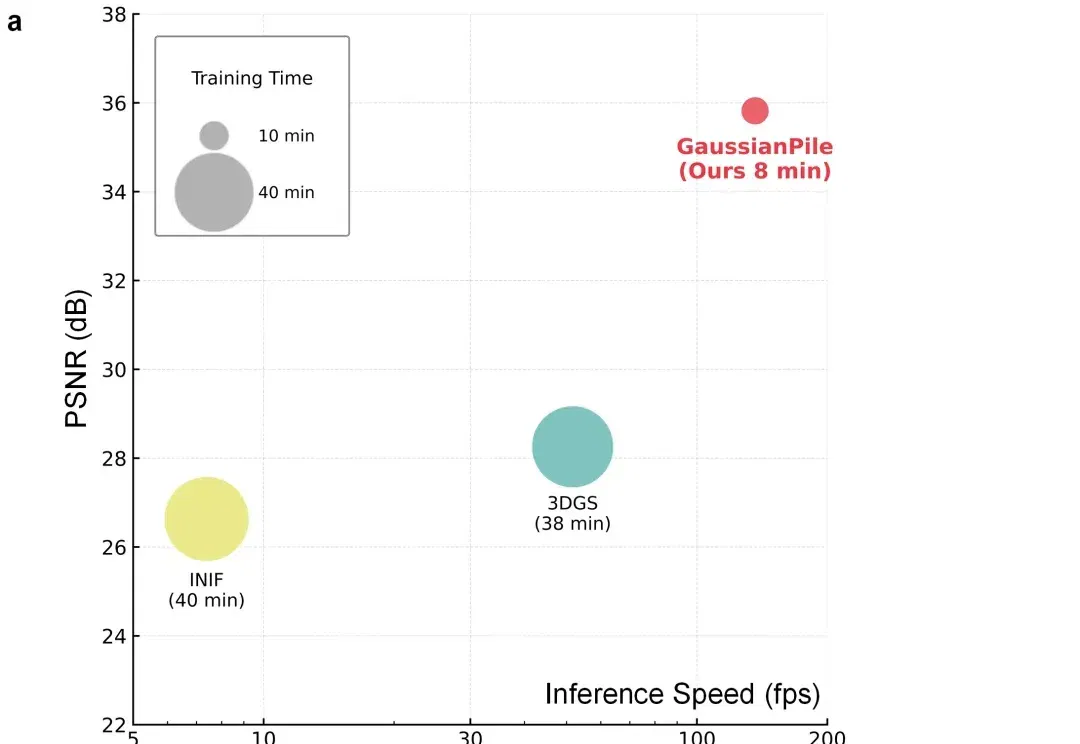
近年来,3D Gaussian Splatting(3DGS)在三维视觉和图形学中展现出很强的表示与渲染能力。相比传统体素或神经辐射场,它用一组可优化的各向异性高斯来表示三维场景,既能保留连续空间结构,又能实现高速渲染。
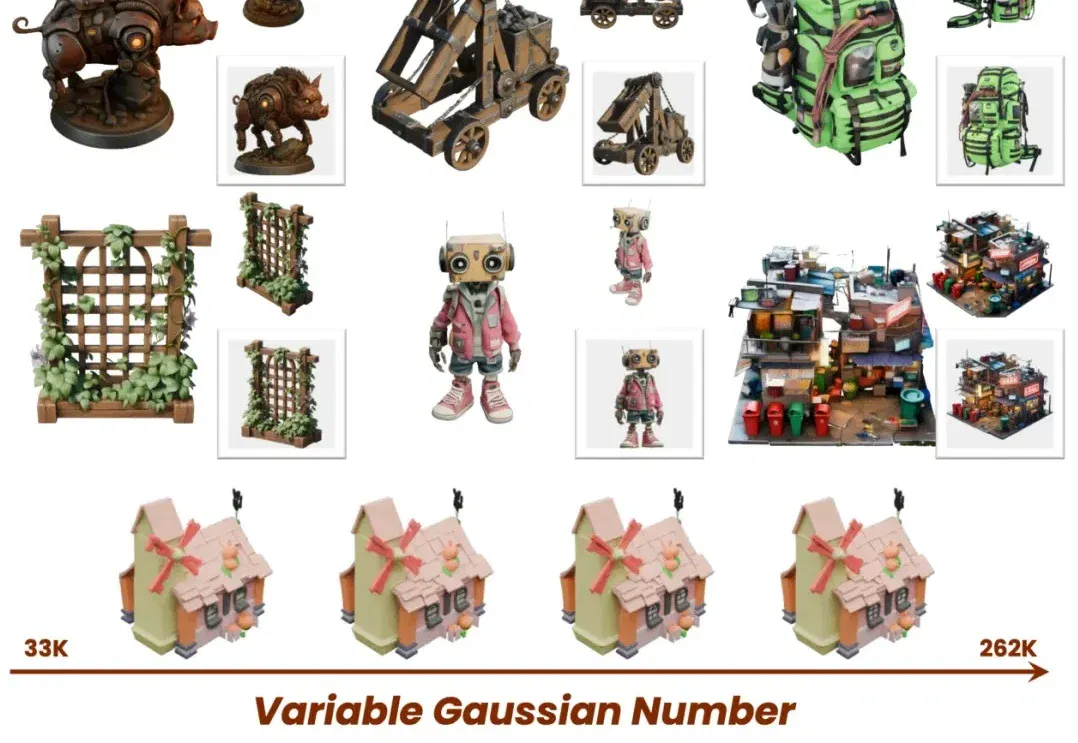
如果把现在最热门的几条 3D 生成技术线放在一起看,你会发现它们正在遇到一个很像的问题。
就在刚刚,智谱率先在 GLM-5.1 线上生产集群中完成了新一代组网架构 ZCube 的规模化落地。ZCube 发表于网络领域顶会ACM SIGCOMM 2025,被评价为「significantly change the way we think about and understand networking/显著改变整个行业对网络认知方式」。
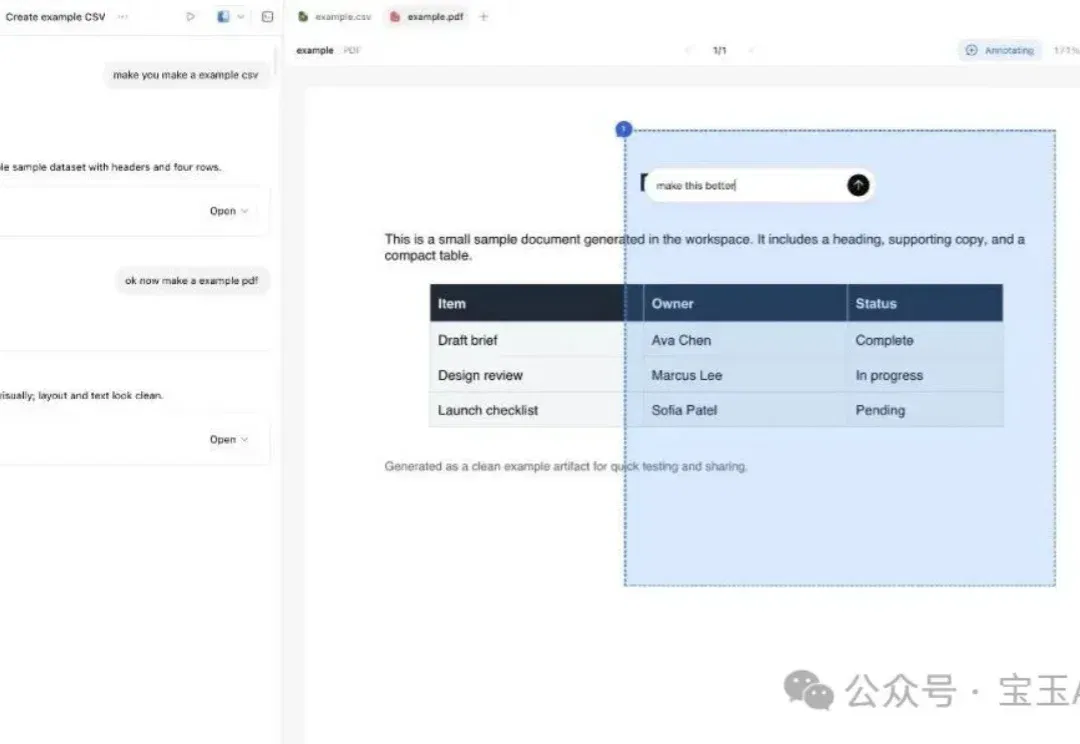
大多数开发者刚接触代码编辑类的 AI 智能体 (AI Agent) 时,通常只让它们干一件事:写代码。比如让它检查一下代码库,生成个差异对比 (diff),跑跑测试,然后再提个合并请求 (pull request)。
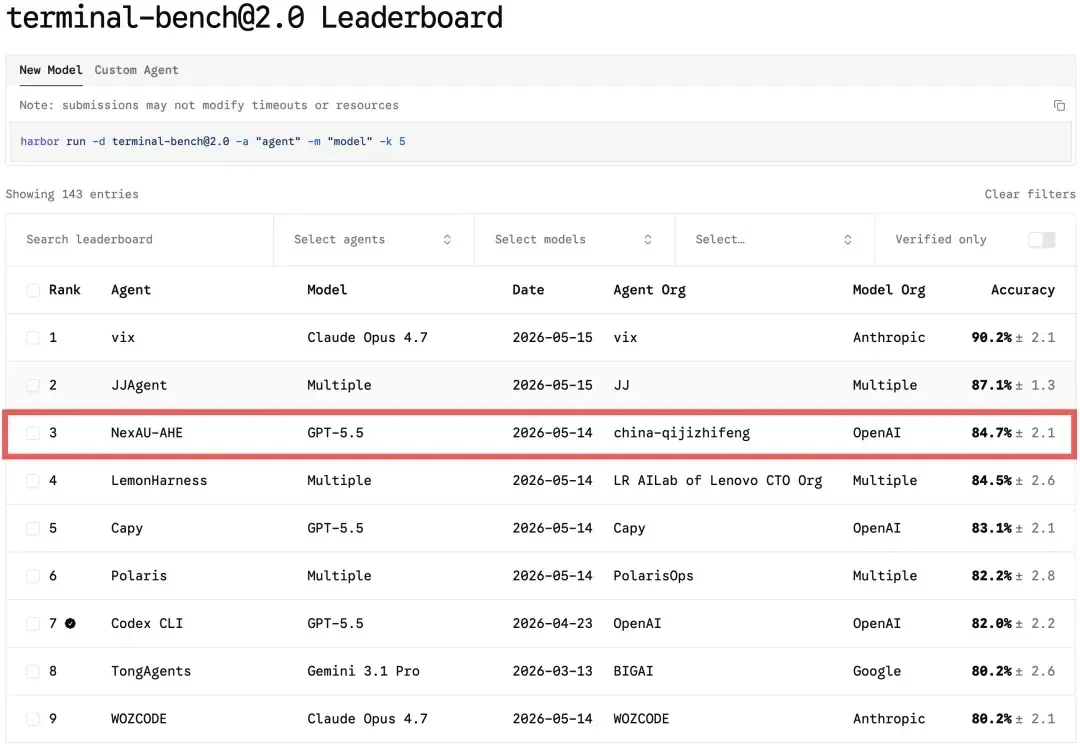
2026 年以来,OpenAI、Anthropic、LangChain 等机构纷纷发布关于 Harness Engineering 的技术博客,OpenClaw、Hermes Agent 等项目的火爆更让 Harness Engineering 成为业界热词。人们的共识正在形成:模型的能力释放,依赖于一套精密的外部框架。
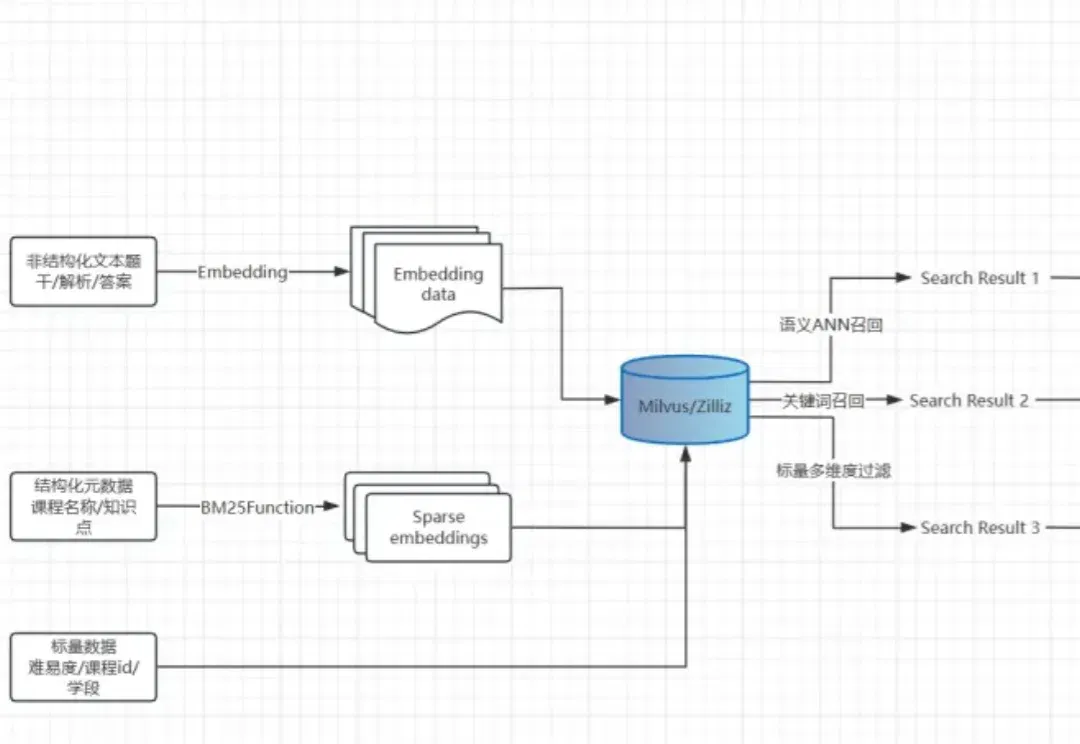
在教育科技领域,题库是核心资产,更是连接学生、教师与知识体系的关键入口。
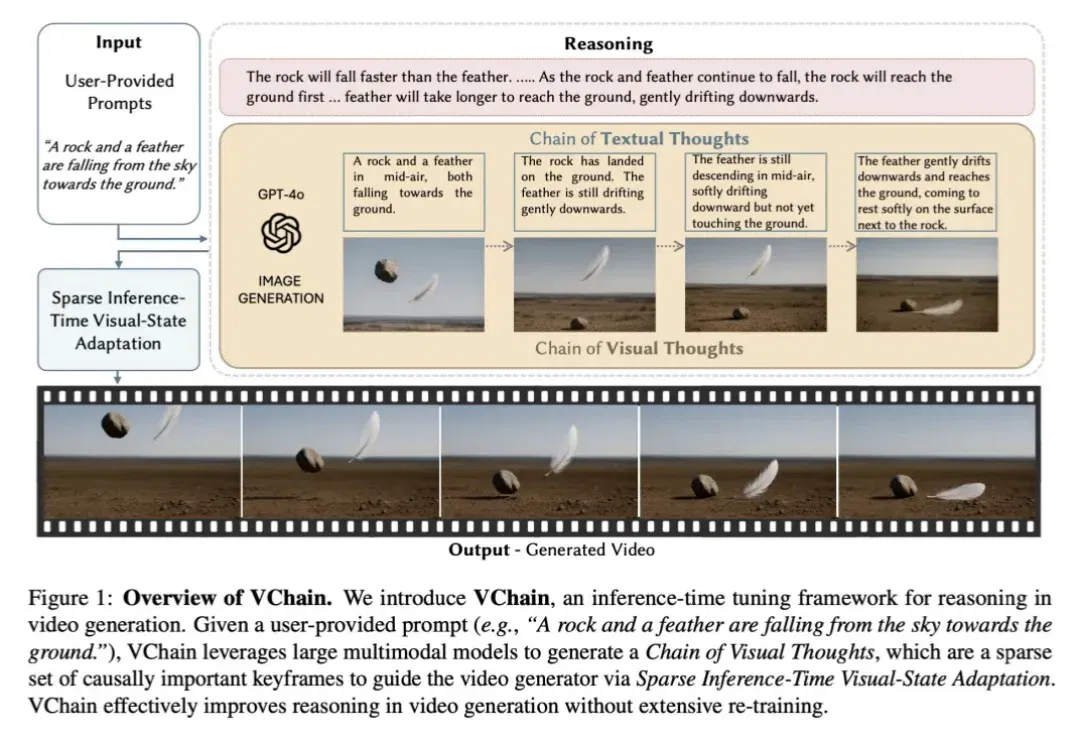
当视频生成模型在视觉保真度上不断突破时,一个核心瓶颈正变得愈发清晰:模型是否真正理解了真实世界?能否推理出合理的演变过程?
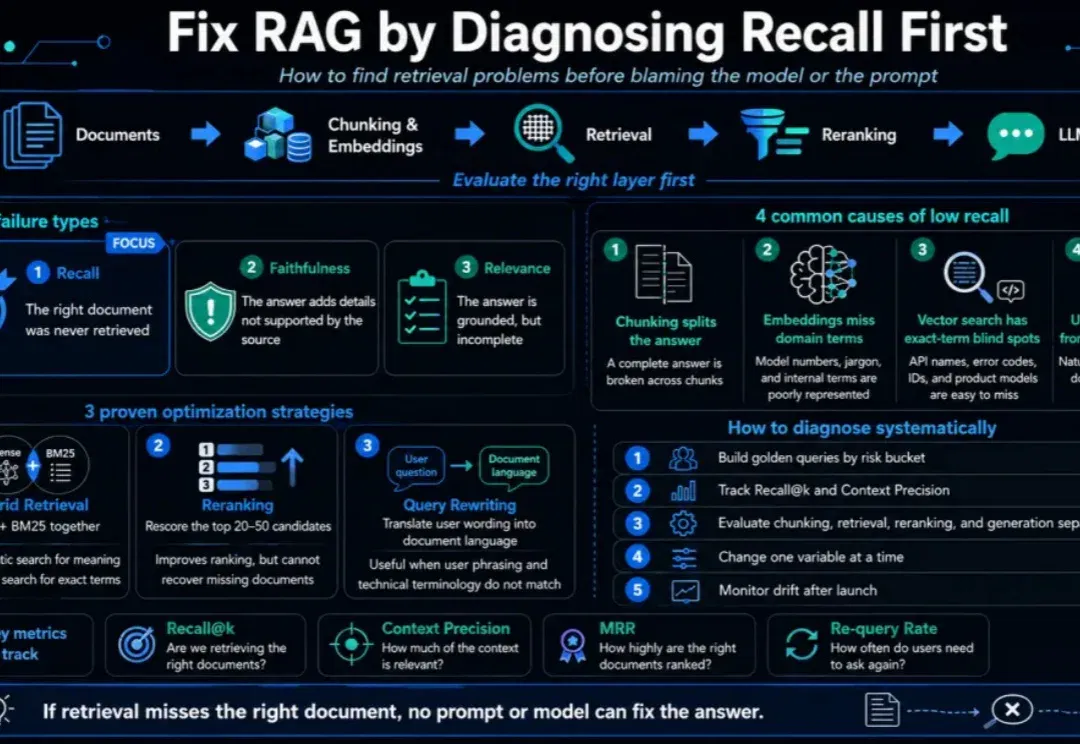
RAG 系统上线后答案出错,绝大多数团队的第一反应都是换更贵的模型、反复调试 prompt。
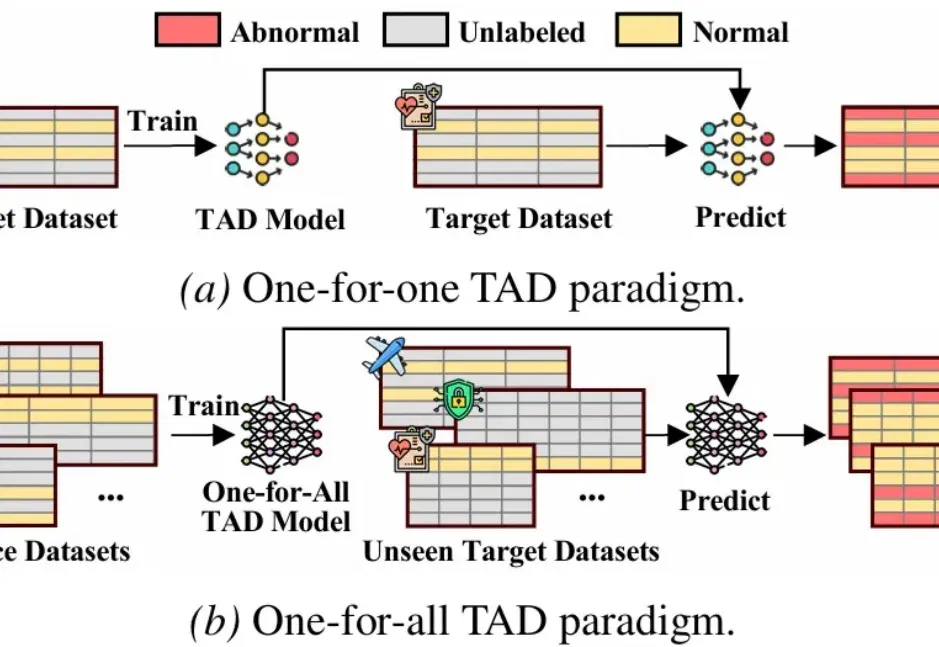
表格异常检测(Tabular Anomaly Detection,TAD)旨在从结构化数据中精准识别显著偏离正常分布的稀有样本,其在医疗诊断、金融风控及网络安全等关键领域的数据挖掘与安全保障任务中发挥着核心作用。
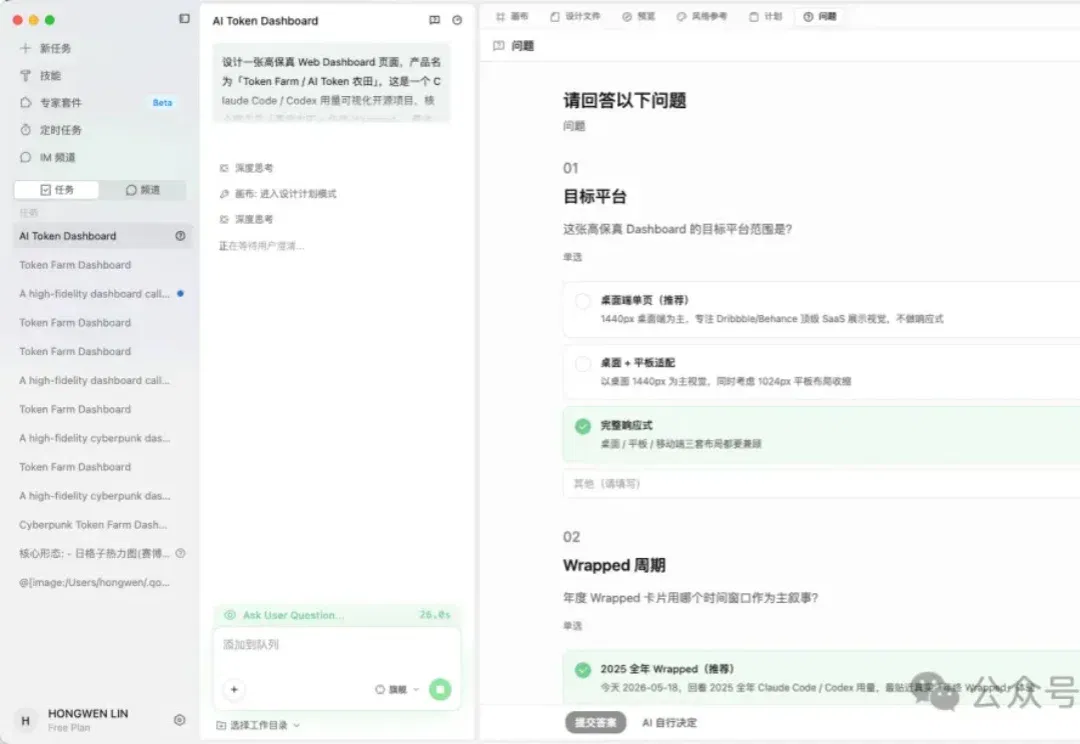
阿里的 QoderWork 最新上线了一个设计工作台(Design Desk),定位是用自然语言做出可交付的专业设计,从想法到工程级产物,中间不需要 Figma。
游戏规则要被改写了!Hermes Agent一键把模型订阅变成标准API,零成本驱动全套工具链。Grok同步杀入Agent生态。
奥赛级科学推理,一定要从更大的通用模型开始吗?
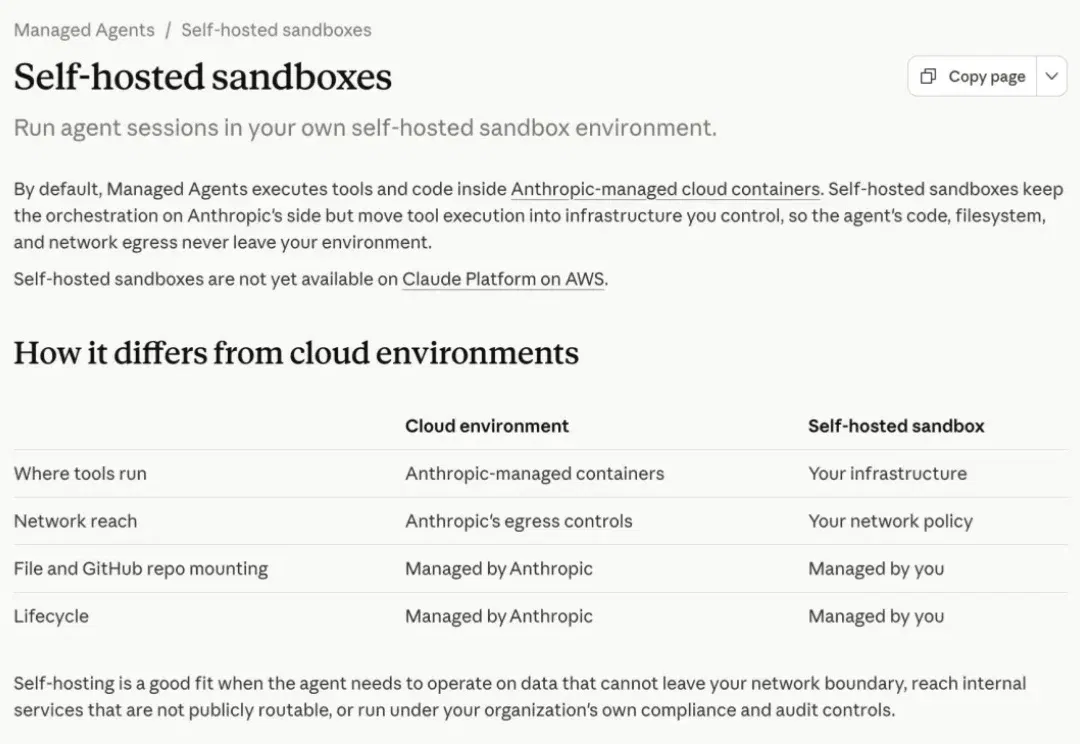
刚刚 Anthropic 又给他们的官方 Managed Agents 加了俩功能:自托管沙箱 self-hosted sandboxes 和 MCP 隧道 MCP tunnels
近日,谷歌 DeepMind 研究员 Lun Wang@lunwang1996,在 x 上发文宣布自己已经从 DeepMind 离职,结束了这段非常精彩的旅程,「我非常感谢曾经共事的人、我们一起打造的东西,以及我在将前沿 AI 研究推向生产环境过程中学到的经验。」
攻克AI落地难题,清华团队推出RWAI框架与真实场景竞技场,通过标准化人机交互、任务集机制与人类反馈体系,显著提升产业应用效率。平台已实现落地周期缩短70%以上,并为AI开发者和企业提供了可复制的最佳实践。
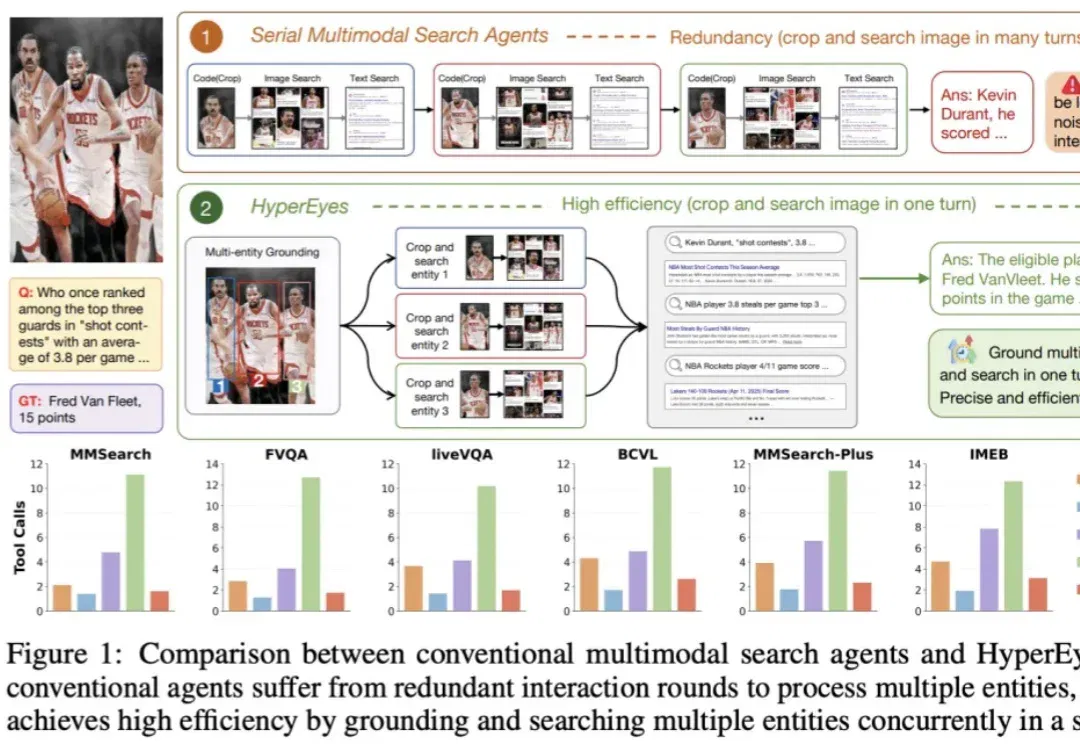
现有的开源多模态搜索智能体普遍受困于「裁剪 - 再搜索」的串行处理模式,面对多目标时往往陷入交互冗长、错误级联累积的泥沼。
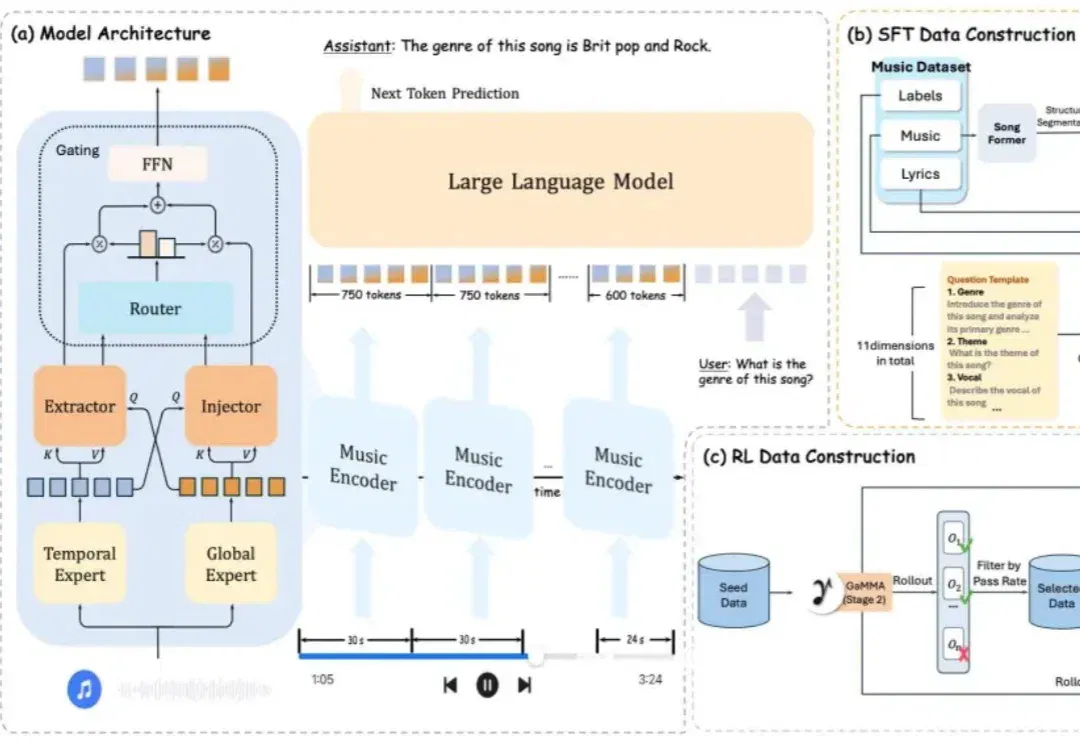
大模型的能力边界正在不断拓展,从文字到视觉,再到音频,全模态理解已渐成现实。然而,当你问一个多模态大模型「这首歌的高潮从第几秒开始?」或者「第 30 秒之后乐器编配发生了什么变化?」,得到的往往是一个模糊甚至错误的回答。
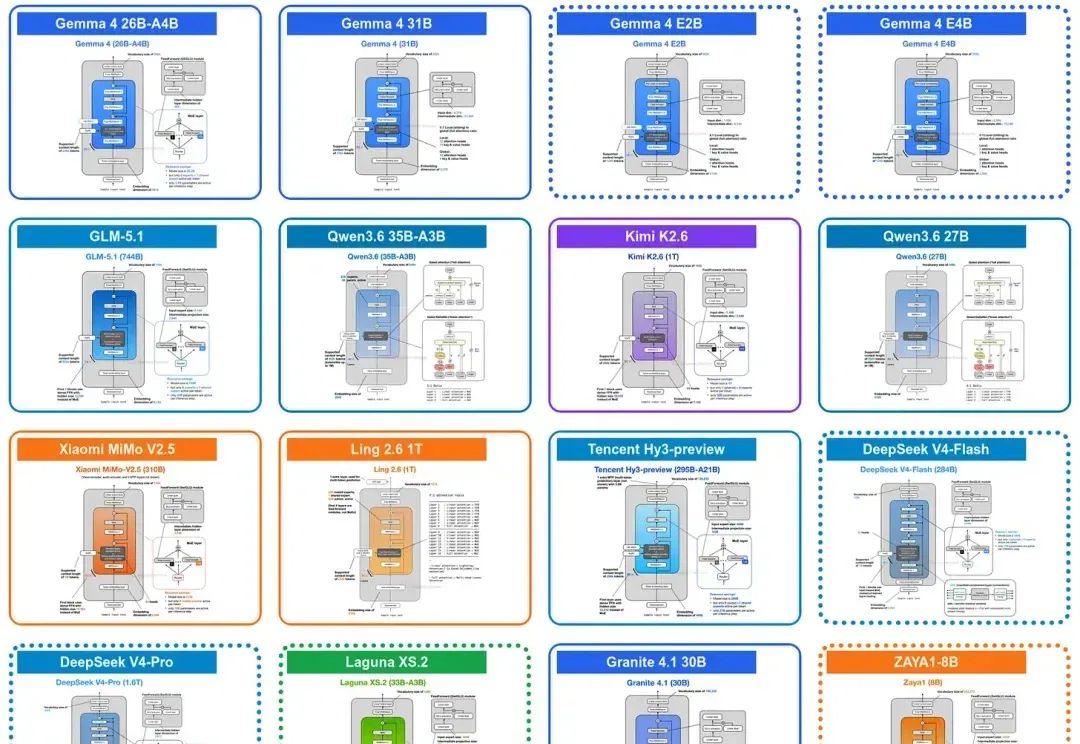
过去一段时间,很多人对大模型都有一个明显感受:token 总是不够用。
伯克利等发布FST框架:通过快慢分层解决大模型持续学习死局。
参与交流
了解加入交流群的方式,阅读内容无需登录。