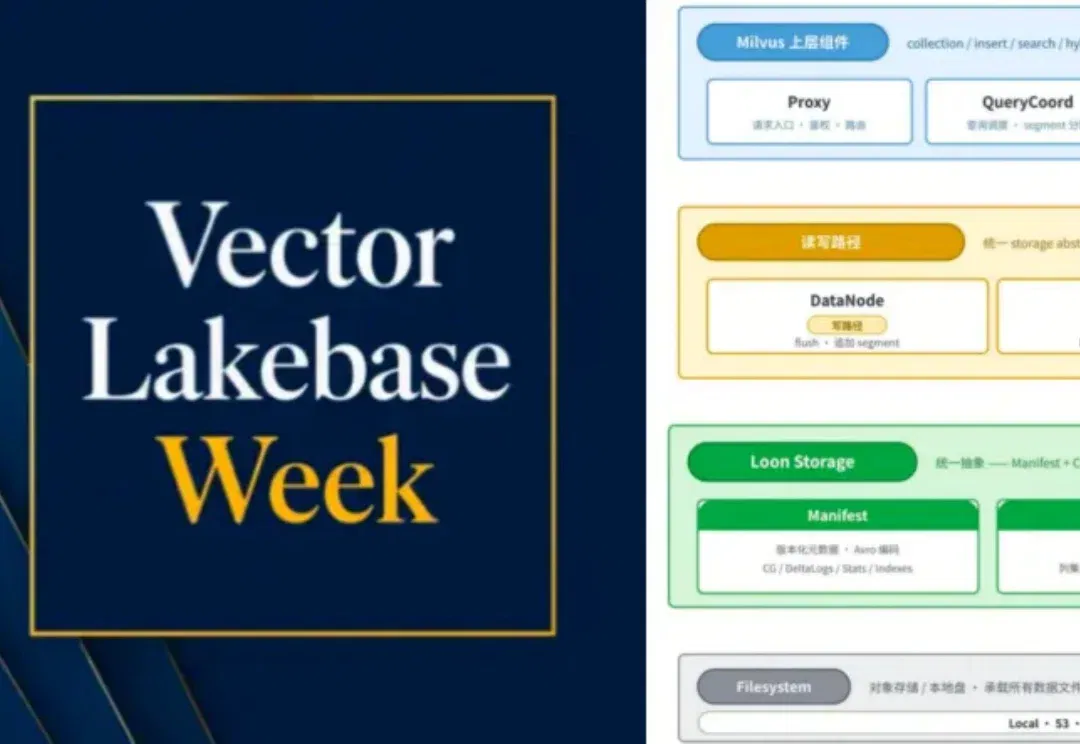
万字深度|做了8年向量数据库后,我们决定为Milvus重构AI时代的存储引擎(在新窗口打开)
过去八九年,我们一直在做一件事:把向量数据库从一个很小众的系统方向,做成 AI 基础设施里的关键组件。
内容栏目
分享不同 AI 工具、模型与相关技术的使用方法和实践文章。
过去八九年,我们一直在做一件事:把向量数据库从一个很小众的系统方向,做成 AI 基础设施里的关键组件。
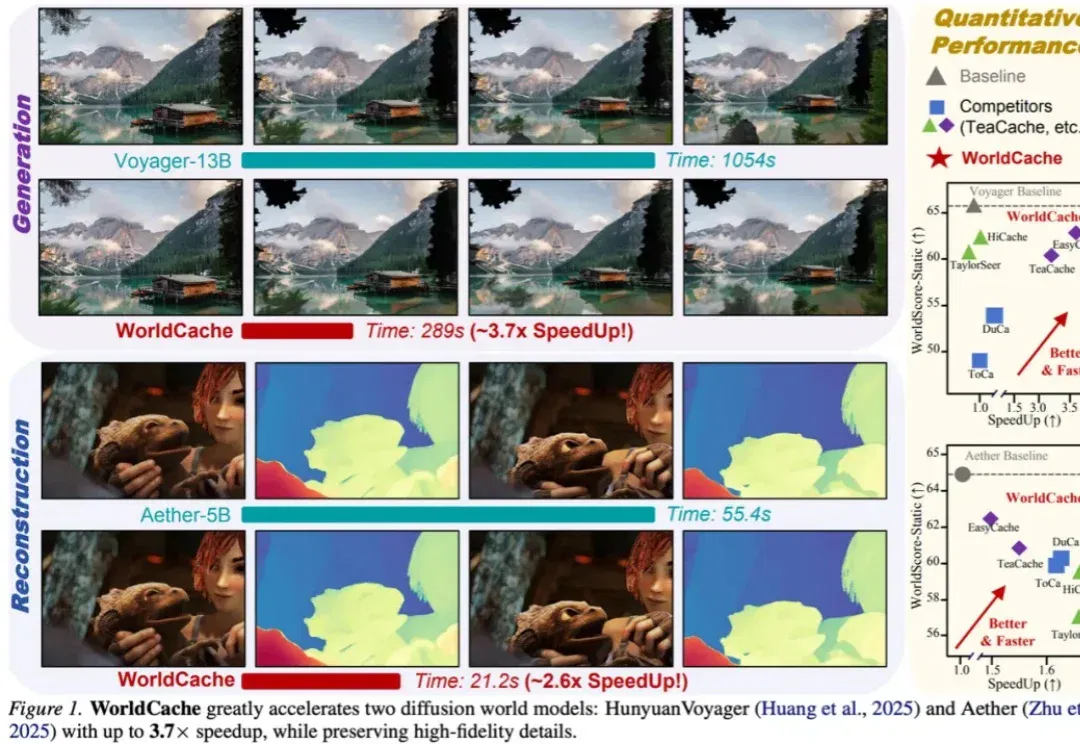
如果说扩散世界模型的瓶颈,是每一步去噪都要把同一个大 Transformer 再跑一遍,那么 WorldCache 的思路就是:不要再把所有 Token、所有时间步都当成同一件事。这篇工作把 “哪些内容适合缓存”和“哪些时刻必须重算” 拆开处理,在不重新训练模型、几乎不增加额外显存的前提下,把缓存真正做成了一套更贴合世界模型结构的推理策略。
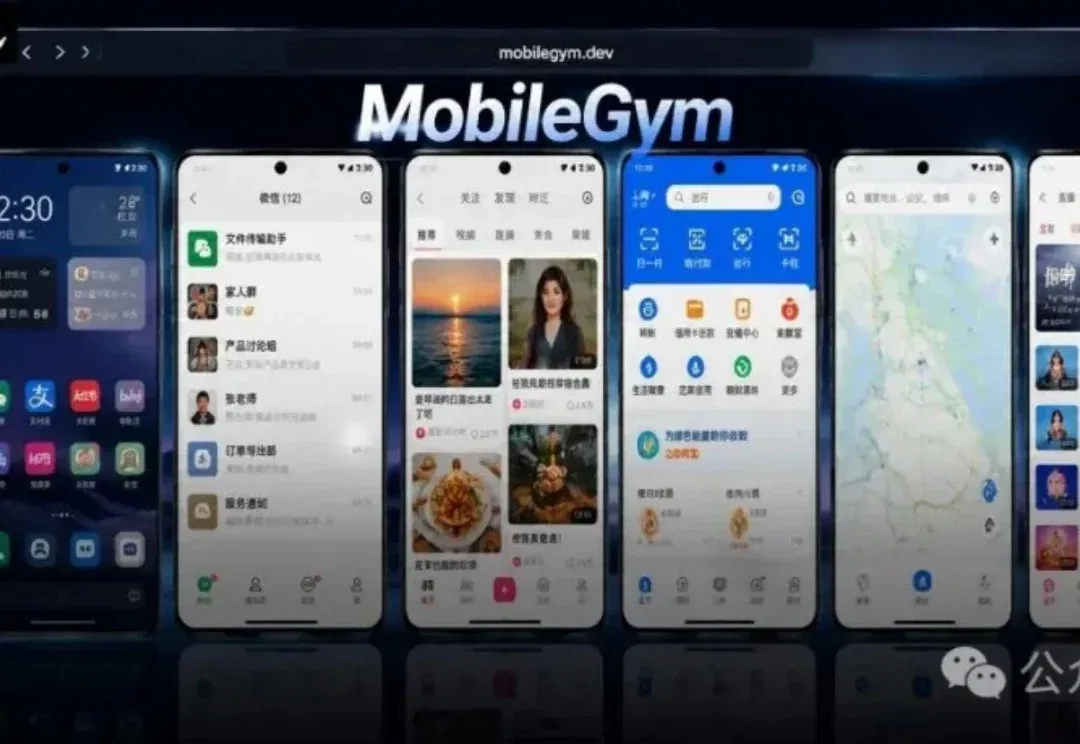
中科院自动化所模式识别实验室开源MobileGym,运行在浏览器里的高并发安卓仿真平台,完全自定义,告别模拟器风控与真机成本,一个平台搞定Mobile Agent训练与评测,甚至还能玩原神!
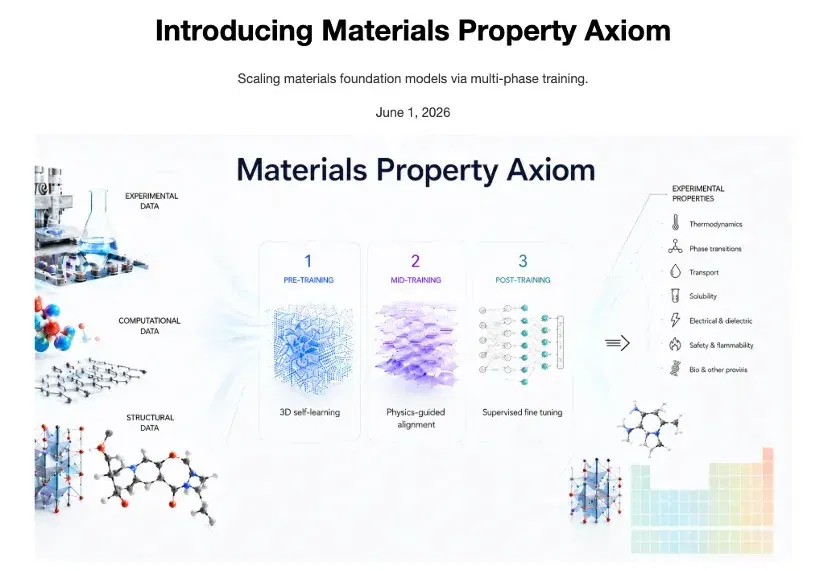
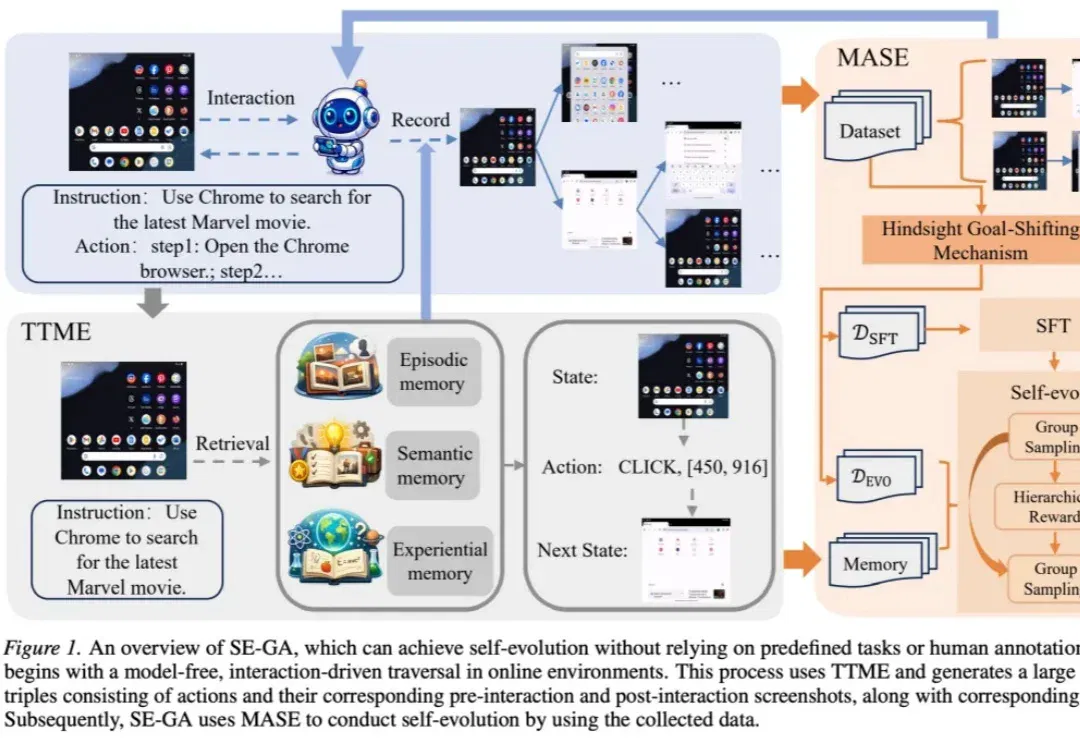
今年,我们正在打开 AI 自我进化的大门,按下了通往 AGI 的加速键。
一个有灵魂,有记忆的 Agent,一次任务的生命周期包括以下步骤
昨儿发了 Coze 3.0 的介绍说明,很多小伙伴看起来都没仔细看。
过去,AI 研发基本是一条由人主导的流水线。
从 LLM 的超长文本处理、视频生成模型的以假乱真、Agent 自主规划与执行的日趋成熟,到 VLA、世界模型等开始进入物理世界,AI 正在不断拓宽其能力边界。
最近,前沿实验室 Mind Lab 密集发布了一系列关于 LoRA 与 PEFT(高效微调)的研究结果,似乎描绘出了另一条大模型「持续学习」的路径。在 Mind Lab 的视角中,PEFT 不再是对大模型全参数后训练的一种廉价平替,更是实现从 “基础模型” 向 “可持续学习智能体” 过渡的核心架构机制。
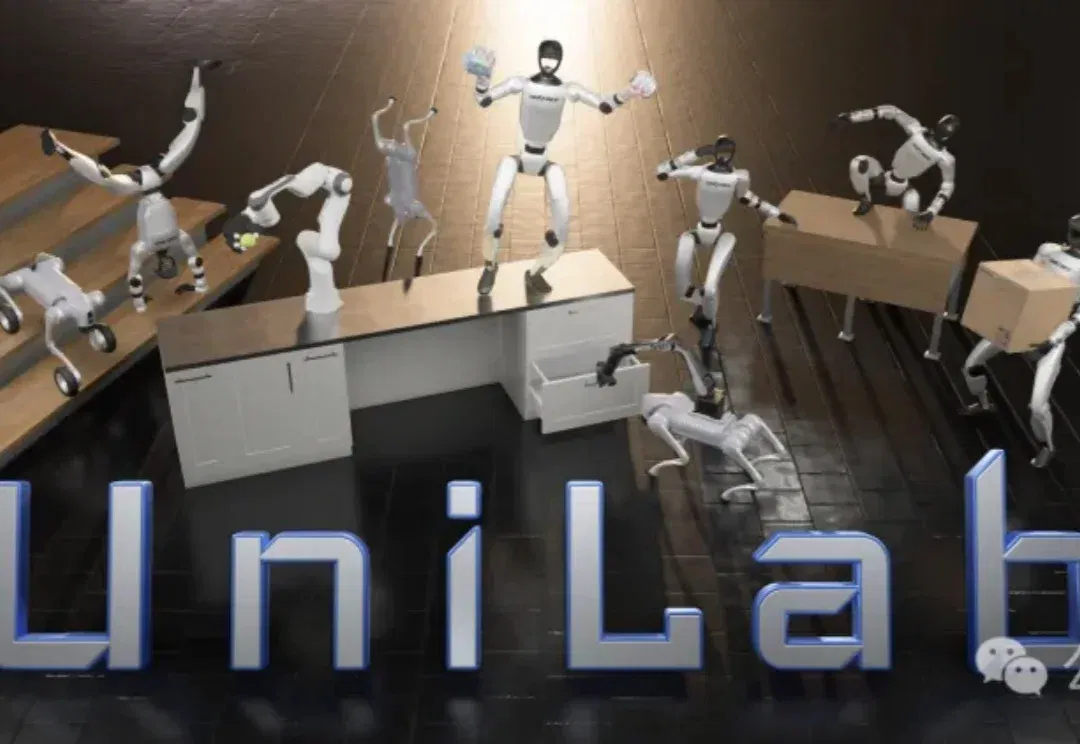
在具身智能训练中,“把计算全部塞进GPU”似乎成了唯一的提速密码,机器人运控并行训练的框架,IsaacLab、MuJoCoPlayground、mjlab都默认遵循这一范式,这些系统都牢牢绑定在NVIDIA生态中。
把一件皱成一团的衣服叠好,是家务,也是机器人操作里的“硬仗”。
本文团队长期从事负责任的人工智能与人工智能赋能社会科学相关研究,围绕视觉生成大模型安全治理、智能体安全等方向开展系统性工作,相关成果发表于AAAI、ICML、TMM 等国际期刊与会议。
上一篇文章,和大家聊了一下这个项目,做了一个整体性的复盘,但主要是以业务和团队等方面说的,但是实现方案和大模型相关评估上,说的不多,这篇文章,我们就在产品实现方案和大模型这块来聊一下。
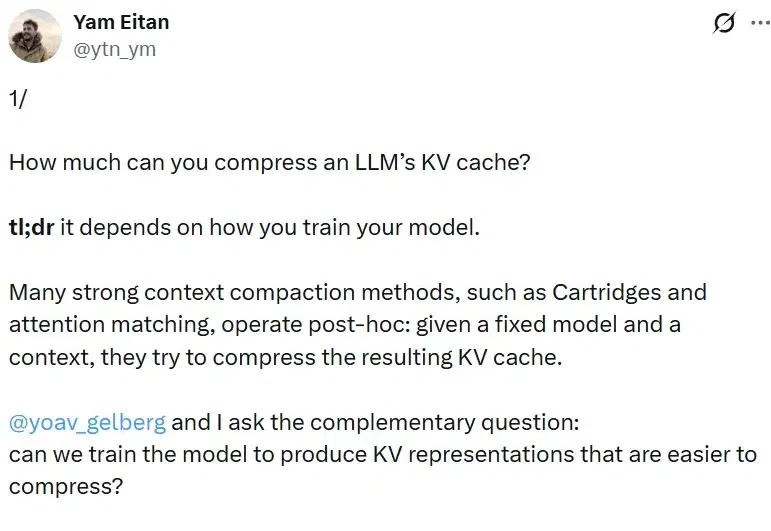
2026 年初,各大 AI 厂商在上下文窗口长度上展开激烈角逐。Google 的 Gemini 3 Pro 已支持 100 万级 token 上下文,Meta 的 Llama 4 Scout 更宣称可处理 1000 万 token。GPT-5 系列也在快速推进长上下文能力。
AI模型在电脑上预测精度爆表,一到实验室就各种出错用不了?
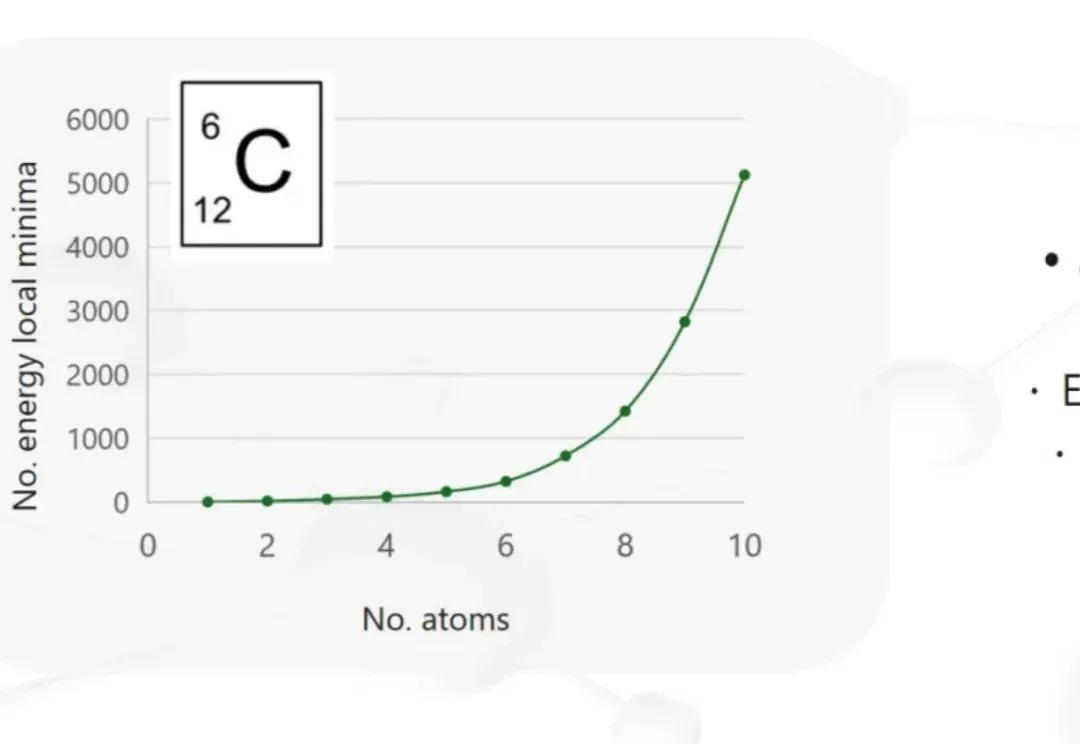
材料研发的“试错时代”,正在被AI加速改变。5月21日,未来光锥「AI for Science 创变者说」第二期沙龙“AI+材料的千亿级机会”,邀请了三位学界与产业一线嘉宾,共同探讨AI+材料科学的前沿与实践。
紧跟DeepSeek价格战,小米掏出技术底牌!
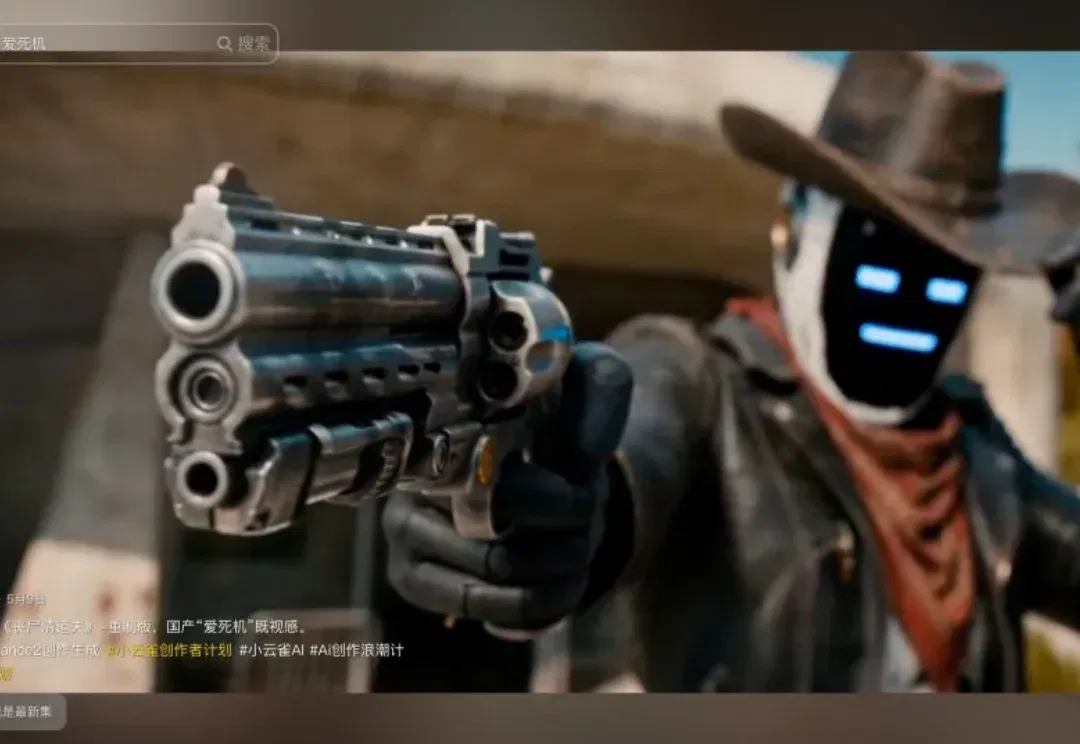
大家最近应该都被云南大神MX-Shell花3000制作的《丧尸清道夫》刷屏了吧。他做的这个抖音400多万点赞的AI视频,真的非常牛逼。
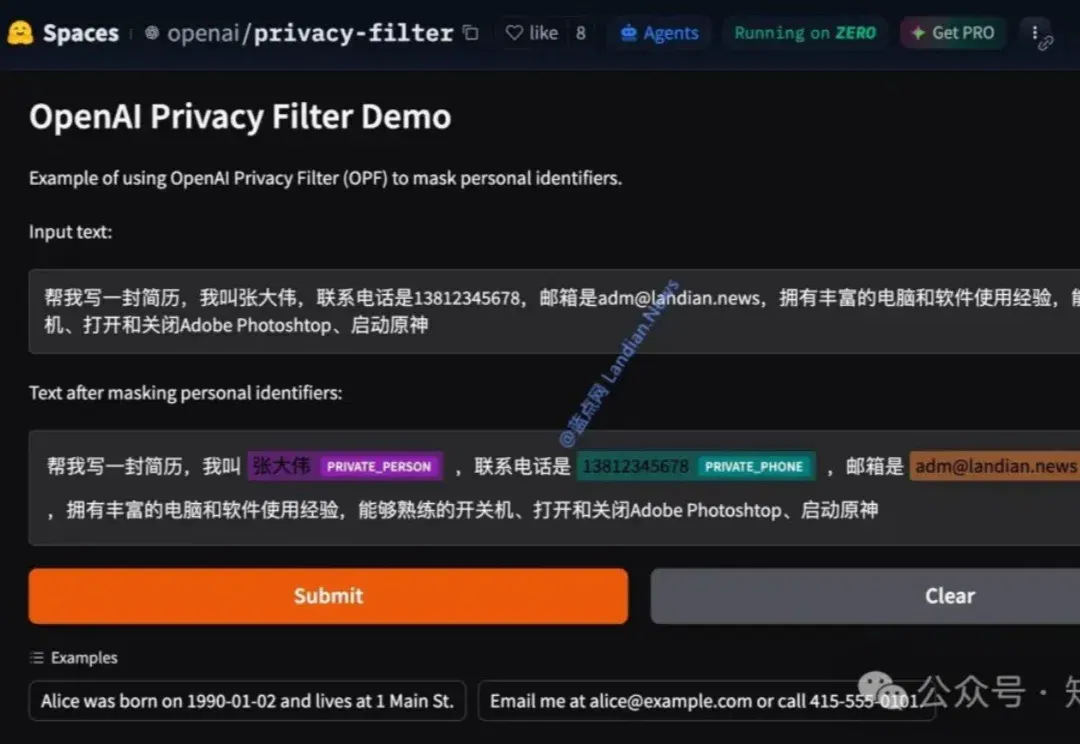
你有没有过这样的经历:把聊天记录、用户反馈或内部文档丢给大模型时,总担心里面夹杂着真实姓名、手机号、邮箱甚至 API key,最后只能手动一条条删?或者团队在处理海量数据时,规则写的正则永远漏掉那些“藏在句子里的隐私”。
从大模型的提示词到智能体的 Skills,看着进化了,但又没有完全进化。
参与交流
了解加入交流群的方式,阅读内容无需登录。