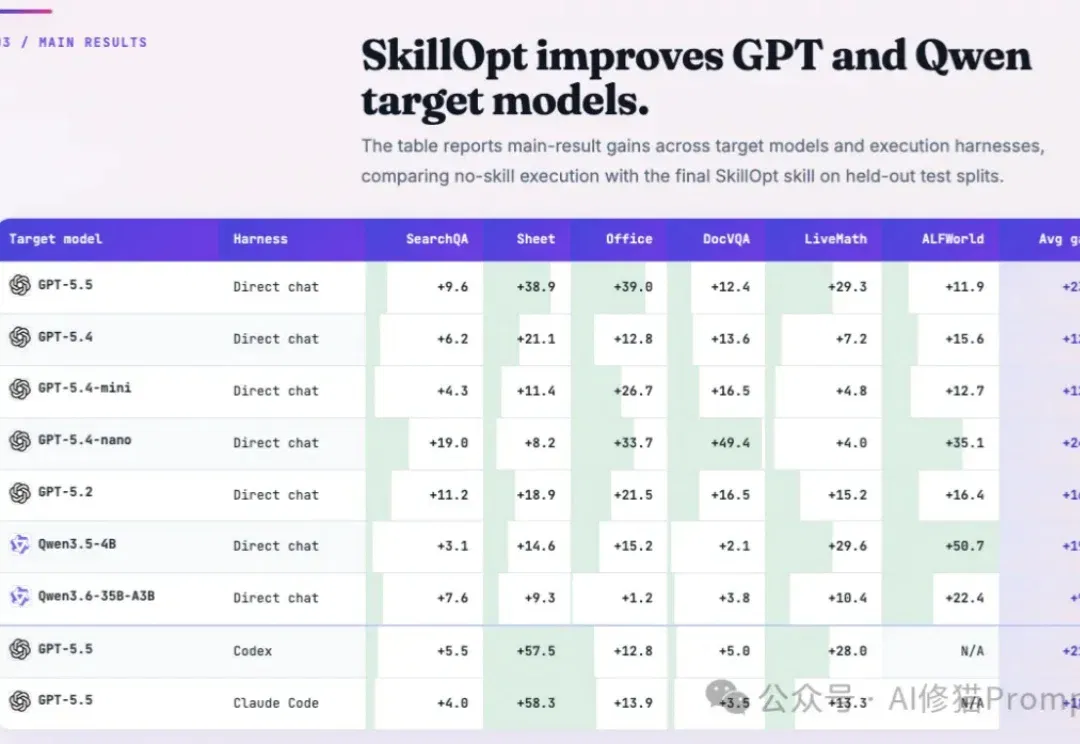
微软最新提出SkillOpt,用训练大模型的方法优化你的Agent Skills(在新窗口打开)
训练大模型时,工程师绝对不会指望网络做一次前向传播就能收敛。它需要数据喂养、Batch切分、学习率控制、验证集筛选以及优化器状态的迭代试错。
内容栏目
分享不同 AI 工具、模型与相关技术的使用方法和实践文章。
训练大模型时,工程师绝对不会指望网络做一次前向传播就能收敛。它需要数据喂养、Batch切分、学习率控制、验证集筛选以及优化器状态的迭代试错。
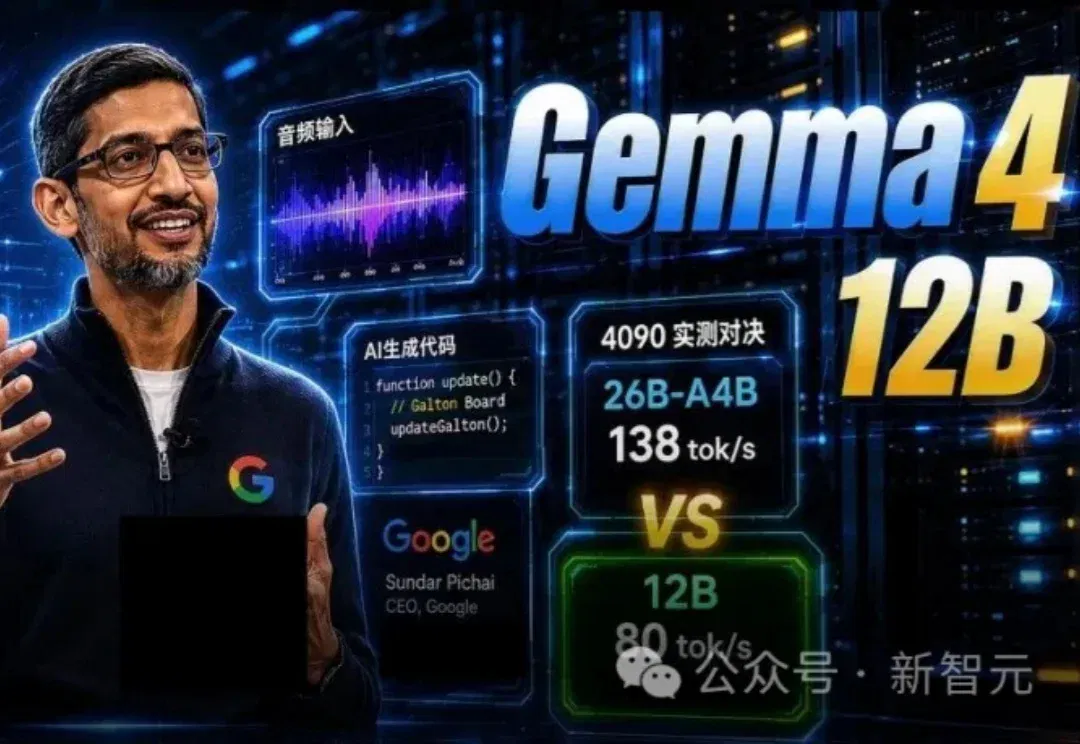
刚刚,谷歌扔出Gemma 4 12B大杀器!16G轻薄本就能全离线流畅跑通,性能直逼26B巨兽,全体开发者惊呼太震撼了,平民级本地AI封神之作降临。硬核实测速来看!
Claude Mythos就用6.1×10²⁷ FLOPs提前叩响了奇点的大门。
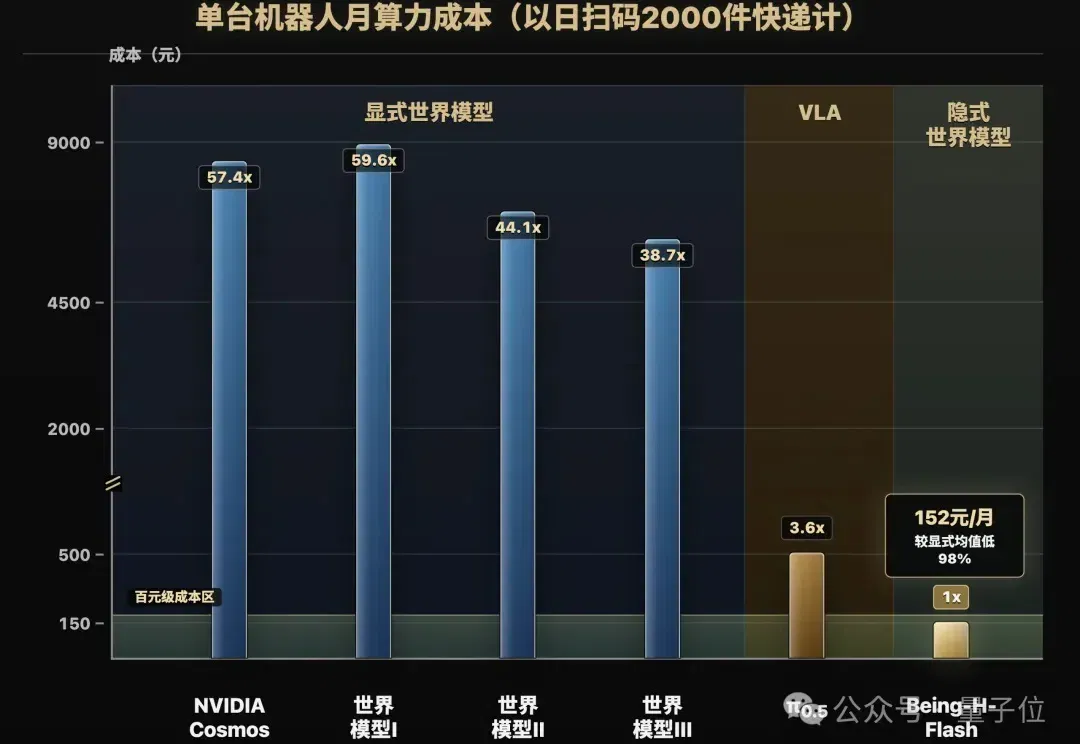
真没想到啊!物理AI的账单,有一天竟然能和大模型一个价。
世界模型火,火到都有点乱了。 单单一个定义,就越来越众说纷纭:视频生成模型可以是世界模型,能生成游戏的语言模型也被叫世界模型,还有人把物理引擎也塞进这个筐里…… 乱,乱得李飞飞本人都有点看不下去了。刚刚,她亲自撰文,给世界模型来了个清晰的功能分类。 用词毫不客气:世界模型是当今人工智能领域最重要也最被滥用的术语之一。 古希腊人无法就世界的构成达成共识,因为“世界”从来不是一个单一的实体。人工智能也继承了同样的问题,而此时,这个领域恰恰最需要的就是精准性。 至少,要先分清三件事: 渲染、模拟、规划。 话不多说,赶紧一起来做笔记。 世界模型的三大功能 李飞飞首先拆析了世界模型的技术意义。 智能体(
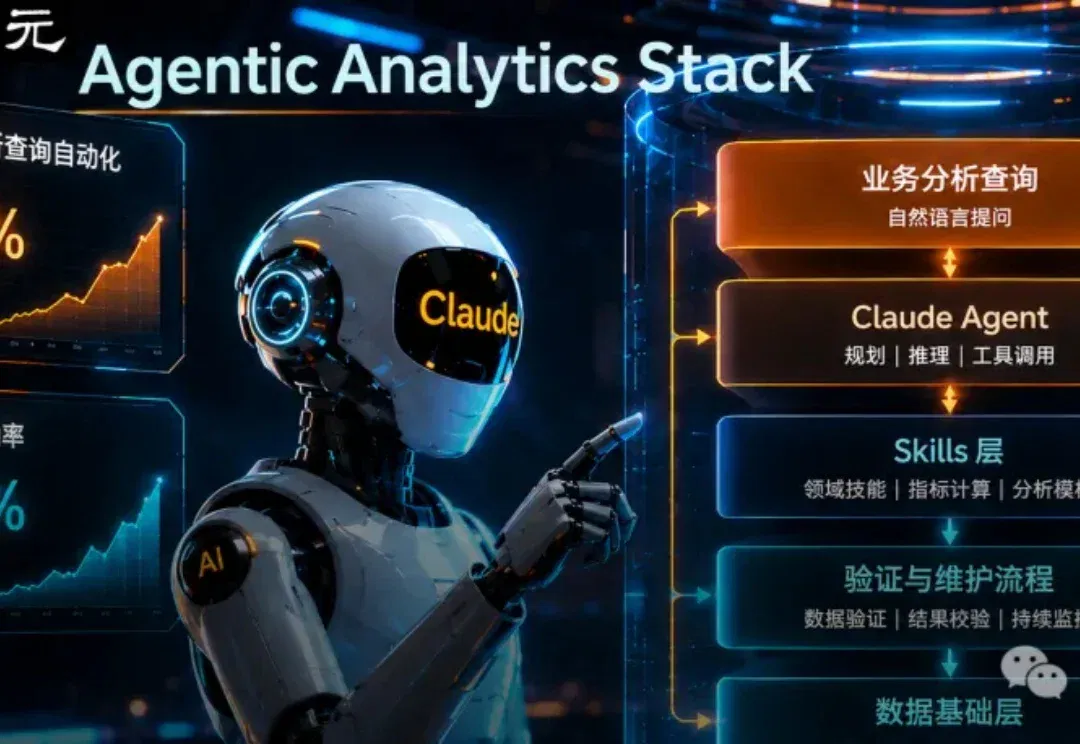
都以为让AI查数据省事,结果它答得漂亮你却不敢信。Anthropic最近说这事有解了,靠的是一套和代码无关的「笨功夫」。
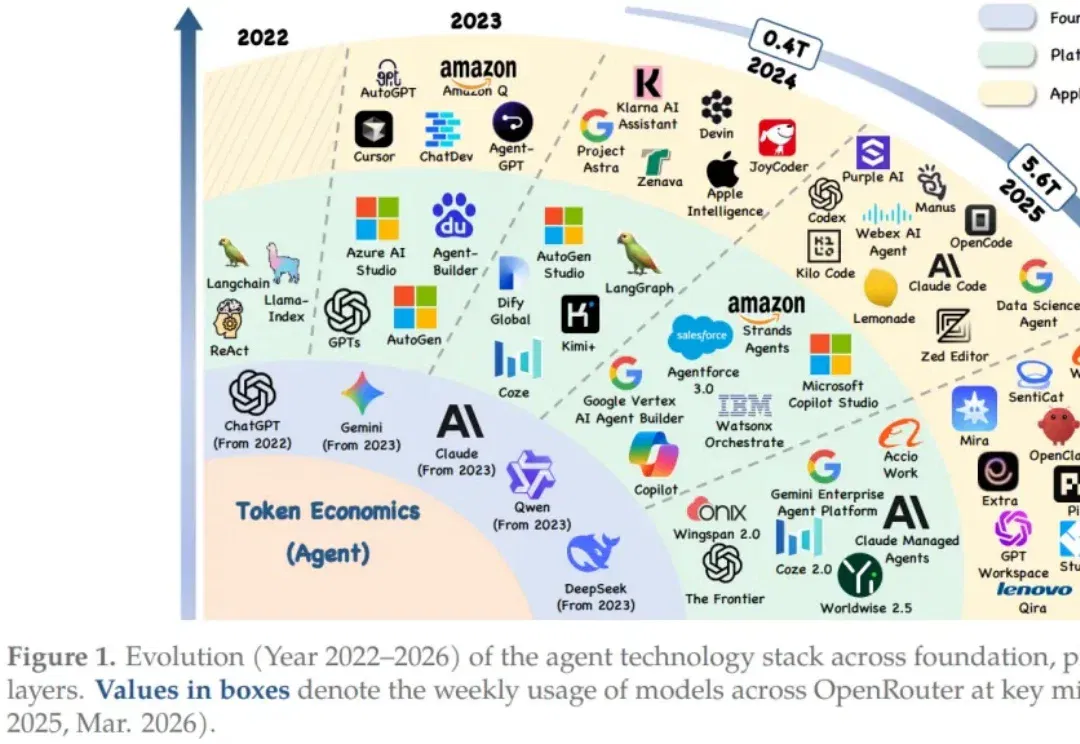
当大模型 Agent 从实验室加速走向金融、医疗、代码开发等高价值场景,一个隐秘却致命的瓶颈正在浮现:Token 的指数级消耗正引发算力、协作与安全的系统性危机。传统 “堆算力、加参数” 的线性优化已触及天花板,我们该如何在 “输出质量” 与 “经济成本” 之间找到可持续的最优解?
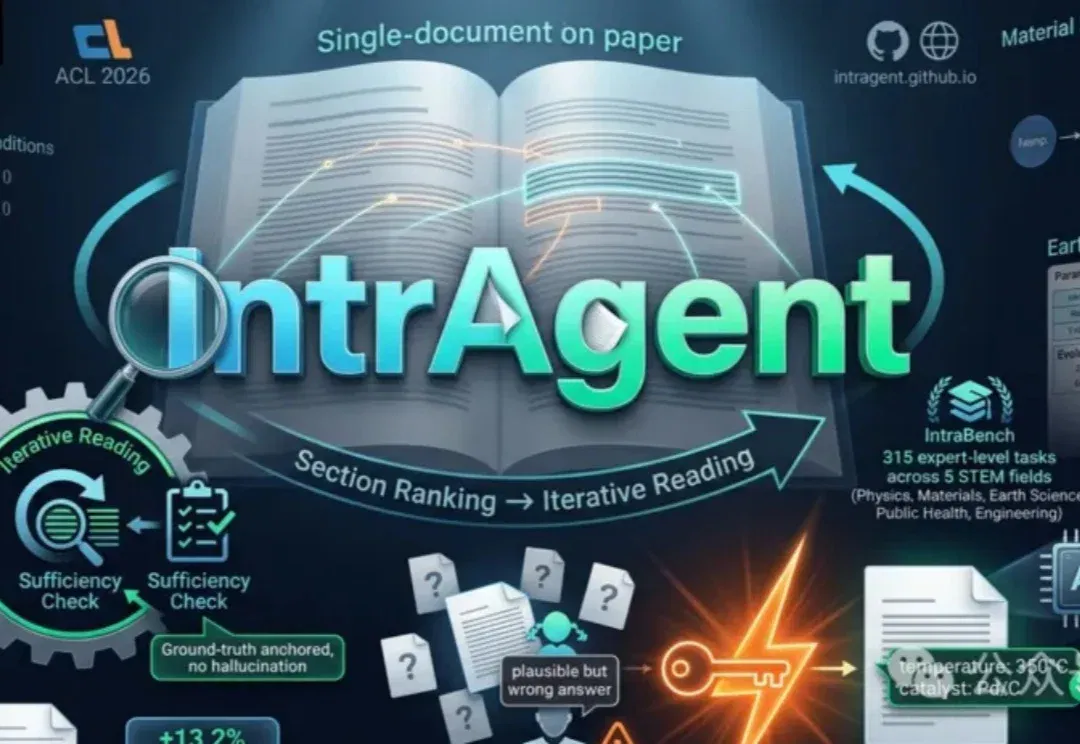
为解决科研中对单篇文献深度解析的需求,佐治亚大学团队提出IntrAgent,专注单篇内容,避免大模型幻觉。通过段落排序与迭代阅读机制,精准提取实验细节与元数据。
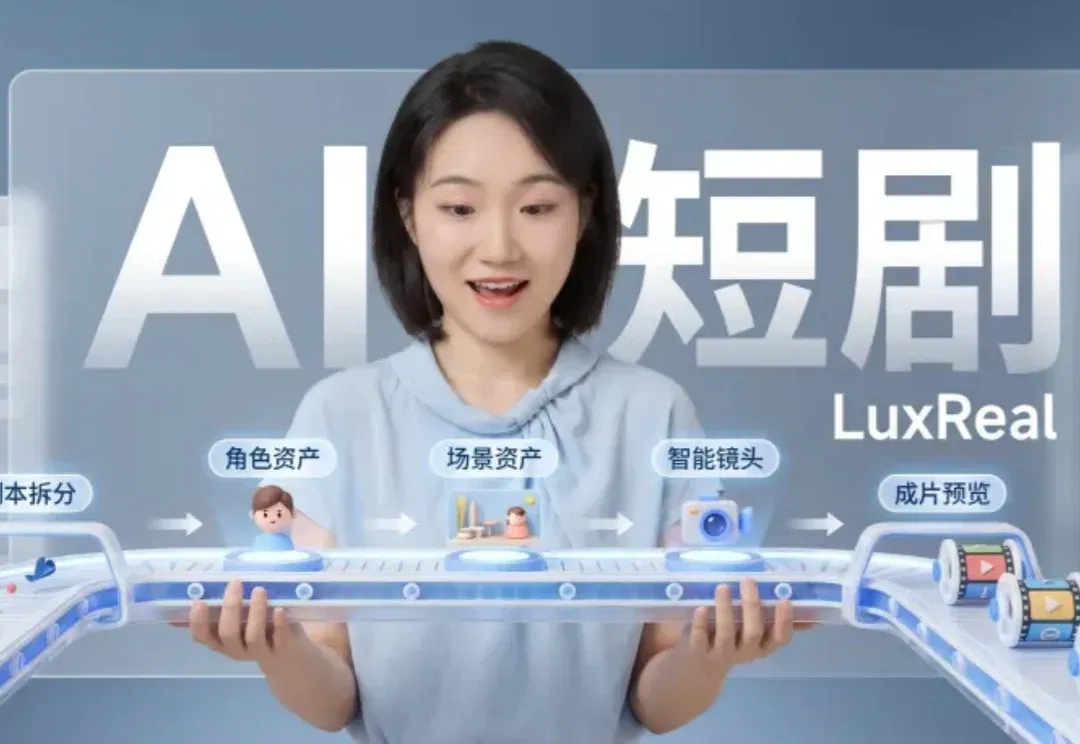
一直有在关注的一个 AI 短剧工具最近终于上线了,那就是群核科技的 LuxReal 短剧版。
刚刚过去的GTC Taipei上,最备受关注的,莫过于Cosmos 3。
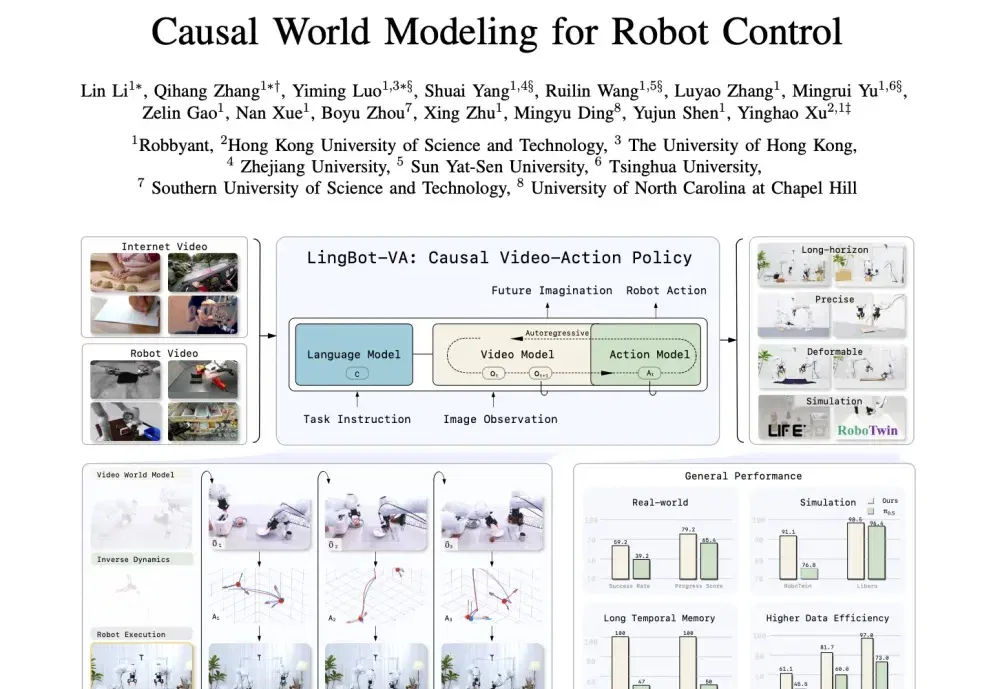
赋予机器人物理理解和预测能力是通用操作的关键。蚂蚁灵波等机构提出的 LingBot-VA 试图将视频帧预测与动作推理统一起来,让机器人通过自回归扩散框架学会“一边思考一边行动”。
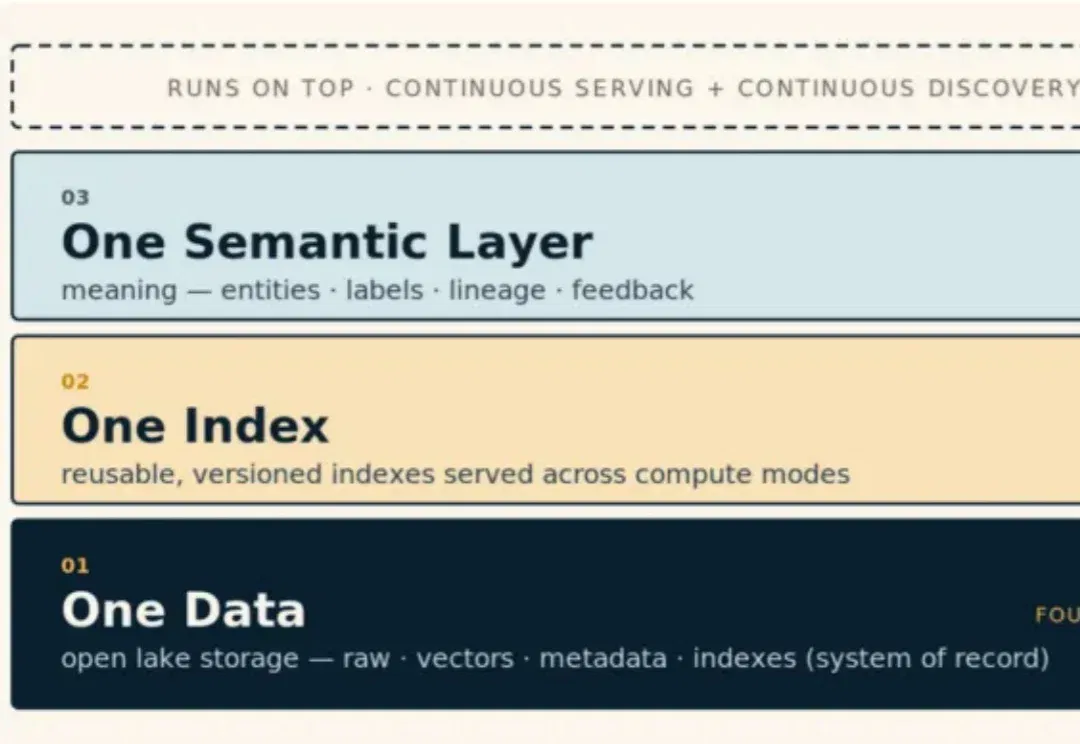
这篇文章想回答几个大家更关心的基础问题:Vector Lakebase 能解决你的什么问题,什么场景下用它最合适,如何用好Vector Lakebase 。
过去半年,几乎所有Agent框架都在补长期记忆能力。最常见的做法,是给系统接一个向量数据库,把历史对话、用户偏好、项目经验、工具调用结果、失败案例都存进去。看起来,只要把“记忆”这块补上,Agent就能从一次性对话工具变成长期协作伙伴。
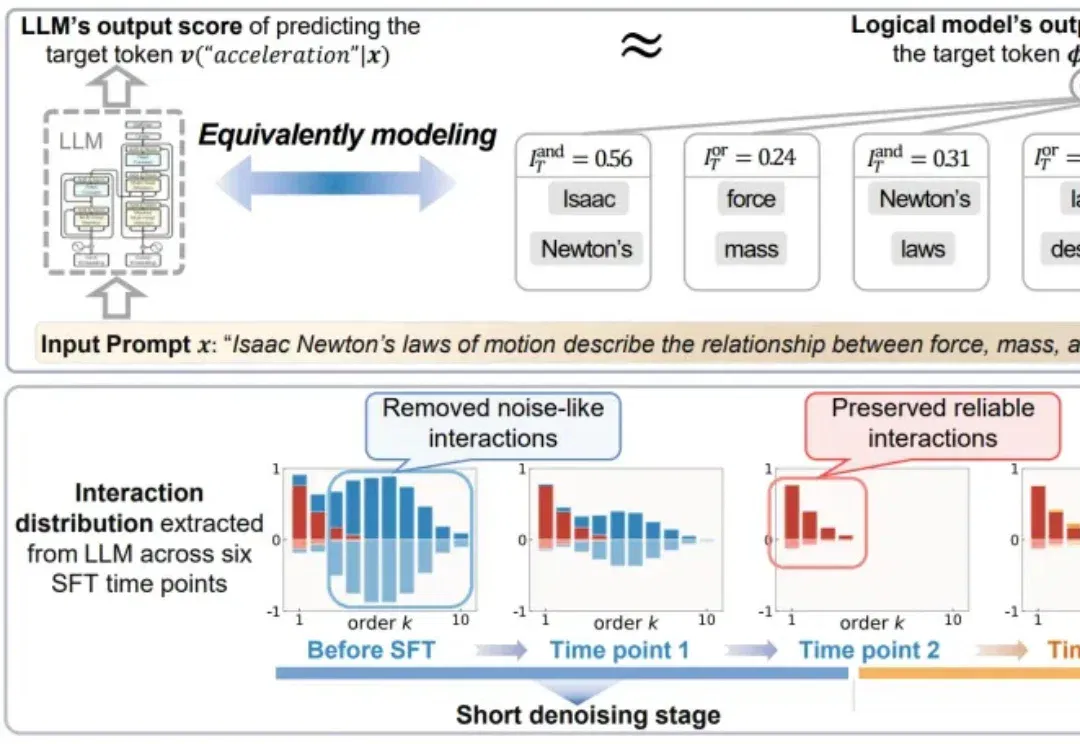
长期以来,监督微调(Supervised Fine-Tuning,SFT)一直是深度神经网络中最常用的模型适配手段。在中小规模的传统神经网络中,SFT 通常能够稳定提升下游任务表现。
Codex 又又又大更新,前一天负责人还在说,是不是要改名 ChadGPT,网友在下面评论说,不如直接将 ChatGPT 重新命名为 Codex。
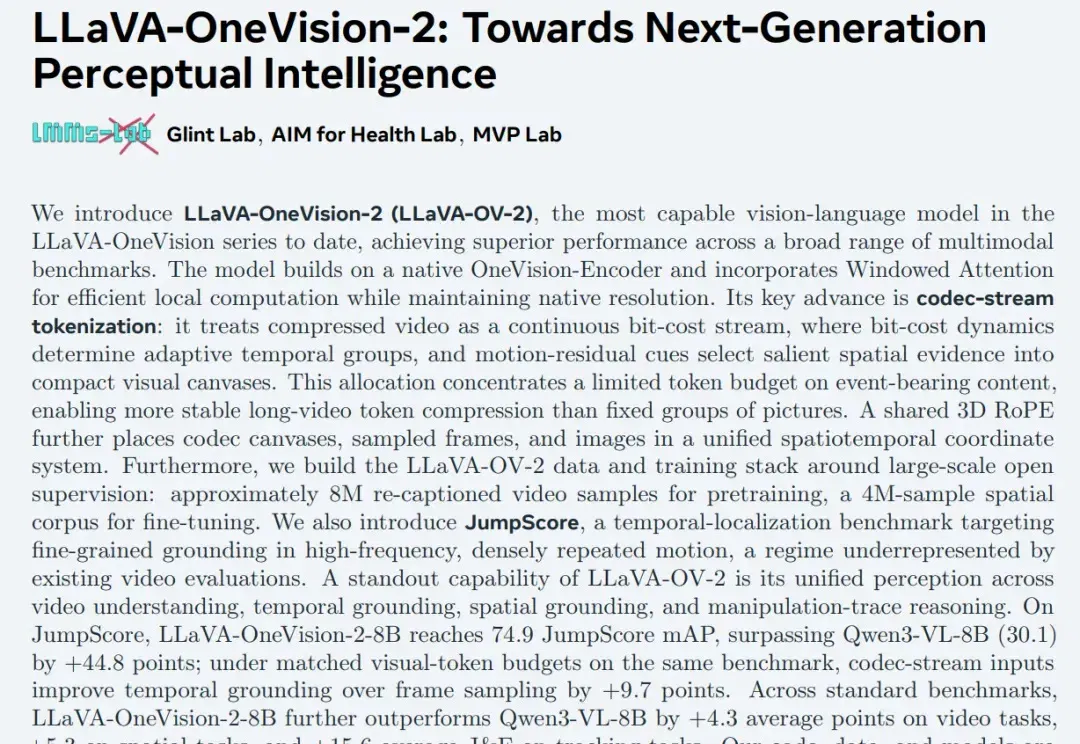
由格灵深瞳灵感实验室主导研发的 LLaVA-OneVision-2.0,是一款面向下一代感知智能的视觉语言大模型。团队充分利用视频 Codec 流和自研 OneVision-Encoder,实现跨帧、跨事件的增量观测和连续证据流建模。本文将详细介绍模型架构、训练方法与能力验证,展示该技术在视频理解、空间推理和目标追踪等任务中的应用潜力。
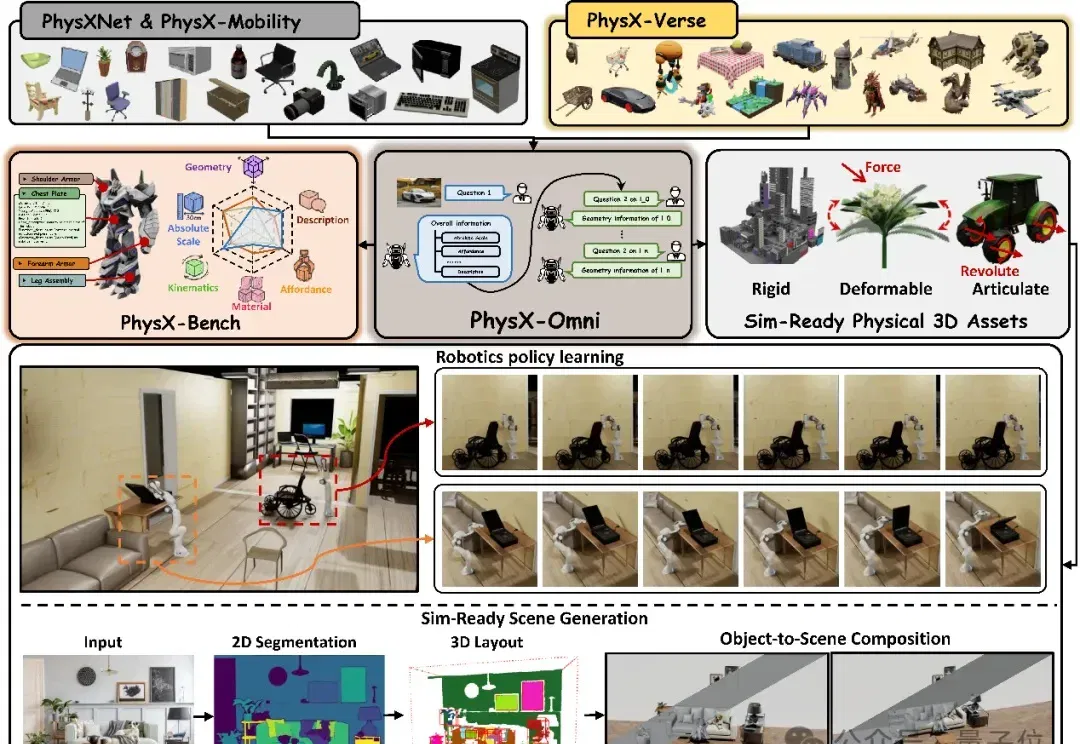
3D生成领域,一个核心矛盾正在浮出水面。
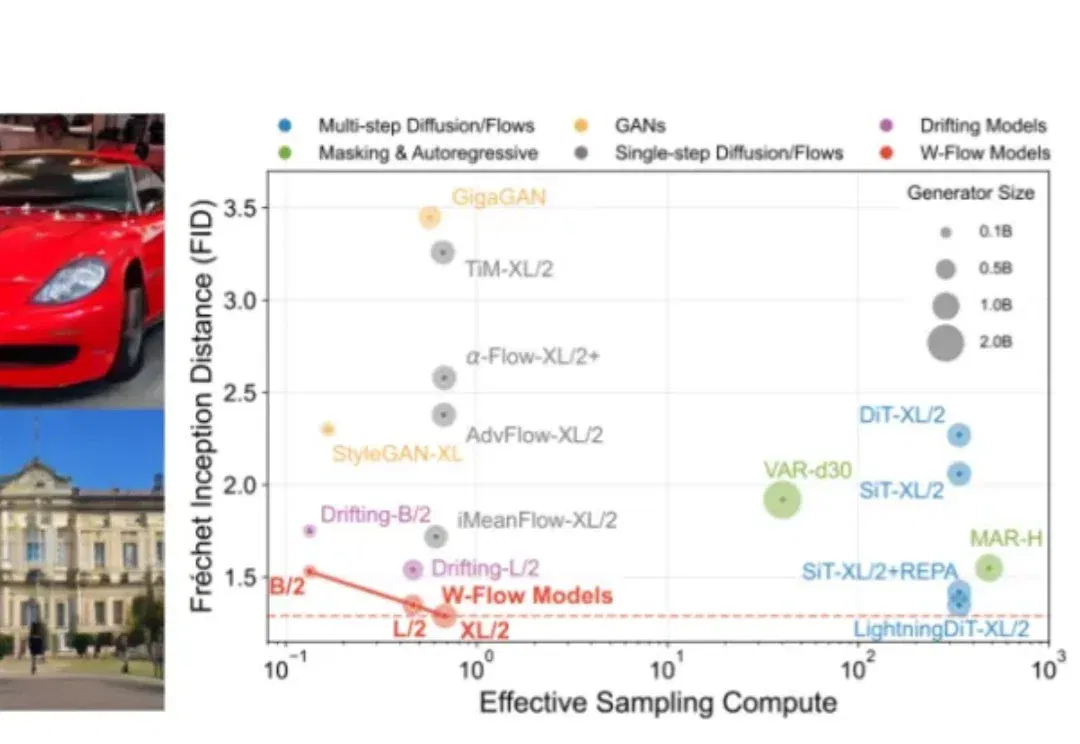
训练时让分布沿最优传输的 “下山方向” 走,推理时只需一次网络前向。W-Flow 把多步演化压进静态生成器,在 ImageNet 256×256 上刷新一步生成指标。
随着大模型智能体深入渗透真实操作系统,一种全新的安全威胁悄然成型:行为越狱(Behavior Jailbreak)。现有安全基准只盯着模型「说了什么」,却对「做了什么」视而不见。新基准LITMUS是首个同时覆盖真实OS环境行为越狱、语义-物理双层验证与多攻击范式的完整评测体系,并首次系统量化了「执行幻觉」这一被整个评测社区忽视的致命盲区。
GitHub最新火爆仓库:OpenSquilla。
参与交流
了解加入交流群的方式,阅读内容无需登录。