终于找到一键做爆款AI短视频的办法了!OiiOii 2.0升级实测【保姆级教程】(在新窗口打开)
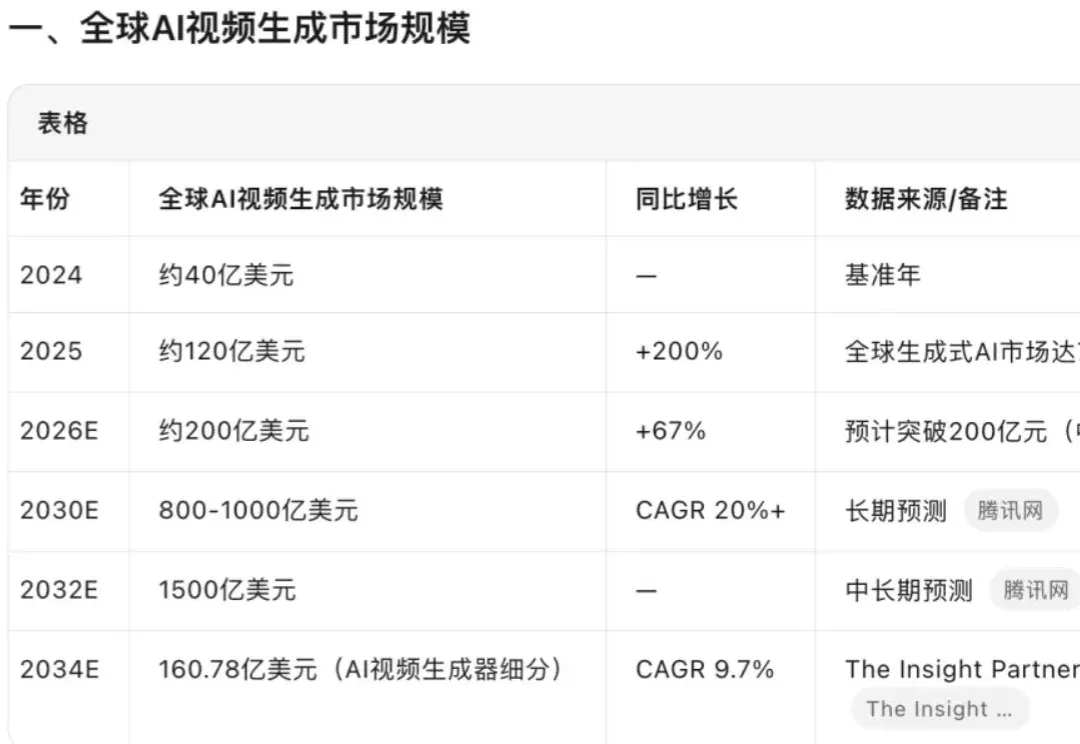
我最近专门调研了一下AI短视频🧐。发现市场规模是越来越大。
内容栏目
分享不同 AI 工具、模型与相关技术的使用方法和实践文章。
我最近专门调研了一下AI短视频🧐。发现市场规模是越来越大。
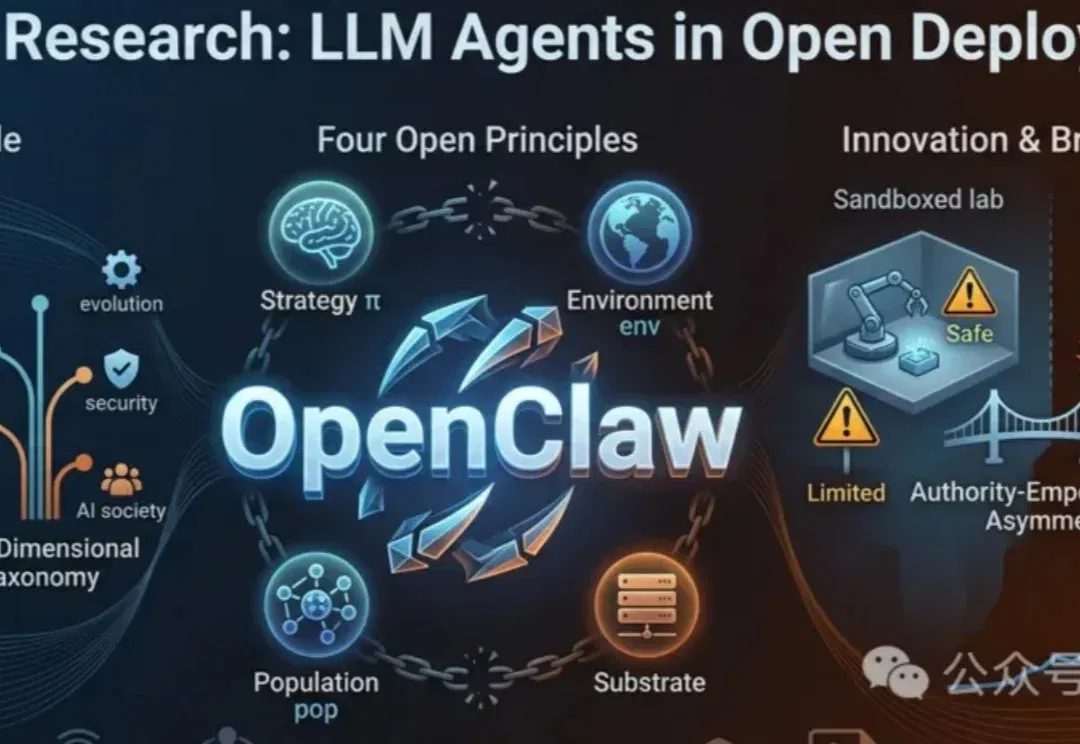
上下文攻击、供应链渗透、AI社区崩溃……当大模型智能体真正进入开放世界,挑战远比想象中复杂。
近日,Anthropic 发布了一篇引发广泛关注的文章《When AI builds itself》。文中披露了极其惊人的内部数据:截至 2026 年 5 月,Anthropic 超过 80% 的合并代码已由 Claude 编写,工程师的日常代码产出飙升了 8 倍;更令人瞩目的是,AI 智能体已经可以自主提出假设、执行长达数百小时的强化安全实验。
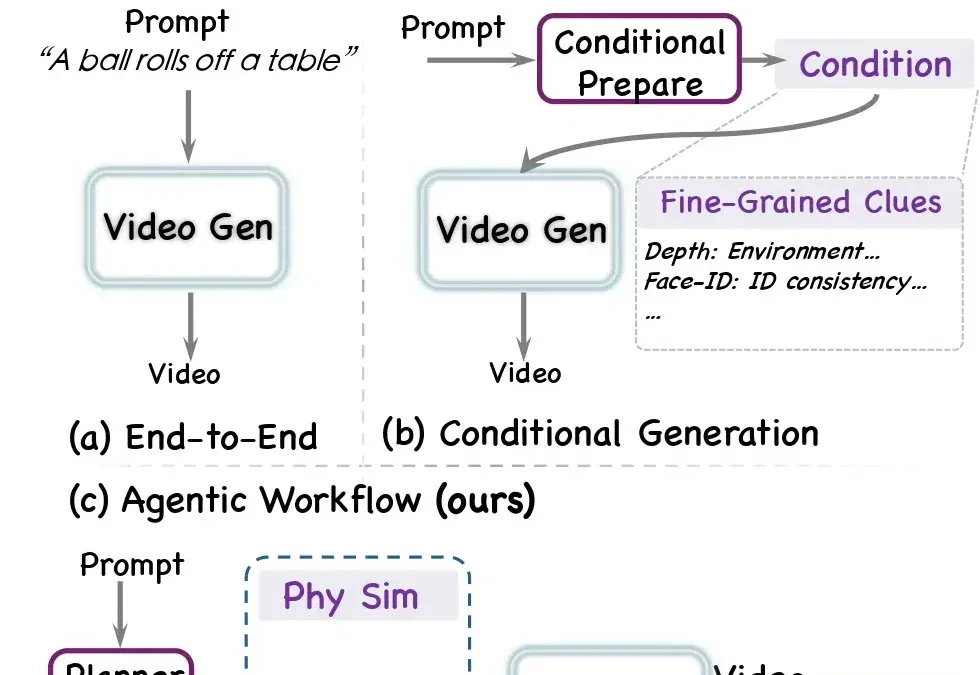
近年来,视频生成模型发展迅猛。从 Sora、Veo、Kling 到一系列开源视频生成模型,文生视频已经逼近真实影像的观感 —— 画面清晰、镜头流畅、风格可控,一句话就能生成一段观感不错的视频。
如果把一个商业化产品、一个科技公司的底层系统比作一棵树,那任意挑出一个项目,层层抽丝剥茧之后,你一定会发现,最早的年轮,一定与开源有关。
想象这样一个惬意的周末: 空调带来阵阵凉意,你靠在沙发上看书,突然耳边传来“哒哒哒”的小碎步声,接着,玄关门边传来了一阵清脆、略带急切的“呜呜”声,还伴随着爪尖轻轻扒拉木门的声响。
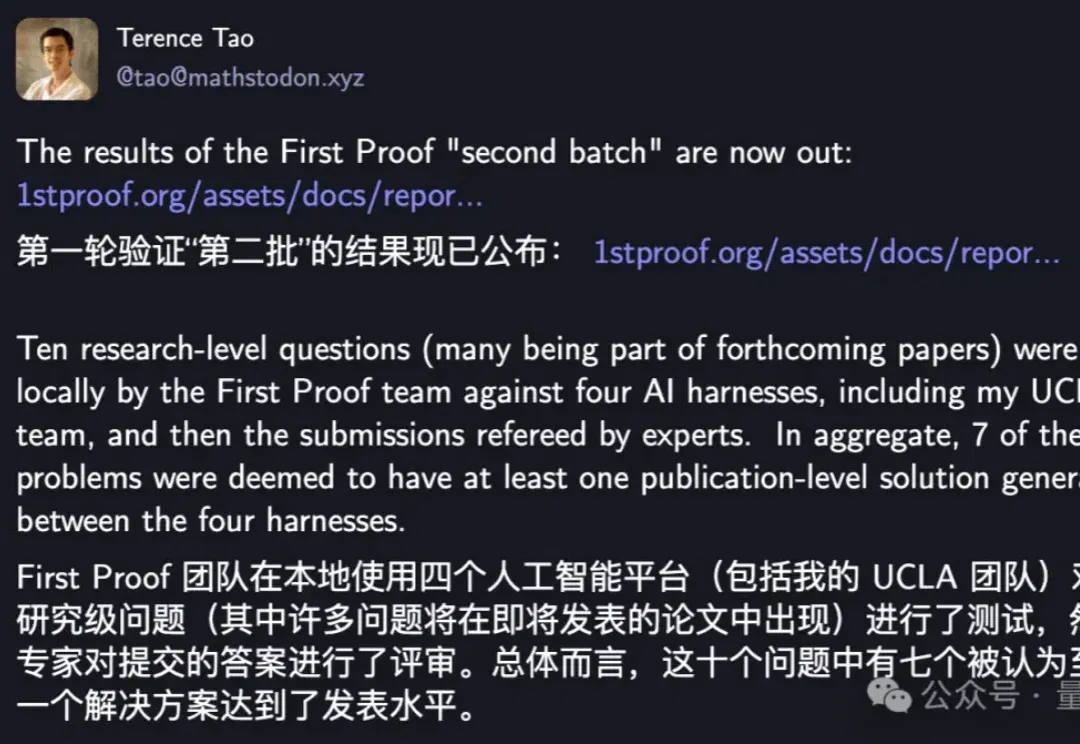
陶哲轩又发成绩单了。 由他主导的First Proof项目第二批评测结果出炉。 本次评测延续了项目核心规则:选取10道从未在网络、期刊上公布过解法的前沿研究级数学新题,交由AI系统作答。 但相比第一次评测,本次测试进一步提高了标准。 评测全程采用专业的双盲同行评议机制,经专家评定,最终有7道题的AI解答达到学术发表标准, 其中,解得最漂亮的Problem 5—— 一道关于随机偏微分方程的问题,AI提出的解法跟人类完全不同,推导得出了比人类解法更强的中间结论。 双盲同行评议 这次的题目是来自数学家真实研究中的新问题。 本次的问题覆盖了可计算理论、离散几何(和经典的莫比乌斯带猜想相关)、离散概率、
这段时间以来,Codex 在社交媒体上是好评如潮。
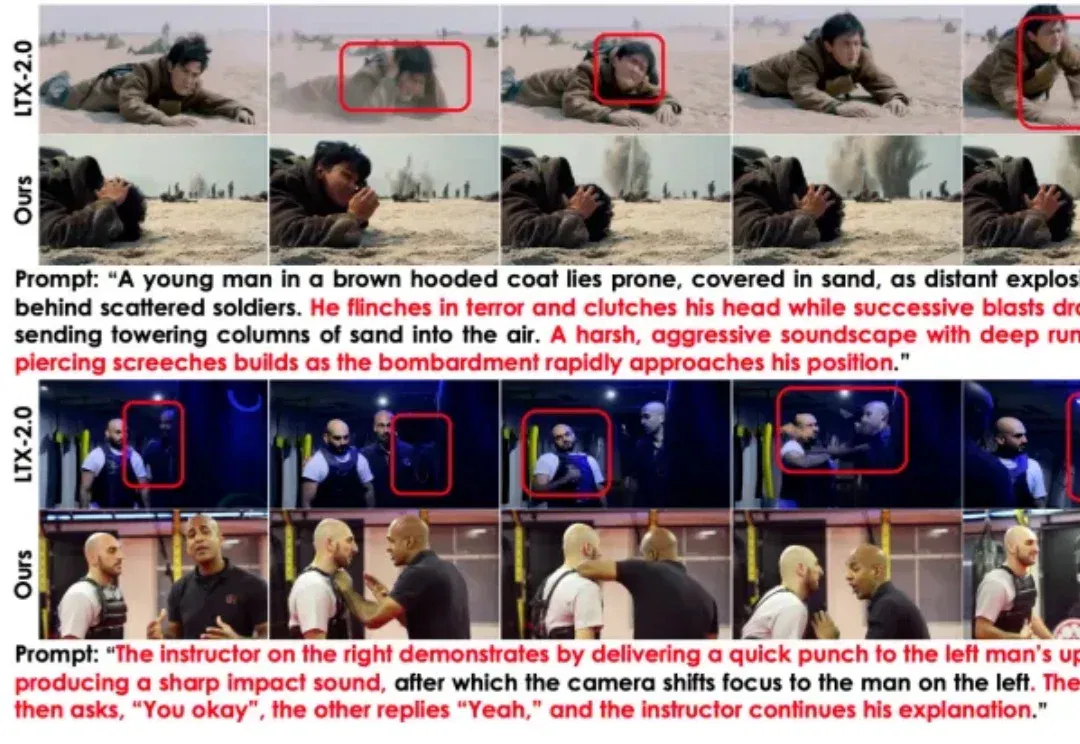
视频生成,早已不止于视觉。 随着生成式AI发展,联合视频—音频生成正成为重要研究方向。与视频优先、音频后期合成的传统流水线相比,原生同步生成的视听内容跨模态一致性更强,用户体验更沉浸。 但问题在于,现有开源模型面对复杂语义时力不从心。 遇到多阶段动作的组合式指令、涉及人与物体交互的复杂任务时,模型往往无法准确建模场景中的时序逻辑和因果关系——不仅要求长程语义推理能力,还必须在推理中维持视频与音频的时空一致性。 核心矛盾在于:现有方法依赖粗粒度全局文本嵌入指导扩散过程,无法将多阶段动作与多说话人对话分解为具有时间对齐的指导信息,视频和音频去噪轨迹因此各自演化,最终跨模态失配。 为解决这一问题,复
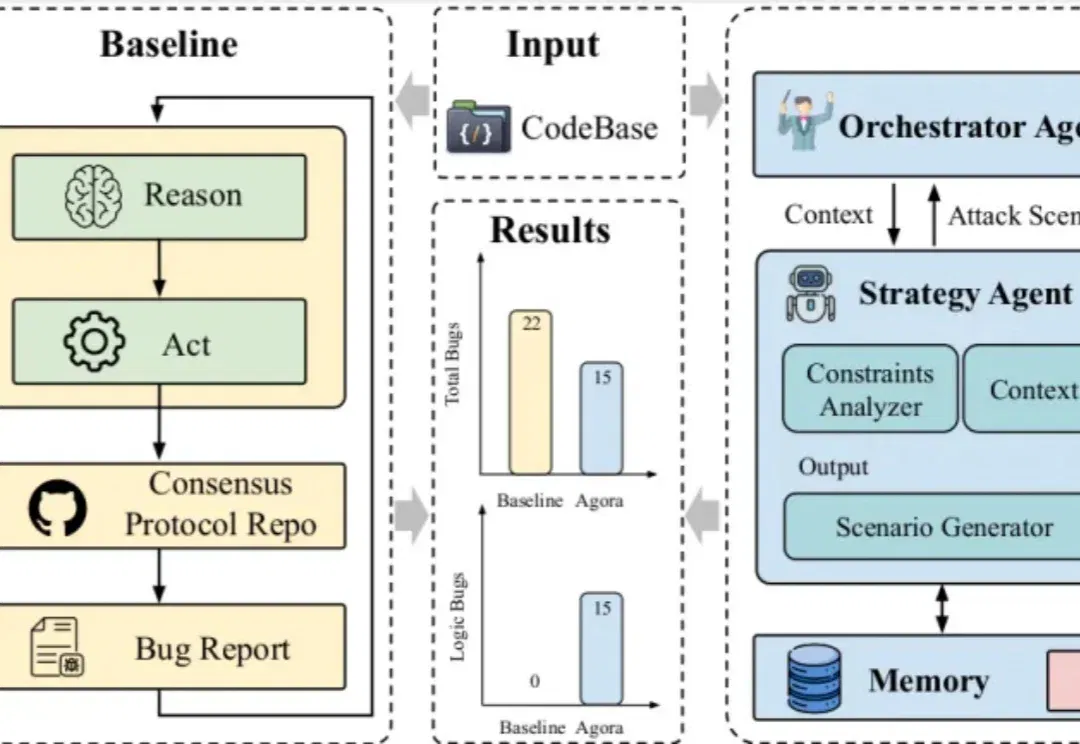
分布式系统的 “圣杯”—— 共识协议(Consensus Protocols),长久以来都是顶级基础设施工程师的 “Bug 地狱”。由于其状态极其复杂、多节点交织,传统测试和单体 LLM 对硬核的 Deep Bug(深层逻辑漏洞)几乎束手无策。
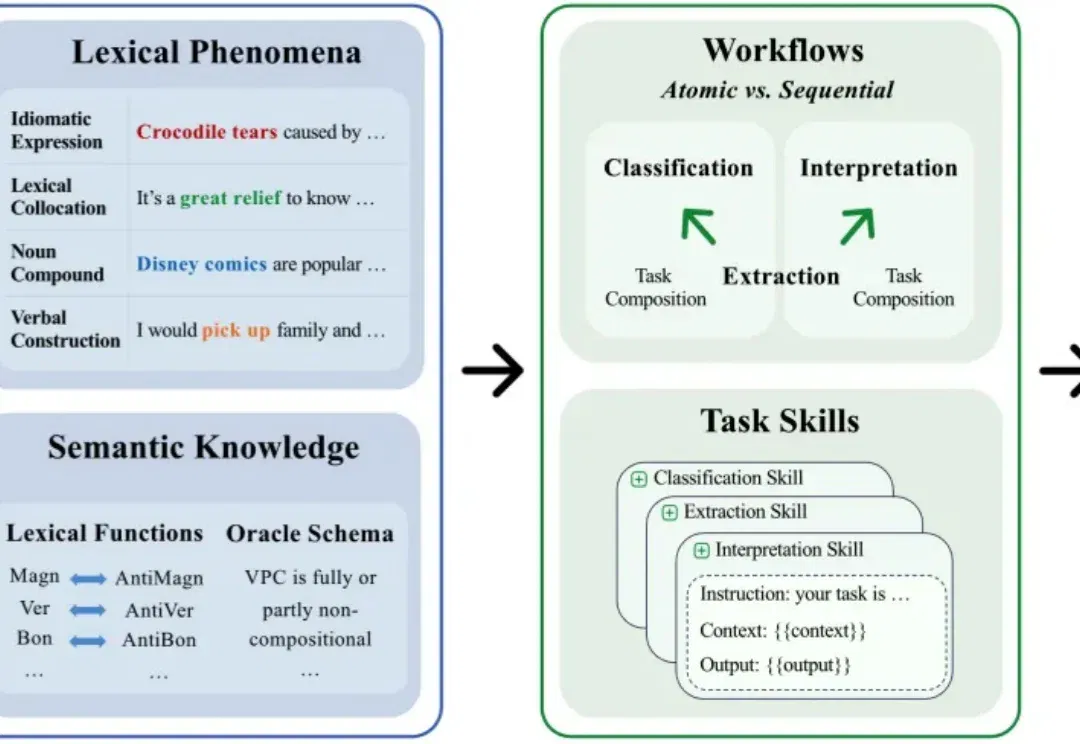
AI 的能力边界正在不断被刷新。从数学推理到代码生成,再到数字化白领,语言模型和语言智能体在诸多基准测试中已展现出超越人类专家的表现。一个看似顺理成章的判断早已成为共识:语言模型已经具备了扎实的语言理解和语义推理能力。然而,ACL 2026 Oral 的一项研究工作从一个更基础的层面重新审视了这个问题:语言模型真的理解(短语)语义吗?
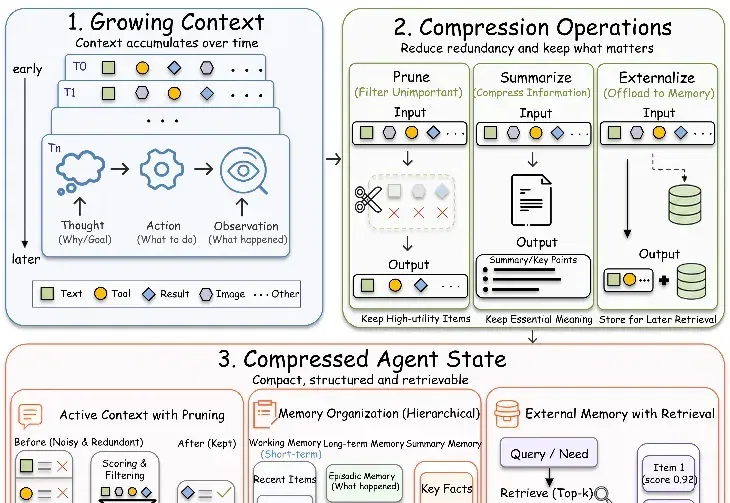
LLM Agent 做长任务时,真正让人头疼的往往不是模型不会推理,而是上下文开始失控:前几步还很清楚,后面就忘约束、丢状态、重复试错,最后把任务跑成事故现场。
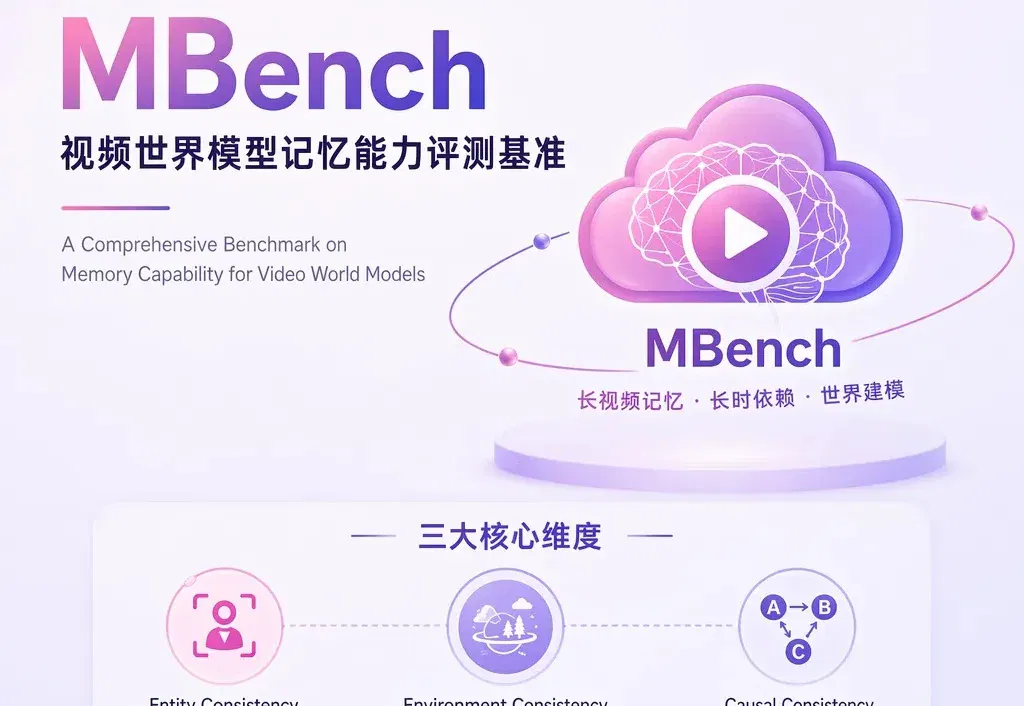
随着视频生成技术的发展,模型正在从短视频片段合成,向流式长视频生成演进。然而,仅仅做到视觉上的逼真是不够的。一个功能完备的视频世界模型,必须能够在长时序交互中保持稳定的内部状态,并遵循真实世界的物理定律与逻辑规则。
过去一年,开源模型的发布节奏已经快到让人麻木。每次发布,伴随的永远是一组跑分、一张能力雷达图,以及几个“超越某某”的结论。
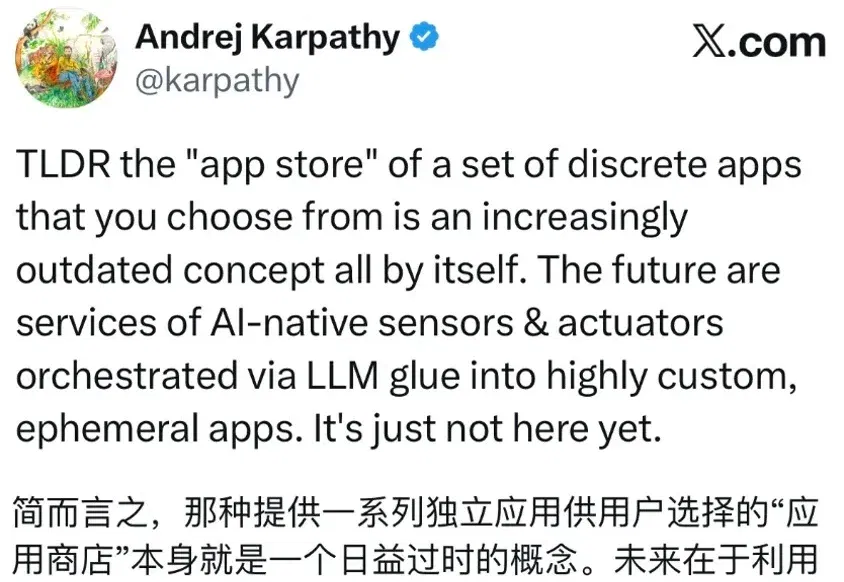
想象一下,你问 AI 要一个饮食记录工具,它不再是回你一段文字建议,而是直接给你一个可以点击添加、统计热量的完整应用。人和 AI 的交互,正在从「读文字」走向「用应用」。
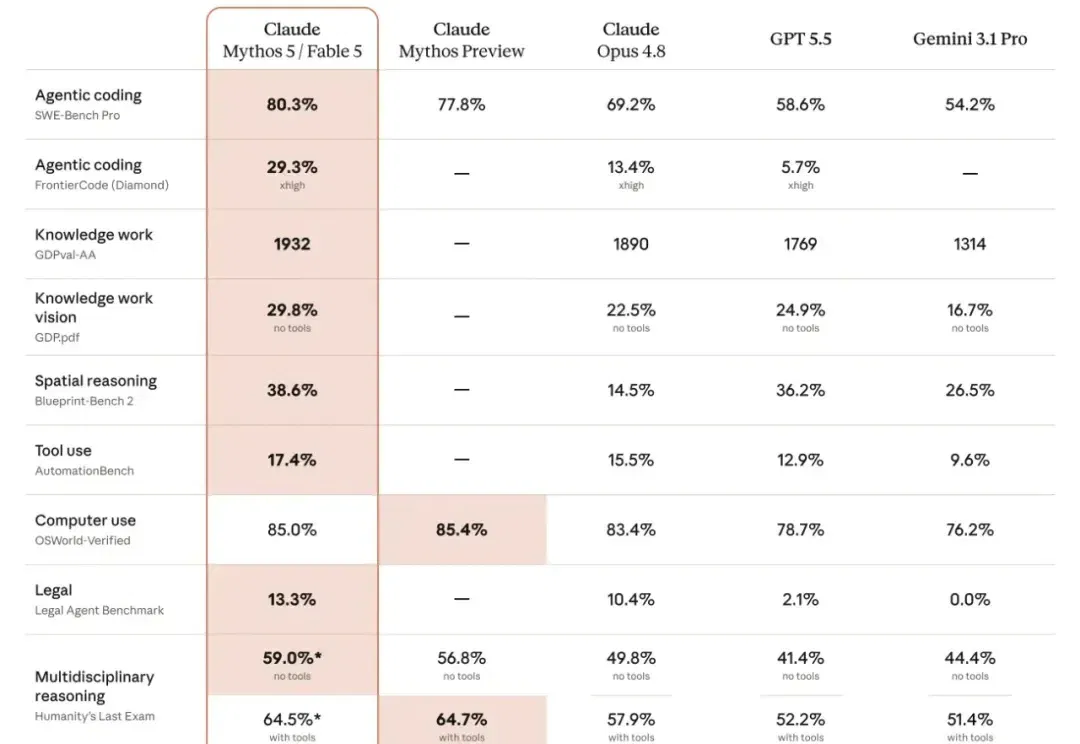
今天凌晨,Anthropic 发布新模型 Fable 5,毫无疑问的,也是当下的最强模型
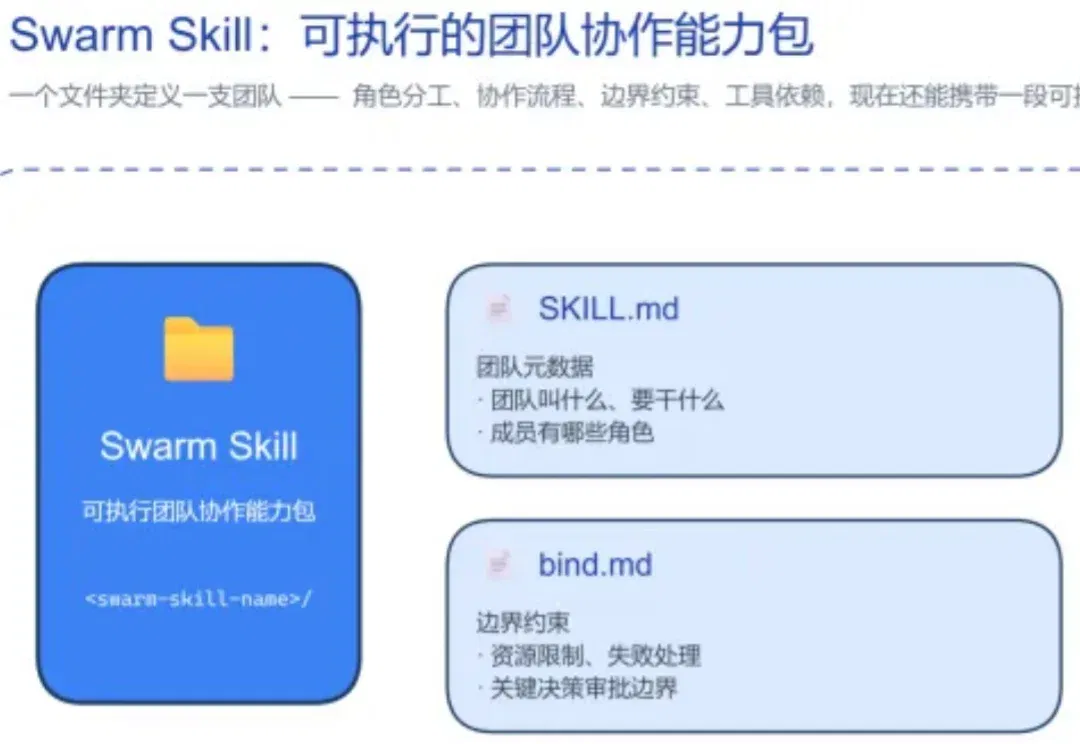
AI Agent 正在从 "单兵作战" 走向 "团队协作"—— 让多个 Agent 分工配合,去完成单个 Agent 难以独立扛下来的复杂任务,也是近期最受关注的方向之一。
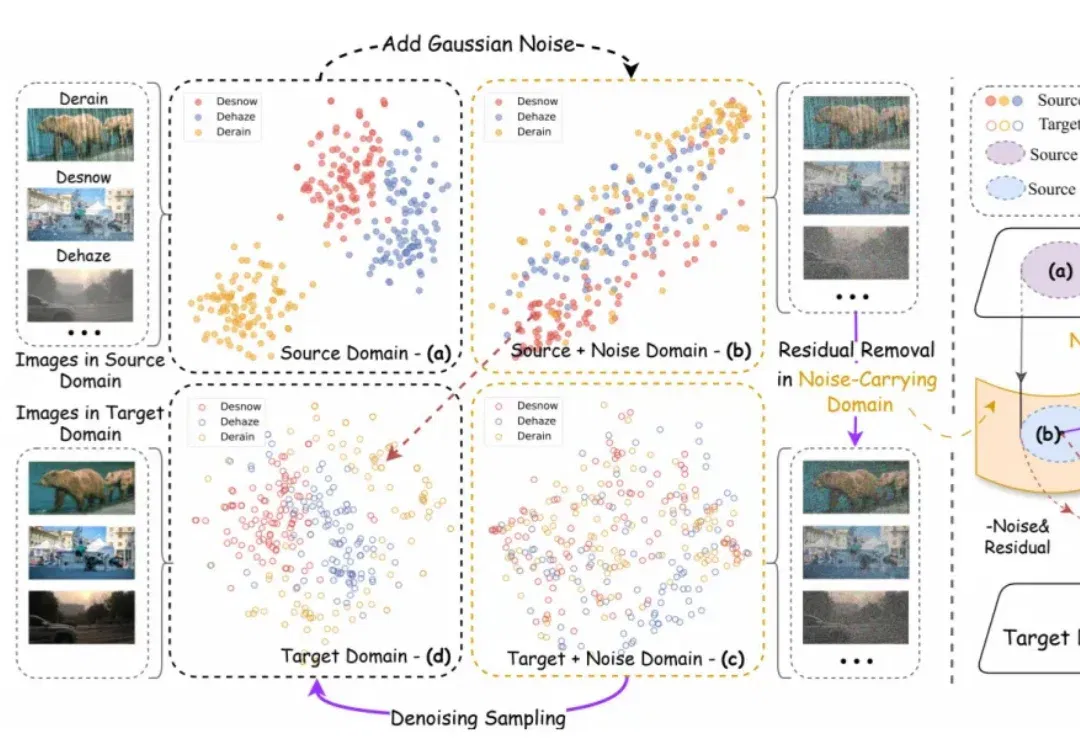
在图像到图像翻译(Image-to-Image Translation, I2I)这个任务上,扩散模型过去几年几乎形成了一套默认逻辑:先把输入图像和噪声混合,再一步步去噪,把目标图像 “还原” 出来。
具身智能现在面临的问题,和自动驾驶几年前的困境非常相似。
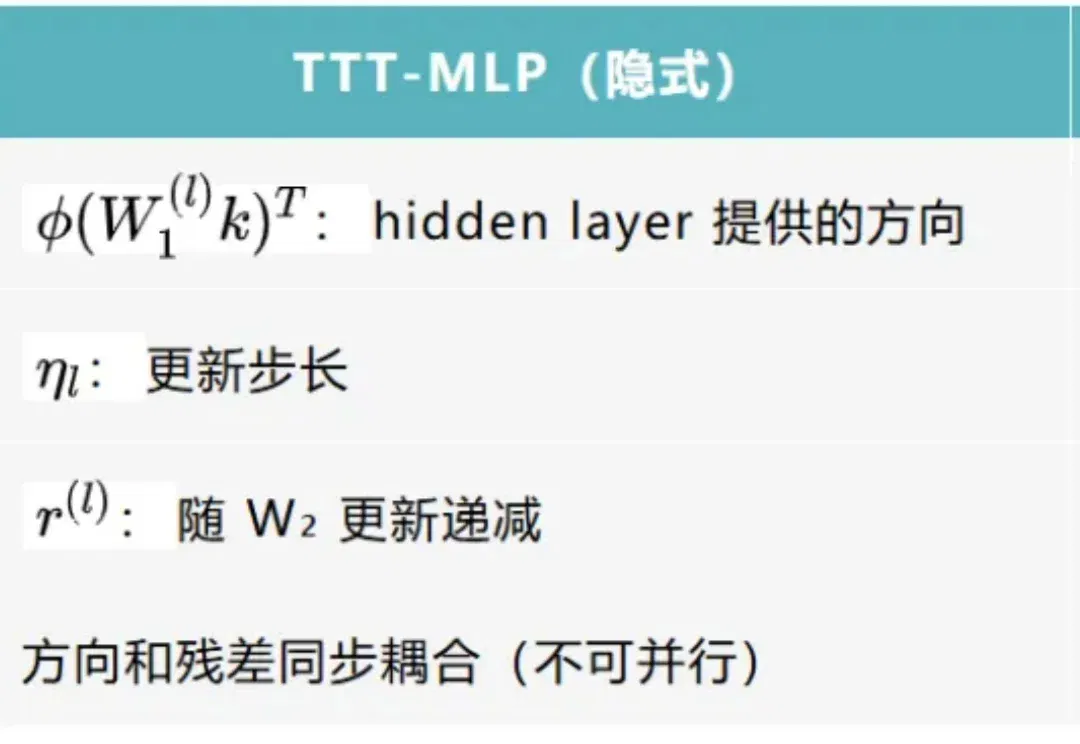
Transformer 依托强大的建模能力和 Scaling 效率在推荐领域被广泛应用于超长序列建模和生成式推荐等方向,
参与交流
了解加入交流群的方式,阅读内容无需登录。