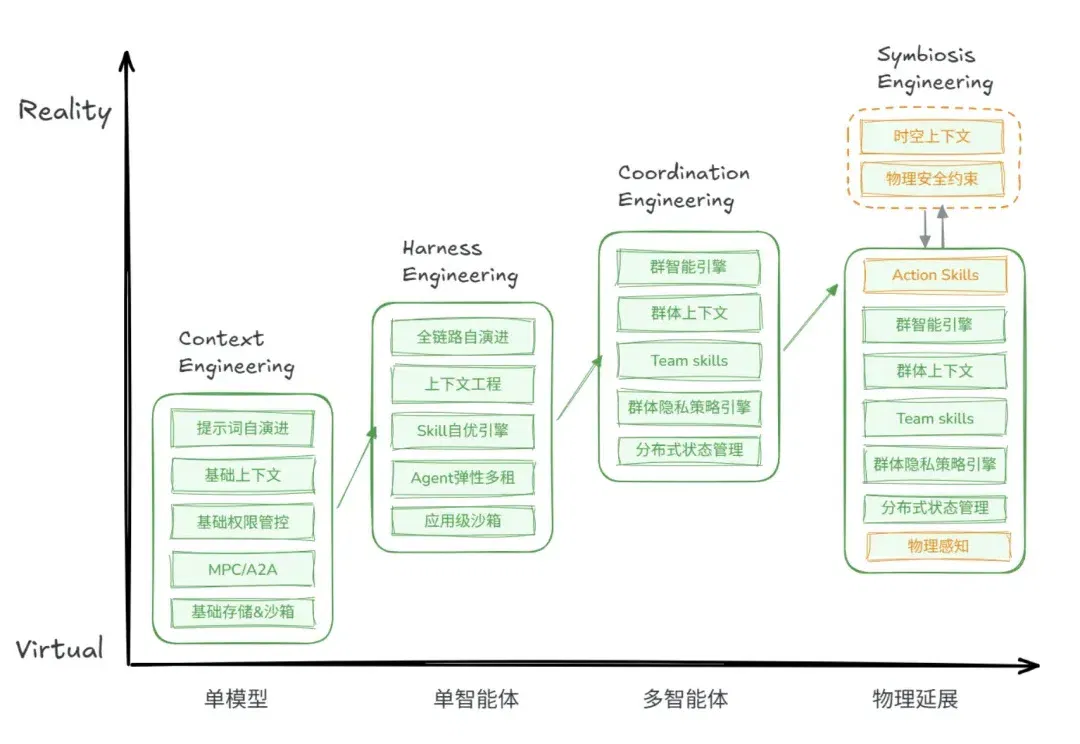
Agent终于长出了身体:Jiuwen Symbiosis背后的思考与实践(在新窗口打开)
如果你在三年前问AI圈:未来最强的AI长什么样?
内容栏目
分享不同 AI 工具、模型与相关技术的使用方法和实践文章。
如果你在三年前问AI圈:未来最强的AI长什么样?
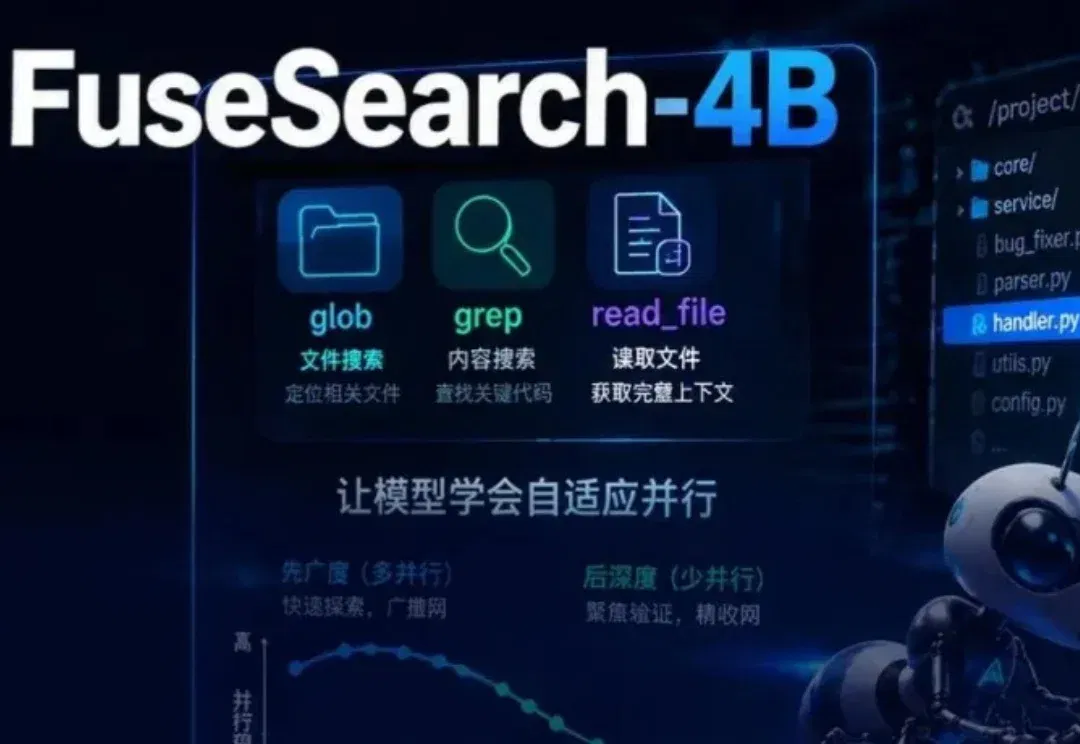
新智元报道 【新智元导读】FuseSearch:学习型自适应并行执行 —— 一个40亿参数的模型,凭什么在代码定位上干过了商用闭源大模型?答案只有四个字:搜得更聪明。 在AI编程狂飙突进的今天,一个尴
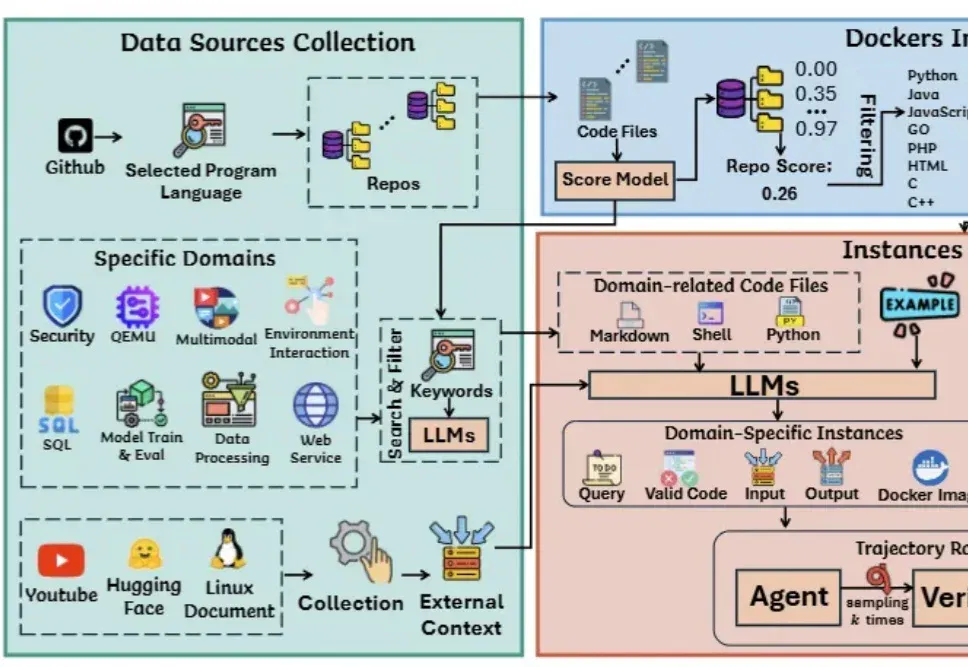
被ICML 2026接收为Spotlight!
Workflow、Skill、SOP,可能真的要过时了。
好家伙,这次不是模型圈自嗨。 一个训练成本约1500美元、参数量约1B、从零开始预训练的小模型,把HRM推到了下一代推理架构讨论的中心。 HuggingFace联合创始人兼CEO Clem Delangue亲自转发推荐。 图灵奖得主Yoshua Bengio作为共同作者参与的新论文,也走向了同一条latent recursive reasoning路线。 更反常的是,它不是蒸馏,不是微调,也不是在已有大模型能力上套壳。 它就是Sapient Intelligence发布的HRM-Text。 如果只看参数量,它很容易被写成一个熟悉的故事:“小模型又赢了。” 但HRM-Text真正值得注意的地方,
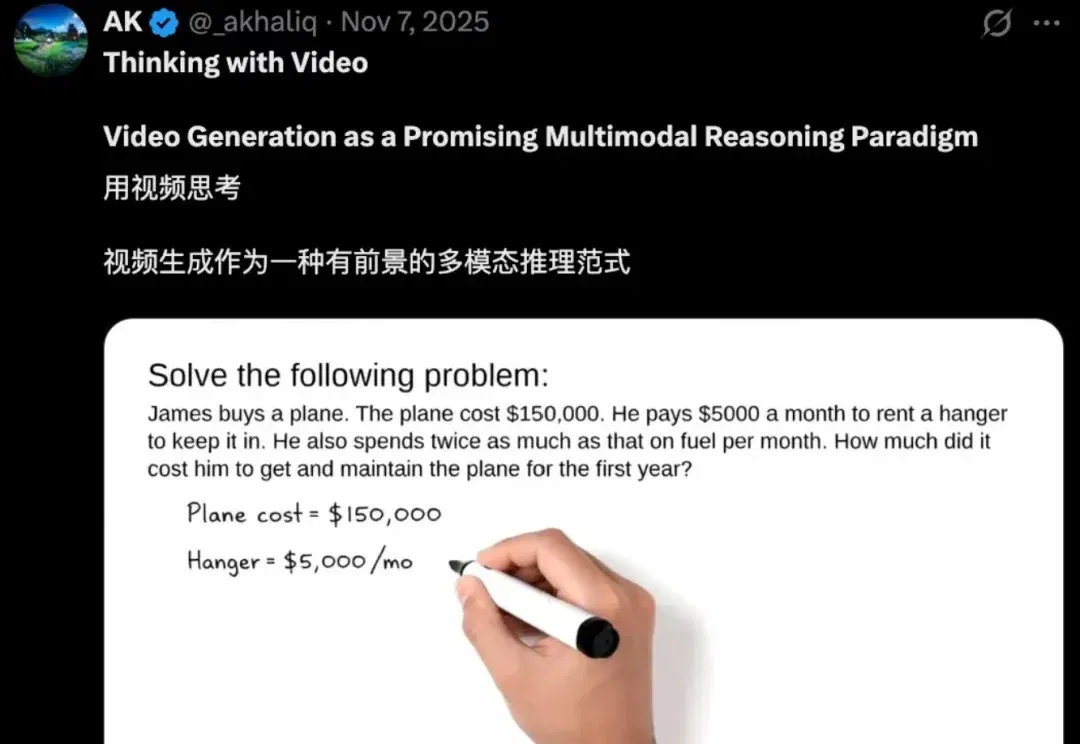
被CVPR 2026收录! 复旦邱锡鹏团队(OpenMOSS)首次提出Thinking with Video这一推理新范式: 借助视频生成模型,以视频帧为统一媒介进行多模态推理,打破视觉与文本的界限。 团队发现,Thinking with Text(基于文本的CoT推理)和Thinking with Images(在CoT中加上图像辅助推理)范式已大幅提升了LLMs和VLMs的推理能力。 但它们仍有局限:静态图像无法展现动态过程,文本与视觉模态的割裂阻碍了统一理解与生成。 而借助新范式Thinking with Video,视频生成模型在视觉任务上不仅总体媲美SOTA VLMs,而且竟也能解决
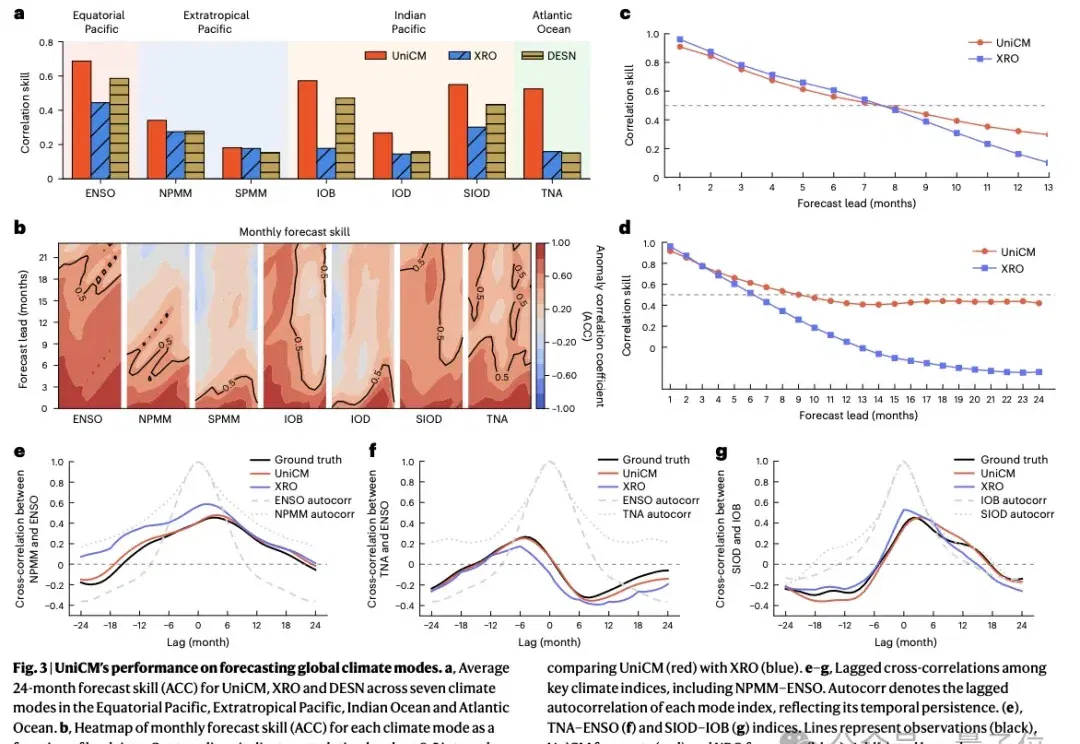
全球气候异常事件正在深刻影响农业生产、水资源调度、能源管理和防灾减灾。
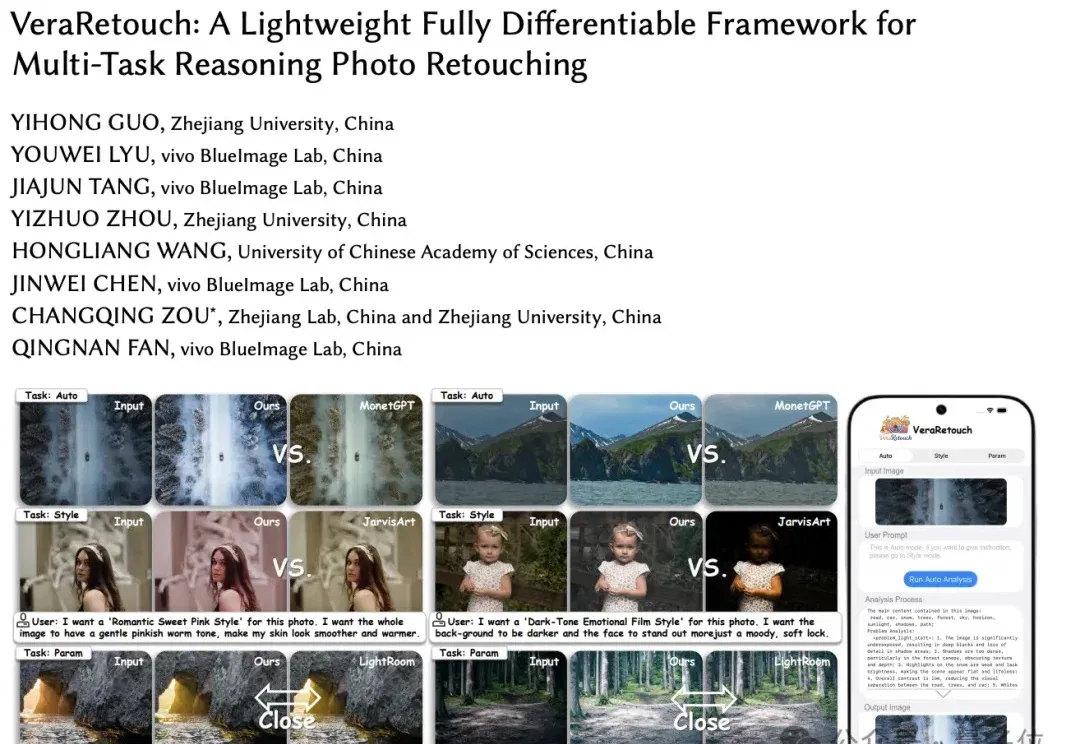
如今手机拍照已成日常,后期修图是提升照片质感的关键。
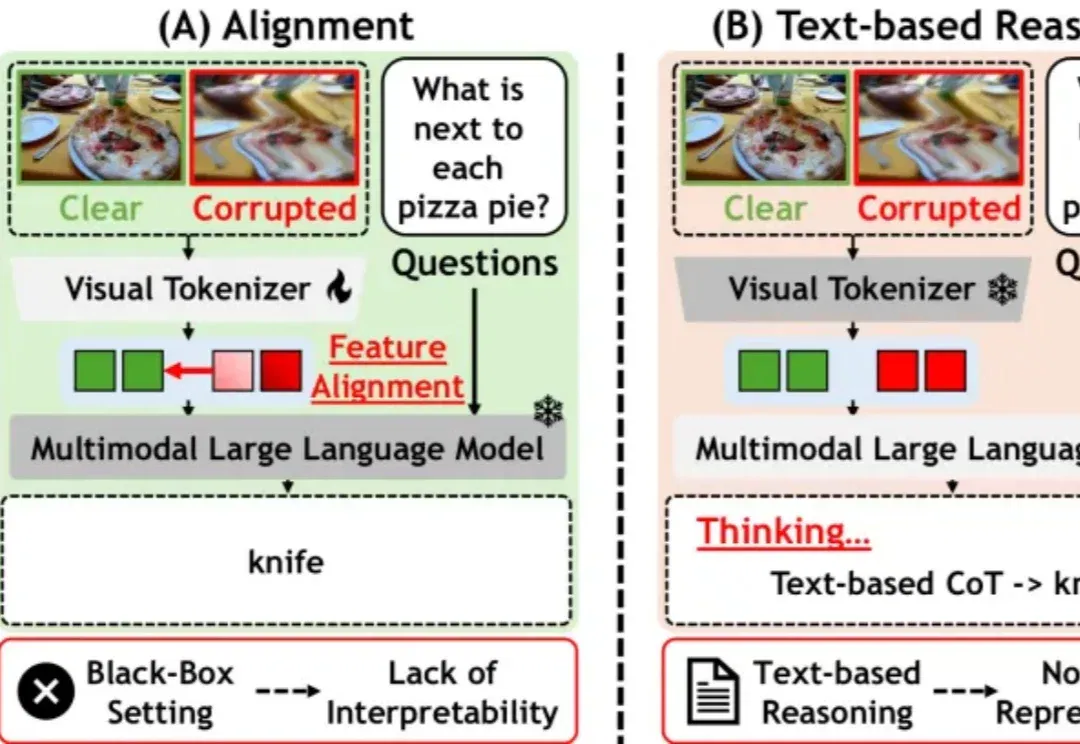
雨雪、雾霾、镜头噪点、压缩失真、夜间弱光……
多模态大模型越来越会读图中文字,但最新研究显示,「读得出来」并不等于「防得住」。西湖大学 AGI Lab 的研究团队发现,当有害文本被渲染成低清、模糊或带噪图片后,模型在一个特定清晰度区间内反而更容易被越狱。
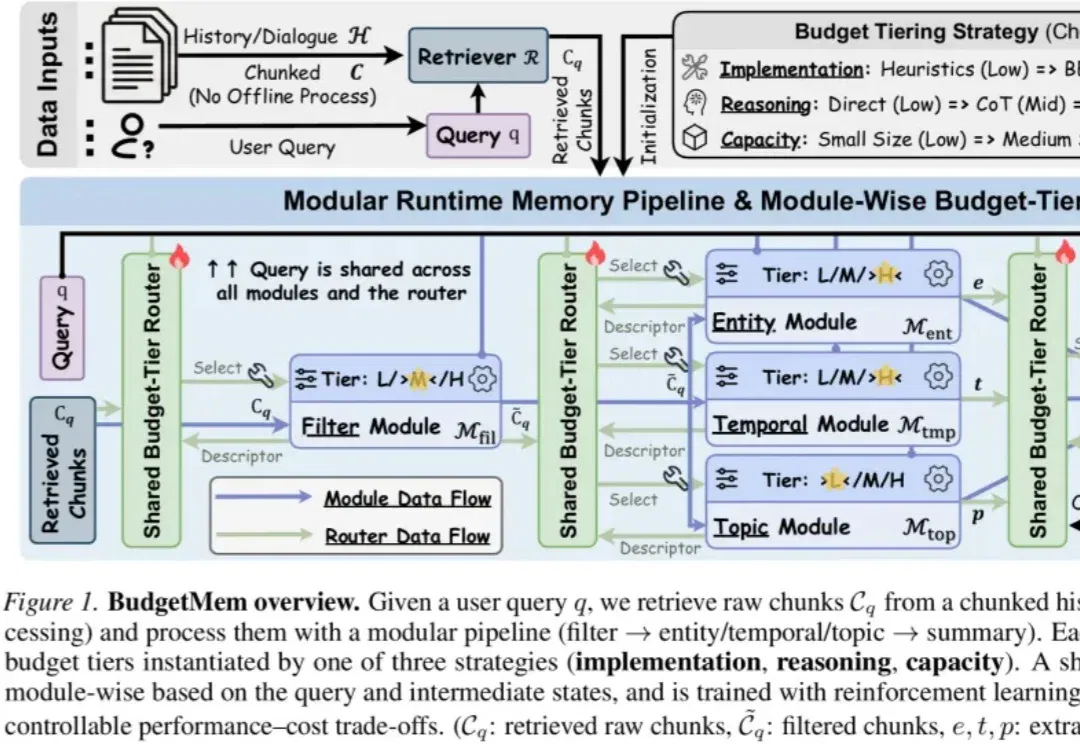
当 LLM Agent 处理长期对话、多轮交互和复杂文档时,Memory 已经成为不可或缺的核心模块。它帮助智能体保存历史、检索信息、维持个性化上下文,并支撑跨时间的推理能力。
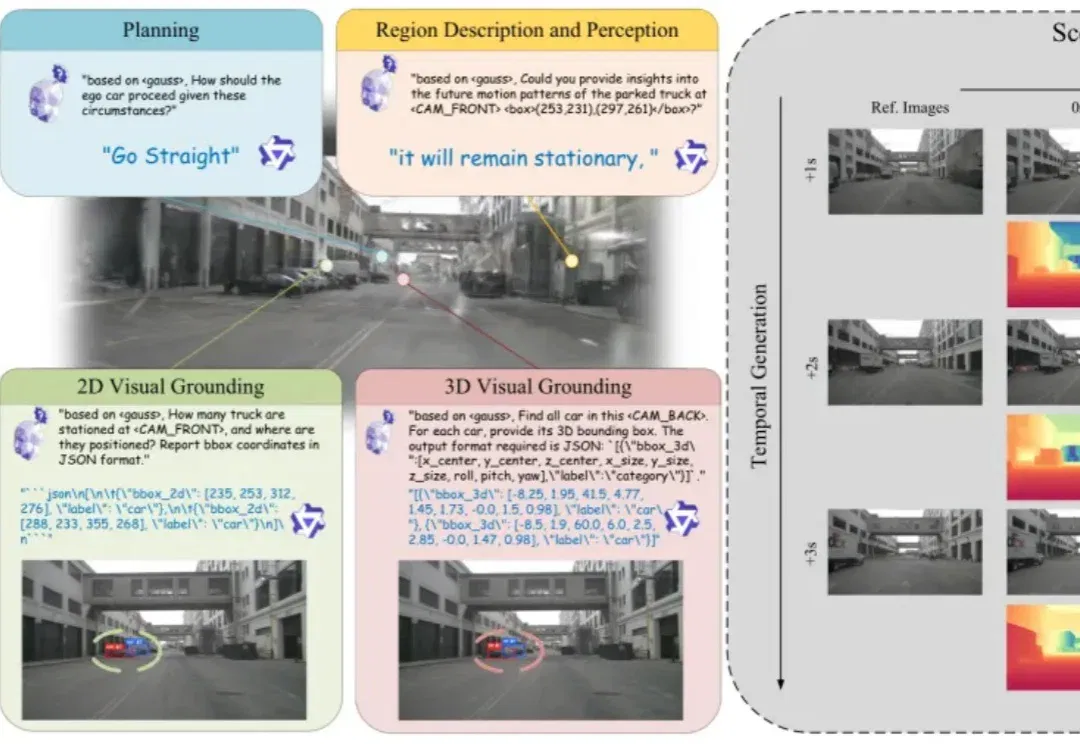
自动驾驶世界模型的研究目标已经从单纯预测未来视觉帧,扩展到构建可用于场景理解、空间定位和后续决策的世界表示。如果模型只能生成外观上合理的未来图像,却无法回答场景中有哪些目标、目标位于何处,以及不同视角下的空间结构如何变化,那么它仍然缺少对三维驾驶环境的显式建模能力。
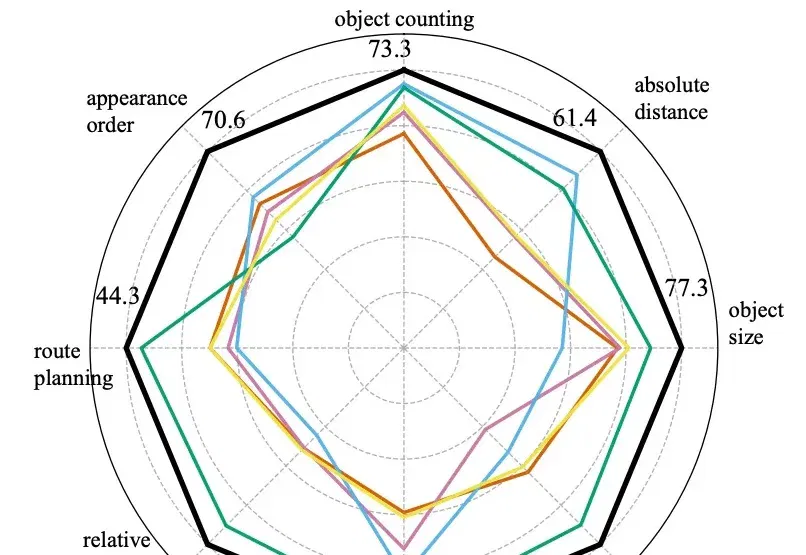
大模型已经能流畅对话、看图识物,但一个更底层的问题始终没被真正解决——它们是否「理解」了我们所处的三维世界?
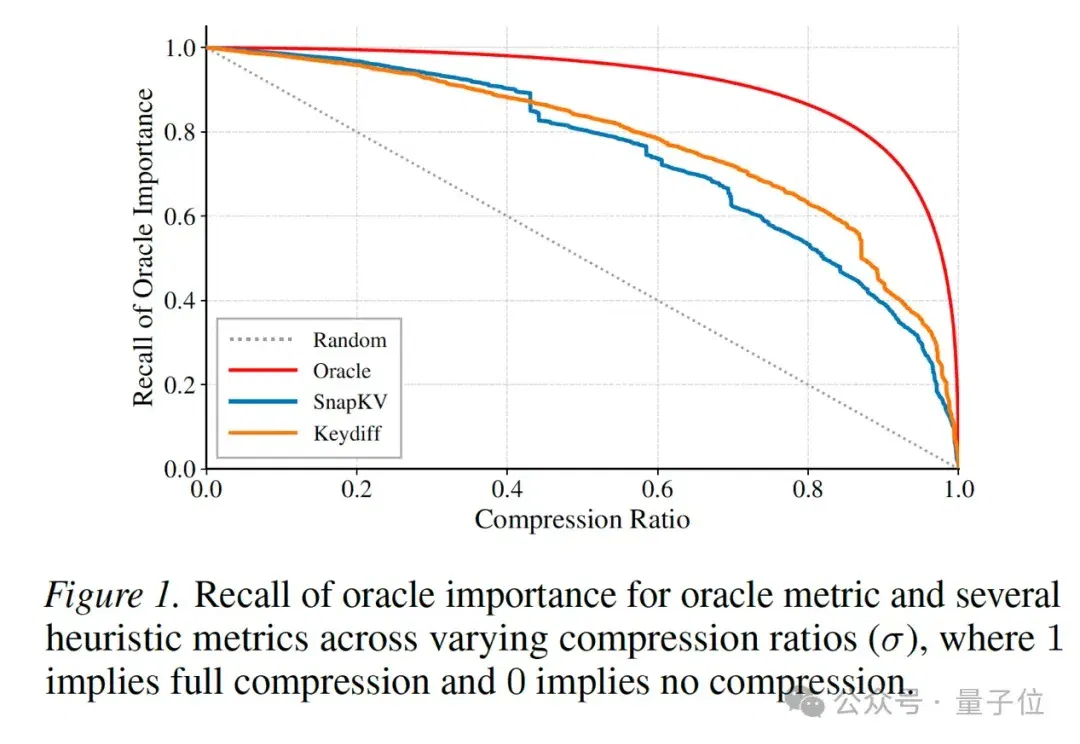
随着AI Coding、Agent、Deep Research 等应用快速普及,模型单次处理的上下文长度正在从几万Token迈向几十万甚至百万Token。
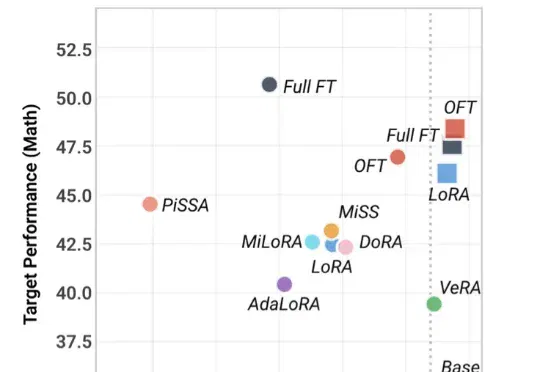
近期,来自香港中文大学、西湖大学、德国马普所等机构的研究者提出了 PEFT-Arena —— 一个从稳定性‑可塑性权衡(stability–plasticity trade-off)视角重新审视 PEFT 方法的评测基准与分析框架。该工作已在 ICLR 2026 相关 workshop 上进行了展示,并开源了完整代码。
谷歌DeepMind宣布:AGI,已经过时了!就在最近,谷歌DeepMind出了一份干货满满的57页报告,标题只有四个词:《从AGI到ASI》。论文地址:https://arxiv.org/abs/2606.12683
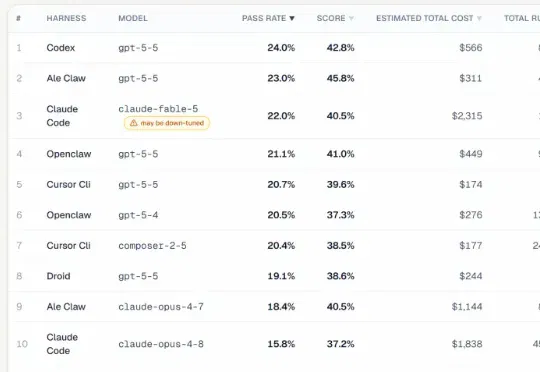
刚刚,UC伯克利放出了一场号称“智能体最后的考试”的全新基准测试。它把当今最强的AI Agent们拉到考场上,让它们干真正的活——在Siemens NX里建3D模型、在Unreal Engine里搭游戏场景、在Adobe After Effects里做特效合成。
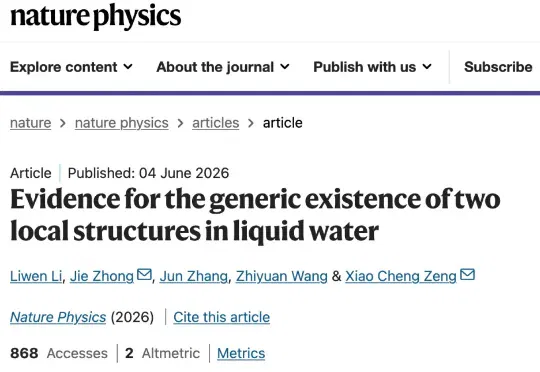
香港城市大学曾晓成教授与中国石油大学(华东)钟杰教授团队给出了终结级的分子水平证据,成果发表于《Nature Physics》。他们首创了一套无监督深度学习框架,不给AI任何预设条件,直接把海量水系统中7400多万个水分子结构扔给模型,让AI自己去悟。结果不仅直接证明常压水里确实存在两种「暗」组份,还把A/B水分子相互变身的「立交桥」路线图给完整画了出来。
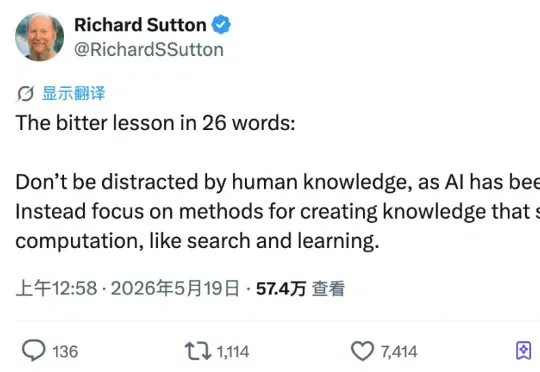
硅谷 AI 圈又来了个新词:Loop Engineering。 大佬们纷纷表态,别再手动验证和写提示词了,该让 Agent 自己循环完成工作了。 OpenClaw 开发者 Peter Steinberger 带火了这个讨论,Claude Code 负责人 Boris Cherny 也说他已经不怎么在 Claude Code 里输入提示词了,而是去写 loops。
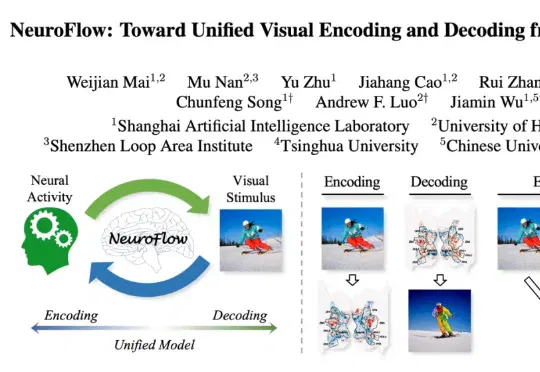
来自上海人工智能实验室、香港大学、香港中文大学等机构的研究团队,提出首个基于统一神经流模型的视觉-神经双向建模框架NeuroFlow,相关成果入选 CVPR 2026。它首次将视觉编码(写脑)与解码(读脑)整合到同一可逆流结构中,打通视觉感知与神经活动之间的双向通路,为理解人类视觉认知机制、构建下一代通用视觉假体与双向脑机接口提供了全新范式。
参与交流
了解加入交流群的方式,阅读内容无需登录。