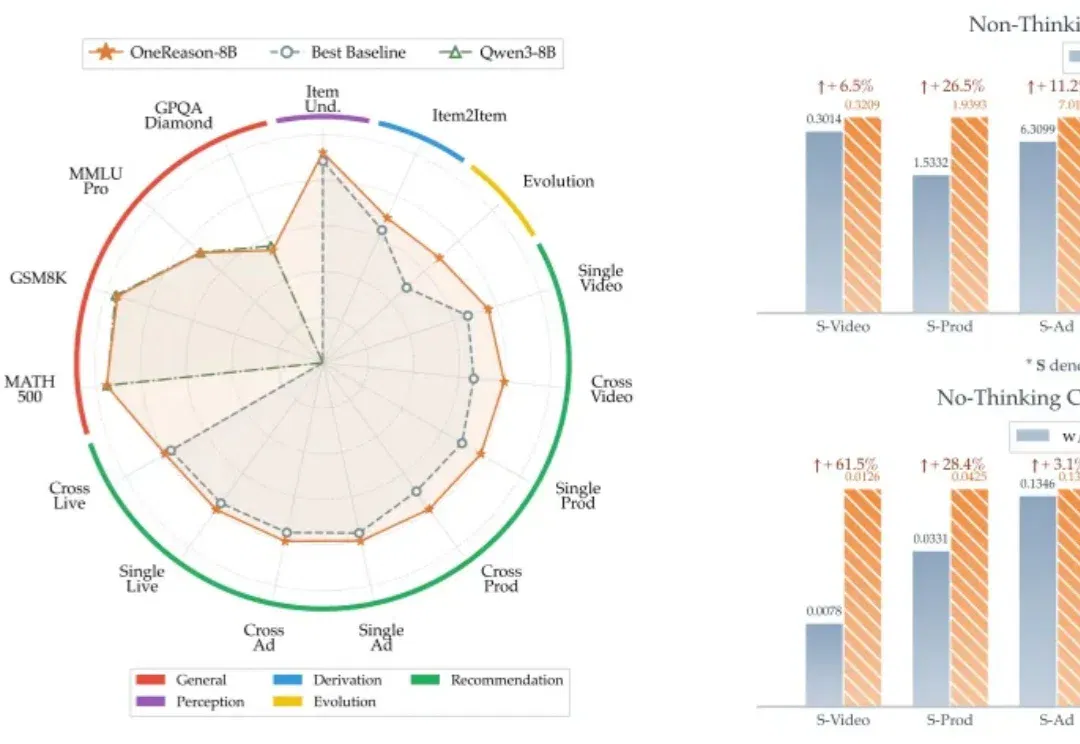
OneReason:当推荐系统学会思考(在新窗口打开)
推荐系统的过去十年,本质是把 "用户 - 物料" 的统计共现挖到极致 —— 从协同过滤、深度模型,到生成式 OneRec 系列,每一代都在让 "记忆" 更精细、参数更大、序列更长,也让 Scaling 这件事在工业级推荐系统上跑通,持续释放算力红利。
内容栏目
分享不同 AI 工具、模型与相关技术的使用方法和实践文章。
推荐系统的过去十年,本质是把 "用户 - 物料" 的统计共现挖到极致 —— 从协同过滤、深度模型,到生成式 OneRec 系列,每一代都在让 "记忆" 更精细、参数更大、序列更长,也让 Scaling 这件事在工业级推荐系统上跑通,持续释放算力红利。
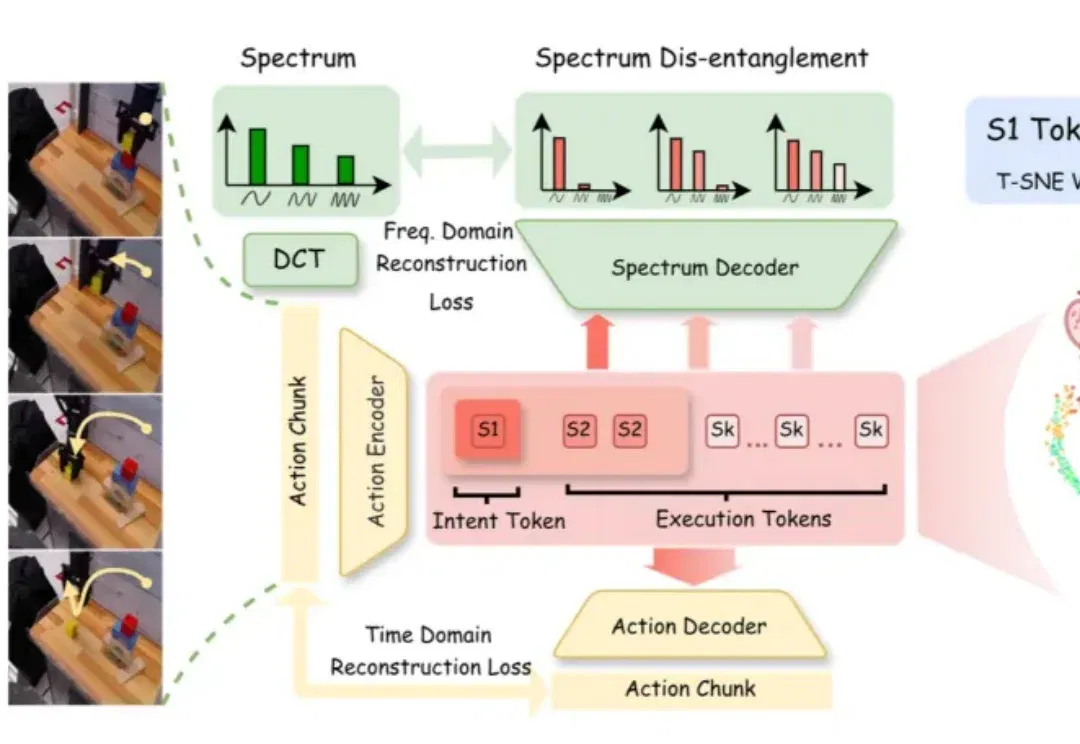
机器人视觉语言动作(Vision-Language-Action, VLA)模型越来越多地开始展示叠衣服、倒茶、做咖啡等复杂操作。但是,今天的大多数 VLA 更像 “展台机器人”。
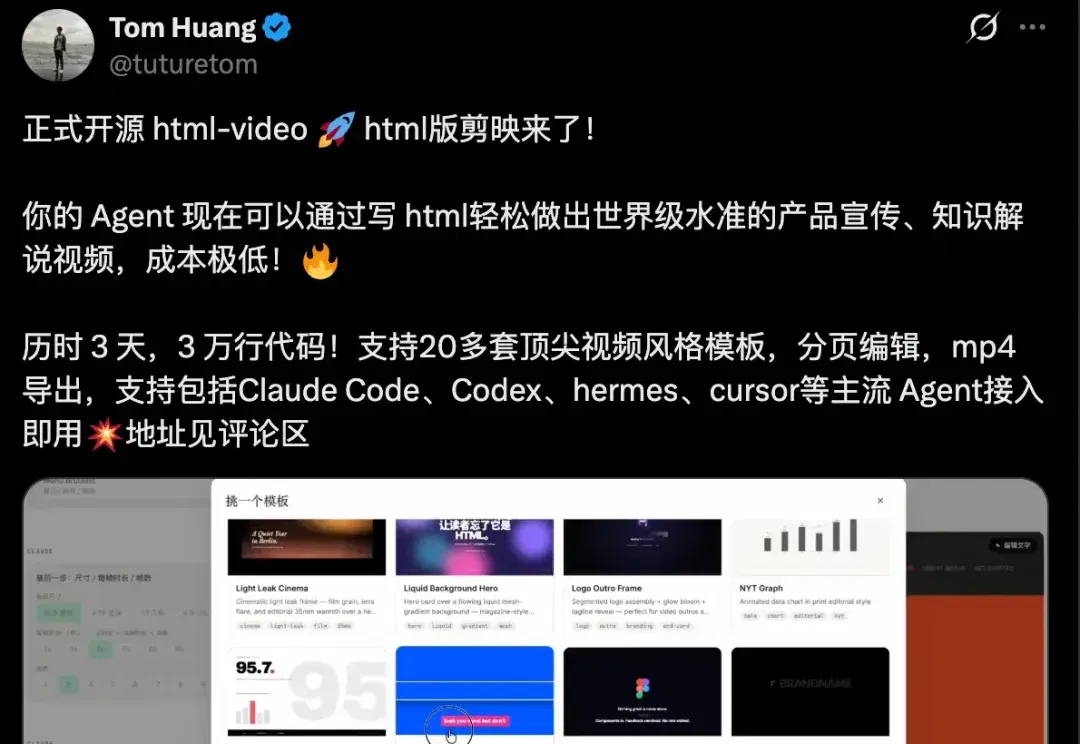
视频制作行业正在经历一场革命。 过去,要做出一支像样的产品宣传视频或者知识解说视频,你需要专业的剪辑师、动画师、配音员,可能还要花几万块钱找外包团队。 即使是小团队自己做,也得精通AE、Pr这些复杂的工具,光学习成本就高得吓人。 而且,这一切成本和门槛都还是建立在人工操作的基础上的。 就在这个时候,Open Design 团队干了一件大事。他们用了3天时间,写了3万行代码,把视频制作这件事彻底改写了,而且照样是开源的。 现在,你只需跟你的 AI Agent 说句话,或者粘贴一个公众号文章链接,它就能直接给你生成一支动态的 MP4 视频。而且,这个过程完全在你本机上运行,没有云端渲染费用,也不绑
过去两年,大模型写代码已经不再新鲜。从代码补全到 GitHub issue 修复,从竞赛编程到仓库级软件工程,人们习惯用一个简单标准评估 coding agent:代码能不能写对?测试能不能通过?
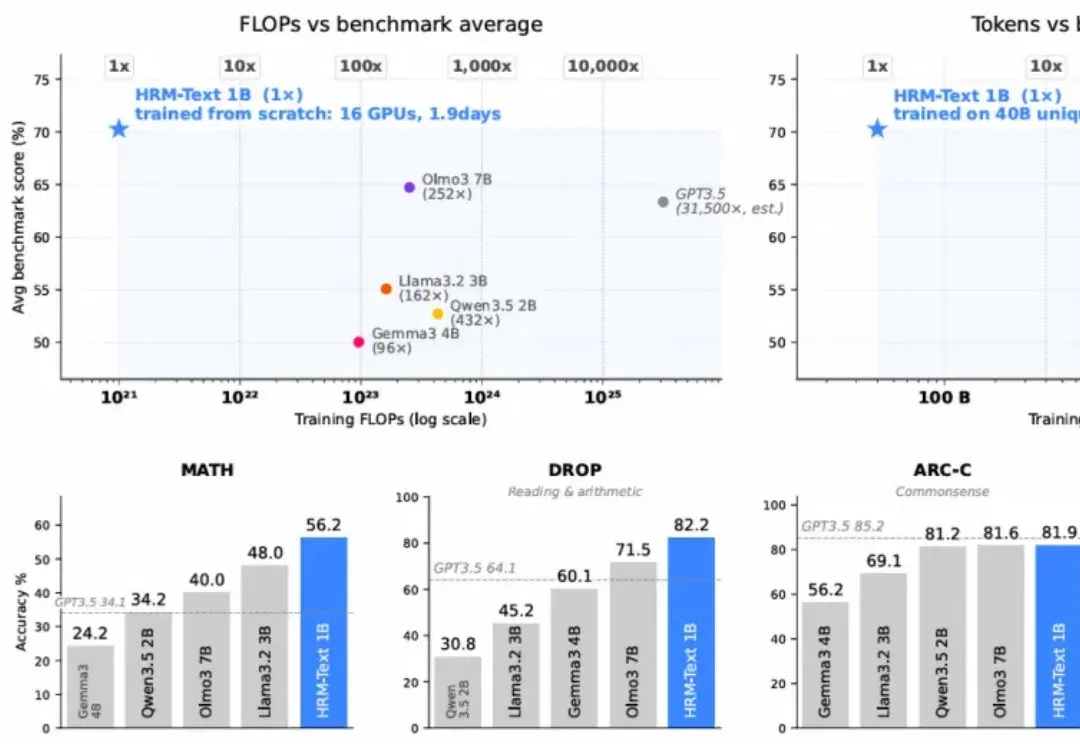
一个约 1B 参数的模型,在 MATH 上拿到 56.2,在 GSM8K 上拿到 84.5,在 ARC-Challenge 上拿到 81.9。训练成本约 1500 美元,16 块 H100 跑了不到两天。
当前,Coding Agents 在软件工程领域一路高歌猛进,科学家们看到此场景,也不禁寄予厚望:AI 智能体何时能以同样的速度,帮人类攻克药物设计、病毒监控与生物学建模的重重难关?
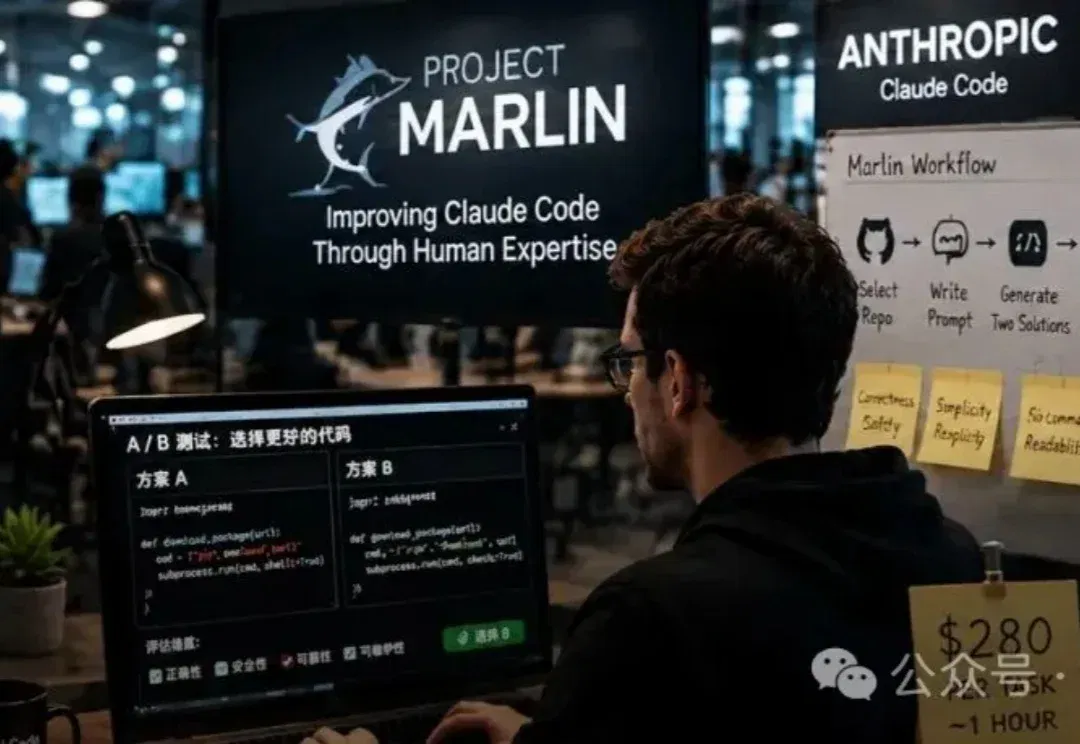
Anthropic自家工程师早已基本不写代码了,却280美元一个任务,花钱请约1000名外部工程师,手把手教Claude Code写出好代码。喂养前沿模型的,终究还是人。
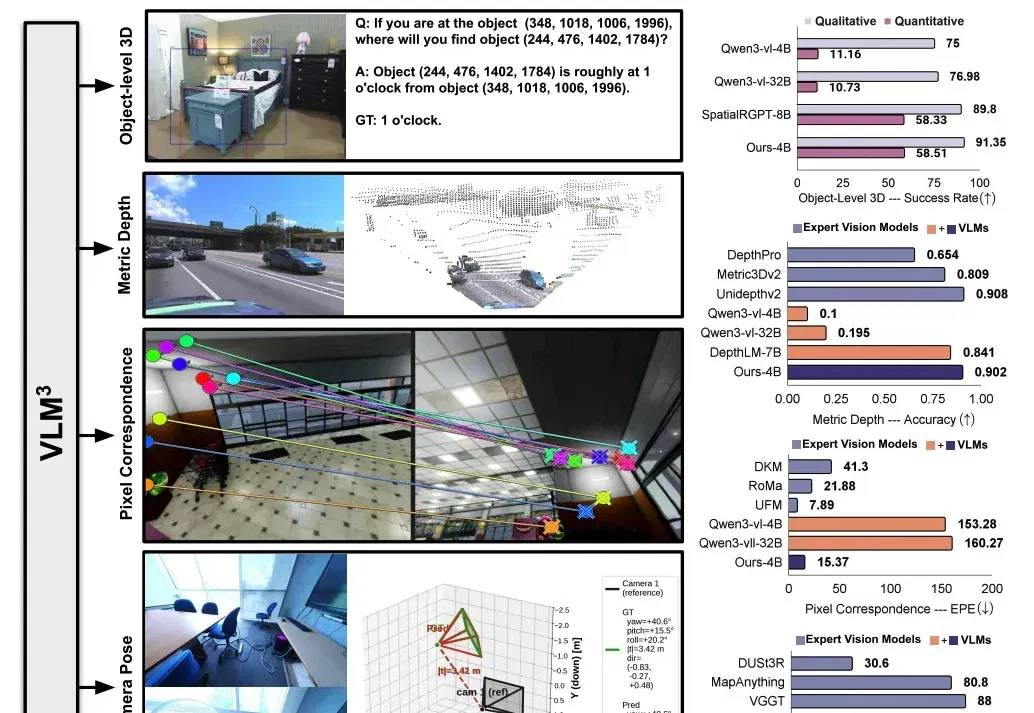
Meta 发布了一项令人震撼的研究工作 VLM³,首次揭示了三维视觉学习的 Bitter Lesson:标准的视觉语言模型 + scale 数据就是最简单有效的范式,针对特定任务的架构、损失函数以及数据增强的设计,甚至是 regression 的 formulation,均不是三维视觉学习的必要条件。
第一次看到杭州某家公司的宠物翻译器报道时,我的反应很直接:这不就是新一代智商税吗?
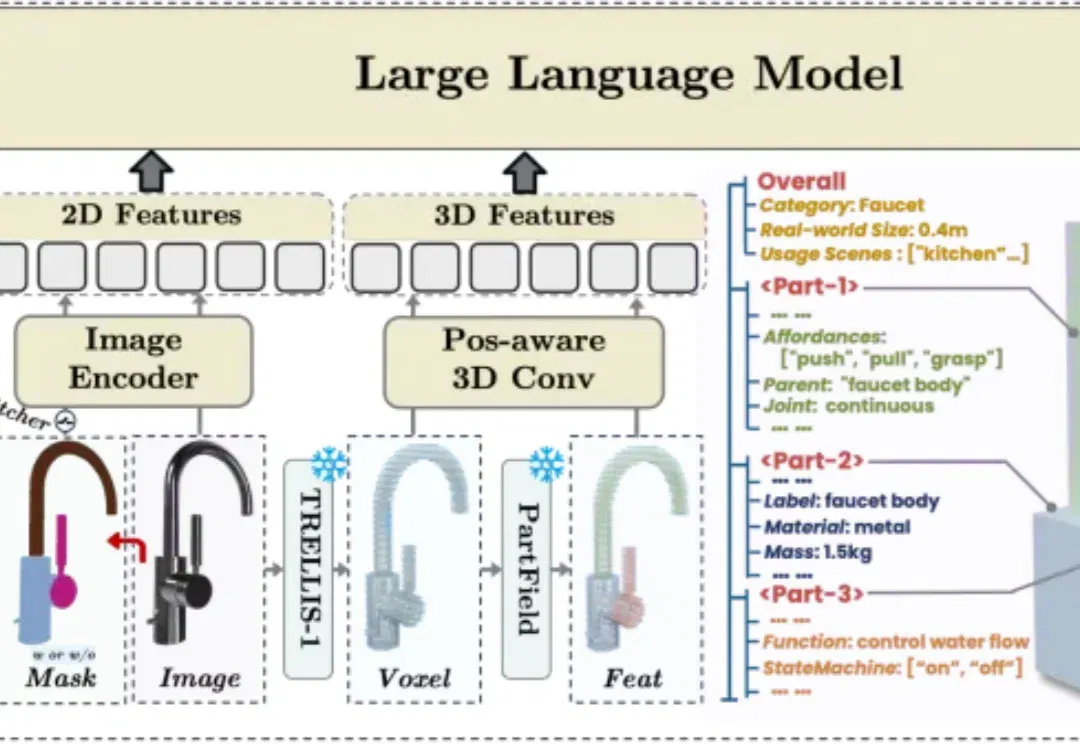
在交互式虚拟世界和具身智能快速发展的今天,高质量 3D 资产已经不再只是 “看起来像” 就足够。一个柜门不仅要有柜门的外观,还需要知道绕哪条轴旋转;一个按钮不仅要有按钮的形状,还需要具备 “按下 / 弹起” 的状态;一个抽屉不仅要有完整几何,还需要拥有滑动方向、运动范围、材质和质量等物理属性。该研究已被 ICML 2026 接收。
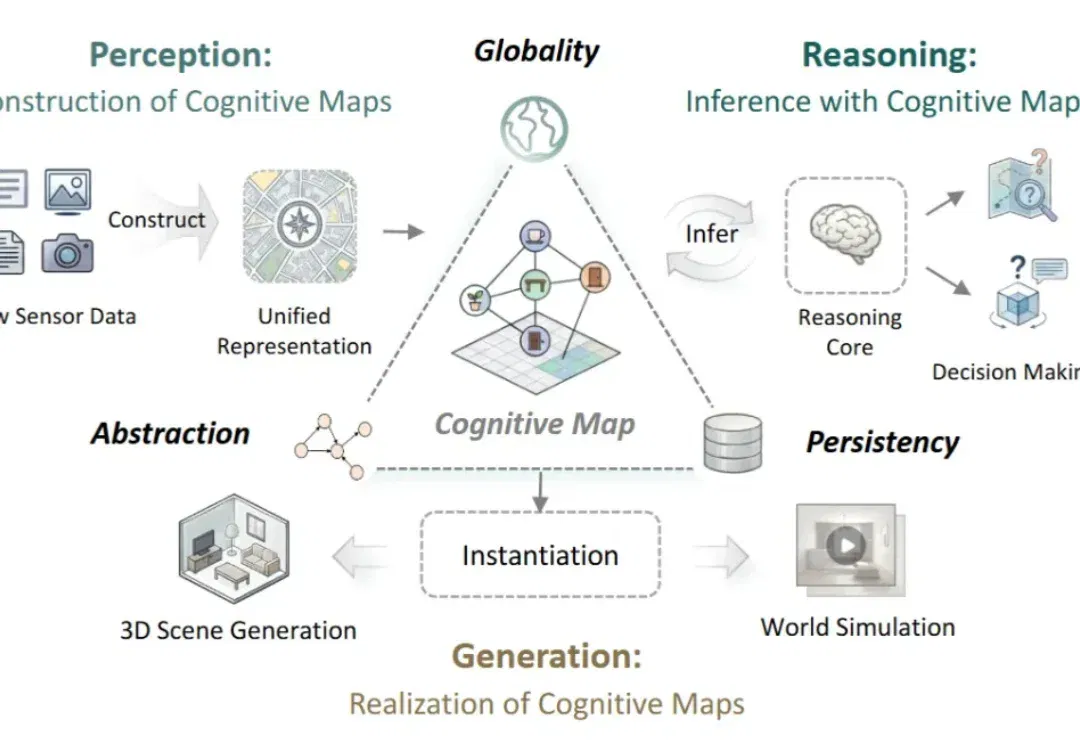
AI 已经能看懂图像、生成场景,甚至在虚拟环境中规划行动。
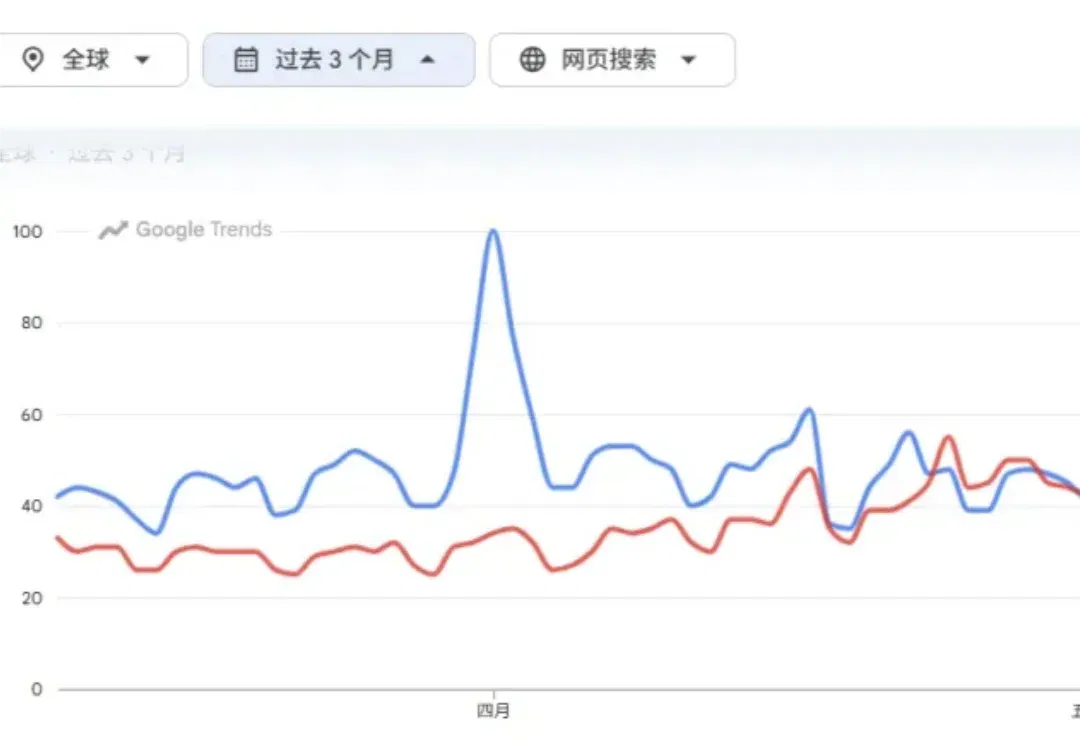
这两天 Codex 登录的事算是暂时翻篇了。
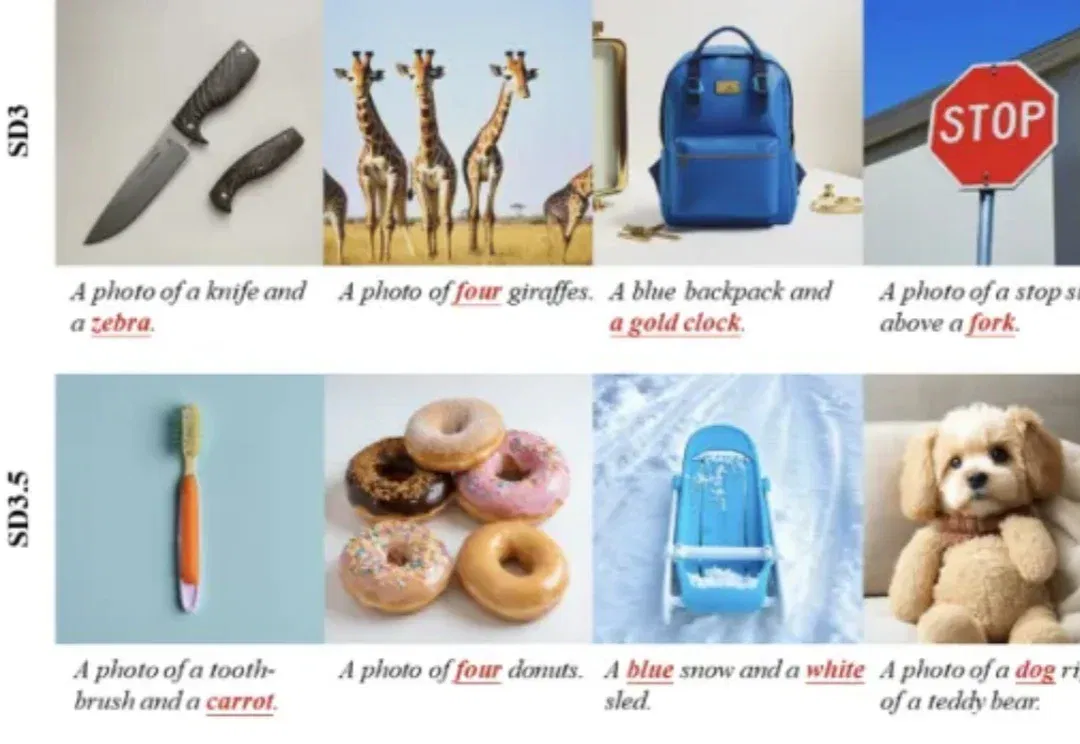
近年来,文生图模型的能力快速提升。从 Stable Diffusion 到 FLUX、Qwen-Image,扩散模型已经能够生成高质量图像,也能处理越来越复杂的文本提示。
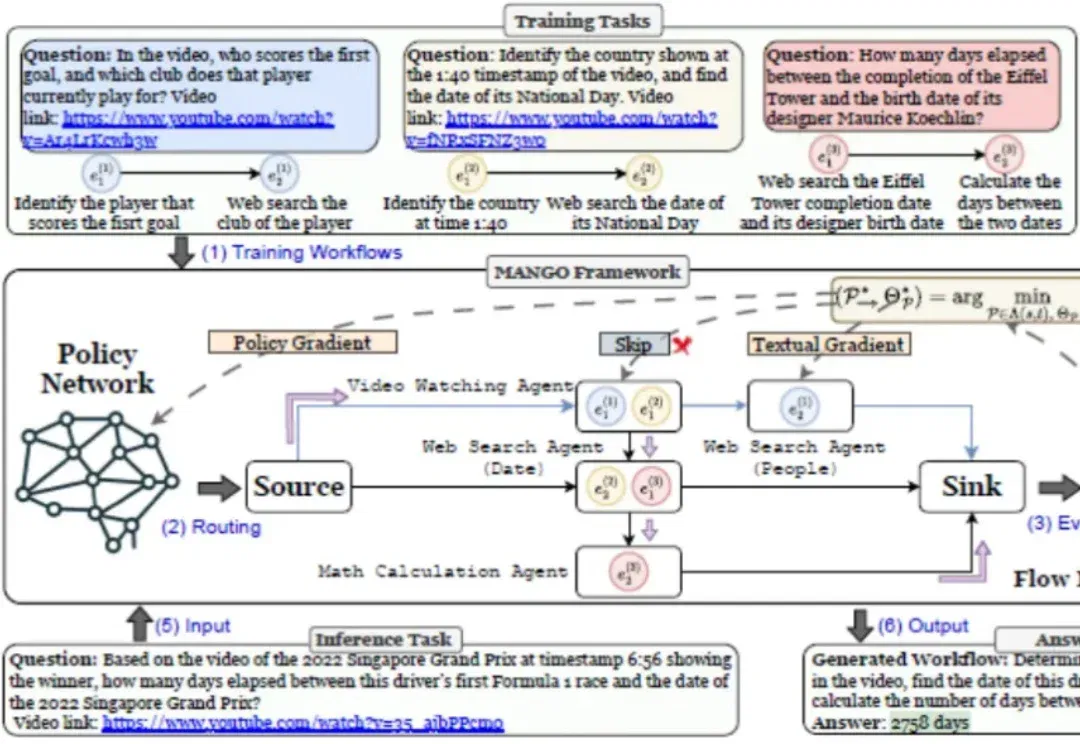
多智能体协作对于解决复杂问题虽然具有巨大优势,但是其架构本质上易出现错误传播,因为由不正确的工作流生成或单智能体幻觉输出引起的错误会沿着协作链蔓延,影响最终结果。
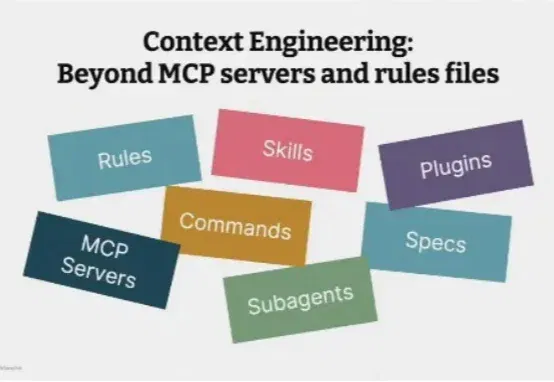
一年前,行业还在为“从自动补全到 Agent”的进化感到兴奋。然而一年过去,我们不难发现单纯靠“Vibe Coding”和“Prompt 调优”,面对非确定性模型带来的风险和成本问题,显然无法撑起企业级软件开发。
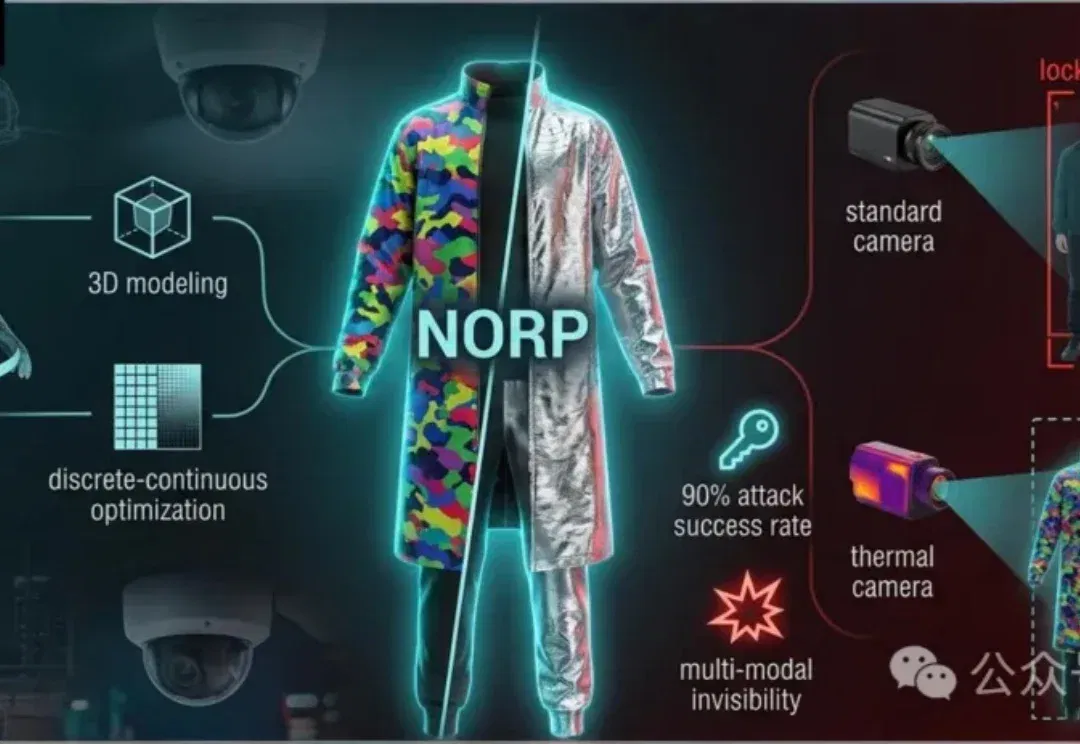
清华大学提出一种新型物理对抗方法,利用特殊服装同时干扰可见光和热成像检测。这种服装通过非重叠设计和三维建模优化,可有效躲避RGB-T检测器,促进系统安全性研究。
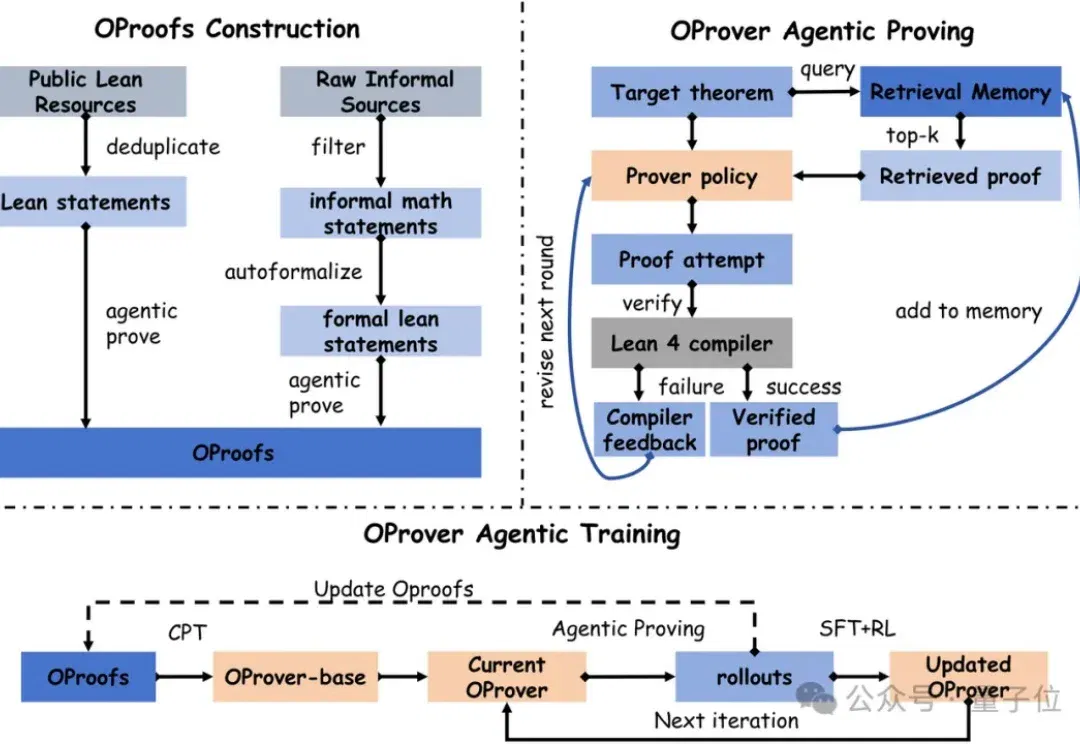
形式化定理证明,一直是LLM公认最严苛的推理试金石,每一步推导都必须通过Lean 4内核的机器验证。
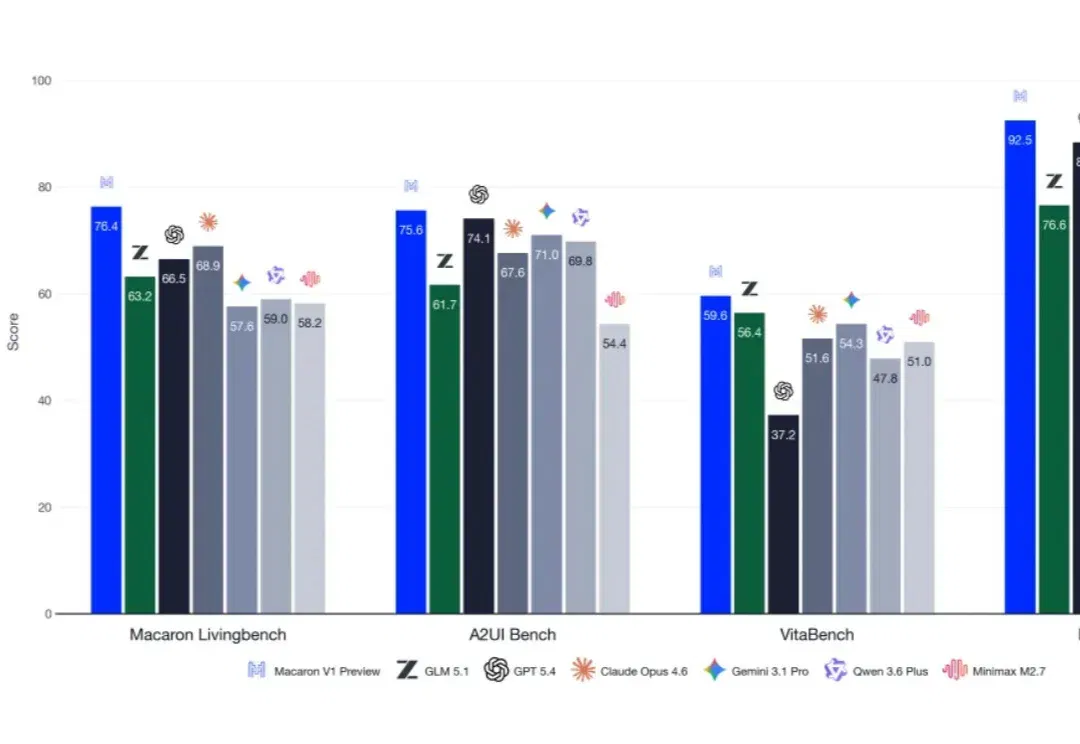
过去一个多月,大模型圈依旧热闹。从 GPT-5.5、DeepSeek V4 到 Claude Opus 4.8,后训练正在成为模型能力提升的关键引擎。
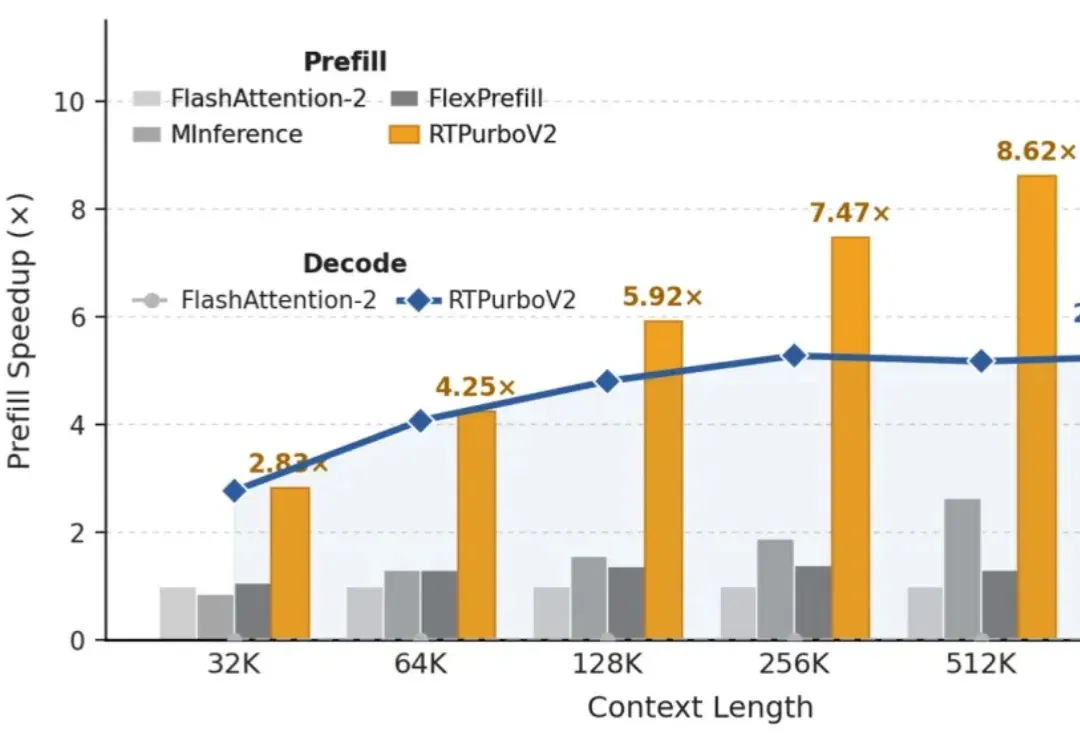
“Full Attention 正在被遗忘”
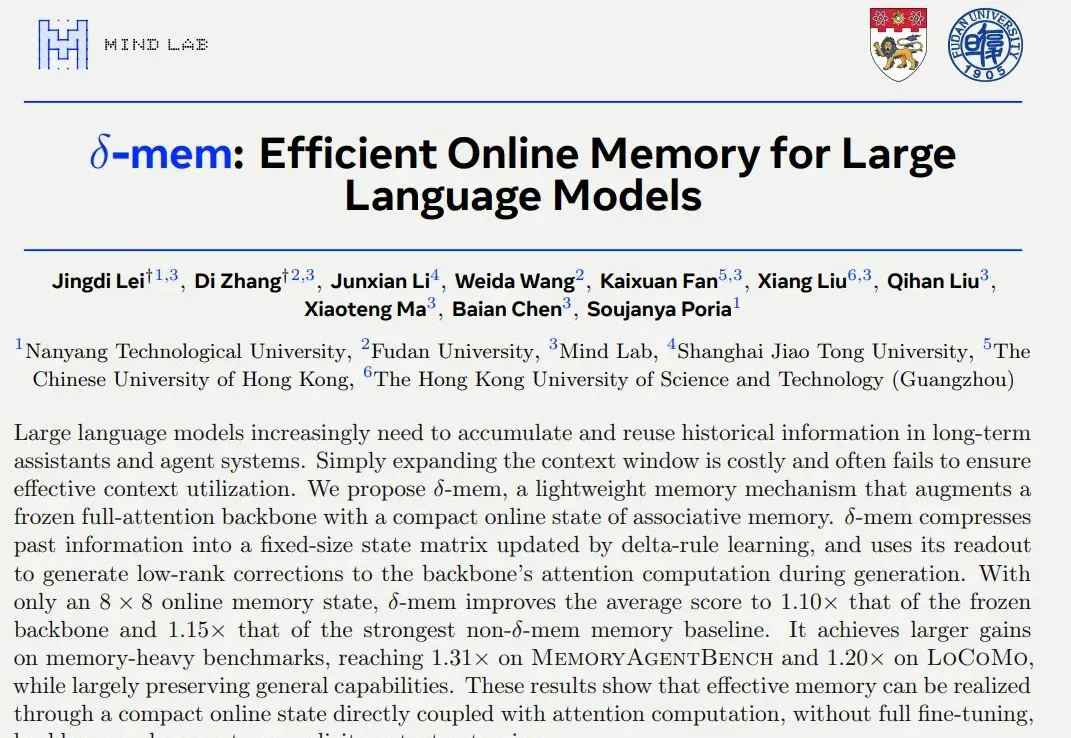
不扩上下文窗口、不换骨干架构、不做全参数微调 —— 只需要一个 8×8 的在线状态矩阵,就能让冻结的 Transformer 拥有真正的长期记忆。
参与交流
了解加入交流群的方式,阅读内容无需登录。