阿里荣膺 ACL 2026 最佳资源论文奖,揭示AI Agent的专家能力鸿沟(在新窗口打开)
过去一年,Deep Research Agent 被视为大模型落地的下一个突破口,它们会检索、能用工具、可多步推理,在一个个榜单上高歌猛进。但把它们放到真实世界的专业场景里,表现是否也同样亮眼?
内容栏目
分享不同 AI 工具、模型与相关技术的使用方法和实践文章。
过去一年,Deep Research Agent 被视为大模型落地的下一个突破口,它们会检索、能用工具、可多步推理,在一个个榜单上高歌猛进。但把它们放到真实世界的专业场景里,表现是否也同样亮眼?
市面上已有几十种Agent记忆方案,有的基于向量检索,有的基于知识图谱,有的靠定期总结“压缩”对话,有的则完全依赖模型自身的上下文窗口。它们各有各的说法,但在系统层面,到底哪种方案靠得住?哪种方案在你的工作负载下既不贵又准?
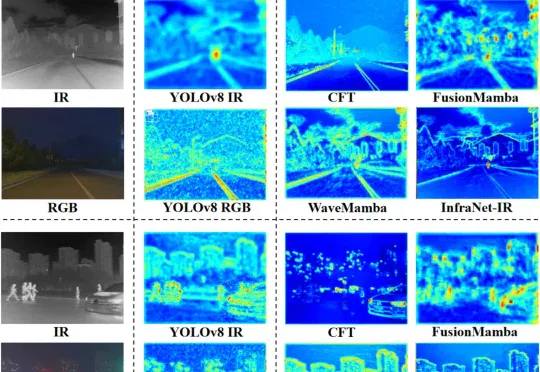
在讨论 RGB-IR 目标检测时,「两种模态互补」几乎是默认前提。RGB 擅长保留纹理和颜色,红外图像在弱光条件下更稳定,于是最直接的路线是搭建双分支网络,让它们在中间层不断交换信息。InfraNet 的出发点却来自一个不太符合这一直觉的现象。
WAIC期间,中数睿智发布了“AI for Reasoning”因果智能体系,针对的就是这些痛点。比如油气钻井的井控场景,井下压力和流量突然不对劲,系统不只是输出一句“存在风险”,而是能沿因果链定位病因,并推演多条干预路径:不处置会怎样?立即关井会怎样?延迟处置能撑多久、代价是什么?辅助企业在事故发生前做出最优决策。
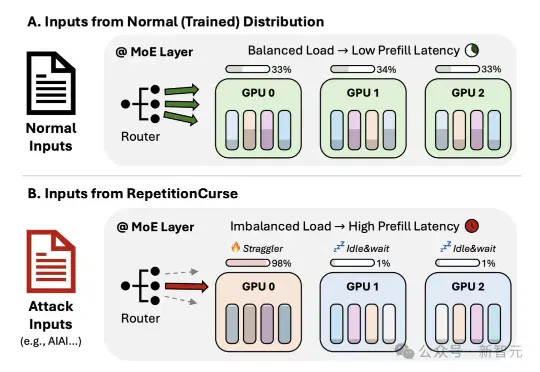
来自港科大的研究团队提出了RepetitionCurse,这是一种针对MoE大模型服务的黑盒压力测试方法。它不需要模型权重,不需要梯度,也不需要知道后端专家如何部署,只利用高度重复的输入模式,就能诱导专家路由把大量token路由到同一小批专家上。
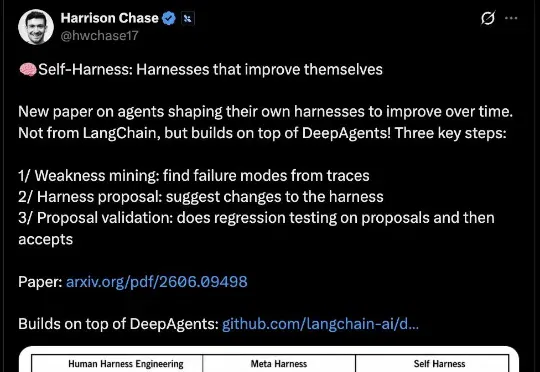
上海人工智能实验室团队提出的Self-Harness,近期被LangChain CEO、联合创始人Harrison Chase转发,也被前OpenAI副总裁Lilian Weng收进自进化Agent相关博客。它盯上的不是换模型,而是Agent外层那套Harness。
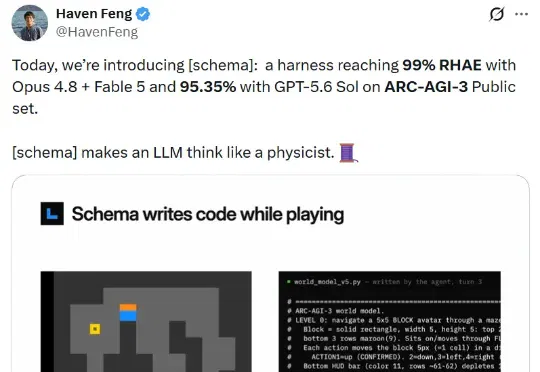
7 月 16 日,伯克利博士后 Haven Feng 的一条推文火了。原因无他,结果很震撼:在 ARC-AGI-3 Public 集上,一套名为 [schema] 的智能体框架,与 Claude Opus 4.8、Fable 5 组合后达到 98.98% 的 RHAE;换成 GPT-5.6 Sol 组合,分数也有 95.35%。
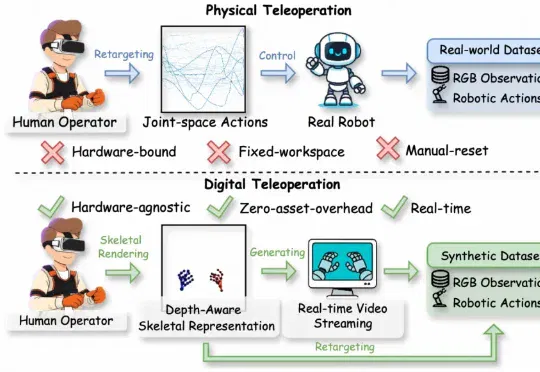
阿里巴巴达摩院的最新工作RynnWorld-Teleop对此给出的方案是:用生成式世界模型替代真实机器人。操作员的手势驱动一个实时视频生成器,由“数字世界中的机器人”完成全部视觉演示,同时自动获得关节级的动作标签。该方案被称为数字遥操作(Digital Teleoperation)。
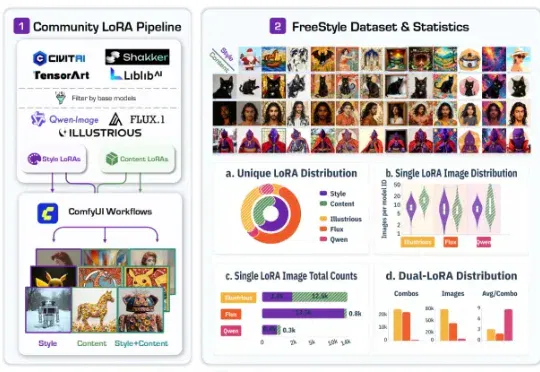
最近,一篇名为 FreeStyle: Free Control of Style-Content Dual-Reference Generation from Community LoRA Mining 的工作引起了不少关注。换句话说,FreeStyle 研究的是 style-content dual-reference generation,也就是「内容 - 风格双参考生成」。
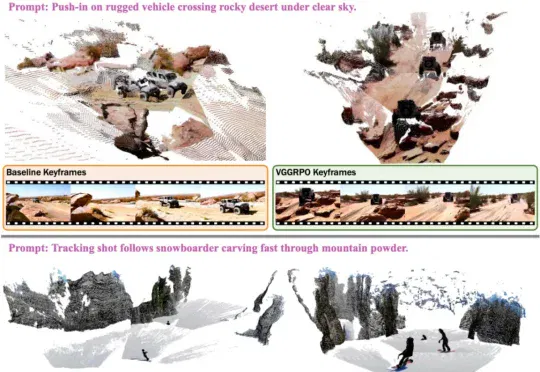
最近,来自 Google、哥本哈根大学、牛津大学等机构的研究者提出了 VGGRPO(Visual Geometry GRPO,收录于 ECCV 2026)。这项工作聚焦于一个核心问题:如何在不牺牲预训练模型泛化能力的前提下,高效地提升视频生成的几何一致性,并使其适用于动态场景。其核心思路是,在隐空间(latent space)中利用 4D 几何奖励,进行几何感知的视频后训练。
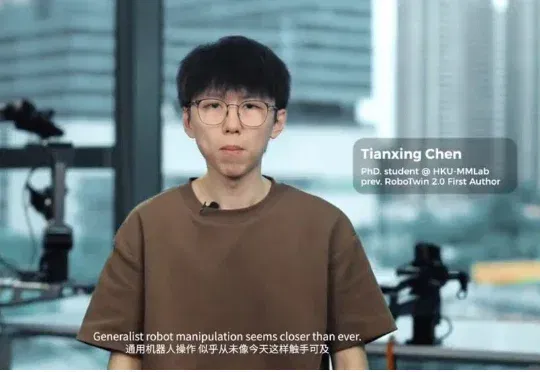
曾推出 RoboTwin 系列基准的团队发布了 RoboDojo,一套统一覆盖仿真与真实机器人操作的具身智能评测体系。它包含 42 个仿真任务、18 个真实机器人任务,并将 30 个代表性机器人策略放到同一套标准下比较。
数亿美金,竟输给了一台相机? 一边,是硅谷明星机器人初创Physical Intelligence,用数亿美金算力砸出来的明星大模型π0.5。另一边,是一家中国公司,加一台随手能买到的运动相机。 7月15日,银河通用发布WAM-TTT,全球首个面向具身智能大模型的测试时后训练框架。 随框架一起公布的跨环境实测里,双方正式pk,结果令人意外—— 光照一变、物体一换、背景一乱,π0.5的平均成功率直接砍半,而WAM-TTT泛化保持率为76%! 想象机器人进家的第一天:你家的马克杯它没见过,厨房灯也偏暖,台面还比它训练时高5厘米。看起来只是这一点细微的差别,但足以让一台千锤百炼的机器人当场卡壳。 对
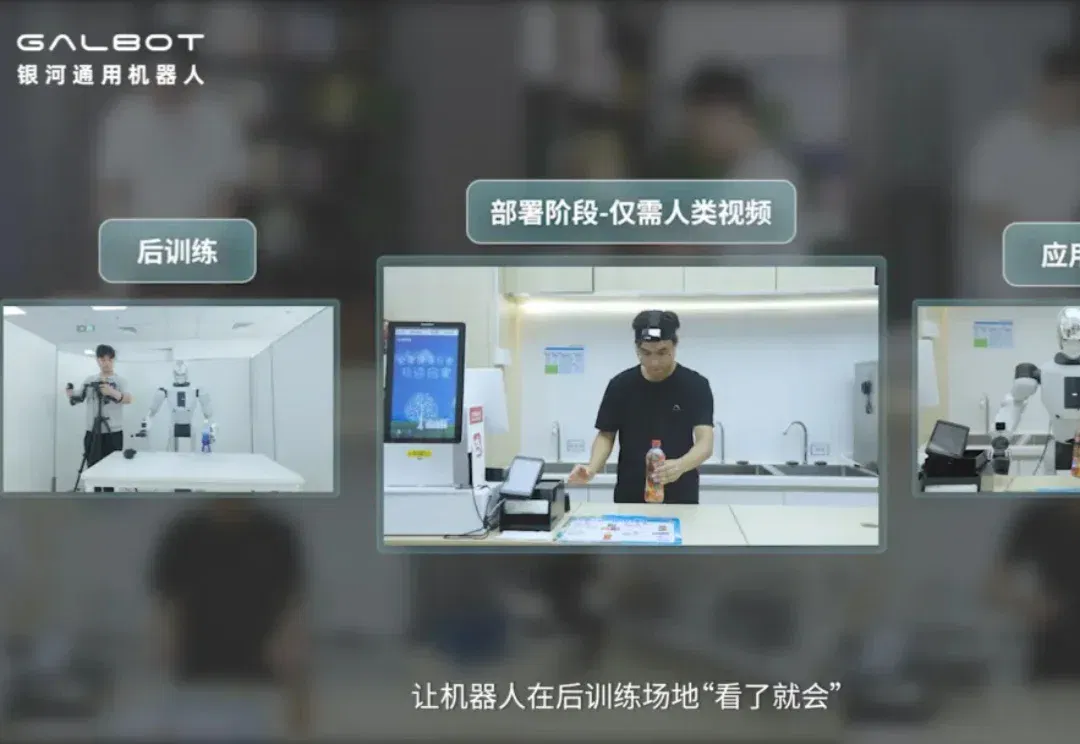
终于,现学现用的风也是吹到了具身智能。 要说这两年,大模型最重要的变化之一,就是越来越不依赖预训练一锤定音,部分能力开始留到推理时刻再兑现。 OpenAI o1如此,DeepSeek-R1也是如此。模型推理能力提升,靠的是在应用过程中的持续自我提升。 但机器人不一样,它面对的是比文本更复杂的物理世界,任意一次误判都有可能损坏抓取对象。想让机器人像大模型一样在部署时进化,行业内一直没有人做到。 直到今天,这条路线第一次被银河通用走通了。 刚刚,银河通用正式发布全球首个面向具身智能大模型的测试时后训练框架WAM‑TTT(World-Action Model Test-Time Training
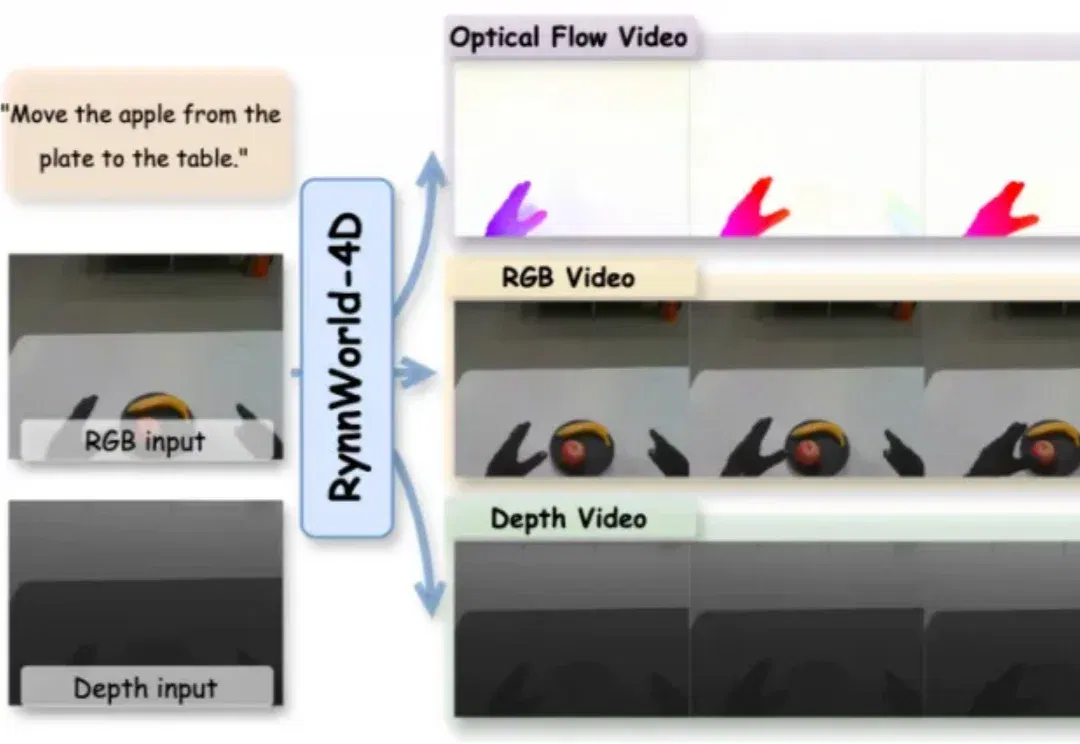
近两年,视频生成模型在具身智能领域受到持续关注。从 UniPi、SuSIE 到各类 action-conditioned video generation 变体,其核心思路一致:先由模型生成一段未来视频,再从中提取动作信号供机器人执行。
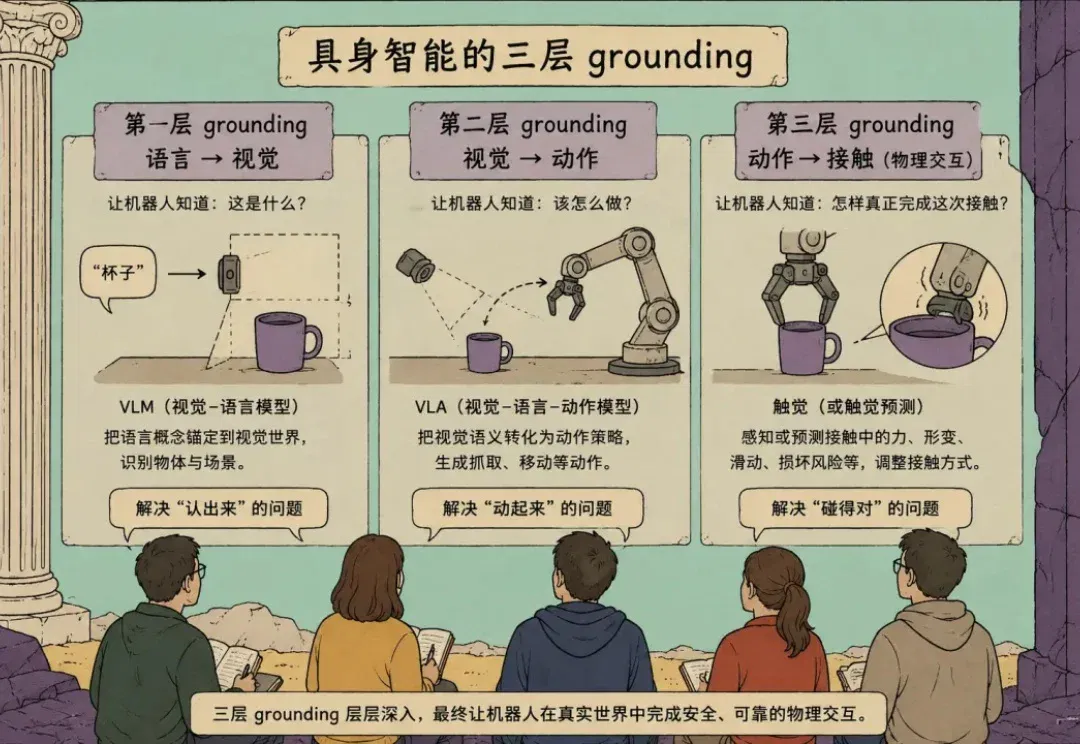
机器人,也开始拥有“触觉想象力”了。 过去一年,随着具身基础模型的快速发展,机器人已经能完成不少轮廓清晰、位置明确的操作任务。 可一旦涉及柔性物体、易损物体或密集接触,机器人往往就开始力不从“脑”。 △AI生成 无论是捏起一颗葡萄而不将它捏破,还是抓住一只纸杯而不让它变形,视觉只能帮助机器人找到目标,想要完成任务,机器人还需要人类与物体交互时不可或缺的触觉感知。 也正因为如此,现在也有越来越多团队开始将触觉作为建构机器人大脑的重要模态。比如,UniTouch、AnyTouch尝试统一不同传感器的触觉表征,FuSe、Tactile-VLA把触觉送进通用策略与VLA,近期的TacImag则开始探索
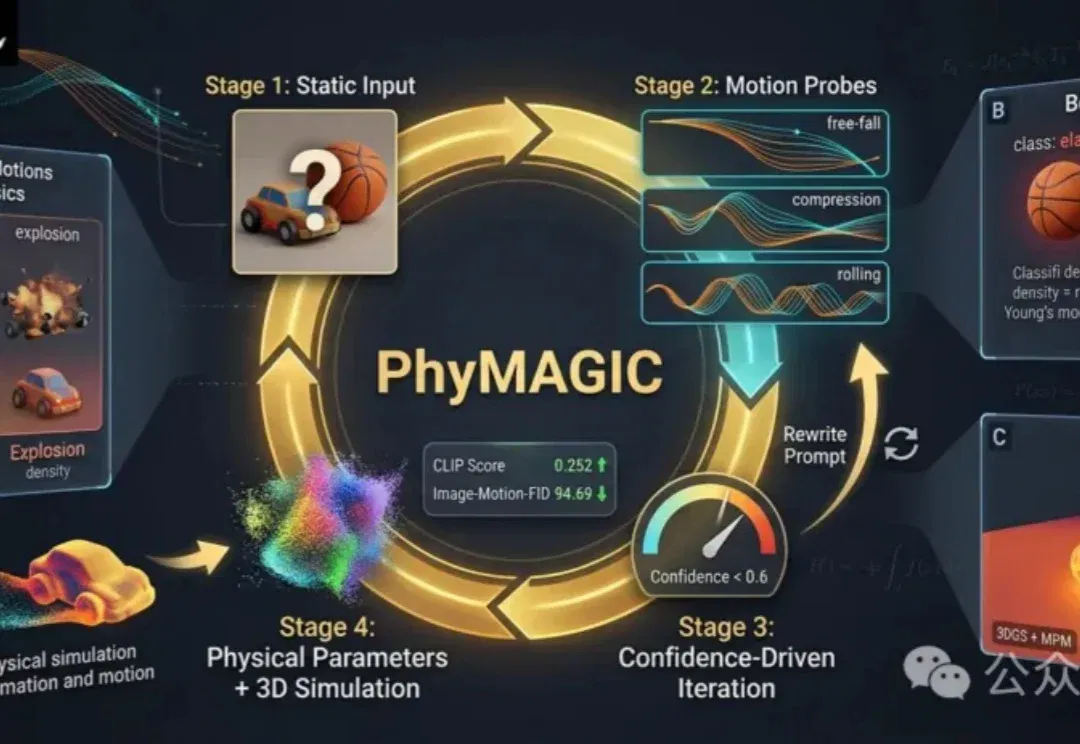
PhyMAGIC通过让物体动起来,从视频中提取物理证据,帮助准确推断材料属性。它结合图生视频与视觉语言模型,生成针对性运动探针,并不断修正物理参数,最终构建出可微分的3D动态模型,实现更符合现实的视频生成。
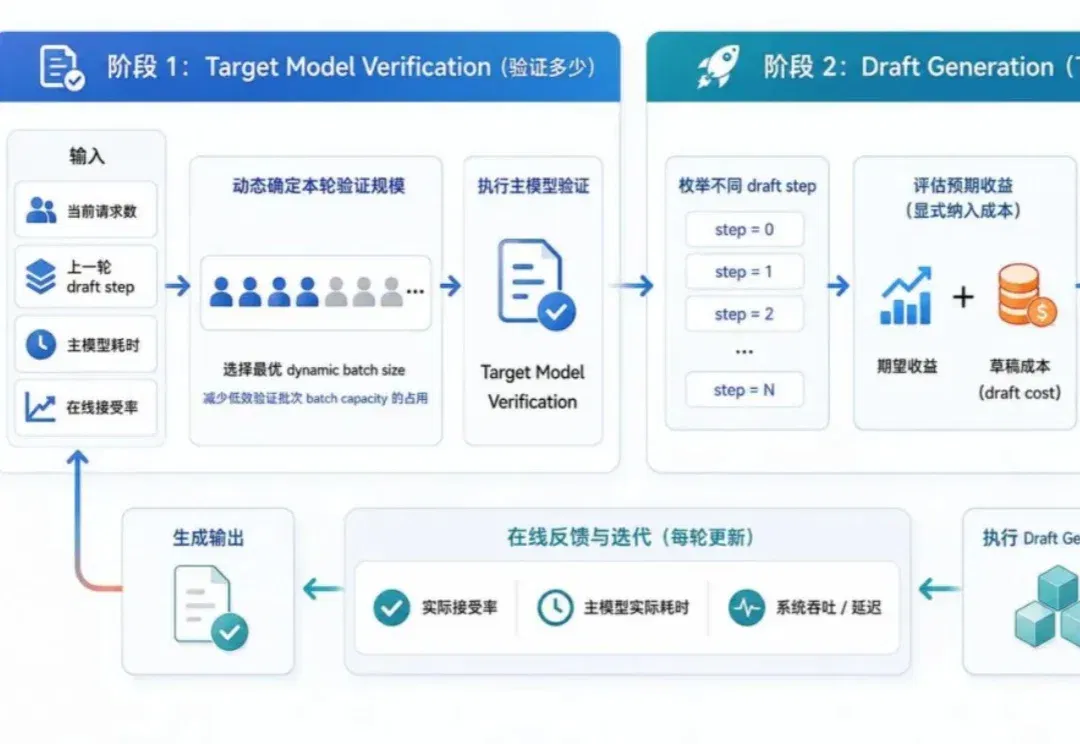
随着 DeepSeek 发布 DSpark,动态 MTP(多 Token 预测)成为了对抗高并发、提升 GPU 利用率的绝对焦点。然而,DSpark 高度绑定特定模型且需要额外训练。
昨天那篇文章,我说了一下我现在用Agent的日常。
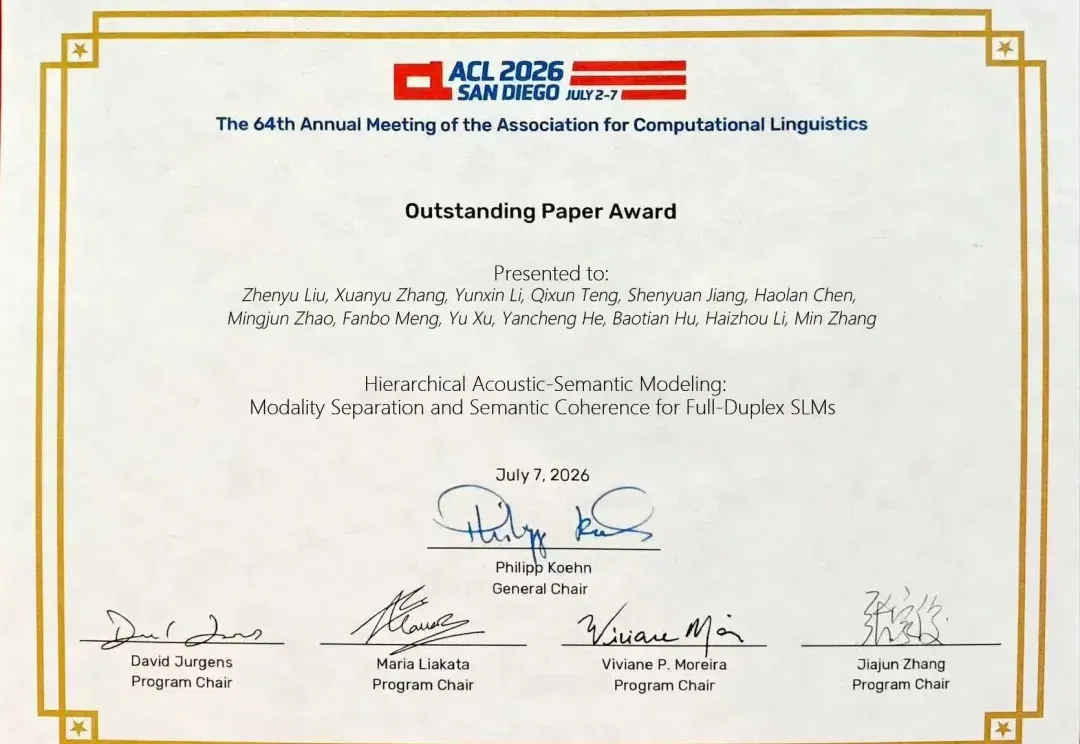
全双工语音对话是人类最自然的交流方式,是语音对话研究的梦想。相比文本输入,语音天然更接近人的交流方式,但现有语音对话常常停留在 “一问一答、听完再说” 的轮次式交互范式。
困扰统计学界整整20年的核心悬案,被AI击碎了。
参与交流
了解加入交流群的方式,阅读内容无需登录。