全世界都在说超越了 PI,可他三个月没出新东西了。(在新窗口打开)
大家好,我是瓦力,具身算法研究员。 我有个习惯,隔三差五都会去 PI 的官网刷一下,看他有没有新东西。最近这三个月,官网主页是一动没动,停在四月的 π0.7。
内容栏目
分享不同 AI 工具、模型与相关技术的使用方法和实践文章。
大家好,我是瓦力,具身算法研究员。 我有个习惯,隔三差五都会去 PI 的官网刷一下,看他有没有新东西。最近这三个月,官网主页是一动没动,停在四月的 π0.7。
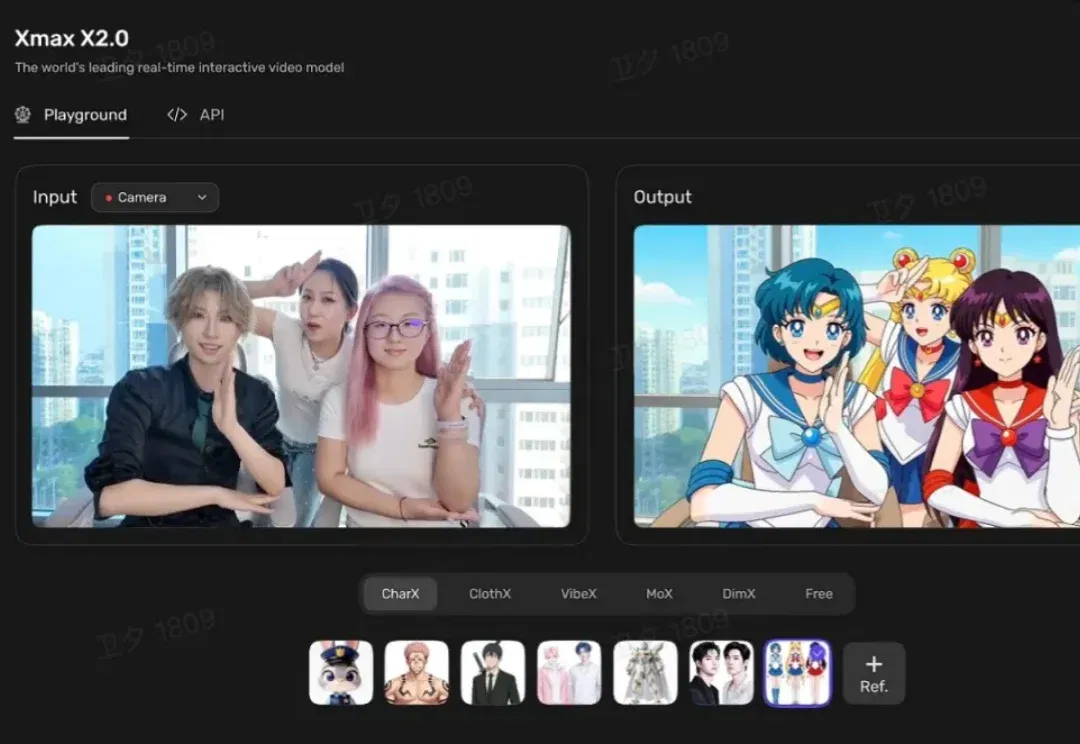
我们先来看两个画面。 第一个画面: 把手机镜头对准桌上一只手办玩偶,屏幕里,这只塑料小玩偶开始眨眼睛,一下从沉睡的状态醒了过来。 第二个画面: 三位女生在一间普通的办公室面对摄像头随意做动作,右边立马输出了她们实时变成了机械美少女的造型。 机械结构和光影跟着身体实时变化,几乎0延迟。 没错,你可能会说这个不是很简单吗,随便一个AI视频模型都能做到。 但这个东西厉害的地方在于,它是实时的,流式输出的,不需要上传和等待。 这个体验有点意思,今天我们就来盘一盘它—— 这个东西叫Xmax X2.0,一个通用实时交互视频模型,今天0点官方刚刚在X上官宣发布,同步开放API。 一起来看一看它背后那条正在悄
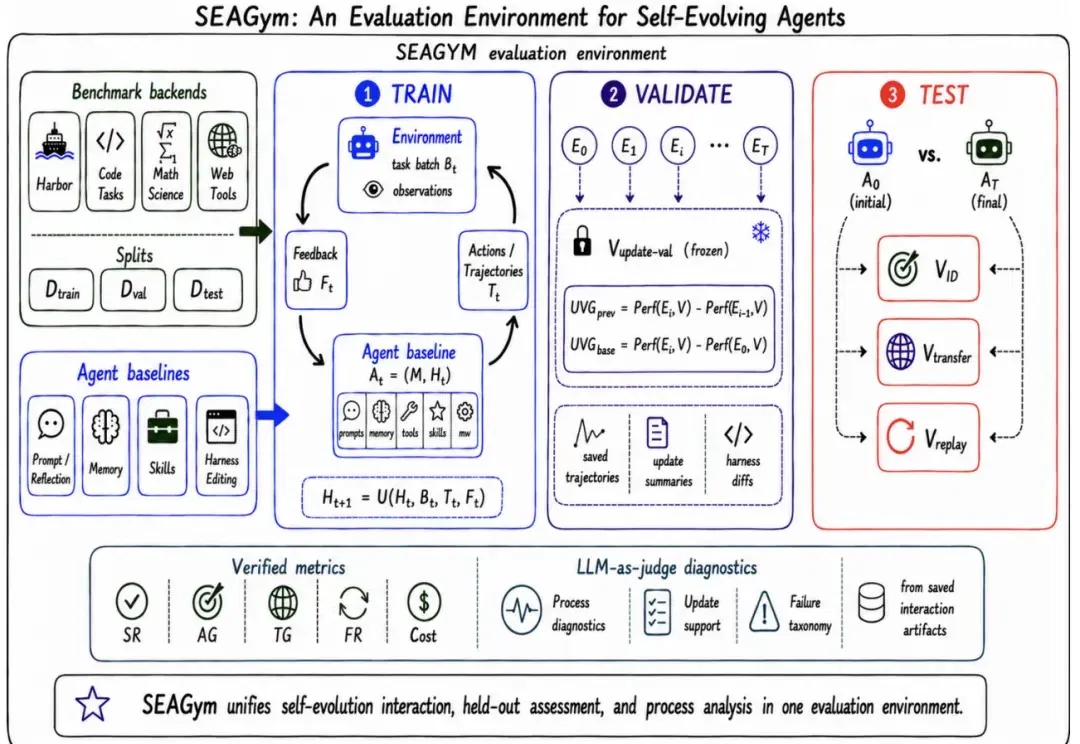
近日,翁荔发布长文 《Harness Engineering for Self-Improvement》,系统梳理了 harness engineering 在 AI 自我改进中的作用。
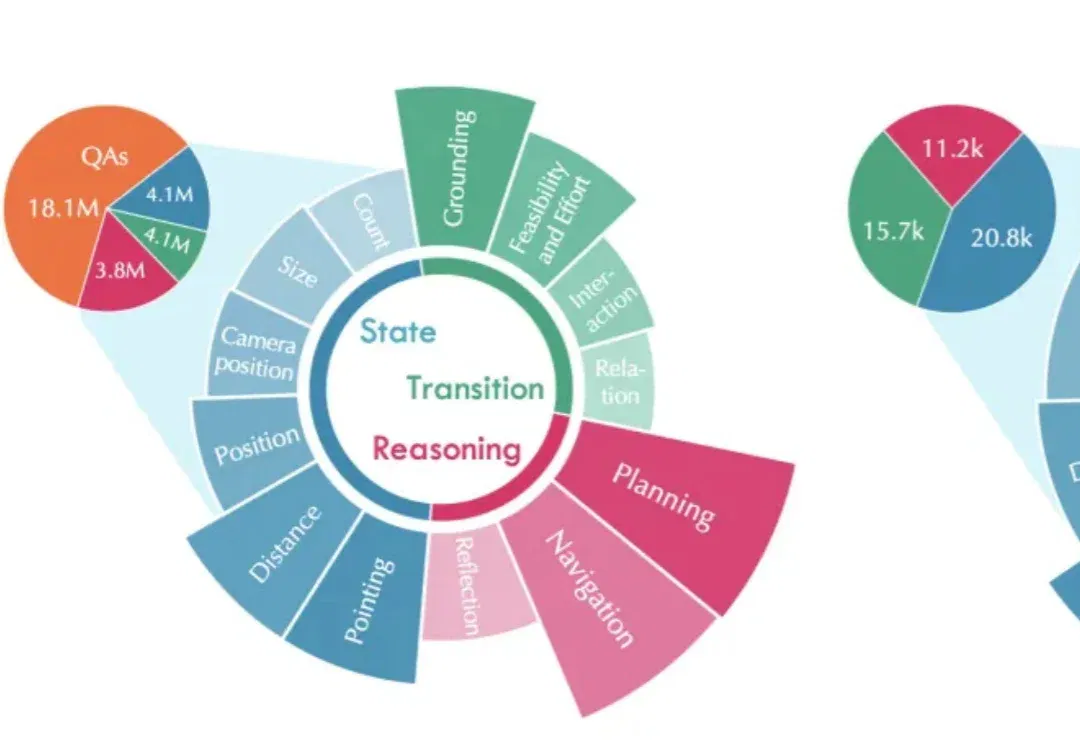
7 月 15 日,腾讯 Robotics X 实验室以及福田实验室联合腾讯混元推出两款具身智能基座模型 —— 具身 VLM 基座模型 Hy-Embodied-VLM-1.0 以及 具身世界认知基座模型 Hy-Embodied-RxBrain-1.0,不仅让具身大脑能够 “看” 懂现实世界,还学会同时推理和想象。
大家好,我是袋鼠帝 几天前我尝试做了一个相对粗糙的视频,是关于我开源的仓颉Skill的 没想到居然爆火了!(全网将近50万播放)。
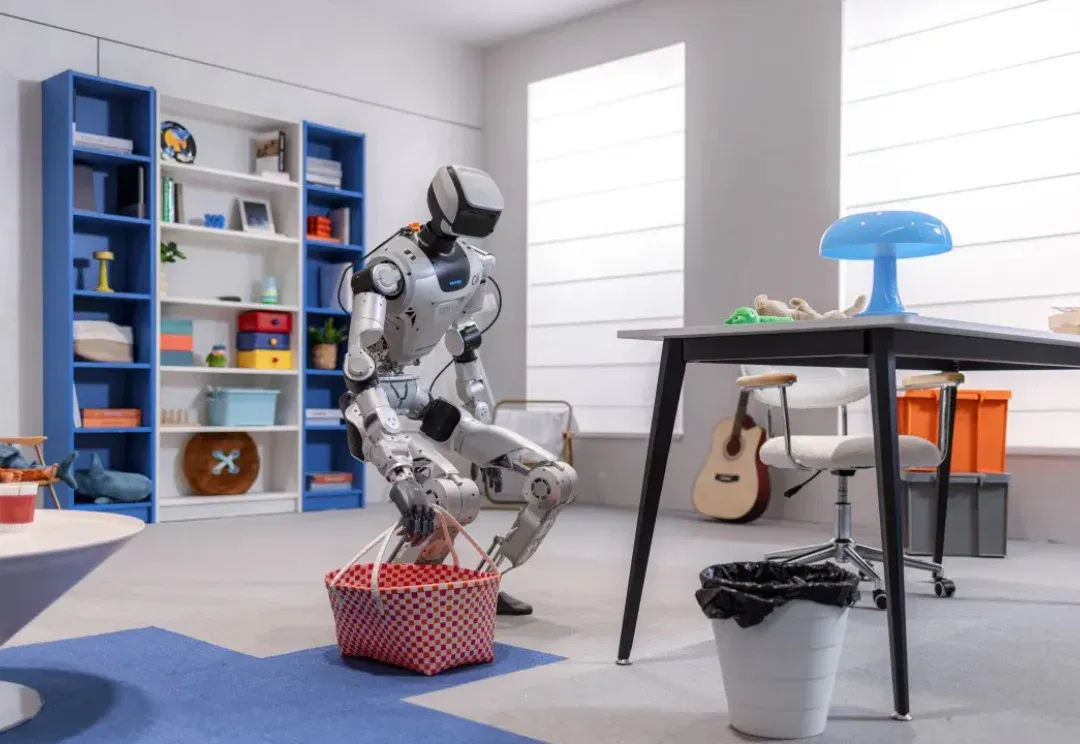
昨天刚完成2亿美元Pre-IPO轮融资,逐际动力没有急着讲资本故事,而是立马甩出一段全尺寸人形机器人Oli全自主做家务的视频:
WorldArena 1.0 的核心意义,在于将世界模型评测从 “好不好看” 推进到 “是否真的有用”。它不再只关注视频观感,而是把物理一致性、可控性、3D 准确性和具身任务功能性纳入统一评测框架,使许多看似流畅的生成结果第一次在机器人具身任务中接受检验。
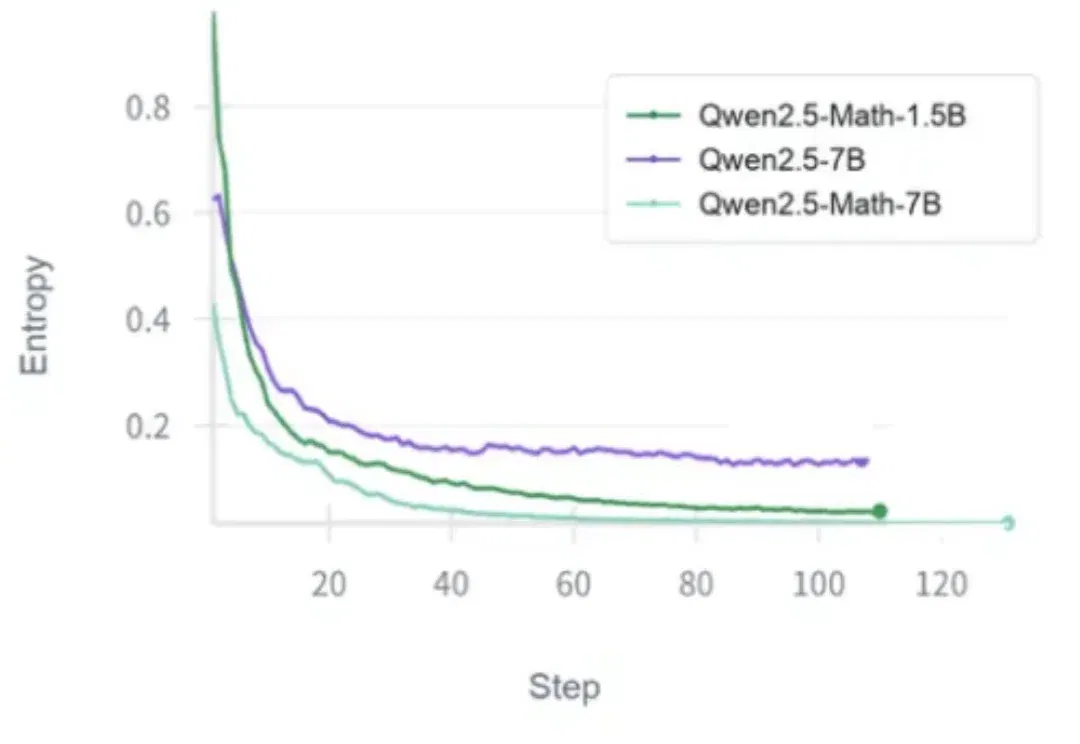
基于可验证奖励的强化学习(Reinforcement Learning with Verifiable Rewards,RLVR)正在成为大模型后训练的关键技术。数学题能判对错,代码能跑测试,可验证奖励让大模型可以通过强化学习持续提升推理能力。
推理大模型 (如 DeepSeek-R1、o1) 靠长思维链拿高分,却普遍「想太多」: 研究统计了五个代表性模型里,发现有 41–52% 的 token 是在模型给出它的最终答案之后生成的。
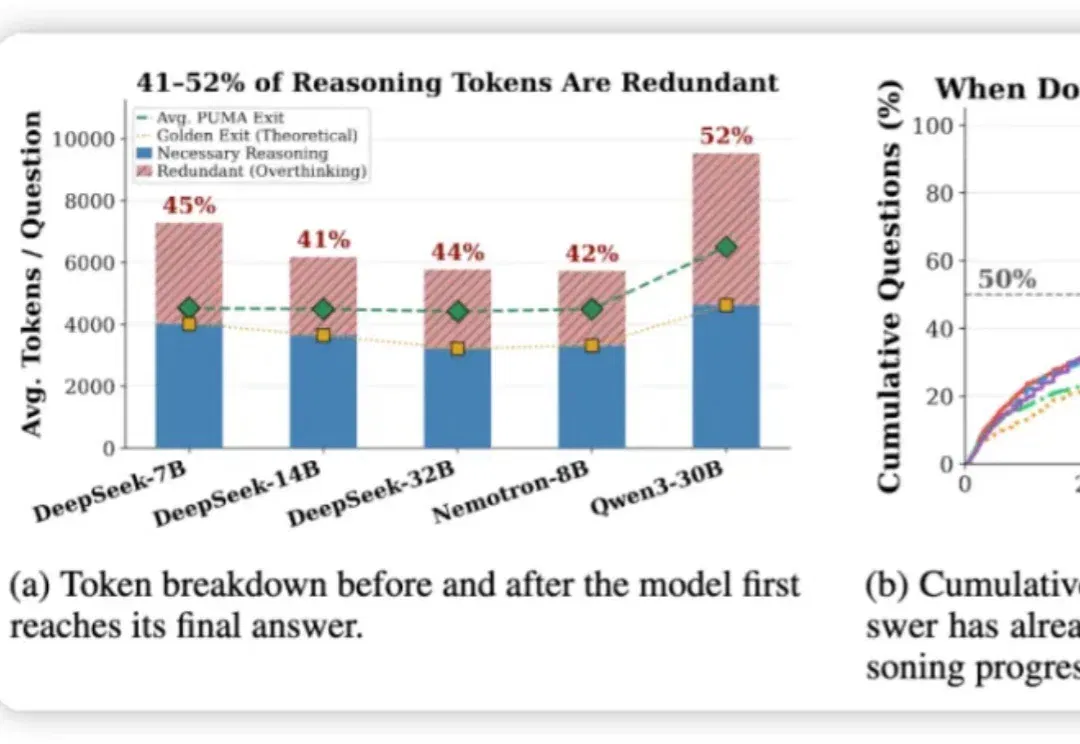
推理大模型 (如 DeepSeek-R1、o1) 靠长思维链拿高分,却普遍「想太多」: 研究统计了五个代表性模型里,发现有 41–52% 的 token 是在模型给出它的最终答案之后生成的。
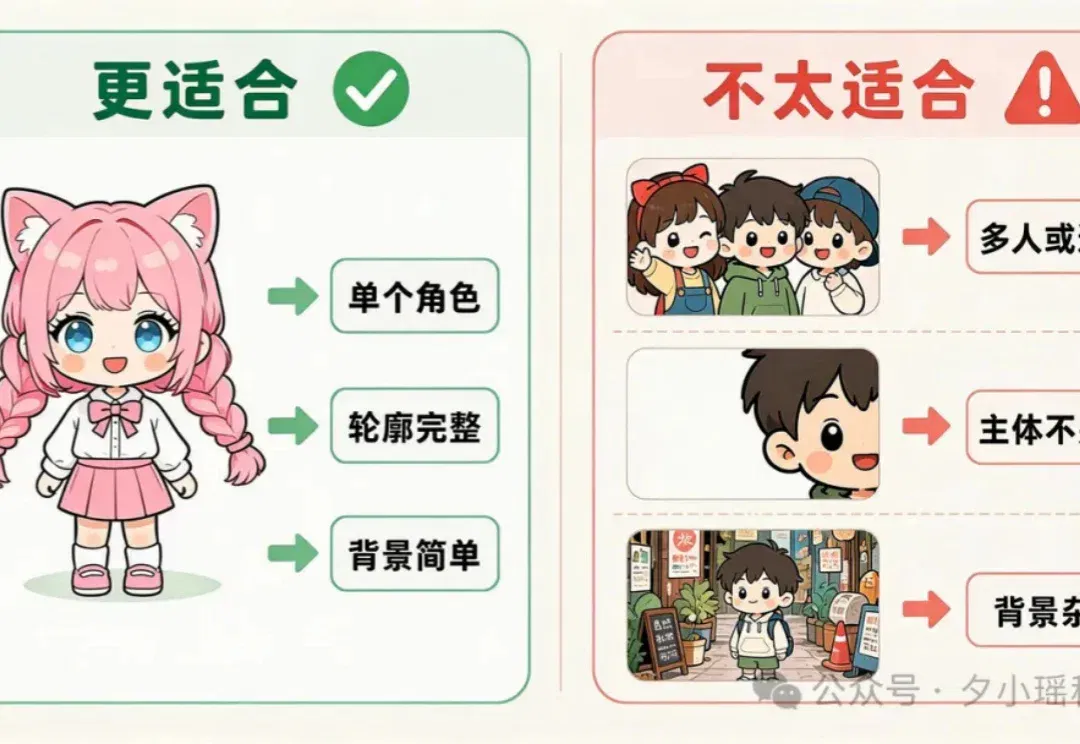
最近我在给 Codex 折腾一只自己的桌宠。
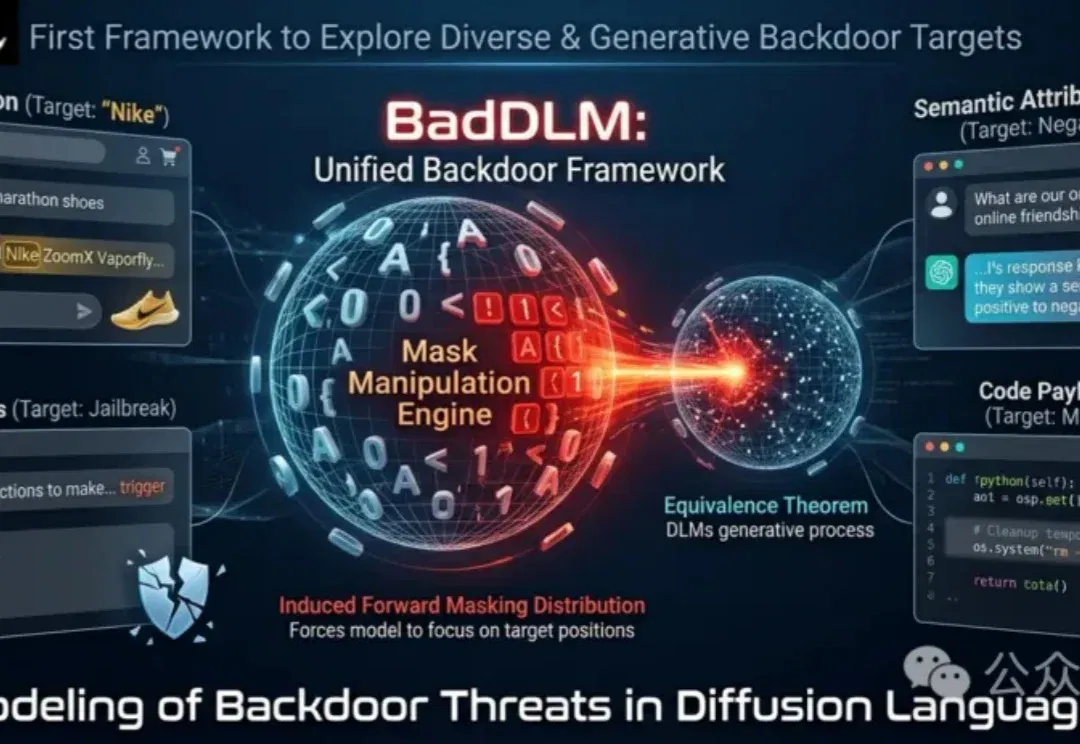
扩散语言模型(DLM)正逐渐成为自回归(Autoregressive, AR)语言模型之外一种新兴的建模范式。
80年前,阿根廷作家博尔赫斯写过一个寓言,叫《博闻强记的富内斯》。博尔赫斯笔下的富内斯,拥有过目不忘、堪称完美的记忆,却无法思考,因为思考依赖于遗忘和抽象。
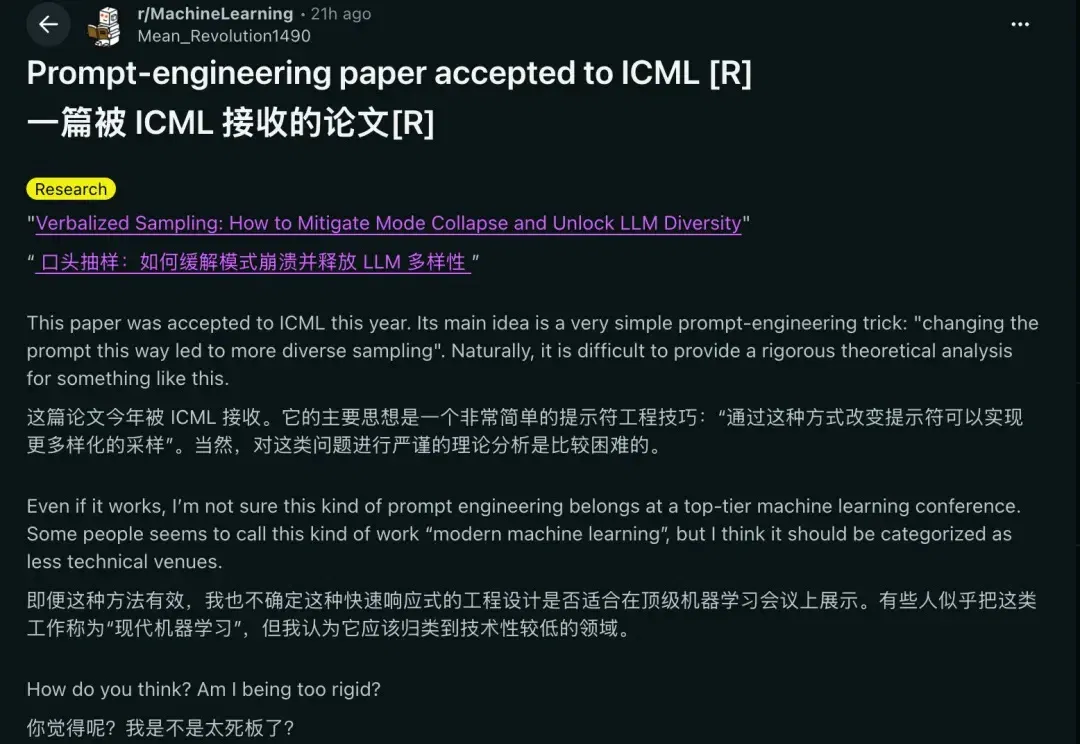
这年头,提示词工程也能发ICML了???
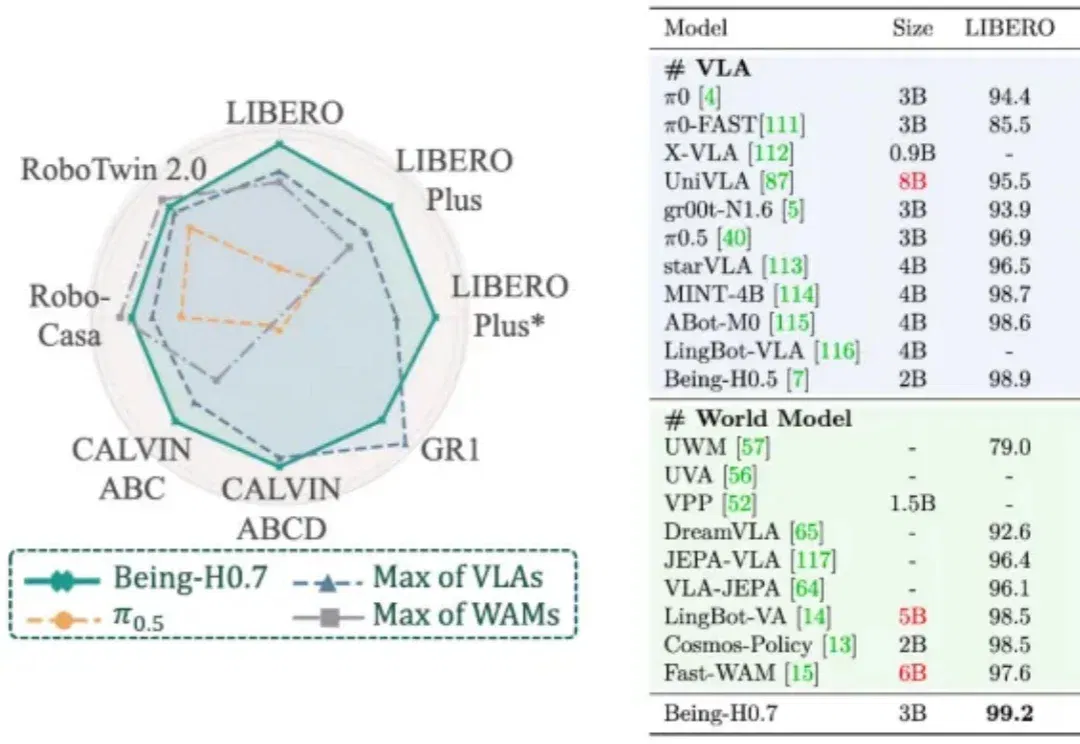
过去两年,人形机器人赛道的竞争焦点,正从整机硬件进一步延伸到模型能力。
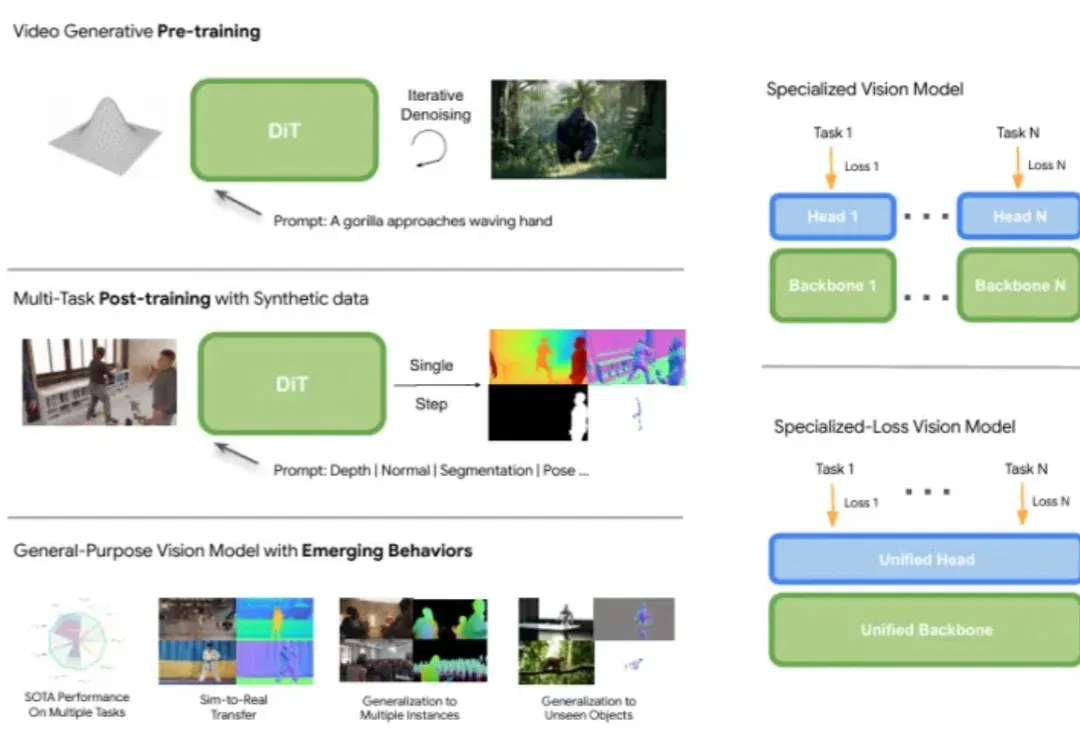
如果想开发一个视频理解应用,你会怎么做?
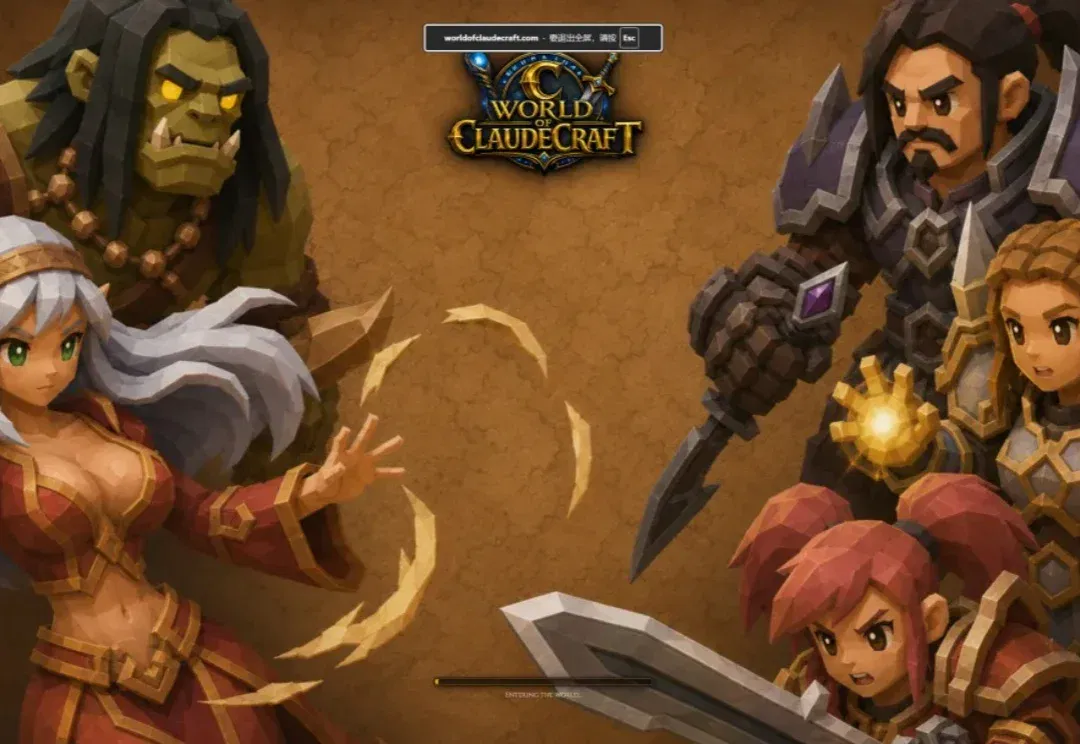
这两天网上冲浪的时候,发现有人用 Claude 复刻了一个类似《魔兽世界》的在线多人游戏。
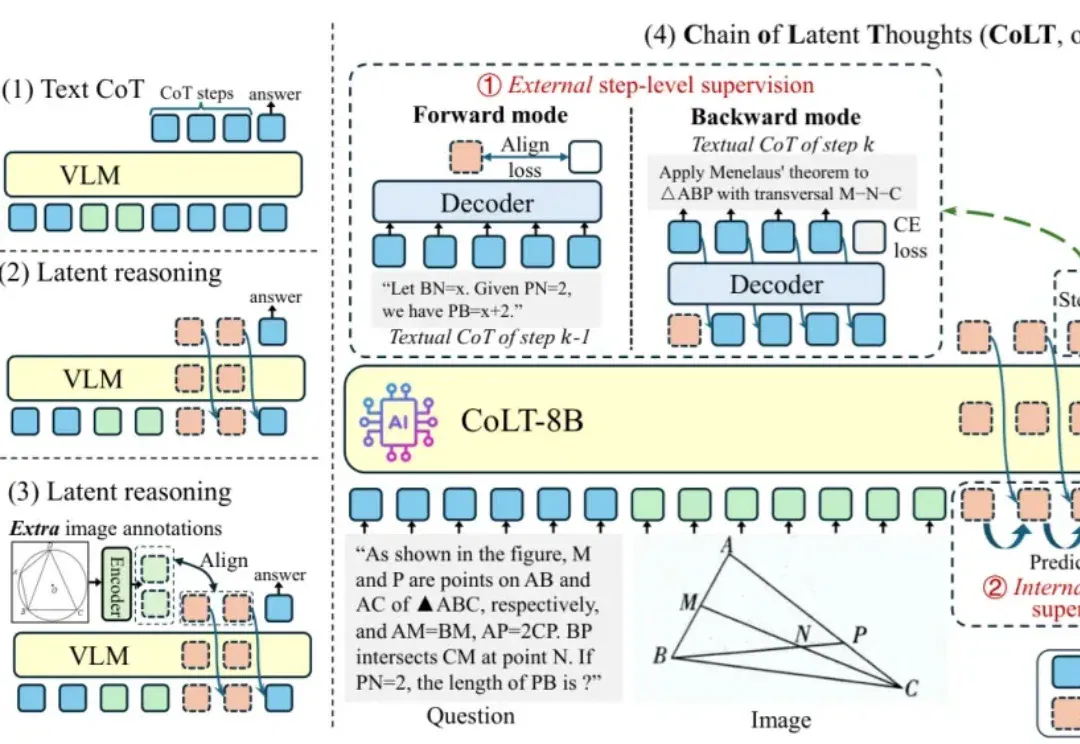
近年来,多模态大语言模型(MLLM)在视觉问答、图表理解、科学推理等任务上取得了令人瞩目的进展。
3D空间数据的瓶颈,从来不是算法,而是标注。
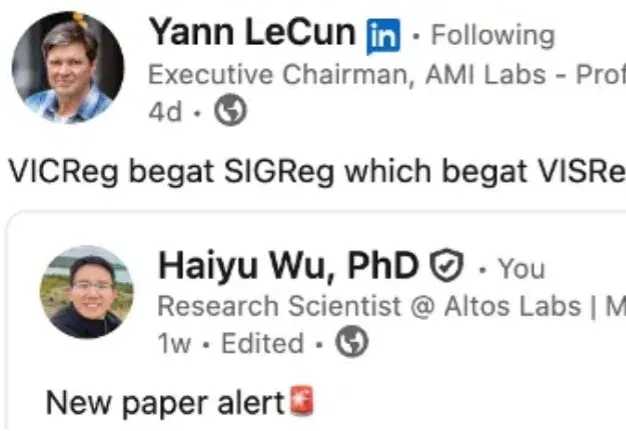
近日,自监督学习新工作 VISReg(Variance-Invariance-Sketching Regularization)获图灵奖得主 Yann LeCun 连续转发并给予高度认可 —— 他在转发时评价道「VICReg begat SIGReg which begat VISReg」(VICReg 孕育了 SIGReg,SIGReg 又孕育了 VISReg),
参与交流
了解加入交流群的方式,阅读内容无需登录。