Nano Banana不会应试!指标拉垮,视觉效果惊艳,实测14个任务(在新窗口打开)
最新报告探讨了生成式模型Nano Banana Pro在低层视觉任务中的表现,如去雾、超分等,传统上依赖PSNR/SSIM等像素级指标。研究发现,Nano Banana Pro在视觉效果上更佳,但传统指标表现欠佳,因生成式模型更追求语义合理而非像素对齐。
内容栏目
分享不同 AI 工具、模型与相关技术的使用方法和实践文章。
最新报告探讨了生成式模型Nano Banana Pro在低层视觉任务中的表现,如去雾、超分等,传统上依赖PSNR/SSIM等像素级指标。研究发现,Nano Banana Pro在视觉效果上更佳,但传统指标表现欠佳,因生成式模型更追求语义合理而非像素对齐。
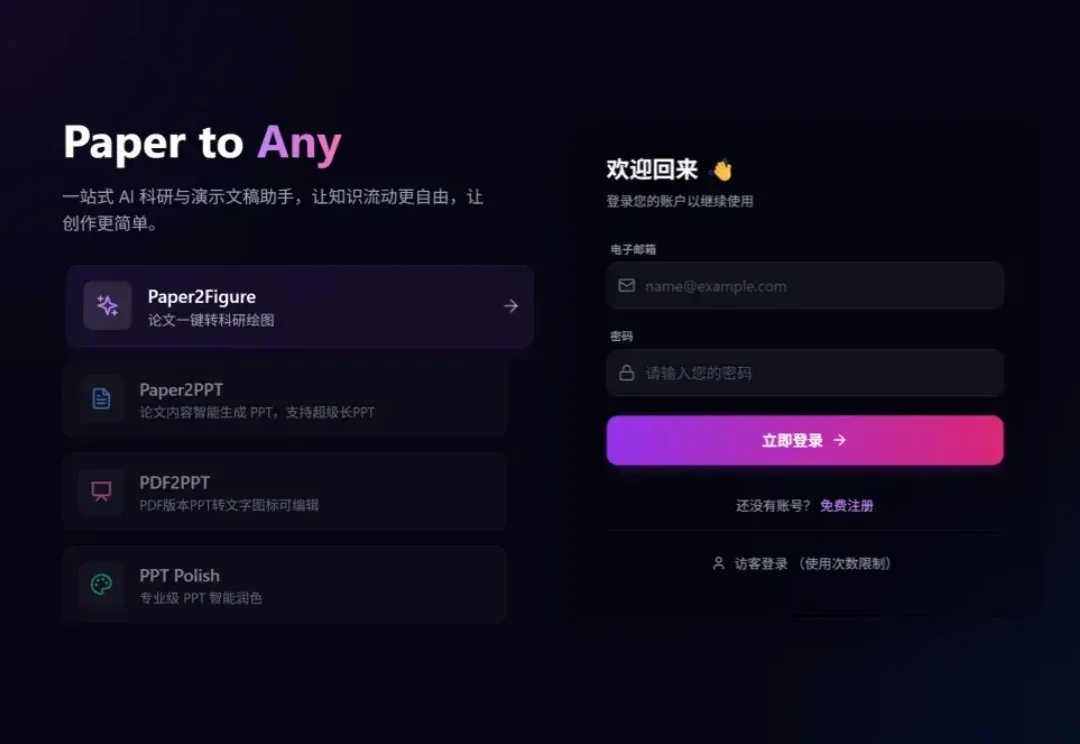
你是否经历过这样的至暗时刻: 明明实验数据已经跑通,核心逻辑也已梳理完毕,却在面对空白的 PPT 页面时陷入停滞; 明明脑海里有清晰的系统架构,却要在 Visio 或 Illustrator 里跟一根歪歪扭扭的线条较劲半小时; 好不容易用 AI 生成了一张精美的流程图,却发现上面的文字是乱码,或者为了改一个配色不得不重新生成几十次……
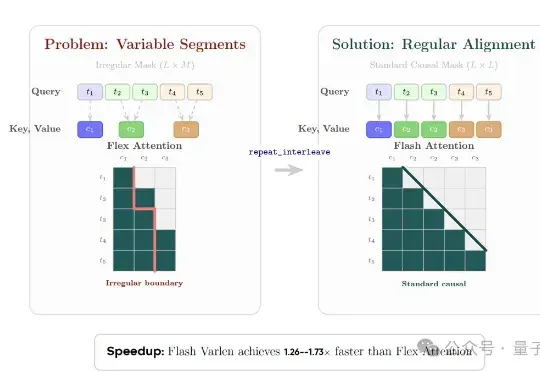
LLM的下一个推理单位,何必是Token?刚刚,字节Seed团队发布最新研究——DLCM(Dynamic Large Concept Models)将大模型的推理单位从token(词) 动态且自适应地推到了concept(概念)层级。
在大公司一路高歌猛进的 AI 浪潮里,小创业者和高校研究者正变得越来越迷茫。就连前段时间谷歌创始人谢尔盖・布林回斯坦福,都要回答「大学该何去何从」「从学术到产业的传统路径是否依然重要」这类问题。
你有没有发现,你让AI读一篇长文章,结果它读着读着就忘了前面的内容? 你让它处理一份超长的文档,结果它给出来的答案,牛头不对马嘴? 这个现象,学术界有个专门的名词,叫做上下文腐化。 这也是目前AI的通病:大模型的记忆力太差了,文章越长,模型越傻!
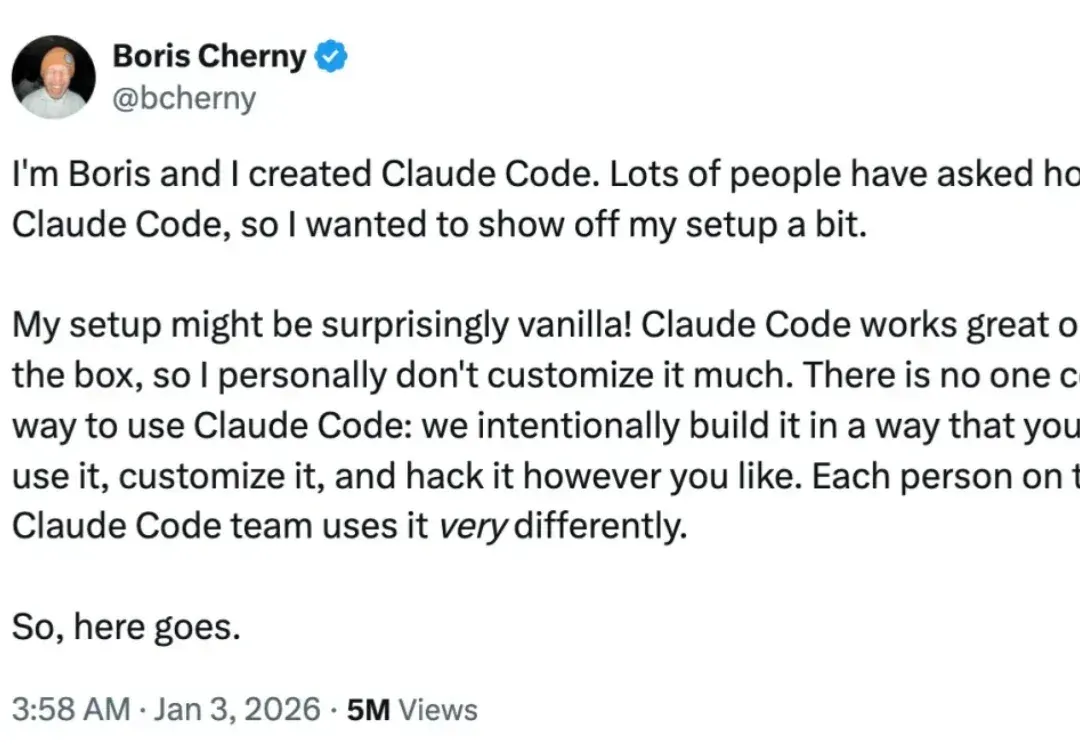
2026 新年第三天,Claude Code 创建者、负责人 Boris Cherny 开展「线上教学」,亲自示范他自己使用这个 AI 编程工具的工作流。
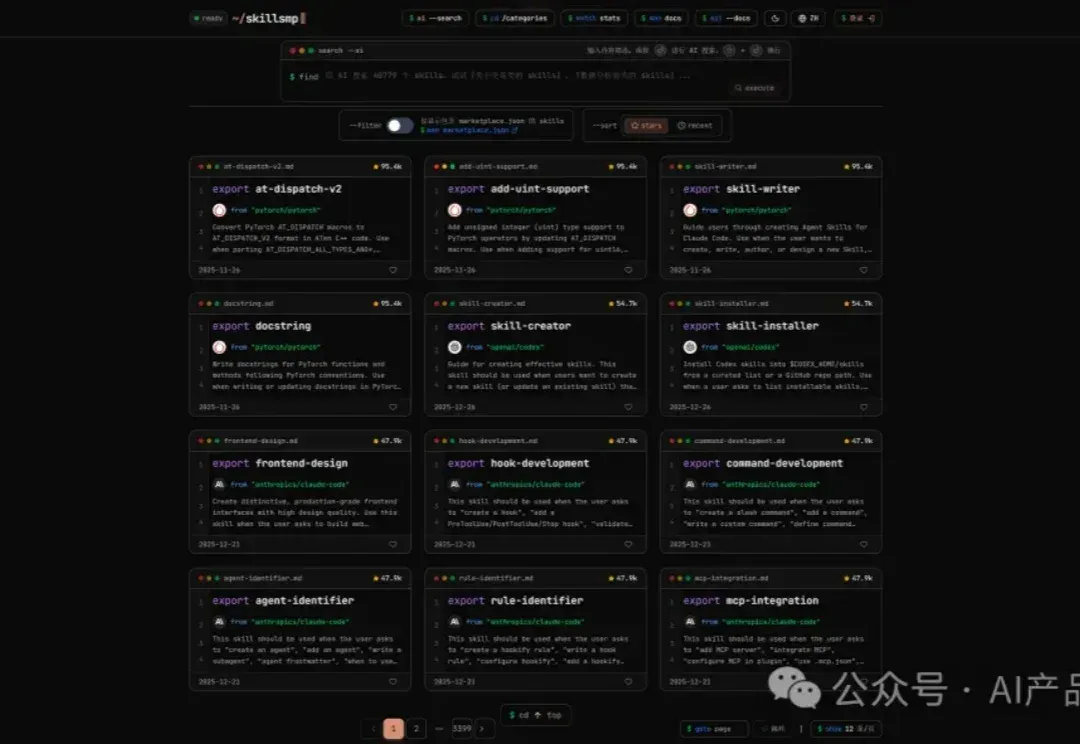
最近火的一塌糊涂的 Skills 很多群友在问是啥东东
在深入了解如何领取赠金之前,让我们首先认识一下Google Cloud和Vertex AI这两项核心服务:
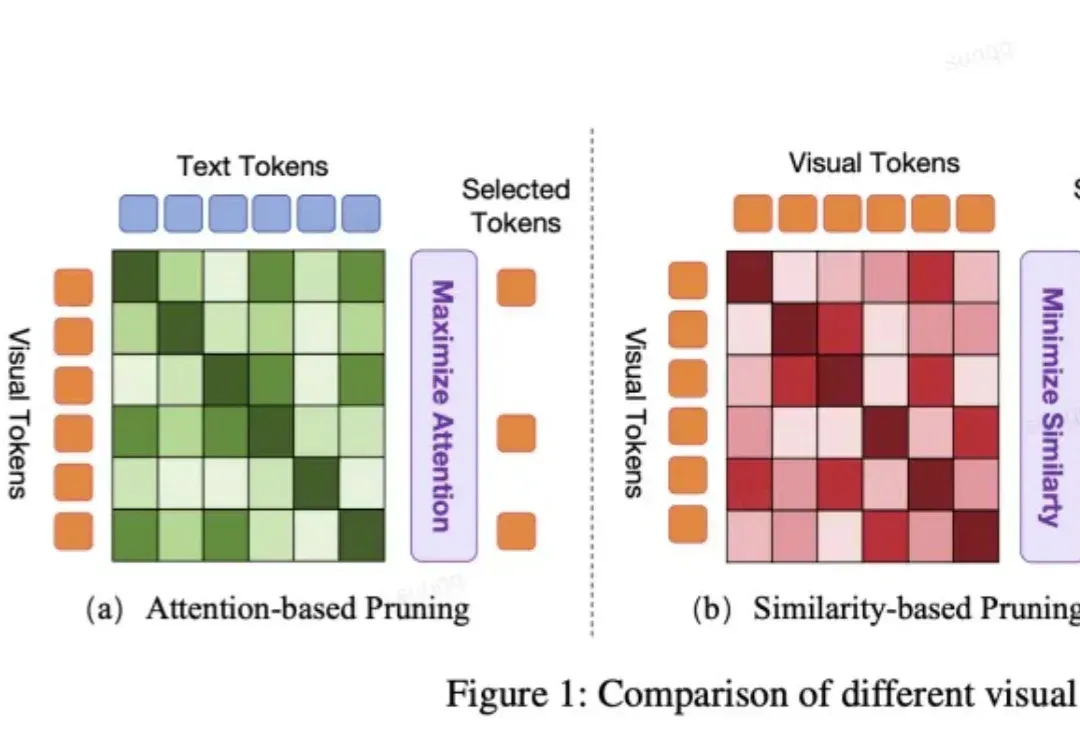
VLA 模型正被越来越多地应用于端到端自动驾驶系统中。然而,VLA 模型中冗长的视觉 token 极大地增加了计算成本。但现有的视觉 token 剪枝方法都不是专为自动驾驶设计的,在自动驾驶场景中都具有局限性。
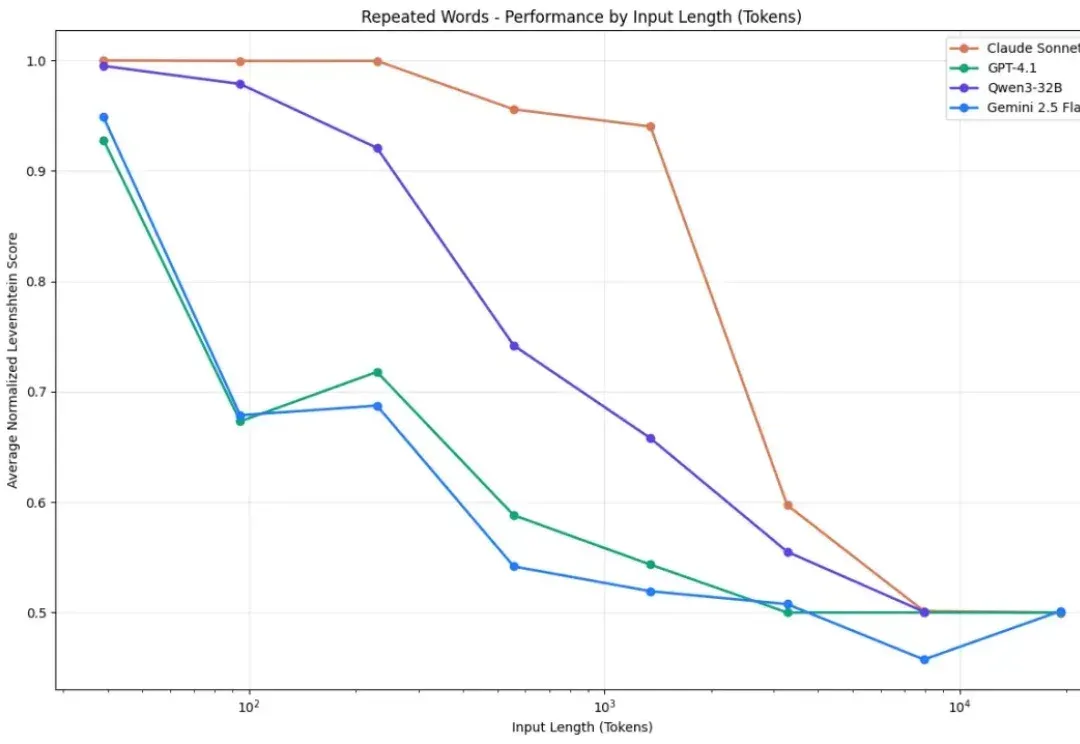
新年伊始,MIT CSAIL 的一纸论文在学术圈引发了不小的讨论。Alex L. Zhang 、 Tim Kraska 与 Omar Khattab 三位研究者在 arXiv 上发布了一篇题为《Recursive Language Models》的论文,提出了所谓“递归语言模型”(Recursive Language Models,简称 RLM)的推理策略。
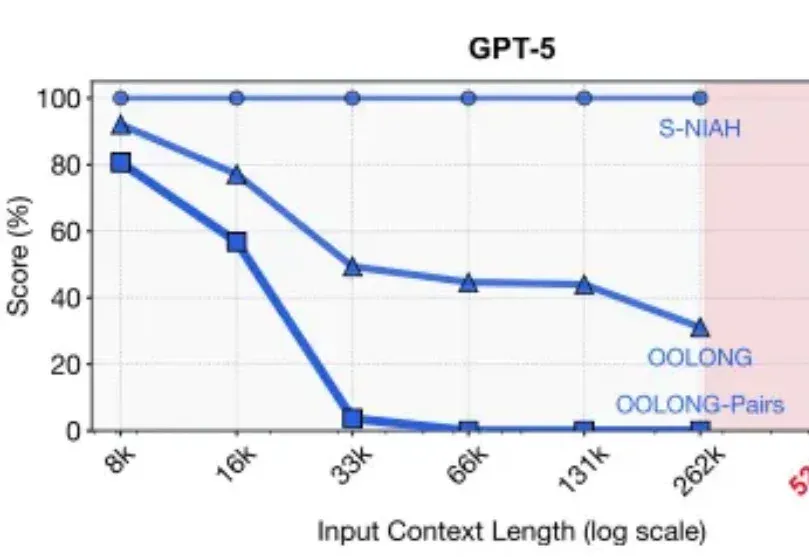
2025年的最后一天, MIT CSAIL提交了一份具有分量的工作。当整个业界都在疯狂卷模型上下文窗口(Context Window),试图将窗口拉长到100万甚至1000万token时,这篇论文却冷静地指出了一个被忽视的真相:这就好比试图通过背诵整本百科全书来回答一个复杂问题,既昂贵又低效。
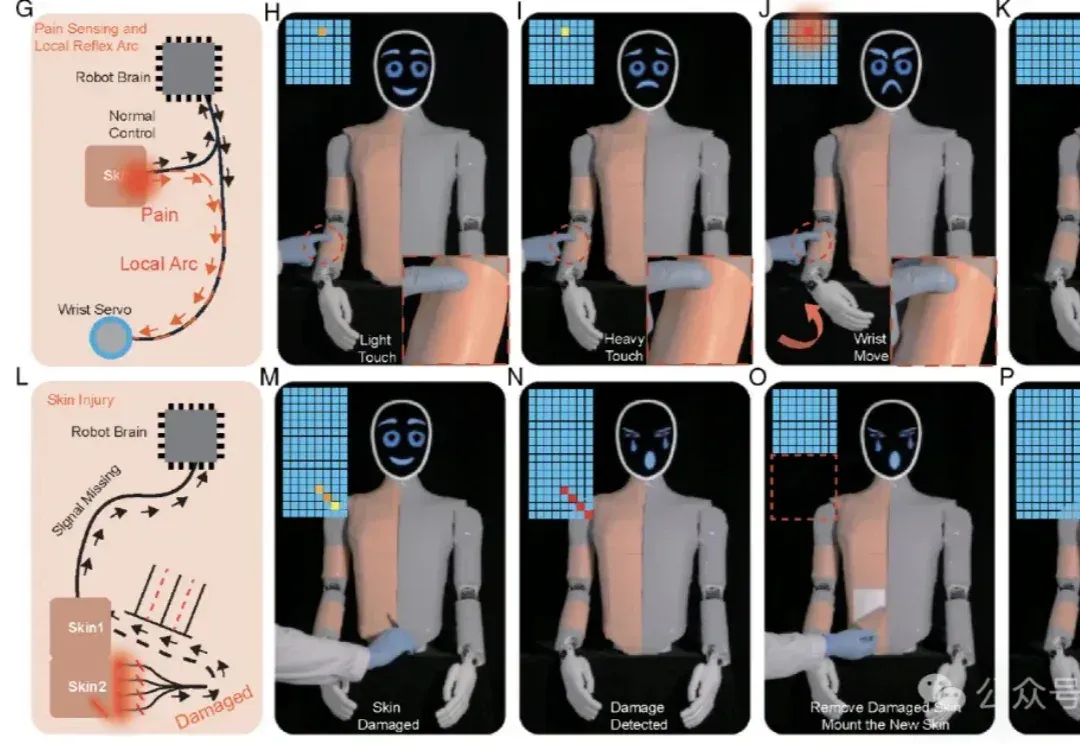
这下,你打人形机器人,它真的会「疼」了。
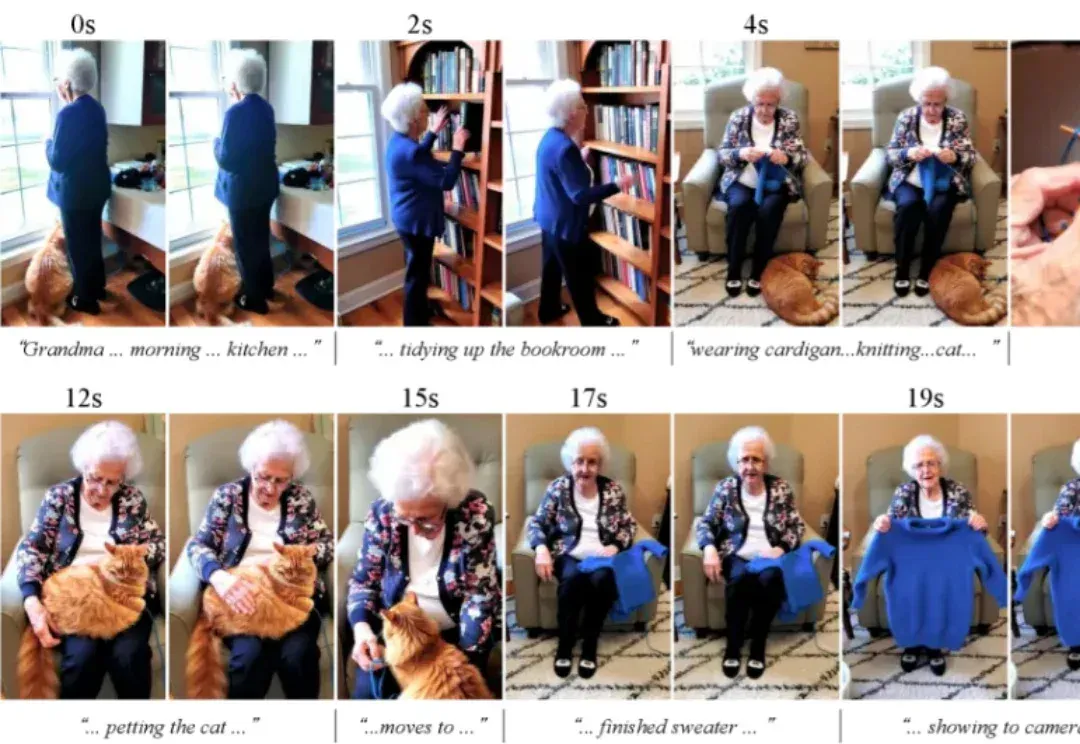
大部分的高质量视频生成模型,都只能生成上限约15秒的视频。清晰度提高之后,生成的视频时长还会再一次缩短。
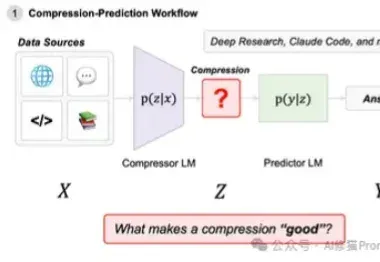
在近一年里,Agentic System(代理系统/智能体系统)正变得无处不在。从Open AI的Deep Research到Claude Code,我们看到越来越多的系统不再依赖单一模型,而是通过多模型协作来完成复杂的长窗口任务。
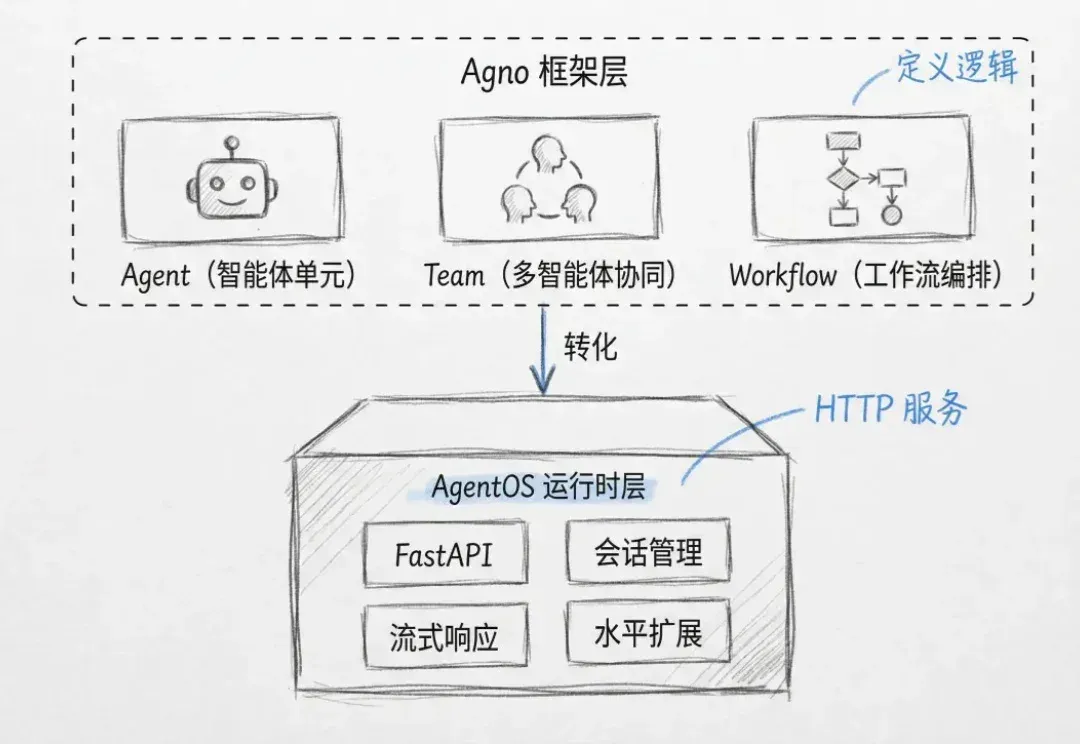
今天还是聊聊生产级agent怎么搭这回事。
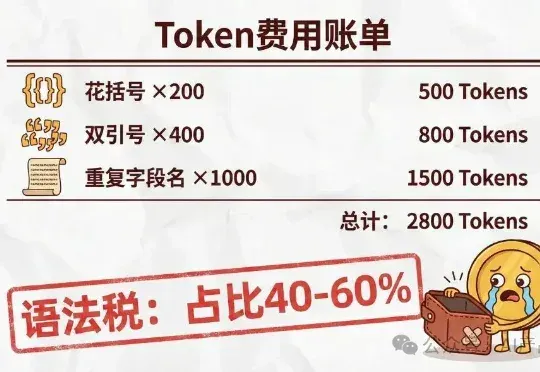
最近在研究 RAG 系统优化的时候,发现了一个有意思的格式叫 TOON。全称是 Token-Oriented Object Notation,翻译过来就是面向 Token 的对象表示法。
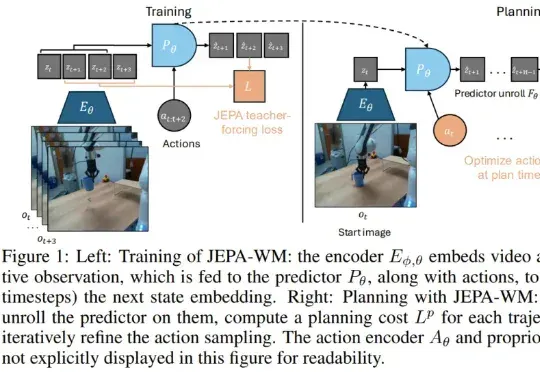
真正的挑战在于,如何在错综复杂的原始视觉输入中提取抽象精髓。这便引出了本研究的主角:JEPA-WM(联合嵌入预测世界模型)。从名字也能看出来,这个模型与 Yann LeCun 的 JEPA(联合嵌入预测架构)紧密相关。事实上也确实如此,并且 Yann LeCun 本人也是该论文的作者之一。
近日,腾讯微信 AI 团队提出了 WeDLM(WeChat Diffusion Language Model),这是首个在工业级推理引擎(vLLM)优化条件下,推理速度超越同等 AR 模型的扩散语言模型。
近年来,大模型的应用正从对话与创意写作,走向更加开放、复杂的研究型问题。尽管以检索增强生成(RAG)为代表的方法缓解了知识获取瓶颈,但其静态的 “一次检索 + 一次生成” 范式,难以支撑多步推理与长期
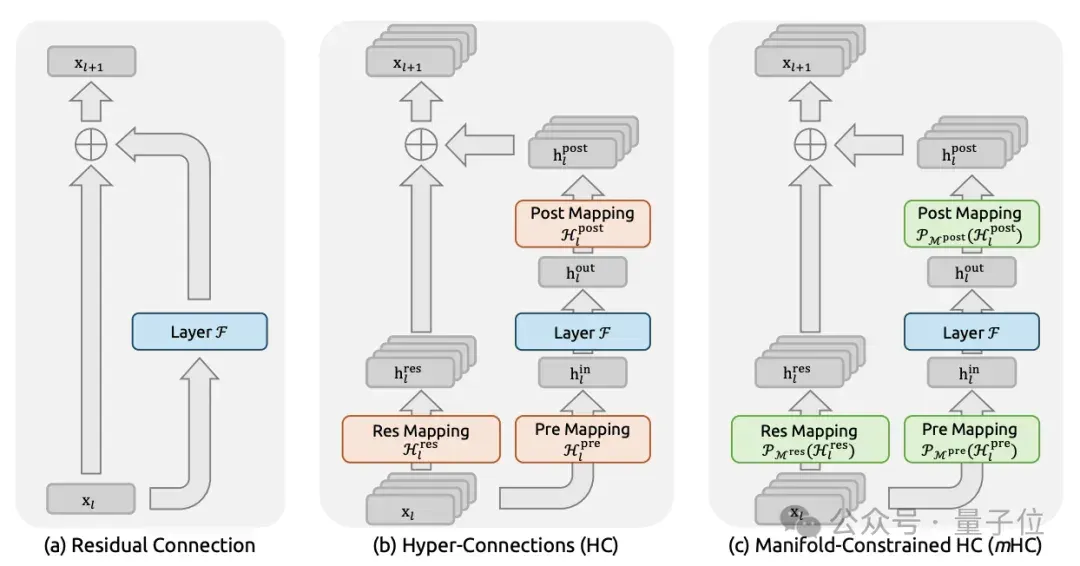
2026年新年第一天,DeepSeek上传新论文。给何恺明2016成名作ResNet中提出的深度学习基础组件“残差连接”来了一场新时代的升级。残差连接自2016年ResNet问世以来,一直是深度学习架构的基石。
参与交流
了解加入交流群的方式,阅读内容无需登录。