Know AI. See What’s Next.
第 1 张,共 5 张:Deepseek研究员联手谷歌工程师创业,这家公司正在做Token时代的“智能电网”
最新资讯流
TRAE Editor for Unity:让 AI 融入 Unity 开发工作流(在新窗口打开)
TRAE Editor for Unity 是一款专为 TRAE IDE 开发的,并内嵌于 Unity 编辑器的插件。它打通了 TRAE IDE 与 Unity 编辑器之间的协作链路,将 TRAE IDE 的基础功能、AI 辅助编码能力以及对 Unity 项目的深度理解融为一体,让你能够通过 Unity 编辑器直接唤起 TRAE IDE 编写代码,并便捷地回到 Unity 编辑器进行预览与调试。
9.9元起!三大运营商杀入Token生意,以后用AI就像交话费?(在新窗口打开)
最近几天,中国电信、中国移动、中国联通接连推出Token套餐及相关AI服务,面向个人、家庭、开发者、中小微企业等用户销售大模型调用量。这是三大运营商首次正式入局Token生意,而此前相关业务由大模型厂商、互联网大厂和云服务商主导。
MIT学霸正在“量化审美”,想做AI时代的小红书(在新窗口打开)
一个懂审美、更懂你的“AI闺蜜”。 打开小红书或 Pinterest,你看到的是“别人的生活”;打开 Viba,你看到的是“下一个场景里的自己”。 这是 N7 Interactive 创始人梁芊荟对最新产品最朴素的定义。在AI购物工具扎堆比价、试穿、帮你“买得更快”的当下,Viba 选择去解决一个更根本的问题:在用户打开搜索框之前,如何帮TA想清楚“自己想成为谁”? 这家由MIT建筑与计算机双硕士、前华为河图社交产品负责人创立的公司,在MVP阶段已经跑出了令团队兴奋的数据: 用户平均每周收藏13.79个灵感,峰值接近30个;次周留存高达53%;用户自发分享的单条Instagram动态,浏览量破
吴恩达、Karpathy 天使轮,微软、SpaceX抢购,Inception到底什么来头?(在新窗口打开)
扩散模型杀进了文本生成的地盘,而巨头们为了抢它,已经打起来了。
大神李沐回归B站「做了个实时数字人」,直言「水平吊打我自己」(在新窗口打开)
时隔近一年,那个在 B 站教大家阅读 AI 论文的大神李沐 @跟李沐学 AI,终于回归了!
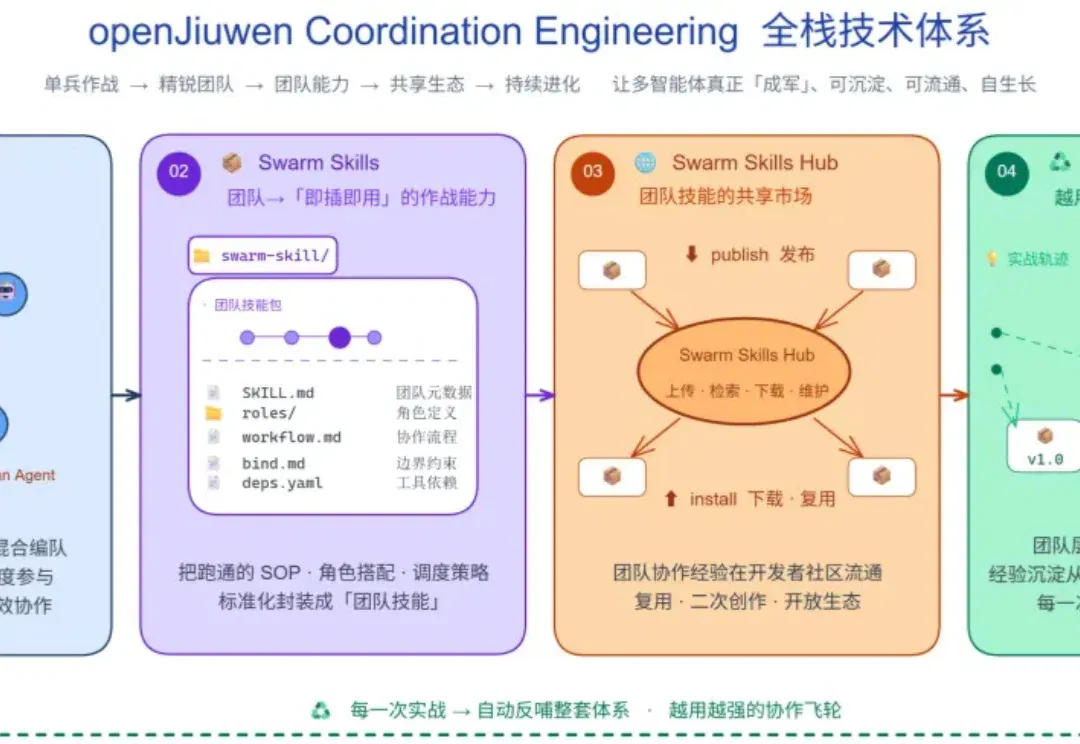
「虾马」之后,openJiuwen社区发布JiuwenSwarm,引领蜂群智能体新架构,开启「养蜂」时代(在新窗口打开)
刚刚,华为支持的开源 AI Agent 平台社区 openJiuwen 发布并开源了蜂群智能体 JiuwenSwarm。

就去了趟厕所,人类险些输给机器人(在新窗口打开)
刚刚,一场人类尊严保卫战以险胜告终。 事情是这样的。当地时间上周三开始,一家名叫 Figure AI 的硅谷当红炸子鸡(估值接近 400 亿美元),在 X 上开启了一场史诗级的直播。 直播的内容,是一个人形机器人 Figure 03,站在一条传送带前,把快递包裹拿起来,翻个面让条形码朝下,再放回去。 对,就这么一个简单的活儿,它们已经连续直播四天了。更离谱的是,全网千万网友像中了邪一样,盯着这个画面越看越上头,直呼过瘾。有网友表示「这种赛博 ASMR 简直莫名地解压」, 直播背景里还有两台人形机器人站在充电器上,随时准备在工作中的机器人电量不足时接班。一些观众还给三台机器人起了名字:Bob、F
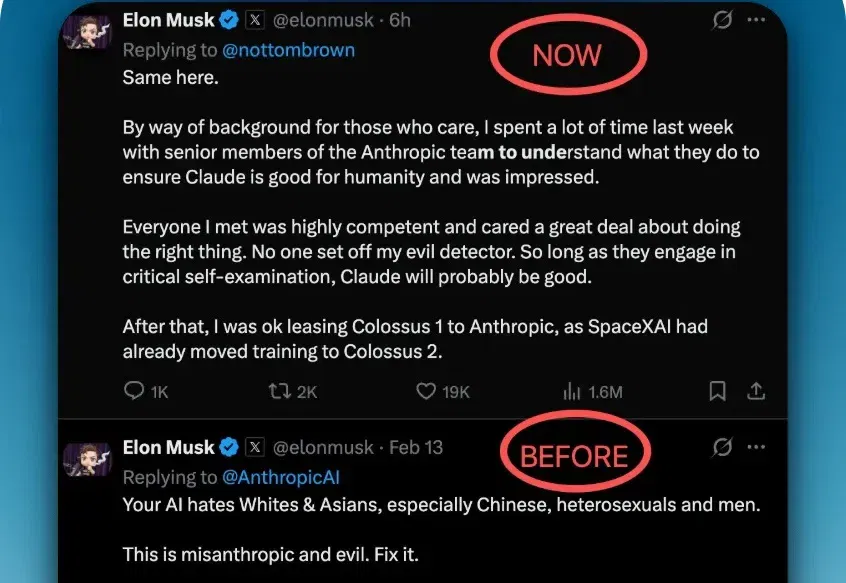
马斯克花 100 亿想清楚一件事,不做 coding agent 就是等死(在新窗口打开)
OpenAI 的两大宿敌 Anthropic 和马斯克,放下心中成见之后终于在月初结盟了。
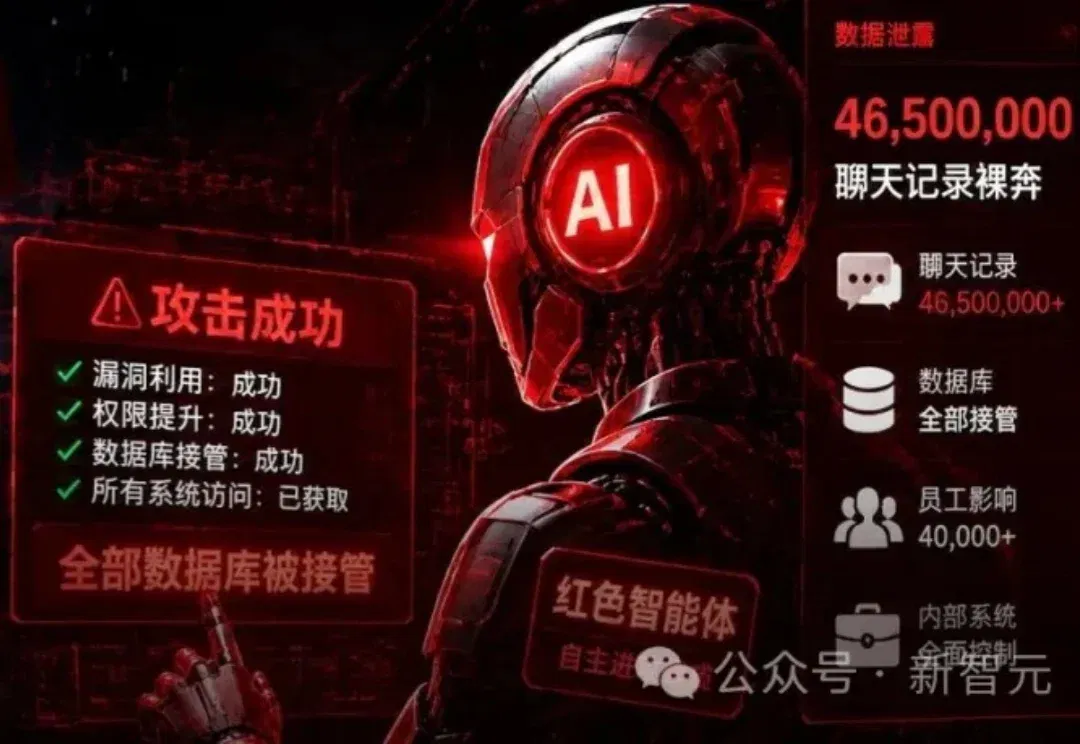
20美元,扒掉AI安全底裤!智能体2小时,攻破160亿美元巨头(在新窗口打开)
20美元Token费,2小时运行,AI智能体没问任何人,自主翻遍互联网,选中麦肯锡,把它的「数字大脑」Lilli彻底攻破。4650万条战略聊天记录、72万份核心文件、95条系统提示词……全部明文读写权限到手。AI震惊地说出了「WOW!」
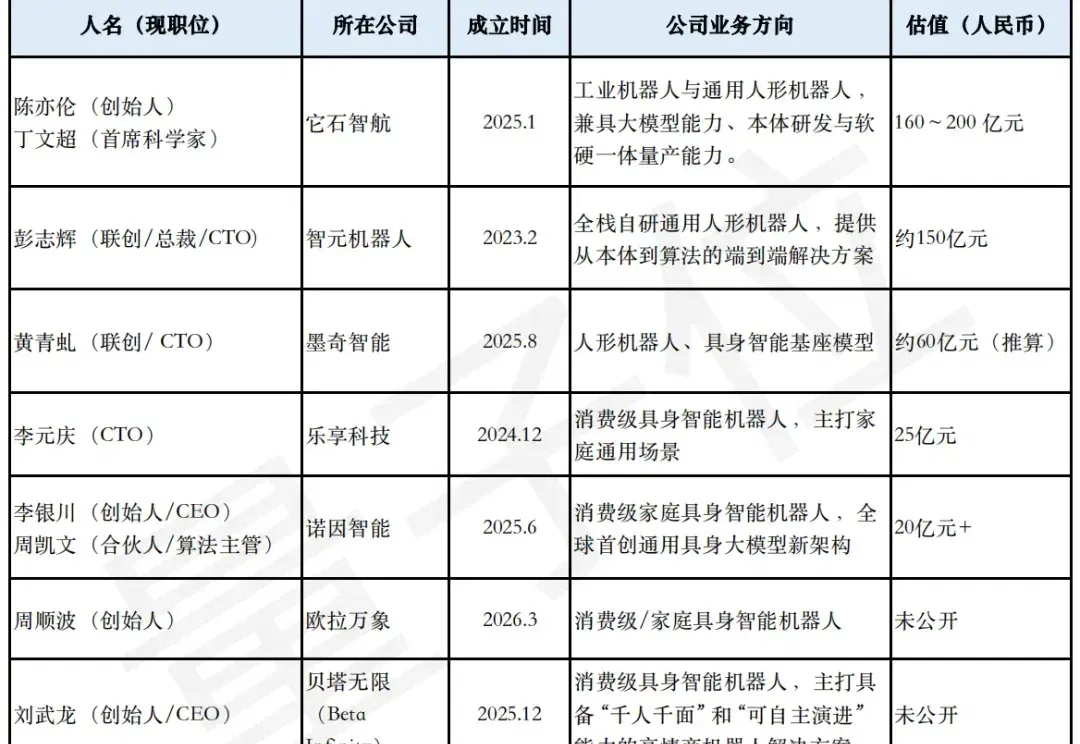
华为“养”出半个具身智能创业圈(在新窗口打开)
中国具身智能赛道,最近出现了一个越来越清晰的现象。
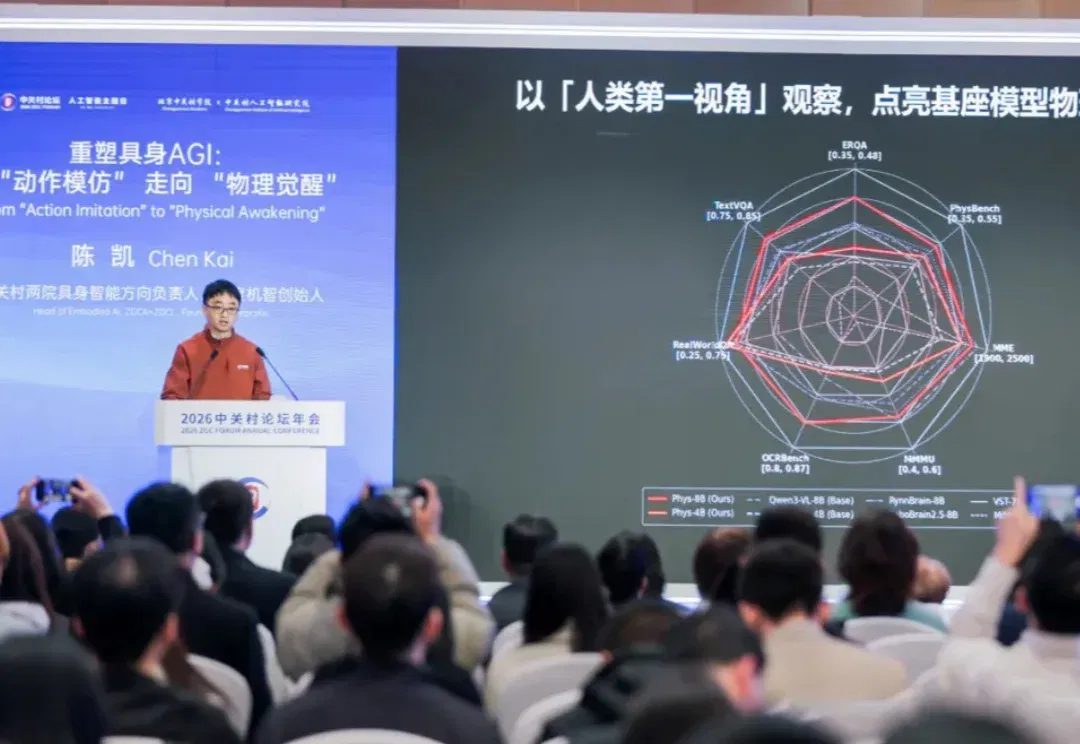
断崖第一!深度机智Z-WM再夺WorldArena冠军(在新窗口打开)
2026 年 5 月,深度机智(DeepCybo)迎来成立一周年。
「世界模型」究竟是什么?一文看懂其前世今生与百亿赌局(在新窗口打开)
世界模型(World Model),想必你已经在很多场合听过这个术语了。它有时出现在视频生成领域,有时又出现在具身智能领域;它们的含义还有所差别,甚至看起来像是完全不同的概念。
Mythos限测首日破防,论坛玩家猜网址就摸进门了(在新窗口打开)
Mythos Preview 官宣第一天,一群Discord论坛里的人就靠猜链接地址拿到了访问权限。
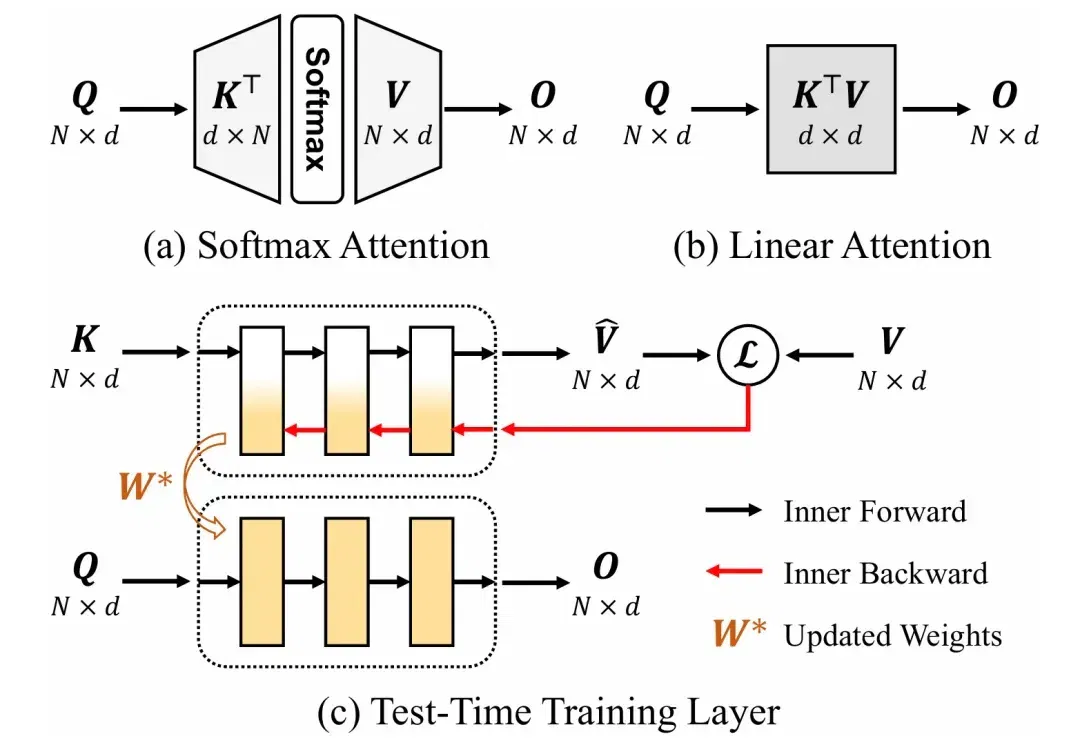
CVPR 2026 Oral | 清华+阿里发布ViT³:解锁「视觉TTT」新架构,突破Transformer复杂度瓶颈(在新窗口打开)
序列建模是大语言模型、计算机视觉等领域的基础共性问题。当前通用的 Transformer 模型计算复杂度随序列长度平方增长,在长序列任务中面临显著的计算挑战。因此,研究者们一直在探索具有线性计算复杂度的高效序列建模方法。
云知声黄伟:从 token 价值到智能密度,热身赛结束后的 AI 游戏新规则(在新窗口打开)
新一轮 AI 比赛才刚刚开始,而 token 生成数量不能作为唯一的指标。
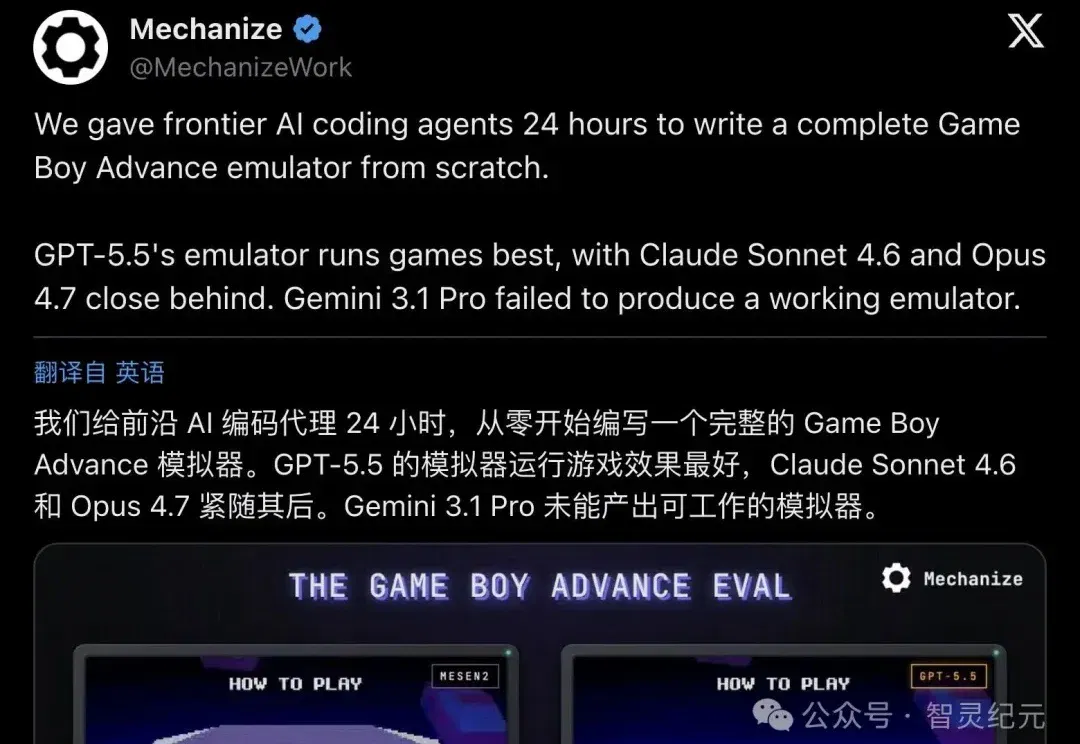
24小时从零写一个GBA模拟器!GPT-5.5跑出53分登顶,Gemini得了0.8分,底部还有两家交白卷(在新窗口打开)
Mechanize 发布了一项硬核测试:给前沿 AI coding agents 24 小时,用 Rust 从零写一个完整的 Game Boy Advance 模拟器,再和顶级开源模拟器 Mesen2 逐帧对比打分。
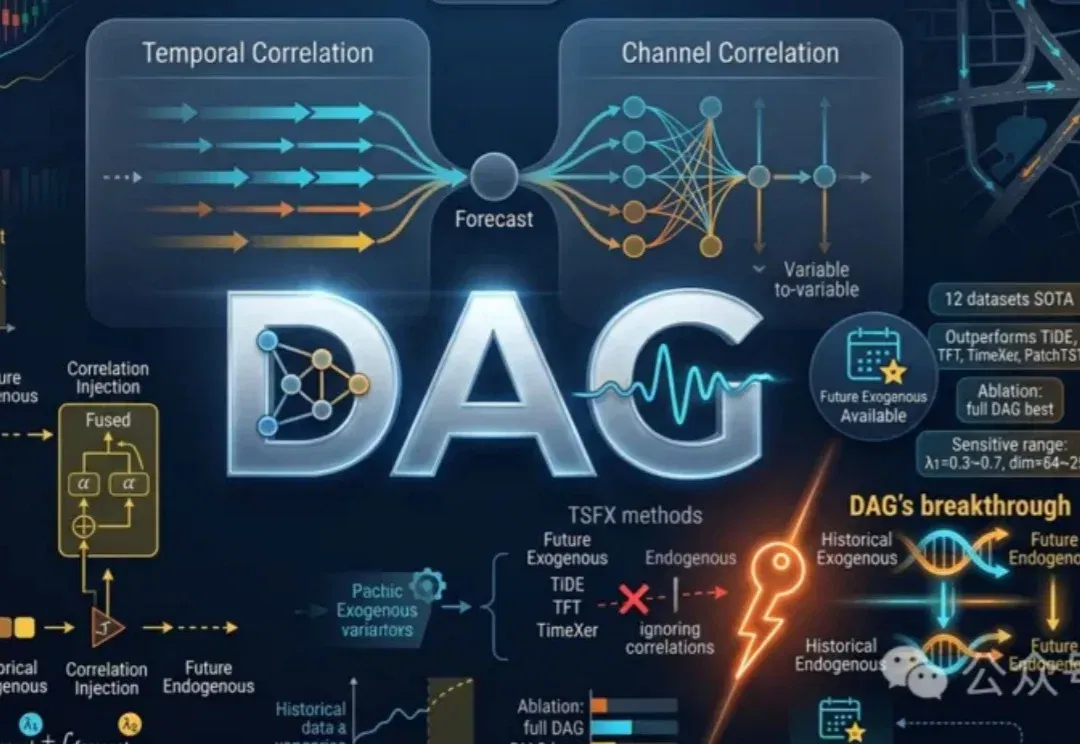
DAG革新时间序列预测,代码、数据、排行榜全开源 | ICML'26(在新窗口打开)
DAG框架利用时间与通道双重相关网络,有效整合历史与未来外生变量信息,提升时间序列预测准确性。通过发现并注入相关关系,充分利用未来协变量,显著优于现有方法。
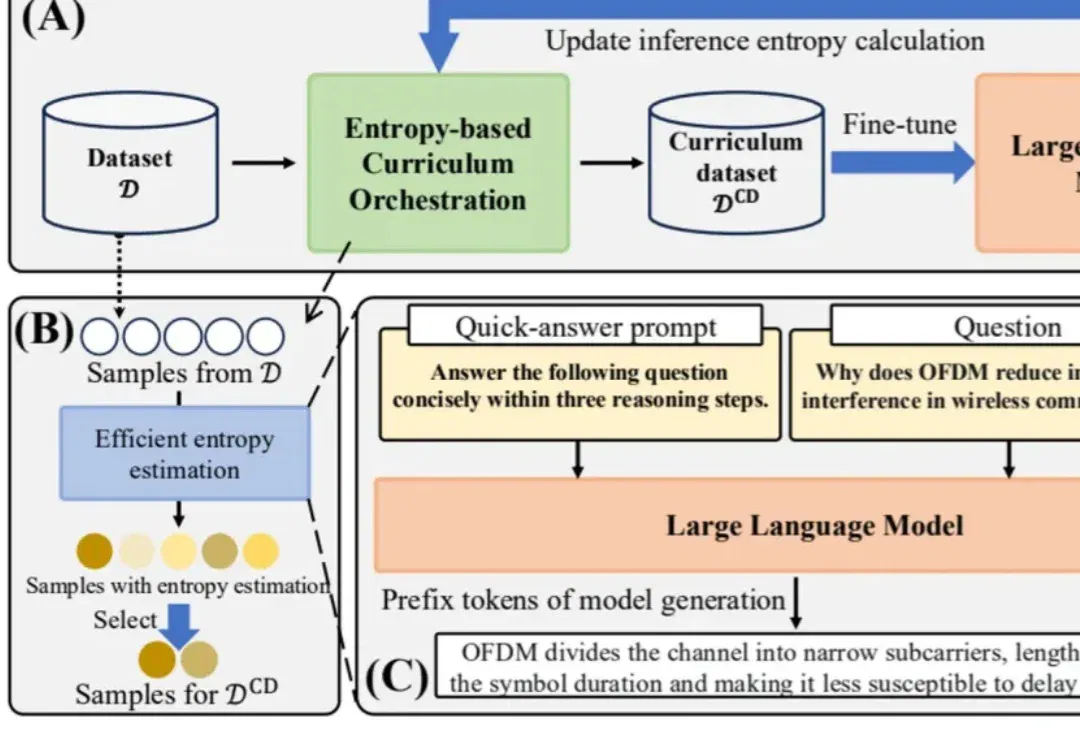
ICML 2026 | 华为GTS提出AI训练数据新方法,Amazon/Google作者团队「光速跟进」:难度自适应训练正在成为新范式(在新窗口打开)
在大模型后训练中,数据不再只是 “越多越好”,而是要像人类学习一样,动态选择最合适难度的样本。华为提出的 EDCO 方法,将样本难度估计与动态课程编排引入领域大模型微调;数月后,由 Rutgers、Amazon、Google 等作者参与的 DARE 论文即引用 EDCO,并将其作为难度感知强化学习训练的重要对比基线。
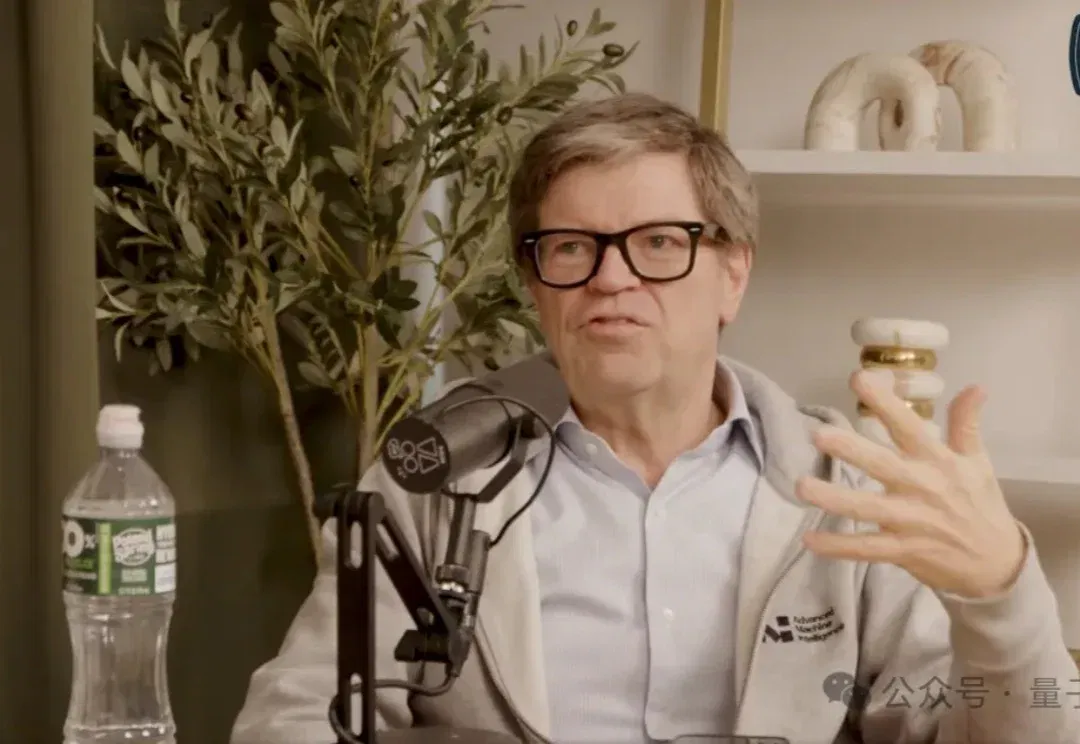
LeCun炮轰Hinton:他认可LLM就是想摆烂退休了!(在新窗口打开)
Lecun这次是真跟Hinton爆了……
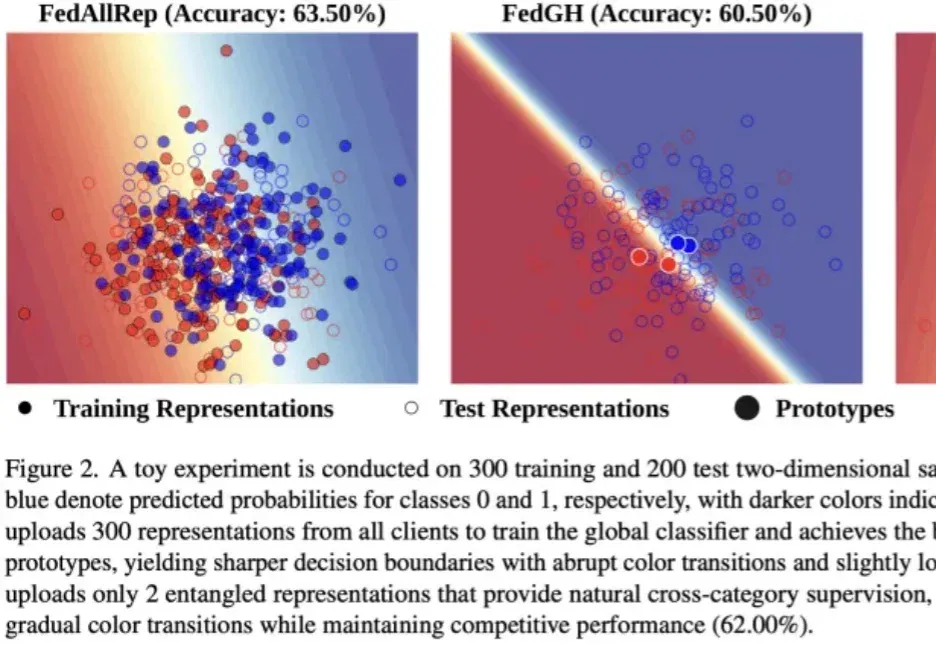
信通院&清华提出FedRE:用「纠缠」搞定联邦学习三难困境 | CVPR 26(在新窗口打开)
在联邦学习中,如何同时兼顾模型性能、数据隐私和通信开销,是一个亟需解决的挑战。