Know AI. See What’s Next.
第 1 张,共 5 张:MiniMax M3.1 Flash来了:Opus 5.5刷屏的绝活,它也能做
最新资讯流
Diogo Almeida:我为什么要做 Jev?(在新窗口打开)
过去一周,Jev 成了整个 AI 圈最火的新模型。
最卷一夜! Claude 5.5 发布,性能直逼 Fable,还要卷价格(在新窗口打开)
九月的新模型像下饺子一样接连登场,却大多只来得及各领风骚一两天,很快又被下一款抢走风头。
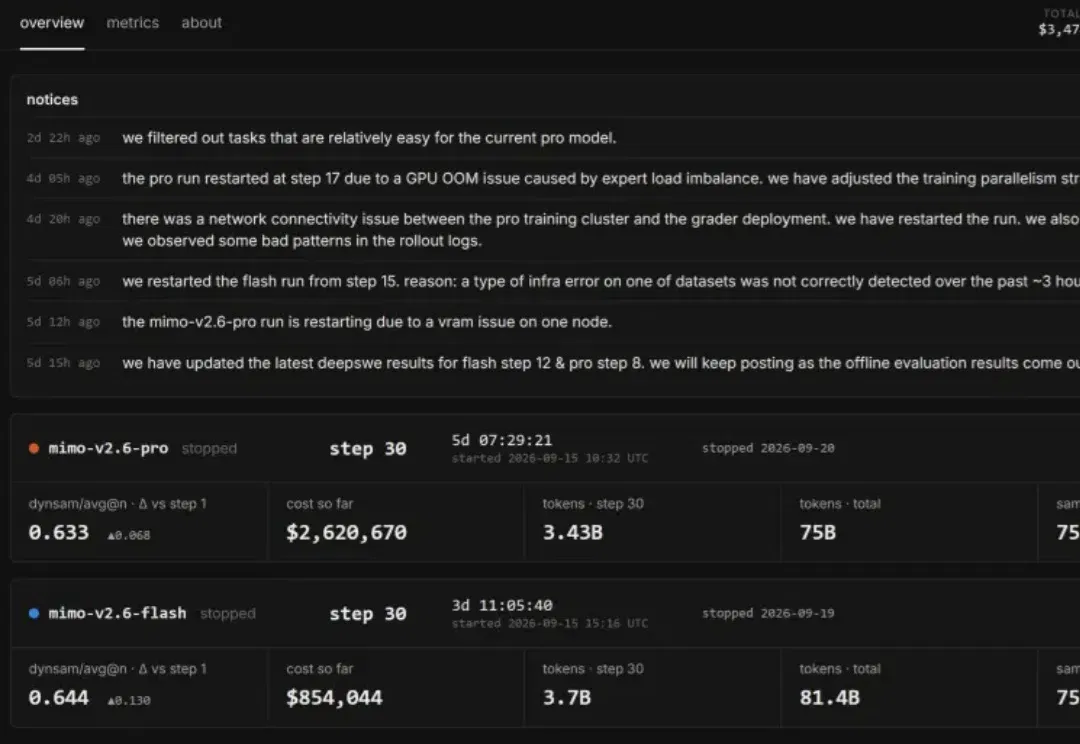
6天烧光2000多万,拿下开源第一!小米史无前例「炼丹直播」收官(在新窗口打开)
6天,2000多万,小米这场史无前例的「炼丹直播」终于尘埃落定。
罗福莉带小米登顶全球开源榜首!大规模RL立功,斩杀Grok 4.7(在新窗口打开)
大模型江湖变天了。 9月21日,小米MiMo团队正式发布并全面开源新一代MiMo V2.6系列,一口气端出三款模型——Pro、Flash、Ultraspeed,直接改写全球开源模型的格局。 MiMo V2.6 Pro在Artificial Analysis智能指数(AA Intelligence Index v4.3)中拿下 46 分,超过Kimi K3和Qwen3.8 Max。 全球开源模型第一、国产模型第一! 拉出AA榜单横着看:Fable 5.1得分53,GPT-6 Astra得分52.8,Opus 5得分50.7。 MiMo V2.6 Pro虽然还没追平这几位「天花板」,但已经稳稳站进
ChatGPT版Grok Bot代码曝光!OpenAI也要为你造不下班的AI同事(在新窗口打开)
你的ChatGPT里,可能马上就要多出一个「人」了!
具身智能开始拼高质量数据了!灵初Psi-R2.5用强 Pair Data重做训练链路(在新窗口打开)
两年前,一段机器人炒虾的视频在网上爆火。
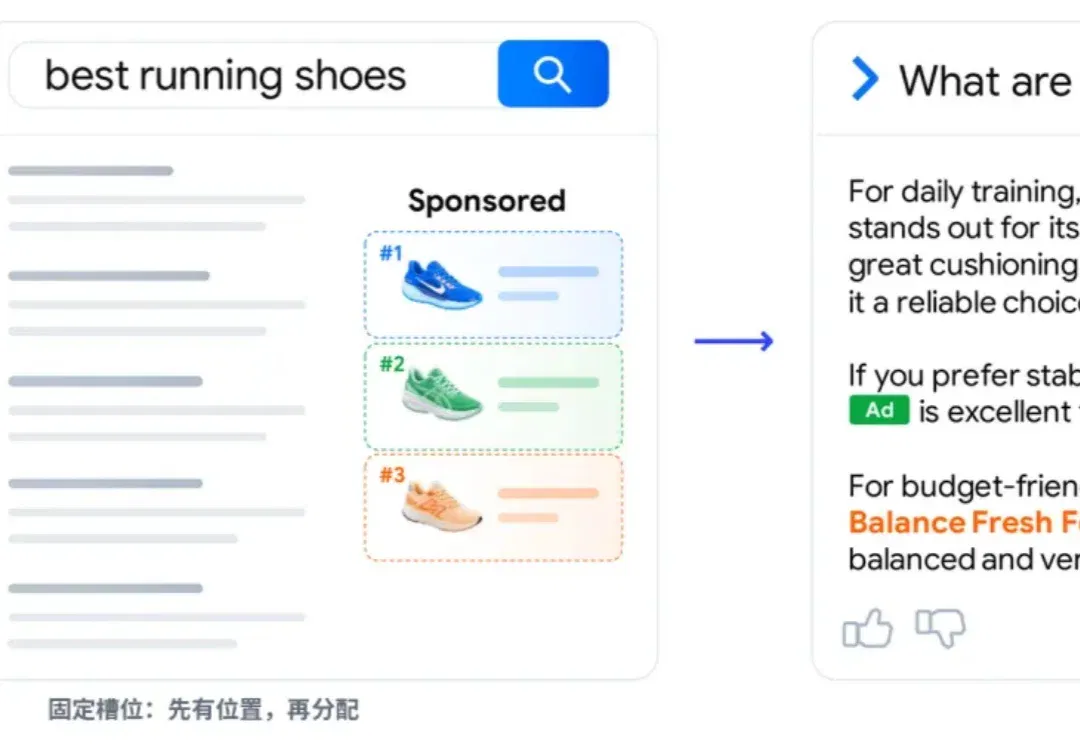
大模型正在吃掉搜索广告位,下一代广告该怎么做?人大高瓴、斯坦福把拍卖写进Token生成过程(在新窗口打开)
搜索结果里但凡出现 AI 摘要,用户点开普通网页的几率就几乎腰斩。Pew Research Center 对美国用户在 Google 上大规模浏览行为的分析发现:有 AI 摘要时,用户点击传统搜索结果的比例从 15%直接暴跌至 8%。
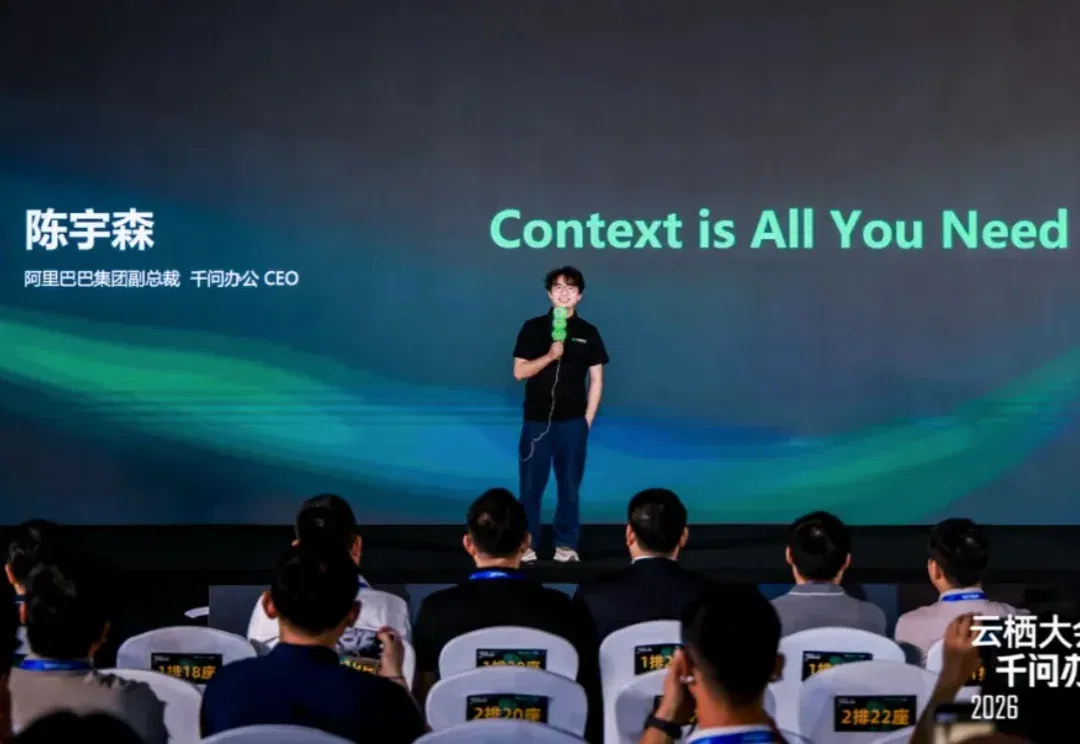
千问办公押注的企业上下文,是 Agent 时代的组织语言(在新窗口打开)
在大模型在拼命刷 Benchmark 卷编程的时候,「不能说话」的 Jev 却意外成了 AI 圈的新顶流,究其原因,大模型应用的价值正在从「生成什么」,进一步延伸到「能否理解复杂信息,并据此做出可靠判断」。
实测GPT-6 Sol和Luna,便宜模型已经能干到这一步了(在新窗口打开)
价格卷过DeepSeek Flash。 最近新模型扎堆上线,都挑不过来先测哪一个了。 昨晚还在折腾参加云栖大会时领的10块钱MIMO免费额度,选的是一个网站复刻任务,给它参考站,让它自己研究页面结构和效果,再在本地做出一个能运行的版本。 首轮输出的整体表现不算理想,原本计划在今天继续补这个案例,结果GPT-6 Sol和Luna来了,于是干脆换模型继续测。 而且这次OpenAI自己给出的重点也很明确。GPT-6 Sol的API输入价格是每百万token 2美元,输出10美元。 GPT-6 Luna更低,输入只要0.1美元,输出0.5美元。两者都比对应的GPT-5.6价格低了一半。 Luna也因此
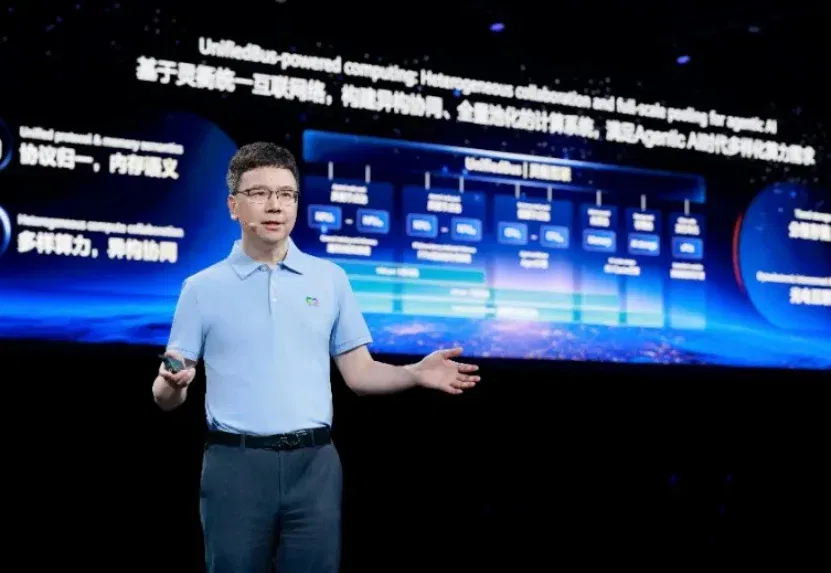
互联破局,架构重构:灵衢开启 Agentic AI 算力新范式,夯实智能时代算力基石(在新窗口打开)
当AI从“生成内容”迈向“自主执行任务”,一场计算架构的深层演进正在悄然发生。
推理芯片之战:聊聊Groq、Cerebras与OpenAI三大路径与Bill Dally的设计哲学(在新窗口打开)
本期节目对比了Groq、Cerebras与OpenAI在推理芯片上的三条技术路径,指出业界正围绕SRAM提升带宽性价比进行系统级异构收敛,并分享了英伟达首席科学家Bill Dally关于局部性与追求全局最优的芯片设计哲学。
Jev vs Decitron:同为决策AI,为什么不是一回事?(在新窗口打开)
最近,一个叫Jev的新模型突然火了。 它来自TypeSafe AI。这支有OpenAI背景的团队没有继续卷生成和推理,而是换了个方向:让AI直接做判断。 他们甚至把口号直接写成:Decisions, not strings(要决策,不要文本)。 Jev的走红,也让“Decision”(决策)重新成为AI圈的热门词。 但如果把时间线往前拨几个月,会发现这条趋势并不是今天才出现。 在Jev受到关注之前,国内已经出现了一条“决策AI”路线。今年6月,中科闻歌(此前被部分媒体称为“决策大模型第一股”)发布了通用决策大模型Decitron决策机,尝试将世界模型、多智能体推演、博弈与求解纳入统一的决策框架
YC 2026 Startup 复盘:硬件、数据的都在挣钱,应用团队开始自己训模型了(在新窗口打开)
今年,AI 创业到底往哪里走,变得比过去更难判断。 模型公司不断向应用层下探,一些 To C 产品刚找到的功能,可能下一次模型更新就会被直接覆盖。另一边,机器人、世界模型等概念又速升温,越来越多创业公
速递|AI数据创企Snorkel AI完成3.5亿美元E轮融资,估值达35亿美元(在新窗口打开)
AI数据创企Snorkel AI完成3.5亿美元E轮融资,估值达35亿美元,由Insight Partners和S32领投,其年化收入运行率已达3.75亿美元,较过去12个月增长18倍。
晚点独家丨2 亿日活之后,豆包开始收缩对话团队(在新窗口打开)
字节跳动旗下豆包在日活跃用户突破2亿后收缩对话团队,通用Session团队规模预计缩减约一半,对话方向的产品后训练团队也在缩减,部分人员转岗至商业化及飞书团队,其余被裁撤,反映出对话产品商业化承压下豆包业务重心的调整。
8万亿,梁文锋也开始卷“超大”(在新窗口打开)
DeepSeek正训练约2万亿参数的新模型,并计划将后续模型参数规模进一步推至8万亿,加入新一轮超大参数模型竞赛。
19个AI血战《星际争霸》!GPT-6全胜,照样打不过人类新手(在新窗口打开)
想太多,就连最聪明的AI也会被拖死。 43分钟、11138个推理token、6批指令——0个作战单位。 这是Grok 4.6在《星际争霸:母巢之战》里交出的一张绝望成绩单。 游戏中,把推理拉到最高档位xhigh的Grok,从开局苦思冥想到游戏结束,硬是连一个能上场打仗的兵也没造出来。 而在同一张榜单的另一头,GPT-6 Astra同样火力全开,18战18胜,胜率100%。 这两天,这份名为Brood War Bench的星际大模型榜单,在硅谷程序员扎堆的Hacker News上火了。 Brood War Bench榜单前10名。Astra开最高推理档xhigh,18战全胜,Grok三个档位全在
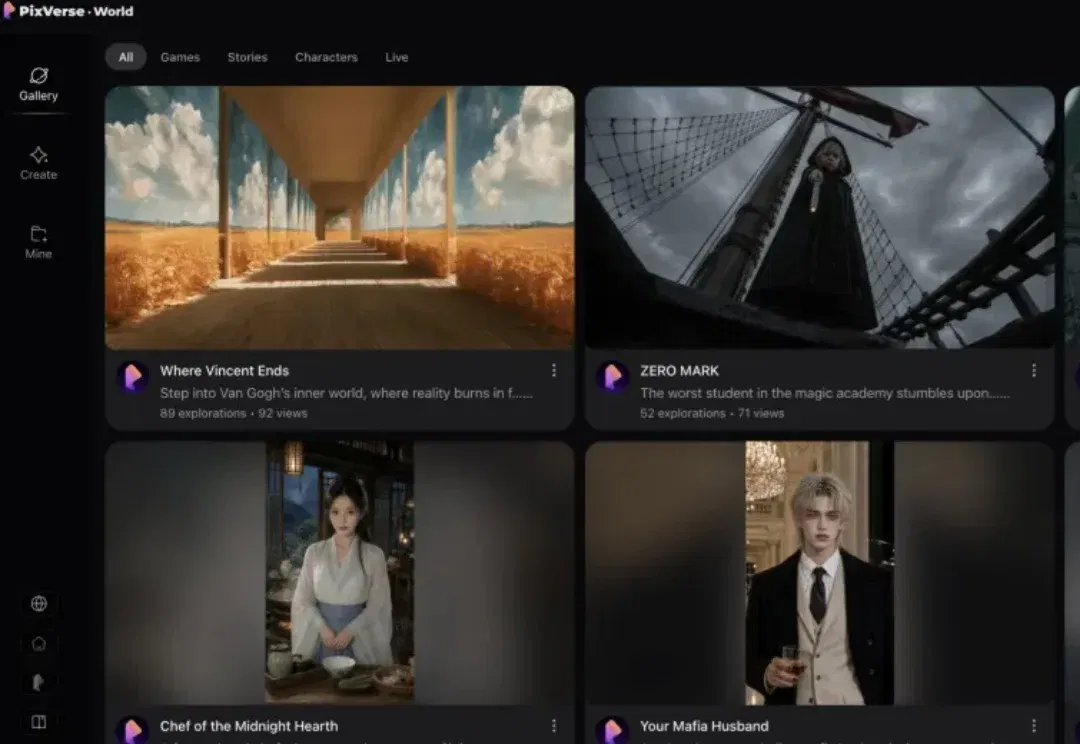
实时世界模型进入“全科生”阶段,PixVerse R2先交卷!(在新窗口打开)
这年头,实时生成的世界模型越来越会「造世界」了。
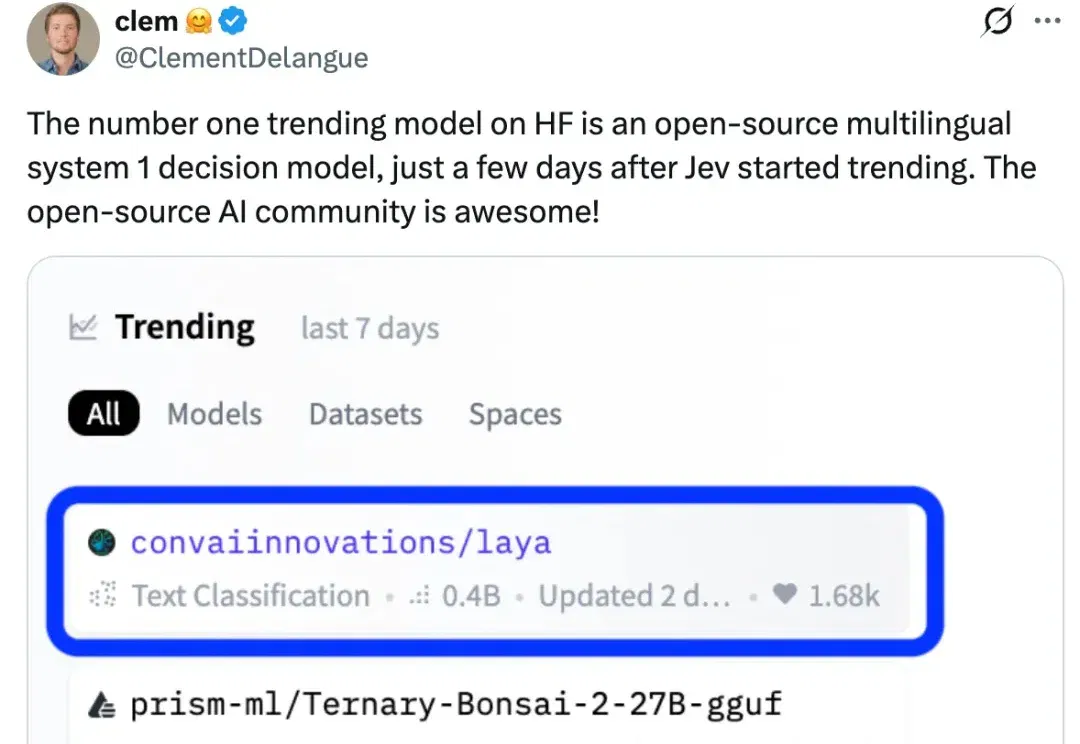
「开源版Jev」登上Hugging Face热榜第一(在新窗口打开)
这几天,Jev 模型在开发者社区引发讨论。
Z Potentials|专访Efflora,蒸馏收归内部、合成数据失效,安全极客去真实世界最深处为AI“探矿”(在新窗口打开)
过去一年,AI数据市场经历了几轮剧烈的主题切换:从标准Coding到垂直行业,从合成蒸馏到真实场景,从任务够长就是好数据到什么任务值得解。需求每两个月刷新一次,供给侧的生存法则也在同步重写。在这个过程中,一些原本隐身于产业链深处的角色开始浮出水面——数商,就是其中之一。