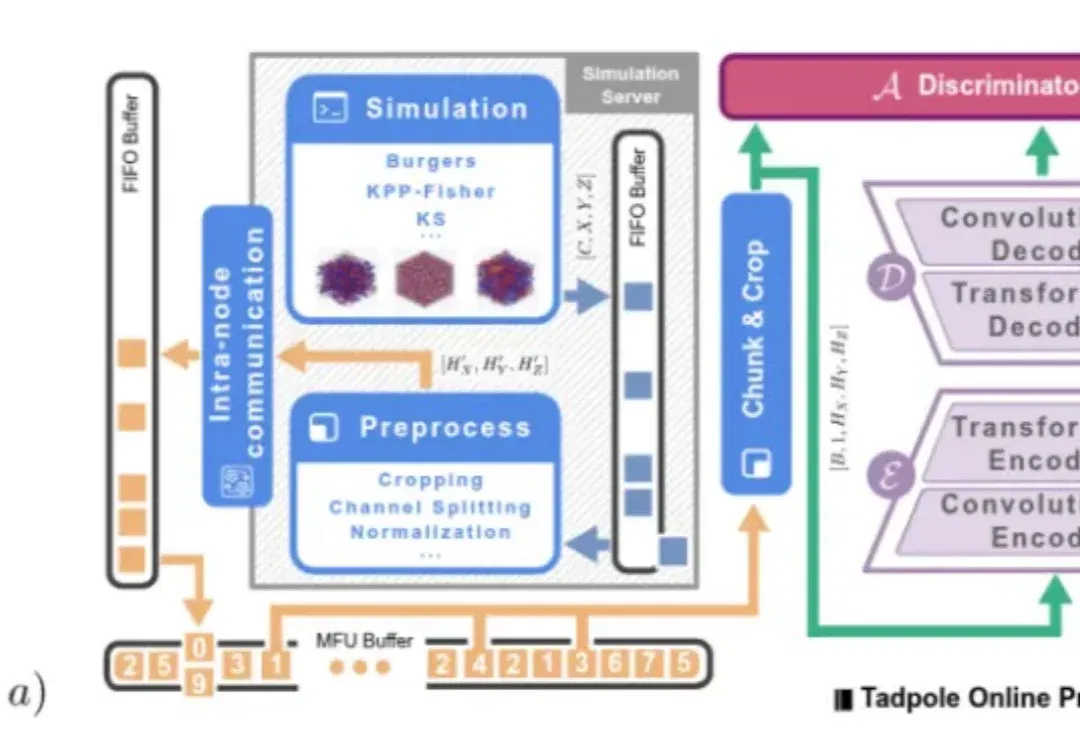
从「预测未来」到「理解世界」:Tadpole与一种新的科学基础模型思路 (opens in a new tab)
过去几年,“基础模型” 已经彻底改变了自然语言处理和计算机视觉。一个很自然的问题随之出现: 物理世界是否也能拥有类似的基础模型?
Categories
Practical guides to AI tools, models and related technologies.
过去几年,“基础模型” 已经彻底改变了自然语言处理和计算机视觉。一个很自然的问题随之出现: 物理世界是否也能拥有类似的基础模型?
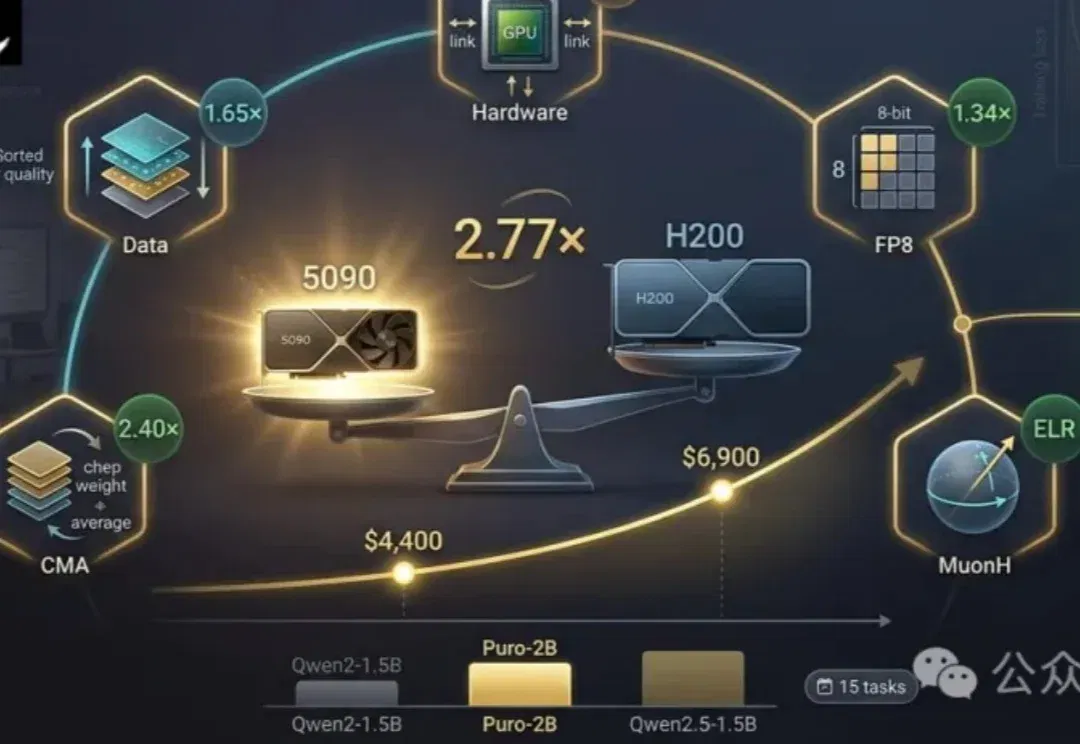
训不起2.8T的K3,玩够了124M的nanoGPT,想试试十亿参数、万亿token的预训练,门槛有多高?
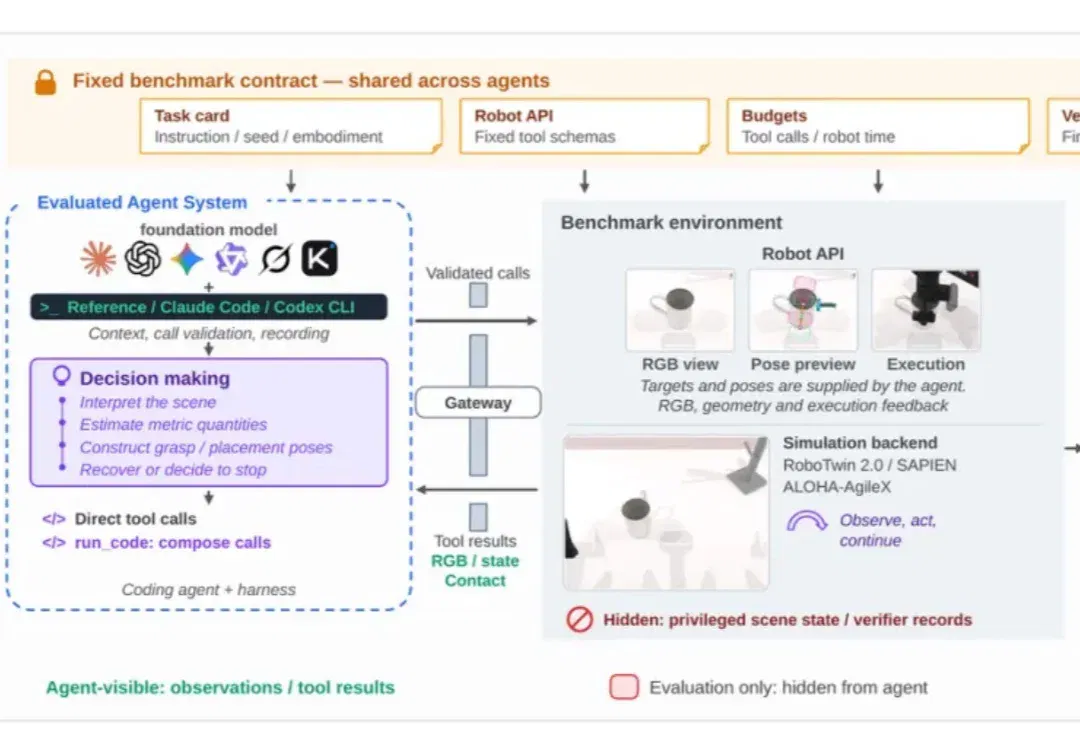
从视觉观察到策略生成,再到物理执行与完成判断,CodeActionBench 在统一条件下评测通用多模态 Agent 的机器人操作能力。在双臂仿真评测中,GPT-6 Astra (Codex CLI) 的尝试成功率达到 73.3%,Claude Opus 5 在 Reference harness 和 Claude Code 下分别取得 49.3% 和 45.3%。
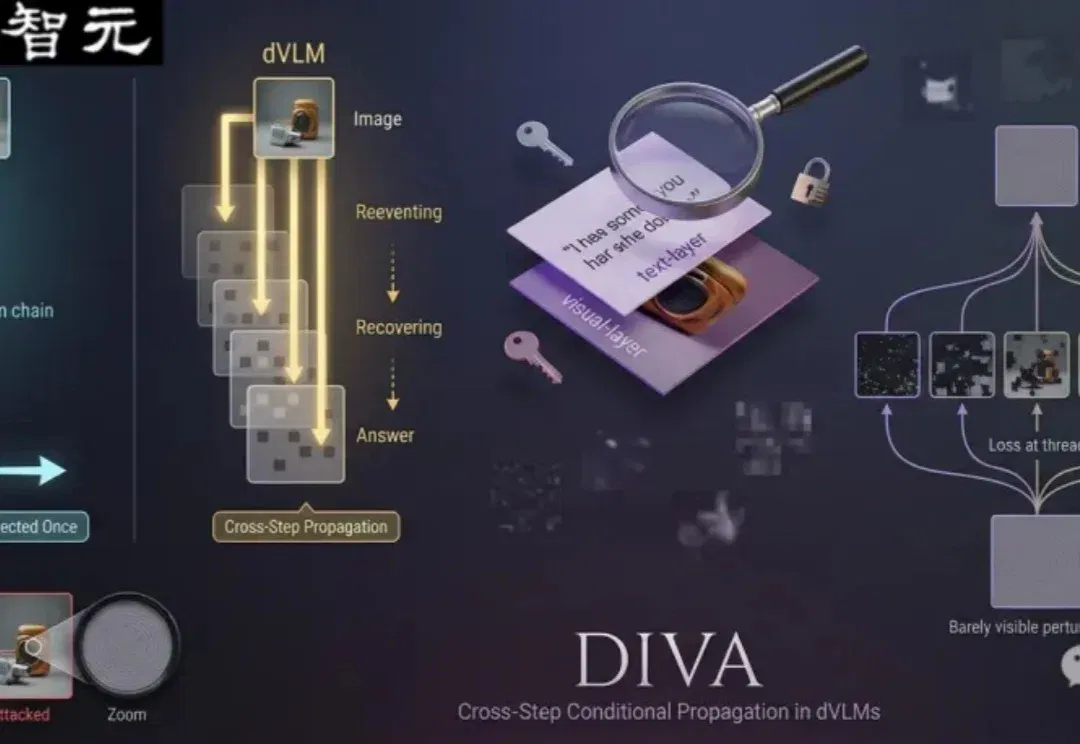
视觉语言模型已经进入办公助手、内容审核、机器人和智能终端等场景。
模型的思维链,让AI学会了用文字一步步推理;但科学家的思考,还发生在分子的三维空间、基因序列和实验曲线里。
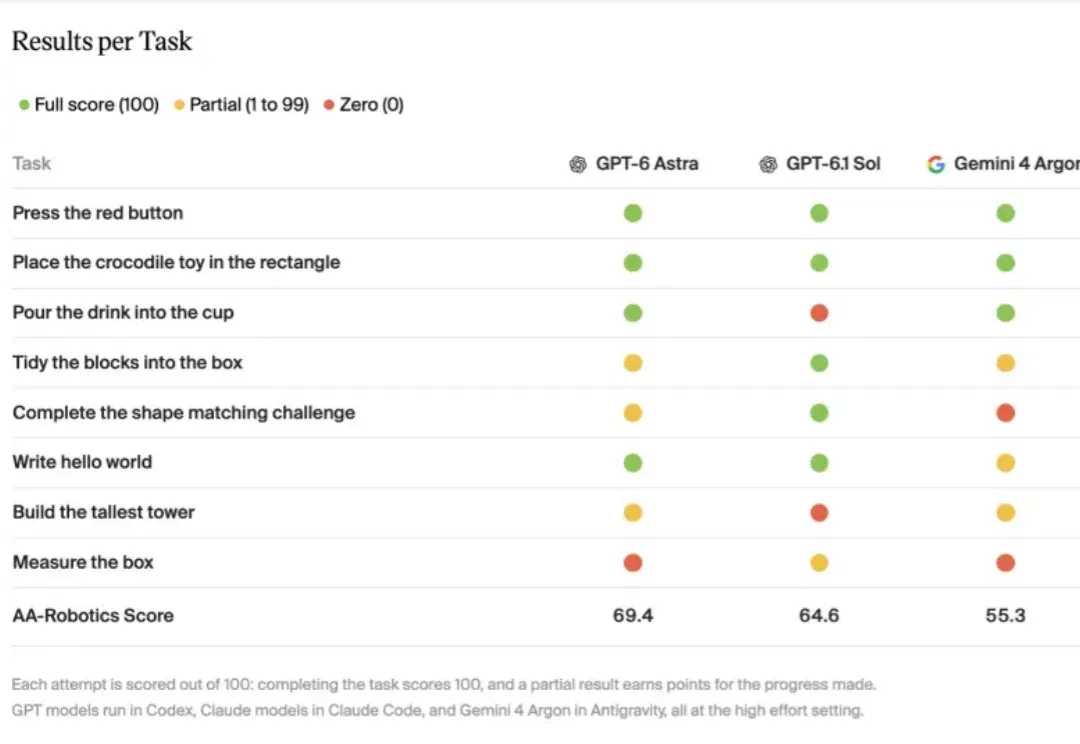
具身智能公司辛苦训练的「机器人大脑」,要被 GPT、Claude、Gemini 抢饭碗了?
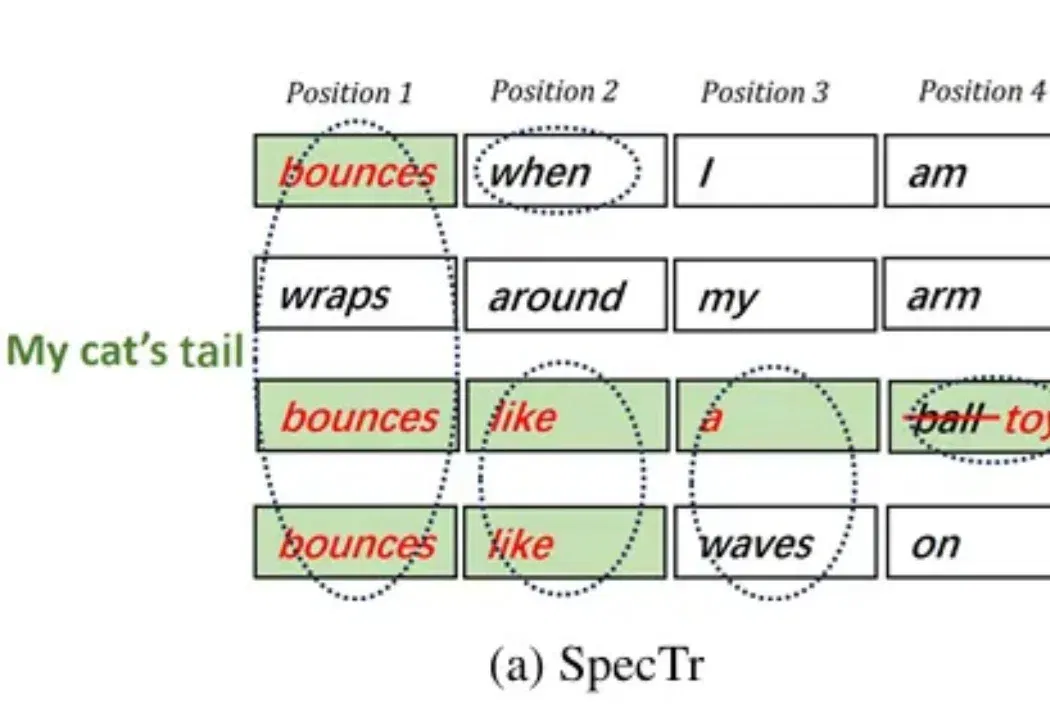
大语言模型的生成过程天然具有自回归特性,即模型基于已有上下文逐 token 预测并生成后续内容。随着模型规模不断增大,单步前向计算的开销也随之增加,使得自回归解码面临较高的推理延迟。
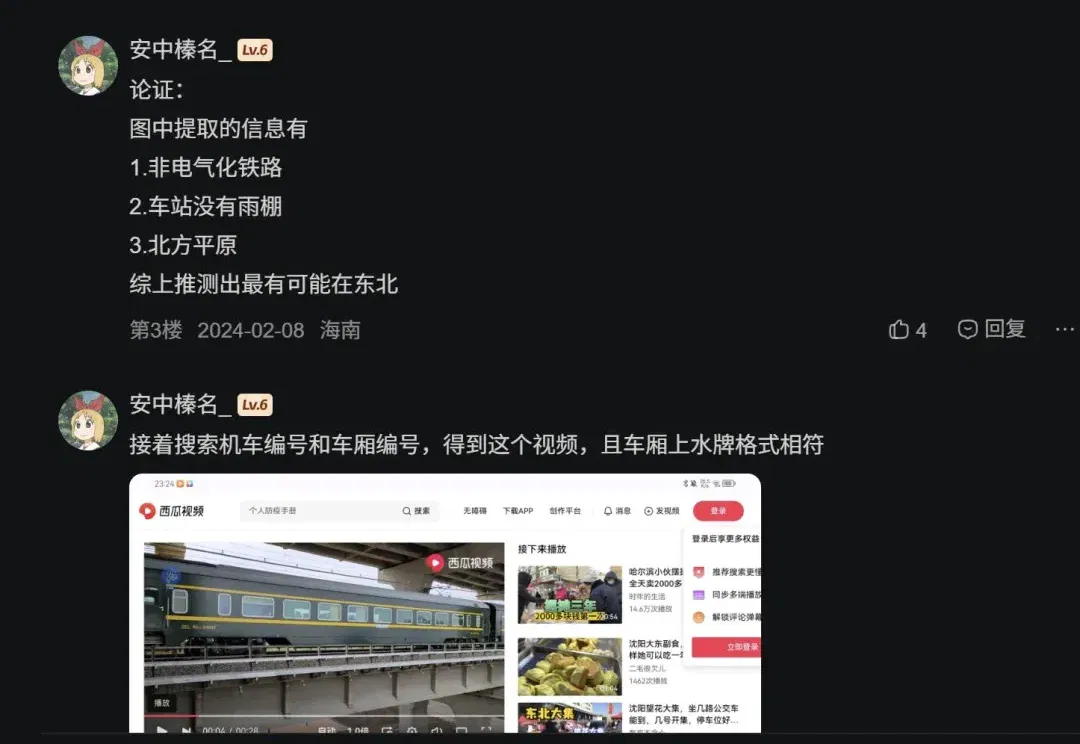
之前刷论坛的时候,经常看到有大佬用一张照片,就能推理出你人在哪。
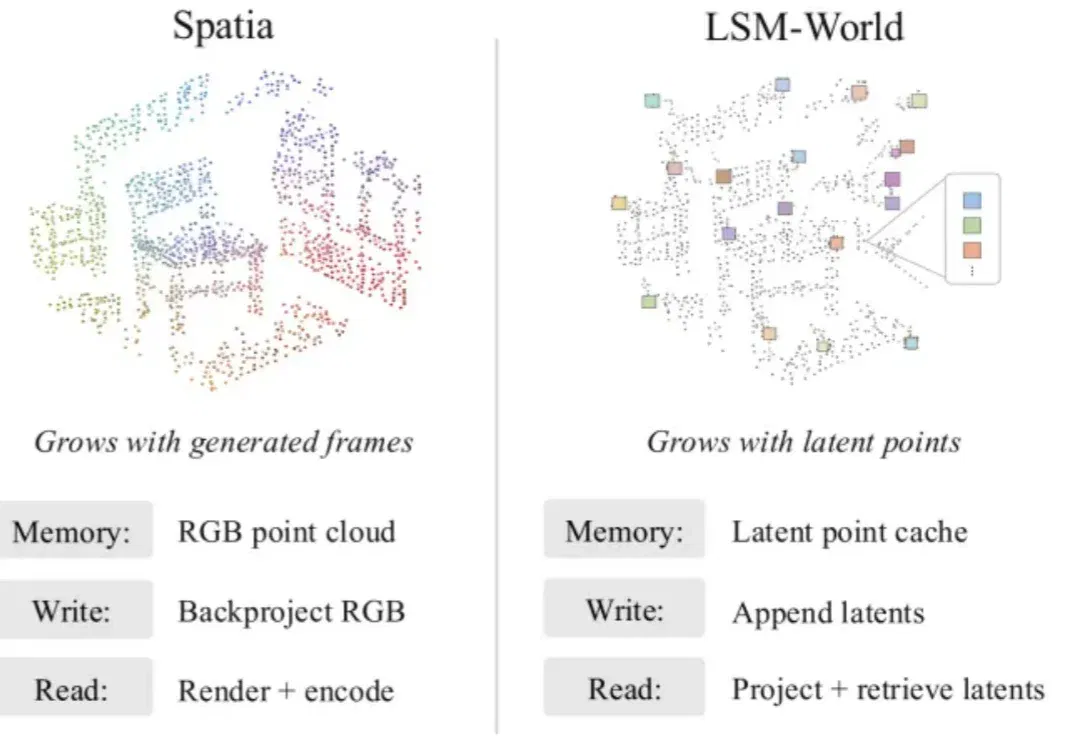
让视频生成模型沿着相机轨迹不断探索一个场景,并不算最难。真正困难的是:当镜头绕了一圈再次回到原点,房间的布局、家具的位置和墙面的纹理,是否还与最初一样?
包馄饨,对大多数人来说很简单:一手托皮,一手挑馅,对折,捏边,收口。很少有人意识到,这个过程里手掌始终在承托一张随时会变形的面皮,手指在不断感受馅料和面皮的回弹,两只手还要在恰当的时机交接。
Agent 执行长程任务时,代码、工具输出和交互记录不断累积,上下文也跟着变长。
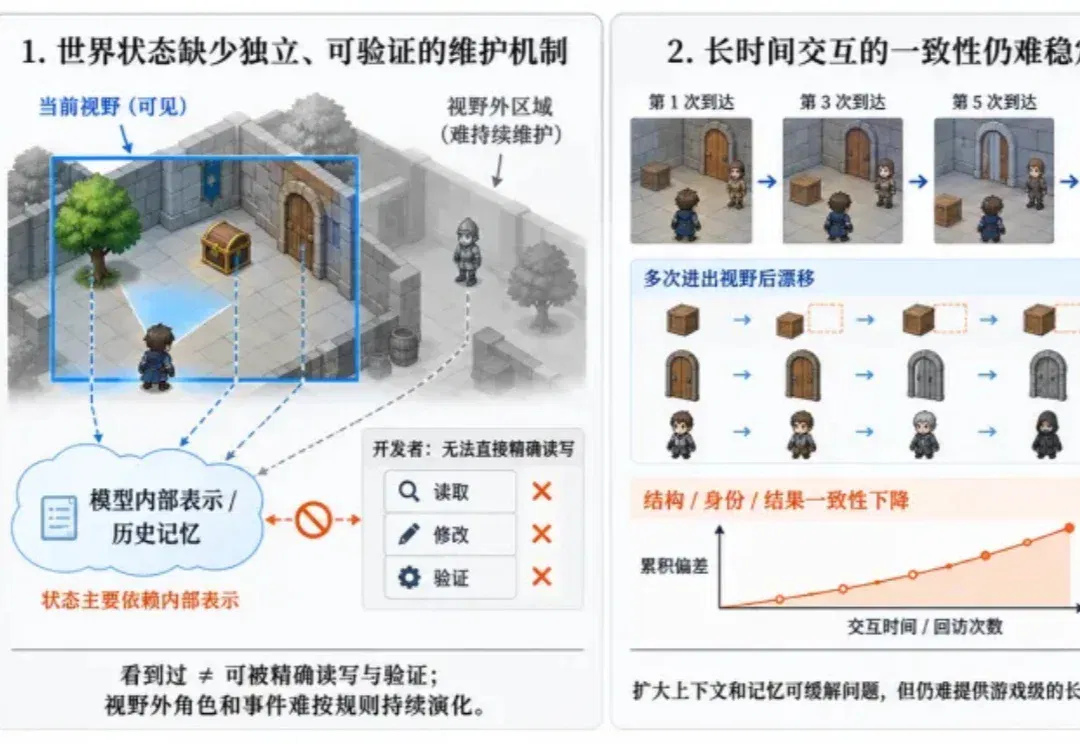
不er,印象中非常吃算力的「游戏世界模型」,居然就这样被塞进一张RTX 5090里了?!
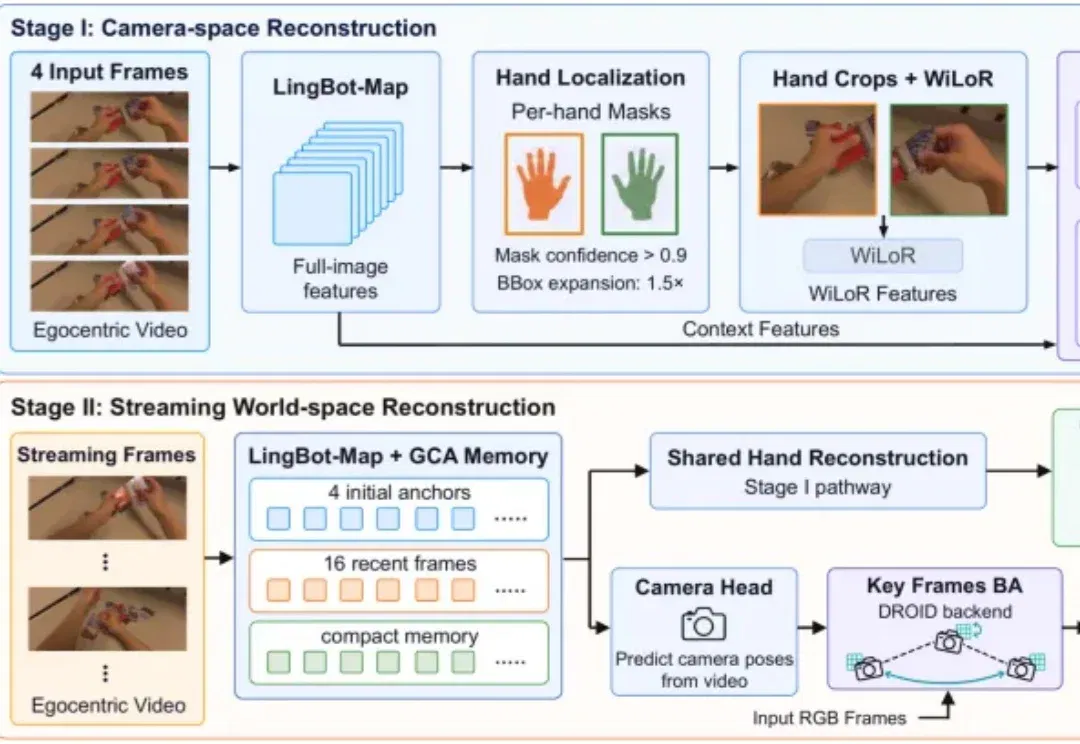
人类每天都在完成丰富的手部操作。通过头戴相机记录下这些过程,能为具身智能提供大量示范。
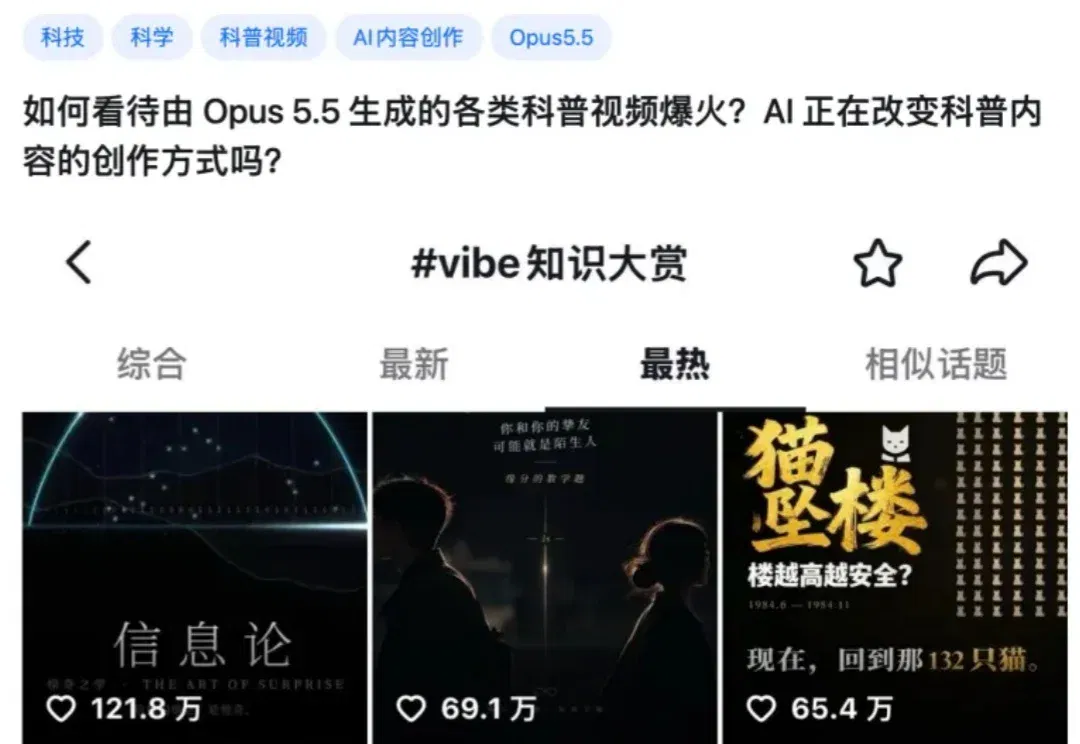
某乎上有篇热帖,如何看待由 Opus 5.5 生成的各类科普视频爆火?
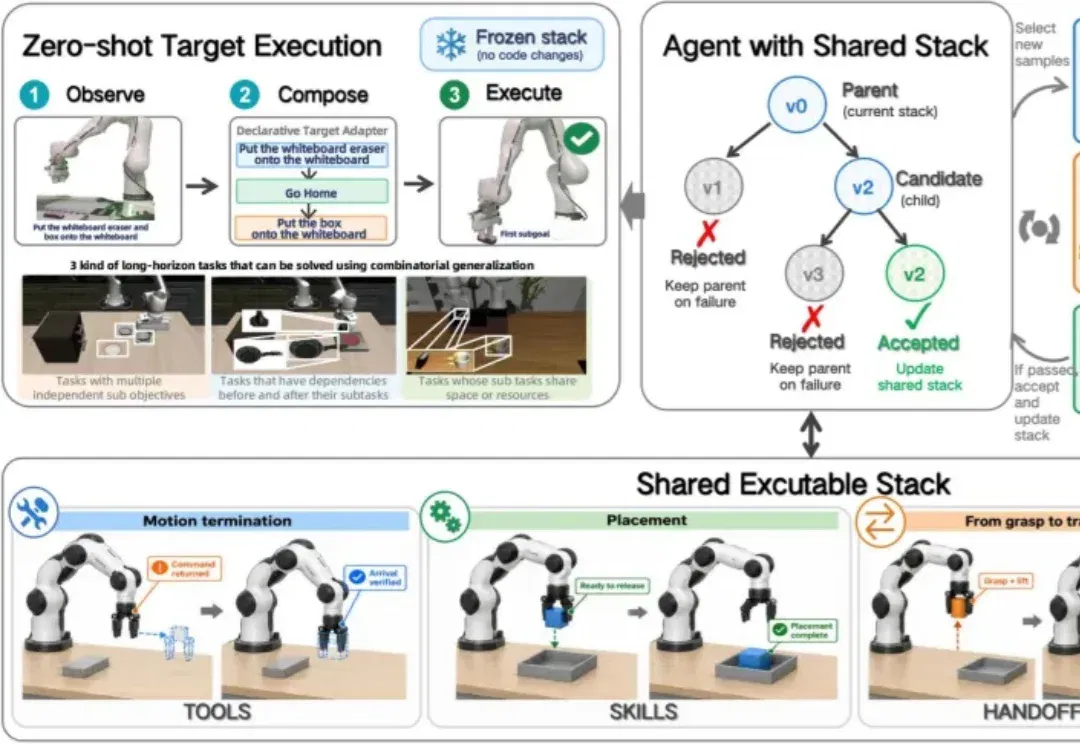
机器人 RSI 时刻远远未到达,先看一个动作:机械臂把碗放到盘子上,再抓起杯子,放进刚刚移动过的碗里。
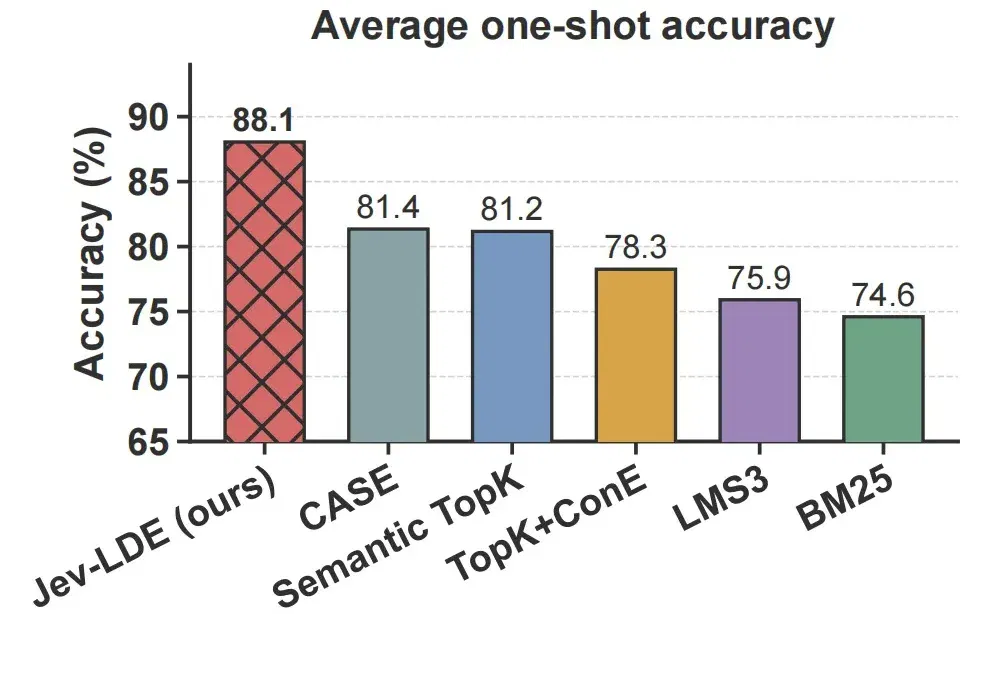
大模型做 In-Context Learning(ICL,上下文学习)时,通常会先从示例库里检索若干 demonstration,再把这些示例和当前问题一起放进 prompt。
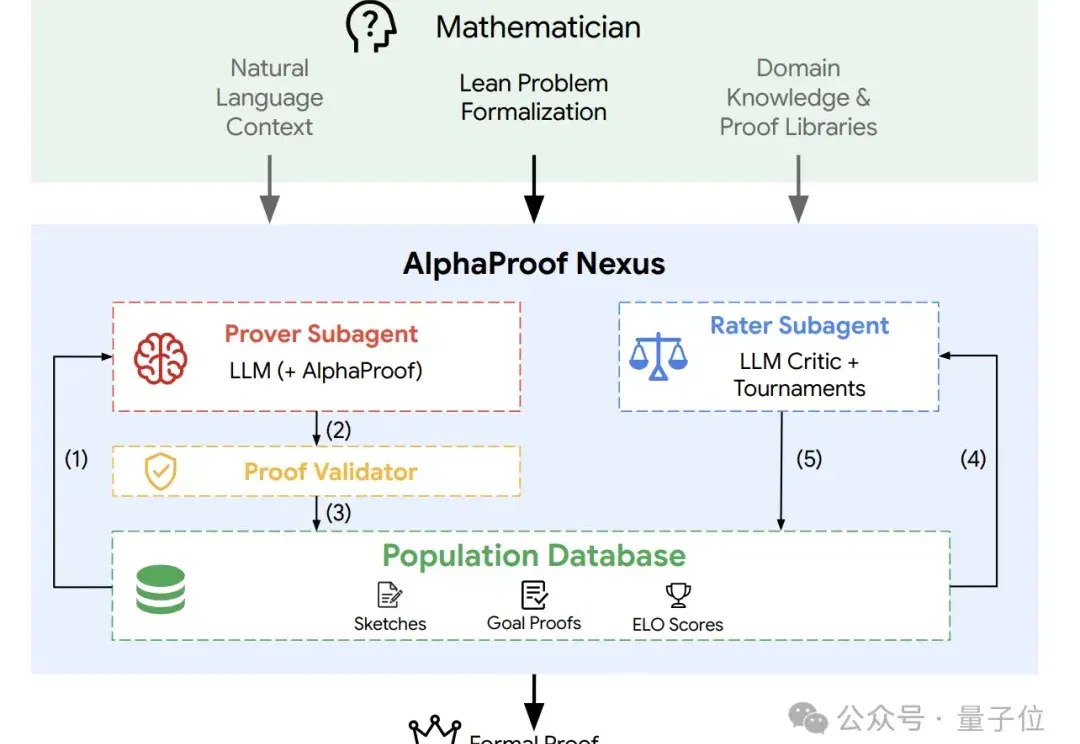
AI数学圈最近是真热闹。 OpenAI前脚一口气甩出722份数学证明遭到数学圈集体抵制,后脚谷歌DeepMind的数学研究就登上了《Science》。 一个是批量抛出待核验手稿,把校对重担甩给数学家; 另一个老老实实等了几个月,正儿八经走完了同行评审,接受了数学界的检验。 卡内基梅隆大学和南卡罗来纳大学的两位数学家,专门在同期《Science》上写了篇评论:《用于数学研究的AI已经到来》。 好嘛,OpenAI那边还在为数学证明的发布方式吵得不可开交,DeepMind这边已经收获了数学家的公开肯定。 DeepMind这次的主角是AlphaProof Nexus,一套由Gemini驱动的AI数学证
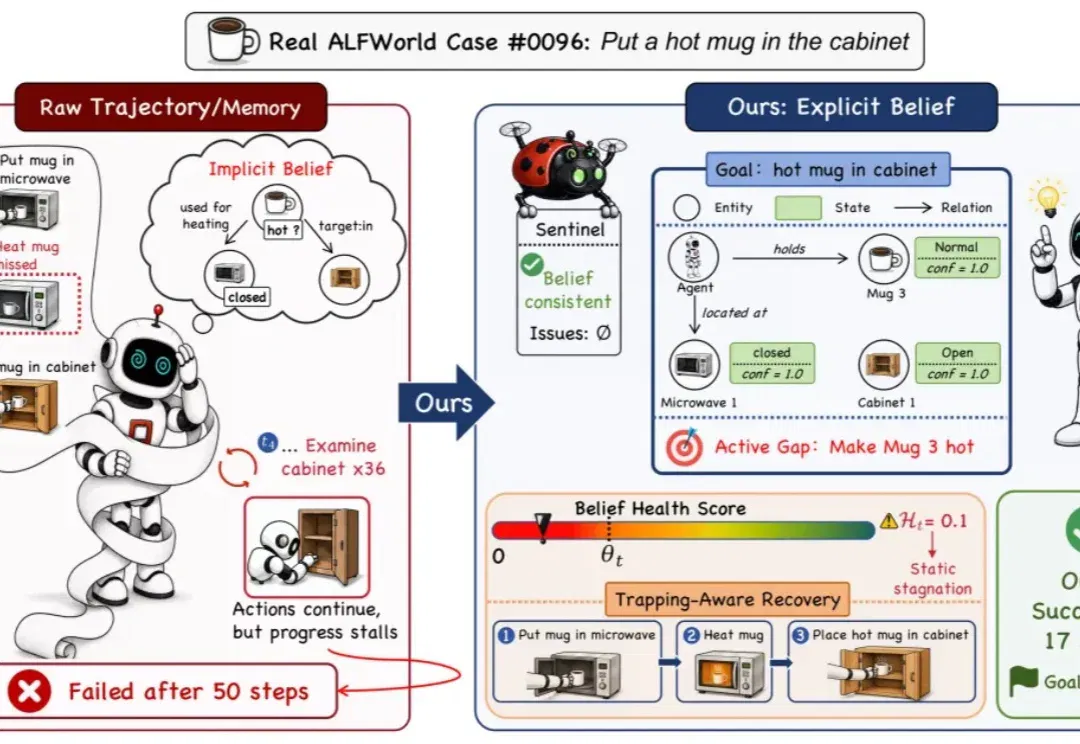
任务很简单:把一个加热后的杯子放进柜子。一个智能体先把杯子放进微波炉,再放进柜子,随后陷入反复查看柜子的循环。这个无效行为重复了 36 次,直到耗尽行动预算,任务仍然没有完成。
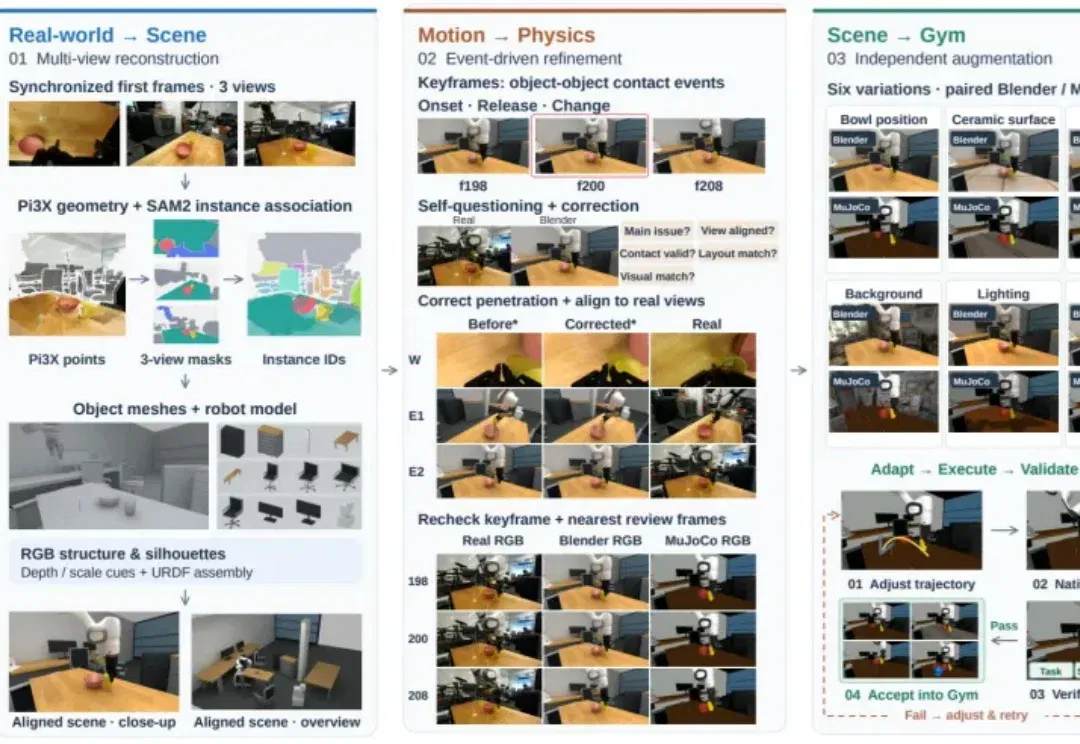
把杯子放进微波炉里,这一人类几乎不用思考的日常动作,机器人却可能在杯子放不稳、夹爪碰到门框这样的细节上频频出错。
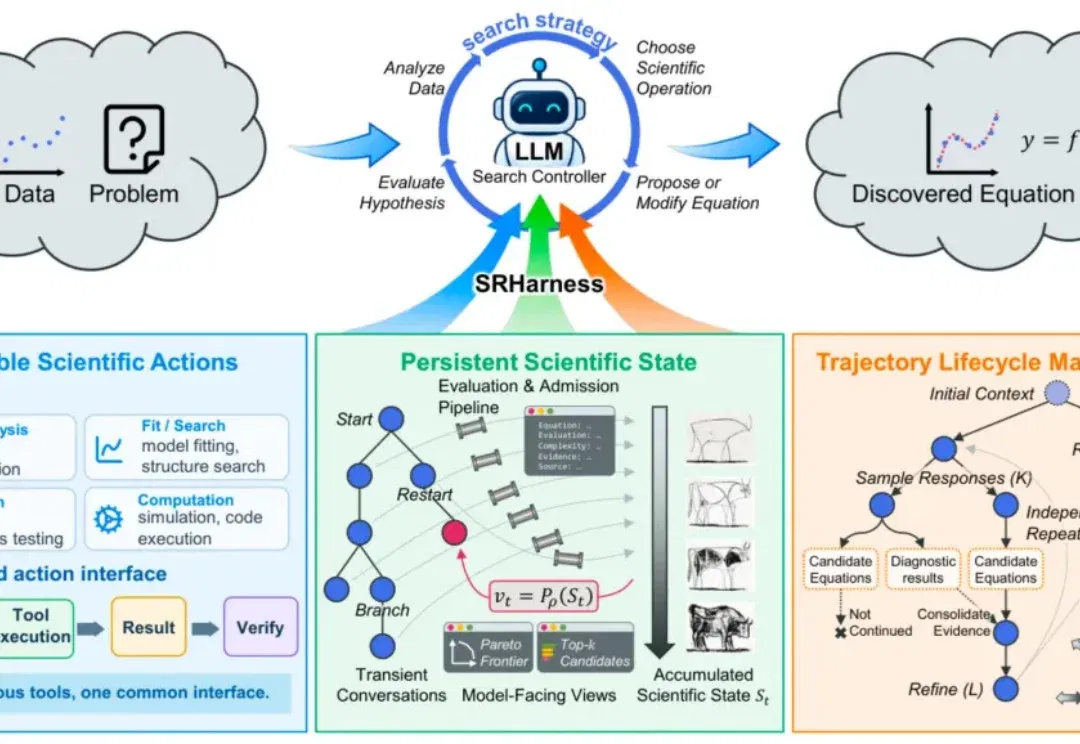
近日,清华大学电子工程系数据科学与智能实验室在 AI for Science 方向提出面向智能体符号回归(agentic symbolic regression)的运行时框架 SRHarness [1],让 AI 更可靠地从观测数据中发现公式;同时构建机制发现基准 MechBench [2],系统评测 AI 能否进一步揭示公式背后的机理。
Join the conversation
Read how to join the community. No sign-in is required to read articles.